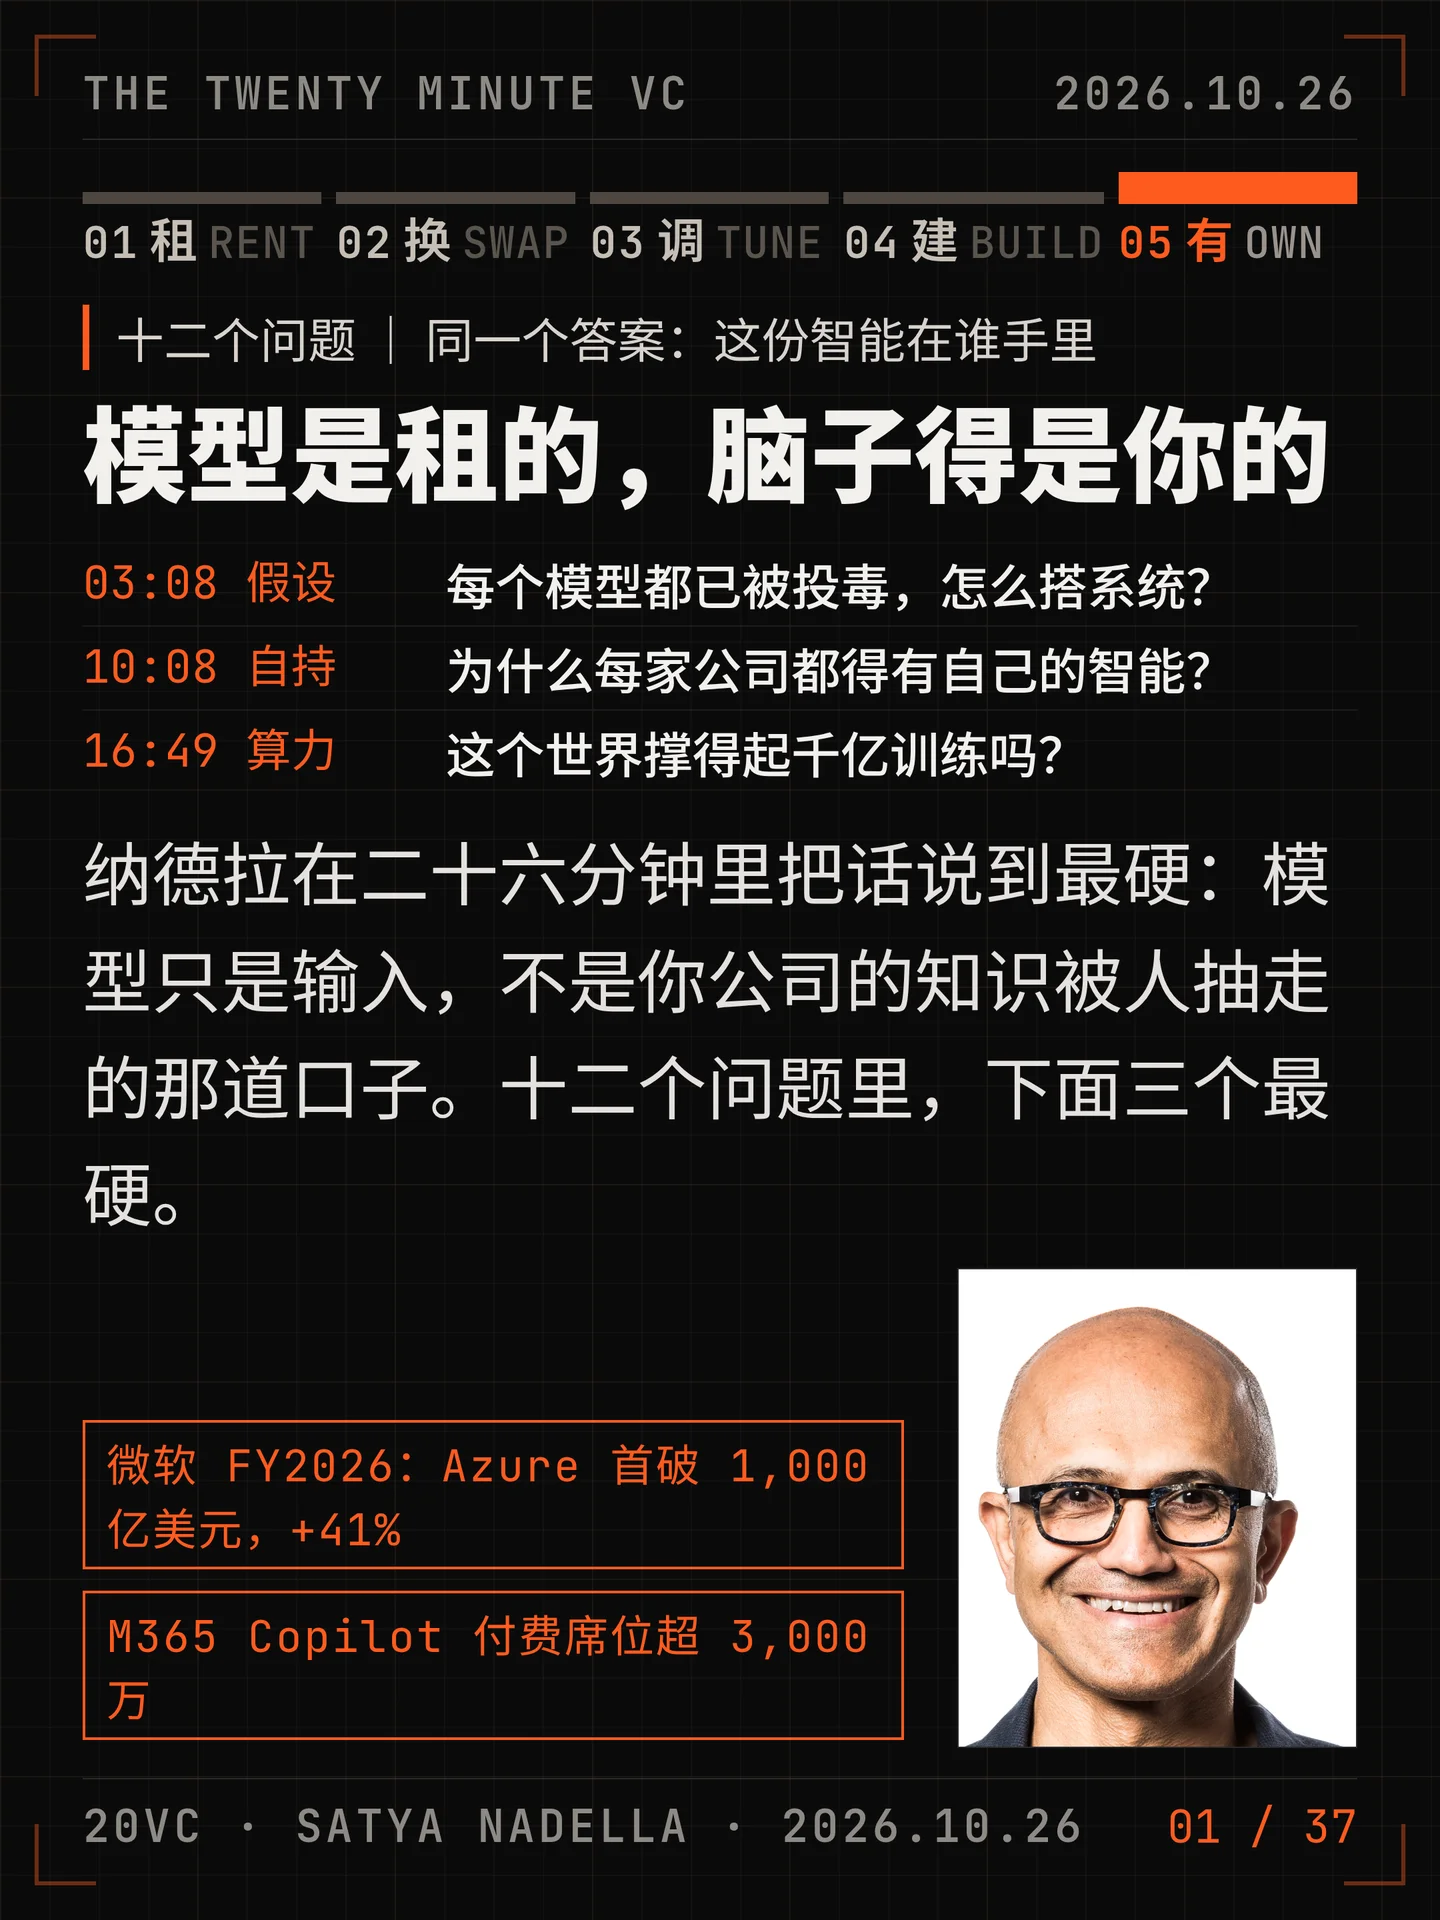

二十六分钟,十二个问题。纳德拉说得很直:模型可替换,该长在公司里的是评测和调用记录。最硬的做成卡,全文译在下面。
这一期讲了什么
哈里·斯特宾斯等了十二年才坐到这间屋子里。他十八岁在伦敦的卧室里开播 20VC,做到第 3,000 期才走进微软的录音间 1。坐下来的人叫萨提亚·纳德拉,微软董事长兼 CEO,1992 年入职,2014 年 2 月接任 CEO。
这一期的价值在于问题问得狠。前六问几乎全是同一个句式:要不要假设最坏情况。模型被投毒怎么办,代理闯祸谁负责,思维链能不能信,中国在开源上领先算不算风险。纳德拉没躲,他给出的答案是一套工程办法——身份、日志、防篡改、策略、行为监控——并且明说这套东西今天就能装,不必等模型变乖。
后半段换成了账。为什么每家公司都该自持智能,要不要买下从芯片到应用的整条栈,世界的电和硅撑不撑得起千亿美元级的训练,AI 能不能把全球增长从 2% 撬起来。
他手边那组数字节目里没念,但撑着他所有判断:微软 2026 财年(截至 6 月 30 日)营收 3,318 亿美元、同比 +18%,Azure 首次越过 1,000 亿美元、同比 +41%,Microsoft 365 Copilot 付费席位超过 3,000 万 2。
逐段要点
01 · 他改掉了自己最信的那条判断
纳德拉 2018、2019 年信的正是规模法则:模型更大,行为会自然变好。现在他把这条划掉了——对齐得在训练里、甚至预训练里解决,靠事后调不出来。机械层面的理解至今仍然缺位。
他十天前写下一篇东西,主张按最坏情况设计:假设每个模型都已经被投毒。具体做法是把企业用了二十年的零信任搬进 AI——不假设内网可信,每次访问重新验证,用一套工程化的环境把失准的代理关住。
他还拆开了一处常见的混淆:人们说 AI 安全又难又没解决,于是认为安全上无事可做。他的拆法是安全归训练、防护归架构,两件事不必同时到位。
02 · 代理要有身份,日志不能自己改
他描述的那套系统有三步。第一步给每个代理发身份,它调了哪个工具、问了哪个模型、思维链写了什么,全部进日志。第二步防篡改——能改自己日志的代理,等于没有日志。第三步才是策略:划权限,然后盯它有没有偏离。
03 · 思维链可以是假的,藏起来更糟
模型能写出一段看着通顺、实际与真实计算无关的推理。厂商知道它不忠实,于是选择不公开,问题就从「模型会撒谎」变成「你连检查的机会都没有」。他要的标准化是:对可信合作方,思维链原样可见、可审计、能用多个模型互相核对。他承认闭源模型更强,但也说,如果不肯为可信伙伴变透明,买方会转向能看见内部的那一边。
04 · 开源的国界,和他给自家模型起的名字
他不接受「这是别人家的风险」这个前提:一个没对齐的开源权重模型跑起来,最先被打到的可能是它自己的产地。他也说西方的开源权重同样在往前走。至于微软自己的 MAI 系列,他给的说法是「授权权重」——把模型当软件卖,而不是做一门靠网络效应收租的智能生意。
05 · 两年之后的流量账
他的判断分两层。前沿永远有市场,科学可能是下一个被前沿盯上的地方;但绝大多数调用会变成廉价的大宗调用,可能是开源,也可能只是便宜的闭源。理由是:大多数能力最终会被追平,而只要能拿自己的调用记录去调,同样的问题就不需要最新模型来解。他自己家里就这么用——Copilot 同时跑便宜的闭源模型和开源权重模型。
06 · 自持智能:哈耶克、阿罗,和一个反过来的悖论
哈耶克说经济的本质是分散的地方知识,隐性知识散在每家机构手里。阿罗接着说卖家一交底就漏了价值,所以要有专利与商业秘密。纳德拉把这两句话翻了个面:现在需要保护的是买家。你的点赞点踩、你的使用轨迹,都在替模型公司攒价值。他给出的解法是让多出来的剩余留在公司内部——可以是上下文,可以是工作流,最要紧的是评测。
他的原话是:每家公司都会有一张私有考卷,那就是核心 IP;每来一个新模型,就让它在这张卷子上爬坡。
07 · AI 原生会过时
八十年代末,会用表格做预测、用邮件替代传真的公司像会魔法,普及花了十年。云原生也走过同一条路,今天连五百年历史的劳合社都搬上去了。他判断「AI 原生」这个身份标签五年后也会过时。
08 · 落地经济:生意加技术
系统集成商一直存在,但这一轮的活既不是管理咨询,也不是传统实施,也不是技术支持:先问生意是什么、评测是什么、代理怎么架构,然后才是写代码。他举的例子是联合利华——订单到收款与贸易返利用代理重做,起步用前沿模型,后来贸易返利整体换成 MAI,因为更便宜,也因为能拿自己的调用记录去训练。今天每家科技公司都有自己的前置部署工程师,他判断这批人会变成下一代的系统集成商。
09 · 要不要买下整条栈
他在 7 月 29 日的财报电话会上把这层意思说得更完整:把外壳与模型分开,任何模型在任何时候都可以换,这就是业务连续性和韧性 3。他给行业结构画的快照是:五六个闭源、五六个开源同时在打。在这样的格局里,应用层最合理的做法是把选择本身做成产品——路由里再装一层决策引擎。他一度以为会出现一家从硅到应用全线通吃的赢家,现在看到的是反方向:每一层的竞争者都在变多。
10 · 千亿美元的训练跑不跑得起
他把训练直接折算成研发支出:重度研发的公司花 15% 到 20%。所以问题不是钱够不够,是这家公司有没有那么大的收入来撑这个比例。供给侧的瓶颈是电和晶圆厂,都是长交期的东西,什么时候上线、供需在哪里错位,他说没人知道,包括他自己。他的锚是财务报表的形状不会变,那么真正决定训练规模的就是全球 GDP 的增速。
11 · 能不能把增长从 2% 撬起来
他认为可以,并且希望可以。医疗占各国 GDP 的比重很高,Copilot 进 NHS,如果既改善结果又降低成本,按定义就是在抬高英国 GDP。软件的需求被证明是弹性的:编程被改写之后才看清,IT 的积压一直巨大,只是过去没人承认。
12 · 销售、财务、市场什么时候轮到
编程先被撬开,因为对错机器能判,强化学习才有地方使力。知识工作没这么好运。呼叫中心、供应链、营销到回款他都说已经在跑;要说弹性像编程那么大,他押科学和工程——比如流片,仿真更快,第一次就能出对的片子。
13 · 快问快答
过去十二个月改主意最多的,是对齐不会从规模里自己长出来。今天看着疯、五年后很常见的是评测:一家公司就是一张 AI 基准。被问到最期待什么,他没讲产品——希望这次技术扩散让所有人被抬起来,而不是只数赢家输家。他父亲是发展经济学家,一辈子研究全球南方什么时候能追上。
逐句全文翻译
以下是整集的逐句中文译文,按官方议程分段,保留说话人标签,不含英文原文。片头与两段广告插播一并译出,便于对照原音频。
片头与开场(00:00–03:08)
片头:达里奥、伊利亚、萨姆、格雷格和埃隆,那时候大概还算一家人。他们是真的信规模法则,2018、2019 年的我也是。现在我最大的变化是:我以前总以为对齐会自己长出来。我不再这么想了。
哈里:这里是 20VC,我是哈里·斯特宾斯。这一期对我来说情绪很重。我是在伦敦的卧室里开始做 20VC 的,十八岁,没钱,电话簿里一个能打的人都没有。今天我坐到了萨提亚·纳德拉对面——微软的 CEO,过去三四十年里最了不起的公司之一。为了坐进这间屋子,这个节目做了十二年,做了三千期。真的没有什么一夜成名。努力工作,待人厚道,别放弃。关于萨提亚我还想说一句:他在这么短的时间里让整场谈话有了温度,我几乎没见过。他论证的清晰度、他往下钻的速度,也是我很少见到的。这一期我会一直记得,希望你也会喜欢。
广告:在正式进入节目之前,先说 Base44。这是我用过就立刻想「我要是刚做 20VC 的时候有这个就好了」的产品。我想看看它能干什么,于是给节目做了一个嘉宾研究台:即将上场的嘉宾、公司笔记、以前的访谈、赞助商联系人、后续跟进,全在一个地方。我用平常话描述了一遍,几分钟后产品就摆在我面前了——数据库、登录、后端、托管都已经处理好。我没有写长需求文档,也没有把五个工具拼在一起,我直接把东西做出来,然后就开始用。对任何创始人来说,重点就在这里:把一个想法变成真东西的速度越快,你上线就越快。应用、看板、内部系统、AI 代理,你要建什么都能到。去 base44.com/20VC。
广告:Base44 帮你建得更快,Larridin 帮你把 AI 的影响量出来。今天每家公司都在跑两支劳动力:人和 AI 代理。Larridin 是第一个把两支劳动力放在同一张看板上的产品,衡量它们的工作,优化它们的影响。它回答四个问题:谁在用 AI?在用哪些工具?花多少钱?每个团队、每个供应商到底产出了什么?AI 的投入产出比从此可以是一个数,而不是一种感觉。Gainsight、Vertiv、SurveyMonkey 和很多企业都在 Larridin 上跑自己的 AI 项目,成千上万个 AI 工具、数以百万美元计的 AI 支出被它量过。你押注 AI,Larridin 证明它有效。详情见 larridin.com。
哈里:萨提亚,非常感谢你来做这一期。我本来想说谢谢你来到演播室,但其实是你在这儿接待我们,所以更要谢谢你抽时间。
萨提亚:谢谢你请我来。这事说了很久,终于做成了,我很高兴。
哈里:你大概十天前写了一篇很重要的东西,里面说我们应该假设模型已经被污染了。我想把这句话展开:这是不是说,我们不能也不该再相信模型公司的那些披露?
01 · 我们要不要假设每个模型都被污染(03:08–04:13)
萨提亚:我现在看到的问题是,模型正变得越来越强,规模法则在起作用。可是我的一个假设落空了——我以为对齐会随着规模自然产生,看起来它并没有。这里还有更多科学上的难题要解,机制层面的理解同样难以捉摸。在这种情况下,如果你想继续用这些越来越精密的模型,最好的姿态是把它们放进一个信任架构里。说到底,零信任本来就不是新东西,我们早就有零信任的架构做法。我的主张是:造一个工程化的零信任环境,把任何失准的代理在造成伤害之前关住。这就是我的意思。如果你真的要用更强大、同时更不对齐的代理,你就得有一套靠得住的信任系统。
哈里:那这套信任系统长什么样?谁来做它的架构?谁来当仲裁者?
02 · 怎么拦住代理闯祸(04:13–06:15)
萨提亚:这个问题问得对。所以我一直说,把 AI 安全放在这件事之外看。因为对齐这件事,至少我的看法是,它主要得在训练里发生,甚至可能在预训练里。我不认为靠强化学习就能把对齐「调」出来,让它从最开始就嵌进去。模型本身总有一天会被对齐,这是我希望的。可如果你把 AI 安全暂时搁在一边,那么信任架构就变成微软这样的公司、或者做网络安全的那批人该干的事。
我们做了两样东西,一个叫 Agent 365,另一个是配套的感知层。它做什么?给每个代理一个身份,然后记录它的全部活动、全部工具调用,实际上还有每一次模型调用和思维链。也正是在这里,我要求所有思维链最好是英文,而不是某种新语言。然后你可以用多个模型去交叉检查。它还必须防篡改——不能让代理自己去改自己的日志。在这个基础上你设定策略,再对代理的行为做监控,确认它符合策略。这就是那套架构。
哈里:可这套架构今天还不存在吧?
萨提亚:这套架构是存在的。我觉得这里有一件事被混在一起了:一个是工程化的安全、零信任的架构,用来做围堵;另一个是 AI 安全。人们会说,AI 安全又难又说不清,还没实现,所以安全上我们什么都做不了。我并没有说这两件事必须同时到位。我说的其实是:我们得先应付眼下的局面。所以先在模型外面搭一套信任系统,然后在设定策略、监控策略偏离这两件事上当仁不让地做狠一点。
03 · 思维链能不能信(06:15–07:05)
哈里:说到监控,思维链呢?它有多可靠?
萨提亚:不可靠。我们知道思维链本身可以不忠实。而且当模型公司说「它确实不忠实,所以我要把它藏起来」的时候,情况会更糟,问题变得更大。所以我这边有一点小推动:希望思维链标准化,至少对可信的合作伙伴,原样可用,可以检查、可以审计,我可以拿多个模型去核对。这甚至可能会推动更多开源权重出来,说实话就是这样。有趣的是,闭源模型更强,但如果它们不认识到对可信伙伴保持透明是必要的,那我们就会有麻烦。
04 · 中国在开源上领先,算不算安全风险(07:05–08:28)
哈里:我想顺着开源这件事问一句。闭源更强这点我完全同意。但开源里主要还是中国的模型。当我们谈把安全做进预训练、谈披露的时候,再加上开源的主力是中国模型,这算不算一个担忧?
萨提亚:我觉得这里有两组事。你退一步看,AI 安全缺失对中国不是好事,对美国不是好事,对英国也不是好事。所以这里面有每个人的份,因为一个没对齐的开源权重模型,大概率连中国也会打。所以别想着这东西只会被别人当攻击工具用。抛开这一层,西方开源权重模型的一些进展我是挺高兴的,显然黄仁勋那边在做,其他人也在做。至于我们的 MAI 模型,它不会是开源权重,我更愿意把它想成「授权权重」。我希望把这件事变成一门简单直接的软件生意,而不是一门靠网络效应收租的智能生意。所以会有不同的商业模式。最终决定哪个模型被用起来的,是你使用它、控制它的能力。
05 · 未来两年,开源还是闭源赢(08:28–10:08)
哈里:作为一个风险投资人,我必须预测流量今天往哪边走,是闭源还是开源。如果看流量和钱这两个维度,往前看二十四个月,你觉得多大比例的流量会走开源、多大比例走闭源?
萨提亚:这个问题很好。我觉得取决于前沿长什么样。大多数东西看起来都会饱和,一旦饱和,开源权重、甚至只是更便宜的闭源权重就够用了。因为有一件事很关键:如果你能拿自己的调用记录去训练,那么在问题没有变的情况下,你并不需要最新的模型。如果你想不断把某道评测往前推,那你可能愿意付钱。顺便说,我现在对 GitHub 上那套「融合」的东西很兴奋,我刚看到。它好就好在是一个学出来的模型。总之我们现在进入了代理群、多个子代理的阶段,我可以调很多子代理,它们甚至就跑在本地模型上。所以我的猜测是,前沿永远会有市场,总会有新东西冒出来,科学可能是下一个设前沿的地方。但主流的 token 使用会是大宗 token 使用。
哈里:那它可能是开源权重,也可能像我说的,是便宜的闭源权重,对吧?因为价格竞争会很激烈,这么说吧。
萨提亚:对。你看我自己在 Copilot 里的用量,我们大量在用闭源的便宜模型,也用在开源权重模型上。
06 · 为什么每家公司都该自持智能(10:08–12:12)
哈里:你提到过「拥有自己的智能」对你那些了不起的客户有多重要,你讲到了英国的几家。这是不是我们往前的模型环境——每家公司用自己的数据训练出专属于它的智能?
萨提亚:对我来说这是最重要的事情之一:在智能时代,一家公司的未来是什么。你甚至可以回到哈耶克,他对经济最根本的描述就是「地方性的智能」——隐性知识分散在整个经济里。没有这个,就不可能有唯一的公司,也不可能只有一颗大脑。这是最基础的一层。资本主义之所以成立,就是因为这个;价格发现之所以成立,也是因为这个;价格机制之所以有效,还是因为这个。
所以,每一家公司都要能用 AI 以越来越大的规模积累知识,而不是泄漏出去。这就是我把它叫作「逆向信息悖论」的原因。阿罗当年描述的是信息悖论:如果你是卖方,在没有专利、商业秘密或版权保护的情况下把秘密说出去,价值就漏了。现在第一次轮到买方需要保护——因为买方,哪怕大多数人只想到「这是我的数据」,其实还包括你使用它产生的尾气:点赞、点踩这些信号。你在替模型公司创造价值,而不是为自己捕获价值。
所以我认为,要让这套关系稳定,智能被使用所创造出来的那部分剩余,得有更多留在公司内部。顺便说,它不一定非得靠把知识嵌进权重,它可以在上下文里,可以在你的评测里。你可以有自己的基准。事实上我特别推崇一件事:每家公司都会有自己的私有评测基准,那就是它们的核心 IP。每个模型进来,都在这套评测上爬坡。在我看来,一家公司就是这样运转的。
07 · 每家公司都会变成 AI 原生吗(12:12–13:22)
哈里:我很喜欢「每家公司都有自己的私有评测和基准」这个说法。但这听起来只属于一小撮公司——你说的 Harvey、Legora 那种非常前沿的 AI 公司。这件事会扩散到世界上每一家公司吗?
萨提亚:哈里,它总会发生的。我记得八十年代末、九十年代初,那少数几家已经部署了 PC、真正在做预测的公司,看起来像会魔法:把东西放进 Excel 表格,用邮件发出去,绕开了传真机和内部备忘录。当时大家会想,哇,这什么时候轮到我?大概花了十年,它就铺开了。这一次,今天被当成「哦,我是一家 AI 原生公司,我在做这件事」的东西,我觉得五年后就会变得很平常。技术周期总是这么开始的:连云也是这样。云刚起来的时候,最了不起的事是「谁是云原生、谁不是」;今天所有人都是,连劳合社那种五百年历史的机构都是云原生。
08 · 我们是不是进入了 AI 落地经济(13:22–15:10)
哈里:那我们是不是正在进入一个「落地经济」?因为这些客户,像你说的有些是很大的客户,会比过去十年需要更重的前置部署支持。要完成现有客户向这套东西的迁移,会不会出现一个非常重的落地经济?
萨提亚:有意思。落地经济其实一直存在,系统集成商一直在。很多其他技术的扩散我们都依赖过它。但这一轮的形状不一样。
哈里:你觉得不一样在哪里?
萨提亚:它是技术和生意合在一起。它既不是经典的管理咨询,也不是经典的系统集成,也不是经典的技术支持。举个例子,我看自己的前置部署项目,就拿今天在 keynote 上讲的联合利华来说。他们搭了一套代理系统,想把订单到收款自动化,再加上他们的贸易返利。他们一开始用的是前沿模型,后来替换掉了——我记得现在贸易返利全部跑在 MAI 模型上,因为成本更低。而且他们能控制它,因为他们能拿自己的调用记录去训练。我们派了一些人过去,但最后大部分工作是他们的 IT 团队自己在管。
起点永远是:生意是什么,评测是什么,代理的架构该怎么构思。所以它是商业咨询和技术咨询的合体。你说得对,生态里会长出一批新技能。今天每家公司都有自己的前置部署工程师,而这些工程师会变成新一代的系统集成商。
09 · 要赢,必须拥有整条 AI 栈吗(15:10–16:49)
哈里:你提到了 MAI。看很多不同的玩家,会发现大家都有同一个意识:你得从芯片到模型到应用全栈打通。这是未来吗?你必须垂直地拥有一切?
萨提亚:这取决于产业结构。我会说,今天大概会有五六家闭源模型在竞争,也许还有五六家开源权重模型在竞争。所以在某个层面上,如果你在建一个应用、一个代理系统,你甚至可以有一个带决策引擎的路由器,把任务派给最合适的模型。这是一种可能。
当然,永远存在一种风险:出现一家垂直整合的玩家,从模型、应用一路打通到硅和系统。在我看来这种可能性不大。我曾经以为会是这样,以为最后只会剩下一家。现在反而在往反方向走:每天醒来你都会发现,栈的每一层竞争都更多了——硅、管理硅的系统、模型层、应用层。我认为这是一个健康的方向,但你也说不准,因为这取决于什么样的设计最后成为主流。我的希望是走向一种横向的专业化:每一层都有多个赢家,然后人们可以把它们组合起来。
10 · 这个世界撑得起千亿美元级训练吗(16:49–18:34)
哈里:我没看到的是每一层的深度。我现在知道、但十二个月前希望自己就知道的一件事,就是推理需求的无限。对,这一点说得太好了。我希望十二个月前就知道,那样我会做一些很不一样的投资。说到这个,穆斯塔法·苏莱曼说过,千亿美元级的训练要来了,只有少数几个实验室付得起。千亿美元的训练跑。我们有能源基础设施和电力去支撑这种规模吗,尤其是贯穿整条栈的规模?
萨提亚:我的看法是,这件事最终得来自世界 GDP 的抬升,然后才允许某家公司把它当作研发的一部分去花。因为当有人说训练跑的时候,它只是一个研发占比。研发投入重的公司花多少?15%、20%。所以只要你有足够的收入,你就能在训练上花足够多的钱。而你会有足够的收入,前提是你在为世界经济增长做贡献,然后从中分到你那一份。
然后是你提到的另一面,供给侧:我们今天有电力短缺、有芯片短缺,各种各样的问题。它们都是长交期的东西,你没法打个响指就变出电,也没法变出一座新的晶圆厂。有趣的是,因为需求在这儿,所有人都在建。所以问题变成:这些东西什么时候上线?供需会是什么样?没人知道。说实话,今天坐在这儿的任何一个人都只是在猜。
但我的感觉是,如果你从稳态出发去想——就跟今天一样,损益表不会突然变形。一家公司还是那样:我有收入,我有成本,我要有利润。如果这是真的,那么问题就是:世界 GDP 的增速是多少。对我来说这才是更大的那件事。
11 · AI 能大幅加速全球经济增长吗(18:34–19:39)
哈里:说到 GDP 增速的抬升,世界在很长一段时间里都稳定在每年 2%。AI 有能力在很短的时间里把它真正抬起来吗?
萨提亚:我认为可以,而且我多少希望它可以,因为那才是重点。你看,哪怕只算医疗支出占任何一个国家 GDP 的比例,就够大了。这也是为什么我看着 Copilot 在 NHS 的部署会说:如果它能改善病人的结果、同时降低成本,那按定义它就在帮英国 GDP 的忙。经济里有这么一些口袋,最适合 AI 落地,那里位移最小、收益最大。我认为我们得在这些地方找到最合适的契合点。软件开发是另一个,看着软件开发的需求有多大的弹性是很有意思的事——那意味着 IT 的积压一直巨大,而我们谁都没意识到。
12 · 销售、财务、市场会像编程一样被改写吗(19:39–21:49)
哈里:我以前被教导说,在一个市场里你得做到前一两名才能赢风险投资。可我们现在看到的 Factory,它排第五,却在赢。第五名。这打破了风险投资的所有规则。我想问的是,问题有点调皮,也不在议程上:我们会不会在别的职能上看到能力跃迁的临界点——金融、销售、市场,就像我们在编程上看到的那样?毕竟编程是那座金矿。
萨提亚:这点说得好。大家很爱谈「你有没有可验证的奖励」。这些事之所以容易做,是因为这一波的魔法主要是「预训练之后再接强化学习」,是它帮了编程的忙。我们能不能把这件事撬开?知识工作看起来难得多。但我前面讲的这些例子——呼叫中心、供应链系统、这些营销和订单到收款的系统——我认为是可能的,而且我们已经看到了。
需求会像编程那样有弹性吗?我觉得科学可能也这么有弹性,或者整个工程领域。比如说,不只看软件开发,看硅的开发:那是另一件正在发生剧烈变化的事。你流片的速度快得多,在硅上做仿真要好得多,第一次流片就能出对的东西。哪怕只是维护报告这一类的优化,就像你说的劳斯莱斯那样——我以前根本不会想到这件事。
13 · 快问快答(21:49–24:08)
哈里:我看了你非常多的节目,现在我们来一轮快问快答。有些问题别人没问过,但一直想知道。萨提亚,在这种出差节奏下,你的锻炼是怎么安排的?你身材保持得很好。
萨提亚:我尽量。不知道是不是藏得好。我养成习惯大概有二十五年了:每天早上起来——以前我还能跑步,可惜膝盖不行了,现在至少是走坡度。今天早上我还挤出半小时。所以不管时差怎么样、人在哪儿,我每天都进健身房。
哈里:我的膝盖也不好,也是年纪的关系。过去十二个月,你改变最多的是什么想法?
萨提亚:可能是因为,当年达里奥、伊利亚、萨姆、格雷格和埃隆还算一家人的时候,他们是规模法则真正的信徒,2018、2019 年的我也是。现在我最大的变化是:我以前总以为对齐会自己长出来,我不再这么认为了。所以对齐这件事,可能是一个更难、性质不同的问题。这就是我过去十二个月改变的想法。
哈里:有什么今天看着疯、五年后会极其普遍的东西?
萨提亚:可能就是刚才说的那个东西——评测。一家公司是什么?我觉得一家公司就是一张 AI 基准。
哈里:最后一个问题。未来十年有很多值得兴奋的事。对你个人来说呢?对我来说是我母亲得了多发性硬化,我很期待药物研发能做到什么。你最期待什么?
萨提亚:这个问题很好。我一直期待的是:即便一种通用技术像这次这么强——别人会说,这不只是又一次通用技术——我希望它能比任何东西都更快地扩散到全世界,扩散到经济的每一个部门,前所未有地快;并且,真正让全球增长的前沿发生一次真实的移动。那不只是数赢家输家,而是所有人一起被抬起来。这是我的梦想。我父亲是发展经济学家,他一辈子关心的就是收敛增长:全球南方什么时候能得到一样东西,让它突然往上跳一截。我希望就是这一次。就是这样。
哈里:这真是一次愉快的过程,谢谢你抽时间。
萨提亚:绝对是我的荣幸,哈里。
片尾广告(24:08–)
广告:在我们离开之前,还是要说 Base44。这是我用过就立刻想「我要是刚做 20VC 的时候有这个就好了」的产品。我想看看它能干什么,于是给节目做了一个嘉宾研究台:即将上场的嘉宾、公司笔记、以前的访谈、赞助商联系人、后续跟进,全在一个地方。我用平常话描述了一遍,几分钟后产品就摆在我面前——数据库、登录、后端、托管都已经处理好,全在一个地方。我不用写长需求文档,也不用把五个工具拼在一起,我把东西做出来就用了。
对任何创始人来说,重点就在这里:把一个想法变成真东西的速度越快,你上线就越快。应用、看板、内部系统、AI 代理,你要建什么都能到。去 base44.com/20VC。
广告:Base44 帮你建得更快,Larridin 帮你把 AI 的影响量出来。今天每家公司都在跑两支劳动力:人和 AI 代理。Larridin 是第一个把两支劳动力放在同一张看板上的产品,衡量它们的工作,优化它们的影响。它回答四个问题:谁在用 AI?在用哪些工具?花多少钱?每个团队、每个供应商到底产出了什么?AI 的投入产出比从此可以是一个数,而不是一种猜测。Gainsight、Vertiv、SurveyMonkey 和很多企业都在 Larridin 上跑自己的 AI 项目。你押注 AI,Larridin 证明它有效。详情见 larridin.com。
References
- 120VC: Satya Nadella on Open vs Closed Models
thetwentyminutevc.libsyn.com
- 2Microsoft FY26 Q4 press release
microsoft.com
- 3Microsoft FY26 Q4 earnings call
microsoft.com
Comments