《SimCLR》:同一张图的两个增强视图,怎么替代 ImageNet 的标签
从同一张图的两个增强视图出发,拆解 SimCLR 的 NT-Xent 损失、投影头与大批量训练,讲清数据增强如何定义对比任务,并用 ImageNet 上的线性评测、半监督与迁移结果读懂它的能力与代价。

2020 年 2 月 13 日,Ting Chen、Simon Kornblith、Mohammad Norouzi 与 Geoffrey Hinton 把《A Simple Framework for Contrastive Learning of Visual Representations》挂上 arXiv,编号 arXiv:2002.05709,四人都来自 Google Research 的 Brain Team;论文在当年 7 月的 ICML 2020 上发表,收录在 PMLR 119 卷 1597–1607 页。12
论文要讲的事可以从一个平常的操作说起。取一张狗的彩色照片,随机裁下一块再缩放回原尺寸,把亮度、对比度、饱和度、色相抖动一下,加一点高斯模糊。同一次操作做两遍,得到两张彼此不同、内容同源的图。把它们分别送进同一个卷积网络,要求网络输出两个彼此接近的向量。
让人意外的是这件事的后果。用同一套做法在 ImageNet 上训练,冻结整个网络、只在最后接一个线性分类器,top-1 准确率是 76.5%,比此前最好的自监督方法高出 7%,与监督训练的 ResNet-50 打平;只用 1% 的标签微调,top-5 准确率 85.8%,超过用全部标签训练的 AlexNet。1
两个数字值得先记住。默认训练批量是 4096,最大做到 8192,此时每个正样本对要同时与 16382 个负样本比较;而 128 个 TPU v3 核心、批量 4096、跑 100 轮,大约需要一个半小时。3
2020 年的自监督学习,任务从哪里来
不用标签训练图像表示,当时主要有两条路。3
生成式方法直接对像素建模,自编码器、GAN、PixelCNN 都属这一类。它的问题在于算力花在重建像素细节上,而这些细节未必是学表示所需要的。
判别式方法给无标签数据编造出输入和标签,构造一个前置任务(pretext task):预测两块图块之间的相对位置、把打乱的拼图拼回原样、给灰度图上色、判断图片被旋转了多少度。这类任务由人手工设计,任务好不好、学了有没有用,取决于设计者的直觉。
再往前一步是对比学习:在潜空间里比较样本。让表示在小变换下保持一致的思路,可以追到 Hadsell、Chopra 与 LeCun 在 2006 年的工作。2018 年 van den Oord 等人的对比预测编码(CPC)把这条线推近了一步,用 InfoNCE 损失预测未来的潜向量,并靠负采样让目标函数变得可算。4
到 2019 年,这条线上的竞争集中在一个地方:负样本从哪里来。要学好表示,正样本得和足够多的负样本比,而一个 batch 里能装下的样本有限。于是有人用记忆库(memory bank)保存历史上出现过的样本特征当负样本,有人用固定切分或受限感受野制造不同视图,还有人专门设计聚合网络。这些做法解决的是同一个问题,代价是方法越来越复杂,也让人说不清究竟哪一部分在起作用。
论文作者问的是另一个问题:把这些组件逐个拆开,哪些真正决定表示质量。第 7 节那段自我定位写得很直接——框架里几乎每个组件都出现在此前的工作中,而本文的优势无法由任何单一设计选择解释,只能由这些组件的组合解释。3
核心思想:任务由数据增强定义
SimCLR 的框架由四个部件组成,第 2.1 节按顺序列了出来。3
第一个是数据增强模块。同一张图经过两次随机增强,得到两个相关视图 与 ,它们构成一个正样本对。默认依次施加三种增强:随机裁剪并缩放回原尺寸、随机颜色变换、随机高斯模糊。
第二个是基础编码器 。论文直接用常用的 ResNet,, 取平均池化之后的输出。
第三个是投影头 ,一层隐藏层的 MLP,, 是 ReLU,输出 128 维。
第四个是对比损失函数。给定一组包含正样本对 的样本,任务是在其余样本里把 认出来。
任务的存在方式就藏在第一条和第四条里:它由数据增强定义。取一个大小为 的 mini-batch,每张图增强两次,一个 batch 变成 个样本点;对其中任何一个样本,正样本是同一张图的另一个视图,剩下 个增强样本全部充当负样本。论文写明不显式采样负样本:负样本就是同批次的其他人。批量 8192 时,那个 16382 的负样本数正是这么来的。
随机裁剪在这里的地位比它看上去重要。裁剪加缩放会产生一类预测任务:同一张图的两个裁剪,可能一个是整幅、一个是局部,也可能落在两块相邻区域。此前的工作要靠约束感受野、固定切分或专门的上下文聚合网络才能造出这两类任务,而随机裁剪用一行预处理代码把它们收进同一个家族,顺手把“任务长什么样”从网络结构里解耦出来。3
一种变换不够:读 Figure 5 那张热力图
为了看清楚每种增强各自值多少,作者搭了一个非对称消融:先统一做随机裁剪并缩放,再把待测变换只施加在框架的一支上,另一支保持恒等。论文自己注明这种非对称设置本身会拉低分数,但不应实质改变单个增强及其组合的相对影响。3
结果是一张 7×8 的热力图。
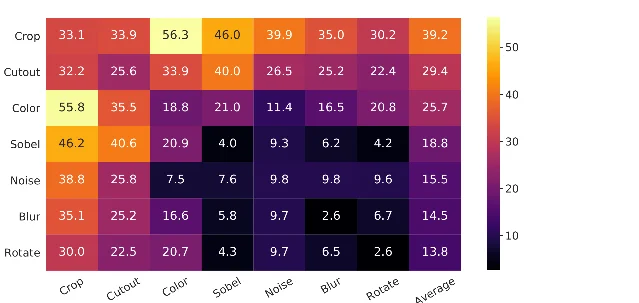
论文从这里读出两件事。单一变换都不足以学到好表示,尽管模型几乎能完美地把正样本对认出来;换成两种变换的组合之后,对比任务变难,表示质量却大幅上升。行平均那一列把这件事说得更清楚:裁剪 39.2、剪切 29.4、颜色 25.7,越往下越低。
为什么偏偏是“裁剪加调色”这一格跳出来?论文给的机制是捷径。只做随机裁剪时,同一张图的不同裁剪块颜色分布几乎一样,而不同图片之间靠颜色直方图就能分开;网络很容易学会“颜色分布一致即同一张图”,用这条捷径把对比任务做对。把颜色变换叠上去,这条线索被破坏,网络只能去找形状、纹理这类更稳定的特征。3
接着是一组更反直觉的对照:把颜色变换的强度从 1/8 一路调到 1(再叠上高斯模糊)。在这条轴上,无监督的线性评测从 59.6 一路升到 64.5,而监督训练的 ResNet-50 反而从 77.0 掉到 75.4。用监督学习搜出来的 AutoAugment 策略拿到 61.1,也不如朴素的“裁剪 + 强调色”。3
| 方法 | 1/8 | 1/4 | 1/2 | 1 | 1(+模糊) | AutoAugment |
|---|---|---|---|---|---|---|
| SimCLR(无监督,线性评测) | 59.6 | 61.0 | 62.6 | 63.2 | 64.5 | 61.1 |
| 监督 ResNet-50 | 77.0 | 76.7 | 76.5 | 75.7 | 75.4 | 77.1 |
两行不能直接比高低:上一行是不用标签预训练再线性评测,下一行是用全部标签直接监督训练,起点本就不同。可比的是每一行自己的走向——同一组增强,无监督的表示越强越好,监督的准确率反而被拖低。论文由此给出第一条结论:对比学习比监督学习更受益于更强的数据增强。3
损失函数:一行 NT-Xent 在算什么
框架的第四个部件是损失函数,它把“认出正样本”变成一个可微的目标。对一个正样本对 :3
逐项拆开看。 是 归一化之后的点积,也就是余弦相似度,比较的是两个向量的方向。分子是正样本对的得分;分母把所有 个样本里除自己以外的每一个都算进来,所以整个分式是一个 类的 softmax。损失要做的事,就是让正样本对在这 个候选里得分最高。批量 8192 时,候选池就是那 16382 个负样本。
温度 控制的是这份 softmax 的尖锐程度。最终损失把所有正样本对双向计入再取平均:
论文给这个损失取名 NT-Xent,即归一化温度标度交叉熵(normalized temperature-scaled cross entropy)。
损失的具体形式为什么值得挑,答案藏在梯度里。论文把三种候选目标连同梯度一起列在 Table 2 里比较:NT-Xent、NT-Logistic 与 margin 三元组。从梯度看,NT-Xent 对每个负样本的加权方式是“越难的负样本权重越大”——相似度越高的负样本拿到的梯度越大;另外两种目标缺少这个性质,必须额外做半难负样本挖掘(semi-hard negative mining),也就是只挑那些比正样本远、但落在边界附近的负样本参与梯度。即便如此,实测仍差一截:margin 50.9、NT-Logistic 51.6,加上半难挖掘升到 57.5 与 57.9,NT-Xent 是 63.9。3
归一化与温度这两个细节,则在 Table 5 里留下了这篇论文最值得单独记住的一组数字。
| 归一化 | 温度 | 对比任务准确率 | 线性评测 top-1 |
|---|---|---|---|
| 有 | 0.05 | 90.5 | 59.7 |
| 有 | 0.1 | 87.8 | 64.4 |
| 有 | 0.5 | 68.2 | 60.7 |
| 有 | 1 | 59.1 | 58.0 |
| 无 | 10 | 91.7 | 57.2 |
| 无 | 100 | 92.1 | 57.0 |
“对比任务准确率”指的是模型在 4096 个候选中把正样本认出来的比例,它衡量的是代理任务做得准不准;线性评测衡量的是表示好不好用。两列放在一起,趋势是相反的:去掉 归一化之后,模型把对比任务做得更准(91.7、92.1),线性评测却掉到 57.0 与 57.2;归一化配 时任务准确率只有 87.8,线性评测反而最高,64.4。温度调大(0.5、1)会抹平负样本之间的得分差距,表示质量随之下降。3
这张表与 Figure 5 说的是同一件事,只是从两个角度切进去:对比任务的准确率是代理指标,它可以被捷径刷高,而表示质量由下游任务说了算。任务要难在语义上——难在让网络放弃颜色统计、朝向这类容易记住的线索,而不是难在噪声本身。
算法与训练配置逐行读
把上面的部件拼起来,训练循环只有几行。3
- 取一个 mini-batch 。
- 为每张图采样两个增强函数 、。
- 第一支:,,;第二支同法。
- 在 个 之间算出两两相似度。
- 按式 (1) 得到 ,在所有正样本对上求平均得到 。
- 用 更新 与 ,循环结束后返回 ,丢掉 。
默认配置是:ResNet-50 编码器;投影头输出 128 维;LARS 优化器,学习率 4.8(等于 批量 );权重衰减 ;批量 4096,训练 100 轮;前 10 轮线性 warmup,之后余弦衰减。3
有一处工程细节值得单独说,因为它暴露了对比学习的小陷阱。数据并行训练时,批归一化(BN)的均值与方差通常各设备各算。但在这个框架里,一个正样本对的两个视图是在同一块设备上算出来的;如果 BN 统计量只在本地聚合,模型可以利用这种局部的信息泄漏把预测做得更准,而表示并没有变好,跟前面那张热力图里刷高任务准确率的捷径是同一类问题。论文的做法是在所有设备上聚合 BN 的均值与方差。3
账本也在这里:128 个 TPU v3 核心、ResNet-50、批量 4096,跑 100 轮约 1.5 小时;而第 6 节里与其它方法对比的那批结果,训练轮数是 1000 轮。3
投影头:训练完为什么要把 g 丢掉
一个只在训练时存在、推理时被丢掉的 MLP,是这套框架里最容易让人困惑的地方。论文用三组对照回答了它值多少:不做投影、线性投影、一层隐藏层的非线性投影。非线性投影比线性投影高约 3%,比不做投影高超过 10%。更反直觉的一条是,即便用了非线性投影,投影之前那一层 仍比投影之后的 好超过 10%。3
作者给出的解释是信息损失。 被训练成对数据变换保持不变,于是它有条件把下游任务用得上的信息一并丢掉,颜色和朝向都在其中; 只通过 这个瓶颈被间接约束,保留的信息更多。为了验证,他们额外训练 MLP 去预测预训练时施加了哪种变换,准确率列在 Table 3:判断颜色还是灰度, 是 99.3%、 是 97.4%;判断旋转角度,67.6% 对 25.6%;判断原图还是损坏图,99.5% 对 59.6%;判断原图还是 Sobel 滤波图,96.6% 对 56.3%(随机猜分别是 80%、25%、50%、50%)。3
结论落到一句可操作的规则上:下游任务用 ,投影头 只是为了让对比损失有一个合适的比较空间。
实验怎么读:三个协议,三组表
论文用三个协议检验这套表示。线性评测冻结预训练主干,只在特征上训练一个线性分类器,用测试准确率作为表示质量的代理;半监督学习只给 1% 或 10% 的标签,把整个网络微调;迁移学习在 12 个自然图像数据集上分别做线性评测与微调。三个协议回答的问题不同,混着读会把不同的事读成一件。
Table 6 是线性评测的主表,同一个 ImageNet 验证集上的 top-1:3
| 方法 | 架构 | 参数量 | top-1 | top-5 |
|---|---|---|---|---|
| Local Agg. | ResNet-50 | 24M | 60.2 | — |
| MoCo | ResNet-50 | 24M | 60.6 | — |
| PIRL | ResNet-50 | 24M | 63.6 | — |
| CPC v2 | ResNet-50 | 24M | 63.8 | 85.3 |
| SimCLR | ResNet-50 | 24M | 69.3 | 89.0 |
| CMC | ResNet-50(2×) | 188M | 68.4 | 88.2 |
| MoCo | ResNet-50(4×) | 375M | 68.6 | — |
| CPC v2 | ResNet-161 | 305M | 71.5 | 90.1 |
| SimCLR | ResNet-50(2×) | 94M | 74.2 | 92.0 |
| SimCLR | ResNet-50(4×) | 375M | 76.5 | 93.2 |
表要分两段读。前五行是同一张 24M 参数的 ResNet-50 上的比较,SimCLR 的 69.3 比 MoCo 的 60.6 高出将近 9 个百分点,这一段是方法本身的差距。后半段的参数量从 94M 一路到 375M,拿 375M 的 SimCLR 去比 24M 的 MoCo 并不成立。摘要里那句“与监督 ResNet-50 持平”,指的是 4× 这一行——375M 参数的模型追上了同样架构、用全部标签监督训练的 ResNet-50。3
Table 7 是半监督,只用 1% 或 10% 的标签微调,1% 大约相当于每类 12.8 张图:3
| 方法 | 架构 | 1% 标签 top-5 | 10% 标签 top-5 |
|---|---|---|---|
| 监督基线 | ResNet-50 | 48.4 | 80.4 |
| PIRL | ResNet-50 | 57.2 | 83.8 |
| SimCLR | ResNet-50 | 75.5 | 87.8 |
| SimCLR | ResNet-50(2×) | 83.0 | 91.2 |
| SimCLR | ResNet-50(4×) | 85.8 | 92.6 |
表里还有一组用标签传播技巧的半监督方法(FixMatch、UDA 一类),论文把它们与只做表示学习的这一组分开列,两组的方法前提不同,读数时要各归各段。1% 标签那一列,4× 的 85.8 对监督基线的 48.4,是摘要里“同样的准确率,标签少 100 倍”这句说法的来源。
Table 8 是迁移,12 个自然图像数据集、ResNet-50(4×)、ImageNet 预训练。微调之后,SimCLR 在 5 个数据集上显著优于监督基线,在 2 个上落后(Pets 77.8 对 78.8、Flowers 94.1 对 94.2),其余 5 个统计上持平。冻结特征做线性评测时的差距更明显:Birdsnap 48.4 对 56.4、Cars 60.0 对 68.8、Aircraft 61.2 对 63.8。3 论文的说法是“在 12 个数据集中的 10 个上与强监督基线持平或更好”,这句话对应的是微调那一栏,把它读成全面胜出会失真。
模型的规模效应在 Figure 7:深度和宽度增加,线性评测都变好;而随着模型变大,无监督表示与监督模型之间的差距在收窄。监督模型自己也随容量上升,两条曲线并未交叉——无监督缩小了差距,但没有反超同等容量下的监督训练。3
批量与训练轮数的权衡在 Figure 9 和附录 Table B.1 里。100 轮时,批量越大优势越明显:批量 256 得到 57.5,批量 4096 得到 64.6。训练拉长之后差距收窄:批量 256 跑 800 轮升到 66.6,批量 4096 跑 800 轮是 68.9。批量到 8192 附近收益饱和(100 轮 64.8、800 轮 69.0),继续加长训练却仍然显著提升,附录里最长跑到 3200 轮。3
这也回答了“更大批量是不是关键”这个问题:更多负样本和更多训练步数在许多情况下可以互相替代,大批量买到的是收敛速度。
局限:哪些结论不能从这里推出来
第一处约束在负样本的来源。既然负样本取自同一个 batch,想加多就要更大的批量,而批量受显存与加速器数量限制。论文的默认批量 4096、最大测到 8192,这不是实现细节,而是方法设计的一部分:不要记忆库的另一面,是把字典交给批量。3
第二处约束在增强策略。默认的随机裁剪、颜色抖动、高斯模糊都是为自然图像设计的,扩大增强集合(再加 Sobel 滤波、均衡化与曝光、运动模糊)只带来 0.2 到 0.7 个百分点的提升,说明结果对策略的选择很敏感。论文只在图像上验证,语音、文本、医学影像都留给了后来的人。3
第三处约束在训练量。与其它方法对比的那批数字用 1000 轮,附录里 3200 轮仍在提升。所以“简单”说的是架构与损失函数,资源账另算。
第四处约束在迁移。12 个数据集里微调后 5 胜 2 负 5 平,冻结特征做线性评测时在 Birdsnap、Cars、Aircraft 上明显落后于监督基线。少标签场景的收益最确定,通用性上的收益要按数据集分别看。
第五处是解释。为什么这类方法有效,论文在第 7 节引用 Tschannen 等人的分析承认,成功是由互信息决定还是由对比损失的具体形式决定,当时并不清楚。3 这套方法有一条工程上可用的配方,理论上的说法则还没有定型。
影响与延伸阅读:同一个接口的四次改写
SimCLR 之后的几年,这条线上的工作几乎都围绕同一个接口动手:负样本字典从哪里来,以及它要不要存在。
MoCo 把字典交给队列。它把对比学习看成字典查询,用队列保存历史样本的特征、用动量编码器保持特征一致,于是用一个不大的批量也能维持大字典;论文报告微调后的表示可以超过监督预训练,在 PASCAL VOC、COCO 等 7 个检测与分割任务上如此。5
BYOL 干脆把负样本去掉。它用在线网络预测目标网络对同一张图另一个视图的表示,目标网络是在线网络的慢速移动平均;论文摘要明确写“当前最先进的方法依赖负样本,BYOL 在不用负样本的情况下达到新的最好水平”,标准 ResNet-50 的线性评测是 74.3%,更大的 ResNet 是 79.6%。6 74.3% 高于 SimCLR 在 Table 6 里对同一个 ResNet-50 报告的 69.3%;两篇论文的训练预算没有逐项对齐,这里只并列报告数字。
SimCLR 自己的续篇改的是流程。SimCLR v2 把模型放大、把投影头加深,并在微调之后用无标签数据做蒸馏;只用 1% 的 ImageNet 标签,ResNet-50 得到 73.9% top-1,10% 标签得到 77.5%,超过用全部标签的常规监督训练。7 到这一步,“预训练 + 微调”被写成了一个三段式的半监督流程。
CLIP 换掉的是“第二个视图”。它用 4 亿对图文数据训练模型判断哪句描述配哪张图,把语言当作监督信号;摘要报告零样本的 ImageNet 准确率追平原版 ResNet-50。8
往回看,这套框架的起点更早:2006 年让表示对小变换保持一致的想法,2018 年 InfoNCE 与负采样把目标变得可算,2020 年 SimCLR 系统地把每个组件量了一遍。改掉的是接口,留下的是方法:用增强定义任务、用大批量或队列提供负样本、用线性评测衡量表示、用少标签微调验证标签效率。
读完论文留下四个思考维度
第一,任务由谁定义。SimCLR 把任务从网络结构搬到数据增强上,于是“选哪种增强、强度多大”从预处理细节变成方法的核心。读到任何自监督工作,都可以先问它的任务是由什么定义的,以及这个定义会不会留下捷径。
第二,代理指标与目标要分开看。对比任务准确率 92% 可以配线性评测 57%,单种增强做准了也可以只值 30 出头。看到论文报告任务精度时,去表里找下游任务的数字,两个数字之间的落差往往就是捷径的位置。
第三,把“简单”连资源一起读。没有专门的架构、没有记忆库,代价是 4096 的默认批量、上千轮的训练和上百个加速器核心。判断一套方法能不能用在你的机器上,看的是资源账,不是摘要里的形容词。
第四,标签效率的比较要在同一坐标系里。1% 标签的 85.8% 是 top-5,对应同一行的 top-1 是 75.5%;24M 参数的结果与 375M 参数的结果分开列。同一张表里把口径和容量对齐,得到的结论才成立。
References
- 1arXiv 摘要页给出的作者、机构与提交日期
arxiv.org
- 2ICML 2020 正式出处:PMLR 119:1597–1607
proceedings.mlr.press
- 3原论文第 2.2 节与附录 B 的训练配置
ar5iv.labs.arxiv.org
- 4对比预测编码 CPC 摘要页
arxiv.org
- 5MoCo 摘要页
arxiv.org
- 6BYOL 摘要页
arxiv.org
- 7SimCLR v2 摘要页
arxiv.org
- 8CLIP 摘要页
arxiv.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.