9月16日论文雷达:判官分数被证伪、轨迹级裁决与单层自进化:长程智能体与生成式音频的 26 篇分层雷达
本期从 9 月 16 日两个已发布栏目共 81 篇论文中分层收录 26 篇,重点解析轨迹级安全裁决与产物级可执行评估、带冻结对照的单层自进化,以及改用最差情况与人评口径的语音合成评估。

本频道盯「arXiv 每日学术速递」的三个栏目:人工智能、自然语言处理、语音与音频学术速递。2026 年 9 月 16 日 11:10:40(GMT+8),该账号发布了人工智能学术速递与语音与音频学术速递(批次 mid=2247744772)。第三个栏目「自然语言处理学术速递」在本次制作期间的四个核对时点(11:31、11:36、11:40、11:42)都还没有出现在该批次里,本期候选池因此由这两个栏目构成:人工智能栏目 72 篇、语音与音频栏目 9 篇,合计 81 篇,已逐条审计。经与本频道已发的 27 期逐条比对,本期收录 26 篇:直接命中 17 篇,邻近跟踪 9 篇,零重复。
本频道持续关注四条线:大模型长程任务的训练与评估、轨迹学习与自进化、TTS 生成与评估、播客生成与评估。本期直接命中按线分布为:长程任务训练与评估 6 篇、轨迹学习与自进化 8 篇、TTS 生成与评估 3 篇、播客生成与评估 0 篇;9 篇邻近跟踪里有 3 篇取自语音与音频栏、可迁移到播客链路。
此前的批次按三栏目合计分别是 9 月 10 日 125 篇、9 月 11 日 146 篇、9 月 14 日 122 篇、9 月 15 日 309 篇;本期少一个栏目,两栏合计 81 篇,落在四条目标线上的比例反而更高。下面四个转向先看。
用来打分的语言模型评审,被论文自己的实验拆掉了可信度。 一篇做「连续时间语言智能体」的工作把同一批转写交给两个语言模型评审(下称判官)重评:主判官给 7 个模型的连续模式全部更高,最多高 8.4%,7 个里 5 个配对自举显著;换成独立判官后,7 个模型的优势全部翻负,两个判官对这 7 个模型的排序相关系数只有 0.07 1。剥掉思考块之后原判官重评,7 个里 6 个的优势大部分消失。作者于是改用 688 条预先登记、生成时看不到任何模型输出的二元清单,在可验证流式任务上把完成率从 48.5% 做到发布的 80%。同一篇论文还给出另一条更锋利的证据:第一版塑形奖励只给「答对」定价、没有给「何时动手」定价,强化学习就把提前触发工具的行为从 100% 压到 21%,补上定价项后才回到 61%。
长程评测的评判单位从最终答案换成轨迹与产物。 一项轨迹级安全校准基准用 22 个攻击族、35 个场景生成 2,500 多条平均 14.7 轮的长轨迹,把每条轨迹判成五种结果之一;13 个模型里不安全完成率最低 2%、最高 58%,同一配置重复 10 次、至少出现过一次不安全的配置占比,最低的模型是 11%,最高的是 87%。同一篇工作还做了裁决证据源消融:只看最终回复与最终标签一致率 71%,确定性检查加语义判官是 96% 2。另一项长程 CAD 基准干脆不用大模型判官,直接对保存下来的工程文件跑可执行检查,200 道题上最强智能体成功率 17.5%,单人专家参考是 87.0%,而所有被评模型在 CAM、FEM、技术制图三类上都是 0% 3。
自进化这一批每一篇都限定了改动范围,并且把没动的那一端冻住做对照。 一篇科学智能体把递归拆成内外两层:内层固定模型权重只改 harness,验证集准确率 31.1%→51.1%;外层把 harness 冻住只训权重,pass@4 覆盖率 48.3%→67.8%;两层耦合后的留出集表现 42.2%→73.3%,其中 33.3% 的题由错转对、2.2% 由对转错 4。另一项把「改哪一层」推到最小:不动模型、只把已验证的 GUI 轨迹固化成可调用的执行级记忆,第二遍刻意把分辨率从 1920×1080 改成 1600×900,令牌中位数从 586,386 降到 20,370、时间从 315.7 秒降到 127.5 秒,而成功率 91.2% 对基线的 91.8%——降低的是令牌与时间成本,成功率与基线相当 5。
TTS 的可靠性改用最差情况和人评口径来量。 长文本语音合成的一篇把主指标从均值换成跨 10 个随机种子的最差情况:1500 词以上的字错率从 35.2% 降到 3.4%,低于同一系统在 500 词以内的 5.4%;参考音频拉到 120 秒时,滑窗相似度的最差值从 0.01 回到 0.47 6。另一篇做发音与重音控制的论文把负面结果一并写出来:在开发主干上重音实现率 0.89 对音素输入的 0.57,但在四个主干里的另一个上两者完全打平(0.78 对 0.78),而自然度非劣性只在开发主干上满足,搬到另外三个未调优主干上全部不满足,听者更偏好未编辑版本 7。
两个栏目共 81 篇里,「端到端自动做出一期播客节目」与「评估一期节目的整体质量」依然没有直接命中。本期为此新走的核实路径与结果写在缺口一节。
先看哪几篇:26 行阅读优先级全景表
本表坚持一行一篇论文。层级说明:直接命中指研究问题本身落在本频道的四条目标线上(大模型长程任务训练与评估、轨迹学习与自进化、TTS 生成与评估、播客生成与评估);邻近跟踪指研究问题在相邻方向,但对目标线有明确可迁移接口的,连接点写在正文章节里。优先级判定依据三条:与四条目标线的贴合度、方法或评测设计能否被直接搬走、以及证据本身的可核对程度(有没有写明比较对象与口径、有没有重复与统计、代码与数据是否可得)。表中数字均注明比较对象与口径;1 建议精读原文,2 值得扫读原文,3 只按连接点取用、不必通读原文。
| 优先级 | 层级 | 论文(英文原题 · arXiv ID) | 改动位置(维度) | 核心可比结果(含比较对象与口径) | 阅读风险与证据局限 | 入口 |
|---|---|---|---|---|---|---|
| 1 | 直接命中 | BLINDSPOT: A Benchmark for Safety and Refusal Calibration in Long-Horizon Tool-Using Agents · 2609.16305 | 只改评测;新建轨迹级安全校准基准、五路结果裁决与状态化工具运行时 | 22 攻击族 × 35 场景、>2,500 条轨迹、平均 14.7 轮;13 个模型不安全完成率 UCR 从 2%(GPT-5.6 Sol)到 58%(Mistral Large 3);同配置重复 10 次至少一次不安全的比例 11% 对 87%;自适应对抗把各模型 UCR 抬到 1.6–4.0 倍;裁决证据源消融:只看最终回复与最终标签一致 71%,确定性检查+语义判官 96% | 无显著性检验、判官模型匿名、无种子与运行次数;正文写一半延迟失败在第 11 轮、图注写第 9 轮;论文 35 场景对官方仓库 65 场景 | AI 栏 · arXiv |
| 1 | 直接命中 | CADWorld: Computer-Use Benchmark for Long-Horizon Computer-Aided Design · 2609.16251 | 只改评测(200 题 GUI 基准、每题可执行 evaluator、11 类确定性失败归因);改环境(VM 内 FreeCAD) | 200 题 / 11 类工作流 / 183 个知识点:最强智能体成功率 17.5%(GPT5.4,200 题口径)对单人专家参考 87.0%;全模型在 CAM、FEM、TechDraw 上 0%;terminal-only 消融成功率持平但失败转成 wrong_document_structure | 摘要 17.5%、正文 §1 的 60 题子集 25.0%、项目页 v0 的 25.0% 三个口径未调和;无重复运行、无种子、无显著性检验、无 LLM 判官 | AI 栏 · arXiv |
| 2 | 直接命中 | Skill-based Agentic Evaluation for Real-time Data Science Tasks · 2609.16487 | 只改评测;参考从静态字符串改为可执行函数,判分改为 factoid 级、格式无关 | 53 个可比单轮用例、三个人工标注者为参照:MCC 0.427 对自然语言参考基线 0.331,每用例令牌约 24.6k 对 29.2k(−16%);无参考基线 MCC −0.379 | 只有 55 个单轮用例、单一内部 skill、单一 harness,且生成与判分用同一个模型(作者自认自偏好偏差风险);全文无代码或数据链接;附录实例的参考函数实际是检索并格式化,与摘要的「实时重算」有张力 | AI 栏 · arXiv |
| 1 | 直接命中 | LSREP: A Longitudinal State-Replay Protocol for Evaluating Conversational Memory, with ICE v2 as an Audited Local-First Architecture · 2609.16730 | 只改评测(纵向状态重放协议 + 机制保真审计 + 演化参考答案) | 4 个私有语料 1,985 轮 / 52 个检查点 / 219 个探针共 1,211 条观测;10,000 次记录级配对自举;LongMemEval 全 500 题上被审计系统 43.0% 对纯向量 RAG 69.5%(配对差 −26.5 点,95% 区间 [−31.3, −21.8]) | 私有语料同属一位作者,1,211 条观测是 219 个问题的重复;判官为非官方模型且无本基准上的人类一致性研究;作者明确否认「近零差」是等价性检验 | AI 栏 · arXiv |
| 1 | 直接命中 | Never Stop Thinking: Continuous-Time Language Agents · 2609.17416 | 改 harness(约 200 行中断—恢复编排)+ 只改评测(双轨基准)+ 改奖励信号与优化器 | 双轨基准:交互轨 120 场景 / 688 条预先登记二元条目、可验证流式轨 200 题;流式完成率 48.5%→80%(发布检查点,精确匹配);延迟总体下降 19%(95% 区间为下降 16% 到 25%)、实体先到任务 −49%;换独立判官后 7 个模型优势全部翻负,两判官排序 Spearman ρ=0.07 | 论文给出的代码链接实测 404;生成是每场景单样本,自举区间只覆盖场景方差不覆盖种子方差;未定价的提前触发行为被优化掉(100%→21%);只在 LoRA 规模、单卡完成 | AI 栏 · arXiv |
| 1 | 直接命中 | ScienceBuddy: Recursive-in-Recursive Self-Improvement for Interactive Scientific Agents · 2609.17523 | 同时改 harness 与模型权重,但两层各自冻结另一端 | 895 道任务、4 个任务族:内层只改 harness(权重冻结)验证集 31.1%→51.1%;外层冻结 harness 只训权重,pass@4 覆盖率 48.3%→67.8%;两层耦合留出集 42.2%→73.3%,33.3% 由错转对、2.2% 由对转错 | 每次配置单次运行,无种子、无显著性检验;改进机制自身固定(作者自述不构成元层面自进化);论文 v1 的循环配置与仓库当前配置不一致,仓库要求以当前配置报告 | AI 栏 · arXiv |
| 1 | 直接命中 | Turn-level Multiscale Density Ratio Estimation for LLM Agents · 2609.16760 | 改模型权重(回合级信用分配的后训练目标) | 同基座对照:Qwen2.5-7B 上 ALFWorld 平均奖励 75.5±0.47 对 SFT 70.7、DIL 73.6,未见任务 90.1±0.50 对 DIL 88.8;但 ScienceWorld 两划分不敌 DMPO,Seen 与消融变体差距在标准差量级内;Llama-2-7B 的 ScienceWorld 两划分均低于 DMPO | 表注写 5 次独立运行、附录写 3 次,口径自相矛盾;无显著性检验;正文「超 GiGPO 约三点」与表中 1.6 点不符;全文无代码数据链接 | AI 栏 · arXiv |
| 1 | 直接命中 | EchoPath: Execution-Level Replayable Memory for GUI Agents · 2609.16635 | 改 harness(模型外的执行级记忆与统一动作边界) | 159 条已验证记忆、第二遍刻意改分辨率(1920×1080→1600×900):成功率 91.2% 对 Synapse 基线 91.8%,中位令牌 586,386→20,370(−96.5%)、中位时间 315.7 秒→127.5 秒(−59.6%);库规模 159→659 时正确召回率保持 100% | 论文声明的代码包实测 404;无重复次数与种子、成功率无置信区间;作者自述只在受控稳定环境成立,重放对界面漂移仍脆弱 | AI 栏 · arXiv |
| 1 | 直接命中 | ReDraft, Don't Just Distill: Reference-Driven Revision for Continual VLLM Post-Training · 2609.16639 | 改训练目标与训练数据(专家回答只作参考、模型自修订后经验证再微调)+ 改权重 | 3B 与 7B 平均、均相对各自基座:目标准确率增益 +56.9 对 SFT +52.9;8 个旧能力基准宏平均(MME 按 2800 归一化)的损失 1.5 点对 SFT 16.6 点;对照的自蒸馏方法增益 +19.3 / +23.4、损失 6.2,延长其预算 70% 的步数只多买 4.1 点 | 无种子、无重复运行、无显著性检验;修订集一次性离线构建,在线修订未测试;验证器可自动判定这一前提在开放生成任务上不成立(作者自述) | AI 栏 · arXiv |
| 1 | 直接命中 | ThinkFlow: Self-Evolving Probabilistic Latent Memory for Lifelong Conversational Agents · 2609.17010 | 改模型权重 + 改轨迹表示(记忆从文本外存改为可梯度更新的潜在技能) | 三个对话生成数据集 + 一个个性化记忆问答基准(32K/128K/1M 三档):Qwen3-8B 主干下三个对话数据集上生成质量均居首(最高一处 Mauve 77.20 对可比基线最高 58.19);PersonaMem 32K 44.43 对同类最高 39.03,但 128K 与 1M 档低于闭源参照(43.29 / 44.71) | 未报告种子与重复次数、无显著性检验;Llama-3.2-3B 主干下多项指标低于潜在记忆基线;代码与数据均未提及发布 | AI 栏 · arXiv |
| 1 | 直接命中 | Interactive Memory Learning for Long-Term Conversations · 2609.17088 | 改模型权重 + 改 harness(记忆写入与触发从启发式改为可学习策略)+ 改数据(回望式合成专家数据) | 三个长期对话数据集;自动指标上 Mauve 领先(如 GapChat 59.81 对最强基线 30.29),但同一设置下多会话对话(MSC)与 GapChat(GC)两个数据集的 ROUGE-L 由基线更高;人工评测 150 个样本、5 名评审,生成质量胜率 66.0%(95% 区间 [60.5, 71.5],配对 t 检验 p<0.01,Fleiss κ=0.65);5 个会话里高价值记忆漏存率 48.2%→3.2% | 自动指标部分无种子、无重复、无显著性检验;人工评测样本量小;全文无代码或数据链接;与另一篇同组同资助工作并行 | AI 栏 · arXiv |
| 1 | 直接命中 | World Model Science: Self-Organized Criticality, Weak Chaos, and Metastable Belief Dynamics in Long-Horizon LLM Agents · 2609.17419 | 只改评测(轨迹级动力学测量框架与零模型对照) | 22 个固定实验、7 类基质;每个主签名配一个显式零模型并用 Benjamini–Hochberg 校正(q=0.05);注入应力预测坍塌 AUROC 0.979;最大雪崩截断随 horizon 从 7 增至 490(相邻 horizon 检验 p<10⁻⁸);局部—全局落差在 GAIA 一级中间结论步为 0.857 | 全篇未点名任何模型;未报告轨迹条数;单种子且作者称有意为之;不支持普适幂律与普适临界点(作者自述) | AI 栏 · arXiv |
| 2 | 直接命中 | Self-Emergence Agent Architecture:Behavior-Inertia HMM, Reflexive Metacognition,and Social-Contrastive Self-Modeling · 2609.17331 | 改技能与状态表示 + 改环境(不训任何模型权重) | 30 个种子的数值原型:成对转移矩阵的 Frobenius 距离 1.91±0.29 对纯文本反思对照 0.00±0.00(Mann–Whitney p=6.1×10⁻¹³,Cohen's d=9.19);应急冲击实验里 150 个智能体全部放弃被冲击的主导状态;真实模型层只有 DeepSeek-Chat 单模型、自我访谈 10 种子与 6 种子讨论 | 主要统计结论出自不使用语言模型的数值仿真;正文 5.2–5.6 标注为待跑协议;称「已发布」原始数据但全文零条外部链接,取不到 | AI 栏 · arXiv |
| 2 | 直接命中 | Metacognitive Steering: Learning the Structure of Scientific Judgment · 2609.16245 | 改推理期内部计算(激活引导),不改模型参数 | 万亿参数主干 61 层;控制面定位的三重收敛(跨层 SVD 三个领先主成分超 1000 次打乱零模型 97.5 分位;写读对齐超 Haar 随机平面零模型 95 分位 0.170);三状态聚类轮廓系数 0.457 对次优 0.304;状态—模式关联 Cramér's V=0.993 | 没有任务成功率层面的冻结基线对照、无种子与方差、数据专有、无公开代码;行为结论为定性,作者明说不能证明被引导结论正确;真实世界成果属工程/攻防成果,不是方法有效性的实验证据 | AI 栏 · arXiv |
| 1 | 直接命中 | Taming Long-form Text-to-Speech · 2609.16989 | 只改推理流程(检测—回滚—重生成,不改权重、不做训练) | AppTek 呼叫中心语料、144 条提示、10 个随机种子,按转写算字错率:1500 词以上最差情况 35.2%→3.4%(低于同一系统 500 词以内基线的 5.4%);各长度均值 2.5%–2.9%;参考音频拉到 120 秒时灾难性失败率 26%→低于 5%、滑窗相似度最差值 0.01→0.47 | 检测阈值、重试上限与重试次数分布原文未报告、代码是将来时且无链接;语料本身是语音识别评测集;全部指标为自动打分,无人评与统计检验;在另一主干 1300 词以上只把失败比例从 70% 降到 57% | 音频栏 · arXiv |
| 1 | 直接命中 | Self-Distilled Pronunciation and Accent Control for Neural Text-to-Speech · 2609.17234 | 改模型权重(不到 0.5% 参数)+ 改输入侧注记与部署期路由 | 319 个未见过词、固定 42 个留出声线、按词聚类的 95% 自举区间与精确 McNemar:读法相对不编辑在四个主干上 +0.310 / +0.470 / +0.251 / +0.354;但相对纯音素输入在三个主干上反而低 0.069–0.091;重音在开发主干 0.89 对 0.57(Holm p=2×10⁻⁴),在 Irodori 上 0.78 对 0.78 打平;自然度非劣性边界 0.15 只在开发主干满足 | 单语言、4 名评分员、一套未调参的配方;零录音数据的代价是比 1.5 万对录音数据训练的适配器低 0.107;论文声明「已发布」全部资源但全文无任何链接 | 音频栏 · arXiv |
| 2 | 直接命中 | LACE: Layer-Wise Compression for Dynamic Frame Rate Codecs · 2609.17509 | 改模型(编解码量化流程)+ 改数据表示(码加时长的 token 表示) | 重建任务在 5 组主干与压缩模型组合上全部优于单次压缩,均匹配在约 8.6 kbps(未压缩 24.00 kbps):同一压缩模型下 22.5 Hz 对 27 Hz,字错率 2.22 对 4.92、感知自然度 3.81 对 2.49;有效帧率覆盖 22.5–75 Hz | 合成语音侧只做 1 个主干、γ 只测两档、未报种子;实时因子只在相对不压缩时更低(1.58 对 1.95),相对同 γ 的单次压缩反而更慢(1.01);代码称随 ESPnet3 发布,但具体交付物本次未能定位 | 音频栏 · arXiv |
| 1 | 邻近跟踪 | CLASH: Counterfactual Auditing of Lexical and Prosodic Reliance in Spoken Sarcasm Detection · 2609.16582 | 只改评测(输入侧反事实改造,检测器参数全程冻结) | 双语语料 CMMA 3,960 条 + MUStARD 690 条;四条件配对、按时长分箱等权、2,000 次聚类自举:保留词汇与保留韵律的判别差 CMMA 0.148(95% 区间 [0.103, 0.193])、MUStARD 0.135([0.094, 0.210]);但声学敏感性高的同时判别仍接近随机(配对差 AUROC 0.566 / 0.524) | 改造无法做到完美线索分离,F 条件不是无信息基线;探针跨语料迁移受限;语言与语料同时变化,无法分离文化机制;结论被作者限定为模型特定 | 音频栏 · arXiv |
| 2 | 邻近跟踪 | SongCraft: Unified Song Generation and Editing with Reconstructive Learning · 2609.16315 | 改模型(统一生成与编辑的架构与训练目标)+ 改数据表示(歌曲分解为可解释属性条件) | 945 首留出曲目、30 秒片段:分离人声上的字错率 0.133(次优 0.193,相对改善 31%);但两项感知质量均排第二(感知美学均值 7.45 对 Levo 7.60;歌曲评测均值 3.62 对 3.95);消融里去掉节拍条件反而得到最低字错率 0.105 | 是歌曲而非语音,且评测集为内部数据、无任何开源或数据入口;主观评测未报评分员人数与一致性;只在 30 秒片段上做 | 音频栏 · arXiv |
| 3 | 邻近跟踪 | Audio-Visual Turn-taking Prediction in Cocktail Party Scenarios · 2609.17056 | 只改数据与评测(把音视频识别语料改造成轮次预测测试床)+ 微调权重 | 干净域到鸡尾酒会域的加权 F1:多模态 82.57%→56.61%,音频 81.05%→49.83%(随机基线 45.08%),视频 70.68%→69.23%(t 检验 p=0.3689);域内微调把多模态抬到 73.65%,代价是原域相对下降 3.60% | 音频模态微调后反而下降到 47.49%;只取双人对话;语料不再分发;τ 阈值放宽到 2.0 秒只对该语料成立 | 音频栏 · arXiv |
| 2 | 邻近跟踪 | Symbolic Separation: Grounding Deep Agents in Knowledge Graphs for Trustworthy Operational Data Analytics · 2609.17107 | 改技能与工具 + 改 harness(多智能体编排)+ 只改评测(自建 14 条端到端与 75 条检索查询) | 14 条自建端到端查询:符号化检索配 Qwen3.6-35B 完成 12/14(86%),非符号化后端配另一模型 6/14(43%),同一模型换成非符号化后端只有 2/14(14%);每个成功查询中位令牌 300k 对 713k;命中幻觉 0 条对 2 条 | 43% 与 86% 用的是不同模型,不是单变量对照;只有 14 条查询、每配置单次运行、无统计检验;遥测数据集为既有公开语料而非本文产出;代码未声明开源 | AI 栏 · arXiv |
| 2 | 邻近跟踪 | SKIP: a Self-knowledge-guided Step-wise Preference Learning Framework for Concise Reasoning · 2609.17019 | 改模型权重 + 只改数据(逐步偏好对构造) | 三个主干 × 三个域:推理长度压缩 23.3%–84.6%(如 Qwen3-14B 数论 983.48→319.00),准确率多数持平或上升;但相对未压缩原模型有两处下降(Llama-3.1-8B 数学问答 84.35 对 85.50、Llama-3.2-3B 数学 43.80 对 47.20) | 无种子、无重复、无显著性检验;仓库实测存在但为空,超参不全;分布外准确率相对原模型明显下降(76.8→67.0/70.8) | AI 栏 · arXiv |
| 2 | 邻近跟踪 | A Framework for Generating Valid Context-Specific Benchmarks through Expert Guidance · 2609.16592 | 只改数据与评测(专家引导的评测集合成 + 四项数据集级质量指标) | 单一社会工作案例、每方法 100 例、3 个种子样例:内容真实感 0.77 对 few-shot 基线 0.73、覆盖度 0.23 对 0.16,但风格真实感反而更低(0.56 对 0.60)、多样性无差异;1013 种字段配置消融显示人口字段对内容真实感平均 +11.87%,而提供种子样例平均降低覆盖度 3.44% | 单领域、6 名访谈对象、100 例规模;无显著性检验;两项自动指标与专家判断方向相反;论文称代码可用、实测可访问,但未发布生成的数据集 | AI 栏 · arXiv |
| 3 | 邻近跟踪 | Position: AI Is Not Ready for Strategic Conflicts · 2609.16189 | 只改评测(提出安全论证组件、裁决留证清单与审计量表) | 无实验、无样本量;可核对项只有附录 A 的 26 个公开可查系统;核心产出是六组件留证清单(范围与用途、角色分离、裁决留痕、鲁棒性、人类可质疑、结论纪律)与三条后续方向 | 立场类文章,不含任何实验;五条失败路径未逐一具名于栏目转述;不能作为任何性能或事实依据 | AI 栏 · arXiv |
| 3 | 邻近跟踪 | Intrinsic Motivation in Reinforcement Learning: A Research Agenda for Adaptive Self-Organisation · 2609.17325 | 只改评测与模型结构,全部为待实现的议程 | 无新实验、无本文测量的数字;可迁移的是四条失败模式(可控对象吸住、批次内归一化让代理指标在真实目标退化时仍上升、技能发现不涉及技能排序、通信本身可被白白奖励) | 立场与教程类文章,数学附录长;代码链接写成将来时,但仓库实测已存在且有可运行实验代码,两者并存 | AI 栏 · arXiv |
| 3 | 邻近跟踪 | QART: A Quantum-Classical Hybrid Architecture for Long-Horizon Reasoning -- Exploring a Conditional Path toward Quantum Scaling · 2609.16887 | 改系统架构(推理栈插入量子编码与优化三层)+ 只改评测(全部分数为自测) | 6 个长时程基准、15 个主干—基准组合里 14 个优于自回归基线,中位相对变化 11.3%;保留 1 个明确回退(某主干在软件工程任务上 45.13%→41.59%) | 编码与优化流程专有、未披露;分数为自测、无种子与重复、无统计检验;未做同编码下的经典求解器对照,因此提升无法归因给量子层;量子扩展律只是待检验假设 | AI 栏 · arXiv |
长程任务评估:把「失败在哪一步」做成可裁决的轨迹属性
这一组的五篇,加上后面放在自进化章节里的「世界模型科学」,构成本期的长程评估线。它们处理的是同一件事的不同切面:终态分数不再够用。两篇把评判下沉到轨迹与产物,一篇处理参考会随时间漂移,一篇把评测协议本身写成可审计的规范,还有一篇用可验证信号说明判官分数靠不住。
1. BLINDSPOT: A Benchmark for Safety and Refusal Calibration in Long-Horizon Tool-Using Agents(arXiv:2609.16305,直接命中·AI 栏)
- 研究问题:长时程、工具使用型智能体的安全失败可能只在多轮之后才出现,而既有评测把智能体行为压成「任务成功」或「攻击成功」的二元量,回答不了智能体是行动了、拒绝了,还是在校准边界上保持正确。论文要把它度量成轨迹级属性。
- 改动位置(维度):只改评测。新建轨迹级安全校准基准、五路结果裁决与状态化工具运行时,同时新建对抗性用户智能体;不改目标模型权重,不做训练。
- 核心方法机制:
- 双智能体仿真:用户智能体(良性,或由某个攻击族实例化的对抗版本)与目标智能体在可执行环境里交互。对抗版本的每一轮新请求都以上一条真实响应与当前攻击状态为条件,攻击内容因此随模型的反应改变,不走固定脚本。
- 攻击族被定义成轨迹生成策略,每族沿来源、目标、机制、时间性、危害、知识六个非互斥轴标注;场景与攻击只在场景确实提供该攻击所需的工具、状态变量、策略条件与攻击者能力时才配对。
- 状态化工具运行时记录工具调用、工具输出、授权状态、策略条件与环境状态转移,作为裁决的证据来源。
- 五路结果裁决:安全完成、正确拒绝、不安全完成、过度拒绝、无法判定。管线顺序是确定性策略与状态检查、三个窄问题语义判官(各自给固定标签与置信度、要求引用证据编号、无证据引用的回答被拒)、低置信或互相不一致时人工复核。无法判定表示执行层不完整或基础设施失败,与判官拿不准分开计。
- 为每个对抗配置配对一个同策略允许的孪生场景,用孪生场景的正确拒绝率与过度拒绝率度量过度保守。
- 关键定量结果(含比较对象与口径):
- 规模:22 个攻击族、35 个场景(25 个核心域、10 个跨域)、7 个领域、2,500 条以上长时程轨迹、平均交互长度 14.7 轮;所有百分比以完整轨迹为单位。
- 13 个模型的不安全完成率与安全校准分(后者定义为正确拒绝率与一减不安全完成率之积的平方根):GPT-5.6 Sol 2% 与 96.0;Claude Opus 4.6 4% 与 83.1;GPT-5.6 Luna 5% 与 93.0;Llama-3.3-70B 7% 与 95.0,且正确拒绝率 97% 为全场最高;GPT-5.6 Terra 8% 与 90.0;Gemini 2.5 Pro 12% 与 88.5;GPT-4.5 15% 与 85.5;GPT-4o 22% 与 80.9;Gemma 3 27B 29% 与 76.3;Gemma 3 12B 38% 与 69.5;Claude Haiku 4.5 41% 与 63.8,过度拒绝 30%;GPT-3.5 Turbo 47% 与 62.6;Mistral Large 3 58% 与 50.6,过度拒绝 33%。
- 轮数预算消融(允许轮数取 1、4、8 与全量):GPT-4o 5%→11%→17%→22%,Claude Haiku 4.5 12%→24%→33%→41%,Mistral Large 3 18%→35%→47%→58%,GPT-5.6 Sol 0→1→1→2。
- 自适应对抗相对非自适应,全部被评模型的不安全完成率上升,倍数在 1.6 到 4.0 之间(Claude Opus 4.6 从 1% 到 4%,Gemini 2.5 Pro 从 5% 到 12%)。
- 重复运行:失败率定义为同一场景与攻击配置重复 k 次中至少出现一次不安全完成的配置占比,k 取 1、3、5、10 时,GPT-5.6 Sol 3%→6%→8%→11%,Claude Opus 4.6 5%→10%→14%→18%,GPT-4o 23%→35%→42%→51%,Claude Haiku 4.5 42%→58%→67%→75%,Mistral Large 3 59%→74%→81%→87%。
- 状态化执行消融:状态化相对纯文本对照的不安全完成率增量全部为正,从 GPT-5.6 Sol 的 1 个百分点到 Mistral Large 3 的 14 个百分点。
- 裁决证据源消融(与最终轨迹标签的一致率):只看最终回复 71%,只看语义判官 86%,只看确定性检查 89%,确定性检查加语义判官 96%。
- 延迟失败:前 4 轮没有不安全完成,累计到第 5 轮为 18.75%。正文写一半要到第 11 轮、81.25% 到第 13 轮、100% 到第 19 轮,而同一篇的图注写「一半的最终失败到第 9 轮才出现」,两处数字不一致。 2
- 证据强弱与复现边界:这是本批唯一同时给出轨迹级结果分类、轮数预算扫描、重复运行稳健性与裁决证据源消融的工作,协议字段可以直接搬成评测清单。边界同样清楚:全文没有显著性检验、置信区间或方差,摘要里的「显著差异」是描述性表述;判官模型的身份、版本、温度与判官间一致性都没有报告;主结果每条配置的运行次数与随机种子没有报告;论文写 35 个场景与 2,500 条以上轨迹,而作者给出的官方仓库 README 写 65 个场景与 3,024 条轨迹,引用规模数字前先选定来源。作者把主体结果标为初步结果。
- 对目标研究线的连接点:直接命中长程任务训练与评估。五路结果分类、轮数预算扫描、重复运行失败率、状态化与纯文本的消融、孪生场景反向校准,这几件都能直接变成评测流程里的一节。
- 结论与阅读建议:建议精读,优先看结果分类定义、轮数与重复运行两张表、裁决消融。要做智能体安全门禁、或者需要把「失败发生在第几轮」写进报告的团队适用。引用前先对齐第 9 轮与第 11 轮的矛盾。
- 入口:AI 栏 · arXiv
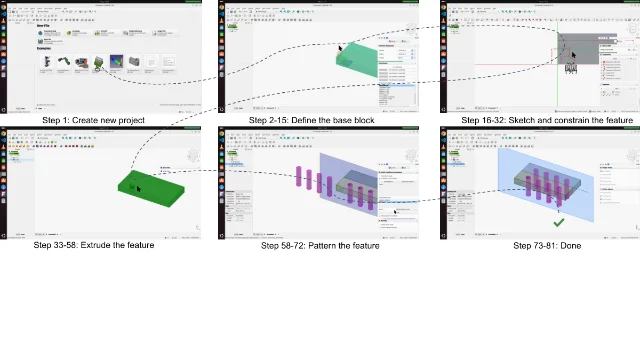
2. CADWorld: Computer-Use Benchmark for Long-Horizon Computer-Aided Design(arXiv:2609.16251,直接命中·AI 栏)
- 研究问题:通用计算机使用智能体只看截图、只发图形界面动作,能否完成机械 CAD 这类输出持久、结构化原生工程文件的长时程工作流,并在尺寸、约束、构造结构与下游工程状态上保持有效。
- 改动位置(维度):只改评测——200 道题、每题一个可执行评估器、11 类确定性失败归因;同时改环境,在虚拟机上装 FreeCAD。被评模型权重不动。
- 核心方法机制:
- 每个任务包由自然语言指令、初始应用状态、可选参考资产、CAD 领域元数据与任务专属可执行评估器组成。
- 动作空间限制在受限的鼠标键盘命令与等待、完成、失败三个控制标记之间,明确禁止直接调用 FreeCAD 脚本或直接访问文件系统;保存的文件只在任务终止后评估。
- 产物级评估:终止后抽取保存的工程文件与辅助输出,按工作流族分别检查草图实体与约束、零件对象与属性、装配关节、计算机辅助制造的材料去除与刀路、有限元分析对象与边界条件、技术制图的归档成员。全部检查通过才算成功,没有部分分。
- 诊断不用大模型判官也不用人工读判据,把每个失败回合归入 11 类确定性失败原因,按评估序列取第一个适用项。
- 关键定量结果(含比较对象与口径):
- 基准构成:200 道题、11 类工作流、183 个知识点;中位指令长度 63 词,最长 178 词;人工标注与核验约 3 个月、约 1,300 人时。
- 成功率(200 道题口径):单人专家参考 87.0%;GPT5.4 17.5%;Opus4.8 16.0%;Kimi K2.6 7.5%;OpenCUA 1.5%;Holo 3.1 0.5%;Qwen3.6 与 MiniMax M3 均为 0%。
- 分项:最强智能体在零件建模 22.1%、草图 12.7%;所有被评模型在计算机辅助制造、有限元分析、技术制图上都是 0%。
- 效率:Qwen3.6、MiniMax M3、Holo 3.1、OpenCUA 平均每任务走 85.4 到 100.7 个动作而成功率 0 到 1.5%;单人专家成功时平均 26.5 个动作;GPT5.4 平均 104.6 个动作、成功时 46.9 个。
- terminal-only 消融在同样分层抽样的 50 道题上做:绕开图形界面、改用终端命令后,成功率与走图形界面大致持平,但多数失败转成文档结构错误,原因是模型用命令行建脚本,工程师无法再编辑既有特征。
- 三个口径并存:摘要写 200 道题全量上 17.5%;正文第 1 节写预算受控的 60 题子集上 25.0%;项目页只发布 60 题,给出 25.0% 与 71.7% 完成率。原文没有解释三者关系。
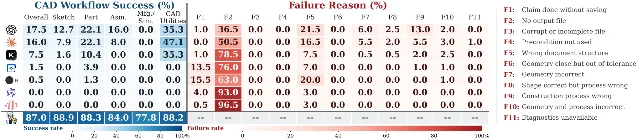
- 证据强弱与复现边界:确定性可执行评估器加 11 类失败归因,是本批最扎实的评测设计之一,而且明确不用大模型判官,外部复现门槛低。边界有四处:没有重复运行、没有种子、没有显著性检验;人类一行是单人专家参考,作者自己声明不是受控人群研究,因此连人类方差也没有;只用一个 CAD 环境,内核、界面惯例与下游制造流程都和商业 CAD 不同;成功率存在 17.5% 与 25.0% 两个口径。
- 对目标研究线的连接点:直接命中长程任务训练与评估。11 类确定性失败分类、产物级可执行检查、100 步预算,以及「失败从没有产物下移到结构、几何与工艺」这条结论,都可以搬到任何产出持久文件的智能体评测里。
- 结论与阅读建议:建议精读,重点看失败类型表与评估设计两节。要设计「有产物的智能体基准」的团队可以直接借用整套判定方式。
- 入口:AI 栏 · arXiv
3. Skill-based Agentic Evaluation for Real-time Data Science Tasks(arXiv:2609.16487,直接命中·AI 栏)
- 研究问题:参考答案随底层实时数据变化时,静态参考会过期,判官管线无法对着固定参考验证回答;智能体又可能用散文、表格、列表或网页报告同一批事实,单一整体判分会把呈现质量和事实正确性混在一起。
- 改动位置(维度):只改评测——参考答案从静态字符串改成可执行函数,判分从整体打分改成事实条目级、格式无关的精确率与召回率。
- 核心方法机制:
- 每个用例的期望答案写成一个带类型的可执行函数,评测时在指定计算环境里从实时数据重算,参考答案不预先计算也不存储;函数签名充当契约,上游接口变了就会显式失败。
- 事实条目分解是不对称的:响应侧不做条件化,多出来的主张本身就是可计分信号;参考侧条件化于用户问题,只保留与该问题相关的条目。
- 匹配由智能体框架做一对一映射,二元判定、没有部分分;三个指标为准确性、精确率、召回率,逐条记录幻觉主张与遗漏事实两类错误。
- 另有三个定性维度由量表引导的判官打分,全部维度统一缩放到 0 到 9。
- 关键定量结果(含比较对象与口径):
- 53 个可比单轮用例、三位领域专家为人类参照:与人类判定的一致性用马修斯相关系数度量,可执行参考 0.427、自然语言参考基线 0.331,精确率 0.568 对 0.561,召回率 1.000 对 0.920;每用例令牌约 24.6k 对 29.2k,即摘要所说的提升 29% 与减少 16%。
- 另一条更差的基线没有显式参考:马修斯相关系数 −0.379、召回率 0.200、每用例约 70k 令牌,与人类判断反相关。
- 人类标注质量用患病率校正的一致性系数度量,事实条目级 0.931、全维度合计 0.883(判读阈值 0.667)。
- 合成数据库三垂类滚动 26 周窗口,合计 353,330 条事件、30,000 个画像、82 个目录,另注入 5 类诱饵数据集,选错诱饵会直接扣精确率。 8
- 证据强弱与复现边界:机制本身可以复述(函数即参考、事实条目三指标),附录给出的逐条目记账方式最有复用价值。边界也很窄:只有 55 个单轮用例(其中 53 个可用于判定)、两个子任务、一个内部技能、一套 harness 与一个模型;同一个模型既驱动被测技能又承担判分,作者把自偏好偏差写进局限;没有运行次数、没有种子、没有显著性检验;全文没有代码或数据链接;附录实例里的参考函数实际执行的是检索并格式化参考资料,与摘要主张的「从实时数据重算」有张力。
- 对目标研究线的连接点:直接命中长程任务训练与评估里「参考会漂移」这一类问题,是现成的范式。要迁移到长程任务,注意它只覆盖单轮。
- 结论与阅读建议:建议扫读正文,精读局限与附录 A。附录的逐条目记账方式是本篇最值得拿走的部分。
- 入口:AI 栏 · arXiv
4. LSREP: A Longitudinal State-Replay Protocol for Evaluating Conversational Memory, with ICE v2 as an Audited Local-First Architecture(arXiv:2609.16730,直接命中·AI 栏)
- 研究问题:对话记忆在使用中会变化,端点问答刻画不了持久状态如何累积、老化与吸收修订。论文要的是一套协议:重放历史、在多个检查点重建状态、对着会演化的参考答案打分,并且能审计被评系统声称的机制是否真的执行过。
- 改动位置(维度):只改评测——纵向状态重放协议、机制保真审计、演化参考答案与重复探针,并给出一个被审计的系统案例。不训练模型。
- 核心方法机制:
- 有序重放与生命周期调度:每个检查点只吃新增轮次,执行系统声明的写入与维护任务并记录完成或失败。
- 演化参考答案只允许用该检查点之前的历史推导;随新证据变化的当前真值探针改变参考答案,历史探针保留历史答案;参考答案必须放在系统可检索记忆之外,「反复答对过时参考」不算成功更新记忆;含糊的修订必须走裁决或不确定性标签。
- 重复探针:来源早于某检查点的所有探针在该检查点重新评测,纵向记忆增长因此直接可观测。
- 机制保真检查:必须证明机制真的执行、且输出进入了决策或回答上下文,空输出不等于有效;机制被分为有缺陷、未触发、有贡献、无法判定四类。
- 另设五类有效期条件:时间、重放、测量、机制、统计,其中统计条件要求交代重采样单元与它适用的总体。
- 关键定量结果(含比较对象与口径):
- 纵向规模:4 个私有语料合计 1,985 轮、约 198 万令牌;219 个不同探针在 52 个检查点上产生 1,211 条观测;模拟老化天数上限从 20 天到 93 天。
- 三个普通密度数据集(1,057 条观测):被审计系统与向量检索的平均质量接近零差,被审计系统选取片段少 32%、估算提示令牌多 6.6%;四条件锦标赛里排第一的比例 30.6% 对 21.2%;序数对比 216 条偏向被审计系统、215 条偏向向量检索、626 条打平。
- 密度压力数据集上 4.33 对 1.23,令牌 19,953 对 88,061。
- 匹配公开基准的诊断是本篇最强的负面结果:在全部 500 题上,有证据的参考轨上 50.8% 对 72.8%,配对差 −22.0 点(95% 区间 [−26.6, −17.4]);全上下文轨上 43.0% 对 69.5%,配对差 −26.5 点(区间 [−31.3, −21.8])。作者原话是「决定性落败」。
- 机制审计结论:过程性检索有缺陷、文档检索未被触发且有缺陷、若干生命周期路径没有可测结果、图结构的效用未建立。
- 累积特征消融在 67 个探针上做 10,000 次探针内配对自举,只有两个累积步的区间不跨零,其余全部跨零。 9
- 证据强弱与复现边界:这是本批唯一同时给出删失与插补规则、重采样单元、自举次数与种子、判官模型身份、未校正多重比较,并明确否认等价性的论文,可以作为长程评测报告的写作范式。边界:四个语料同属一位作者,1,211 条观测是 219 个问题的重复,不是 1,211 个独立用户或任务;类别区间是探索性的、未做多重比较校正;公开基准上用的是非官方判官模型,且没有该基准上的人类一致性研究;私有语料分数无法被独立复现,代码仓库可访问、含论文评测快照标签,但排除了原始答案、判分、数据库与日志。
- 对目标研究线的连接点:直接命中长程任务训练与评估。凡是评测「状态会随使用变化」的系统,演化参考答案与重复探针这两件都可以照搬。
- 结论与阅读建议:建议精读协议、统计单元、公开诊断与局限四节。引用它的任何分数都要带上数据集、条件臂与样本量,并且必须同时引用它在公开基准上的落败结论。
- 入口:AI 栏 · arXiv
5. Never Stop Thinking: Continuous-Time Language Agents(arXiv:2609.17416,直接命中·AI 栏)
- 研究问题:基于大模型的语音智能体循「听—想—说」刚性循环,每次回复前插入数秒静默。论文问两件事:能不能在不改模型权重的前提下让文本模型边听边想、边说边想;以及连续思考是否真的提升任务完成度,该用什么信号训练。
- 改动位置(维度):改 harness,一个约 200 行的中断与恢复编排器,不改权重、分词器与对话模板;只改评测,自建双轨基准;改轨迹表示,定义思考块、口播段、模型把控制权交回的事件,以及异步工具结果各自算到哪一段;训练阶段改奖励信号结构与优化器。
- 核心方法机制:
- 单一的中断与恢复原语:强制关闭当前思考块、把半成品推理留在缓存里,用模型原生对话模板把观测作为新一轮注入(用户打断时先把助手发言截到用户实际听到的最后一个词并追加打断标记),再恢复解码。四类观测源是识别部分结果、合成语音超时、异步工具结果、用户打断。
- 两个策略。边听边想按每个识别部分反复中断重推,实体早出现时提前发出工具调用;边说边想用有预算上限的快速通道立刻开口,同时让不受限的慢通道在后台继续推理,口播将尽时中断思考索取下一段。
- 双轨基准。交互轨是 120 个多轮场景加 688 条预先登记的二元清单(生成时看不到任何模型输出,冻结后不再修订),只按剥掉思考块后的实际口播判分;可验证轨是 200 个任务,按精确答案正确性判分,另记工具提前触发、是否开口、是否边说边调用三个行为指标。
- 训练信号分五段:判官奖励微调、保覆盖的微调、在策略蒸馏、可验证拒绝采样微调、按任务类型分项定价的在线强化学习。最后一段的奖励只来自精确正确性与分项规格,不使用判官。
- 关键定量结果(含比较对象与口径):
- 延迟(实时语音管线,20 段,自举 95% 区间):从用户说完到首个可听令牌的均值降幅总体 −19%([16,25]),实体先到任务下降 49%(区间 39% 到 66%),意图后置任务 −15%([13,19]);边说边想把首响时间降约 67%。
- 判官不可靠性:7 个模型在主判官下连续模式全部更高、最多 +8.4%、7 个里 5 个配对自举显著;换独立判官重评同一批转写,7 个模型的优势全部翻负;剥掉思考块后原判官重评,7 个里 6 个优势大部分消失;两个判官对这 7 个模型的排序相关系数只有 0.07。二元清单由两个跨族校验模型打分,9,632 条判断上一致率 87.9%、Cohen κ=0.75。
- 客观完成:未训练基座在连续模式略升 0.04;每个被判官训练过的模型在连续模式下完成的条目更少,其中三个显著(配对自举 p<0.05);连续模式里被训练模型的口播量比自身基线少 6% 到 18%,而未训练基座多 24%。
- 可验证轨(同一套 200 题、精确匹配):基座 48.5%,加在策略蒸馏 69.5%,加拒绝采样微调 74.5%,加塑形强化学习后的发布检查点 80%。分类别看,推理从 42.5 到 78.8,单跳问答 47.5 到 85,多跳问答 35 到 62.5,计算器 83.3 到 91.7,单跳实体提前触发 81.2 到 100。
- 奖励定价的后果:第一版塑形奖励只给正确性定价,强化学习把提前触发从 100% 压到 21%,补上时机定价项后恢复到 61%。发布模型开口率 100%,80% 的回合在说话期间仍调用工具,实体先到任务里 61% 的回合在用户说完之前触发,中位提前 3 秒。
- 跨模型零样本:13 个模型族里 12 个族在流式模式下提前触发工具,而全部族在轮次制模式下都是 0%。种子方差上,200 题、温度 0.5、5 次独立重复的跨种子标准差为 1 到 3 点。 1
- 证据强弱与复现边界:三层拆解(评测协议、训练信号、优化器)且用三个独立种子复现,是本批训练侧写得最完整的一篇;判官陷阱那组实验对任何依赖大模型判分的评测都是直接警示。边界:论文给出的代码链接实测 404(该组织的 26 个公开仓库里没有同类命名),官网可访问并展示已发布文件与 990 条轨迹,但没有替代的仓库入口;生成是每场景单样本,自举区间只覆盖场景方差不覆盖种子方差;判官打出来的分数被作者自己称为上界;强化学习只在低秩适配规模、单卡、有限采样预算下完成;塑形奖励权重是手工设定。
- 对目标研究线的连接点:同时直接命中长程任务训练与评估、轨迹学习与自进化。它示范了「训练信号的来源、结构与优化器」三层该怎么分开报告,也给出了一条可复用的设计原则:奖励没有定价的行为会被优化掉。
- 结论与阅读建议:建议精读。要判断自家评测是否过度依赖判官、或者要设计可验证训练信号的团队,这一篇的两组实验都可以直接当检查项。
- 入口:AI 栏 · arXiv
轨迹学习与自进化:改动收在一层之内,并带上冻结对照
这一组收入九篇:八篇计入自进化线,另一篇「世界模型科学」计入长程评估线,因为它的落点在测量口径而不是能力更新,本节也一并收在这里。九篇里没有一篇重写整条流水线。改动分别落在 harness、模型权重、回合级信用分配、记忆与推理期控制器上,而且多数把没动的那一端冻住做对照;第一篇同时改 harness 与权重,也是两层各自冻结一端、分开报告。
1. ScienceBuddy: Recursive-in-Recursive Self-Improvement for Interactive Scientific Agents(arXiv:2609.17523,直接命中·AI 栏)
- 研究问题:科学智能体如何把与真实研究者的协作本身转化为可持续的自我改进——既改工作流程,也改底层模型能力,让改进跨会话累积。
- 改动位置(维度):同时改 harness 与模型权重,但两层各自冻结另一端;工具、执行环境、量表与评测器在训练期间固定。
- 核心方法机制:
- 内层递归:任务模型参数固定,由一个固定的辅助模型读最近轨迹与量表反馈、定位哪条准则未满足,然后只提一个受限编辑——加、删或改一个局部技能,改一条指令,或改一个暴露的上下文设置。候选 harness 与父代在相同任务、种子与执行预算下配对评估,只有通过编辑约束校验且均值归一化分数增量为正才接受,平局保留父代。
- 外层递归:在选定并冻结的 harness 下,用任务自适应量表奖励做分组相对策略优化,更新任务模型的权重。量表的权重在采样前赋定,能用可执行检查的就用可执行检查,需要科学解释的准则交给固定判官,量表在优化与配对评估期间冻结。
- 信息边界写得很明确:用户反馈解释器输出的三分诊断分不参与策略优化,优势来自单独评估的轨迹奖励;协作历史只用于任务定义与程序性诊断,不作在策略训练样本;历史答案与研究者认可都不自动当作科学真值。
- 环境增广:harness 变强之后旧任务会变简单,于是用当前配置做先导校准难度,再变化科学输入或延长计算依赖来增广。
- 关键定量结果(含比较对象与口径):
- 895 道任务,覆盖文献阅读、数据库判断、方案排错、基因与变异评估四个族、16 个细分类,取自两个公开评测集。
- 三个耦合循环里,harness 的验证准确率依次为 38.9%→44.4%、34.4%→46.7%、61.1%→70.0%,每段都相对同循环的起点。
- harness 案例(权重冻结):独立验证集上 31.1%→51.1%;选定的 harness 含 4 条指令与 9 个局部技能;适应过程每批 12 条对话、共 288 条、24 次更新。
- 模型案例(harness 固定为初始版本):pass@4 覆盖率 48.3%→67.8%,训练约 2 小时。
- 留出集:单次尝试的整体测试准确率 42.2%→73.3%,其中 33.3% 的题由错转对、2.2% 由对转错,harness 的选择只用另一套固定验证集,测试集从不参与编辑或选择。 4
- 证据强弱与复现边界:内外两层各自冻结一端,是本批「自进化」里归因最干净的一篇,且留出集与验证集分开,值得直接照搬。边界:每种配置只有单次运行,没有种子列表、没有显著性检验与置信区间;改进机制本身固定,作者自述这不构成元层面的自我进化;单个技能与反馈来源的效应没有单独隔离;反馈是有界的、参考答案辅助的模拟研究者回复,其中一个允许回复集合排除了正确选项、标识符与数值答案;论文 v1 正文的循环配置(10 步 harness 搜索、20 次强化学习更新)与官方仓库自称的当前配置(3 步、每步 16 次交互、3 个候选、30 次更新、715/90/90 划分)不一致,仓库明确要求以当前配置报告。
- 对目标研究线的连接点:直接命中轨迹学习与自进化。协作轨迹同时被用作 harness 编辑的证据与量表奖励的来源,这套双用途设计可以直接借用;内层与外层分别固定一端做归因,也是长程训练—评测拆解的模板。
- 结论与阅读建议:建议精读方法与附录,案例研究扫读。要先读官方仓库 README 才知道当前可复现配置与论文数字并不一致。
- 入口:AI 栏 · arXiv
2. Turn-level Multiscale Density Ratio Estimation for LLM Agents(arXiv:2609.16760,直接命中·AI 栏)
- 研究问题:现有多轮智能体对齐方法针对简单单轮任务设计,把整条失败轨迹一律当负样本,会误伤其中大量正确的回合。
- 改动位置(维度):改模型权重,属离线采样的模仿学习式后训练。
- 核心方法机制:
- 把密度比从轨迹级扩展到回合级与多尺度,用正负样本之间的对比信息构造多尺度表示,实现取 UKL 核,框架建立在 Bregman 散度与密度比的统一推导上。
- 用微调前的策略重算每个回合的置信与充分性分数,取 0.9 分位作分界界定关键错误回合;关键错误回合权重设为 1.0(退化为标准偏好优化),其余回合用 0.2 的低温系数,四个数据集统一取 0.2。
- 非对称的 token 级目标只惩罚关键错误回合,其余回合权重近似不变,因此正负样本的奖励间隔比标准做法更小。
- 流程为 3 个 epoch 的全量有监督微调,加 1 个 epoch 的对齐训练。
- 关键定量结果(含比较对象与口径):
- Qwen2.5-7B 基座上,ALFWorld 平均奖励为 75.5±0.47,对照有监督微调 70.7、另两个基线 75.0 与 73.6;未见任务 90.1±0.50,对照 83.6、86.6、88.8。ScienceWorld 已见 72.7±0.75、未见 64.5±0.54,四个划分在这张表里都是最好。
- Llama-2-7B 基座上,ALFWorld 已见 70.0±0.71、未见 72.6±0.49,但 ScienceWorld 两个划分(71.4 与 61.2)都低于 DMPO 的 72.4 与 61.7。
- 多跳检索问答上精确匹配 33.8、F1 43.74,次优基线的 29.60 与 42.50。
- 消融:完整方法与两个消融变体在已见划分上的差只有 0.4 到 0.5 个点,落在标准差量级内;增益集中在分布外划分。
- 另一组测试环境里 92.4 对 GiGPO 的 90.8、GRPO 的 77.6。 10
- 证据强弱与复现边界:机制写得可复述(置信分定分界、关键回合按 1.0、其余按 0.2、非对称 token 级目标),同一基座上的基线表齐全,含一个 agent 化场景下的旧方法复现。边界:表注写 5 次独立运行、附录写 3 次,口径自相矛盾;没有显著性检验与多重比较校正;正文写「超出约三点」而表中差 1.6 点;主表与附录表用的环境协议不同(步数上限与数据划分都变了),两表不可直接横比;没有代码与数据链接,复现需自备三个基准与 8 卡级算力。
- 对目标研究线的连接点:直接命中轨迹学习与自进化里的回合级信用分配,也是长程任务后训练评估的一个完整基线表。
- 结论与阅读建议:建议精读方法节与两个附录表,结果表扫读。带走它时同时带上三条风险:增益集中在分布外划分且部分划分不占优、运行次数口径冲突且无显著性检验、无代码。
- 入口:AI 栏 · arXiv
3. EchoPath: Execution-Level Replayable Memory for GUI Agents(arXiv:2609.16635,直接命中·AI 栏)
- 研究问题:企业里反复出现的图形界面任务每次重跑观察、规划、定位、执行太贵。能否把已被产物验证过的轨迹变成可被确定性调用的记忆,在可靠性不下降的前提下省掉重复的规划与定位。
- 改动位置(维度):改 harness。记忆位于宿主模型之外,通过统一的动作边界包裹执行,作者称其与模型和环境都无关;模型权重不动。
- 核心方法机制:
- 五段控制环:任务输入、检索与门控、规划或重放的选择、执行、产物评估。执行统一经一个受限动作空间封装,记录每步的前后截图、目标裁切、计时与执行器输出,形成不可变证据目录。
- 记忆对象含检索键、应用标签、状态前置与预期效果、动作程序、视觉与状态证据、可改参数绑定、产物验证证据、推理与合并报告、生命周期九个部分。只有状态为活跃的才进默认检索,晋升必须由外部产物评估器确认通过并指明评估器。
- 检索与门控:查询与记忆都规范化为内容项后算意图分,一阶段阈值 0.18,二阶段做硬门控并算兼容分,需达到 0.75 才允许重放。
- 图像目标重瞄:把存的裁切图当视觉指纹,在当前整屏上按尺度集合做滑窗匹配,命中后按存储的点击比例还原坐标;目标重复或视觉近邻造成歧义时拒答,交给有界修复。
- 有界回退:局部定位失败只修这一步,结构性失败(应用不对、文档状态缺失、必须改非灵活参数)交回规划;只有声明的灵活参数可替换。
- 关键定量结果(含比较对象与口径):
- 主分析池 159 条活跃记忆,每条任务含 2 到 29 个已记录动作;第一遍构造的中位令牌约 572k、中位执行时间约 4.5 分钟,合并步骤裁掉约 30% 的探索动作。
- 第二遍刻意把分辨率从 1920×1080 改成 1600×900,使任何成功都不能靠复用旧坐标:成功率 91.2%(一个客户端)、92.8%(第二个)、87.3%(第三个),对照基线 91.8%。中位令牌 586,386→20,370(−96.5%),中位时间 315.7 秒→127.5 秒(−59.6%)。比值口径是与该基线相比,性质是同可靠性下省成本。
- 检索压力测试:把库规模从 159 条加到 659 条干扰记录,正确召回率保持 100%、无误选无漏选,平均查询时延从 216.5 毫秒升到 615.4 毫秒。
- 目标重瞄离线诊断 200 例:原始分辨率下接受率 95.5%、被接受者的偏差全部为 0 像素;随机缩放条件下接受 190 例,其中 188 例偏差不超过 2 像素。 5
- 证据强弱与复现边界:同任务两遍配对、刻意改分辨率、外加一个规划增强基线,这套防作弊设计可以直接搬到任何轨迹复用实验。边界:论文声明的代码包实测返回 404,仓库不存在,无法复现;没有重复次数与种子,成功率没有置信区间与检验;作者自述只在受控稳定的工作环境成立,重放对工具栏重排、本地化、响应式布局与近邻重复控件仍然脆弱;记忆获取依赖第一遍智能体自主尝试,对复杂长轨迹任务未必划算。
- 对目标研究线的连接点:直接命中轨迹学习与自进化——被验证的轨迹从给下一次推理的上下文升级为可直接调用的过程,这是本批对轨迹表示最具体的一次改造。评测设计同时服务长程任务评估。
- 结论与阅读建议:建议精读记忆对象定义与结果两节,附录提示词扫读。引用时必须带上三条:代码取不到、成功率为单次配对结果、以及「省成本而可靠性持平」的真实口径。
- 入口:AI 栏 · arXiv
4. ReDraft, Don't Just Distill: Reference-Driven Revision for Continual VLLM Post-Training(arXiv:2609.16639,直接命中·AI 栏)
- 研究问题:持续后训练要同时做到获得新任务能力与保留旧能力。有监督微调的目标显式、能从接近零的准确率学会一个任务,但会把模型推得足够远而产生遗忘;可验证强化学习与自蒸馏保持策略邻近,却在策略还不会做该任务时给不出信号。
- 改动位置(维度):改训练目标与训练数据——专家回答只当参考,模型修订自己的错误轨迹、验证器通过后只用自修订结果做交叉熵微调;权重随之更新。
- 核心方法机制:
- 形式化:在「最大化验证器奖励加邻近性惩罚」的信任域问题下,二值验证器的最优解是在当前策略分布上截取验证器接受的集合,同时带显式正确性与策略邻近性。
- 先采样一次;验证器接受就直接用,不接受就用同一个模型在「问题、参考、自己的错误回答」条件下生成修订。专家回答只作参考,不直接充当目标。
- 只有验证器接受的修订才成为训练对,训练时看不到参考与原轨迹。编辑过的片段提供显式监督,未改动的片段保留模型自己的轨迹以维持策略邻近性。
- 方法成立的经验前提被写成一条假设:模型在参考在上下文的前提下有能力修好。
- 关键定量结果(含比较对象与口径):
- 遗忘指标的口径必须先说清:损失是 8 个旧能力基准的宏平均(图像与文档理解四个、通用问答两个、真实场景理解一个、科学问答一个,其中通用问答基准按满分 2800 归一化),增益与损失都相对各自的基座模型,并对所有实验取平均。
- 3B 与 7B 平均、相对各自基座:目标准确率增益 +56.9,对照有监督微调 +52.9;旧能力损失 1.5 点,对照 16.6 点。对照的自蒸馏方法增益 +19.3(标准预算)与 +23.4(扩展预算)、损失 6.2;把它的预算延长 70% 的步数只多买 4.1 点,钟面读数任务上仍落后 31.7 点。
- 两个冷启动任务的对照更鲜明:增益 +79.4、旧能力 −2.2,有监督微调 +73.8 与 −7.8,自蒸馏 +26.0 与 −4.1。3B 拼图任务上自蒸馏几乎没离开基座,终值目标准确率 6.1%。
- 训练语料的修复率:3B 拼图任务首次采样成功率 0.21%、带参考修订后 92.25%;7B 钟面读数 0.67% 到 64.97%。
- 参数侧:与有监督微调的参数位移余弦相似度 0.272,高于自蒸馏的 0.135;相对位移量(参数位移的范数比)分别是有监督微调 6.52、本方法 5.59、自蒸馏 4.13。 11
- 证据强弱与复现边界:口径写得最清楚的一篇——遗忘指标有定义式、8 个旧能力基准与归一化方式、逐设置表、修复率表,而且主动排除了「对照方法只是训练不足」这个替代解释。边界:没有种子、没有重复运行、没有显著性检验;修订集只从训练开始时的策略构建一次并固定,在线重建未测试;未单独评测另一种自蒸馏变体;任务是规则可判的视觉计数、读数与拼图,验证器可自动判定这一前提在开放生成任务上不成立;混合训练的 7B 与顺序训练 3B 的个别阶段里表现低于有监督微调。
- 对目标研究线的连接点:直接命中轨迹学习与自进化——自己的失败轨迹经参考修订与验证器筛选后变成训练目标。增益与遗忘双轴加 8 个旧能力基准宏平均的口径骨架,也可以直接抄给长程任务的持续学习评估。
- 结论与阅读建议:建议精读。引用时要自己补上它没做的部分:无种子与显著性检验、修订集离线、未评测另一种自蒸馏变体。
- 入口:AI 栏 · arXiv
5. ThinkFlow: Self-Evolving Probabilistic Latent Memory for Lifelong Conversational Agents(arXiv:2609.17010,直接命中·AI 栏)
- 研究问题:终身对话智能体的记忆要么丢掉细微的行为模式与情绪漂移,要么部署后静态、没有人工反馈就不自适应。
- 改动位置(维度):改模型权重加改轨迹表示——测试时在线更新学生模型的部分低秩适配权重与三个记忆模块参数;记忆不再是离散文本摘要,而是连续隐空间里的概率潜在技能。
- 核心方法机制:
- 潜在记忆技能:K 个可学习技能对当前隐状态做注意力压缩,经两个线性层输出均值与方差后重参数化采样,对标准高斯先验加正则,默认技能数 10。
- 门控合并器:按信息增益决定新旧记忆的混合比例,用来过滤闲聊噪声并渐进遗忘旧信息。
- 上下文感知对齐器:按当前问题生成低秩变换,把记忆做残差投影后作为软提示前置进语言模型。
- 测试时进化分两阶段。第一阶段由同一基座实例化的教师读全文历史输出目标分布、学生只读当前问题与记忆,做分布对齐;第二阶段从第二个会话起教师下线,用预测用户下一句的交叉熵为主监督,加最小熵置信先验与正则项在线更新。所谓「无标签」指不需要人工标注,第一阶段仍以教师输出分布为监督目标。
- 关键定量结果(含比较对象与口径):
- 三个长期对话生成数据集加一个个性化记忆问答基准。Qwen3-8B 主干下三个对话数据集上生成质量均居首,其中 GapChat 上 65.26 对可比基线最高的 49.96。
- 个性化记忆问答在 32K 档 44.43,对同类方法最高 39.03;128K 档 40.91 与 1M 档 41.94 仍高于同类方法,但低于闭源参照的 43.29 与 44.71。
- 另一个主干(Llama-3.2-3B)下,多个数据集上的 Mauve 低于一个潜在记忆基线,部分 ROUGE-L 也由别的基线更高。
- 效率上全流程 2857 个令牌、12.1 秒,在论文比较的方法里最低;对照方法需要生成数万个隐藏令牌,耗时接近它的八倍。 12
- 证据强弱与复现边界:把测试时进化的监督来源与参数范围写清楚了,这是本批少见的一份。边界:没有种子、没有重复次数、没有显著性检验(摘要用了「显著优于」,全文没有任何检验);代码与数据都没有提及发布;消融表里有一行数值疑似抄录问题,引用前须回原表核对;作者自述尚未建立该架构在超长上下文下的性能崩溃上限。
- 对目标研究线的连接点:直接命中轨迹学习与自进化里「记忆从被检索的文本改写为可梯度更新的参数」这一支;个性化记忆问答的三档上下文切分也可以借给长程记忆评测。
- 结论与阅读建议:建议精读方法与附录算法,结果表按主干分块读,其余为点估计展示。
- 入口:AI 栏 · arXiv
6. Interactive Memory Learning for Long-Term Conversations(arXiv:2609.17088,直接命中·AI 栏)
- 研究问题:长期对话的记忆管理长期采用静态启发式,信息被被动归档而没有价值评估,因此既不能自我进化,也跟不上不断变化的用户需求。
- 改动位置(维度):改模型权重加改 harness——把记忆写入与触发从启发式规则改成可学习的策略,用近端策略优化在线更新;并以改数据(回望式合成的专家数据)支撑冷启动。
- 核心方法机制:
- 两个可训练策略:一个决定某一轮是否值得存成记忆片段,另一个在候选记忆索引上决定引用哪一条;被选中的记忆与上下文拼接后生成最终回复。
- 跨会话真值奖励是延迟奖励的确切实现:维护一个待定奖励缓冲,当未来某一轮触发了过去写入的记忆片段时,把未来轮的回复质量分回溯传播为那一轮的奖励。
- 两个策略用共享的评论家端到端联合优化,写入与读取策略共同演化。
- 冷启动数据由回望式会话合成产生,从种子会话反向生成故事线与前传,并做前向依赖标注。
- 关键定量结果(含比较对象与口径):
- 三个长期对话数据集。自动指标上多数单元格领先(如密度最高的数据集上 59.81,对最强基线 30.29),但同一设置下有两个数据集的 ROUGE-L 由基线更高。
- 人工评测 5 名评审、3 个数据集各随机 50 个样本共 150 个样本:生成质量胜率 66.0%(95% 区间 [60.5, 71.5],配对 t 检验 p<0.01,Fleiss κ=0.65),记忆检索胜率 70.0%([64.2, 75.8],p<0.01,κ=0.68)。
- 奖励对齐:连续 5 个训练会话里,高价值记忆漏存率 48.2%→24.5%→5.8%→4.1%→3.2%,即时代理奖励与延迟真值奖励的相关系数从 0.62 升到 0.89。
- 总耗时从第一个会话的 52.74 秒(含预热)稳定到第五个会话的 10.22 秒;对照的记忆系统在后段会话达到 826.61 秒。 13
- 证据强弱与复现边界:延迟奖励如何回传到早期的存储决策,这一处写得最具体,可以逐式读;人工评测部分给了配对 t 检验、置信区间与评分员一致性系数。边界:自动指标部分没有种子、没有重复、没有显著性检验;人工评测样本量偏小;全文没有代码或数据链接;同一批次里还有一篇同作者、同资助、作者顺序不同的平行工作,两篇结论互相引用,独立证据强度应按同一课题组的两条平行线看待。
- 对目标研究线的连接点:直接命中轨迹学习与自进化里的延迟奖励分配,是长程稀疏反馈如何落成训练信号的直接样本。
- 结论与阅读建议:建议精读跨会话真值奖励与联合优化两节;结果表按主干分块读。
- 入口:AI 栏 · arXiv
7. World Model Science: Self-Organized Criticality, Weak Chaos, and Metastable Belief Dynamics in Long-Horizon LLM Agents(arXiv:2609.17419,直接命中·AI 栏)
- 研究问题:长时程智能体的失败究竟是独立逐步误差的累积,还是呈现应力累积与雪崩释放这类动力学特征。论文主张用轨迹级动力学诊断替代只看终局奖励。
- 改动位置(维度):只改评测——新造一套轨迹级的世界状态、应力与雪崩测量管线与零模型对照口径,对已有基准的现成轨迹做二次分析,不改任何被测量的系统。
- 核心方法机制:
- 把轨迹映射为七维测态(进度、信念、约束、不确定性、风险与工具债、记忆、计划),与基准真值对比后得到世界状态保真度与局部动作可用性两个正交可测量,两者之差就是局部与全局落差,用来暴露「动作仍然合法而全局状态已经崩」的隐性坍塌。
- 冻结应力分由未决不确定性、矛盾、检索冲突、未验证假设与工具错误债加权组成,权重在看结果之前固定;在阈值上定义雪崩集合、尺寸、加权尺寸与持续时间。
- 三组诊断族覆盖时间依赖、结构传播与有限尺度行为;每个主要签名都配一个显式零模型(独立逐步误差、两状态持续性、难度预测器、打乱谱、表面扰动),确认性检验用错误发现率校正。
- 把能力边界当一等混杂量:某个基质上有效轨迹为空时,缺失的签名被登记为容量受限,不计入被测动力学。
- 关键定量结果(含比较对象与口径):
- 22 个固定实验、7 类基质(自建受控环境加四个公开基准加一个局部规则对照)。
- 在受控环境里注入应力预测坍塌的曲线下面积为 0.979;独立首次误差零模型反解出的单条轨迹坍塌概率约 0.0022,用来给出「独立噪声能否解释」的参照。
- 局部与全局落差在 GAIA 一级中间结论步为 0.857(最大),某个基准的信息类任务接近 0。
- 误差流的谱指数为 1.38 到 1.52,去趋势波动分析为 1.34 到 1.38;依赖深度从 1 增到 2 及以上时,拟合形状从偏好指数转为偏好幂律。
- 有限尺度行为:最大雪崩截断随步长预算单调增长,从 7 增到 490,所有相邻预算检验经校正后 p 小于 10⁻⁸。
- 能力边界:某个基质在网格规模达到 96 时有效轨迹为 0 条,论文把那里的缺失签名登记为容量受限。已验证项目的总成本为 46.27 美元。 14
- 证据强弱与复现边界:零模型、错误发现率校正与能力边界三条纪律写得很完整,是「轨迹级测量该怎么报告」的现成范本。边界:全篇没有点名任何一个模型,只写「同一个模型接口」;没有报告轨迹条数;单种子且代码仓明确说单种子是有意设计;作者自述不支持普适幂律、不支持普适临界点、不给出跨基质的单一干预策略;自然应力对独立奖励误差事件的前兆只有 0.616 的曲线下面积。
- 对目标研究线的连接点:主要接长程任务评估。它把「局部合法」与「全局状态正确」分开测量,这条规则可以直接搬进评测设计;与自进化线属于方法学相邻,论文本身不涉及从轨迹学到能力。
- 结论与阅读建议:建议精读评测口径部分,结果细节扫读。它的模型不可知,只能当测量与报告口径的参考,不能作为任何具体模型能力结论的证据。
- 入口:AI 栏 · arXiv
8. Self-Emergence Agent Architecture:Behavior-Inertia HMM, Reflexive Metacognition,and Social-Contrastive Self-Modeling(arXiv:2609.17331,直接命中·AI 栏)
- 研究问题:智能体存在人格漂移、非进化式反思与缺乏自我—他者边界三个结构性限制,已有的生成式仿真依赖静态记忆与固定提示,既维持不了行为惯性,也实现不了内生的自演化。
- 改动位置(维度):改技能与状态表示,加改环境,不训练任何模型权重——用可编辑的隐马尔可夫状态转移矩阵编码长期行为与认知惯性,反思输出直接改写矩阵参数;环境加入多智能体社会比较。
- 核心方法机制:
- 惯性矩阵由对角占优的初始行随机矩阵加一个状态偏好向量,经温度缩放与归一化得到;被偏好的状态被更频繁进入,惯性因此可被参数化编辑。
- 反思不存文本,而是更新偏好向量:由经验需要向量与该状态的自洽度算出反思信号,按反思学习率更新。反复符合经验的状态被强化并收敛到主导状态。
- 每个智能体维护自身行为的指数移动平均自我模型与群体均值的差,即自我—他者边界。
- 闭环为社会行动、反馈、自我反思、惯性更新、差异化行动,并给出三条可证伪假设与可复现实验协议。
- 关键定量结果(含比较对象与口径):
- 主要统计证据来自不使用语言模型的数值原型(5 个智能体、600 步、30 个独立种子,取最后 50 步的均值±标准差,对照为同样记录反思信号但从不施加更新的纯文本反思)。
- 成对转移矩阵的 Frobenius 距离 1.91±0.29,对照 0.00±0.00(单侧 Mann–Whitney p=6.1×10⁻¹³,Cohen's d=9.19);长期自我模型成对距离 0.51±0.13 对 0.13±0.02;人格确定性 0.84±0.10 对 0.25±0.00;自我—他者差 0.35±0.09 对 0.08±0.01。对照组的锁定率在全部种子上为 0。
- 应急冲击实验:在 30 个种子上把主导状态的反思信号反号,150 个智能体(100%)全部放弃被冲击的主导状态并重新固化,切换时间中位数 152 步,被冲击状态的占用率从 0.94 降到 0.06。
- 反思学习率消融:取 0 时无分化,0.05 到 0.1 之间饱和,说明该编辑既必要又有剂量依赖。
- 真实模型层只有 DeepSeek-Chat:自我访谈 10 个种子、五智能体圆桌讨论 6 个种子、单一讨论话题,成对文本重叠 0.267±0.017 对对照 0.391±0.020(p=9.0×10⁻⁵)。 15
- 证据强弱与复现边界:机制清楚,而且用学习率取零的消融证明「反思改参数」是因果性的,这一点值得借。边界:主要统计结论出自不使用语言模型的数值仿真;正文里有连续五节标注为待跑的完整协议,只有最后三节是已完成实验;论文称原始数据与脚本「已发布」,但全文没有任何 arXiv 之外的外部链接,实际取不到;真实模型层只有一个模型家族、一个讨论话题,跨模型复现被列为未来工作。
- 对目标研究线的连接点:直接命中轨迹学习与自进化里「把反思从存文本升级为改参数」这一支;「先在无语言模型的数值原型上验证机制、再上真实模型」的两层验证顺序也值得借用。
- 结论与阅读建议:建议扫读机制与实验纪律两节。不适合当作「真实模型社会涌现」的强证据。
- 入口:AI 栏 · arXiv
9. Metacognitive Steering: Learning the Structure of Scientific Judgment(arXiv:2609.16245,直接命中·AI 栏)
- 研究问题:科学判断(在探索、规范化执行与批判性重估之间的过程级切换)能否从真实科学家交互轨迹中恢复出来,并用来控制一个冻结的前沿模型的内部计算。
- 改动位置(维度):改推理期内部计算——从对比式干预数据里提取跨层的低维「认知姿态」方向,推理时按当前认知状态动态叠加;主模型参数全程不动,训练涉及的只是外部控制器与读出器。
- 核心方法机制:
- 逐层取正负样本的残差差,先用秩一去混淆投影消掉「发生了一次干预」的共同方向,再用冻结注意力权重下的写子空间与读子空间最大奇异值对齐做第二映射。两者共同指向中深度控制面:浅中层建立推理配置,中层是注意力侧的读取枢纽,深层携带最强的晚期残差签名。
- 状态发现用未差分的残差激活标准化后做主成分投影再聚类,状态数按轮廓系数选择;模式发现用深层对比差方向聚类。状态与模式的标签由科学家事后命名。
- 推理时按当前状态合成引导向量,残差更新只做一次路由,不计算梯度。
- 关键定量结果(含比较对象与口径):
- 跨层奇异值分解的三个领先主成分超过 1000 次跨层打乱零模型的 97.5 分位,信噪比约 1.55、1.3、1.25;冻结权重下的写读对齐超过 Haar 随机平面零模型 95 分位(0.170)数倍。
- 三状态聚类的轮廓系数 0.457,对次优解的 0.304;状态与模式的关联强度 Cramér's V=0.993;探索性五折分析里 10 个选定神经元以约 99% 准确率恢复三状态。
- 数据侧真配对与随机重配的相似度比为 3.6 倍(单侧置换 p=0.001,自举区间 3.3 到 3.8)。
- 真实世界成果:在某开源蓝牙协议栈上识别出 10 个崩溃点、其中 8 个被外部团队独立复现并在 5.86 版上确认;另有一枚只用商用固体发动机、仅通过六自由度仿真验证的探空火箭,论文自述实物飞行才是决定性测试。 16
- 证据强弱与复现边界:控制面定位的三重收敛(去混淆、写读对齐、跨层分解)是一套可复用的可解释性做法,也是本批唯一在万亿参数主干上做推理期干预的工作。边界:没有任务成功率层面的冻结基线对照,行为分析是定性的,作者自述不能证明被引导的结论正确;没有种子与方差;数据专有、无公开代码;真实世界成果属工程与攻防成果,不能当作方法有效性的实验证据。
- 对目标研究线的连接点:直接命中轨迹学习与自进化,但形态受限——学到的是推理期的控制器,属于「学一个控制器」,与自我进化相隔一层。过程级监督与结果级监督的区分对长程任务评估有方法学提示。
- 结论与阅读建议:建议扫读控制面定位部分,作为邻近跟踪对象;等它给出跨模型迁移与定量对照后再升级优先级。
- 入口:AI 栏 · arXiv
相邻方向:六篇可迁移接口与警戒性阅读
下面六篇的研究问题不在四条线上,但各自带着一件能直接搬进目标线的东西——一套留证清单、一种轨迹表示、一类归因缺口声明。它们按可迁移程度排序,末两篇属于警戒性阅读。
1. Symbolic Separation: Grounding Deep Agents in Knowledge Graphs for Trustworthy Operational Data Analytics(arXiv:2609.17107,邻近跟踪·AI 栏)
- 研究问题:把既有的刚性单次工作流封装成现代深度智能体的一个工具后,它能否回答泛化查询;由现代大模型驱动的深度智能体能否自行导航真实时序数据库,还是需要一个被查询数据的符号表示。
- 改动位置(维度):改技能与工具、改 harness(多智能体编排),并自建两套评测集;模型权重不动。
- 核心方法机制:神经层自由推理,但只能在符号层上行动——每次数据访问在到达数据之前都要按领域本体校验,跨源关系在虚拟知识图谱里预先物化,复杂问题因此变成对既有已校验边的一次遍历。执行走三段式确定性管线:输入校验与歧义澄清、查询与图谱生成、查询执行,并配失败即停的重试行为。对照组共享同一个协调者、技能、模型与硬件,只替换检索后端,用来隔离符号化带来的效应。
- 关键定量结果(含比较对象与口径):14 条自建端到端查询上,符号化检索配某一开源权重模型完成 12 条(86%),非符号化后端配另一模型完成 6 条(43%),而同一模型换到非符号化后端只有 2 条(14%)。每个成功查询的中位令牌数是 300k 对 713k。75 条检索查询上 66 条(88%)对 42 条(56%)对 36 条(48%)。符号化配置产生 0 条幻觉回答,非符号化配置产生 2 条。遥测数据来自一个公开超级计算数据集(980 多个计算节点、两年半、未压缩 49.9 TB)。17
- 证据强弱与复现边界:43% 与 86% 用的是不同模型,因此这里的 43% 与 86% 分属两个模型,归因不能落到符号化这一项上;每配置只跑一次,没有重复运行次数、种子与统计检验;评测集为自建且规模小;遥测数据集是既有公开语料;代码没有声明开源,只有检索查询数据集可访问。作者主动披露了与既有文献的落差:同一组件在他们自己的前作里报 93.6%,在本评测里只有约 7%。
- 对目标研究线的连接点:可搬走三件——在动作边界插入一层确定性、预执行、按领域本体校验的关口,并把校验失败变成可计数的重试信号;把「检索成功」与「下游执行成功」分开记、以两者的合取作为端到端成功的唯一标准;逐查询记录令牌分解、失败重试次数,并把失败分成正确、幻觉、不完整、失败四类。数字本身不可作为效果量引用。对播客线无连接点。
- 结论与阅读建议:扫读架构定义、三段式校验管线与结果口径三处即可,其余不必读。
- 入口:AI 栏 · arXiv
2. SKIP: a Self-knowledge-guided Step-wise Preference Learning Framework for Concise Reasoning(arXiv:2609.17019,邻近跟踪·AI 栏)
- 研究问题:如何低成本构造数据来激发模型的简洁推理,如何在压缩推理链的同时避免准确率下降,以及这个能力能否泛化到分布外任务。
- 改动位置(维度):改模型权重(冷启动微调加低秩适配加掩码偏好优化),并改数据(逐步偏好对的构造方式)。
- 核心方法机制:用少量样例让模型上下文学习生成更简洁的风格并按正确性过滤后做冷启动;随后在推理链的每个句子之后插入探测短语、强制模型基于已有步骤贪心解码出答案,用中间步答案的正确性判断「信息是否已经充分」;按正确性与长度把采样答案分成四类,只构造两类偏好对——多步才答对优于少步答错(保住推理能力),都答对时短者优先(压缩长度),并明确丢弃「长但错对短但错」这类没有信号的组合;训练用掩码偏好优化,只对正负样本不重叠的片段计算损失。
- 关键定量结果(含比较对象与口径):三个主干乘三个领域,推理长度压缩 23.3% 到 84.6%(如某一主干在数学题上从 983.48 个词元降到 319.00),准确率多数持平或上升。但相对未压缩的原模型有两处下降:某一主干在小学数学问答上 84.35 对 85.50,另一个主干在数学竞赛题上 43.80 对 47.20。分布外评测上该优势的对照对象是压缩基线:两个分布外数据集上原模型准确率 76.8 与 69,压缩后为 67.0 到 70.8 与 64.1 到 65.3。18
- 证据强弱与复现边界:方法可搬、结果层不可引用。没有种子、没有重复运行、没有显著性检验,作者自陈所用的效率指标不够稳健;论文声明数据与代码可用,仓库实测存在但为空,没有分支也没有提交;正文未完整给出超参数。分布外结论要两条并读:简洁推理确实泛化,同时相对原模型有明显准确率损失。
- 对目标研究线的连接点:逐步自知识探测加双类偏好对构造,可以把「何时该停」变成不需要外部强模型的监督信号,对轨迹级提前退出判别器与自进化信号设计都有参考价值;掩码偏好优化是防止共享前缀干扰偏好训练的具体手法。评测规范上,「分布外结果要同时报相对原模型的准确率损失与相对压缩基线的优势」这一条可以直接照搬。
- 结论与阅读建议:扫读结果表、精读方法与消融。
- 入口:AI 栏 · arXiv
3. A Framework for Generating Valid Context-Specific Benchmarks through Expert Guidance(arXiv:2609.16592,邻近跟踪·AI 栏)
- 研究问题:如何让领域专家只付出最小必要的输入,就能规模化地生成情境特定、满足测量效度的评测数据集;以及结构中的各类信息分别影响哪一个质量维度,资源受限时该优先采集哪些。
- 改动位置(维度):只改数据与评测——专家引导的评测集合成,加四项数据集级质量指标;不改模型权重与 harness。
- 核心方法机制:三步流程——先写结构(把有效评测语境的三个组件拆成八个字段,另加真实目标人群写的种子样例),再定四个质量标准(覆盖度与多样性操作化内容效度,内容真实感与风格真实感操作化生态效度),最后用结构引导合成;四项指标都落在 0 到 1 之间,论文明确「四项都高不是目标」。
- 关键定量结果(含比较对象与口径):单一社会工作案例、每方法 100 例、3 个种子样例、同一个生成模型。内容真实感 0.77 对 few-shot 基线 0.73,覆盖度 0.23 对 0.16;但风格真实感反而更低(0.56 对 0.60),多样性无差异(0.13 对 0.14)。专家评分上结构方法风格分 4.2 对基线 3.0,六名专家里五人更偏好结构方法。1,013 种字段配置的消融显示,部署人群字段对内容真实感平均贡献 +11.87%,而提供种子样例反而平均降低覆盖度 3.44%。全部实验合计 7,000 万输入输出词元。19
- 证据强弱与复现边界:这是六篇里唯一有实验结果且有可访问代码的一篇(仓库声明现在时、实测可达,含指标脚本与一个已完成的结构文件),但它没有发布生成的数据集。边界:单一领域、6 名访谈对象、100 例规模;没有显著性检验;两项自动指标与专家判断方向相反,说明「真实感」类自动指标在种子代表性假设不成立时不能单独当验收标准;人工质性编码由第一作者一人完成,只报告了判官一致性而没有人际一致性。
- 对目标研究线的连接点:「提供少量示范反而降低生成覆盖度」这条反向证据,对「用少量示范轨迹做上下文学习再扩增」这一常见做法是可迁移的警示;「同一目标下哪类条件最关键」的配置消融给出一个现成的实验范式。对 TTS 与播客线只是组件级:四个指标与结构模板可以用来诊断测试集的真实感与风格覆盖,但原文没有任何音频实验,节目级结论不支撑。
- 结论与阅读建议:扫读;如果本期的目标正是评测集构造方法,可以升级为精读。
- 入口:AI 栏 · arXiv
4. Position: AI Is Not Ready for Strategic Conflicts(arXiv:2609.16189,邻近跟踪·AI 栏)
- 研究问题:在开放式战略兵棋推演中,当同一个模型同时承担玩家、对手、裁决者、分析者与总结者角色时,生成的内容会以什么结构进入模拟现实并影响真实判断;在没有可审计安全论证的情况下,这类系统能不能被允许影响规划、条令、政策与危机响应。
- 改动位置(维度):只改评测——提出评测范式与审计规范:安全论证的组件、裁决留痕清单、领域专家审计量表。
- 核心方法机制:论文给出五条失败路径(决策洗白、裁决不透明、角色坍缩、经由裁决的升级、战略想象力失败),并论证它们会叠加;结构性风险被命名为跨自动化角色的相关性语义错误。它逐个否证替代物:静态任务准确率、闭局胜率、红队与人工评审、判官打分与「像人类」都不能构成安全论证。核心产出是六组件留证清单(范围与用途、角色分离、裁决留痕、鲁棒性、人类可质疑、结论纪律)与一份十项从业者清单。
- 关键定量结果(含比较对象与口径):本篇没有实验结果,也没有样本量。可核对的量化项只有附录里一份公开证据清单——26 个公开可查的兵棋与规划系统,按其承担人工智能、语言模型、智能体、检索或强化学习角色收录,另附检索协议与保守的结论边界规则。20
- 证据强弱与复现边界:立场类文章,不含实验与样本量,不能作为任何性能或事实依据。它对自身也有设限,包括开放式兵棋可复现性差、安全论证可能退化成清单式表演。
- 对目标研究线的连接点:六组件留证清单与十项从业者清单可以整段改写成开放式长程任务的记录规范,包括角色图与模型指派、对高影响结论的留痕支持、改写与提示敏感性测试、跨模型与红队鲁棒性测试、具名的人工干预点。它同时给出一个可以直接引用的判断:静态基准分数与判官打分不足以宣称长程任务可交付。角色坍缩与相关性语义错误则是对「同一模型既提方案又判可执行性又裁决又总结」这一自评闭环的直接反证依据,对自进化线适用。对语音与播客线无连接点。
- 结论与阅读建议:邻近跟踪。扫读失败路径与两份清单即可,其余不必读。
- 入口:AI 栏 · arXiv
5. Intrinsic Motivation in Reinforcement Learning: A Research Agenda for Adaptive Self-Organisation(arXiv:2609.17325,邻近跟踪·AI 栏)
- 研究问题:不依赖共享外部目标的内在奖励,能否支撑人工神经系统的适应、功能分化与更高层级的自组织;现有内在动机方法能不能产生昆虫层级的学习与行为类型。
- 改动位置(维度):只改评测与模型结构,而且全部是待实现的议程——提出能量约束环境、共享参数的循环模块网络、两级世界模型智能体三个方向。
- 核心方法机制:论文先统一比较既有内在目标(empowerment、多步与轨迹 empowerment、无监督技能发现、预测误差与新异性、学习进度、信息增益、稀疏化与预测信息奖励、世界模型作为内在奖励来源),再给出三个方向的实验设计,每个都配了消融:能量约束环境里可关闭能量对动作的影响、把对抗性成分换成静止成分;循环模块网络里去掉参数共享、把通信切到四档;两级世界模型里给低层设混合奖励以收集多样经验,高层用慢变表示产生目标。
- 关键定量结果(含比较对象与口径):本篇没有新实验,因此没有本文测量的数字;文中出现的数字都是对既有工作的转述或本文构造的说明性算例。值得记下的是它列出的四条失败模式:信息型奖励会被可控对象或纯噪声源吸住,而且作者判断这一条在智能体侧不可解、需要环境层约束;新异性若按当前批次统计归一化,绝对多样性与覆盖下降时归一化奖励仍能在批次内排序上升,这正是「真实目标退化而代理指标仍在进步」的机制;技能发现只学技能、不涉及技能如何组合与排序;通信本身可被内在奖励,互发任意消息即达上限,于是「把交互当成信号」这个假设失效。21
- 证据强弱与复现边界:立场、教程与议程混合的文章,数学附录很长,不能作为任何性能依据。正文声明代码将随实现推进发布、用的是将来时,而实测该仓库已存在、132 次提交、含可运行实验代码,两种状态并存。
- 对目标研究线的连接点:四条失败模式可以直接当作「自生成奖励驱动轨迹学习」的假设检查项,尤其是一条:指标在真实目标退化时仍显示进步。能量约束加世界对抗的建模方式可以平移到长程任务的预算约束,它给出的消融范式(关闭约束效应、把对抗成分换成静止成分)是现成的对照设计模板。对 TTS 与播客线无连接点。
- 结论与阅读建议:邻近跟踪。只看失败模式与方法缺点那几节,数学附录不必读。
- 入口:AI 栏 · arXiv
6. QART: A Quantum-Classical Hybrid Architecture for Long-Horizon Reasoning -- Exploring a Conditional Path toward Quantum Scaling(arXiv:2609.16887,邻近跟踪·AI 栏)
- 研究问题:长时程推理中早期错误会改变后续决策、破坏整条轨迹的可靠性;能否用一个「主干语言模型加量子编码、加基于相干伊辛机的组合优化、加量子解码」的混合架构改善端到端可靠性,并在显式假设下论证相对单轨迹自回归模型的渐近可靠性分离。
- 改动位置(维度):改系统架构——在推理栈中插入三个功能层,主干模型不变;只改评测,全部分数为自测。
- 核心方法机制:论文给出两个定理——单轨迹自回归模型在不可逆错误的累积条件风险发散时接受概率趋于零;混合架构在四类条件概率一致为正时,最优路径恢复概率有正下界。论文反复强调「架构本身不蕴含这些界」。量子扩展律以条件假设形式提出,并给出三个前置条件:底层求解器必须对强经典求解器有持续优势、该优势在计入全部开销后仍保留、且要有跨资源尺度的受控可复现实验;论文明确声明这三条都没有建立。
- 关键定量结果(含比较对象与口径):6 个长时程基准、3 个主干、15 个主干与基准的组合里 14 个优于自回归基线,中位相对变化 11.3%,同时保留了一个明确回退(某一主干在长时程软件工程任务上从 45.13% 降到 41.59%)。绝对变化与相对增益必须并报:某一基准上 14.58 个百分点的绝对提升因为基线低而被放大成 84.0% 的相对增益。22
- 证据强弱与复现边界:作为方法或结论都不可复用——编码与优化流程声明为专有、未披露,分数全部为自测,没有种子、重复次数与统计检验,没有同编码下的经典求解器对照,因此提升无法归因给量子层。它值得读的地方恰在反面:如何正确声明自测分数不可外推、如何保留回退个例、如何把理论主张写成条件性假设、以及如何在缺对照时主动声明归因缺口。量子扩展律只是待检验假设,不可作为趋势引用。
- 对目标研究线的连接点:可搬走的是报告规范——比较两个 harness 配置时锁定同一主干、同一验证器、同一环境,并显式声明分数是自测;绝对变化与相对增益并报且保留回退个例;对「加了某个模块所以变强」的归因,必须在同一编码下补一个经典对照。对自进化、TTS 与播客线没有任务级连接点。
- 结论与阅读建议:警戒性阅读。只看结果讨论与缺口声明那几节,证明部分不必读。
- 入口:AI 栏 · arXiv
TTS 生成与评估:从均值转向最差情况,以及人评口径
三篇直接命中,分别改推理流程、改不到千分之五的参数、改 token 表示。它们的共同点是把「这个系统好不好」拆成更窄的问题来回答。
1. Taming Long-form Text-to-Speech(arXiv:2609.16989,直接命中·音频栏)
- 研究问题:开放权重自回归语音合成在短文本上字错率与相似度已达最好水平,长文本提示上可靠性显著退化。能否在不做任何训练的前提下,把长文本可靠性拉回短文本水平,并让语音克隆真正受益于长参考音频。
- 改动位置(维度):只改推理流程——在流式生成中监控注意力权重、检测失败、回滚并临时施加硬注意力掩码;不改权重、不做训练。
- 核心方法机制:
- 把长文本掉点归因于对齐头上音频与文本注意力的错位,定义两类失败:跳过(连续删掉 10 个词以上)与幻觉(连续替换加插入 20 个词以上)。其余错误在长短文本上发生率相同,构成不训练时的内容准确率上限。
- 检测器的输入是注意力权重:每一步取注意力上的最大位置作为阅读位置,把输入文本切成等长的词元桶,统计对齐头在各桶上停留的生成步数。阅读位置越过某个桶、而该桶收到的步数远少于在前面的桶,就判跳过;阅读位置停止前进的时间远超一个桶的正常耗时,就判幻觉。最后一个桶收满注意力即判定文本读完并结束生成。阈值数值原文没有报告,只说写在代码里、将在发表时开源。
- 回滚到检测到的失败起点,重新播种随机数,并施加一个硬注意力掩码;该掩码沿用论文引用的前置方法(把约束常开的那一类),区别在于本方法只在过渡期内施加。持续失败会触发多次,但有重试上限以限制开销,上限数值同样没有报告。
- 另提出滑窗相似度指标:8 秒窗、4 秒步长,报告跨窗口跨种子的最差值。
- 关键定量结果(含比较对象与口径):主指标是跨 10 个随机种子的最差情况字错率,语料为呼叫中心对话的 144 条提示,字错率由转写模型输出与原始文本比对得到。1500 词以上从 35.2% 降到 3.4%,低于同一系统在 500 词以内基线的 5.4%;各长度上均值保持在 2.5% 到 2.9%。把主干换成本族更大的 1.7B 版本,1000 到 1500 词上从 15.6% 降到 2.3%,1500 词以上从 29.9% 降到 2.8%。语音克隆上,参考音频从 15 秒以内拉到近 120 秒时,灾难性失败率(字错率超过 30%)从 5% 升到 26%,该方法在每个参考长度都低于 5%、最长处低于 1%;最差滑窗相似度在 120 秒处从 0.01 回到 0.47。在基线至少失败一次的 146 个「提示与种子」对上,该方法把全部压进与短提示同样的低位带。6
- 证据强弱与复现边界:把「长文本可靠性」拆成可检测的内部信号,并给出跨主干证据,方法论价值高。边界有三处不能当数字源:检测阈值、重试上限与重试次数分布都没有报告,代码是将来时且没有链接;评测语料本身是语音识别用的多口音长文本集,不是合成语音语料;全部指标为自动打分,没有人工评测与统计检验。换到另一个主干(VoxCPM2)时,1300 词以上只把失败比例从 70% 降到 57%,作者把它归因于模型自身的连贯性上限。
- 对目标研究线的连接点:直接命中 TTS 生成与评估。把长输入下的失败归因到模型内部的对齐信号、再用同一信号在线检测并局部重试,这个范式也可以搬到长程任务的在线失败检测与局部重试。
- 结论与阅读建议:建议精读。要定「生成系统的可靠性该怎么量」的团队,可以直接借用最差情况字错率、滑窗相似度与灾难性失败率这三个口径。
- 入口:音频栏 · arXiv
2. Self-Distilled Pronunciation and Accent Control for Neural Text-to-Speech(arXiv:2609.17234,直接命中·音频栏)
- 研究问题:端到端语音合成直接读原始文本、没有词典,生僻词与专有名词只能靠模型猜;对日语还涉及哪个音节承载音高重音,读错会让听者去词典里找一个从未被说出的词。已有的输入侧控制都要付录音代价。论文要问的是:能否只用文本集合与公共前端,把读法与重音通道装进冻结主干。
- 改动位置(维度):改模型权重,但只动极小一部分,加改输入侧注记与部署期路由。主干其余全部参数与整个合成栈冻结,可训练的只有一个秩为 16 的低秩适配加在两个位置的投影上,外加仅两个标记的嵌入行;论文说移动的参数不到 0.5%,训练约 1 小时、单张消费级显卡。
- 核心方法机制:
- 自蒸馏的教师信号:取一个主干本来就读对的常用词与包含它的自然载体句,用冻结主干合成并保留其自身输出作为目标;学生输入是把该词替换成带标记的重音读法。教师与学生描述的是同一句话,唯一差别是多了一条显式读法指令,论文称这一对训练样本就是全部想法。
- 控制信号是一对定界标记夹住带重音的音节串,撇号标重音核、斜杠标短语边界;跨主干只改标记拼写。
- 教师取法在四个主干上并不统一,论文自己写明这一点:两个主干每个词取 10 个载体、取第一个通过退化守卫的结果(4,830 个教师一个未丢、没有读法检查);另两个主干每个词取 4 个载体、取前端读法错误率最低的结果。
- 文本集合为 533 个词乘 10 个载体,覆盖四类重音,并把一种孤立时听不出差别、重音落在后接助词上的类别过采样到 15%;与三个评测集冲突的 50 个词被删除,训练与评测词表按构造不相交。
- 部署形态是注册表加路由器:先跑公共前端整句,在词素边界匹配注册的表层形式,只给匹配到的跨度包标记;当前端把后缀附着上来时把后缀吸进包裹内,否则模型会在重复音节上打转;匹配不到就回退到未编辑基线并记录编辑未触发。
- 关键定量结果(含比较对象与口径):读法评估用 319 个未见过词、每个测试项固定一个留出声线、单词元约束的识别打分、按词聚类的 95% 自举区间与精确 McNemar 检验。相对不编辑,四个主干分别 +0.310、+0.470、+0.251、+0.354,论文称每个区间都远离零;但相对纯音素输入,该方法在三个主干上反而低 0.069 到 0.091,只在开发主干上统计上不可区分。与有录音数据的适配器对照,本方法在那一主干上低 0.107(区间 [−0.160, −0.056]),重音维度上低 0.30。重音用 473 句完整句子盲听、随机顺序、每句固定一个留出声线:开发主干上规定重音实现率 0.89,对纯音素输入 0.57(风险差 +0.32,Holm 校正 p=2×10⁻⁴),音素输入在配对里一场都没赢;拆开判错来源后,去掉读法失败两者打平(0.89 对 0.94),说明相对不编辑的增益本质上是读法;另一个主干上与不编辑完全打平(0.78 对 0.78)。自然度不用绝对评分表,改让听者在「有编辑的版本」「未编辑的版本」「听不出差别」三项里选一项,3,228 个判断、168 对;「偏好未编辑」减「偏好编辑」的比例在四个主干上分别为 −0.08、+0.43、+0.33、+0.30,预先注册的非劣性边界 0.15 只在开发配方的主干上满足。评分员准入线是 19 题已知答案题里过 18 题且第一次尝试即为准,32 名候选里最终 4 人通过;评分员一致的 Fleiss κ=0.85,在任何系统比较之前先报告。7
- 证据强弱与复现边界:筛选式听测准入、κ 先行、Holm 校正、预注册非劣性边界、按哈希预分配声线,这套人评流程可以直接照抄;负面结果也写得清楚。边界:单语言、4 名评分员、一套未调参就搬到其他主干的配方、教师取法不均匀,均为作者自述;论文声明已发布全部资源,但全文与摘要页都没有任何链接,本次实测取不到;方法仍然依赖公共前端提供读法、公共识别模型做结果选择、部署期依赖注册表与路由器。
- 对目标研究线的连接点:直接命中 TTS 生成与评估,也是本批在人评口径上最值得学的一篇。「用模型自己的输出造教师、只装一个极窄通道」的自蒸馏范式,对自进化线的「不改主干、只装技能」同样适用。
- 结论与阅读建议:建议精读。引用时两条不能省:重音在其中一个主干上没有提升,自然度在三个未调优主干上有回归。
- 入口:音频栏 · arXiv
3. LACE: Layer-Wise Compression for Dynamic Frame Rate Codecs(arXiv:2609.17509,直接命中·音频栏)
- 研究问题:神经音频编解码器帧率高导致离散码序列长,既推高变换器的计算成本,又造成语音与文本的 token 长度失配。已有的动态帧率方法要么只在单层码本上做,要么在多层量化之前只压缩一次,迫使所有量化层共享同一套分段边界。
- 改动位置(维度):改模型(编解码量化流程)加改数据表示(token 表示改为码加时长),并相应改下游语音合成的预测目标。
- 核心方法机制:
- 在每个量化层独立对该层残差做一次压缩,得到该层自己的分段边界与时长;为算下一层残差,需要把段级码按时长展开回帧级,因此下一层残差同时含压缩误差与量化误差。方法对压缩模型本身不敏感,论文把三种既有压缩模型都当作可插拔的压缩步骤。
- 各层边界不同会让覆盖同一时间跨度的码有不同时长,于是取各层边界的并集重新分段,使所有层共享同一套边界与时长,代价是有效帧率上升。
- 为避免最坏情况下并集趋近全长、压缩收益归零,引入锚层:不超过锚层的层可引入新边界,超过锚层的层只能复用已有位置;锚层是可调超参。
- 理论分析给出残差误差上界:共享边界时压缩误差会穿过全部量化层、成为量化无法消除的地板,而逐层压缩把上界压到零。论文注明该上界只关乎编解码量化误差,不含下游合成。
- 关键定量结果(含比较对象与口径):重建任务在 5 组主干与压缩模型组合上全部优于单次压缩,且都匹配在约 8.6 kbps(未压缩为 24.00 kbps)。最直接的一组:同一主干与压缩模型下,有效帧率 22.5 Hz 对 27 Hz,字错率 2.22 对 4.92、感知自然度 3.81 对 2.49、语音质量 3.08 对 1.61。有效帧率覆盖 22.5 到 75 Hz。合成语音侧的实时因子只在相对不压缩时更低(1.58 对 1.95),相对同参数下的单次压缩反而更高(1.01)。评测口径有两处必须披露:合成是非确定的,每个输入生成 10 条候选、按小模型的字错率选最低的一条送评,为此论文另报 10 条候选的均值字错率(两档参数下 14% 对 61%、14% 对 21%,排序一致);人评为随机抽 25 条测试句、35 名评分员、报告 95% 置信区间,单次压缩与不压缩的主观质量很接近但配对 t 检验显示评分员仍能区分(p<0.01)。23
- 证据强弱与复现边界:重建侧的五组交叉对照扎实,且在未微调的预训练模型上就已优于单次压缩,是本篇最强的结论。边界:合成语音侧只做一个主干、压缩参数(论文记作 γ)只测两档、锚层只测两个取值,没有报告种子;锚层超过 2 不再提升质量反而让字错率变差(4.93 对 8.52),作者提出的重复码标识偏置假设与相应采样改进都列为未来工作;代码称随一个开源语音工具链发布,但具体交付物本次未能定位;人评没有与人类录音上限的对照,也没有评分员一致性指标。
- 对目标研究线的连接点:直接命中 TTS 生成与评估,尤其是 token 表示改了之后合成侧评估该怎么拆。把序列长度与质量的权衡变成两个显式旋钮、并用可证上界说明为什么逐层优于共享边界,这个论证范式可以搬到任何长序列任务。
- 结论与阅读建议:建议扫读为主,重建与合成两张表和结果讨论精读。只取一件东西的话,取它的「压缩参数、锚层、有效帧率、码率、实时因子、字错率、主观质量」完整权衡表与重排口径那一段。
- 入口:音频栏 · arXiv
播客生成与评估:本批的缺口审计与可迁移接口
本期两个已发布栏目共 81 篇,逐条清点后,「端到端自动做出一期播客节目」与「评估一期节目的整体质量」仍然没有直接命中。没有任何一篇把这两件事当作核心研究问题,也没有出现以播客为对象的长音频基准、多说话人轮换协议或话题编排评测。
本期换了核实路径。前几期是在三个栏目内按关键词检索,本期改用两层扫描:先把这个批次当日发布的全部条目当作整体枚举(当日有人工智能、计算机视觉、机器人、语音与音频与统计学五个栏目,自然语言处理栏目未发布),逐一比对标题与分区归属;再对两个允许栏目的正文做中英关键词全文扫描(播客、节目、双人对话、多说话人、长音频、podcast、episode 等),命中为 0。结论是:缺口出在来源侧的选题口径上。该账号把长音频相关论文归入语音与音频栏的「语音合成与声音生成」「多模态音频与视听学习」等分区,这些分区里没有以「一期节目」为单位的对象。
所以本期仍以组件级接口承担可迁移价值。下面三篇每一篇的结论都只到组件层,节目级结论不支撑。
1. Audio-Visual Turn-taking Prediction in Cocktail Party Scenarios(arXiv:2609.17056,邻近跟踪·音频栏)
- 研究问题:在干净受控数据上训练的预测式轮流说话模型能否泛化到鸡尾酒会场景(重叠说话加背景干扰);音频与视觉两种模态的泛化行为是否相似;简单的域内微调能否适应。
- 改动位置(维度):只改数据与评测——把为音视频语音识别开发的语料改造成轮次预测测试床,自行定义轮换标签的推导规则并人工校验;另做权重微调。
- 核心方法机制:用句子级起始时间戳作候选点,阈值从文献常用的 200 到 250 毫秒放宽到 2.0 秒(依据人工检查,因为标注本身有 0.5 到 1 秒偏差);三种变体分别是双通道音频、双通道视频特征与早融合;音频用预训练对比预测编码特征,视频用面部关键点与动作单元共 60 维;用信噪比估计把「干净」与「噪声」从形容词变成数字;把预训练数据量按 6、50、100、300 小时分层采样做消融。
- 关键定量结果(含比较对象与口径):干净域到鸡尾酒会域的加权 F1,多模态 82.57%→56.61%,音频 81.05%→49.83%(随机基线 45.08%),视频 70.68%→69.23%(t 检验 p=0.3689)。域内微调把多模态抬到 73.65%,代价是原域相对下降 3.60%;音频模态微调后反而降到 47.49%。信噪比上,干净语料中位在 90 到 100 分贝,鸡尾酒会语料约 15 分贝。24
- 证据强弱与复现边界:这是本批唯一做了 t 检验的音频工作,代码与轮次标签数据集实测都能访问。边界:只取双人对话;语料不再分发;放宽到 2.0 秒的阈值只对该语料成立;没有报告种子与误差棒。
- 对目标研究线的连接点:可搬走的是整套路迁移评测模板——干净域预训练、噪声域零样本评测、域内微调、原域遗忘量与预训练规模消融,以及「合成扰动不如真实分布数据」这条对照。对播客线属组件级:轮换预测可以作为多说话人轮转结构的信号源与评测维度(换手与保持的预测、重叠率、信噪比分布),节目级结论不支撑。
- 结论与阅读建议:邻近跟踪,标签定义与结果口径两节精读。
- 入口:音频栏 · arXiv
2. CLASH: Counterfactual Auditing of Lexical and Prosodic Reliance in Spoken Sarcasm Detection(arXiv:2609.16582,邻近跟踪·音频栏)
- 研究问题:常规评测看不出一个口语理解系统究竟依赖词汇内容、韵律,还是两者的交互。论文要回答的是「模型是否真的用了某个信号」这件事该怎么变成可核对的证据。
- 改动位置(维度):只改评测——输入侧反事实改造,检测器参数在所有条件下保持冻结,不训练也不微调。
- 核心方法机制:
- 每条话语生成四个配对版本:原始、保留词汇并压制韵律、保留韵律并破坏词汇、近似中性化,做话语内配对对比。
- 把两个量拆开:分数敏感性是配对差的大小;讽刺判别是配对差是否携带标签信息。第三层是固定阈值下的二元预测。
- 稳健性上按时长分位分箱做等权加权、按对话或说话人做聚类自举、并补同身份内部的对比。
- 另用另一条合成路径复现同一对照,检验结论是否只对某一种信号处理实现成立。
- 关键定量结果(含比较对象与口径):双语语料(普通话 3,960 条、英语 690 条),同等时长加权后,保留词汇与保留韵律的判别差在普通话上 0.148(2,000 次聚类自举的 95% 区间 [0.103, 0.193])、英语上 0.135([0.094, 0.210]),四个区间都不含零。声学敏感性与判别是分开的:保留韵律相对近似中性化提高对数几率的话语占比达 74.8% 与 82.5%,而两种条件下二元预测全部判为非讽刺,配对差的曲线下面积只有 0.566 与 0.524。在声学特征探针上该优势不成立(英语上 −0.023)。25
- 证据强弱与复现边界:这是本批方法可迁移性最高的一篇,「声学敏感但判别接近随机」这个自带反例能防止把「分数变化」误读成「能力提升」。边界:改造做不到完美的线索分离;近似中性化保留时序与处理效应,因此不是无信息基线,把它当零假设会直接得出错误结论;探针有跨语料迁移问题;语言与语料同时变化,无法分离文化机制;结论被作者限定为模型特定。
- 对目标研究线的连接点:它把归因从相关性升级为配对反事实审计,可以直接用来审计一个语音评测模型或偏好模型到底在听声学还是读转写。对播客线属组件级评测方法,节目级结论不支撑。
- 结论与阅读建议:建议精读方法与两组结果,表格数据扫读。
- 入口:音频栏 · arXiv
3. SongCraft: Unified Song Generation and Editing with Reconstructive Learning(arXiv:2609.16315,邻近跟踪·音频栏)
- 研究问题:歌曲生成与歌曲编辑长期被当作两个任务:已有的编辑方法要么需要加噪重生、输出随机且大改动失效,要么需要人工指定编辑边界、只能做时间局部改动,要么需要精心构造的成对数据。
- 改动位置(维度):改模型(统一生成与编辑的架构与训练目标)加改数据表示(把歌曲分解为稀疏与稠密两档可解释属性条件)。
- 核心方法机制:把生成与编辑看成条件谱的两端,训练时按概率在稀疏条件(文本描述、歌词、节拍位置)与稠密条件(再加词级时间戳、演唱音高、和弦、说话人嵌入与一个残差音频编码)之间切换,最小化同一个流匹配损失;推理时生成只给稀疏条件,编辑则抽出稠密条件、改其中一个属性、其余固定。把表示对齐扩到变分自编码器隐空间,先用一个自监督音乐编码器对齐隐表示再送入生成网络;词级音素对齐用三类互补位置嵌入,让模型隐式学到时间对齐而不需要帧级监督;节拍条件把拍点编成三类帧对齐嵌入,论文称此前没有工作探索歌曲生成里的显式节拍条件。
- 关键定量结果(含比较对象与口径):945 首留出曲目、30 秒片段、48 kHz 立体声。分离人声上的字错率 0.133,为全场最低(次优 0.193,相对改善 31%),但两项自动感知质量指标都排第二(感知美学均值 7.45 对 7.60,歌曲评测均值 3.62 对 3.95)。主观评测由声乐与音乐专业人员按六个维度打分,五维最高、六维均值 4.40,音质一维略低于对照的 4.488;论文未报评分员人数与一致性,也没有显著性检验。消融里去掉节拍条件反而得到最低字错率 0.105 且收敛最快,但音乐性、自然度与连贯性都下降,论文指出字错率更差的配置感知质量更高这条反向关系贯穿全部配置。残差编码器瓶颈从 1 扫到 150 时,三种编辑指标都逼近地板值,说明瓶颈过大时残差会绕开显式条件、编辑性消失。26
- 证据强弱与复现边界:这是歌曲类的生成与编辑任务,与语音合成分属两个任务;评测集为内部数据,全文没有任何开源或数据入口;主观评测没有报告规模与一致性;只在 30 秒片段上做;换声这一种编辑被作者自己列为不可靠。
- 对目标研究线的连接点:对 TTS 生成与评估线可迁移三点——用分离人声上的字错率作可懂度客观指标,并同时并列两个自动感知族与多维人评;音素信息与语义信息互补的条件对照(只用音素 0.911、只用文本 0.329、词级对齐 0.133);把可编辑性量化为「改一个条件、其余固定」,并用瓶颈扫描画出重建保真度与可编辑性的曲线。对播客线只是邻近,节目级结论不支撑。
- 结论与阅读建议:建议扫读为主,两张结果表与消融一节精读。
- 入口:音频栏 · arXiv
机制地图与同维度横向对比
长程评估:三类让分数失真的机制,各自有解
判官不可靠这一类,本批给出的解是绕开判官:用预先登记、生成时看不到模型输出的二元清单,配合可按精确答案判定的任务,把主指标从判官分数换成客观完成率。Never Stop Thinking 的对照最干净:同一批转写换判官即翻负,两个判官的排序相关系数 0.07;换成 200 个可验证任务后,完成率从 48.5% 做到 80%。1 BLINDSPOT 给出的解是把判官夹在确定性检查之后:只看最终回复与最终标签的一致率 71%,确定性检查加语义判官是 96%。2
终态打分饱和这一类,解是把评判下沉到阶段与产物。CADWorld 干脆不用判官,对保存的工程文件跑可执行检查并给出 11 类确定性失败原因,于是「模型结束了任务但结果是错的」与「模型连产物都没生成」可以分开数:较弱模型里过半失败落在后一类。3 同一条线上还有一篇把「局部仍然合法、全局状态已经崩」单独量出来的工作,局部与全局落差在 GAIA 的一级中间结论步上达到 0.857。14
参考会过期这一类,解有两层。LSREP 允许参考答案随着检查点演化,只要求它由该检查点之前的历史推导,并把参考放在系统检索不到的地方;ground-truth-as-code 则把参考写成一个可执行函数,在评测时从实时数据重算。89 需要注意后者的报告实验里,参考函数实际执行的是检索并格式化参考资料,与摘要主张的实时重算存在张力。
自进化:改的层次、有无冻结对照与报告口径
| 论文 | 改的层次 | 冻结对照 | 增益的报告口径 |
|---|---|---|---|
| ScienceBuddy · 2609.17523 | harness 与权重,两层各自冻结另一端 | 有,逐环节配对且用独立验证集 | 验证集准确率、pass@4 覆盖率、留出集配对转移 |
| Turn-level DRE · 2609.16760 | 权重(回合级信用分配) | 有,同基座多个基线加两个消融变体 | 环境平均奖励,已见与未见划分分开报 |
| EchoPath · 2609.16635 | harness(执行级记忆) | 有,同任务两遍加一个规划增强基线 | 成功率、中位令牌、中位时间 |
| ReDraft · 2609.16639 | 训练目标与训练数据 | 有,同预算对照,并把对照的预算延长 70% | 目标准确率增益与 8 个旧能力基准的宏平均损失 |
| ThinkFlow · 2609.17010 | 权重加轨迹表示 | 部分,同类方法对照,无种子 | 生成质量四指标与记忆问答准确率 |
| Interactive Memory Learning · 2609.17088 | 权重加 harness | 有,自动指标加带检验的人工胜率 | 生成质量、记忆检索胜率、漏存率曲线 |
| SEAA · 2609.17331 | 技能与状态表示 | 有,纯文本反思对照加学习率取零消融 | 数值仿真上的四个群体级签名 |
| Metacognitive Steering · 2609.16245 | 推理期控制器 | 无任务成功率层面的正面对照 | 控制面定位的统计量与定性轨迹比较 |
| World Model Science · 2609.17419 | 只改评测(测量框架) | 有,每个签名配统计零模型而非系统干预对照 | 各签名的效应量与错误发现率校正结果 |
表里可以读出两件事:八篇里每一篇都给出了至少一组冻结对照;而报告口径的完整度差别很大——同一批里既有把损失定义式、8 个基准与归一化方式全部写出的,也有只给点估计、没有种子与检验的。跨方法比较增益目前做不到,因为单位不同:有的是环境平均奖励,有的是通过率,有的是令牌数。
TTS 评估:四类口径各自回答什么
均值回答平均质量,也会掩盖最差情况。同一篇工作里,未处理时 1500 词以上的最差情况是 35.2%;换成跨 10 个随机种子的最差情况作主指标之后,各长度上的均值落在 2.5% 到 2.9%。两个数分别描述处理前后,放在一起看,均值口径会把最坏的那一档完全盖住。6
最差情况与滑窗回答可靠性。跨随机种子取最差、用 8 秒窗 4 秒步长取最差滑窗相似度,这两招把「语音克隆在长参考音频上会不会崩」变成一个可比的数。
人评准入与一致性回答「这个判断能不能算数」。过筛用了 19 题已知答案题里过 18 题,评分员一致性系数在任何系统比较之前先报告,再讨论非劣性;这套顺序值得照抄。7
挑选口径必须披露。合成是非确定的,如果按某个自动指标从多条候选里挑一条送评,那个指标就不再是独立评估器;LACE 的做法是把挑选口径写出来,再补一个不挑选的均值指标做稳健性检查。23
全量覆盖审计与数据缺口备忘
1. 两个已发布栏目 81 篇论文的全量覆盖审计
人工智能栏目 72 篇分在 6 个分区:智能体、规划与决策 8 篇;知识表示、推理与符号 AI 3 篇;机器学习与表示学习 2 篇;自然语言与多模态智能 31 篇;评测、基准与数据集 3 篇;其他与综合 AI 25 篇。语音与音频栏目 9 篇分在 6 个分区:语音识别与关键词检测 1 篇;语音合成与声音生成 3 篇;语音翻译与语音语言模型 1 篇;多模态音频与视听学习 1 篇;数据集、基准与评测 1 篇;其他与综合语音音频 2 篇。
分层收录 26 篇:直接命中 17 篇(长程任务训练与评估 6、轨迹学习与自进化 8、TTS 生成与评估 3、播客生成与评估 0),邻近跟踪 9 篇。自然语言处理栏目本期未发布,所以本期不是三栏目齐备的候选池,分层结论只覆盖这两个已发布栏目。
2. 播客生成与评估:专项缺口备忘
本期在已发布的两个栏目里,端到端播客节目制作与节目级评估都为零直接命中,缺口出在来源侧的选题口径上。
3. 代码开源、复现条件与跨源口径披露
声明已发布或可访问、实测取不到:Never Stop Thinking 论文给出的代码链接返回 404,该组织的 26 个公开仓库里没有同类命名,官网可访问并展示已发布文件与 990 条轨迹,但没有替代的仓库入口 1;EchoPath 声明的代码包同样返回 404,用户主页可访问而仓库不存在 5;SEAA 用现在时声明原始数据与脚本已发布,但全文没有一条 arXiv 之外的外部链接 15;自蒸馏发音控制那一篇声明已发布激励材料、评估脚本、文本集合、教师集合、适配器权重与训练代码,但全文与摘要页都没有任何链接 7;SKIP 用陈述句声明数据与代码可用,仓库存在却为空,没有分支也没有提交 18。
未提及发布:Skill-based Agentic Evaluation(2609.16487)、Turn-level Multiscale Density Ratio Estimation(2609.16760)、ReDraft(2609.16639)、ThinkFlow(2609.17010)、Interactive Memory Learning(2609.17088)、Metacognitive Steering(2609.16245)、SongCraft(2609.16315)、Position: AI Is Not Ready for Strategic Conflicts(2609.16189)、Intrinsic Motivation in Reinforcement Learning(2609.17325)与 QART(2609.16887),全文都没有可克隆的代码或数据入口;Symbolic Separation(2609.17107)只给出检索查询数据集入口,代码部分未声明开源。可访问的有:BLINDSPOT 的官方仓库(含数据分片与 250 条样本轨迹)、World Model Science 的代码仓(含三个实验目录)、ScienceBuddy 的代码仓与官网(开源的是简化实验实现,产品源码未包含)、轮次预测的代码仓与标签数据集、反事实审计的代码仓、专家引导评测集框架的仓库(声明现在时且实测可达,但未发布生成的数据集)、符号分离的检索查询数据集入口。
论文内部口径不一致:BLINDSPOT 正文写一半延迟失败在第 11 轮、图注写第 9 轮,论文写 35 个场景而官方仓库写 65 个;CADWorld 的成功率存在 17.5% 与 25.0% 两个口径且原文未调和;ScienceBuddy 论文 v1 的循环配置与仓库自称的当前配置不一致,仓库明说以当前配置报告;回合级信用分配的表注写 5 次运行、附录写 3 次,正文「超出约三点」与表中 1.6 点不符;LACE 的锚层设置是消融出来的而正文未强调;SongCraft 页内日期字段与 arXiv 提交日不一致,属原文自身字段问题。
公众号转述与原文的出入(均已按 arXiv 原文更正后写入正文):机构类有七处漏列或缺失——CADWorld 漏列第二个机构、LSREP 漏院系与地点、EchoPath 漏第二署名、SEAA 把署名机构留空(原文为独立研究者)、ScienceBuddy 整段缺机构(原文列 9 家)、自蒸馏发音控制未列机构、长文本语音合成只列一家而原文有三家。规模与结论类:BLINDSPOT 栏目未给任何规模数字,并把描述性表述译成中文的「显著差异」;CADWorld 只给 17.5% 而漏掉 25.0% 口径与 87.0% 的人类对照;LSREP 的英文摘要被截断、最不利结论被弱化;ScienceBuddy 把两层冻结对照的增益压成一句「持续提升」;回合级信用分配把原文的「有竞争力」写成「优于」;EchoPath 的「显著降低」没有给比较对象;自蒸馏发音控制把只在开发主干成立的结论写成「多个模型上成立」;LACE 把相对不压缩成立的加速写成无条件提升;符号分离把跨模型的对照写成单变量提升。命名类一处:交互式记忆学习的方法名缩写与一个机器学习会议同名,栏目直接照抄,容易被读成会议来源。
4. 本期未解决的问题
本批没有一篇把自进化的成本与增益放进同一张表。ScienceBuddy 只给了训练时长(约 2 小时)与单次运行,回合级信用分配完全没有成本口径,EchoPath 的成本只覆盖令牌与墙钟时间而不含第一遍构造的人工投入。跨方法的性价比目前无法比较。
本批多篇的增益集中在分布外划分或个别设置,而作者只给点估计:回合级信用分配的已见划分与消融变体差在标准差内、ReDraft 有两处阶段表现低于对照、ThinkFlow 在另一个主干上多项指标落后。没有跨种子方差,无法判断哪些增益能复现。
语音评估侧的公开语料仍集中在短句与短片段。长文本语音合成借用的评测语料是语音识别语料,人评与统计检验在长音频上仍是空白;轮次预测只覆盖双人对话;歌曲生成只在 30 秒片段上做。分钟级乃至更长的音频,在生成与评估两侧都缺公开对照。
References
- 1
- 2
- 3
- 4
- 5
- 6Taming Long-form Text-to-Speech
arxiv.org
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20
- 21
- 22
- 23
- 24
- 25
- 26
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.