9月18日论文雷达:驾驭层可剖析可回归、自进化按层与分母记账、TTS 判官把四维压成一位:长程智能体与生成式音频的 46 篇分层雷达
本期从 9 月 18 日三个栏目 168 篇论文中分层收录 46 篇:长程智能体的增益被拆成到达率与完成率两个可分别测量的量,驾驭层组件按窗口预算与模型规模条件定价,自进化按技能图、搜索信号与优势分母分层记账,TTS 多维判官的维度耦合被量化并给出去耦版本。

本频道盯「arXiv 每日学术速递」的三个栏目:人工智能、自然语言处理、语音与音频学术速递。2026 年 9 月 18 日 12:10:29(GMT+8),该账号发布了当日的图文批次(批次编号 mid=2247745255),人工智能学术速递 89 篇、自然语言处理学术速递 72 篇、语音与音频学术速递 7 篇,三栏齐发共 168 篇。逐条读完后收录 46 篇,直接命中 35 篇、邻近跟踪 11 篇。这 46 篇的 arXiv 编号与本频道已发 30 期覆盖的 416 个编号逐条比对,零重复。
本频道的候选池固定为该账号这三个栏目;arXiv 摘要页、arXiv 原文,以及论文原文明确链接的作者官方代码仓库、项目页、数据页,本期只用于核验。同批次还发布了计算机视觉、机器学习、机器人、统计学四个栏目和一篇单篇论文导读,当日 17:14 另有第二组单篇导读,都不在允许范围内,没有进入候选池。
本频道持续关注四条线:大模型长程任务的训练与评估、轨迹学习与自进化、TTS 生成与评估、播客生成与评估。本期直接命中 35 篇按线分布为:长程任务训练与评估 20 篇、轨迹学习与自进化(含长期记忆、技能库与评测协议)13 篇、TTS 生成与评估 2 篇、播客生成与评估 0 篇。46 篇按阅读优先级分为 1 级 18 篇、2 级 25 篇、3 级 3 篇。
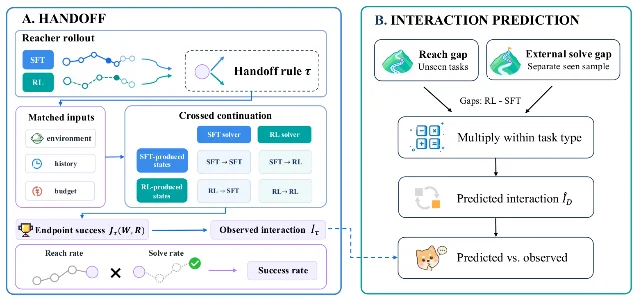
长程智能体的增益第一次被拆到「走到哪」和「到了之后做成什么」两个可以分开测量的量上。 把 SFT 检查点和 RL 检查点停在同一个状态上交叉交接,端到端成功率就被拆成 REACH(到达与成功相距固定步数的状态)与 SOLVE(从同一个克隆状态完成);五个条件下到达者与解决者的交互项下界全部为正,例如 ALFWorld 未见任务 +24.2 个百分点,区间 [13.3, 35.0]。同样一批 ALFWorld 未见状态上,SFT 检查点到达率 13.3%、RL 检查点 82.5%,而从同一批 115 个克隆状态出发,SFT 求解 56.5%、RL 95.7%——端到端差距里有 39.1 个百分点来自「到了之后做不做成」,区间 [29.8, 48.4] 1。
同一个驾驭层里的组件不是同一种商品,价值随窗口预算和模型规模换向。 固定执行循环、只变上下文管理、规划与动作空间,176 个设置在 SWE-Bench Verified 与 Terminal-Bench 2.1 上跑完:上下文管理把 32k 窗口的成功率抬 35.7 个百分点,到 128k 只剩 2.7;规划开关让 30B 模型在 SWE-Bench 上 +11.6 个百分点,到 550B 则转变为成本降约 30% 而成功率降 2.0 个百分点 2。把「计划里的信息量」和「只是字数变多」用词数匹配的乱序对照分开后,265 个匹配格上 oracle 成功率相差 +7.17 个百分点,区间 [1.15, 13.36];但经 Holm 校正,模型特定的那几组对比没有一组达到显著 3。
自进化这一批几乎全部只改一层,并且开始给「换掉最贵的评估环节」定价。 把自进化里最昂贵的下游评估换成判官成对比较加 Bradley–Terry 排名来驱动搜索,Polyglot-225 上 31.1 对 DGM 的 27.1,而同一设置去掉判官只有 29.8、低于 DGM;代价是 34.3 美元 API 与 224 CPU 小时,论文正文另一处又写 42 CPU 小时与 150 美元 4。另一篇只把组内优势的分母换成 MaxNorm 并配一套奖励分辨率协议,Qwen3-32B 在 AIME25 上 84.2±1.2 对预设 p90 参照的 79.4±0.9,六个评测单元全部为正,5 个种子 5。
TTS 评估这条线出现了「判官自己会被维度耦合证伪」的量化。 从 Gemini 蒸馏出的平价韵律判官,在标准多维设定下把各个维度的分数一律对齐到总体偏好,140 个多维样本上有 0 个给出彼此独立的核心维度判断;删掉总体裁决、按不确定的成对-维度掩码做监督微调、再把归一化后的优势只落到对应 rationale 段,同一批样本上独立判断升到 71.4%。Best-of-8 候选中,它在 400 组里选出 136 组两名标注者都给出高置信排序的结果,Hit@1/2/3 分别为 72.06%/77.94%/85.29%,随机期望是 12.5%/25.0%/37.5% 6。
先看哪几篇:46 行阅读优先级全景表
本表坚持一行一篇论文。层级说明:直接命中指研究问题本身落在本频道的四条目标线上;邻近跟踪指研究问题在相邻方向、但对目标线有明确可迁移接口的论文,连接点写在正文章节里。优先级判定依据三条:与四条目标线的贴合度、方法或评测设计能否被直接搬走、证据本身的可核对程度。表中数字均注明比较对象与口径;1 建议精读原文,2 值得扫读原文,3 只按连接点取用、不必通读原文。下面各篇的入口一栏同时给出该篇所在的公众号栏目与 arXiv 原文两个入口。
| 优先级 | 层级 | 论文(英文原题 · arXiv ID) | 改动位置(维度) | 核心可比结果(含比较对象与口径) | 阅读风险与证据局限 | 入口 |
|---|---|---|---|---|---|---|
| 1 | 直接命中 | Reach or Solve? Attributing Agentic RL Gains with Checkpoint Handoffs · 2609.19636 | 只改评测协议,用克隆状态交接,不重训 | TravelPlanner 1.5B/3B/7B 交互项 +17.8[9.4,26.1]、+14.4[6.1,22.8]、+10.6[0.6,20.6] 个百分点;ALFWorld 未见 +24.2[13.3,35.0];115 个克隆状态上 SFT 求解 56.5% 对 RL 95.7% | ALFWorld 每划分仅 30 任务、115–117 状态;无公开代码;结论为行为层 | 栏目 · arXiv |
| 1 | 直接命中 | An Architecture for Long-Horizon Agents: Levels, Ticks and Cascaded Intelligence · 2609.19519 | 只改驾驭层:按时间尺度分层、时钟 tick、失败送审才升级 | 十天战役:driver ticks 211、context resets 47、升级 25 次、关键发现 7 条、GPU 2,215/3,000 小时;未 steer 的 worker 会话停在 958 秒/步,steer 后 180 秒/步 | 单案例存在性证明,无基准、未报告模型与规模、无种子;全文无本文 artifact 入口 | 栏目 · arXiv |
| 1 | 直接命中 | AgentPProf: Semantic Profiler for Long Horizon AI Agents · 2609.20301 | 只改观测层,离线语义剖析器,不动执行循环 | CodeTraceBench 405 条轨迹 B³ F1 0.764 对最强自动基线 0.663;440 条 web 轨迹中失败运行 44.6% 步数耗在 recover、成功运行 12.0%;23 个留出场景降 agent 侧 token 19.0% | 摘要称 MAP 最多 +56%,正文只给绝对增量 0.031/0.107/0.117,无法复算;自动分割一次性 37 分钟 | 栏目 · arXiv |
| 1 | 直接命中 | An Empirical Study of Harness Design for Coding Agents · 2609.20804 | 只改驾驭层,执行循环固定,扫上下文管理、规划、动作空间 | 176 个设置:上下文管理在 32k 抬 35.7 个百分点、128k 只剩 2.7;30B 规划开 +11.6(SWE);动作空间 30B 预定义工具 +15.0%,550B 反过来只 bash +3.6% 且成本降 53% | 每设置每任务单次运行;Terminal-Bench 2.1 仅 89 题;动作空间为打包改动 | 栏目 · arXiv |
| 2 | 直接命中 | How Do Agent Harnesses Create Value? Planning Information and Release Control in Stateful LLM Agents · 2609.20474 | 只改驾驭层的规划信息与放行控制,词数匹配乱序对照 | 265 个匹配格 oracle 成功率 Fixed 对 Sham +7.17[1.15,13.36] 个百分点;Sham 对 Minimal +1.89[−3.45,7.09] 跨零;高危损失层验证器增量成本约规划器的 12 倍 | Holm 校正后模型特定对比全部不显著;网格缺 213/1,440;计划由人工撰写 | 栏目 · arXiv |
| 2 | 直接命中 | SIMLIFE: Pattern Understanding for Long-Horizon Human-Agent Partnership · 2609.19610 | 改环境与评测协议,另适配既有记忆与检索架构 | SimLife-BP 106 集、1,439 题:最强配置 Gemma-4-31B-it 的 AC 36.2%;反事实减无关线索差距在 V+L/L/L-N 三档为 4.2%/16.2%/32.1%;人类对假设消除 78.1% 对模型最强 40.5% | 项目页的代码与数据按钮无下载目标;The Sims 4 非确定性;人类对照 12 人且信息不对称 | 栏目 · arXiv |
| 1 | 直接命中 | Refuse, Decompose, Refresh: A Claim-Safe Protocol for Closed-Loop AI Evaluation · 2609.20538 | 只改评测协议:弃权、分栏报告、参考重算 | 独立验证器 56/56 通过;稳定误纳 0/20 组件,单侧 95% 上界 0.1391;流量模型每单元-臂行 NLL 好 0.1264 nats[0.0593,0.1918];漂移检测在 λ0=7 时 0/15 报警、λ0=5 时 15/15 | 单一模拟器与组织配置;无第三方复现;Refresh 未验证新数据能修复过期参考图 | 栏目 · arXiv |
| 1 | 直接命中 | JustMem: Just-Enough Memory Access for Long-Term Conversations · 2609.19877 | 只改记忆访问策略:发现广度与读取保真两维可调 | LoCoMo 79.61±0.12 对 LightMem 79.08±0.26(+0.53,p=0.532);LongMemEval-S 83.40±0.24 对 76.44±0.17(+6.96);全局原子 Top-10 79.81% 对会话优先 74.29%(p=2.54e−10) | LoCoMo 主结论不显著;效率只统计生成 token;无公开代码与数据 | 栏目 · arXiv |
| 2 | 直接命中 | To Memories and Beyond: From Remembering to Knowing You across Long-Term Multimodal Personal Archives · 2609.19167 | 改评测基准与记忆画像模块,不动权重 | ReaLMem 三层九子任务:预测性个性化 T3 上 Gemini-3.0-Flash 59.2%、GPT-4.1-mini 57.9%;加时间稳定性先验后 GPT-4.1-mini T2 78.3(+4.0)、T3 61.4(+3.5);带字幕 82.6% 对仅视觉 57.4% | 仅 7 名参与者、单次评测;无公开数据入口;T3 对记忆覆盖不敏感 | 栏目 · arXiv |
| 2 | 直接命中 | Continual Enterprise World Model Discovery in Dynamic Systems · 2609.19551 | 改驾驭层与持久世界模型,权重不更新 | 600 题/骨干:预测隐藏规则效果 IoU 领先 6.99–8.98 个百分点且 0 次活查询;精度 91.15 对 82.47;Gemma-4-31B 上 3 种子均值 87.85(sd 2.03)对 83.02(sd 2.70) | 仅一个骨干做多种子;评测动作由作者选定;建在 live ServiceNow 上难以外部复建 | 栏目 · arXiv |
| 2 | 直接命中 | Beyond Depth Truncation: Controlled Evaluation of Depth Utilization in Recursive Language Models · 2609.19934 | 只改评测协议,加正控制、负控制与受控训练干预 | 朴素深度截断 k=1→k=8 降 1.4251 nat;拆成四分量后「不同迭代」只占 −0.0392 nat(−2.8%),校准占 0.3645 nat(25.6%);后训练检查点上不同迭代 +0.0022 nat | 单一递归架构、542.8M 且欠训练;bootstrap 不含检查点与种子方差;无公开代码 | 栏目 · arXiv |
| 2 | 直接命中 | Replan, Repair, or Edit? A Unified Empirical Evaluation of Travel Agents for Itinerary Revision under Resource Disruptions · 2609.19654 | 只改评测协议:效果、稳定性、成本三维加配对子集比较 | 单一中断 500 例:LLM-Z3+Gemini 485/500、IPyHOPPER 484/500,原文称不支持有意义排名;配对 346 例编辑次数 6.809 对 1.000、保留率 64.70% 对 92.68%;复合中断 200 例 LLM-Z3 186/200 最高 | 无种子与重复,微小差异无法与方差区分;合成中断;各策略在候选与预算上不对等 | 栏目 · arXiv |
| 3 | 邻近跟踪 | Diagnose, Recover, Certify: Task Readiness under Hidden Dynamics Changes · 2609.20304 | 改决策算法:诊断、恢复、认证三段协议 | 严重度 0.20 下 regret 0.819±0.008 对随机 0.854±0.008,回报 0.850±0.009 对 0.678±0.004(4 个 MuJoCo);6 个系统中 4 个取得最强选择性回报 | 属控制与强化学习侧,非语言智能体;证书依赖校准后的联合模型;HTML 表错位,端到端数值难复原 | 栏目 · arXiv |
| 1 | 直接命中 | Self Improvement via Fast Tree-search · 2609.19526 | 改搜索层与信用分配:判官排名驱动父节点采样 | Polyglot-225 上 31.1 对 DGM 27.1、SICA 25.1、Base 20.0;去掉判官 29.8 低于 DGM;TerminalBench 2.1 判官排名第一者 36.7% 对按准确率排名第一者 28.1% | 搜索实际用 Polyglot-50 而摘要写 full Polyglot;资源数字正文与表不一致;无公开入口 | 栏目 · arXiv |
| 1 | 直接命中 | UnifiedPlayers: Enhance Tool-Integrated Reasoning in Agentic Reinforcement Learning · 2609.20089 | 改权重与信用分配:规划、执行、评估三角色联合 GRPO | 数学平均 Qwen3-4B-Base 56.4 对 Agent0 52.7;通用域 46.1 对 42.1;因子实验 Full 56.4±0.8 对仅执行 50.6±1.1;去扰动引擎 51.6(−4.8) | 训练任务全为数学题,通用域增益属迁移;主表单次评估无方差;无公开入口 | 栏目 · arXiv |
| 1 | 直接命中 | SkillAA: Attribution-Guided Skill-Graph Updating with Targeted Validation and Rollback · 2609.20455 | 只改技能图,学生与教师全部冻结 | SearchQA 81.5±1.3 对扁平技能 72.5;LiveMath 66.7±2.1 对 42.2;DocVQA 91.2±1.0 对 87.7;三种子独立优化并报半极差 | 与 GEPA 的对比是 source-protocol 口径,非同算力;严格匹配计分把别名与格式失败算错;图规模中等 | 栏目 · arXiv |
| 1 | 直接命中 | SoL-Pi: Recursively Scaling Auto-Research Loops for Efficient Agent Harness · 2609.20519 | 只改驾驭层:递归自我研究循环加双门控 | EdgeBench token 1.0990B 对 Pi 2.1538B(−49.0%),成本 894 对 1,339 美元(−33.2%);ObservationPack 平均分 47.208 对 44.833;Terminal-Bench 4 解 15 题对 18 题 | 质量侧并非全面占优;EdgeBench 每配置单次运行;自动研究循环本身昂贵 | 栏目 · arXiv |
| 2 | 直接命中 | FINSKILLOPS: A Self-Evolving Multi-Agent System for SEC Filing QA · 2609.19680 | 只改技能库:提案、定向验证、保护集回归、退役 | 权重正确率 4.55 对初始 3.70;去掉技能演化 −0.85;四基准等权平均 3.66 对 SkillOpt 2.66;12 轮里 33 个候选只有 6 个晋升,保护集挡下 5 个并暴露 7 处回归 | 主结果来自自建基准且每任务单次运行;12 轮无法建立盲泛化;无公开入口 | 栏目 · arXiv |
| 2 | 直接命中 | EconSkills: Studying Skill Transfer and Retrieval for Web Agents on Live Economic Data · 2609.19523 | 只改技能库:从已验证轨迹蒸馏参数化技能 | 配对 300 题 49.3% 对基线 41.0%(+8.3 个百分点),双成功格平均少 2.37 步;把 50 条全部注入反而掉到 11.4%,未覆盖任务提示 11.4% 对基线 16.7% | 未隔离提示长度、冲突指令与相关性判断;库级为单次运行;技能库无版本与冲突合并 | 栏目 · arXiv |
| 3 | 邻近跟踪 | LearnActCoder: Role-Aware Error Memory for Adaptive Clinical Coding Agents · 2609.19721 | 只改记忆层:按假阴性/假阳性把错误记忆路由给不同角色 | MIMIC-III 150 篇 CPT F1 17.4 对 11.5(+5.9 个百分点);同批 ICD-9 42.6 对 41.1(p=0.11 不显著);结构化记忆 17.4 对原始样例 12.1 | 任务域窄、受控子集仅 150 篇;绝对性能低;未做路由对调消融;无公开入口 | 栏目 · arXiv |
| 1 | 直接命中 | RetireOPD: Self-Retiring On-Policy Distillation for Agentic Reinforcement Learning · 2609.20784 | 改权重的监督安排:技能条件教师加自适应退休 | 3B ALFWorld 93.8 对 GRPO 75.0、WebShop 77.3 对 63.3;消融完整 92.2 对不退休 82.8 对纯 GRPO 75.0;教师未优化时 3B/7B 仅 28.9/23.4 | 无自陈局限;短程、脚本化环境;未报告种子、训练集规模与算力 | 栏目 · arXiv |
| 1 | 直接命中 | What Does Privileged Information Add to On-Policy Self-Distillation? · 2609.20612 | 改轨迹表示与监督信号,LoRA 训练学生 | Qwen3-1.7B 域内 step100 无参考蒸馏 +1.80[0.20,3.47] Avg@4;外部 +4.07[1.73,6.54] Avg@12;换成 long thinking rollout 后增益整体转负 | 短程数学 LoRA;SmolLM3 关键对照 n=2;外部每基准仅 30 题 | 栏目 · arXiv |
| 1 | 直接命中 | Chronicle: Cut-Point Replay for Regression Testing of LLM Agents · 2609.20625 | 改边界插桩与测试协议,不改权重 | 录制中位 23 微秒/次跨越,占假设 300 毫秒调用的 0.008%;完整回放 20 次零分歧、零模型调用;切点测试在 6 个事故上全部检出未防护失败;192 个一阶变异体切点杀 51 个、全打桩基线杀 0 个 | 不覆盖流式与并发;基准为 6 个自建事故,规模小;延迟只在笔记本 CPU 上测 | 栏目 · arXiv |
| 2 | 直接命中 | Reflective Recovery: A Self-Supervised Method for Reasoning by Learning from Mistakes · 2609.19156 | 改权重并改轨迹表示:用失败轨迹前缀构造恢复数据 | 7B:AIME24 53.0→54.3(RFT)→56.7;AIME25 30.0→34.7→37.5;Minerva 37.6→46.7→47.8;14B LiveCodeBench 48.3→53.1→55.3 | 增益 1–3 分且集中在数学;构造失败与重采样成本高;未报告种子与算力,无官方入口 | 栏目 · arXiv |
| 2 | 直接命中 | Advantage Scale Calibration Imbalance in Group-Relative Optimization under Low-Variance Rewards: Diagnosis and Bounded Recovery · 2609.19164 | 只改组内优势的分母:MaxNorm 加奖励分辨率协议 | Qwen3-32B AIME25 84.2±1.2 对 p90 参照 79.4±0.9(+4.8);LiveCodeBench v6 69.7±0.7 对 63.9±0.8;六个单元全部为正,5 个种子加 bootstrap 区间 | 有界干预不通用;主观判官需另行校准;未公开 GPU 时长与超参;无代码 | 栏目 · arXiv |
| 2 | 直接命中 | Evolution or Illusion? Rethinking Evaluation in LLM Evolutionary Search · 2609.19799 | 只改评测协议:报告种子×迭代前沿而非单一预算点 | 40 种子×200 迭代:Cloudcast 上一个策略从 1 种子时的第 3 名升到 40 种子时的第 1 名;Heilbronn 上第 1 与第 2 名互换;10% 预算下最优划分与全预算不同 | 离线事后评估;单一引擎与模型;API 成本高;无公开代码 | 栏目 · arXiv |
| 2 | 直接命中 | Dual-Axis Policy Optimization for LLM Agents: Bayesian Feedback Attribution and Trajectory Mass Normalization · 2609.19830 | 改奖励与批内聚合:反馈归因加轨迹等权归一 | ALFWorld 1.5B GRPO 72.9±3.4→85.6±2.8、GiGPO 86.8±1.8→94.1±1.7;WebShop 1.5B 57.1±3.6→68.2±2.8;墙钟时间 1.10–1.17 倍 | 反馈归因测的是模型兼容性而非因果;部分提升与标准差同量级;无种子与重复 | 栏目 · arXiv |
| 1 | 直接命中 | MAGMA-GEN: Validated Recovery Supervision from Ambiguous Failures via Counterfactual Re-Execution · 2609.20056 | 改监督数据生成:反事实重执行验证恢复动作 | 恢复率 26.25±3.75% 对 Best-of-N 16.66±1.36(+9.59 个百分点);消融无指导 1.66±1.44、有提议不验证 5.00±0.00、完整 26.25±3.75;真机 15/30 对专家轨迹 12/30 | 只能恢复「仍有可行延续」的失败;仿真与真机动力学不匹配会让已验证干预失效;真机无统计 | 栏目 · arXiv |
| 1 | 直接命中 | Rethinking Multi-Agent Collaboration: When More Is Less · 2609.19759 | 只改协作拓扑:按依赖图边界按需派生 | 四个长程基准:Terminal Bench 2.1 单智能体 76.71 反而高于本方法 75.50;NL2Repo 49.23 对 48.74;Deep Research Bench II 55.23 对 51.49;派生上限放松到 5、6 时掉到 67.32、64.02 | 只在依赖稀疏的长程任务上成立;仅 Terminal 报告 3 次尝试;依赖密度无自动判据;无公开入口 | 栏目 · arXiv |
| 2 | 直接命中 | RAFT: A Stateful Retrieval-Augmented Framework for Troubleshooting Agents · 2609.20754 | 只改检索表示:条目级索引加锚定轨迹 | 合成集 Case Hit 0.842/0.871/0.888 对朴素 RAG 0.673/0.719/0.769;配对差 +16.79 个百分点[13.91,19.78];插入无关轮次后本方法 −9.36 对朴素 −49.31 | 根因与修复维度配对差跨零;Jira 真实集仅 30 组无区间;不评端到端修复成功率 | 栏目 · arXiv |
| 2 | 直接命中 | Closed-World Resolution Against Tool Hallucination in LLM Agents · 2609.19425 | 只改调用解析层:门控之前先做封闭世界解析 | 十模型两界面合计 322 次真实幻觉;schema 界面下 Opus/Sonnet 幻觉率 0.00,Llama-3.1-8B 0.62/0.73;解析层单独把前三类幻觉归零,诚实过拒 0 | 诚实过拒为构造一致性;无区间与重复;MCP 侧 154 次幻觉同样来自受控装置;声明入口在包索引上对应的是另一个项目 | 栏目 · arXiv |
| 1 | 邻近跟踪 | ScientistTwo: Pioneering the Human Knowledge Frontier with Autonomous AI · 2609.19644 | 改研究流程编排:多智能体闭环加自评与反驳 | 86 篇自动论文的自动评审分 7.5±1.3、认可率 91.9%,对照 Stanford 基线 5.7±0.6;达到人类最强基线相对增益中位 7.7%;消融去掉评审与反驳降到 5.2±2.2 | 两个自动评审方向相反;未达 spotlight 级;单任务约 3,765 美元、每问题单次运行,无第三方复现 | 栏目 · arXiv |
| 3 | 邻近跟踪 | Position: It is Time to Virtualize Foundation Models with a Self-evolving Operating System Layer · 2609.19203 | 提出系统层抽象:能力虚拟化加需求驱动编排 | 零实验、零数据、零基线;给出三条设计原则、三类架构组件、两个设想案例 | 立场论文,收益全为前瞻;形式化被作者标为类比;无自有入口 | 栏目 · arXiv |
| 1 | 直接命中 | Multi-Dimensional Prosody Judgment For Live Streaming Speech Synthesis · 2609.20124 | 只改奖励与评测协议:判官蒸馏加去耦 | 多维样本上独立核心维度判断 0/140 → 67.9%(去耦)→ 71.4%(span 局部优势);十次采样一致率 T1 71.22%、T4 83.50% 对 Gemini 单次 65.23%、58.00%;Best-of-8 在 136 组高置信上 Hit@1/2/3 为 72.06%/77.94%/85.29% | 单一种子;对商用模型是十次采样对单次的不对等比较;多维标注只覆盖四个维度;数据不公开 | 栏目 · arXiv |
| 2 | 直接命中 | Dictionary-Constrained Grapheme-to-Phoneme for Unsegmented Languages from LLM-Annotated Data · 2609.19805 | 改权重的文本前端:词典词格加判别式 CRF | Joyo-Kanji-Yomi 基准 13,536 句:读音准确率 99.62%、词级音素错误率 0.32%、句级 0.14%,对照 MeCab+UniDic 96.66%/2.82%/1.23%;去掉边缘化项 99.53% | 属 TTS 链路的文本前端,不产生波形;单一日语基准;训练数据未公开;同一模型既造数据又当基线 | 栏目 · arXiv |
| 2 | 邻近跟踪 | A frontend-backend architecture for tool calls in full-duplex speech models · 2609.19334 | 改前后端架构:双工前端发委派令牌,后端执行工具 | 单轮工具调用召回 92–97%,拒答无关调用 81.2%;带大后端时在全双工基准上与开源闭源相当;前端识别字错率从 10.80% 升到 11.47% | 单次评测、无种子与区间;训练数据全为合成、不可复现;语音合成质量不在评测范围 | 栏目 · arXiv |
| 2 | 邻近跟踪 | Full-Duplex Speech Models Take the Floor When Asked, Not When Needed · 2609.19596 | 只改评测协议:把触发理由与出声机会分开 | 40 话题×10 条件、每配置 5 种子 2,000 次试验:中性条件下出声率 0.01–0.42,提问提高 0.08–0.24,加 1.5 秒静音后最高升到 0.83;假事实与危险相比中性最多差 0.06 | 合成独白、单说话人、仅英文;无区间与显著性;出声判定阈值会漏掉短插话 | 栏目 · arXiv |
| 2 | 邻近跟踪 | Reading Emotions in the Token Space: Discriminative Adaptation of SpeechLLMs for Emotion Recognition · 2609.20081 | 只改读出方式:冻结骨干接单层线性分类头 | IEMOCAP 四类留一说话人:有分类头 78.04 对无分类头 75.63(Macro F1);真实转写字错率 8.06% 时 76.50 对 74.47;单编码器与双编码器 78.04 对 78.14 | 单数据集、单种子、无区间;四类归并;上下文只用上一句;无公开代码 | 栏目 · arXiv |
| 2 | 邻近跟踪 | Music Hallucination in Audio-Language Models: A Hierarchical Formulation and Empirical Study · 2609.20195 | 只改评测协议与免训练缓解探针 | 五层幻觉、三值判定加覆盖率:人声层幻觉率 45.9–61.3%,调性层结构化准确率 0.0%(MiMo)到 68.6%(Qwen2.5-Omni);判别式与结构化两范式的模型排序相关 0.80(p=0.01),判别式与自由生成只有 0.17 | 幻觉率是保守下界,须与覆盖率同读;风格与情绪层依赖语言模型判官;缓解效果跨范式不迁移 | 栏目 · arXiv |
| 2 | 邻近跟踪 | The Public Discourse Corpus (PDC): A Speaker-Attributed Dataset for Valence and Epistemic Modality with Target Speaker Participation · 2609.20232 | 只改数据与标注协议:目标说话人参与度分类加音频优先切分 | 998 段视频、100 位说话人、186,642 句、311 万词;目标说话人参与度五分类 κ=0.616、二分 κ=0.690;本地与商用管线的词重叠 84.1%;跨提供方效价精确率 75.9%(κ=0.63) | 本地管线的说话人归属尚无人工验证;只发布文本;研究对象是效价与认知情态,不是节目级评估 | 栏目 · arXiv |
| 1 | 直接命中 | Form Over Content In Gradient-Based Data Attribution Methods · 2609.19589 | 只改测量:把任务与答案格式正交化再测梯度相似度 | 共享答案格式的不同基准间去衰减余弦约 0.4,同一基准换格式后接近 0.0;零参照 280 对均值 −0.001、标准差 0.008;被审方法的选择在目标自身格式上富集到基础率的 3.7 倍 | 无独立复现;富集分析依赖该方法的已发布选择结果与规则分类器;只覆盖五个英文问答基准与七种格式 | 栏目 · arXiv |
| 2 | 直接命中 | What Do We Expect from LLMs? Mapping the Design of LLM Benchmarks · 2609.19182 | 只改测量:对 14,767 篇基准论文编码七字段并做趋势归因 | 智能体与工具系统份额 2024 年 9.0%→2026 年 28.3%;语言模型判分 25.8%→40.3%;交互式评测 9.5%→28.2%;把 5% 标签翻转后两条趋势仍为 +19.29 与 +14.51 个百分点 | 单作者、单模型编码、无独立复现;2026 只覆盖 1–8 月;属描述性统计而非因果 | 栏目 · arXiv |
| 2 | 直接命中 | Reproducibility is not construct validity: LLM measurement of institutionally situated communication · 2609.19866 | 只改测量:四步效度诊断 | 857 份提交、348 份有同时文本与问卷:五次注释的内部一致 ICC(C,1) 0.994–0.996,而与问卷的收敛效度 r=0.029(安全,p=0.59)、0.176(权利,p=0.001)、0.097(可解释性,p=0.072);分组分歧商业协会 +1.00 对公共机构 −0.70 | 单一政策域、单一模型、单一提示;348/857 自选择;六个分组里四个样本量 ≤26 | 栏目 · arXiv |
| 2 | 直接命中 | When AI Agents Commit: Cognitive Serializability Across Data, Evidence, Policy, and Authority · 2609.20261 | 只改执行与评测协议:依赖令牌加守卫优先提交 | 28 条受控历史上本方法无非法提交,仅事务隔离在 7 条核心语义历史中 5 条未阻止异常、并发扰动下异常通过率 41.2%;32 线程峰值 1,842 事务/秒,比严格档低约 23%;万笔提交均值 3.22 毫秒 | 单机单库原型;28 条历史由作者自设;推理延迟为采样值而非真实调用;无公开入口 | 栏目 · arXiv |
| 2 | 邻近跟踪 | Evaluating Communicative Success in Machine-Translated Conversation · 2609.19885 | 只改评测协议:语义、语用、文化社会三层清单加对抗扰动 | 5,624 个有向场景、12 个方向、10 个系统:全部设置按三层递减;多轮汇总语言模型配置 92–94%、传统系统 45–47%;指标最高四分位里仍有 10.3–12.2% 的清单分 ≤0.6 | 人工校准是最大限制,人机一致性为下界;清单生成器与主判分器同源;字幕域 | 栏目 · arXiv |
| 2 | 邻近跟踪 | Not All AI Agents Are Equal: Characterizing Resource and Performance Dynamics · 2609.19947 | 只改运行时测量与资源编排 | 七个基准:本地检索占问答延迟 62%、网络检索 49% 在网络接口、编码任务 39% 在本地 shell;并发从 0.5 升到 6 请求/秒时问答延迟涨 13.1 倍、编码只涨 1.5 倍;六核预算下总平均延迟降 32%,但同一配置下某编码基准延迟升 28% | 单机单环境;语言模型延迟为回放值;内存峰值不能外推;只测两种总预算 | 栏目 · arXiv |
驾驭层:长程能力住的那一层,现在能被剖析和做回归测试
这一批里有六篇把「模型外面那圈代码」当成独立对象来量:给它做剖析器、做回归测试、拆成组件逐个定价、把端到端增益拆成两段。共同点是权重不动,可迁移的部分是评测与观测协议。
1. Reach or Solve? Attributing Agentic RL Gains with Checkpoint Handoffs(arXiv:2609.19636,直接命中·智能体、规划与决策)
- 研究问题:强化学习后的智能体端到端成绩变好,这个「变好」里有多少是它更常走到有利状态,有多少是它在同一个状态上做得更好;只看两者都能到达的状态能不能把这两件事分开。
- 改动位置(维度):只改评测协议。把一个检查点亲手走过的状态克隆下来交给另一个检查点,不重训、不动权重。
- 核心方法机制:按「距离成功还有固定步数」定义交接点,环境确认后把状态连同历史一起交给另一个检查点继续跑;到达率(REACH)量的是到达这种状态的频率,完成率(SOLVE)量的是从同一个克隆状态出发的完成频率,两者相乘对回端到端成功率。实测里还专门做了反例:把比较限制在两者都到达过的状态上,会选到结果变量上,在这批数据里直接把效应符号翻了过来。
- 关键定量结果(含比较对象与口径):TravelPlanner 验证集 180 题、Agent-STAR 1.5B/3B/7B,到达者与解决者的交互项分别为 +17.8、+14.4、+10.6 个百分点,区间 [9.4, 26.1]、[6.1, 22.8]、[0.6, 20.6];ALFWorld 上未见任务 +24.2([13.3, 35.0])、已见任务 +17.5([6.7, 27.5]),五个条件下界全部为正。同一批未见任务的 115 个克隆状态上,SFT 求解 56.5%、RL 95.7%(差 39.1 个百分点,[29.8, 48.4]);115 个状态里有 45 个只有 RL 求解者解出,只有 SFT 求解者解出的是 0 个(已见划分是 41 与 10)。用已见划分单独估出的分量去预测未见划分的交互项是 20.7 个百分点,实测 24.2,残差 3.5([−7.2, 14.2])。
- 证据强弱与复现边界:100,000 次任务级配对 bootstrap、ALFWorld 四个配对种子、每个到达状态恢复 2 次,两个检查点来自两组独立发布的流水线,属于本批少见的冻结对照。边界同样清楚:ALFWorld 每个划分只有 30 个任务、115 到 117 个状态,且两个检查点都是 Qwen 系,跨无关基座能不能迁移没有测;它给出的是行为层的分解,不是机制解释。论文没有公开代码,材料放在匿名补充档案里;两组第三方检查点在模型托管站上可以打开确认有实质内容。
- 对目标研究线的连接点:直接命中长程任务的训练与评估。任何一次「RL 比 SFT 好」的报告,都可以用这套交接把「更常到达」与「到达后做得更好」分开报,避免把到达率的提升读成策略变强。
- 结论与阅读建议:建议精读,重点看交接点的定义、克隆状态里保留了什么(环境、历史、预算),以及那个会把符号翻过来的反例。
- 入口:栏目正文 · arXiv
2. An Architecture for Long-Horizon Agents: Levels, Ticks and Cascaded Intelligence(arXiv:2609.19519,直接命中·智能体、规划与决策)
- 研究问题:一个要跑上几天到几周的智能体,如何在不换模型、不微调的前提下既不忘记也不空转;长程能力到底长在模型里还是长在外面的代码里。
- 改动位置(维度):只改驾驭层。按时间尺度分层、用时钟驱动的 tick 作为自主动作单位、失败送审才升级到更强模型。
- 核心方法机制:论文先从长程设定里推出七个瓶颈,再用四组抽象回应:七级时间尺度,每级留一份有界的文件摘要下一级;时钟驱动的 tick 决定什么时候该动;命名文件协议承载跨层通信;judgment、labor 与确定性检查三层级联,只有当一份工作过不了评审才升级。作者把整体设计概括为「先能一直跑不忘记,才谈得上一直学」。
- 关键定量结果(含比较对象与口径):十天战役的记录:driver 侧 211 次 tick、47 次上下文重置,worker 会话按常规档 403 次、强档 35 次;升级 25 次、只有主控能做的决定 9 次;对抗性评审 30 次、关键发现 7 条;GPU 用时 2,215/3,000 小时;日历 10 天,实际在时钟下的 8 天。过程对照里,未加引导的三个 worker 会话停在 958 秒/步且没有诊断信息,加引导后降到 180 秒/步,没有动用强档。
- 证据强弱与复现边界:这是单案例、单次运行的存在性证明:没有基准、没有模型名称与规模、没有种子与重复,唯一的对照是同一任务上「未引导」与「已引导」两段过程。十天里只有 8 天在时钟下,成本常数也没有给出。全文与附录都没有本论文自己的代码或数据入口。
- 对目标研究线的连接点:直接命中长程任务的训练与评估。它给出的是「分层加时钟加评审升级」这套骨架的完整工程形状,可迁移的是层与层之间的信息接口,不是任何性能数字。
- 结论与阅读建议:建议精读,把它当架构清单读;引用时不要引用那条 958 到 180 秒的比值,它是单次叙述。
- 入口:栏目正文 · arXiv
3. AgentPProf: Semantic Profiler for Long Horizon AI Agents(arXiv:2609.20301,直接命中·智能体、规划与决策)
- 研究问题:智能体跑了几天的轨迹,怎样回答「失败发生在哪」「哪类任务最烧钱」这类跨运行的问题;系统软件里有剖析器,智能体这边只有逐个运行的调试。
- 改动位置(维度):只改观测层。离线剖析器,不动模型权重,也不动执行循环。
- 核心方法机制:把智能体轨迹里的活动统一成「语义操作」,用操作栈替代运行时调用栈,从而支持不同粒度的归因;再用递归操作分割沿任务边界切开连续区间;最后聚合成标准剖析文件,输出可直接画火焰图的结果。附带一个不依赖语言模型的分割器做对照。
- 关键定量结果(含比较对象与口径):CodeTraceBench 405 条轨迹上,分割的 B³ F1 为 0.764、边界 F1 0.480,最强自动基线 0.663/0.266(+0.101/+0.214);在另一个长程基准上,有监督分割器 0.816,同款无语言模型分割器 0.786,不改指令的对照 0.448。按同一份剖析结果归因,一个「诊断鉴权」任务的责任份额随测度变化:按操作数 21%、按耗时 37%、按 token 46%。440 条网页轨迹里,失败运行有 44.6% 的步数花在恢复动作上,成功运行只有 12.0%。用剖析结果引导修复,23 个留出场景、69 对对照里智能体侧 token 降 19.0%。摘要里「MAP 最多提升 56%」在正文只有绝对增量 0.031、0.107、0.117,且没有给出基线 MAP,无法复算。
- 证据强弱与复现边界:样本量在同类工作里偏大(41 条长程编码会话、440 条网页轨迹、1,394 条本地会话,人工标注 2,948 个阶段),但没有报告种子与重复,也没有明确的冻结对照。自动分割一次性成本 37 分钟;基准里的长程轨迹实际只有 8 到 52 个操作,长程依赖来自作者的 42 段会话。它是本期少数几个自带入口且入口确实有内容的工作:代码托管在 eunomia-bpf/agentsight 下的 pprof 扩展,许可为 MIT。
- 对目标研究线的连接点:直接命中长程任务的评估。把「失败运行的步数里有多少花在恢复」做成常规报表,比只看成功率更能解释成本。
- 结论与阅读建议:建议精读;引用数字时用正文的绝对增量,不要用摘要的 56%。
- 入口:栏目正文 · arXiv
4. An Empirical Study of Harness Design for Coding Agents(arXiv:2609.20804,直接命中·自然语言与多模态智能)
- 研究问题:同一段执行循环下,上下文管理、规划、动作空间这三个驾驭层组件各自值多少,以及这个价值随窗口预算和模型规模怎么变。
- 改动位置(维度):只改驾驭层。执行循环固定,做 176 个设置的条件扫描。
- 核心方法机制:上下文管理分五档(从无管理到替换旧输出、摘要、外部存储与按需召回),配四个窗口预算;规划作为开关,把计划逐轮注入且单独存放;动作空间在预定义工具集与只给 shell 之间切换。任务配对做 McNemar 并做多重比较校正。
- 关键定量结果(含比较对象与口径):上下文管理相对无管理的成功率差在 SWE-Bench Verified 上:32k 窗口 +35.7、64k +15.9、96k +5.5、128k +2.7 个百分点;无管理档的溢出率从 78.7% 降到 8.7%。Terminal-Bench 2.1 上同口径为 +9.5、+7.5、+4.8、+2.8。32k 下 30B 模型从 9.40 升到 20.60,120B 从 11.40 升到 43.00,550B 从 6.40 升到 51.40。两档管理方式相比,32 组对比里 15 优、14 劣、3 平,等权平均 −0.36 个百分点;64 个设置里有 36 个(56.3%)从未调用按需召回,调用率从 32k 的 0.540 次/任务掉到 128k 的 0.007。128k 下开规划:30B 在 SWE-Bench +11.6、Terminal +4.5;550B 成本降约 30%、成功率降 2.0。动作空间:30B 用预定义工具 +15.0%(SWE)/+10.1%(Terminal);550B 反过来只给 shell +3.6%/+5.6% 且成本降 53%/30%。
- 证据强弱与复现边界:176 个设置、四个模型、两个基准,每个设置每个任务只跑一次,没有重复与种子扫描;Terminal-Bench 2.1 只有 89 题,很多对比不显著;规划与动作空间只在最大的窗口档做消融,动作空间是打包改动,隔离不出工具数量与粒度各自的作用;成本按公共端点定价而非本地推理的真实成本。全文没有本论文自己的入口。
- 对目标研究线的连接点:直接命中长程任务的训练与评估。它把「上下文管理有用」这类笼统结论换成了条件式结论:窗口越小越值钱;规划在小模型上涨分,在大模型上转为降本。
- 结论与阅读建议:建议精读,重点看三张条件表和那个「按需召回从未被调用」的统计;引用时必须带上单次运行与 89 题这两个限定。
- 入口:栏目正文 · arXiv
5. How Do Agent Harnesses Create Value? Planning Information and Release Control in Stateful LLM Agents(arXiv:2609.20474,直接命中·自然语言与多模态智能)
- 研究问题:计划带给智能体的价值,是信息本身还是「上下文变长了」这个副作用;再加一个验证器,价值从哪里来、在什么风险水平下才划算。
- 改动位置(维度):只改驾驭层的规划信息与放行控制,并设计词数匹配的乱序对照。
- 核心方法机制:把计划分成两种呈现——固定计划,与把同样字数打乱顺序后注入的对照;用任务簇 bootstrap 与 Holm 校正做区间估计。再扫「高风险损失的代价」与「每步验证的预算」两轴,看在什么参数下规划与验证器各自合算。
- 关键定量结果(含比较对象与口径):265 个匹配格上,固定计划相对乱序对照的 oracle 成功率 +7.17 个百分点,任务簇区间 [1.15, 13.36];乱序对照相对最简提示 +1.89 个百分点,区间 [−3.45, 7.09] 跨零,因此不能说两者等价。高复杂度任务 123 格上 +13.01 个百分点,低复杂度 142 格 +2.11。模型特定对比在 Holm 校正后没有一组显著:某模型 67 格 +13.43(校正前区间 [1.49, 24.64],校正后 p=0.08),另一个 60 格 +13.33(未校正 p=0.0172,校正后 0.086)。验证器拒绝 137 条无效结果中的 83 条(61%),同时扣下 92 条正确结果中的 16 条(17%)。成本上,高危损失层下规划器、验证器与两者同开的净收益分别是 1.9748、1.5275、0.5460 美元,到低危层排序翻转(35.1299、97.3133、99.1962),同开档的增量成本约为单独验证器的 12 倍。
- 证据强弱与复现边界:词数匹配的乱序对照是本期最干净的一条设计,可整体搬走。但结论本身弱:主样本只有四个模型乘 23 个任务共 265 个匹配格,网格缺 213/1,440,计划由人工撰写且带着完整信息,验证器在 oracle 之后运行;模型特定对比经校正后全部不显著。没有公开入口。
- 对目标研究线的连接点:直接命中长程任务的评估与驾驭层价值归因。要做「加个验证器值不值」的决策,这篇给的是扫描方法;结论要从自家环境里跑出来。
- 结论与阅读建议:建议扫读,重点看乱序对照的构造与成本扫描那两张表;性能数字不要单独引用。
- 入口:栏目正文 · arXiv
6. SIMLIFE: Pattern Understanding for Long-Horizon Human-Agent Partnership(arXiv:2609.19610,直接命中·机器人与具身智能)
- 研究问题:让智能体从长期的日常观察里推断出「这个家里的作息规律是什么」,现在能做到哪一步;规则变了之后它还跟不跟得上。
- 改动位置(维度):改环境与评测协议(用模拟人生系列游戏先写定潜在规则、再合成多天长视频),另适配两种既有记忆与检索架构。
- 核心方法机制:基准含 106 段长视频、平均 15.49 小时、38.57 个游戏日,共 1,439 道题,分四类问答乘三档提示;输入分视觉加语言、视觉加音频、只语言、只语言加负向提示四种;另外用逐日的信念轨迹与五个参考基线对齐,检查模型的判断是否随时间收敛到真实规则。
- 关键定量结果(含比较对象与口径):只语言加完整提示的最强配置是 Gemma-4-31B-it,答案准确率 36.2%、问答准确率 74.6%。反事实问题与信息线索题之间的中位差距随输入从 4.2%(视觉加语言)升到 16.2%(只语言)再到 32.1%(只语言加负向提示);同一个模型单类反事实准确率能到 86.6%,而整体只有 36.2%。信念轨迹上,三个模型族与频率基线的最高秩相关是 28.8%、32.2%、38.5%,人类对假设消除是 78.1%;Gemma 与 Qwen 有 97–100% 的预测落在概率 ≤0.05 或 ≥0.95 的两端,人类是 37%。制度变更的对话只被 pivot 之后 1–12% 的推理痕迹引用过,开放模型的 Brier 分数在 pivot 后升 0.09 到 0.14。
- 证据强弱与复现边界:基准规模在长视频问答里偏大,但模拟器的随机性使复现受限,作者也承认「模拟惯例是确定性抽象」。人类对照只有 12 人且信息不对称——人类被明确告知规则可能变化,模型只能从对话里推断,这个差距不能当成能力差距读。项目页可以打开但代码与数据按钮没有下载目标;许可为非商业共享。
- 对目标研究线的连接点:直接命中长程任务的评估。四类问答乘三档提示、加逐日信念轨迹对齐的协议可以照搬,用来测任何「需要从长期观察里学规则」的系统。
- 结论与阅读建议:建议扫读,重点看题类划分与信念轨迹的对齐方法;那几个准确率绝对值要带上输入模态与提示档位再引用。
- 入口:栏目正文 · arXiv
长程评测:评分对象下沉到持久状态、失败位置与协议本身
这七篇把评分对象又往前提了一步:记忆的每一次读取、世界模型在规则变更后的修订、参考图是否还有效、以及评测协议自己有没有被声明清楚,都进了分数。
1. Refuse, Decompose, Refresh: A Claim-Safe Protocol for Closed-Loop AI Evaluation(arXiv:2609.20538,直接命中·其他/综合 AI)
- 研究问题:闭环评测里,参考图会随环境和上游变化而失效,一个分数可能「可复现但结论错」;评测本身能不能写成一份可执行、可验证的契约。
- 改动位置(维度):只改评测协议,模型与环境都不动。协议含三个动作:证据不足时弃权、分栏报告、参考过期时作废并重算。
- 核心方法机制:把可信评测写成声明契约——证据不足就返回弃权而不是分数;执行完整性、误纳、覆盖、功效、结构假设分别成栏报告;漂移触发告警后,参考图作废并重算。门槛在跑之前冻结,状态机把「参考弃权、运行弃权、信号合格、检出」四种状态分开。论文给出一个独立验证器和预注册的留出集。
- 关键定量结果(含比较对象与口径):独立验证 56 项全部通过,1,440 个样本与 21,600 行分区齐备;参考门槛接纳 72 个单元里的 55 个(76.4%),覆盖 24 个组件中的 20 个。稳定误纳在 20 个组件上是 0,单侧 95% 上界 0.1391,低于预设的 0.20。流量模型相对单元格比例模型每单元-臂行 NLL 好 0.1264 nats,区间 [0.0593, 0.1918];族充分性的对数损失改进 0.0015 nats/行,上界 0.0066 小于 0.01。漂移检测在 45 个干净当前单元中报警 29 个;门槛取 5 时 15/15 报警,取 7 时 0/15,取 9 时 14/15。
- 证据强弱与复现边界:这套协议是本批证据强度最高的:预注册留出集、冻结阈值、独立验证器、约 2,000 次组件簇 bootstrap、按种子区间保留数据。边界是单一模拟器与单一组织配置,Refresh 只验证了作废逻辑、没有验证新数据能否修复过期参考图。匿名工件地址可以打开,里面是一份 748 字节的说明文件,写明构建命令与一个校验脚本,没有声明许可。
- 对目标研究线的连接点:直接命中长程任务的评估。凡是把评测跑成流水线、参考会随上游漂移的团队,这套「弃权加分栏加参考重算」的契约可以直接照抄。
- 结论与阅读建议:建议精读,重点看状态机与冻结门槛那两节。
- 入口:栏目正文 · arXiv
2. JustMem: Just-Enough Memory Access for Long-Term Conversations(arXiv:2609.19877,直接命中·其他/综合 NLP)
- 研究问题:长期对话的记忆系统,读取的宽度与读取的保真度各自值多少;在哪一类问题上读得更多反而没用。
- 改动位置(维度):只改记忆访问策略。记忆条目不变,改的是发现广度(读多少)与读取保真(读多细)。
- 核心方法机制:把记忆访问拆成两个维度,在紧凑原子记忆上实现三种条件化查询配置,并给每条原子卡带上来源;用结构化规划器选路,把压缩证据预算固定下来做对照。
- 关键定量结果(含比较对象与口径):LoCoMo 1,540 题上 79.61±0.12 对最强基线 LightMem 的 79.08±0.26,+0.53 点,配对 p=0.532 不显著;LongMemEval-S 500 题上 83.40±0.24 对 76.44±0.17,+6.96 点。token 上构建与推理分别比基线少 50.7%/67.2%(LoCoMo)与 64.9%/55.7%(LongMemEval-S)。组件对照:全局原子取前十条 79.81% 对会话优先取前十条 74.29%(p=2.54e−10);引导扩展把 71.20% 提到 76.60%,召回@10 从 91.80% 到 96.60%(p=3.55e−4);自适应回放 83.40% 对压缩阅读 74.40%。
- 证据强弱与复现边界:同一配置对照、答题与判分各重复 5 次、配对 McNemar 与逐维度消融齐备,是本期记忆类工作里唯一做到这一步的。但主结论并不普遍:LoCoMo 上那 0.53 点不显著,显著优势只出现在 LongMemEval-S;效率只统计生成 token,不含检索与嵌入成本;没有公开代码与数据。
- 对目标研究线的连接点:直接命中长程任务的训练与评估里「评分对象是持久状态」这一支。它给的是一条纪律:报告记忆系统的优势时必须指明落在哪个基准、哪个维度上。
- 结论与阅读建议:建议精读,重点看两维分解与逐维度消融的表格结构。
- 入口:栏目正文 · arXiv
3. To Memories and Beyond: From Remembering to Knowing You across Long-Term Multimodal Personal Archives(arXiv:2609.19167,直接命中·大语言模型与基础模型)
- 研究问题:长期个人记忆的评测长期停留在合成的纯文本上,能不能用真实的多年多模态个人档案,把「记得住」和「认识你」分开评。
- 改动位置(维度):改评测基准与记忆画像模块,不动模型权重;画像模块把属性的时间稳定性当成显著性先验。
- 核心方法机制:基准用真实多年的个人视觉档案构建,配第一人称的主观标注,分三层九子任务:事实回忆、人设推断、预测性个性化。画像模块逐段抽取属性并做新增、去重、更新、冲突合并,用时间稳定度决定哪些属性在冲突时优先。
- 关键定量结果(含比较对象与口径):2,508 段素材、1,629 道题。预测性个性化这一层上,Gemini-3.0-Flash 59.2%、GPT-5.4-mini 59.0%、GPT-4.1-mini 57.9%;事实回忆层 Gemini 82.6% 是三个全上下文模型里最高。一个记忆系统在以约七十倍压缩的前提下事实回忆 69.4%,仍低于 GPT-4.1-mini 全上下文的 72.6%。加入时间稳定性先验后,GPT-4.1-mini 在人设推断上 78.3(+4.0)、在预测性个性化上 61.4(+3.5)。模态消融:有字幕 82.6% 对只有视觉与元数据 57.4%。
- 证据强弱与复现边界:真实素材是它的价值所在,也是它的边界:只有 7 名参与者、单次评测、没有重复与种子,评分靠模型自评,第三层对记忆覆盖并不敏感,瓶颈解释属观察性关联。数据按许可限制发放,未给出可达地址。
- 对目标研究线的连接点:直接命中长程任务的评估。三层九子任务的划分可以直接借来设计长期记忆的评测,尤其是「预测性个性化」这一层目前是共同的短板。
- 结论与阅读建议:建议扫读,重点看任务分层与时间稳定性先验的注入方式;绝对分数受 7 人样本限制,不要横向比较模型。
- 入口:栏目正文 · arXiv
4. Continual Enterprise World Model Discovery in Dynamic Systems(arXiv:2609.19551,直接命中·其他/综合 AI)
- 研究问题:企业系统的业务规则会在运行中变化,智能体维护的世界模型怎样在规则被修改、新增、删除后仍然可用。
- 改动位置(维度):改驾驭层与持久世界模型表示,模型权重不更新。
- 核心方法机制:分两阶段——主动实验阶段构建符号化的世界模型(触发条件到效果),应用阶段只从这份模型作答,并在世界切换时修订它。配套的基准有四个版本,分别对应规则修改、新增、删除。
- 关键定量结果(含比较对象与口径):每个条件每个骨干 600 道题:预测隐藏规则效果的 IoU 领先对照 6.99 到 8.98 个百分点,且不需要任何实时查询;精度 91.15 对 82.47,召回 89.82 对 89.48。运行方差上,Gemma-4-31B 三次种子的均值 87.85(标准差 2.03)对 83.02(标准差 2.70),差 4.83。持续维护相对每次重建,在单世界模型上平均高 3.48/4.83/9.69 个 IoU。成本上一旦构建完成,每题只需一次模型调用、零次实时查询,而对照每题要 1.57 到 5.71 次实时查询,固定成本在 45 到 86 题之间收回。
- 证据强弱与复现边界:三个骨干里只有一个做了多种子,评测动作由作者选定,基准建在一个商用企业系统上、外部难以复建,设置里一次只变一条规则且所有条件都能读到规则定义。摘要把 8.98 当成整体提升,正文里它是三个骨干中的最大差值,均值口径是 4.83。没有公开入口。
- 对目标研究线的连接点:直接命中长程任务的评估。四阶段规则变更协议与「预测隐藏规则效果」的 IoU 指标,可以搬到任何需要长期维护状态理解的系统评测上。
- 结论与阅读建议:建议扫读,重点看规则变更的四个版本与成本收回的算法。
- 入口:栏目正文 · arXiv
5. Beyond Depth Truncation: Controlled Evaluation of Depth Utilization in Recursive Language Models(arXiv:2609.19934,直接命中·其他/综合 AI)
- 研究问题:递归语言模型靠多次迭代把上下文串起来,常见的「深度截断」指标把好几件事混在一起;真实被利用的深度到底有多少。
- 改动位置(维度):只改评测协议,加正控制、负控制与受控训练干预,模型权重不动。
- 核心方法机制:用三组正控制分别隔离「模块被应用的次数」「不同迭代带来的算力」「读出头分布外」三种效应,把负控制施加到稠密模型上,再用受控训练干预验证因果,最后用固定应用次数只变迭代的内容做重复对照。朴素指标拆成四个分量并各带区间。
- 关键定量结果(含比较对象与口径):朴素的前缀截断从 k=1 到 k=8 降 1.4251 nat;拆开后模块应用与残差分布占 0.6831 nat(47.9%),不同深度只占 −0.0392 nat(−2.8%),模块间组合 0.7812 nat(54.8%),校准 0.3645 nat(25.6%),四个区间都排除零。校准后差距从 1.4251 降到 1.0599 nat,温度从 1.45 降到 0.91。换到后训练检查点,不同迭代只贡献 +0.0022 nat。跨架构对照里稠密模型上模块应用份额是 −35.9%、−39.9%,而校准占 3.3%、14.5%。
- 证据强弱与复现边界:正控制、负控制、重复对照与匹配 1,000 步的训练干预齐备,方法模板可整体搬走。边界是只有一个递归架构、542.8M 且欠训练,bootstrap 不含检查点与种子方差,质量只用负对数似然衡量。论文特别声明这不是对递归架构的总体否定。没有公开入口。
- 对目标研究线的连接点:直接命中长程任务的评估。任何「长上下文/递归深度被真正利用」的结论,都可以先过一遍这套控制。
- 结论与阅读建议:建议扫读,把它当成「先把混杂因素拆开再下结论」的模板;结论本身限定在这一个检查点上。
- 入口:栏目正文 · arXiv
6. Replan, Repair, or Edit? A Unified Empirical Evaluation of Travel Agents for Itinerary Revision under Resource Disruptions(arXiv:2609.19654,直接命中·智能体、规划与决策)
- 研究问题:行程被打断后,是整套重新规划、分层修复,还是局部改动更划算;三种做法在效果、稳定性和成本上各自付出什么。
- 改动位置(维度):只改评测协议,把三个已有实现适配到统一的三维框架里,模型权重不动。
- 核心方法机制:用单一中断与复合中断两套任务,在成功例子上做配对子集比较,同时记录对已接受行程的保留率、逻辑编辑次数、调用次数、token 与延迟分位。
- 关键定量结果(含比较对象与口径):单一中断 500 例上,分层重规划 485/500(97.0%)、分层修复 484/500(96.8%),论文据此说这个差距不支持有意义的排名。配对的 346 例上,两者的逻辑编辑次数是 6.809 对 1.000,对已接受行程的保留率 64.70% 对 92.68%。复合中断 200 例上,分层重规划 186/200(93.0%)最高,分层修复 178/200(89.0%),局部改动在三个模型上分别是 134/151/134;配对 167 例的编辑次数 9.132 对 2.222、保留率 57.28% 对 86.77%。效率上分层重规划单次中断平均 1,369 token、均值 5.10 秒、P95 9.08 秒。
- 证据强弱与复现边界:三维框架与配对子集比较是可搬走的评测设计;但论文没有种子与重复,微小差异无法与方差区分,各实现在候选生成、反馈、预算与路由上并不对等,复合组里的行程难度也没有匹配。公众号摘要说「分层修复在保留已接受行程和计算效率上更优」,原文的重心是重规划在复合中断下成功率最高,并明确写了没有哪个策略在全部维度上占优。没有公开入口。
- 对目标研究线的连接点:直接命中长程任务的评估。工具失败后的修订评测可以直接套这三个维度。
- 结论与阅读建议:建议扫读,重点看配对子集口径;不要引用那个 0.2 个百分点的排名差。
- 入口:栏目正文 · arXiv
7. Diagnose, Recover, Certify: Task Readiness under Hidden Dynamics Changes(arXiv:2609.20304,邻近跟踪·其他/综合 AI)
- 研究问题:部署环境悄悄变了(比如执行器失效),智能体怎样先诊断、再恢复,并在证据不足时给出弃权而不是硬做。
- 改动位置(维度):改决策算法层,把诊断、恢复与认证写成统一的问题与贝叶斯程序。
- 核心方法机制:先用与任务无关的诊断脉冲把响应转成匹配分证据,并做证据门控传输到严重度后验;再用传输后的联合信念选恢复脉冲;任务身份揭示后给出任务条件化策略与下置信界,够就部署、不够就弃权到安全回退。
- 关键定量结果(含比较对象与口径):六个执行器失效的连续控制环境里,严重度 0.20 时 regret 0.819±0.008 对随机策略 0.854±0.008,回报 0.850±0.009 对 0.678±0.004;严重度 0.35 时回报 0.940±0.005 对 0.772±0.003;六个系统里四个取得最强的选择性回报;恢复轨迹数为零或只给两次探测时仍然领先。每个结果先做种子内平均、再跨 5 个种子取均值。
- 证据强弱与复现边界:对照齐备(随机、风险贝叶斯、赌博机式诊断、信息矩阵与规划类方法),但本体属于控制与强化学习侧,不是语言智能体;证书的保证限定在已校准的联合模型与指定的变化族内;论文的表格在网页版里列错位,端到端数值难以复原。没有公开入口。
- 对目标研究线的连接点:邻近跟踪。可迁移的是「诊断—恢复—认证」三段协议与弃权语义:把它套在语言智能体的执行失败上,可以回答「这次失败该重试、该换策略,还是该停下来」。
- 结论与阅读建议:按连接点取用协议结构,不必通读原文。
- 入口:栏目正文 · arXiv
自进化:技能图、搜索信号与验证门控各改一层
自进化这一批的共同纪律是只改一层,并且给这一层配对照:技能图、错误记忆的路由、教师监督的安排、搜索用的信号,各自被拆开定价。看的时候先问它改的是哪一层,再看没动的那一端有没有被冻住。
1. Self Improvement via Fast Tree-search(arXiv:2609.19526,直接命中·智能体、规划与决策)
- 研究问题:编码智能体递归改自己的实现时,最贵的一步是评估候选改动——每次都要重跑一部分基准;能不能换成便宜的信号来排序候选。
- 改动位置(维度):只改搜索层与信用分配,权重不动。判官只读智能体的实现文件,成对比较候选改动。
- 核心方法机制:用语言模型判官对候选补丁做成对比较,胜负记录经正则化的 Bradley–Terry 模型聚合成强度分,强度分驱动树搜索里的父节点采样;昂贵的下游任务评估只留给最有希望的节点;搜索流水线完全异步解耦,判官打分不阻塞在慢评估上。
- 关键定量结果(含比较对象与口径):Polyglot-225 上 31.1,对照 HGM 30.5、DGM 27.1、SICA 25.1、基座 20.0;换成另一组模型时 35.1,对照 DGM 30.7、基座 14.2,而同一设置去掉判官只有 29.8,低于 DGM 的 30.7。TerminalBench 2.1 上,按判官排名第一的智能体 32.7/89(36.7%),按准确率排名第一的只有 25.0/89(28.1%)。判官自身的质量:最强判官对最佳智能体的召回@5 为 4/5、Spearman 相关 +0.72;把完整文件而不是差异块喂给判官,相关从 0.40 升到 0.68。成本上,一组配置是 34.3 美元 API、224 CPU 小时、6.7 小时,正文另一处又写 42 CPU 小时与 150 美元。
- 证据强弱与复现边界:主比较是单次搜索,另一组配置有 3 次重复(32.0 到 35.6);最终成绩仍然依赖下游基准确认,且最强配置里判官强于被编码的骨干,属于非纯自评判;摘要写「完整 Polyglot」而搜索实际只用其中 50 题;资源数字在正文与表之间不一致。没有公开入口。
- 对目标研究线的连接点:直接命中轨迹学习与自进化。把最贵的评估换成可复用的排序信号,是自进化能不能跑起来的关键一环。
- 结论与阅读建议:建议精读判官设计与资源对照两节;引用性能数字时带上 Polyglot-50 这个搜索集。
- 入口:栏目正文 · arXiv
2. UnifiedPlayers: Enhance Tool-Integrated Reasoning in Agentic Reinforcement Learning(arXiv:2609.20089,直接命中·智能体、规划与决策)
- 研究问题:工具智能体的自进化里,出题、解题、判题三件事各自变化,会互相污染对方训练用的数据;三者联合训练能不能稳定下来。
- 改动位置(维度):改权重,同时改奖励与信用分配。三个角色各拿一份从可执行证据派生的奖励。
- 核心方法机制:规划角色出题、执行角色用 Python 工具多轮作答、评估角色构造可执行的验证器;三者共享一个扰动引擎与沙箱裁决矩阵,奖励都从可执行证据派生,评估角色额外加了代码多样性项。每轮外层迭代串行跑三个 GRPO 更新块;对照臂用迭代开始时的快照产生证据,用来区分「用新证据」与「用旧证据」的差别。
- 关键定量结果(含比较对象与口径):数学平均 56.4 对既有自进化基线 52.7,通用域平均 46.1 对 42.1(Qwen3-4B 基座)。因子实验里三角色全开 56.4±0.8,只开执行角色 50.6±1.1;去掉扰动引擎 51.6(−4.8)。机制分析里,评估角色对对抗样本的拒绝率在 3 次迭代内从 31% 升到 79%。
- 证据强弱与复现边界:因子消融有 3 个配对种子、每种子 312 到 432 GPU 小时,并有新旧证据的冻结对照;但主表是单次评估没有方差,训练任务全部是数学题、通用域增益属于迁移,扰动规则只有 5 条。没有公开入口。
- 对目标研究线的连接点:直接命中轨迹学习与自进化。三个角色各自的可执行证据来源写得很细,是可以照着搭的结构。
- 结论与阅读建议:建议精读三角色奖励的派生方式与新旧证据对照;迁移到非数学任务前要先自测。
- 入口:栏目正文 · arXiv
3. SkillAA: Attribution-Guided Skill-Graph Updating with Targeted Validation and Rollback(arXiv:2609.20455,直接命中·其他/综合 AI)
- 研究问题:智能体维护一张技能图时,一次失败该改图上哪一处;改错地方会连带破坏本来能用的部分。
- 改动位置(维度):只改技能图,学生模型与教师模型全部冻结。
- 核心方法机制:技能图的节点带适用条件、执行步骤与对象地址,边带理由;失败后教师用固定的五步诊断链路归因到六类根因,只编辑对应的字段或边,归不出根因就不打补丁;两级门控——局部门控对改动做配对重测,大范围门控按轮次提交,补丁组原子接受或整体回滚。
- 关键定量结果(含比较对象与口径):SearchQA 81.5±1.3 对扁平技能 72.5;LiveMath 66.7±2.1 对 42.2;DocVQA 91.2±1.0 对 87.7。与另一套提示演化方法比,SearchQA 87.0±0.6 对 84.8,但这是按各自原始协议比,不是同算力。去掉大范围门控后相对扁平技能的增益变成 +7.5/+17.9/+4.5,也就是说门控在两个基准上反而压低了增益。
- 证据强弱与复现边界:三种子独立优化加评估、报半极差,冻结设置与组件消融齐备,是本期技能图方向里做得最完整的一篇。边界:与外部方法的比较不同算力;三个种子的半极差不是置信区间;严格的精确匹配把别名和格式差异算成错;图规模中等、只做单轮。代码仓库公开可访问,含配置、数据、图优化与测试目录,但目前只有一份许可证说明文件。
- 对目标研究线的连接点:直接命中轨迹学习与自进化。归因到唯一可编辑面加两级门控加原子回滚,是可以直接落地的一套。
- 结论与阅读建议:建议精读,重点看六类根因与门控的判定条件。
- 入口:栏目正文 · arXiv
4. SoL-Pi: Recursively Scaling Auto-Research Loops for Efficient Agent Harness(arXiv:2609.20519,直接命中·其他/综合 AI)
- 研究问题:驾驭层本身能不能像模型一样用自我研究循环来改进,而且改进的判据不只是质量还要算效率。
- 改动位置(维度):只改驾驭层,不训练模型权重。
- 核心方法机制:外层把 152 条机制假设分成六族,用 oracle 分析找出可避免的工作量;内层循环走「提议、实现、固定实验、评审、保留或丢弃」,加独立评审与能力/效率双门控。最终保留四件改动:动作融合、在线上下文压缩、观察打包、保留证据的规约器。
- 关键定量结果(含比较对象与口径):EdgeBench 上 token 消耗 1.0990B 对基线 2.1538B(−49.0%),成本 894 对 1,339 美元(−33.2%);观察打包这一件使平均分 47.208 对 44.833。Terminal-Bench 4 上解出 15 题对 18 题,但总成本低 26.3%;某数学竞赛上通过 3/6,成本 62.69 对 114.47 美元。逐件加入的消融显示,单加动作融合就有 46.664 对 44.833。
- 证据强弱与复现边界:搜索集 535 个环境,评估集另置,训练用一套模型、迁移到另一个模型上验证,四件改动默认关闭便于消融。边界:关键评估每配置单次运行没有方差;质量侧并非全面占优;自动研究循环本身很贵,无法在固定预算下比较搜索的广度与深度。代码与项目页都公开可访问,代码许可为 MIT。
- 对目标研究线的连接点:直接命中轨迹学习与自进化,也落在长程任务的成本口径上。它把「驾驭层自进化」的收益用 token 与美元报了出来,分数之外还有成本。
- 结论与阅读建议:建议精读,重点看双门控的判据与四件改动的逐件消融。
- 入口:栏目正文 · arXiv
5. FINSKILLOPS: A Self-Evolving Multi-Agent System for SEC Filing QA(arXiv:2609.19680,直接命中·多智能体与博弈)
- 研究问题:把技能当成可以提案、验证、上架和退役的资产来管理,能不能在部署之后继续变好而不引入回归。
- 改动位置(维度):只改技能库,模型权重与服务流程都不动。
- 核心方法机制:两阶段诊断按错误模式聚合,超过阈值才提案;技能草案自带适用与排除条件、以及注入位置,可被修订;准入要过三关——定向验证有提升、保护集回归为零、负对照不误触发;通过后进注册表并做版本化,效果下滑就退役。
- 关键定量结果(含比较对象与口径):权重正确率从初始 3.70 升到 4.55;在一个内部集合上相对多智能体初始版本 3.46 升到 4.52;去掉技能演化这一环是 −0.85,准确率增量从 +0.62 掉到 +0.00。四个基准等权平均 3.66 对另一套技能优化方法 2.66。12 轮运行里,非纠正率从 30.0% 降到 18.3%;33 个候选只有 6 个晋升,5 个被保护集挡下并暴露 7 处回归。
- 证据强弱与复现边界:技能生命周期的治理逻辑是这一篇的主要价值,评价者一致性 κ 在 0.675 到 0.840 之间。但主结果来自自建基准且每个任务只跑一次,消融给出的配对区间跨越零,12 轮同时改了路由与诊断两处,无法建立盲泛化;保守门控会拖慢适应速度。没有公开入口。
- 对目标研究线的连接点:直接命中轨迹学习与自进化。它回答的是自进化最容易被忽略的一问:改完之后怎么保证没把已经会的弄坏。
- 结论与阅读建议:建议扫读,重点看准入三关与退役条件;分数不要单独引用。
- 入口:栏目正文 · arXiv
6. EconSkills: Studying Skill Transfer and Retrieval for Web Agents on Live Economic Data(arXiv:2609.19523,直接命中·其他/综合 AI)
- 研究问题:从已经解过的任务轨迹里提炼出的技能,能不能迁移到同类新任务上;技能库越大越好吗。
- 改动位置(维度):只改技能库,权重不更新。技能从已验证的成功轨迹蒸馏,实例值被替换成占位符。
- 核心方法机制:把每条已解轨迹蒸馏成一个带七段式步骤的经济数据检索程序,序列化成可注入的文本;评测时按需匹配注入,与直接给原始轨迹、给提示、给全部技能等条件对照。
- 关键定量结果(含比较对象与口径):配对 300 题上 49.3% 对基线的 41.0%(+8.3 个百分点),双成功格上平均少 2.37 步。库级检索 360 题上 28.3% 对基线 28.1%,几乎没有差别;把 50 条技能全部注入掉到 11.4%,显著低于基线;对没有覆盖到的任务给提示,11.4% 也低于基线 16.7%。
- 证据强弱与复现边界:技能库本身公开可下载(50 条,许可为 Apache-2.0),迁移实验有 100 个变体乘 3 个种子的受控设置。边界:没有隔离提示长度、冲突指令与相关性判断三者的作用,库级实验是单次运行,技能库没有版本合并与冲突处理,未覆盖任务上的技能反而拖慢或带偏。这一篇是本期少见的「技能越多越差」的定量证据。
- 对目标研究线的连接点:直接命中轨迹学习与自进化。技能库要不要按需检索、上限设在哪,这篇给了负方向的证据。
- 结论与阅读建议:建议扫读,重点看库级检索与全量注入两组对照;技能库可以直接下载来试。
- 入口:栏目正文 · arXiv
7. LearnActCoder: Role-Aware Error Memory for Adaptive Clinical Coding Agents(arXiv:2609.19721,邻近跟踪·其他/综合 AI)
- 研究问题:智能体从自己的错配里学习时,漏判和误判是两种相反的错,能不能把它们分别路由给适合的角色。
- 改动位置(维度):只改记忆层。纯推理期适配,权重与工作流都不动。
- 核心方法机制:先把一小批错配蒸馏成结构化的错误知识库,再按角色路由——漏判的教训送给偏向召回的编码角色,误判的教训送给偏向精确的审核角色;两个角色多轮交互并查表校验,把「代码存在且描述匹配」与「临床证据支持」分开判断。
- 关键定量结果(含比较对象与口径):MIMIC-III 150 篇上 CPT 的 F1 从 11.5 升到 17.4(+5.9 个百分点);同一批上 ICD-9 从 41.1 到 42.6(+1.5,p=0.11 不显著);MIMIC-IV 上 ICD-10 精确率 40.3 对 36.1(+4.2,p=0.003)。记忆表示对照:结构化条目 17.4 对原始样例 12.1。
- 证据强弱与复现边界:有配对 bootstrap 与 Wilcoxon 检验,但任务域窄、受控子集只有 150 篇、绝对性能偏低,参考标签是行政编码而非专业编码员审定,也没有做路由对调或对称路由的消融。公众号摘要只写了那 +5.9 个百分点,略去了 ICD-9 不显著这一条。没有公开入口。
- 对目标研究线的连接点:邻近跟踪。可迁移的是「按错误方向路由记忆」这个机制:任何有明确漏判/误判区分的智能体都可以借用;但它本身不是长程或自进化的主线工作。
- 结论与阅读建议:按连接点取用机制,不必通读原文。
- 入口:栏目正文 · arXiv
轨迹学习与训练信号:奖励没定价的步骤会被学掉
这一批把训练信号本身当对象:失败轨迹能不能当数据、教师什么时候该退场、组内优势的分母怎么取、用来排序的信号是否真的在测任务、以及评测协议会不会随预算换向。
1. RetireOPD: Self-Retiring On-Policy Distillation for Agentic Reinforcement Learning(arXiv:2609.20784,直接命中·其他/综合 NLP)
- 研究问题:在策略蒸馏里,教师从头监督到尾会把学生的探索压住;教师该在什么时候退场。
- 改动位置(维度):改权重的监督安排。先把技能条件化的教师用强化学习训好再冻结,学生同时拿环境奖励与蒸馏损失,并按窗口内的 token 差距与成功率自适应地让教师退休。
- 核心方法机制:学生目标由两部分组成——常规的组相对策略优化损失,加上一个反面 KL 的采样式蒸馏损失,权重由自适应系数控制;系数按「教师与学生在该窗口上的差距」以及「学生自己的成功率」决定,条件满足就退休,之后完全回到常规训练。
- 关键定量结果(含比较对象与口径):1.5B 上 ALFWorld 89.8 对纯强化学习 72.8、WebShop 75.8 对 56.8;3B 上 93.8 对 75.0 与 77.3 对 63.3;7B 上 95.3 对 81.2 与 84.4 对 72.6。消融里完整方法 92.2、不退休 82.8、纯强化学习 75.0(3B)。教师未优化时 3B/7B 只有 28.9/23.4,优化后是 79.7/90.6。退休之后继续训练,成功率从 76.6 升到 93.8。
- 证据强弱与复现边界:近邻对照完整,训练脚本与代码公开可访问(许可 Apache-2.0,含两阶段脚本),是本批少数能跑的。边界:论文没有自陈局限;任务短程、环境脚本化;未报告种子、训练集规模与算力;固定 150 步。
- 对目标研究线的连接点:直接命中轨迹学习与自进化里的「教师该退场」这一支,也落在长程任务的训练侧。
- 结论与阅读建议:建议精读,重点看退休判据的两个观测量与阈值敏感性。
- 入口:栏目正文 · arXiv
2. What Does Privileged Information Add to On-Policy Self-Distillation?(arXiv:2609.20612,直接命中·其他/综合 NLP)
- 研究问题:在策略自蒸馏里,教师拿到的「特权参考」到底贡献了什么——是泄露了解题内容,还是帮助学生把一种生成模式迁移到另一种。
- 改动位置(维度):改轨迹表示与监督信号。用同一道题的多个答案匹配视角构造对照,只微调学生的低秩适配器。
- 核心方法机制:每道题准备六个答案匹配的视角,比较有参考与无参考两种蒸馏;损失用逐词裁剪的前向 KL,教师开启思考但不更新;再切换 rollout 的类型与损失支撑集,看结论会不会反转。
- 关键定量结果(含比较对象与口径):Qwen3-1.7B 域内第 100 步,无参考蒸馏比基座 +1.80([0.20, 3.47])Avg@4;外部基准 +4.07([1.73, 6.54])Avg@12。有干净解相对无参考只 +1.30([0.20, 2.41]),经 Holm 校正后不成立;有干净解相对基座则是域内 +3.10([1.54, 4.73])、外部 +4.91([2.04, 7.96])。换成长时间思考的 rollout 之后,答案、干净解与完整轨迹三种条件相对基座的增益全部转负。
- 证据强弱与复现边界:5,319 道题乘 6 个视角共 31,914 条,10,000 次问题簇 bootstrap 加 Holm 校正,部分条件有 3 到 4 个种子,代码与数据集都公开可访问(许可 MIT 与上游 Apache-2.0)。边界:短程数学、100 步低秩微调,第二个骨干的关键对照只有两个种子,外部基准每题 30 题,只测正确性。
- 对目标研究线的连接点:直接命中轨迹学习与自进化。它的价值在于演示了「换一种 rollout 就反转」的反例,任何搭蒸馏管线的人都该先跑一遍这个对照。
- 结论与阅读建议:建议精读,重点看六视角的构造与换 rollout 后反转的那张图。
- 入口:栏目正文 · arXiv
3. Advantage Scale Calibration Imbalance in Group-Relative Optimization under Low-Variance Rewards: Diagnosis and Bounded Recovery(arXiv:2609.19164,直接命中·其他/综合 NLP)
- 研究问题:奖励方差很低时(大多数样本得分相同),组相对优化里的优势会被少数几个异常值主导,训练因此不稳;这在哪个环节坏、能不能有界地修。
- 改动位置(维度):只改组内优势的分母,并配一套奖励分辨率协议。
- 核心方法机制:诊断口径是有界、带分辨率下限、并跳过零差距组的奖励分辨率协议;修法是把组内优势除以「该组最大绝对优势与分辨率下限的较大者」并阻断梯度,实例化到两种已有的组相对方法上。
- 关键定量结果(含比较对象与口径):Qwen3-32B 在 AIME25 上 84.2±1.2 对预设 p90 参照的 79.4±0.9(+4.8);LiveCodeBench v6 上 69.7±0.7 对 63.9±0.8(+5.8);另一个竞赛集 63.0±0.9 对 59.1±1.0(+3.9);MoE 骨干上 93.7±1.1 对 90.0±1.2(+3.7)。六个评测单元全部为正,平均约 +4.77。消融里新方法 78.3 对组相对基线的 70.6,同时 KL 从 0.086 降到 0.055。
- 证据强弱与复现边界:5 个种子加种子 bootstrap 区间、预设 p90 参照,是本期奖励侧里证据形状最完整的一篇。边界:有界干预不是通用解,主观判官的场景仍需另行校准,GPU 时长与完整超参未公开,没有代码。
- 对目标研究线的连接点:直接命中轨迹学习与自进化里的信用分配层。诊断指标可以直接套到训练日志上,用来判断这次训练是不是在跟少数异常样本较劲。
- 结论与阅读建议:建议扫读,重点看诊断指标的定义;引用时注意对照组取的是同一方法的 p90 参照。
- 入口:栏目正文 · arXiv
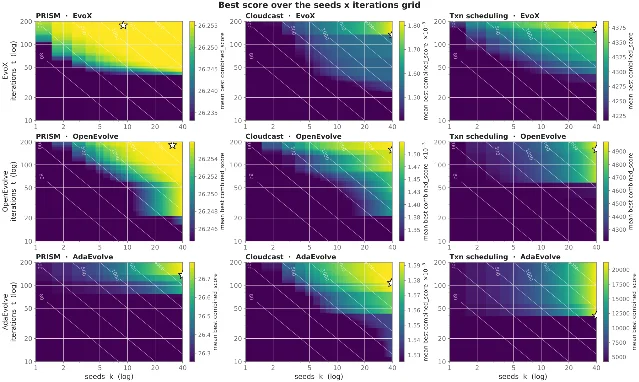
4. Evolution or Illusion? Rethinking Evaluation in LLM Evolutionary Search(arXiv:2609.19799,直接命中·其他/综合 NLP)
- 研究问题:进化式搜索的论文通常只报一个预算点(几个种子、固定迭代次数)就给方法排名;换一个预算点,排名还成立吗。
- 改动位置(维度):只改评测协议。用完整的种子数乘迭代次数网格替代单点报告。
- 核心方法机制:固定搜索智能与底层模型,切换三种进化策略,在五个优化任务上扫满种子数与迭代次数的网格,每个预算点的最优成绩按次序统计量计算,并报出宽深前沿与 2,000 次 bootstrap 下的排序反转概率。
- 关键定量结果(含比较对象与口径):40 个种子乘 200 次迭代的网格上,一个任务里某策略在单种子时排第 3(1.19e-3),到 40 种子时升到第 1(1.82e-3);另一个任务上第 1 与第 2 名互换;还有任务上最优迭代次数远低于常见实践,多出来的深度浪费掉本可以换成更多种子的预算。在十分之一预算下,最优的宽深划分又与全预算下不同。论文还记录了一起奖励漏洞:某方法发现得分高四倍的程序,实际是钻了验证器的空子。
- 证据强弱与复现边界:40 个种子乘 200 次迭代的完整网格与 bootstrap 反转概率,方法上可直接搬。边界:评估是离线事后评估,只用一个引擎与一个模型,API 成本很高,没有跨批次重复,交易类任务的评估器本身不完整。没有公开入口。
- 对目标研究线的连接点:直接命中轨迹学习与自进化。它把「自进化到底有没有变强」变成一个要先问预算点的问题。
- 结论与阅读建议:建议扫读,重点看前沿的读法与排序反转概率;下次要复现任何进化搜索的排名,先按它的协议跑一遍网格。
- 入口:栏目正文 · arXiv
5. Chronicle: Cut-Point Replay for Regression Testing of LLM Agents(arXiv:2609.20625,直接命中·大语言模型与基础模型)
- 研究问题:语言模型智能体的失败很难复现,因为它依赖不可逐位复现的推理、会变状态的工具和很少重复的多步轨迹;改了代码之后,怎么拿旧事故当回归测试。
- 改动位置(维度):只改边界插桩与测试协议,不改权重。
- 核心方法机制:把一次运行在它的非确定边界上记录成不可变封套;核心操作是切点回放——选定一部分边界从记录里取值、其余边界用新代码实时执行,于是旧事故变成可以在持续集成里跑的回归测试。断言用结构化检查,语言模型判官只作建议。
- 关键定量结果(含比较对象与口径):记录一次跨越的中位开销 23 微秒,占假设 300 毫秒模型调用的 0.008%;开启记录后总延迟 3,136 毫秒对关闭时 3,045 毫秒(+91 毫秒,区间 [−59, 241])。完整回放 20 次零分歧、零次实时跨越、零模型调用、零接口费用。切点测试在 6 个事故上全部检出未防护的失败,对已加防护或无关改动则通过;同样的断言换成全部打桩的基线,6 个事故一个也没检出。192 个一阶变异体里,切点测试杀死 51 个、打桩基线杀死 0 个;在会改记录的 82 个变异体里杀死 51 个(62%)。
- 证据强弱与复现边界:代码与基准在同一个公开仓库里(许可 MIT,含 6 个事故夹具),可以立刻拿来自建。边界:不捕获流式与并发,不重抛异常,只捕获接口层;基准是 6 个自建事故,规模小,延迟只在笔记本处理器上测。
- 对目标研究线的连接点:直接命中长程任务的评估与自进化的验收。自进化改完代码之后,需要一道能挡住回归的闸门,这一篇给的就是闸门。
- 结论与阅读建议:建议精读,重点看切点选择与「哪些改动能被挡住」的变异研究。
- 入口:栏目正文 · arXiv
6. Reflective Recovery: A Self-Supervised Method for Reasoning by Learning from Mistakes(arXiv:2609.19156,直接命中·大语言模型与基础模型)
- 研究问题:只用正确轨迹做模仿学习,在题量有限时会遇到「加更多正例也不涨」的天花板;能不能把失败的尝试变成训练数据。
- 改动位置(维度):改权重,同时改轨迹表示与损失口径:截取失败轨迹的前缀并重新采样,损失只算错误前缀之后的部分。
- 核心方法机制:从失败轨迹里截断出初始片段,接上提示让模型继续求解,只在错误前缀之后的 token 上计算损失;整个过程不需要外部评判器或奖励模型。
- 关键定量结果(含比较对象与口径):7B 模型上 AIME24 从 53.0 到 54.3(常规正例微调)再到 56.7;AIME25 从 30.0 到 34.7 再到 37.5;Minerva 从 37.6 到 46.7 再到 47.8。14B 上 AIME25 从 40.0 到 43.3 再到 45.3,LiveCodeBench 从 48.3 到 53.1 再到 55.3。截断点消融:取轨迹一半 37.5,取四分之三 35.8。
- 证据强弱与复现边界:同一条流水线内部有常规正例微调作对照,方法本身简单可查。边界:增益集中在 1 到 3 分且偏数学,构造失败与重采样成本高,未报告种子与算力,没有官方入口。公众号把「规模塌缩」归因于错误累积,原文归因于题集有限时增加正例不再带来持续提升,这是两种不同的机制。
- 对目标研究线的连接点:直接命中轨迹学习与自进化里的「用什么轨迹训练」这一支。
- 结论与阅读建议:建议扫读,重点看截断点消融;把它当成一个可以试的便宜手段,别当效应量引用。
- 入口:栏目正文 · arXiv
7. Dual-Axis Policy Optimization for LLM Agents: Bayesian Feedback Attribution and Trajectory Mass Normalization(arXiv:2609.19830,直接命中·智能体、规划与决策)
- 研究问题:多轮智能体的训练里,同一条轨迹内部的哪些步骤值得学,以及不同长度的轨迹之间该按什么权重聚合,这两件事常常被混在一起。
- 改动位置(维度):改奖励与信用分配、以及批内聚合口径,兼容两种已有的组相对方法。
- 核心方法机制:一条轴用贝叶斯方法把环境反馈归因到具体动作上,做法是采样反事实动作并用反馈似然做后验、再按长度校正;另一条轴把按有效 token 平铺的聚合改成每条轨迹等量贡献,让短轨迹不再被长轨迹淹没。
- 关键定量结果(含比较对象与口径):ALFWorld 1.5B 上组相对策略优化 72.9±3.4 提到 85.6±2.8,另一种组方法 86.8±1.8 提到 94.1±1.7;7B 上 77.7±5.0 到 86.9±2.7 与 90.9±1.4 到 94.9±1.5。WebShop 1.5B 上 57.1±3.6 到 68.2±2.8 与 67.1±4.7 到 76.4±2.7。消融显示两条轴的贡献可加:基座 72.9、加归因 84.1、加归一 82.4、两者同开 85.6。墙钟时间是基线的 1.10 到 1.17 倍。
- 证据强弱与复现边界:三个环境、两个规模的匹配变体共享训练,消融可加性清楚。边界:归因那条轴测的是模型兼容性而非因果,部分提升与标准差同量级,没有报告种子与重复,算力未报。没有公开入口。
- 对目标研究线的连接点:直接命中轨迹学习与自进化里的信用分配层。把「轨迹内部」与「轨迹之间」分成两条轴,是可以直接借用的记账结构。
- 结论与阅读建议:建议扫读;轨迹间归一那一轴改动小、代价低,可以先试它。
- 入口:栏目正文 · arXiv
长程执行、失败恢复与自主研究
这一组处理的是「跑到一半坏了怎么办」以及「谁来定研究方向」:把模糊的失败变成可用的监督数据、按依赖结构决定要不要派生更多智能体、把结案案例的轨迹做成条目级索引、在调用进入门控之前先做一次成员与签名检查。
1. MAGMA-GEN: Validated Recovery Supervision from Ambiguous Failures via Counterfactual Re-Execution(arXiv:2609.20056,直接命中·智能体、规划与决策)
- 研究问题:分层机器人执行长程操作时,一次失败是「高层决策选错了」「观测不全」还是「决策对但执行坏了」分不清;这种模糊失败正好是恢复监督最缺的数据。
- 改动位置(维度):改监督数据的生成方式。底层技能冻结,最后用低秩适配做监督微调。
- 核心方法机制:先按阶段切分轨迹并粗分类失败;再由带特权信息的「教练」定位最早的疑似决策错误步、给出诊断,并提出一个修正动作或一个恢复动作;候选干预作为分支,在模拟器里从同一状态重新执行,只有下游进度真的变好才保留;随后在策略采样与教练提议的并集上按子树成功率选出样本,用于监督微调。
- 关键定量结果(含比较对象与口径):恢复率 26.25±3.75% 对最强采样式基线 16.66±1.36%(+9.59 个百分点);任务成功率 16.79±2.98% 对 14.15±2.76%;条件目标完成 30.74±3.98% 对 26.73±4.84%。消融很清楚:没有教练指导 1.66±1.44,有提议但不做重执行验证 5.00±0.00,两者齐备 26.25±3.75。真机每条件 30 次里成功 15 次,对照的专家轨迹 12 次、另一基线 11 次。代价是 3,585 次大模型调用加 5,012 次小模型调用,阶段覆盖 77.56%,产出 3,769 个正样本。
- 证据强弱与复现边界:4 次生成运行、同 180 个种子任务、均值加减标准差,对比基线包括采样式、修复式与专家轨迹。边界:只能恢复「现有高层动作仍有可行延续」的失败;仿真与真机的动力学不匹配会让已验证的干预失效;绝对指标低,真机只是迁移可行性,没有统计检验。公众号摘要写「仿真与真机都提升」,原文正文明确真机只证明迁移可行。
- 对目标研究线的连接点:直接命中长程任务的训练与评估。反事实重执行这条验证回路,可以搬到任何「失败原因不明确」的长程环境里。
- 结论与阅读建议:建议精读,重点看候选干预怎么被验证、以及消融里「有提议不验证」那一档。
- 入口:栏目正文 · arXiv
2. Rethinking Multi-Agent Collaboration: When More Is Less(arXiv:2609.19759,直接命中·多智能体与博弈)
- 研究问题:多个智能体分工是不是总比一个强;在长程任务里,什么时候该派生新的子智能体,什么时候该让主智能体自己干。
- 改动位置(维度):只改协作拓扑与编排:把任务轨迹形式化成依赖图,只在检测到跨子任务的桥边时才派生,否则主智能体单干。
- 核心方法机制:用依赖图把任务切开,节点完成时把结果写下来、下游按需检索,形成渐进式的边解析;派生有上限(默认深度 1、数量 4),一旦某个性质不满足就不派生。
- 关键定量结果(含比较对象与口径):四个长程基准上结论并不一致:Terminal Bench 2.1 的解决率单智能体 76.71 反而高于本方法 75.50;NL2Repo 上 49.23 对 48.74;深度研究基准上 55.23 对 51.49;另一长程基准上 71.80 对 53.57。token 上 NL2Repo 用 1,282M/11M 对 1,408M/10M,Terminal 用 501M/10M 对 475M/8M。把派生上限从 4 放松到 5、6,成绩从 71.80 掉到 67.32、64.02;深度从 1 放到 2、3 掉到 66.39、63.17。
- 证据强弱与复现边界:四个长程基准、统一驾驭层、基础模型相同,对照含单智能体与三种多智能体编排。边界:协作收益只在依赖稀疏的长程任务上成立,密集耦合的任务上单智能体仍占优;只有 Terminal 报告了 3 次尝试,其余重复次数未报;依赖密度没有自动判据,派生上限靠人工设死。论文正文自己写了「本方法并非在每个基准上都占优」,公众号摘要省略了这一句。没有公开入口。
- 对目标研究线的连接点:直接命中长程任务的评估,也是「要不要上多智能体」这条选型问题的直接证据。
- 结论与阅读建议:建议精读,重点看桥边检测与前后的 token 成本;引用时必须带上那个反例。
- 入口:栏目正文 · arXiv
3. RAFT: A Stateful Retrieval-Augmented Framework for Troubleshooting Agents(arXiv:2609.20754,直接命中·其他/综合 AI)
- 研究问题:故障排查案例是有状态的、多阶段的,按整篇案例检索会把无关阶段一起带进来;能不能按条目检索并锚定到关键那一步。
- 改动位置(维度):只改检索表示与索引。案例被抽成有序的时间线条目链,检索在条目级进行。
- 核心方法机制:把结案案例抽成时间线条目,每条记录动作、当时的假设与理解,并抽出评审意见、根因、修复与实体;条目级用语义加关键词的倒数排名融合检索,再贪心升到父案例,返回完整轨迹并锚定命中的条目;可选的案例级图按预算做一跳扩展。
- 关键定量结果(含比较对象与口径):合成集上案例命中 0.842/0.871/0.888 对朴素检索 0.673/0.719/0.769;配对差 +16.79 个百分点([13.91, 19.78])。真实工单集上案例命中 0.833/0.840/0.895 对 0.667/0.667/0.789。插入无关轮次后,本方法在 60% 进度点只掉 9.36 个百分点,朴素检索掉 49.31。要留意的是根因与修复两个维度:60% 进度点上的配对差分别只有 +1.88([−0.07, 3.89])与 +0.57([−1.18, 2.32]),区间跨零。
- 证据强弱与复现边界:合成集 826 个案例跑 5 次独立运行,真实集 30 组加 570 个干扰共 600 个案例跑 5 次平均,索引与评测模型固定。边界:主评测是中等规模合成语料,案例长度远小于真实工单;真实集只有 30 组且没有区间;不评端到端诊断或修复成功率。代码公开可访问(许可 MIT,含测试、示例与数据集)。
- 对目标研究线的连接点:直接命中长程任务的评估与记忆检索层:条目级检索加锚定轨迹这一套可以直接搬成长程智能体的经验检索层。
- 结论与阅读建议:建议扫读,重点看条目抽取的字段与检索融合;引用时把「命中」与「根因、修复」两个维度分开说。
- 入口:栏目正文 · arXiv
4. Closed-World Resolution Against Tool Hallucination in LLM Agents(arXiv:2609.19425,直接命中·智能体、规划与决策)
- 研究问题:智能体会调用根本不存在的工具,这类幻觉在结构上是「没有封闭世界假设」造成的;在调用被放行之前该做什么。
- 改动位置(维度):只改调用解析层。在执行门控之前插入一个不做训练、只做注册表成员检查与签名检查的解析器。
- 核心方法机制:先把工具幻觉分成五类,再用一个训练无关的解析梯级做成员与签名校验,放在门控之前;配套基准对任意解析器打分,报每类攻击的成功率、诚实请求被误拒的比例,并保留留出划分。
- 关键定量结果(含比较对象与口径):十模型两界面合计捕获 322 次真实幻觉;其中一类在原始 JSON 界面出现 34 次、在带模式的界面只有 3 次;十模型在两界面下每模型 60 次探测时,某闭源模型在带模式界面幻觉率为 0.00,一个开源 8B 是 0.62/0.73。消融显示只做门控会放行前三类全部与第五类,解析梯级单独就能把前三类归零,全栈把前四类归零且诚实误拒为 0。在工具协议在线环境里十模型合计 154 次幻觉,朴素主机全部执行,解析梯级全部拒绝。综合基准分数:单注册表解析加门控 0.96、只用解析梯级 0.76、无防御 0.00。
- 证据强弱与复现边界:受控消融每类 400 个试例,结论在「解析层必须在门控之前」这一点上很有用。边界:诚实误拒为 0 是构造一致性;没有区间与重复;第五类存在不可约残余。论文声明的安装包在一个公开包索引上对应的是另一个项目,因此当前没有可打开的公开入口。
- 对目标研究线的连接点:直接命中长程任务的评估。工具幻觉的计数与「先解析后放行」的位置结论,可以直接进调用栈设计。
- 结论与阅读建议:建议扫读,重点看五类幻觉的划分与消融表;防御效果读者自带折扣。
- 入口:栏目正文 · arXiv
5. ScientistTwo: Pioneering the Human Knowledge Frontier with Autonomous AI(arXiv:2609.19644,邻近跟踪·多智能体与博弈)
- 研究问题:给一个开放问题,让多智能体自己找文献空白、提假设、做实验、写论文,并且用模拟评审自我验证,能做到什么程度。
- 改动位置(维度):改研究流程编排,基础模型权重不动。文献局限抽取与核验、想法生成与新颖性检查、编码复现基线、想法演化、消融归因、写作与评审反驳构成闭环。
- 核心方法机制:先迭代抽取并核验现有最优结果的局限,再产出一批候选想法,用编码智能体复现基线并三分类筛选;想法演化环节会吃掉包括失败日志在内的执行轨迹;评审闭环最多两轮,早期停止由自动评审触发。
- 关键定量结果(含比较对象与口径):107 道取自三个顶会接收论文的问题上,86 篇自动论文的自动评审分 7.5±1.3、认可率 91.9%,对照另一个自动研究系统在不同样本量下是 5.7±0.6/72.1% 与 3.8±1.2/14.3%。消融去掉评审与反驳后降到 5.2±2.2、46.9%,两轮评审为 7.6±1.0、93.9%。相对人类最强基线的增益中位 7.7%、平均 25.2%。成本上单个任务 2 到 3 天、约 3,765 美元。
- 证据强弱与复现边界:两个自动评审给出方向相反的结论,论文自己也写尚未稳定达到顶会亮点级;每问题单次运行、无种子与重复、样本量不配对、失败的那些篇目没有报告原因。项目页可以打开,有 86 篇预览与审计表,但没有代码、权重或数据入口。认可率 91.9% 要打折使用。
- 对目标研究线的连接点:邻近跟踪。可迁移的是「用执行轨迹(含失败日志)驱动假设演化」与「自评闭环加早期停止」这两段编排;它本身是自主研究系统,不是长程智能体的评测工作。
- 结论与阅读建议:建议精读它的编排与消融两节,结论部分按自动评审读。
- 入口:栏目正文 · arXiv
6. Position: It is Time to Virtualize Foundation Models with a Self-evolving Operating System Layer(arXiv:2609.19203,邻近跟踪·智能体、规划与决策)
- 研究问题:智能体系统被框架切碎,状态、记忆、预算与护栏各写各的,行为不可移植、治理脆弱;要不要在框架之下加一层操作系统。
- 改动位置(维度):提出系统层抽象,主张在编排框架下新增一层,把基础模型交互虚拟化;不改权重。
- 核心方法机制:立场论文。提出三条设计原则(能力虚拟化排在稳定语义之后、需求驱动编排、生态兼容)与三类组件(记忆分层与分页缓存、模型组合路由与版本回滚、按风险升级验证的可信层级),并给出两个设想案例。
- 关键定量结果(含比较对象与口径):零实验、零数据、零基线、零复现;全文没有报告任何定量结果。附录用操作系统的经典条件做类比式形式化,作者明确标注为类比。
- 证据强弱与复现边界:当议题清单与术语表用;收益全为前瞻,敏感操作的边界需要另行定义,自进化会引入受控的非确定性。没有自有入口。
- 对目标研究线的连接点:邻近跟踪。它的价值在于把「驾驭层该管什么」列成了一份可以逐条对照的清单——记忆分层、模型路由与回滚、按风险升级验证,正好对应本期另外几篇实证工作在做的事。
- 结论与阅读建议:按清单取用,不必通读原文。
- 入口:栏目正文 · arXiv
语音与音频接口层:TTS 判官把四个维度压成一位
音频线这一期出现了一个直接命中,也是本期最实用的一篇之一:面向直播语音合成的多维韵律评判。它是评估与奖励模型,正好落在 TTS 评估这条线上;另一篇直接命中在 TTS 链路的文本前端,走到声学与波形生成之前就结束了。其余五篇是接口层工作。
1. Multi-Dimensional Prosody Judgment For Live Streaming Speech Synthesis(arXiv:2609.20124,直接命中·语音合成与声音生成)
- 研究问题:直播场景的语音合成要评情绪、语调、能量这类细粒度韵律,传统打分器评不出来,商用大模型又太贵;能不能蒸馏出一个平价的多维判官,以及多维评分本身是否可信。
- 改动位置(维度):只改奖励与评测协议,生成模型不动。先做判官蒸馏,再修多维评分里的耦合。
- 核心方法机制:把商用模型的成对判断蒸馏进一个开源多模态模型(低秩适配挂在注意力投影上,训练后合并),只保留两个顺序都一致的成对样本,课程从人机对比到跨模型与同模型对比。针对多维评分提出三项改造:删掉总体裁决这个目标,避免判官偷懒地把各维度分数对齐到总体偏好;监督微调时按成对-维度掩码掉不确定的标签;再用跨度局部化的组相对优化,把每个维度归一化后的优势只施加到该维度对应的理由文本跨度上,而不是广播到整条输出。
- 关键定量结果(含比较对象与口径):多维耦合的量化:在 140 个多维样本上,标准判官给出的核心维度判断没有一个是彼此独立的(0/140);去耦版本升到 67.9%,跨度局部优化升到 71.4%,同时与自信人评的一致率也是 71.4%。固定十次采样的四个维度一致率分别为 71.22%、70.27%、82.86%、83.50%(其中一条强约束子集为 82.35%),对照商用模型单次调用是 65.23%、65.77%、73.33%、58.00%,另一套开源评分奖励模型十次是 55.88%、48.65%、53.97%、42.00%。候选选择上,八个候选取一、400 组里有 136 组两名标注者的前三排序完全一致:命中第 1、前 2、前 3 的比例是 72.06%、77.94%、85.29%,随机期望是 12.5%、25.0%、37.5%。五个维度的成对区间全部包含零,原文因此把增益描述为描述性的。
- 证据强弱与复现边界:三名标注者独立、对系统与来源盲,训练与验证在五个层面不重叠。边界要说清:只有单一种子;拿十次采样的自家判官去比商用模型的单次调用并不对等;多维标注只覆盖四个核心维度;音频因版权不重分发,也没有作者自有的代码与权重入口。公众号这条的总结字段是空的,只留了英文摘要与链接。
- 对目标研究线的连接点:直接命中 TTS 生成与评估里的评估一侧。三项改造——删总体裁决、掩码不确定标签、优势只落到对应理由跨度——可以直接搬到任何多维奖励模型上,包括智能体的分维度打分。
- 结论与阅读建议:建议精读,重点看耦合的度量方式与三项改造的消融;用它的分数做奖励前,先在自己的语料上重跑一次 0/140 那个检查。
- 入口:栏目正文 · arXiv
2. Dictionary-Constrained Grapheme-to-Phoneme for Unsegmented Languages from LLM-Annotated Data(arXiv:2609.19805,直接命中·大语言模型与基础模型)
- 研究问题:像日语这样不分词的语言,字素到音素转换要同时解决分词与多音字消歧,而准确标注的数据稀缺。
- 改动位置(维度):改权重的文本前端。词典词格上的路径打分由判别式条件随机场完成,字符级编码器提供特征;推理时走维特比。
- 核心方法机制:先从词典构造词格,放宽分词并做边缘化,损失由条件随机场的对数似然加一个间隔项组成;训练数据用大模型合成,规模超过两百万句。
- 关键定量结果(含比较对象与口径):基准 13,536 句上,读音准确率 99.62%、词级音素错误率 0.32%、句级 0.14%,对照传统形态分析器加词典 96.66%/2.82%/1.23%、端到端字符模型 98.09%/1.22%/0.42%、合成数据所用的大模型本身 99.78%/0.18%/0.10%。去掉边缘化项后准确率 99.53%。
- 证据强弱与复现边界:必须讲清它在链路里的位置:这是 TTS 的文本前端,位于文本规整下游、声学与波形生成上游,它本身不产生任何音频,不能把它的分数写成 TTS 生成质量。边界:单一日语基准;未报告种子与重复;训练数据未公开;同一个大模型既造数据又当基线,存在循环。第三方基准仓库与数据公开可访问(许可 MIT),本文自身没有入口。
- 对目标研究线的连接点:直接命中 TTS 生成链路的文本前端一段。方法可迁到中文多音字这类同型问题上。
- 结论与阅读建议:建议扫读,重点看词格与边缘化的设计;引用时注明这是前端模块的指标。
- 入口:栏目正文 · arXiv
3. A frontend-backend architecture for tool calls in full-duplex speech models(arXiv:2609.19334,邻近跟踪·大语言模型与基础模型)
- 研究问题:全双工语音模型能自然地来回对话,但要调用外部工具时,如何不打断低延迟体验。
- 改动位置(维度):改前后端架构。双工语音转文本前端学会发出委派令牌,把流式转写转给文本后端执行工具;工具结果用轻量回填机制注入前端,再用流式合成播给用户。
- 核心方法机制:前端保持最小的双工行为改动,只增加一个委派令牌与一个智能体文本头;后端用现成的文本智能体框架跑工具循环。
- 关键定量结果(含比较对象与口径):单轮工具调用召回 92–97%,拒绝无关调用 81.2%。带更大的后端时,在全双工基准上与开源闭源模型相当;在一个交互基准上明显优于两个对照系统。代价是前端识别字错率从 10.80% 升到 11.47%。
- 证据强弱与复现边界:单次评测,没有种子、重复与区间;训练数据全为合成、不可复现;语音合成质量不在评测范围内,演示页目前也不可交互;代码、权重与数据都没有发布。
- 对目标研究线的连接点:邻近跟踪。连接点在接口层:它给出的是「双工语音前端怎样把工具调用委派出去、结果怎样回到语音通道」这一段的可行配方,可以迁移到带工具的通话型助手;它本身不评节目级质量。
- 结论与阅读建议:建议扫读架构与那三个数字;复现门槛高,不要指望直接跑起来。
- 入口:栏目正文 · arXiv
4. Full-Duplex Speech Models Take the Floor When Asked, Not When Needed(arXiv:2609.19596,邻近跟踪·其他/综合 NLP)
- 研究问题:全双工语音模型什么时候开口;它是被叫到才说,还是听懂了内容里需要它说话。
- 改动位置(维度):只改评测协议,不训练。把「有理由说」与「有机会说」分开成两组条件。
- 核心方法机制:40 段第一人称英文独白,同一话题只改触发条件,共十种条件;用词级时间戳把间隙压到 0.12 秒以内,保留自然停顿;另设 1.5 秒静音与逐提示许可作为出声机会的对照。
- 关键定量结果(含比较对象与口径):主网格 40 乘 10,每配置 5 个种子共 2,000 次试验。中性条件下的出声率在 0.01 到 0.42 之间;提问使出声率提高 0.08 到 0.24;加 1.5 秒静音后最高升到 0.83。内容类线索——假事实、重复、危险——相对中性最多只差 0.06。也就是说,出声主要由「被叫到」和「沉默够久」驱动;内容是否真的需要它介入,只带来很小的差别。
- 证据强弱与复现边界:七种配置、五个模型族、每配置 5 个种子,设计干净。边界:刺激是合成的独白、单说话人、只有英文;没有区间与显著性;出声判定阈值会漏掉短促或偏晚的插话。仓库已经建好但目前没有任何文件。
- 对目标研究线的连接点:邻近跟踪。它给的是「理由对机会」的匹配协议,可以搬到任何需要决定何时介入的实时系统上,包括播客式的双人对话生成;但它是单说话人刺激,不能读成对话质量结论。
- 结论与阅读建议:建议扫读协议设计与出声率表;把「内容线索不起作用」这条负结果记下来。
- 入口:栏目正文 · arXiv
5. Reading Emotions in the Token Space: Discriminative Adaptation of SpeechLLMs for Emotion Recognition(arXiv:2609.20081,邻近跟踪·语音语言联合与音频文本)
- 研究问题:用生成式解码读情感标签,会跑出目标集合以外的标签,也偏向高频类别;换成判别式读法会不会更稳。
- 改动位置(维度):只改读出方式。骨干冻结,在最后提示词的隐状态上接一个单层线性分类头,一次前向给出标签。
- 核心方法机制:分类头保持单层线性以保留可解释性——每个情感对应输出词空间里的一个方向,可以看出哪些词与之关联;另做单编码器与双编码器的对照。
- 关键定量结果(含比较对象与口径):IEMOCAP 四类留一说话人、5,531 句上,加分类头的宏 F1 是 78.04,不加是 75.63;用真实转写(字错率 8.06%)时 76.50 对 74.47,说明文本退化时增益最大;单编码器与双编码器接近(78.04 对 78.14)。对照基线里,一个音频语言模型 76.69、通用语音模型 70.45、另一多模态模型 54.16。
- 证据强弱与复现边界:单数据集、单种子、无区间;四类经过归并;上下文只用上一句;关联词方向反映的是预训练文本里的偏置,不能当因果解释。没有公开入口。
- 对目标研究线的连接点:邻近跟踪。连接点在读出层:任何用语音大模型做分类(包括语音质量与情感评价)的场景,都可以用这个「冻结骨干加线性头」的对照,把「模型读不出」与「解码方式不合适」分开。
- 结论与阅读建议:按连接点取用;引用分数时要带上转写质量这一条件。
- 入口:栏目正文 · arXiv
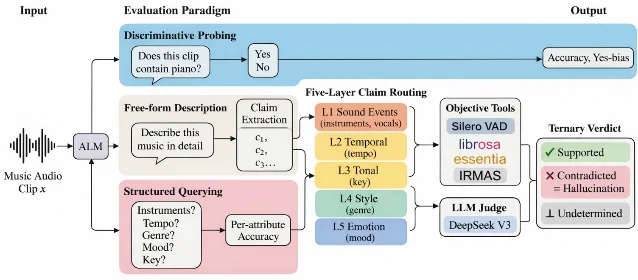
6. Music Hallucination in Audio-Language Models: A Hierarchical Formulation and Empirical Study(arXiv:2609.20195,邻近跟踪·语音翻译与语音语言模型)
- 研究问题:音频语言模型会对音乐给出输入里并不存在的自信描述;这类幻觉有没有层次结构,能不能按层诊断。
- 改动位置(维度):只改评测协议加两个免训练缓解探针,不动权重。
- 核心方法机制:把音乐幻觉分成五层——声音事件、时间属性、调性、风格、情绪;前两层与调性用客观工具验证,风格与情绪交给语言模型判官;判定用三值逻辑(支持、矛盾、证据不足),幻觉率只在可评估的主张上计算,并同时报出覆盖率;三种范式(判别式提问、自由生成、结构化提问)并行评估九个模型。
- 关键定量结果(含比较对象与口径):九个模型每模型约 6,500 道是非题。人声识别的幻觉率在 45.9% 到 61.3% 之间;调性层的结构化准确率从 0.0%(某模型)到 68.6%(另一个模型)。三个范式给出的模型排序并不一致:判别式与结构化两范式的排序相关 0.80(p=0.01),判别式与自由生成只有 0.17(p=0.67)。两个免训练缓解方法在探测式提问上能降低幻觉,但增益因模型而异,且大多不迁移到自由生成。
- 证据强弱与复现边界:9 个模型、3 种范式、10,000 次 bootstrap、固定门限与证据可靠性审计,协议骨架完整。边界:幻觉率是保守下界,必须与覆盖率同读;风格与情绪层依赖语言模型判官;缓解方法只在四个开源模型上测(商用接口不给 logits);没有多种子。公众号把这篇归到「语音翻译与语音语言模型」分区,而它的主分类是语音与音频,内容与语音翻译无关;公众号也没有列出原文的会议接收信息。
- 对目标研究线的连接点:邻近跟踪。连接点是评测设计:三值判定加覆盖率、多范式同时评估并报告范式间的排序一致性,这两条可以整体搬到任何音频生成或音频理解的主观评价上。
- 结论与阅读建议:建议扫读协议部分;它是音乐理解研究,不是语音生成结果,不要把它的结论写成 TTS 或播客质量。
- 入口:栏目正文 · arXiv
7. The Public Discourse Corpus (PDC): A Speaker-Attributed Dataset for Valence and Epistemic Modality with Target Speaker Participation(arXiv:2609.20232,邻近跟踪·评测、数据集与基准)
- 研究问题:公众人物访谈这种多说话人长音频,怎样保证留下的都是目标说话人,并把每句话的效价与认知情态标注出来。
- 改动位置(维度):只改数据与标注协议,不训练模型。
- 核心方法机制:提出目标说话人参与度的五类标注体系,只保留其中三类;切分采用音频优先管线——本地识别加说话人分离,按重叠最长的说话人给每个识别片段归属;效价与认知情态用零样本双维标注,并做跨提供方验证。
- 关键定量结果(含比较对象与口径):最终 998 段视频、100 位说话人、186,642 句、311 万词。目标说话人参与度五分类的标注者一致性 κ=0.616、二分 κ=0.690。音频优先管线相对纯文本法能检出多说话人(35 个文件里 24 个),本地管线与商用管线的词重叠 84.1%。跨提供方验证 1,863 条:效价精确率 75.9%(κ=0.63)、情态 72.5%(κ=0.53)。
- 证据强弱与复现边界:1,088 段候选里 91.7% 评为可用;切分管线用人工真值抽检过 60 条、话语级 91.7%。边界:本地管线的归属还没有人工验证;只发布文本不发布音视频;参与度分类里多嘉宾播客与访谈混在同一档。数据页与两个管线仓库公开可访问(Apache-2.0),但仓库说明里的计数与论文最终口径不一致。
- 对目标研究线的连接点:邻近跟踪。连接点在最前置的一段:多说话人长音频的切片、说话人归属与标注协议,正是节目级音频生产与评估要处理的第一步;它本身的研究对象是效价与认知情态,没有任何节目级指标。
- 结论与阅读建议:建议扫读管线与标注体系;引用语料规模时以论文口径为准。
- 入口:栏目正文 · arXiv
评测效度与测量方法
这一节六篇的共同问题是「这个数字到底在测什么」:梯度相似度测的是不是任务、评测的内部一致能不能当成有效、可复现与构念效度是不是一回事、对话评估能不能只看保真度、智能体的延迟瓶颈在哪一层、以及智能体提交变更时的一致性该怎么定义。
1. Form Over Content In Gradient-Based Data Attribution Methods(arXiv:2609.19589,直接命中·大语言模型与基础模型)
- 研究问题:被广泛用来挑选训练数据的梯度相似度,究竟在测任务语义,还是在测答案的表面格式。
- 改动位置(维度):只改测量设计。把任务与答案格式两个因素正交化——让两个数据集共享任务但不共享格式,或者共享格式但不共享任务。
- 核心方法机制:五个基准乘七种答案格式得到 35 个数据集,每个取 64 个样本,只取编码器主体的答案跨度梯度,投影到固定维度的素描空间,再算数据集间的平均余弦并做去衰减校正;另设零参照对与跨模型家族检查。
- 关键定量结果(含比较对象与口径):共享答案格式的不同基准之间去衰减余弦接近 0.4,而同一基准换一种格式类之后接近 0.0;零参照 280 对的均值 −0.001、标准差 0.008,因此 ±0.02 以内读作零。审查一个被广泛使用的梯度选择方法后发现,它为目标挑出的样本在目标自身的答案格式上过度富集,例如字母答案在某个基准上达到池内基础率的 3.7 倍。这个顺序从最早的预训练检查点一直保持到后训练,跨模型规模与家族都成立。
- 证据强弱与复现边界:35 个数据集乘 64 个样本乘 29 个检查点乘 4 个模型家族,还做了去衰减校正,设计干净。边界:没有独立复现;富集分析依赖该方法已发布的选择结果与一个规则分类器;只覆盖五个英文问答基准与七种格式。测量代码未发布。
- 对目标研究线的连接点:直接命中长程任务的训练与评估里的数据选择与评测效度。凡是拿梯度相似度解释「这条数据为什么有用」的地方,先按这篇把任务与格式分开测一次。
- 结论与阅读建议:建议精读,重点看正交渲染的设计与零参照的读法。
- 入口:栏目正文 · arXiv
2. What Do We Expect from LLMs? Mapping the Design of LLM Benchmarks(arXiv:2609.19182,直接命中·自然语言与多模态智能)
- 研究问题:基准设计这几年往哪里走,评测是不是越来越强调行动与交互;这些趋势有多稳。
- 改动位置(维度):只改测量。对大量基准论文编码七个设计字段,再做趋势归因与敏感性分析。
- 核心方法机制:三步管道:元数据分类路由、摘要筛选、全文编码七个字段,最后用分解方法做归因;对标签翻转做敏感性分析。
- 关键定量结果(含比较对象与口径):从 1,153,355 条元数据里纳入 14,767 篇。智能体与工具系统的份额从 2024 年的 9.0% 升到 2026 年的 28.3%;语言模型判分从 25.8% 升到 40.3%;交互式评测从 9.5% 升到 28.2%;生成式材料的份额从 2022 年的 15.6% 升到 2025 年的 52.5%。把 5% 的标签翻转后,前两条趋势仍为正(+19.29 与 +14.51 个百分点)。
- 证据强弱与复现边界:单作者、单模型编码、无独立复现;2026 年只覆盖到 8 月;属描述性统计而非因果。代码与数据公开可访问(代码 MIT、数据 CC BY 4.0),不需要接口密钥即可重算下游分析。
- 对目标研究线的连接点:直接命中长程任务的评估。趋势曲线本身可以用来判断一个评测方向是否已经拥挤,以及「判分即评测」的普及程度。
- 结论与阅读建议:建议扫读那三条曲线与敏感性表。
- 入口:栏目正文 · arXiv
3. Reproducibility is not construct validity: LLM measurement of institutionally situated communication(arXiv:2609.19866,直接命中·自然语言与多模态智能)
- 研究问题:用语言模型做标注,重复跑很多次结果都一样,是否就说明它测到了想测的东西。
- 改动位置(维度):只改测量。用四步效度诊断:构念对应、收敛与区分效度、系统性分组分歧、以及下游结论的稳健性。
- 核心方法机制:对同一批政策咨询文本做多次注释,先算内部一致性,再与同一批人的问卷答案做相关,接着按提交方分组检验系统分歧,最后用因果推断检验某个结论对注释质量的敏感性。
- 关键定量结果(含比较对象与口径):857 份提交、其中 348 份同时有文本与问卷。五次注释的内部一致性达到 0.994 到 0.996(组内相关系数),但与问卷的收敛效度很低:安全关切 r=0.029(p=0.59)、权利 r=0.176(p=0.001)、可解释性 r=0.097(p=0.072);一致性相关系数只有 0.013 到 0.080,测得的均值差对应约 ±4 点的区间。分组分歧上,商业协会平均偏移 +1.00([0.68, 1.33])、公共机构 −0.70([−1.32, −0.07]),组间检验 p=6.0e−7。
- 证据强弱与复现边界:四步诊断的框架可以搬到任何语言模型打分管线;但经验结论绑定单一政策域、单一咨询场景与单一模型,五次重复只测了运行稳定性,348/857 是自选择,六个分组里四个样本量不超过 26。数据与代码需要向作者申请,没有公开地址;同一页面的作者数与下载行标注也不一致。
- 对目标研究线的连接点:直接命中长程任务的评估。凡是拿语言模型给轨迹、给产物打分的团队,都可以用这四步先自查:稳定不等于有效。
- 结论与阅读建议:建议扫读四步诊断,不必引用那些相关系数。
- 入口:栏目正文 · arXiv
4. When AI Agents Commit: Cognitive Serializability Across Data, Evidence, Policy, and Authority(arXiv:2609.20261,直接命中·智能体、规划与决策)
- 研究问题:智能体基于数据库读取、检索到的证据、策略与授权边推理边提交变更,这些输入在推理过程中可能已经变了;事务隔离只保证提交的顺序,谁保证「这个变更在推理时依据的那些值没变」。
- 改动位置(维度):改执行与评测协议,并用一个原型做准入门。
- 核心方法机制:用带类型的依赖令牌把「内容完整」与「仍然适用」分开,用可信中介记录推理看到的值;提交走守卫优先协议,授权与收据都被绑定;同时给出一档较弱的准入:不主张把原始的随机推理过程串行化,只要求效果对当前的依赖向量与当前策略重新认证。
- 关键定量结果(含比较对象与口径):28 条受控历史上本方法没有一次非法提交;只用事务隔离的对照在 7 条核心语义历史里有 5 条没能阻止异常,并发扰动下的异常通过率 41.2%,另一档防护的失败率 18.5%;某条历史上陈旧写入通过率 48.3%、另一条 100%、还有一条 72.1%。吞吐上 32 线程峰值 1,842 事务/秒,比严格档低约 23%,对照的纯事务隔离峰值只有 1,120 并在 128 线程降到 310。提交成本 10,000 笔均值 3.22 毫秒(中位 2.85、p99 8.41),元数据约 192 MB,预写日志多 2.4%。在 20% 漂移下,较弱档能提交 92.8%,其中 63.8% 恢复出仍满足更新后策略的变更。
- 证据强弱与复现边界:四配置对照、1 到 128 线程、10,000 笔延迟微基准,工程细节完整。边界:单机单库原型,28 条历史由作者自设,推理延迟是采样值而非真实调用,形式结果依赖可信捕获完整等一串前提,也不缓解提示注入。没有公开入口;这一篇的版本实际提交于 7 月底,不是 9 月新帖。
- 对目标研究线的连接点:直接命中长程任务的评估与执行边界。把「内容完整」与「仍然适用」分开这一类区分,对任何长跑智能体写外部状态都是必要的检查项。
- 结论与阅读建议:建议扫读两张对照表;形式化部分按原型读,不要按普适定理读。
- 入口:栏目正文 · arXiv
5. Evaluating Communicative Success in Machine-Translated Conversation(arXiv:2609.19885,邻近跟踪·机器翻译与跨语言处理)
- 研究问题:口语对话里的机器翻译,用句级保真度指标评不够;沟通有没有成功该怎么量。
- 改动位置(维度):只改评测协议:三层清单加判分器加交互协议。
- 核心方法机制:从字幕语料构造有向场景,用语言模型生成语义、语用、文化社会三层检查清单;再搭用户、口译、判官三个角色,单轮与多轮都跑,并用对抗扰动与人工标注做校准。
- 关键定量结果(含比较对象与口径):5,624 个有向场景、12 个翻译方向、10 个系统:全部设置的得分都按语义、语用、文化社会依次下降。多轮汇总上语言模型配置 92% 到 94%,传统翻译系统 45% 到 47%;相对单轮,某配置 +16.1 个百分点、另一配置 +15.6,而传统系统 −4.5。最能说明问题的是分离:在指标最高四分位里,仍有 10.3% 到 12.2% 的对话清单分不超过 0.6。提示消融显示,加上场景上下文、结构化指令与文化语境能把成功分从 36.4% 提到 51.3%。
- 证据强弱与复现边界:三层清单加对抗扰动加人工校准是可迁移的评测设计。边界:人工校准是最大限制,与人的一致性只给出下界;清单生成器与主判分器同源;机器翻译与语言模型在上下文获取上并不对等;域是字幕。原文声明会发布场景与脚本,但没有给出任何地址。
- 对目标研究线的连接点:邻近跟踪。连接点是评测框架:把「内容对不对」与「沟通成不成功」分成三层,可以搬到播客或对话类音频的节目级评估设计上,但这一篇的证据来自字幕文本,不是音频。
- 结论与阅读建议:按连接点取用清单设计;不要引用具体百分比作为音频结论。
- 入口:栏目正文 · arXiv
6. Not All AI Agents Are Equal: Characterizing Resource and Performance Dynamics(arXiv:2609.19947,邻近跟踪·智能体、规划与决策)
- 研究问题:智能体的延迟与资源瓶颈在不同任务上落在哪一层;为什么加核或换更快的模型不一定更快。
- 改动位置(维度):只改运行时测量与资源编排。用记录-回放消除模型输出的非确定性,再单独测本地资源。
- 核心方法机制:对七类任务做三维测量——任务画像、并发请求、敏感度分析;然后提出两项编排优化:按处理器占用决定是否接纳某个工具,以及按任务类型分配处理器核心。
- 关键定量结果(含比较对象与口径):延迟分解:检索问答里本地检索占 62%,网络检索里 49% 在网络接口、10.5% 在本地摘要,编码任务里本地 shell 平均占 39%。处理器占用:检索问答平均 86%、网络检索 14%、编码 22%,请求之间的标准差后者更大(1.57 核对 0.19 核)。并发从每秒 0.5 个请求升到 6 个时,检索问答延迟涨 13.1 倍,而编码任务只涨 1.5 倍。在六核总预算下,优化使总平均延迟降 32%、检索问答降 5.4 倍,但同一配置下某个编码基准的延迟反而升 28%。
- 证据强弱与复现边界:单机单环境,模型延迟用回放值而非真实调用,内存峰值不能外推,优化只在两种总预算与一个请求率下测过。没有种子与重复,没有独立复现,也没有公开入口。公众号把这条写成了「延迟提升 5.4 倍」,而原文说的是延迟下降到原来的约五分之一,并略去了同一配置下编码任务延迟上升 28% 这一条。
- 对目标研究线的连接点:邻近跟踪。连接点在成本口径:长程智能体的成本报告里,延迟与资源的瓶颈会随任务换层,这一类分解可以搬来做预算归因。
- 结论与阅读建议:按连接点取用延迟分解方法;引用数字时注意方向与那个反例。
- 入口:栏目正文 · arXiv
缺口与核验说明
播客生成与节目级评估。 本期做了三层核实:① 按公众号的条目列表把该批次当日发布的全部条目逐条枚举(12:10:29 那一批共 8 条:人工智能、自然语言处理、语音与音频、计算机视觉、机器学习、机器人、统计学七个栏目加一篇单篇论文导读),没有任何一条以播客或节目级音频为对象;② 逐条清点语音与音频栏目 7 篇的五个分区,其中「语音合成与声音生成」分区只有一篇,是本文提到的多维韵律评判,它评的是韵律与偏好,不是节目整体;③ 对三个允许栏目的全文做中英关键词扫描(播客、节目、双人对话、多说话人、长音频、全双工、电台、有声书、podcast、episode、two-speaker、multi-speaker、long-form audio 等),直接命中为零,「全双工」只出现在语音与音频栏的两篇接口层工作里。也就是说,「自动做出一期完整节目」与「评估一期节目的整体质量」这两件事,本期没有任何论文以它们为研究对象,这是来源侧选题口径造成的结构性缺口。
可迁移的是接口层三件:多说话人长音频的切片与说话人归属协议(PDC 的目标说话人参与度分类加音频优先管线)、全双工语音前端的工具委派与低延迟回吐、以及「何时该出声」的配对评测协议。三件都停在素材与接口层:节目级的选题、脚本、成片与整体质量评估不在它们的范围,引用时不要把接口层的成绩写成节目级结论。
TTS 生成与评估。 本期出现 2 篇直接命中,是本频道在这一栏少见的收获:一篇是多维韵律评判(评估与奖励侧,不是生成模型,向量奖励回灌生成模型后训练被原文列为未来工作),一篇是字素到音素的文本前端(位于文本规整下游、声学与波形生成上游,本身不产生音频)。生成侧的波形合成与声码器,本期为 0 直接命中。
入口实测:声明与实际对不上的地方。 以下状态由本期逐条实测。有内容且与论文相符的:AgentPProf 的代码入口(含剖析扩展)、Chronicle 的仓库与事故夹具、SkillAA 的仓库(含配置与测试目录,但只有一份许可证说明文件)、SoL-Pi 的仓库与项目页、RetireOPD 的两阶段脚本仓库、技能条件教师那篇的代码与数据集、技能迁移那篇的技能库(可通过数据集页下载)、梯度归因那篇引用的官方仓库、基准设计映射那篇的代码与数据、公共话语语料的数据页与两个管线仓库、检查点交接那篇所固定的两组第三方检查点。声明了发布物但没有给出地址的:评测安全协议那篇(匿名地址可打开,是一份说明文件加校验脚本)、自我研究系统那篇(项目页有 87 篇预览与审计表,无代码入口)、前馈检索框架那篇(项目页无可下载入口)、长程人机协作基准那篇(项目页的代码与数据按钮没有下载目标)、全双工何时出声那篇(仓库已建但当前没有任何文件)。其余各篇(长程架构、驾驭层价值、驾驭层设计实证、判官蒸馏、字素到音素、自蒸馏对照、裁判熵复现、记忆系统、世界模型发现、递归深度、行程修订、多智能体协作、自主研究、认知可串行化、构念效度、口译交际成功、智能体资源动态、音乐幻觉、说话人标注语料等)在全文里都能核对到自己的实验与数字,但公开入手处只有其中一部分。
本期没有收录的 122 篇。 三个栏目 168 篇里,未进入本期的部分主要分布在知识表示与符号推理、多智能体博弈的应用场景、机器学习与表示学习、跨语言与低资源方法、信息抽取与领域问答、以及大量与四条目标线没有可迁移接口的应用类工作。逐条清点后按同一价值门槛排除,理由只有一个:它们回答的问题不在本频道盯的四条线上,与论文本身的好坏无关。
References
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.