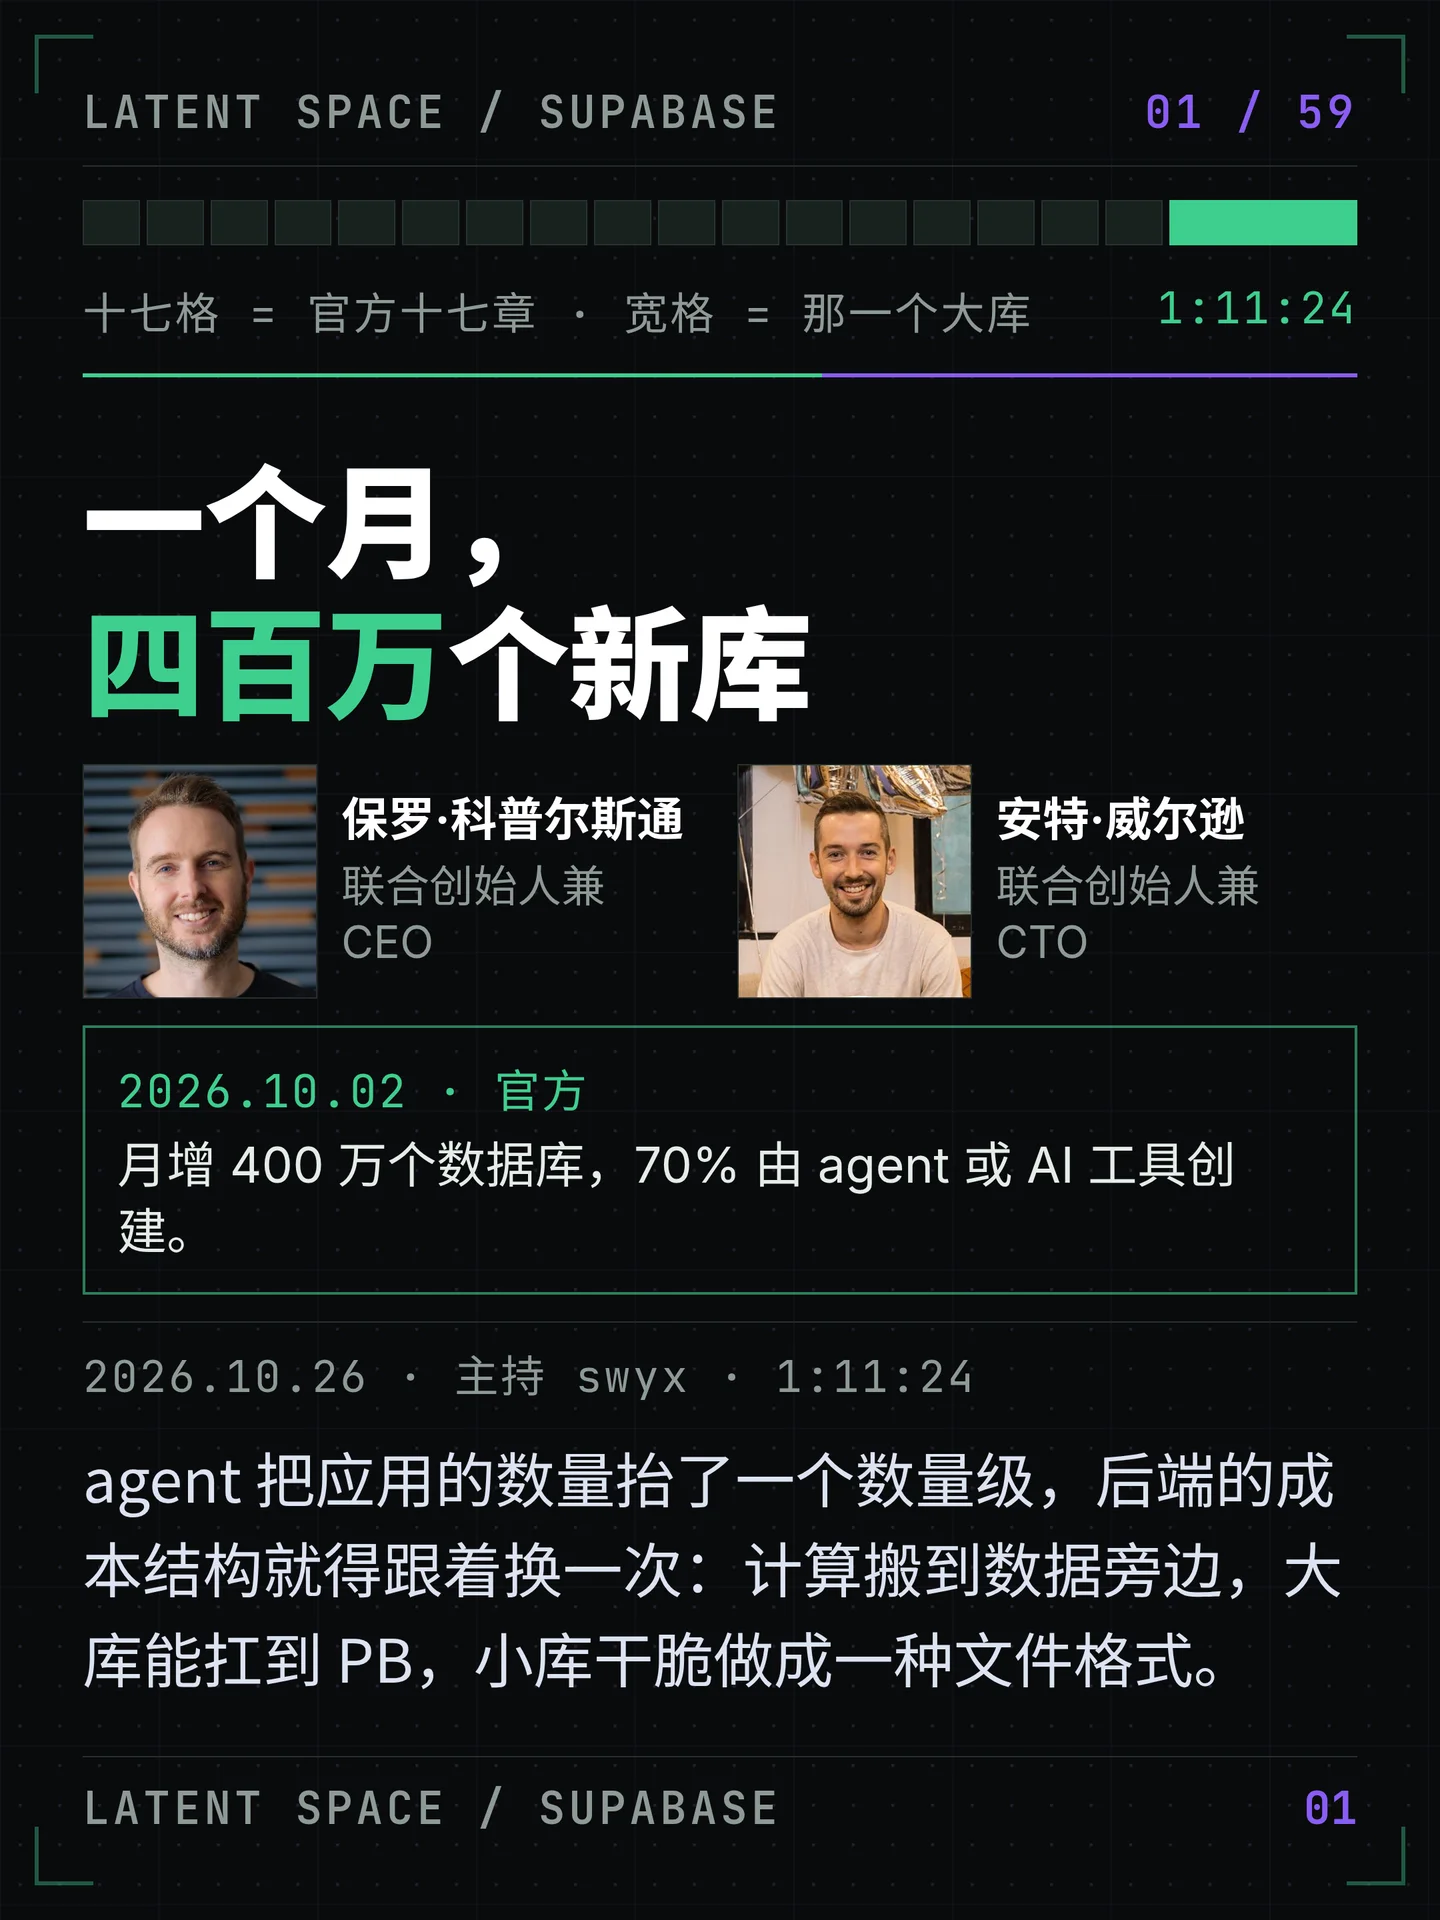

agent 一个月造出四百万个库。那其中一个长到 PB 的时候怎么办?问保罗和安特,他们说这就是重写存储引擎的理由。其实是同一件事。
这一期讲了什么
Supabase 的两位联合创始人在客户大会 Select 之前坐下来,把自己一年里最重要的四件事讲了一遍:Compute(把计算搬到数据旁边)、OrioleDB(换掉 Postgres 的存储引擎)、Multigres(重写跑集群的那层 operator)、Turso(把数据库做成一种文件格式,好让 agent 想开就开)。
四件事指向同一个判断:agent 正在把「应用」的数量抬一个数量级,所以后端要同时解决两个方向——向下缩,让每个原型都有一个自己的库;向上扩,让其中一个能扛到 PB。中间夹着的才是生意:谁更粘、钱怎么算、迁移到底会不会发生。
逐段要点
01 · 六年一遇(0:00)
这一期是录在 Supabase Select 之前的,发布在大会之后,所以两位创始人聊的是「刚刚宣布完」的那批东西。主持人 swyx 把这次见面说成「准备了六年」:他从两人在 YC S20 毕业、在新加坡庆祝那阵子就认识他们,第一次听说这家公司是因为一个陌生用户在 Hacker News 上帮他们做了软发布——他们自己还没准备好被发出去。
这一段也是全期的目录:Compute、OrioleDB、Multigres、Turso,四件事分别对应「把计算搬到数据旁边」「让单个库更快」「让单个库别丢数据、别停机」「让库的数量涨两个数量级」。这一期的官方章节一共十七段,从 0:00 到 1:09:451。
02 · Supabase Compute:两秒的墙(0:51)
过去 Supabase 只有一种跑代码的方式:Edge Functions,跑在 Deno 上,硬上限两秒。安特的说法很直接——社区要的是分块、嵌入、跑 agent,这些活都是几分钟起步的,两秒做不了。
Compute 换了一个原语:它跑在和你数据库同一个私有网络里,同址部署,所以延迟是单数字毫秒,可以直接从 Compute 里开 Postgres 连接。语言不限,Rust、Python 都行,可以在里面跑 agent,本质上是「一整台完整的计算实例」。
被问到拿什么类比时,安特的答案是容器型的 Lambda——你可以跑一个完整容器。同一个原语既能做常驻服务,也能做 agent 的短命沙箱:跑完挂起,状态保留,下次接着来。这是 Edge Functions 根本做不到的动作。
03 · OrioleDB:换掉存储引擎(2:01)
安特把三项数据库侧的创新对齐到三个方向:性能、向上扩、向外扩。第一项是性能,就是 OrioleDB。
它是当前 Postgres 存储引擎 heap 的直替换:快 1.5 到 2 倍,其他什么都不用改,完全兼容;还把 vacuum 这类后台任务的需要整个去掉了。这一年的全部工作是在证明它不丢数据——跑通 PG Regress、和 Postgres 完全兼容、跑 Antithesis、用 TPC-C 做每夜基准、再过 Jepsen。产物是「完整 beta」的发布。
授权一次改到位:Apache 2.0,而且这项技术的专利也被 Apache 2.0 覆盖。原话是「我们把这项技术收购下来、继续开发、为专利付钱,现在免费送出去」。理由也很工程:存储引擎是所有应用的瓶颈,不该被一家攥着。
04 · Multigres:每一种 operator 都会丢数据(3:27)
第二项是向上扩。团队先做了一件很笨的事:把 Postgres 生态里的 operator 全测了一遍。结论不是「有更好的」,而是「在某些条件下,每一个都会丢数据」。所以他们不从任何一个实现上改,直接把 operator 的整个结构从底层重写。
新东西叫 Multigres。最初的目标只是给 Postgres 补上分片,最后长出来的是一整套操作系统:故障切换、备份、扩缩容都在它手里。测试强度是 1,000 次连续故障切换零丢失。发布方式是明天完全开源,平台上先做邀请制。
关于进度有两个容易被说错的点。第一,这一年不是两年;分片本身还没发布,部分设计大概明年年初落地。第二,苏古(Vitess 的作者)这次的第一目标不是分片,是兼容:Vitess 当年你一分片就得改查询,他这次从底层重写就是为了发布分片时用户代码零改动,同样的查询继续跑。
设计伙伴已经有一批:博思艾伦、Postman、Perplexity。共同点是都在规模上跑 Postgres,都在等一个向上扩的办法。保罗补了一句边界——Multigres 不该只服务 Supabase 的客户,它完全开源,任何在规模上跑 Postgres 的人都该能用。
05 · 向外扩:把数据库做成一种文件格式(7:06)
第三项是向外扩,也是这期的重心。现状是平台上每个月上线约五百万个数据库;他们要去的未来是一个月几十亿个。「多人用」和「多量级」是两回事,所以必须换架构。
Turso 的方案可以一句话说完:给 SQLite 做 MVCC。SQLite 本身只能单写入(它就是一个文件格式),Turso 从 libSQL 起家 fork,补上并发写;底座是 diskless、WAL 直接写在 S3 上,所以库可以随用随开,成本按单个库算。安特对对象存储的评价很有意思:11 个 9 是持久性,不是可靠性,但作为集群底下那一层够用——「数据库领域的一部分创新,其实发生在对象存储这一侧」。
真正的约束在这句话里:几十亿个库不可能是几十亿台机器,「我们需要它们是一种文件格式」。这就是他们看上 SQLite 的原因,也是这次收购的全部理由。
落地成一个新产品:Supabase Spark,一个更小的实例类型,和现有所有库兼容。原型阶段就给它一个库,起飞了一路升级到完整 Postgres,再到 Multigres。安特说,向上扩和向下缩一直是他们想解决的两件事,是等这些技术出现之后才敢说能做了。
保罗补了另一半:库小不要紧,要紧的是零停机迁移——「这是必须有的」。因为客户会长大,长大那一刻决定他走不走。他举的例子是 Magic School:创始人原来是个老师,看到教学里的低效就自己动手;这类公司开局没有技术联合创始人、没有 CTO,而这不是个别现象。
安特的算术更狠:真按「一人一个 Postgres 集群」给,物理计算机很快就会用完;这一年他们的增长,一半是在处理算力容量。
06 · 从原型到 PB(23:10)
标语从「一个周末做出来,扩展到几百万用户」换成了「从原型到 PB」。保罗说最真实的变化是变现速度:过去是先选数据库、做产品、到了某个点再加计费;现在可以直接在 agent 那一层接 Stripe,有人开个项目、当周就真的赚钱,而那个东西是几天 vibe coding 出来的。
看到有人头几天赚到一万美元,他们判断这不是一阵风。对照是 NFT 那一波:加个「用以太坊登录」「用 Solana 登录」,但没投多少开发时间,因为大家都知道会过去。vibe coding 这次,团队争论了很久「要押多深」。
最后的结论是两头都要做:最大的客户一直在把他们当时的能力拉到极限,而新的用户正在底部涌进来。
07 · AI 与增长:三波(25:10)
安特把 Supabase 吃到的东西拆成三波。第一波是嵌入:其他人在做专门的向量数据库,他们的主张是「Postgres 就能当向量数据库用」,靠 pgvector 这一类扩展把「你不用再买一个库」讲清楚。第二波是 vibe coding:2024 年底 Lovable、Bolt 起来,内部争论很久——要不要服务这批人,甚至要不要自己在 Supabase 上做一个 vibe coding 平台;最后回到使命:你起步的时候我在,确保你永远不想走。第三波是今年,模型变强,漏斗顶部直接变陡。
最意外的一条:市场几乎没花钱,涨的主要是梗。swyx 插了一句所有人都在想的话——你们的图全都长得一样,只是每次换个 Y 轴。
更反常识的是转化。通常漏斗顶部涌进更多偏消费者式的流量,激活率和付费转化会掉;这次两件事同时涨,而且涨得不慢。
08 · agent 驱动的激活(27:40)
原因被保罗压成一句:从注册到激活中间那几步,agent 一步就做完了,摩擦消失,所以激活接近 100%;而这批人的付费转化率,比传统开发者用户还高。
swyx 拿出自己的 AEO 追踪:在几个品类里搜 Supabase 都排第一,结果就是每一个前沿模型都把它推荐成集成后端的首选。安特的解释是时机而不是技巧——在市场里熬了三四年,正好卡在大模型起来之前:「我们时机上非常幸运,纯属意外。」
保罗补了另一半机制:早期增长靠花大量时间在社区里,结果社区在写博客、做 YouTube、做播客,全是「怎么用 Supabase、我怎么把这个东西做出来」;这些东西后来被模型整批吞下去了。
09 · 社区、众筹与那个答了两万个问题的人(30:00)
去年他们宣布要做众筹,然后和律师打了一年:以他们想参与的人数,不让人成为合格投资者,就没有机制。转折是一句反问——如果直接送股票呢?律师查完说可以。于是一百万美元的 Supabase 股票,送给一批社区成员。
第一个被请上台的是 Discord 里的加里·奥斯汀(真名加里·阿博特)。数据是查过的:六年里在两万个问题下回答过,其中一万三千个是在问题提出后第一个小时内答的,而且不是机器人。他退休了,自己做了个侍酒师应用,爱红酒,家里的圣诞树上挂着 Supabase 的 logo。
渠道的结论很朴素:Discord 用户会用 Discord,Reddit 用户会用 Reddit,所以全都得做——代价是工作量巨大。他们自己唯一做的一件事是把好问题和答案抓下来,放进 GitHub Discussions 再镜像到官网;安特的评价是「这策略很好,因为所有人都在反复问同样的问题」。
企业侧在这里第一次出现:Control Tower,给企业一个「一批数据库」的集群视图,明天上线,官网找不到。它的来路很实在——有家大型制药公司跑了一百个实例之后自己找上门;而底子是 Supabase for Platforms(2025 年 12 月上线),AI 公司拿它在上面给终端用户开几百万个库。
10 · 开源、销售与绿地(36:00)
Supabase 是典型的 PLG 公司,指标是「每一届 YC 里 60% 的公司在用」,榜样是 Stripe——十多年过去,市场变了,对开发者的好感还在。
销售被他们做成了「产品驱动销售」:每周大约一千个产品信号(撞限额、报错、付费额跳档、某个重要 logo),发一千封邮件,其中五百个回复;没回复的当对照组,月增 25%;回复并聊过的那批涨到 125%。那 100% 的增量才是给销售发奖金的依据——因为平台本身就在长 25%,你不能为自然增长付佣金。
企业侧最重要的一句判断:迁移生产数据库几乎从来不发生。他们看过每一家靠迁移做起来的数据库公司,都随时间失败了——哪怕你造出一个更大、更好、更能扩的 Postgres。所以全部注意力放在第一天就落进去的绿地(greenfield),然后确保客户留到第一百天、第一万天。
被追问「拆掉 Oracle」这条白鲸时,安特给了两个数字和一个机制:一年前有人说按收入算只有 5% 的 Oracle 负载跑在云上;而让 Oracle 粘住的,是那几百万行存储过程——编码 agent 让重写这部分容易多了。真正的障碍不在重写,在 OLTP:它撑着最赚钱的应用,一分钟停机就是钱,两套并行就出脑裂,而脑裂对账几乎没人做成过。
还有一个变化:过去是卖给开发者、让开发者内部卖;现在直接遇到会说「我十年没写过代码,但我在公司内部把各种东西造出来了」的 CPO——C 层拥护者自己出现了。
11 · 谁更粘:数据库还是构建器(40:50)
安特的答案只有一句:跑数据库非常难。保罗补的是比较级:迁移数据库比迁移前端工具难得多,所以 CPO 会换掉构建器,不会换掉那张表。
他也给了对手应有的评价:Lovable 是第一批把「别让 agent 对数据库干蠢事」做好的。早期 agent 会试图把图片塞进 Postgres,为了跑通就把 RLS 关掉;Lovable 写了一整套 skills 把这类动作拦住——那不是模型变强,是护栏写得好。
关于 HTAP,supabase 不打算屠龙。安特的路线上限很明确:到 PB 级只能分片,因为能挂的 NVMe 是有限的,把事务拆到两台服务器上就要从对象存储取,最终会拖慢数据库;分析另作一回事,不必硬塞进一个库。他顺带夸了 DuckDB 和 Duck Lake——「分析生态里的 Postgres」,还提到 DuckDB Labs 被 AWS 收购。
12 · 持久化工作流缺的那块(48:10)
Temporal 那条线他们一直在敲鼓,但真正卡住的不是意愿,是原语:社区早就在 Supabase 的函数上试过做工作流引擎,全部死在两秒超时上。Compute 一到位,长时运行的持久化工作流才谈得上。
这一段最值钱的是一个数量级:ChatGPT 十二亿月活,如果每个用户每月开一个库,那就是十二亿台 Postgres 服务器。所以「一个月几十亿个数据库」不是口号,是成为模型默认后端的准入条件——安特说,直到今天收购了一家能带来这项技术的公司,他们才做得到。
P1 也顺势讲清楚:尽可能和前沿实验室、和模型做伙伴;美国的实验室带来最多流量,其他地区「可能会做」,但现在不多。
13 · 公司优先级:P4 才是企业(50:52)
安特把优先级排得很直白:P0 是赢下战略实验室、赢下模型;P1 继续推 PLG;P4 才是企业——「我喜欢 P4 是企业这件事,1、2、3、4,这就是排名」。
被问到 PLG 的天花板,保罗给了一段罕见的自述:公司刚开始时他们估算 PLG 能做到一亿、大概两亿美元,之后就得换一种推进方式;AI 来了之后这个天花板被抬走,而且不知道抬到了哪——「是十亿?是二十亿?」。年初在 offsite 上抛出一个「疯」数字,还有人劝他别定,结果四个月就打到了。
所以结论不是二选一,是两边都得做:小的和大的。「可能我们是有点贪。」
14 · code-first 与声明式 schema(53:24)
安特说今年最大的重心是从「看板公司」转向 code-first。这个转折值得说清楚:看板曾是最好的开发者体验,headless 他们也一直有;但 agent 工作的地方是文件系统。
具体形态是:在本地起一个 Supabase 实例,你得到一个 Supabase 文件夹,它就是你的数据库——函数、策略、注释,全在里面,基础设施即代码,agent 不用连任何东西。同时宣布的是对声明式 schema 的最后一轮改动:把 schemas 文件夹变成数据库的完整声明式状态,覆盖 Postgres 的全部。
为什么非做不可:行业标准做法是迁移文件,每次改动往里加一个文件,像一份历史日志。这很好,但你把 agent 丢到一千个文件面前问「这张表长什么样」,它只能猜,或者起库跑一遍再 introspect,太慢。新库叫 pg_delta(节目里念作「pgDulta」),可以用在任何 Postgres 上。
他对终局的描述是:你不需要是工程师,你有个想法,对手机说一句,一秒钟之后应用就上线了,你自己就能迭代。
15 · AI 造的软件会收敛吗(56:30)
保罗的担心是模式坍缩:所有人被模型带着走向同一种建法,代价是没人再看细节,最后停在一个局部最优上。「软件行业最好的地方就是这些著名的口水战——什么才是正确的做法。我们会不会把这些丢掉?」
swyx 的反驳是分层:普通建造者会收敛到模型的平均值,但真正在意细节的高手会一直在,而且品味会往下渗透。保罗的反问更狠:那些高手还会继续被培养出来吗?
这一章还收了两个人的来路。他们从新加坡的 Entrepreneur First 认识,之后住进一个七个人的合租房,每个人各做各的创业公司;结论是技术人配技术人比「技术配领域专家」高效得多,因为做开发者工具时你自己就是领域专家。后来大部分人被招了进来。
招人有个反例很值得记:YC 的建议是「给你钱,别招人」,但他们去找合伙人说,我们有一个史蒂夫·查韦斯,PostgREST 的维护者。合伙人说,别管那条建议,立刻招。招进来之后只让他继续做 Postgres,不做别的。
关于 Rust 重写,安特的判断是分层的:重写要重写到某个层级就停,别把创新 token 花在重写一切上;如果真发生,Postgres 的 Rust fork 也只会有一个赢家。Elixir/BEAM 那一段,他说没认真想过要换。
内部 AI 政策则是下放的:Supabase 像几家创业公司粘在一起,auth 团队自己决定用什么工具、怎么运作,AI 也一样;现在只在成本这一块开始收拢一些。
16 · 团队怎么用 AI(1:06:01)
一个可以带走的数字:安特直接问自家的 AI,Supabase 现在每月大约花三十万美元,四百五十人。swyx 给的经验值是 token 支出对人力支出的比例——0.1 起步,1 还算安全,超过 1.5 大概就有麻烦。
安特补了一个观察:他们有个排行榜,把榜单挂出来,人们通常会有点不好意思。保罗的纠正更关键:关注点不该是账单,而是「你到底解决了多少个端到端的流程,做到里面不再需要人」,或者把原本要跑很久的人力问题压成很短的问题。
做法上有一点很妙:因为公司完全远程、一切都有文档,他们给公司建了一个 harness——把 AI 指过去问「我们的原则是什么」,它会把 Supabase 全部历史上做决策的原则写下来。
17 · 远程优先的招聘(1:09:45)
现在有五十个岗位在招,全球远程、不按城市调薪,最缺的是 SRE。筛的其实不是技术,是「你是不是真的想远程工作」——完全异步的环境不是适合所有人的,有人进来会说「我需要看到人」。
结尾两个人一起把话收在同一点上:swyx 说他一直公开讲,AI SRE 是 agent 创业公司里最难的品类之一;安特接过来说,「到目前为止它是对的,AI 还没有攻下 SRE」——写软件是解决问题,维护是让东西一直跑着,那是完全另一头野兽。
口径与核对
官方可查:2026 年 10 月 2 日,Supabase 宣布 1.5 亿美元新融资,GIC 领投,CapitalG、IronArc、SquarePeg 参投,距 6 月的 5 亿美元 F 轮只有四个月;同期口径是月增 100 万用户、400 万个数据库,其中 70% 的新库由 agent 或 AI 工具创建,全站开发者超过 1300 万2。
F 轮本身是 5 亿美元、投前 100 亿美元估值,由 GIC 领投,同一天发布了 Multigres v0.1 alpha(开源、可自托管);当时的数字是数据库上线量一年增长 600%、超过 60% 的新库由 AI 工具发起3。
收购 Turso 这件事有两侧官方文本:Supabase 侧说的是「每周上线超过一百万个数据库」、Turso 用 Rust 重写了 SQLite、一台服务器可以管几百万个库、客户包括 Superhuman、Sauna.ai、CTO.new、Mastra,格劳伯·科斯塔与佩卡·恩伯格带团队加入,格劳伯负责 agentic services4;Turso 侧的说法是「每 agent 一个库」的 many database 架构、diskless WAL-on-S3、以及 SQLite 单写入这个必须被解掉的限制5。
Compute 的形态有官方产品页:沙箱与常驻服务共用一个原语,和 Postgres 同网络(单数字毫秒),空闲缩到零、恢复亚秒级,每个 workload 一个独立 microVM,还是私有 alpha、只开放 us-west-2 的项目6。
只有节目里说过、没有公开材料可核的:Supabase Spark 这个更小实例类型、Control Tower 的次日上线、声明式 schema 的新库(节目里念作「pgDulta」,官方拼写未能确认)、每周约一千个产品信号与 25%/125% 那组对照、每月 30 万美元的 AI 支出、五十个在招岗位。
两处口径不一致,按更保守的写:数据库月增量,官方新闻稿是 400 万个、官方博客是每周 100 万+,节目里说「大约五百万个」——正文按官方口径;Turso 收购金额、Control Tower 的价格,两边都没公开。
逐句全文翻译
按官方十七段章节顺序,只保留中文译文,保留说话人标签。
01 · 六年一遇(0:00)
swyx:好,这一期准备了六年。
swyx:很高兴把科普尔斯通和安特请进演播室。欢迎两位。谢谢,谢谢你们接待。我们是在 Supabase Select 之前录的,那是你们面向客户的大会,节目会在大会之后发布。但我还是想先庆祝一下你们走的这段路:我从你们 YC 毕业那会儿就看着你们,在 新加坡那个地方,你们在庆祝什么;第一次见你们的时候我还想,这家挺火的数据库公司是怎么冒出来的——好像是一个陌生用户在 Hacker News 上帮你们做了个软发布。总之,恭喜你们取得的这一切。在 Select 上,你们要宣布的头条是什么?咱们直接进去。
02 · Supabase Compute(0:51)
安特:好。头条有好几个,要讲的东西不少。最主要的一个从计算开始。我们有个产品叫 Edge Functions,跑在 Deno 上,基本有两秒的上限。我们发现、也是从社区听了很久的反馈:大家想跑长得多的工作负载,想做分块、做嵌入这类事。所以明天我们要宣布——等这期播出去的时候已经宣布了——Supabase Compute。它什么都能跑:长时运行、serverless,而且跑在和你数据库同一个私有网络里,也就是同址部署,延迟很好,你可以直接从 Compute 开 Postgres 连接。里面什么都能跑,不再被限制在 Deno 上,你可以用 Rust 或 Python,可以在里面跑 agent。它基本上就是一整台完整的计算实例。
swyx:如果拿其他云上大家更熟的产品来类比,这个相当于什么?
安特:类似 Lambda 函数,但是容器型的那种 Lambda。也就是说你基本上可以跑一个完整容器。
03 · OrioleDB 与存储引擎(2:01)
swyx:然后还有别的东西。
安特:对,然后我们在数据库这一侧有三项创新。第一项是去年讲过的 OrioleDB。过去一年我们基本上把它反复捶了一遍,确认它足够可靠、可以为 Postgres 生态所用。这三项创新分别对 性能、向上扩、向外扩。Postgres 涉及——抱歉,OrioleDB 对应的是性能。它是当前 Postgres 存储引擎 heap 的直替换,运行速度快大约 1.5 到 2 倍,其他什么都不用改,完全兼容。它还彻底去掉了 vacuum 这类后台任务的需要,所以对你数据库本身也很高效。这一年我们要做的全部工作,就是让它跑通 PG Regress、和 Postgres 完全兼容,跑 Antithesis,用 TPC-C 做每夜基准,再 过 Jepsen,确保它基本上不可能丢数据。所以明天我们发完整 beta。同时我们把授权改成 Apache 2.0:它带着一项专利,Apache 2.0 授权覆盖了这项专利。我们当初把这项技术收购下来、继续开发,然后为这项专利付费,现在免费送出去。
swyx:你刚才顺口提到一件事,我一直没缓过来:你们把每一种 operator 都测了,然后你说,每一种 operator 在某些情况下都会丢数据。
04 · Multigres 与可靠性(3:27)
安特:对,那是第二项。
swyx:向上扩。所以那就是 Multigres?
安特:对。Multigres 是第二个大宣布。我们看了整个 Postgres 生态,看了所有的 operator。不太熟的人可以这样理解:跑 Postgres,你从一个单节点开始,但……几乎所有数据库你都要跑多节点,你要故障切换,你要它管备份。通常你需要一个叫 operator 的东西,帮你把整个集群跑起来。Postgres 生态里有不少 operator,而我们发现,在某些条件下,它们每一个都会丢数据。所以用 Multigres,我们决定把 operator 的整个结构从底层重写。Multigres 本质上——虽然我们最初的目标是给 Postgres 社区补上分片——最后长出来的是一整套操作系统。我们又对它做了非常严格的测试:做了 1,000 次连续故障切换,没有丢任何数据;基本上能做的测试都做了,各种往死里砸,看它会不会丢数据。所以现在我们对它的稳定性很有信心,这个也一起发。明天它完全开源;在我们的平台上会是邀请制,跑重负载的人可以来找我们,我们开始帮他们向上扩。
swyx:这是 Multigres 已经和 Vitess 完全对齐了,还是说还有一段路?
安特:其实挺有意思。Vitess 最初是 Sugu 为 MySQL 生态做的,但专门是为分片做的。他这次来的时候说,这一轮的第一目标不一样:因为我们用 Vitess 时一直在补兼容性,你一分片就得改东西、得改一些查询。所以他说,我要先把兼容性做好。我们的设计方式就是为了这一点——这次从底层重写,是为了让我们发布分片的时候,你实际上不需要为你的数据库改任何东西:同样的查询继续跑,Multigres 自己接住。你的代码零改动。
swyx:这个愿景很了不起。而且你们两年就做到了——
安特:一年。一年。分片还没发。早期原型和具体做法的设计我看过,其中一部分大概明年年初会落地,取决于平台上其他事情的进度。我们手上事情很多,但对进度很满意,做得挺不错。
swyx:我感觉这是 Postgres 通吃的最后一块拼图。对吧?就是这样。而且不熟的人可能不知道,Vitess 支撑着 YouTube、GitHub,还有别的。如果负载有一天要从 MySQL 挪走,你就需要这个到 Postgres——
保罗:然后逼着 Supabase 赢。也希望不只是给 Supabase 的客户,对吧?它完全开源,是社区的东西。任何在规模上跑 Postgres 的人都该能用 Multigres。
swyx:我相信每一个联盟、每一家和 Postgres 有关的公司,都在以某种方式给这件事贡献,对吧?因为我们都想要它。
安特:对,我们有一整套设计伙伴计划。我们在和博思艾伦(Booz Allen)这样的公司合作,在和 Postman 合作,在和 Perplexity 合作。所以有很多客户在进来。很多人需要它——他们在规模上跑 Postgres,需要一个东西帮他们向上扩。第三项,这一项很大:向外扩。目前我们平台上每个月大约上线五百万个数据库。而在我们要去的那个未来里,我们认为一个月要上线几十亿个。向外扩完全是另一头野兽。所以我们决定必须去看新的架构,去看这个领域里的人——agent 数据库这个领域。而在 agent 这件事上做得好的数据库厂商,没有别人,就是 Turso。所以明天、等这件事宣布的时候,就是我们已经宣布收购 Turso,让它来帮我们撑起 agent 数据库。
05 · 向外扩与 Turso(7:06)
swyx:这很了不起。而且它主要是基于 SQLite 的,但这一点其实不重要,对吧?更重要的是它的架构——那种,我找不到词,就是某种广播式的做法?用来向外扩。他们的思路是:把 SQLite 扩起来,要有一个单写入、多读取。
安特:对。SQLite 本身只能单写入,它是一个文件格式,所以一般不是——像是给 SQLite 做一个 MVCC。
swyx:对,就是 MVCC for SQLite。
安特:正是。所以他们搭了 Turso 这套架构:本质上就是给 SQLite 做 MVCC,让你可以有多个写入者。而因为 SQLite 的授权有点奇怪,他们不得不 fork 它。
swyx:他们得 fork。
安特:得 fork。他们最早是从 libSQL 起步,然后走过来,又做了另一个很酷的架构。而且现在这套架构,几周前在 S3 上被讨论得很多。数据库领域的一部分创新,其实来自对象存储正在发生的事。对象存储加了一批新能力,它们基本上意味着你可以开始把它当数据库用一点了。而对象存储本身是 11 个 9 的数据持久性——对,这不是可靠性,但……
swyx:不是可靠性,管它呢。
安特:对,不是可靠性,但它给了你通常一个数据库集群底下那层所需要的东西。它有点像是你底下那个集群。所以你可以开始做一些挺酷的事:现在有相当多流行的数据库或者数据用例,直接建在对象存储之上。在我们的世界观里它有限制:对那些更小的事务型用例大概是合适的,因为事务型数据库有大量读写,这种场景你大概不想在它上面做超大规模的事——所以我们需要 Multigres。但对我们要去的那个方向,那几十亿个数据库,我们需要它们是一种文件格式。这就是 SQLite 特别有意思的地方:它在通吃。真正勾起我们兴趣的,是我联系了格劳伯,他发过一篇博客讲他们怎么做重写。基本上,我们有了一条路,能让 Postgres 和他们的文件格式兼容。所以,对,收购他们,而且我们会保留 Turso 这个品牌——Turso 会专注在 SQLite 上。然后我们会在 Supabase 上推一个新的更小的实例类型,叫 Supabase Spark。它会和我们所有库兼容,你可以给任何一个想法、任何一个原型配一个数据库;等它起飞了,你再升级到完整的 Postgres 数据库,一路升到 Multigres。我知道你们做这件事做了很久,这就是那个梦,对吧?
安特:对。向上扩和向下缩,一直是我们想解决的两件事。真的是等这些创新出现之后,我们才意识到,好,这件事我们能做。
swyx:你知道自己在往一个月五百万走。假设你看到的是一个月几十亿的曲线。其中一个秘诀是,它们其实都是挺小的库,对吧?这些东西很小,是 vibe coding 出来的应用。我不知道你对刚刚发生这一切有没有什么观察。
保罗:对,在它们获得增长之前。关键就在这:一旦你上了 Hacker News 首页,你就得知道你还能走多远。所以这整套东西的想法是,我们必须保证有一条非常顺的路径在几种后端之间迁移,比如零停机迁移,这是必须有的。因为我们现在看到很多非技术背景的人在造公司。我们有个客户叫 Magic School,那个人原来是个老师,他看到教学里各种低效——老师把时间花在本来可以自动化的事情上。所以现在这些创业公司开局就没有技术联合创始人、没有 CTO,而这已经不是个别现象了,正在变成……所有人。现在人人都是建造者。这就是为什么过去 18 个月我们看到的增长这么疯。
安特:对,但它还是感觉很早期。我认为还有一个大得多的市场,几乎是消费者式的建造者:公司里面的人、想自己做创业公司的人。这意味着多出很多数据库。就像我们说的,如果给每个人一个专属 Postgres 集群,那大概很快全世界的物理计算机都不够用。而这基本上就是正在发生的事:这一整年我们一直在面对它,增长成了我们必须处理的算力容量问题之一。
swyx:恭喜。另外我要说一句,我觉得格劳伯也是个玩梗高手。
安特:对,这也是我们喜欢他的原因之一。拜托。
swyx:他很厉害。不熟的人不知道,Supabase 那些梗背后就是这个人。低调的杀手,我会这么说。而且威尔·格劳伯也是。我不知道你们会不会互相交流什么好笑之类的?
保罗:还没有。不过我们肯定会给他 Supabase 推特账号的权限。我确实需要点帮助。
swyx:等等,现在还是你自己在弄?
保罗:现在我们有一小群青少年帮我。你们还办工作坊,对吧?
保罗:对,我们每周办一次工作坊,一个梗工作坊,基本上每周一次。但这个岗很难招人,因为你得懂技术,还得懂开发者觉得什么好笑,才能做这类营销。
swyx:对。
保罗:其实你们也是低调的玩梗高手。
swyx:我没你们好笑。你们真的非常非常好笑。有一张是海鸥,你站在一只乌龟上面——我记得是站在 Postgres 上面。
保罗:对,像一只站着的海鸥骑在一只飞着的海鸥上。
安特:我的天。
swyx:Supabase 太痛苦了。我现在找不到了。这都属于 Supabase 的深历史了。但你知道,有那么一段时间,那些东西就是,太好了。人们想成为你们,但做不到。那就是你们的护城河:梗。
保罗:有一些大公司想在自己的推特账号上玩梗。我不点名,但都是非常大的机构。
保罗:但就像我说的,这很难招人。那个写了四万字长文拆解梗策略的人——其实很早就有人研究我们的推特策略,发在了 Hacker News 上。
安特:对,在 Hacker News 上。
保罗:那件事挺好笑,因为他们把策略记录下来的方式,我们自己都还没落到纸上。所以后来我们招新的市场同事时,我们就说:这就是策略。它是别人写的。
安特:当然是 Hacker News 讨厌它。然后他们在评论里骂。
保罗:还拿了第一条评论。这个人、这个人——
swyx:这个人。《四个月 Supabase 推送里学到的》。他只看你们做了四个月。这是什么时候?
保罗:2022 年?好。
swyx:等等,我提过?哦,好,人在那儿。他就这么拆了。
安特:他拆了。然后 Hacker News 在上面骂。所以安特把他们骂的内容截了图,发在我们的推特账号上。
swyx:「你们的恨正好给我加油。」
安特:这是什么?有趣的文章。对,好,所以我也去评论了。
安特:对,我们很大一部分增长得归功于 Hacker News。早期我就是住在那个站上。
swyx:这我们得聊聊。你们和 Dang 签了什么魔鬼协议?哦天。
保罗:我们被 Dang 骂过很多次,基本上是因为一周里发太多东西。他对 Hacker News 和 YC 之间的关联有理由地警惕。所以一旦出什么事,他有点想把我扔下车,好让人知道:我们不是为 YC 的公司做这事,我们是独立站点。所以他一直在帮我们确保不去抹黑 YC 或者 Hacker News 的名字。
swyx:到这个程度,你们其实不需要他们了。但确实,我觉得 Dang 的可信度极高,没人真的质疑他。不过我确实觉得,你们发明了「发布周」这个打法。有一段时间,我记得是第四次还是第五次发布周,每一次发布都是 Hacker News 的第一名或者首页第一。
安特:我因为这个被骂惨了,因为我得意地把这件事发了推。我说,哦,我们在这儿。然后我被骂了,因为那看起来很难看:一家 YC 公司突然霸占 Hacker News 首页,看起来像是偏袒,而我还把这件事拿出来炫耀。
安特:而且这是真的。所以给所有人一个提示:永远不要把「你上了 Hacker News 首页」截图发到推特上。
swyx:因为那确实看起来像……说实话,那就是在炫耀,被指出来是对的。这一整套,我得说,现在算是有点上古史了,这件事有意义已经是好几年前。但对不了解 Supabase 历史的人来说,这些是必须打卡的景点。还有呢?
保罗:我觉得那个置顶帖很有意思,因为那是发布帖。但那不是我们发的,是别人把我们发出去的。我们没准备好,我们没准备好被发到 Hacker News 上。
swyx:而且你们当时并不把自己当成 Firebase 的替代品。
安特:对。那天是我们改标语的那天。
swyx:原来的标语是什么?
安特:是「实时 Postgres」。因为当时发生的事情是:我们想,来做一家 Postgres 公司吧。但在我上一家公司,我得从 Firebase 迁到 Postgres,又需要一个实时功能,所以我在 Postgres 之上写了一个实时引擎。我们以为这就是那个杀手级的东西:这个实时引擎在开源上有了一些关注,挺酷。所以我们说「实时 Postgres」,结果没人在意。我们有个网站,没人在意。于是我们说,改成「开源的 Firebase 替代品」,因为我们知道我就是因为这个原因才迁走的。然后大概只过了 12 个小时,那篇文章就上去了。对,到现在还是历史第一。
保罗:而且当时我们跑在 DigitalOcean 上,每个新数据库是两个 droplet,两个每月 5 美元的 droplet——一个给数据库,一个给 API,因为我们要把 API 升级、解耦。那时候我们只有少数几个测试用户。
安特:然后突然之间……我记得我们只有八个用户,就那一次发布,从八个变成了八百个。
保罗:然后我们烧掉了——我记得大概有一万美元的 DigitalOcean 额度,基本上 48 小时就烧完了。后来我们进了 YC,AWS 说,哦,我们可以给你……不管是多少,十五万美元的额度,只要你迁过来。所以我们在 YC 的第一周,就是把 800 个数据库迁到另一朵云上。你要是迁过一个数据库,就知道有多痛;迁 800 个,绝对不是你想在 YC 第一周干的事。太疯了。
安特:你还记得吗,我们本来可以留在 DigitalOcean。你进 YC 的时候,他们有个额度计划,那时候 DigitalOcean 给的额度非常多。我们说,嘿,能不能给我们这些额度,我们这儿正起飞。他们说,不行,你们已经用掉了那个一万美元的额度计划,不能再拿这个三十万美元的。所以我们只能迁到 AWS。
swyx:DigitalOcean 最大的错失机会,太严格了。
安特:以我们现在的 AWS 账单来说,大概会是他们有史以来因为太严格而失去的最大的客户之一。
保罗:但那是因为当时是新冠,那是一个所有人都在担心接下来会发生什么的时期。所以我觉得他们是:我们不想把自己铺得太开。
保罗:公平。以当时世界的样子看,那完全公平。
swyx:新冠期间人们做过很多不理性的决定。对。但你永远说不准,我刚想说,你们现在放在 DigitalOcean 上可能更值钱。但不知怎么 DigitalOcean 自己也一路猛涨。看这个。因为计算机——
安特:他们去年翻了三倍。挺酷。所以他们现在是多少?160 亿。十亿,对,一半。
swyx:好吧,那我想是 CPU 短缺了。对,有短缺。你们是怎么感受到的?
安特:我们真的是,一直在跑道尽头,经常和 AWS 碰。
swyx:有尖峰的时候有什么办法能顶上去?你们怎么做?就是跟人签协议?
安特:对,我们得提前规划得很细。我们付更多钱,我们和他们做伙伴。明天我们也会宣布引入一个新的投资伙伴,CapitalG。CapitalG 基本上能接触到 Alphabet 的生态,两边对我们都有好处。我们现在必须考虑多云策略:我们需要 GCP,或者说我们需要更多算力,那 GCP 是很自然的选择。当然我们也想尽可能和所有 AI 实验室合作,他们有一整套产品;我们在 Gemini 上已经和他们合作,我们想确保自己深深嵌进他们所有产品里。
swyx:这也是另一件事:你刚提到,数据库生态有多少是被块存储这些创新塑造的。显然 AWS 在那边是领先者。如果你打算拿 GCS 换掉 S3,多云就很难。
安特:对,只要他们的功能都齐。其实我不确定他们的对象存储是不是功能齐全,但我相信 S3 做了什么,别人会跟。
swyx:我还记得,大概三年前,他们推出了强一致性。对,那就是帮上忙的创新。
安特:而且现在已经上线了。
swyx:什么?还有 S3 Express,那也是一个大改变。
安特:为什么?因为基本上现在你要做的是:通常你写本地盘,然后需要批量刷到更持久的地方。而那个批量过程——写到这里的时间是一到两毫秒。所以在你向客户端保证写入成功之前,你基本上需要把它批量写到某个持久的地方。所以这个是持久的,没有 S3 那么持久,不是 11 个 9,但足够持久,你可以加上去。
swyx:「短暂的持久」。
安特:对,正是。然后在后台,你把这个当缓存用,再在后台往 S3 挪,那更便宜。
swyx:那还需要 Redis 吗?
安特:需要,你还是需要 Redis。这个离够快还差得远。你的缓存层基本上是内存、NVMe 盘、本地挂的 S3 等价物,最后才是 S3。
06 · 从原型到 PB(23:10)
swyx:好,正常。太精彩了。刚才那段信息量很大,我们跳得挺厉害。还有几件事要聊。你们的标语原来是「一个周末做出来,扩展到几百万用户」,现在是「从原型到 PB」,这非常好。它也真实反映了你们在规模上做的演进。你有没有什么对比的故事——早期 Supabase 和现在,人们起步的时候扩张得有多快?
保罗:有,最大的变化是,我认为是人们变现的速度。一开始是你选好数据库,把产品做出来;到了某个点,你再加上计费。现在因为可以在 agent 那一层直接接 Stripe,我们看到客户开一个项目、同一个星期里就开始真的赚钱了。而那是几天 vibe coding 出来的东西。当时我们并不确定这件事会持续,会不会改变软件的建造方式。但当我们看到有人——我记得是产品上线头几天就赚了一万美元——我们就说,哇,这是真的。人们在造真东西,而且真的赚到钱。所以我们知道必须押进去。过去我们也成功骑过浪:NFT 很火的时候我们押了一点,加了「用以太坊登录」「用 Solana 登录」,但我们没有投大量的开发时间,因为大家多少都知道它总会过去。为 vibe coding 做这个决定,我们讨论了很多次:团队要押多深。而那正是一个我们知道需要往上走一点市场的时刻:我们最大的客户已经在把我们当时的能力拉到极限。所以我们就知道,两边都得做——在小的、原型那一侧创新,也在大得多的一侧创新。那就需要更多人手。
07 · AI 与增长(25:10)
安特:从数字上看,Supabase 经历过三波 AI。第一波是嵌入。我记得当时我们讲的是 Supabase Vector。
swyx:那场演讲我转录下来了,它会一直……我们大概该更新它,因为那是你在 AI 工程大会上唯一讲过的一场。
安特:我们做了那场演讲,基本上就是所有嵌入数据库、向量数据库都在出来。我们当时力推的是:你可以把 Postgres 当向量数据库用。安德鲁·凯恩——一个完全独立的人——开发了一个非常棒的扩展。我们就想,好,去教育市场:Postgres 差不多什么都能干,你要存嵌入,不需要另一个数据库。这是第一波,它对我们是非常好的增长引擎,对 Postgres 生态也是好事,就是让大家知道这件事。现在嵌入上有很多创新,比如 TurboBuffer 在做的,他们用了很多 Turso 在做的创新,我觉得那类东西是非常好的用例。所以这是第一波。第二波是 vibe coding 的浪:Lovable、Bolt,这些一起来,那是 2024 年底。那段时间我们争论很多:嘿,我们真的要去那儿吗?我们要服务这些人吗?我们甚至要不要在 Supabase 上做自己的 vibe coding 平台?但最后,我们的使命是存下世界的数据。要做到这一点,按我们的标语,就是「你起步的时候我在,确保你永远不想走」。所以我们看到人们在那里起步,他们在做玩具,但它符合我们的使命,我们只需要相信这些工具会随着时间变好。然后第三波,也就是那些疯狂的数字,从今年开始:模型就是变强了。然后我们看到漏斗顶部、我们的注册率开始快速上升。通常发生这种事的时候,你要往市场里倒很多钱;而我们几乎没在市场花什么钱,大部分就是梗之类的东西。
swyx:我这儿有一张你们的图。来了。我是说,你们所有的图看起来都一样,因为都是指数级增长,你只需要一直改 Y 轴。
保罗:这件事另外一点很疯:通常当漏斗顶部来了更多偏消费者式的流量时,你的激活率和付费转化率会下降。但这两件事同时上升了,而且上升得相当快。
08 · agent 驱动的激活(27:40)
swyx:你知道激活率和付费转化率吗?哦,是你们 Supabase 的全套指标。
保罗:原因是注册到激活这一步,agent 一步就替你做完了,所以基本上接近 100%,摩擦消失了。于是这些用户付费转化的比例,比我们传统的开发者用户更高。
swyx:好。
保罗:我觉得很好。
swyx:我猜所有开发者工具都在看同一件事,对吧?只是速率不同。我认为你们显然在这个位置上领先。我本来想提这个:我有一个 AEO 追踪器,你输入 Supabase,有几个品类里你们是第一。基本上它导致了每一个前沿模型都把你推荐成集成后端的首选。集成后端是什么意思?就是你原来那套东西——认证、函数、数据库,还有 API 等等。我觉得有意思的是,你们得在市场里熬三四年,正好是你们的时间窗口,然后等大模型起来;然后你把自己摆成当时那个领先者的头号竞争者,接着你就可以接棒。
安特:对。对,我们时机上非常幸运,不能更巧了。纯属意外。
swyx:我是说,从第一性原理看,我们采访过一些在大模型之后才起步的创始人,Resend 就属于那种情况。我们也问过他们:为什么我的大模型一直推荐 Resend?是因为他们在 AEO 上做得很好。
安特:当然,我们在这方面投入非常大。但你知道,我们从一开始就在那个位置上,而那是意外。所以现在我们要做的只是保持领先。
保罗:还有社区。我们早期的一个增长策略就是花大量时间在社区里,结果是他们在写博客、做 YouTube 视频、做播客,全都是关于怎么用 Supabase、在什么场景下用、我是怎么把这个东西做出来的。我确信这些全都被模型吞下去了。
swyx:当然开源也有帮助。对,开源。你们在社区这一侧还有一个挺有趣的宣布,因为你们融了那么多钱,又想更深地把社区卷进来。
09 · 社区与众筹(30:00)
保罗:对。去年在 Supabase Select,我们宣布要做一轮众筹。这是我们一直想做的事,其实早该做了,只是手上别的事太多。然后过去一年我们在和律师打:他们说,以我们想参与的人数,如果不让人成为合格投资者,就没有机制可以做。直到我们问了一句:如果他们不投资呢?如果我们直接把股票送出去呢?他们说,好,我们查一下。然后他们回来说,其实有一个机制,如果你真的只是想送股票,是可以的。所以现在我们已经划出大约一百万美元的 Supabase 股票,基本上就是送给一批社区成员。我们要第一个请上台宣布的社区成员是这位,他在 Supabase 的 Discord 里叫加里·奥斯汀。这个人是 Supabase 社区的传奇。我们查过他的数据:过去六年,加里在 Discord 里回答了两万个问题。更疯的是,其中一万三千个是在问题提出后的第一个小时内回答的。而且他不是机器人,他是真人。
swyx:你见过他吗?他到底是什么来路?
保罗:他基本上算是退休了,就是单纯对 Supabase 感兴趣。加里·奥斯汀。
swyx:加里·阿博特。对,加里·阿博特是他的真名。
swyx:好,就是这位。
保罗:他爱 Supabase,因为他自己做了一个侍酒师应用,他爱红酒。然后他就玩得很开心——你知道,他家的圣诞树上挂着 Supabase 的 logo。
swyx:顺便说,这是我最喜欢的 Supabase 梗:就是你提醒我,我的 Supabase 额度快用完了。
保罗:所以这个宣布就是:任何在 Supabase 生态里的传奇人物,我们现在都可以(送股票)。
swyx:Discord 现在还是……我是说,我对 Discord 感觉复杂。它是最好的聊天工具,Slack 很烂。但它也不是公开的,对吧?里面的所有工作都不可扩展。你们找到什么办法解决了吗?
保罗:早期我们看过一些工具,最后决定不做,因为你还是得管哪些东西要公开、哪些不要。但我记得最早我们争论很多的是:好,我们要承载这个社区,是做 Discord、做 Slack 社区,还是做 Reddit?我们试了几种,最后落到这个结论上:Discord 用户会用 Discord,Reddit 用户会用 Reddit,所以我们基本上全都得做。
安特:就到他所在的地方去。对,就到他们所在的地方。
保罗:这就是答案?工作量很大。
安特:对,但结果对了。那就是正确答案。
保罗:但后来也冒出很多很好的工具。我不觉得有谁经受了时间的考验,这么说吧。确实有一些工具把 Discord 镜像到公开的问答站,是有人这么做的,我不知道有没有谁做成了。Common Room 帮了很多忙。
保罗:其实我们自己唯一做的事是这样的:任何人在这些地方问了一个像样的问题,我们就把问题和回答抓下来,放进我们自己的网站——抓进 GitHub Discussions,然后镜像到我们网站上。所以那些会被模型吞掉的内容……
swyx:你们把 GitHub 当 CMS 用。
安特:对,就当 CMS 用。这个策略很好,因为最终所有人都在反复问同样的问题,所以我们每次都能把它翻出来。
保罗:对。这里容易混:有开源的 Supabase,还有云平台的 Supabase。大多数人大概是来寻求云平台 Supabase 的支持。
swyx:你们对自己的开源市场占有率有概念吗?这很难说。
安特:我们相当刻意地不知道。我们不在开源版本里放任何追踪。你可以随便用。也确实有企业——比如大型制药公司——来找我们说:嘿,我们跑着你们开源项目的一百个实例,你们能不能给我们一个产品?所以我们有一个产品叫 Control Tower,让企业监控一批数据库。你在我们网站上找不到它。
swyx:哦,别这样。
保罗:为什么找不到?因为它明天上线。
安特:明天。我不确定明天会不会宣布,但基本上它就是 Control Tower,做的就是这个集群视图。我们有一个很受欢迎的产品叫 Supabase for Platforms,所有那些 AI 公司都建在它之上,我们替它们上线几百万个数据库。所以我们要做的只是把它重新打包给企业;企业也想做同样的事,它们想给自己的所有用户开很多内部的 Supabase,并且想看到、想管理它们。所以 Control Tower 本质上就是把我们已经为这些平台商开发的东西重新打包,只不过专门给单个企业用。
swyx:这个我想聊,因为很多人把你们看成纯自下而上的 GTM,会想知道你们在企业侧做了什么。首先,向文博致敬。
swyx:我觉得这是你们最近最成功的一次发布。
安特:Supabase for Platforms?它上线是在……2025 年 12 月。
swyx:对,但我看到过一些数据,你们自己也说它成功。我不——
10 · 开源与企业销售(36:00)
安特:我不知道。企业那一侧到底是什么?除了「给我一个看板」,那边的故事是什么?首先,我们得聊聊销售策略。
安特:Supabase 是一家非常典型的 PLG 公司。我们在意的是:每一届 YC 里 60% 的公司在用 Supabase。我们几乎把全部注意力放在这上面,就是成为一家「默认选项」公司。我们在这件事上的榜样是 Stripe:我们想跟着他们的脚印走。他们是我们见过的极少数开发者工具之一——十多年过去了,市场变了,他们对开发者的好感还在。所以这是第一件事。
安特:为了做到这一点,我们开始做销售的时候,做的是在此之上加一层,我们叫它产品驱动销售。我们找的是产品信号:可能是某个 logo,某个我们觉得很重要的客户;但更重要的是,他们可能正在快速扩张,可能撞上了某些限额,可能开始报错,可能付了某个金额。这类信号我们有一堆。然后 AI 来了,我们说,哦,从这上面能做一些有意思的事。假设我们每周有一千个产品信号,我们发一千封邮件给那些正在出问题的人,其中五百个回复。我们把没回复的那批人当作对照组。
swyx:好。
安特:然后我们衡量他们增长了多少。结果是他们每月增长 25%。接着我们把回复了的那些人挑出来,跟销售团队说:你们唯一要做的事就是和这些人通个电话,帮他们解决问题。因为我们有他们全部的流量模式,我们可以给他们一份话术——我们知道他们的问题是什么,AI 在这件事上非常有用。我们就给他们一份话术,只是帮个忙。结果光是通个电话、帮个忙,他们的账户增长就到了 125%。那 100% 的增量提升,就是我们给销售发奖金的依据。传统做法是:你去和这些人通电话,把东西卖给他们,然后你拿全额配额。但因为我们的数据库、我们的平台在这批用户上本身每月增长 25%,我们就知道销售队伍额外带来了这 100% 的增量。所以我们的销售职能就是这么跑的:永远聚焦在那些 logo,或者非常具体的产品需求上。
安特:所以企业那边进来,通常是因为他们想上线很多很多数据库。迁移生产数据库几乎从来不发生。比如把数据库从 MySQL 迁到 Postgres,或者从一个可扩展的数据库迁到另一个,基本上不会发生。而这正是 Supabase 一开始的核心论点:我们看过每一家试图做迁移的 Postgres 公司、数据库公司,它们都随时间失败了。你没法说服人们迁移,哪怕你造出一个更大、更好、更能扩的 Postgres。你要做的是第一天就和他们一起落地,然后确保他们留到第一百天、第一万天。所以我们全部的注意力都在第一天这些企业 logo 上。
swyx:绿地。
安特:绿地。对。他们还是不会迁移?我保证他们几乎永远不会迁移。会有一部分人需要 Multigres——我们和几个在考虑用开源的 logo 聊过,他们非常想参与,因为他们撞到了在规模上跑 Postgres 的问题,想帮我们把方向定对。但接下来大概五年,我们在企业侧几乎全部注意力都是确保我们能接住绿地的用例。
保罗:而在这件事上,企业现在被证明是一个非常高产的用例,因为他们希望自己所有的产品人都尽可能地去开发和创新。所以这对我们来说又几乎是完美时机,因为这正是我们长期专注的东西。Control Tower 是我们最大的事情之一;Multigres 当然给了我们在他们想迁移的时候去赢下那些重负载的机会,但它永远不会是我们的核心焦点之一,至少未来五年不是。我们必须把重心放在先落进这些企业里,然后再往上扩。
保罗:另一个变化是,过去我们显然把全部注意力放在开发者身上:卖给开发者,把他们变成内部的拥护者,他们帮你内部销售。有意思的是,现在我们遇到一些 CPO 会说:哇,我过去十年没写过代码,但现在因为 Lovable 和 Supabase,我在公司内部把各种东西都造出来了。所以我们直接在 C 层有了拥护者,而且不需要为此搞一个很大的动作。
swyx:这很好。说到 Lovable、说到 Bolt——Lovable 也会有自己的一套数据库,你知道的,每个人基本上都会试图侵入别人的地盘,放在大格局里这很正常。那谁更粘?——
11 · 谁更粘(40:50)
安特:谁更粘。
swyx:谁更粘。比如,CPO 更可能和 Lovable 绑在一起,还是和 Supabase 绑在一起?这个问题你们会遇到吗?
安特:这是个好问题。我认为归根结底,跑数据库非常难。
保罗:说得对。就像我们刚讨论的,迁移数据库比迁移前端工具难得多。
安特:对。
保罗:而且我不是说 Lovable 不粘。我觉得它很棒。事实上他们是第一批把「别让 agent 对数据库干蠢事」这件事做好的。因为我们很早就看到,agent 会试图把图片数据塞进 Postgres,它们会为了让自己跑通就把 RLS 关掉——基本上就是靠回形针最大化。Lovable 写了一整套很好的 skills 来阻止它们的 agent 干蠢事。他们是第一个,那是他们的秘方。
swyx:对,为了让这些全都解决。而且现在模型本身不会干那种蠢事了。所以情况好了很多,从 2022 年那个「威尔·史密斯吃意面」变成了 2026 年的「威尔·史密斯吃意面」。那是个很有名的梗。说到迁移这一点,我提一句就放过它:我有个很大的顿悟时刻,是见到你们董事会的凯伦(Coatue 的)。她说她的论点是——你替代的不只是 Firebase,你还在成为「新的 RDS」,也就是亚马逊那个。如果 Supabase 在大模型之后有第四纪元、第四阶段,那就是你增长里那另外的一万亿:把 Oracle 拆掉。我不知道,那是不是那头白鲸?
安特:那不就是最有名的那些迁移的来源吗?我听过一个很疯的数字,可能现在不一样了,因为 Oracle 也在把一切往云上搬。但大概一年前有人说,按收入算,只有 5% 的 Oracle 负载跑在云上。所以几乎每个人都在说:来,把 Oracle 拆了,做迁移。这就是我的意思:当我回看那些尝试过这条策略的数据库厂商的历史,听起来都很棒。我们自己当然也会去试,为什么不试?但它难得离谱。我觉得你首先还是想聚焦在落进企业里。
swyx:有道理。就是那种,我整天和做编码 agent 的人聊,最大的承诺就是你终于可以迁走所有这些遗留软件了。
安特:对,希望那意味着你把一切全都切过去。因为让 Oracle 这么粘的原因之一,是你最后写出了几百万行的存储过程,把所有东西都塞进数据库里。所以现在重写那部分大概容易多了。
swyx:对。所以希望编码 agent 是那个引爆点。也许它们还没到那儿。也许你们得变得更偏本地部署。
安特:迁移大部分的问题其实不在重写。比如在数据分析那一侧,从一个仓库迁到另一个仓库很容易。问题是你的 OLTP 数据库通常支撑着你最赚钱的那个应用,所以一分钟停机就意味着真金白银的损失。于是你只能让两套东西并行跑,而这里面的风险是你会出现脑裂:有些数据在一侧,有些在另一侧。任何试着去对账脑裂的人都知道,那是个非常难的问题。所以 OLTP 这边的风险高太多,很多时候人们干脆就只是想想,然后开始新负载、在新地方做很多新业务,希望有一天能把东西迁过来。
swyx:对。
安特:但通常那样你就有了两个问题。
swyx:说到 OLTP,这简直是数据库人的纵欲话题。我们这儿也来过 Databricks 的两位联合创始人,马泰和雷诺兹,他们声称自己解决了 HTAP。那是数据库人心里的白鲸。你知道,传统上你需要一个 OLTP、一个 OLAP 数据库,两者永不相见,除非有时你希望自己从来不需要复制任何东西。
安特:对。
swyx:你们关注这些吗?从 Supabase 的角度有故事吗?
安特:我关注 Duck Lake,Duck Lake 和 DuckDB 都是很有意思的技术。
swyx:是「鸭妈妈」加一个数据湖吗?Duck Lake 是什么?
安特:Duck Lake。DuckDB 基本上就是面向分析的 SQLite。
swyx:列式存储。
安特:对,正是。它可以直接从对象存储读,这通常就是它被宣传的方式;它其实也能直接读你的 Postgres 数据库。开源,很好的技术。另外还有 DuckDB Labs,最近被 AWS 收购了。所以他们有个基金会在开发,围绕开源在建一个委员会。我其实有点把 DuckDB 看成分析生态里的 Postgres:他们努力让这个东西不属于任何一家公司。它做很多事,非常通用。像个荷兰教授。
swyx:对,正是。
安特:对,他们在荷兰生活和工作,挺酷的。所以我们在仓库那一侧的兴趣,主要不是把 Postgres 做成分析型数据库,而是用对的技术做对的事。HTAP 我不知道,很多人试着去屠那条龙。对象存储可能是解,但总体我们认为,一旦你在 OLTP 这一侧到了一定规模,你就必须有分片:你能挂的 NVMe 盘是有限的,如果你要把事务拆到两台服务器上,本质上你就要从对象存储取,那最终会拖慢数据库。所以我们认为分片是扩到 PB 级最好的办法;然后分析你就该另外对待。这不意味着你不该把数据直接存在对象存储上、再从另一条路去读,但硬把这两件事砸在一起,在我看来并不太说得通。
swyx:行,那就先到这儿,我们还有别的要聊。我确实觉得,据我读到他们在做的,他们是拿数据库机器上的闲置算力来撑这些复制。
安特:说实话,我没有细看他们是怎么做 HTAP 的,所以我可能说错。
swyx:对,就是这样。你在自己的车道里,你的客户也没有拍桌子要这东西。只是如果你想成为那个最重要的数据库公司,总有一天你得有个答案。
12 · 持久化工作流(48:10)
安特:正是。
swyx:有意思。我还想追问的另一块是持久化工作流那个世界,你知道 Temporal 一直在推。
安特:这件事我一直在敲鼓。你们每年都做一点小东西,对,我们在往前挪。
swyx:为什么它没有更像你们的 P0?因为你知道 Temporal 做得非常好,对吧。
安特:所以对我们来说,做持久化工作流缺的是什么?是 Compute。对,所以你们现在开始做了。
安特:这个领域我觉得很有意思。之前社区里有人试过在 Supabase 的函数之上造工作流引擎,就是不行,因为那个两秒超时。
swyx:对。
安特:现在我们有那个原语了,能把长时运行的持久化工作流解锁出来。
swyx:Supabase 最初的卖点就是那种一站式、agent 式的云,是大家能用的集成后端,对吧?你现在有了和 ChatGPT 的登录集成,那是很好的一块。你基本上就是把 AI 想要的一切都给它,然后它就会成为你最好的朋友。
安特:对,差不多。而且要高产。我们的 P1 策略就是尽可能和这些前沿实验室、这些模型做伙伴,所以我们得在这件事上高产。然后我们看到的附加率也一路在涨。
swyx:显然有美国的实验室,你们也在美国。其他实验室有重要的合作吗?它们是什么样的——Mistral、Cohere、中国的实验室?我不知道。
安特:不太多。它们可能会做。
swyx:好,你们大概只在乎美国。
安特:对。
保罗:行,这挺公平。主要因为目前是它们带来最多流量,对吧?那会变。
swyx:但合作到底长什么样?在他们应用商店里是一个层面,成为他们发布 artifact 时的默认选项是另一个层面。
安特:对,那件事对我们非常有吸引力,希望我们能成为那些供应商之一。过去我们做不到的原因之一就是我们接不住他们的规模。拿 ChatGPT 举例,它现在有多少?十亿月活?
swyx:十二亿。
保罗:十二亿月活用户,其中每一个用户每个月开一个数据库,那我们就要跑十二亿台 Postgres 服务器。所以就像我说的,我们必须做到一个月几十亿个数据库。直到今天收购了一家能带来这项技术的公司,我们才做得到。
swyx:向上扩、向外扩。好,除此之外,公司的其他 P0 目标是什么?未来一年,你们怎么定方向?
13 · 公司优先级(50:52)
安特:我们的 P0 基本上是:赢下那些战略实验室、赢下那些模型,然后继续推 PLG,然后 P4 才是企业。我喜欢 P4 是企业这件事,1、2、3、4,这就是排名。老实说,事实就是这样。在企业上我们盯着的,就是赢下这些新的工作负载。
保罗:而且更多是 PLG 的天花板问题。公司刚开始的时候我们想,PLG 能做到一亿美元,大概能到两亿,但之后我们就得换一种推进方式。但因为 AI,那个天花板被抬起来了,而且我们不知道被抬到哪儿:是十亿?是二十亿?你可能就……我们可以一直往上走。但我们还是想把另外那件事也做了。所以基本上去年我们的结论是:两边都得做,小的和大的。可能我们是有点贪。
swyx:我觉得那正是人们想要的,对吧?同一个心智模型——而且他们会付钱给你,让你去处理升一个数量级时那些细颗粒度的事。我不知道那是多少个数量级,但挺多的。
保罗:这很疯,因为如果 18 个月前你问我们,那时我们在快速增长;如果你说,你能做什么把漏斗顶部扩大十倍?我会说,什么都做不了。很疯,对吧?然后整个市场就那么爆炸了。那就看看接下来会发生什么。
安特:对,我记得年初公司 offsite,我们抛出了一个疯到不行的收入数字。然后有人过来跟我说:你不该定那个数字,团队会很失望的。结果我们四个月就打到那个数字了。从年初开始就是一条荒谬的增长曲线。
swyx:太厉害了。你们有哪些悬而未决的问题?如果你有一个水晶球,它会改变你下注的方式。
安特:开发会怎么做,以及人们会开发什么。这是我经常想的两件事。
swyx:好,可能的答案是什么?就是更多 agent?
安特:今年我们很大程度上聚焦在——我会在 keynote 里讲——我们从一个看板公司起家,那时候那就是最好的开发者体验。后来很多人说,哦,headless 模式。Headless 其实是我们一开始就有的东西:headless、360、Salesforce 这些。我们从一开始就有,你可以直接用 Supabase,API 驱动。这也是我们成功的原因之一。今年我们最大的重心是转向 code first,做到原生。也就是说,当你在本地机器上启动一个 Supabase 实例时,你会得到一个 Supabase 文件夹,它就代表你的数据库,里面有你的所有函数、所有东西。
swyx:这个今天存在吗?
安特:今天就有。如果你用 CLI。
14 · code-first 与声明式 schema(53:24)
swyx:那是个虚拟文件系统。
安特:对,它是一个表示,像基础设施即代码。事实上明天我们要宣布的,是我们对声明式 schema 做了最后一轮改动。这一项其实非常难,要覆盖 Postgres 的全部。所以现在你可以有一个 Postgres 的完整文件表示——你数据库的形状,声明式地放在你的文件夹里。这对 agent 非常重要。因为通常你操作 Postgres 的方式是迁移文件:每次改动你就往 migrations 文件夹里加一个文件,它像一份历史日志。这很好,是行业标准。但想象一下,你把 agent 丢到一千个文件面前,问它:这张表的形状是什么?它得在一千个文件里猜。它得重新编译——重新编译,或者你得在本地起数据库、把迁移跑上去,然后去 introspect 数据库。那太慢了。所以我们想做的是,把 Supabase 文件夹里的 schemas 文件夹变成一个你数据库的完全声明式状态。我们把这个全部捕获住了:表、策略、数据库注释,全都在这些文件里。所以我们发布一个新的库,pg_delta(节目里念作 pgDulta)。你可以把它用在任何 Postgres 数据库上,不过我们为 Supabase 准备了机制。所以对 agent 来说这是重要的一步:我们知道 agent 主要会在代码上操作,它们不想去连任何东西,它们必须在文件系统上快速迭代。
安特:现在大家用 CLI,对这些外壳是满意的。我猜我们会更往前走一步:比如我现在试着只在手机上做点开发,而且相当顺手。当然我知道背后在发生什么,所以我会告诉它一些从基础设施角度我知道它必须做的事。但我们正在到一个状态:我可以想象你不需要是工程师。你有个想法,你对手机——或者对你的女儿,对你那个个人 agent——说,我想做 X。一秒钟之后,应用就上线了,你自己就能迭代。所以我在想的是:如果真是这样,人们会想要哪些用例?是个性化吗?我们在意什么?这些东西会往上扩吗?机制是什么?我们要怎么开发?我们需要提供什么工具,才能确保我们在这个新世界里是默认的供应商?
保罗:你对水晶球有什么想问的吗?作为一个已经做了几十年软件工程师的人,你对软件该怎么建有很强的看法,对吧?比如持续集成、持续交付之类的。我发现自己会把我的看法强加给 agent:哦,你应该这样做。但现在越来越多的时候你不需要了。而我的担心是:它们会不会全都在某一种建造软件的方式上收敛?
swyx:模式坍缩。
保罗:那正是——
15 · AI 造的软件会收敛吗(56:30)
swyx:太好了。他们全都会去用 Supabase。太棒了。
保罗:但软件开发行业最好的地方就在这儿:这些都是著名的口水战,对吧?什么才是正确的做法。我们会不会把这些丢掉?
swyx:所以你想要想法上的多样性。
保罗:对,正是,这样最好的想法才可能赢。但模型会让你变得太懒,懒到没人愿意去看细节,然后它们就全都收敛到一种建软件的方式上。那会不会变成一个局部最优——
swyx:我不知道。首先,我觉得这个担心是成立的。我也觉得这在你控制之外。是的,那些品味较低的、我们叫它普通应用建造者,会收敛到平均值上,也就是模型的平均值,也就是你们。但那些有辨别力的高手会一直真的在意细节,本来就该如此,而这些最终会往下渗透。
保罗:对,这是我的想法。但那些高手还会继续被培养出来吗?
swyx:我不知道。我觉得人足够有热情。有一件事是,我觉得普通大学大概是完了,你可能不再需要上大学,你可以自学,然后找到自己的工作。一直有那么一批顶尖的人推动着大部分进展,你需要他们,而他们总能找到办法满足自己的利益——出于好奇,想知道有没有更好的可能。那种休学一年去 Recurse Center、就为了做很酷的编程问题的人,哪怕他们本可以在工业界赚钱。对,一定是这样。
swyx:你们两个人之间有什么分歧吗?能同时请到你们两位很难得。
保罗:这挺好。
swyx:在这个节目上。所以我想把这个记下来。
保罗:我觉得我们能配合得这么好,原因之一是:确实会有我们不认同的时候,但只要对方稍微推一下,另一个人就会说,行,也许你是对的,试试吧。所以我们从不会吵到翻脸。而且事实证明,那些东西大部分根本不重要,只要大方向是对的,就还行。不过我想不起来有——
swyx:你们俩这儿明显卡住了。我的天。
安特:对。这也是因为从来没有什么重要到需要真的吵起来。我们从没翻过脸,因为从来没有哪件事重要到值得为此狠吵。而且我们他妈的太忙了。所以通常就——
swyx:各管自己那块。你们在处理业务的不同部分。也许只是因为公司在增长,你有了自己的领域,然后就只要一起干。
swyx:有意思的是,我们仨当年都在新加坡的 Entrepreneur First。
安特:我们那时候都在做不同的公司。
swyx:然后你们在那一期之后留了下来?你们那期之后成了室友?
安特:对。我们住在一个七个人的房子里,所有人都在做不同的创业公司。
swyx:所以——
安特:当时那位在做他的创业公司,我在做另一个。那是在 Supabase 之前。
swyx:所以我觉得你们不知怎么就在能量上发现,彼此适合一起工作、一起做这个项目。
保罗:对。因为传统上,尤其是在加速器模式里,你会被推着让一个技术的人去配一个领域专家。但我们住的那个房子里,基本上七个人全是建造者、全是技术的人。我们发现这种配对高效得多,尤其是在做开发者工具的时候,因为你自己就是那个领域专家——你是个开发者。所以能做成的事多得多。后来我们把住在那个公寓里的人大部分都招了进来当员工。
安特:罗里是第一个员工吗?不是第一个,但是市场侧的第一个。现在他管整个 GTM。第一个是那个 Postgres 的人。
保罗:不是,是安杰利科。对,我们当时有个实习生。
保罗:是我上一个创业公司的实习生,我们就是把他拉过来了。然后第二个全职招进来的是这位,史蒂夫·查韦斯,他是 PostgREST 的。好笑的是,我们在 YC 那一期,YC 给你的建议是:好,我们会给你一笔钱,别招人。最大的诱惑就是招一个大团队。然后我们去找我们的合伙人说:哦,但我们有这个人,史蒂夫,他是 Postgres 的主要维护者。他说,立刻招他。别管那条建议,去把人拿下。
swyx:是因为他的名声,还是因为这对 Supabase 说得通?
保罗:两个都是。这件事说得通:这是我们非常依赖的技术,而我们要押进去。好笑的是,我们把史蒂夫招进来之后说:你别管 Supabase,你就继续做 Postgres,把它做得更好。之后当然如果有支持请求什么的,我们可以问他。这个模式跑得非常好。后来史蒂夫想把 Postgres 团队做大,我们就招了更多专门做那个项目的人。
swyx:你们为社区和开源做了很多。我心里一直有个问题:大型商业开源公司的未来是什么?第一,显然有很多垃圾,我确信你们也在处理;第二,你的依赖正在变成可选项,你可以随手 vibe code 任何东西。
swyx:所以你们脑子里关于开源的未来,我很想听。
安特:我觉得用 Rust 重写是个合理的机制。我们团队里有人来找我说:哦,我正在把我们在做的一切都用 Rust 重写。我说,写到什么层级?你要重写数据库吗?你要重写 Postgres 吗?Postgres 不是 Rust 写的,但我怀疑你会在意到那个层级。所以是有层级的:你会想重写到某个层级,然后你不会想把真正的创新 token、或者你真正的 token 花在重写一切上。大概会出现几乎所有工具向 Rust 坍缩这件事——如果 Rust 最终成为写东西的终极方式,因为它更快也更正确。这大概会发生在大多数开源工具上。但等这一轮迭代做完,所有东西都跑在这个非常高效的语言上之后,你就不会每次都把所有东西重写一遍了。会有少数赢家。一个很典型的例子是:Postgres 是 Haskell 写的——一门非常不寻常、非常难维护的语言。它现在能不能用 Rust 写?大概能。机制还在,功能仍然有价值。如果那真的发生,大概只会有 Postgres 的一个 Rust fork,而它会在那个品类里成为赢家。
swyx:但你们还没做。而且你们很多东西是 Elixir 写的。
安特:对,那是另一件事。然后你要在基础设施这一侧想:Elixir 是一门很有意思的语言,因为有 BEAM。
保罗:所以你会开始想,在运维这些系统的时候,什么才是对的机制。但现在你几乎可以轻松地换范式,只要你的测试都过得去。
安特:对,那是个好观点。我没有认真想过我们会不会把 Elixir 换成 Rust。
swyx:现在它只是个选项。Vercel 的 Malte,他有一条推我记到现在。他有很多有意思的想法。他拨出一笔钱,把我们所有的依赖在 C 层或者 C++ 层重写成 Rust,因为我们就知道它更安全、更正确之类的。这是对开源的一次性升级。所有驱动,你用到的所有东西。我觉得那是个相当有意思的判断。
安特:这个想法我喜欢。但我觉得它不会发生,因为人们喜欢自己动手做。不过作为一个想法,如果我们公司来做,我会百分之百支持。
swyx:太好了。然后我想是收尾问题,我本该早点问的:Supabase 内部的 AI 编码。显然你们是外面编码 agent 的大受益者。内部政策是什么?你们花多少?会担心支出吗?这类事情。
保罗:Supabase 一直感觉像是几家不同的创业公司粘在一起。所以我们有 auth 这个产品,我们一直坚持他们应该自己决定用什么工具、团队怎么运作、汇报结构怎么定。AI 政策也差不多。很多人来问:AI 编码政策是什么?我们说:这取决于你们团队自己。我们现在开始在某些地方收拢一些,尤其是成本这一块。但只要能,我们还是想保留这个模式:让团队自己决定要怎么做。
16 · 团队怎么用 AI(1:06:01)
swyx:就是这样。非常去中心化。
swyx:我一直想给公司管理者一个能带走的数字:市场的标准是什么?这里有哪些数据点可以让你挂帽子?人们说,普通个人每月花二十美元左右,普通员工大概每月两百美元。OpenAI 那边,第五十百分位大概每月三千到五千美元,最高的那档大概是几十万美元。这是粗略的概念。我觉得一个好指标基本上是:你的 token 支出对人力支出的比例。对很多人来说,大概是一个人力薪水配 0.1 的 token 支出。你大概可以安全地涨到 1。如果超过 1.5,你可能就有麻烦了,差不多这样。
安特:我得说,作为一家远程公司,基本上发生过的一切都有文档,所以我可以问我们的 AI 我们花了多少钱。目前我们每月大约花三十万美元。
swyx:给六百人?不,是四百五十人?
保罗:四百五十人。对。
安特:四百五十人。
swyx:好。但你刚才说的、把成本和员工数挂钩的思路说得通。对我们来说也是这样,因为我们招人非常快。所以如果我们能从额外的支出里拿到很多杠杆,那就该这么做。
swyx:你应该这么做。你需要一堆能随用随开的 serverless 员工。
保罗:正是。就像,你知道,我刚碰到另一家顶级创业公司的 CTO,他说他很担心公司的支出。我说,其实那是你对其他所有人的投资。而且它大概是极度偏斜的:你公司里有两三个人特别猛,其他所有人大概都还没用够 AI。
安特:对,我们看到的也完全一样。我们有个排行榜,把榜单挂出来,通常人们会有点不好意思。
swyx:因为你在浪费钱,大概。
安特:而且那个关注点也是错的。关注点不应该是你花了多少钱,而是端到端——从系统思维的角度去考虑。
保罗:而是你到底解决了多少个端到端的流程,做到里面不再需要人;或者把那些原本要跑很久的人力问题压成很短的问题。所以我们的投入大部分花在这儿:我们怎么用 AI。幸运的是,就像你看到的,Supabase 发生过的一切都有文档,因为我们是一家异步公司。所以给公司建一个 harness——给 Supabase 建一个议程式的 harness——基本上就只是把它形式化:你可以把 AI 指过去问,我们的原则是什么?它会把 Supabase 全部历史上我们的决策原则都写下来。这是我们花很多时间的地方。在聊人之前,我们现在大概有五十个在招的岗位。我们完全全球远程,所以你在哪儿我们不在意。
swyx:哪儿都一样薪水,对吧?
保罗:对,不论你住在哪儿,薪水一样。如果你在自己做的事上非常强,请去看看我们的招聘页。
swyx:能不能举一个画像,随便挑一个,你现在最想找的、也为什么?
安特:SRE。可以。为什么?因为我们增长得太离谱了,我们需要能招到的所有 SRE。
swyx:那什么样的特质——你们大概会收到很多 SRE 的申请,很多你不看。什么能跳出来?
安特:我们真正在意的是,你真的想远程工作。这有点奇怪,但——
17 · 远程优先的招聘(1:09:45)
swyx:对,这是真的。我们收到很多很高质量的人,但要融入 Supabase,你多少得能在远程优先、完全异步的环境里如鱼得水。这其实不是适合所有人的。我们很早就学到了这一点:有人进来会说,哦,这环境,我需要看到人。而我心里 SRE 的典型形象是——一个灰胡子,坐在某个地牢里,本来就不想和人说话。那才是完美的人选。
安特:对。
swyx:所有这样的人,都请来申请。
安特:希望他们会听这期播客。
swyx:我们在 SRE 上大概确实有很多很棒的人。我一直公开说,对 agent 创业公司来说,AI SRE 是最难的品类之一。
安特:我觉得我可能很快就会被证明错了,但到目前为止它是对的。AI 还没有攻下 SRE,不管什么原因。
swyx:还没有,还没有。
安特:对,我同意。写软件这件事,你知道,还可以讨论,是解决问题。维护,也就是让东西一直跑着——
swyx:对。
安特:那是完全另一头野兽。
swyx:好吧。谢谢你替所有人让东西一直跑着。恭喜你们这段旅程,我真的很骄傲能做你们的朋友——
安特:谢谢。
swyx:——也是投资人。看着这些进展。我太期待 IPO 了,不管那是什么时候。看起来还要一段时间,但会很好玩。我真的很想看到你们敲钟,一起把下一家伟大的开源公司建起来。对吧?太好了。
保罗:一定的。谢谢你请我们来。
References
- 1Supabase’s Plan for a Billion AI-Built Apps
latent.space
- 2
- 3Supabase Series F
supabase.com
- 4Supabase is acquiring Turso
supabase.com
- 5
- 6Compute | Supabase
supabase.com
Comments