9月7日-13日大模型发布追踪:DeepSeek-V4.1-Flash、GPT-Image-2.5 与 GPT-Live-1
本期核对 9 月 7 日至 13 日的三个核心模型发布,聚焦 DeepSeek-V4.1-Flash 的非对称架构与极低缓存价格,以及 OpenAI GPT-Image-2.5 与 GPT-Live-1 的能力、定价与选型边界。

一句话判断
本期覆盖窗口是 2026 年 9 月 7 日至 13 日(UTC+08:00)。本周大模型赛道出现两条鲜明演进路线:国内厂商聚焦于核心架构重构与极致工程降本,深度求索发布采用非对称编码-解码器 MoE 架构的 DeepSeek-V4.1-Flash,将缓存命中单价压缩至每百万 token $0.003,并宣布由其全面平替 V4-Pro;国际厂商则在生成模态与交互维度纵深突破,OpenAI 集中交付图像生成模型双子星 GPT-Image-2.5 Flare / Sunburst 与首个全双工实时语音 API 模型 GPT-Live-1。
研发团队在本周进行技术选型与服务接入时,可将 DeepSeek-V4.1-Flash 部署进高吞吐、长上下文的代码与智能体工作流,用其验证缓存降本空间;将 GPT-Image-2.5 接入需要多轮修改、局部重绘和高保真人像的图像管线;将 GPT-Live-1 用于低延迟电话呼叫与实时语音客服,由其承担全双工交互并将深层推理委派至后台主力大模型。
先看价格、状态和边界
| 模型 | 发布与定位 | 关键技术与架构变化 | 官方评测信号 | API 价格与上下文 | 当前可用性 | 先测什么 |
|---|---|---|---|---|---|---|
| DeepSeek-V4.1-Flash 1 | 9 月 10 日发布;552B 原生多模态模型,全面接管 V4-Flash 与 V4-Pro 服务流量 | 非对称因果编码-解码器(Causal Encoder–Decoder)MoE 架构;输入激活仅 8B、输出激活 16B;KV Cache 占用压缩至前代 1/4 HBM 与 1/8 SSD | DeepSWE v1.1 74.2,Terminal-Bench 2.1 90.6,CyberGym 88.1,GPQA Diamond 90.9 2;Artificial Analysis 记录 Intelligence Index 40、输出速度 214 tokens/s 3 | 缓存命中:非峰值 $0.003、峰值 $0.006 / MTok;缓存未命中输入:非峰值 $0.15、峰值 $0.30 / MTok;输出:非峰值 $0.60、峰值 $1.20 / MTok;1M 上下文、384K 最大输出 4 | API 模型名 deepseek-flash 已上线;旧版 Flash 已下线;9 月 14 日 04:00 UTC 起 deepseek-v4-pro 流量自动重定向至该模型;Hugging Face 开放权重与报告 5 | 真实工程仓库长任务、代码生成准确率、缓存命中单价与峰谷时段成本 |
| GPT-Image-2.5 Flare / Sunburst 6 | 9 月 8 日发布;图像生成与精准编辑模型,分为轻量高吞吐 Flare 与高精细度 Sunburst | 生成延迟相比 Images 2.0 降低达 50%;多轮对话编辑质量保持稳定;强化参考照片主体特征保留、复杂排版与透明背景生成能力 | Artificial Analysis Image Arena 榜单显示 Flare (max) 取得 Elo 1186.73,Sunburst (max) 取得 Elo 1180.21,分列文生图与图像编辑榜前两名 78 | 图像输入:标准 $8.00、缓存 $2.00 / MTok;图像输出:$30.00 / MTok;文本输入:标准 $5.00、缓存 $1.25 / MTok 9 | ChatGPT 各端已全量上线(支持 Sketch 草图与模板);API 端提供 gpt-image-2.5-flare 与 gpt-image-2.5-sunburst 接口调用 | 参考图一致性、连续多轮修图细节漂移率、透明背景抠图精度、批量生成耗时 |
| GPT-Live-1 (API) 10 | 9 月 10 日上线 API;全双工实时语音基础模型,告别传统分立级联架构 | 单模型同时处理语音输入与输出音频流;平滑打断处理;支持通过系统提示词定义音色、语速与对话风格;支持将深度推理委派给 GPT-6 Astra 等文本模型 | Full Duplex Bench 相较 GPT-Realtime-2.1 综合表现提升 30 个百分点;搭配 Astra (medium) 在语音智能体基准 Tau3 排名第一;Artificial Analysis 对话动态评测得分 97.3% 10 | 前端语音交互层固定为 $0.05 / 分钟;后端调用的文本推理模型与工具按照各自 API 费率单独结算 10 | OpenAI 开发者平台 API 全面开放;提供电话协议支持与 Codex 协同范式 | 强噪音与插话打断反应时延、后台复杂推理委托衔接度、通话场景吞吐与成本 |
注:价格统一按美元(USD)核算。DeepSeek 区分工作日峰值(UTC 01:00-04:00 与 06:00-10:00)与非峰值时段;第三方 Artificial Analysis 的跑分基于独立测试集与固定参数,数据与厂商自报口径独立保留。
DeepSeek-V4.1-Flash:552B 非对称架构与千分之一美元级缓存
该模型的首要技术变革在于抛弃传统对称结构,采用因果编码-解码器(Causal Encoder–Decoder)MoE 架构。在单次前向计算中,模型读取输入时的激活参数量仅为 80 亿(8B),生成输出时的激活参数量为 160 亿(16B)。这种计算不对称设计大幅降低了大规模并发处理输入 prompt 时的算力消耗。深度求索通过新型预训练机制配合更大规模的强化学习(RL)后训练,使轻量级激活模型在编程与智能体评测中展现出越级表现。1
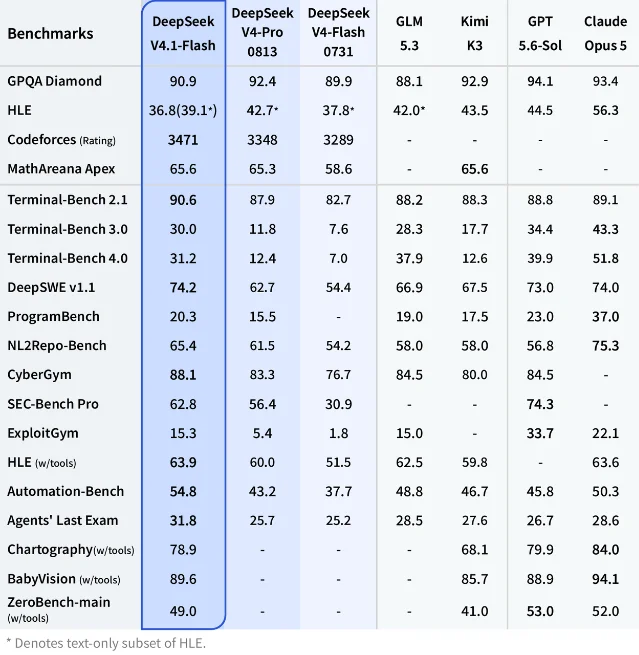
从官方公布的评测指标看,DeepSeek-V4.1-Flash 在多项工程化任务中反超前代旗舰 DeepSeek-V4-Pro:
- 真实软件工程任务基准 DeepSWE v1.1 达到 74.2 分(V4-Pro 为 62.7 分,前代 V4-Flash 为 54.4 分);
- 终端环境测试 Terminal-Bench 2.1 达到 90.6 分,Terminal-Bench 4.0 达到 31.2 分;
- 网络安全防御基准 CyberGym 取得 88.1 分,SEC-Bench Pro 取得 62.8 分;
- 学术推理基准 GPQA Diamond 达到 90.9 分,Codeforces 评级达到 3471 分。12
在显存与存储效率方面,DeepSeek-V4.1-Flash 压缩了长上下文下的状态膨胀问题。官方公布数据显示,相比上一代模型,V4.1-Flash 的 KV Cache 显存占用(HBM)缩减至原来的 1/4,外存固态存储占用(SSD)缩减至原来的 1/8。由于智能体工作流普遍依赖多轮对话与历史前缀复用,缓存体积缩小直接驱动 API 成本下调。1
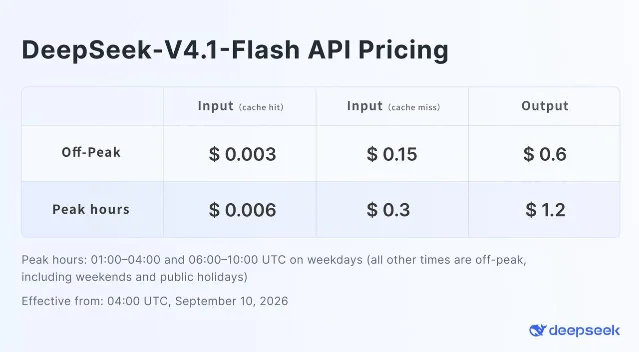
在 API 服务层面,深度求索给出极具冲击力的计费方案:
- 缓存命中输入(Cache Hit):非峰值时段为每百万 token $0.003(约合人民币 0.021 元),峰值时段为 $0.006;
- 缓存未命中输入(Cache Miss):非峰值时段为每百万 token $0.15,峰值时段为 $0.30;
- 输出内容(Output):非峰值时段为每百万 token $0.60,峰值时段为 $1.20;
- 峰值时段定义为周一至周五的 UTC 01:00-04:00 与 06:00-10:00,其余时段均按半价(非峰值)结算。4
针对模型迁移与产品整合,深度求索做出两项关键业务调整:第一,前代 V4-Flash 与实验性模型 V4-Flash-Vision-Exp 正式下线,旧模型名接口临时自动路由至 V4.1-Flash;第二,由于第三方实测中 V4.1-Flash 在能力、耗时和成本上全面超越 V4-Pro,深度求索启动 V4-Pro 退出流程,自 UTC 时间 9 月 14 日 04:00 起,所有发往
deepseek-v4-pro 的请求均自动转由 V4.1-Flash 承载,并执行更优惠的 Flash 计费标准。对于开源社区,深度求索在 Hugging Face 完整开放了模型权重、评估代码与技术白皮书,遵循宽松的 MIT 许可证。15独立评测机构 Artificial Analysis 在 Reasoning (Max Effort) 配置下对该模型进行了首轮实测:V4.1-Flash 取得 Intelligence Index 综合指数 40,平均输出速率达到 214 tokens/s,首 token 响应时间为 1.17 秒,单任务测算成本约为 $0.27。该独立数据说明,该模型在开启高推理强度时依然保持了较高的吞吐速率。3
OpenAI GPT-Image-2.5:Flare 与 Sunburst 分工,多轮编辑一致性落地
OpenAI 于 9 月 8 日上线新一代图像模型体系 ChatGPT Images 2.5,同时向开发者开放两款 API 模型:
gpt-image-2.5-flare 与 gpt-image-2.5-sunburst。官方数据显示,目前全球用户每周通过 ChatGPT 与 API 生成超过 30 亿张图像,本次升级旨在解决工业设计与生产工作流中长期存在的指令漂移、多轮修图失真与生图延迟过高三大痛点。6在核心能力层面,Images 2.5 实现以下突破:
- 生图延迟大幅优化:端到端生成时延相比 Images 2.0 降低达 50%,加快了概念设计的迭代循环;
- 真实人像与主体保真度跃升:模型基于参考照片进行二次创作时,能够高度保留人物面部特征、神态、光影质感与环境固有色;
- 多轮交互编辑一致性:在连续修改指令下,模型精准执行新增、替换或局部微调操作,避免画面无关元素出现变形或画质劣化;
- 复杂图文排版与透明背景支持:模型原生支持生成透明背景图层,并能稳定遵循包含位置、层级和文字排版要求的复杂设计草案。6
在产品功能与接口体系上,OpenAI 将两套模型按生产场景清晰切分:
- GPT-Image-2.5 Flare:作为通用默认模型,主打低延迟与高吞吐,生成速度达到 GPT-Image-2 的 2 至 4 倍,适配社交营销素材、动态创意、商品速览等大批量工作流;
- GPT-Image-2.5 Sunburst:专为高保真专业级创意打造,通过分配更充分的生成推理时间,捕捉更为严苛的材质细节与多轮微调一致性,服务于商业广告与工业级物料制作;
- 在 ChatGPT 消费端与企业端,OpenAI 同步集成 Sketch(草图交互功能,允许用户通过绘制简笔画或线框图直接约束构图)以及海报、文创等常用设计模板。6
根据 OpenAI 开发者文档的计费标准,两款模型的 API 价格保持一致:
- 图像输入(Image Input):每百万 token 计费 $8.00(缓存读取为 $2.00);
- 图像输出(Image Output):每百万 token 计费 $30.00;
- 提示词文本输入(Text Input):每百万 token 计费 $5.00(缓存读取为 $1.25)。9
在公开测评方面,第三方机构 Artificial Analysis 将 Flare 与 Sunburst 接入 Image Arena 竞技场进行盲测:Flare (max) 取得 1186.73 的 Elo 评分,Sunburst (max) 取得 1180.21 分,两款模型包揽了文本生图竞技场、图像编辑竞技场以及多图混合编辑榜的前两名位置。对于依赖图像生成流水线的开发者,双模型架构提供了明确的成本与精度折中路径。78
OpenAI GPT-Live-1:全双工语音进入 API,架构从拼装走向单模型
OpenAI 在 9 月 10 日正式将端到端全双工实时语音基础模型 GPT-Live-1 引入开发者 API。以往智能语音解决方案普遍采用“语音识别(STT)+ 文本大模型(LLM)+ 语音合成(TTS)”的串联级联架构,各环节交接造成严重的端到端延迟,并且极易在用户插话、停顿思考或环境噪音下产生调度冲突。10
GPT-Live-1 在单一模型内部原生统一了听与说的双向音频流处理:
- 实时平滑打断:模型能够实时识别用户的打断信号、犹豫语气和轻声应答,早期应用案例表明,语言教学产品 Speak 引入该模型后,将学员思考停顿期间被系统不当打断的概率降低了近 80%;
- 后台推理与工具委派:GPT-Live-1 专注充当前端高情商、低延迟的语音交互中枢,复杂业务逻辑与深度思考可无缝委派至后端文本大模型(如 GPT-6 Astra 或通用型 Luna),形成“前台敏捷对话、后台深度推理”的协作机制;
- 对话风格精准调控:开发者可通过标准 System Prompt 灵活约束智能体的语气基调、说话节奏与个性特征;
- 环境降噪与电话通信级支持:模型能原生过滤嘈杂环境噪音,并提供对传统电话通信协议(Telephony)的标准对接支持,适用于订座、挂号与电话客服等真实外呼场景。10
在评测基准方面,GPT-Live-1 展现出原生全双工架构的代际优势:在针对全双工交互表现的 Full Duplex Bench 上,其综合得分相比上一代 GPT-Realtime-2.1 跃升了 30 个百分点;在真实语音任务评测 Tau3 中,当搭配 GPT-6 Astra(中等推理强度)运行时夺得总榜第一;在 Artificial Analysis 针对交互时序与打断判定的 Conversational Dynamics 评测中,该模型取得了 97.3% 的高分。10
在调用费率方面,OpenAI 采取模块化计费机制:前端实时语音交互层按每分钟 $0.05(相当于每小时 $3.00)统一定价;语音模型在会话中委派给后端文本模型(如 Astra、Luna、Terra)产生的 token 消耗,按照对应模型各自的标准 API 费率单独计算。这种解耦方式使开发者能够自由平衡交互自然度与后端思考成本。10
本期未纳入条目与覆盖说明
本期追踪严格执行 2026 年 9 月 7 日至 13 日的有效时间窗核验,各主流厂商的筛查结果如下:
- 阿里通义千问(Qwen):本周通过 Qwen 官方博客、GitHub 组织代码库与阿里云百炼模型更新列表核对,官方团队在 9 月 10 日至 11 日仅对
qwen-code客户端与工程工作流执行了日常分支维护与补丁修复,未发布新的基础大模型。上一代 Qwen3.8-Flash-Next(8 月 26 日)与旗舰快照 Qwen3.8-Max(9 月 2 日)已在前期文章中完整覆盖。 - 智谱 GLM、月之暗面 Kimi、MiniMax:本周检索智谱 Z.ai 官方动态、月之暗面开放平台以及 MiniMax 官方发布渠道,均未发现满足“窗口内具备官方原始详情页、明确发布日期及模型级能力升级”的全新发布,因此本期不予收录。
- Google 与 Anthropic:Google 在 9 月 10 日于 Google Labs 推出儿童故事生成应用 Dreambeans,属于上层实验性消费产品,并非底层模型发布;Anthropic 在 9 月 10 日发布了 2026 年 9 月威胁情报分析报告,未更新 Claude 系列模型。两者在 9 月初发布的 Gemini 3.8 Flash 与 Claude Fable 5.1 已在上一期周报详述。
- Meta:Meta 在 9 月 8 日正式推出名为 Muse 的个人 AI 智能体应用,运行于其专有的 Muse Secure VM 环境中。经核验官方新闻稿与技术说明,该产品底层由 9 月 2 日已发布的 Muse Spark 1.3 驱动,不属于全新基础模型架构发布,故不占用本期主条目篇幅。11
面向技术选型的三项行动建议
结合本周发布的三组模型特征,技术与产品团队可在接下来的工程验证中执行三项具体行动:
- 针对长任务智能体,复测 DeepSeek-V4.1-Flash 的缓存命中率与平替稳定性。 提取当前生产环境中最消耗 token 的复杂代码仓库与长指令任务,将模型参数分别配置为
deepseek-flash与deepseek-v4-pro。比对两者的任务成功率、代码缺陷修复准确率,并重点记录在稳定前缀复用下的实际账单。若团队日均调用规模较大,可将非实时批量作业调度至 UTC 10:00 至次日 01:00 的非峰值时段,以利用 $0.003 / MTok 的极低缓存单价。 - 在设计与创意生产线中,建立 Flare 与 Sunburst 的分级生成流。 梳理图像工作流的延迟容忍度与画质要求:将海量素材快速预生成、用户探索界面和实时交互渲染交由低延迟的
gpt-image-2.5-flare承接;将终端高精交付、商品主图精修与需要透明背景的原画生成切换至gpt-image-2.5-sunburst。同时在多轮局部微调场景中,验证输入原图特征的保留度。 - 基于全双工架构重构语音服务,评估 GPT-Live-1 的打断体验与后端算力配比。 搭建基于 WebSocket 或电话通信协议的交互原型,测试在背景人声干扰与用户频繁插话时的响应延迟和听觉顺畅度。设计合理的分工提示词,由 GPT-Live-1 负责问候、确认和短答,仅在涉及知识检索与长程推理时异步调用后端 Astra 或 Luna 模型,避免在高频闲聊中产生不必要的推理溢价。
References
- 1DeepSeek-V4.1-Flash 发布公告
api-docs.deepseek.com
- 2DeepSeek API 更新日志
api-docs.deepseek.com
- 3Artificial Analysis:DeepSeek V4.1 Flash 评测对比
artificialanalysis.ai
- 4DeepSeek API 价格页
api-docs.deepseek.com
- 5DeepSeek-V4.1-Flash Hugging Face 模型库
huggingface.co
- 6OpenAI:推出 ChatGPT Images 2.5
openai.com
- 7Artificial Analysis:GPT Image 2.5 Flare 评测
artificialanalysis.ai
- 8Artificial Analysis:GPT Image 2.5 Sunburst 评测
artificialanalysis.ai
- 9OpenAI API 价格文档
developers.openai.com
- 10OpenAI:GPT-Live-1 登录 API
openai.com
- 11Meta:推出个人 AI 智能体 Muse
about.fb.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.