8月24日-30日大模型发布追踪:Qwen3.8-Flash-Next 与 GLM-5.3-Flash
本期聚焦 8 月 24 日至 30 日发布的 Qwen3.8-Flash-Next 与 GLM-5.3-Flash,比较开放权重、原生多模态、上下文、速度、价格和实际选型测试边界。

一句话判断
本期覆盖窗口是 2026 年 8 月 24 日至 30 日(UTC+08:00)。窗口内值得进入周报的模型级发布有两项:Qwen3.8-Flash-Next 把开放权重、混合注意力和 1M 上下文路线放到同一个模型家族里;GLM-5.3-Flash 则把原生多模态、1M 上下文和面向生产的服务入口放在一起。前者更适合先做本地和高吞吐验证,后者更适合测试视觉任务、长上下文与多轮智能体工作流,最终选择仍要回到自己的任务集和实际账单。
Qwen 官方博客把 Qwen3.8-Flash-Next 标为 2026 年 8 月 26 日发布的多模态 MoE 开放权重模型,也是 Qwen4 架构的早期预览。Z.ai 官方博客同样在 8 月 26 日发布 GLM-5.3-Flash,并将其称为 GLM-5 系列首个原生多模态模型。12
先看价格、状态和边界
| 模型 | 发布类型与日期 | 核心变化 | 官方或记录价格 | 上下文与输出 | 权重与 API | 首先测试什么 |
|---|---|---|---|---|---|---|
| Qwen3.8-Flash-Next / Qwen3.8-Flash | 开放权重模型首次发布;2026-08-26。生产版由 QwenCloud 提供 | GDN + QSA 混合注意力、门控残差、N-gram Embedding | QwenCloud 官方价:输入 $0.15 / 1M tokens,输出 $0.47 / 1M tokens | 开放权重版原生 262,144,可用 YaRN 扩展到 1M;生产版默认 1M,最大输出 131K | Hugging Face、ModelScope 权重已公开;QwenCloud 支持 OpenAI / Anthropic API 协议 | 长代码库、长文档和高并发生成 |
| GLM-5.3-Flash | 模型首次发布;2026-08-26 | 稀疏注意力 + 线性注意力、mHC、原生视觉、多模态预训练 | Z.ai 已打开的官方文档没有列出标准 token 单价;Artificial Analysis 页面记录的 Z.ai API 价格为输入 $0.15 / 1M tokens、输出 $0.50 / 1M tokens | 上下文 1M,最大输出 128K | Hugging Face 权重公开,MIT License;Z.ai 提供 Chat Completion API,并纳入 GLM Coding Plan | 视觉网页复刻、图表理解和工具调用 |
Qwen 的两个名称需要分开看:
Qwen3.8-Flash-Next 是开放权重和架构预览,Qwen3.8-Flash 是 QwenCloud 上的生产版本。GLM-5.3-Flash 的“官方可用”则同时包括公开权重、Z.ai API 和 Coding Plan。价格表中的 Artificial Analysis 数字属于第三方页面对 Z.ai API 的记录,不能替代 Z.ai 官方价目表。345Qwen3.8-Flash-Next:先开放架构,再提供生产版
架构变化落在哪里
Qwen 官方给出的主模型规模是 125B 参数、6B 激活参数,另有 51B N-gram Embedding 和 4B MTP 模块。模型把 Gated DeltaNet(GDN)与 Qwen Sparse Attention(QSA)组合成混合注意力层,并加入 Gated Residual,让残差路径也参与门控。N-gram Embedding 只放在较早的层中,用额外参数处理局部 token 组合;训练阶段则采用 Muon 与 AdamW 的协同优化。16
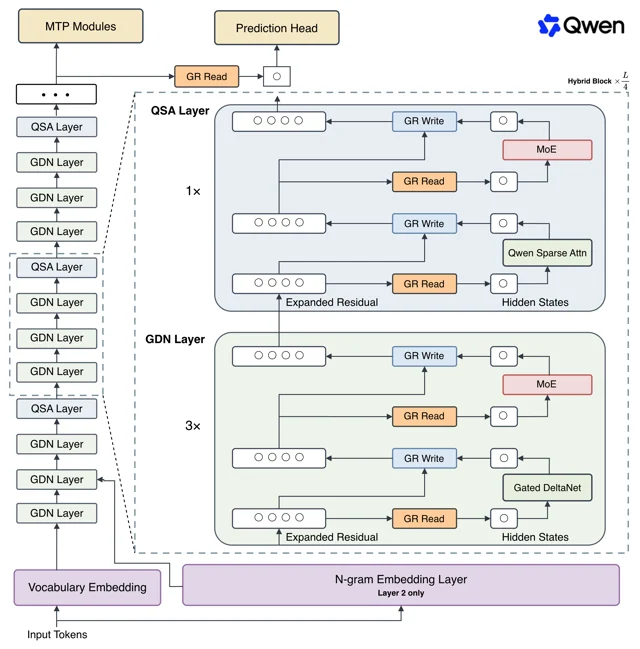
这组设计对选型的直接含义有两个。第一,开放权重版的 262,144 原生上下文与生产版的默认 1M 上下文属于两个部署边界,不能把后者的服务能力自动套到本地权重。第二,6B 激活参数有利于降低单次计算量,但 125B 主模型、51B N-gram Embedding 和部署所需的并行策略仍然会显著影响显存、吞吐与工程复杂度。Qwen 官方仓库给出了 Transformers、llama.cpp、MLX、SGLang、vLLM、TokenSpeed 和 Unsloth 等部署入口,SGLang / vLLM 示例使用 4 路张量并行。7
官方评测给出的能力侧重
Qwen 官方专项评测显示,模型在代码、工具使用和视觉操作任务上都有较高分数:DeepSWE 1.1 为 58.7,SWE-bench Pro 为 62.5,SWE-bench Multilingual 为 81.0,Toolathlon Verified 为 73.5;GPQA Diamond 为 91.7,LiveCodeBench v6 为 91.9。视觉与计算机操作方向,ClawEval-MM Pass@3 为 64.4、平均分 60.4,AndroidWorld 为 84.5,OSWorld 2.0 的 binary / partial 分别为 19.4 / 52.3。1
这些数字属于 Qwen 自报结果,测试设置、提示词、工具环境和采样策略会影响结果。读者可以把它们当作“值得复测的任务清单”:代码库修复优先看 SWE-bench 类任务,工具调用优先看 Toolathlon,桌面操作优先看 OSWorld 和 AndroidWorld。厂商分数需要在自己的工具协议和数据分布下重新测量,不能直接当成跨厂商排名。
QwenCloud 的生产版支持文本、图片和视频输入,输出文本;页面列出 1M 默认上下文、约 991K 最大输入、131K 最大输出、2M TPM 和 15K RPM,并支持 function calling、structured outputs、context cache、batch、web search 与 code interpreter。输入和输出单价分别为每百万 tokens $0.15 与 $0.47,缓存读价为每百万 tokens $0.016。3
GLM-5.3-Flash:把视觉输入放进长上下文服务
模型变化和服务状态
GLM-5.3-Flash 的官方规格是 320B 总参数、18B 激活参数。Z.ai 介绍的结构包括稀疏注意力与线性注意力的混合架构、Manifold-Constrained Hyper-Connections(mHC)和 IndexPool。Z.ai 还称,模型使用 30T token 的多模态预训练语料;相较 GLM-5.3,注意力计算量减少 3.0 倍,KV cache 减少 4.4 倍。2
“原生多模态”对选型的价值在于视觉任务可以与代码、长文档、工具步骤放进同一个调用流程。Z.ai 文档列出图片、视频、文本和文件输入,1M 上下文、128K 最大输出,并支持 streaming、function calling、context caching 和 structured output。文档还给出
reasoning_effort 的 low、high、max 选项,当前默认使用 max;Coding Plan 在非高峰时段和周末按标准点数的 50% 消耗。4Z.ai 的官方博客给出了 Terminal Bench 2.1 84.3、DeepSWE v1.1 63.4、Toolathlon Verified 78.4、AutomationBench 48.8、OfficeQA Pro 62.4、CharXiv Reasoning w/ Tools 89.4、Chartography w/ Tools 78.0、MVBench 77.8 和 MMVU 80.5 等结果。博客还称 GLM-5.3-Flash 在 Z.ai Code Bench v1.0 的 max effort 结果为 29.0,Claude Opus 4.8 为 29.5;这组数字仍然属于厂商公布的专项评测。2
官方博客提到 Artificial Analysis Intelligence Index v4.1.1 得分 57,并将折扣期单任务成本写为 $0.045。这个成本是发布方对评测成本的宣传口径,不能直接理解成标准 API token 价格。已打开的 Z.ai 官方开发文档也没有列出标准 token 价目;Artificial Analysis 页面记录的 Z.ai API 价格为输入 $0.15 / 1M tokens、输出 $0.50 / 1M tokens,读者使用时需要以实际账户和账单为准。245
开放权重方面,Z.ai 的 Hugging Face 模型卡列出 GLM-5.3-Flash 权重及 SGLang、vLLM、TokenSpeed、Transformers、KTransformers 和 Unsloth 支持,许可证为 MIT。实际本地部署仍需要按 320B 总参数、18B 激活参数、并行方式和显存条件做工程评估;“权重公开”描述的是获取状态,不等于低成本部署。8
第三方横向比较:57 对 56,速度与上下文取舍相反
Artificial Analysis 的 v4.1.1 比较页使用 reasoning 版本和自己的 Intelligence Index,给出的结果是:GLM-5.3-Flash 得分 57,Qwen3.8-Flash-Next 得分 56;输出速度约 45 对 87 tokens/s;首 token 延迟约 1.55 秒对 2.58 秒;blended cost per task 为 $0.10 对 $0.09;页面记录的上下文约为 1,000K 对 256K。9
这组独立数据支持一个清晰的测试分工:GLM 在该指数上略高,首 token 更快,上下文窗口更大;Qwen 的输出吞吐更高,页面记录的综合任务成本略低。Qwen 官方规格的原生上下文是 262,144,生产版 QwenCloud 默认 1M,因此 Artificial Analysis 页面记录的约 256K 应看作它对开放权重版的页面标注,不能和 QwenCloud 的 1M 服务规格合并成一个数字。36
Artificial Analysis 的横向指数包含 GDPval-AA v2、Terminal-Bench v2.1、SciCode、Humanity’s Last Exam、GPQA Diamond 等九项任务。它与 Qwen、Z.ai 在各自博客中选择的专项评测不重合,reasoning 设置、工具环境和评分体系也不同。读者可以用它做初筛,不能把 57 / 56 改写成“所有榜单上的总排名”。9
本期未纳入与面向选型的行动
本期没有把 OpenAI、Google、Anthropic、Meta、DeepSeek、月之暗面 Kimi 或 MiniMax 写成新的主条目。已打开的合格详情页没有同时满足“2026 年 8 月 24 日至 30 日内的原始发布时间”和“可说明模型级变化”这两个条件:Anthropic 找到的是 Model Hardware Standard 研究预览,MiniMax 8 月 26 日条目是上半年财务结果,MiniMax Music 3.0 的官方列表日期为 8 月 13 日;Meta 的 Muse Spark 1.2 已在上期覆盖。其余厂商本周检索到的内容主要是产品、公司或服务更新,当前证据不足以纳入模型发布条目。
这份缺口意味着本期是“两款模型的可核验深读”,不代表上述厂商本周没有任何动态。读者若正在做模型选型,可以按下面三组小测试补上自己的证据:
- 长上下文代码库 / 文档。 使用同一份代码库或文档集,分别测试 262,144 原生上下文的 Qwen 开放权重版、QwenCloud 的 1M 服务版和 GLM 的 1M 服务版。记录模型是否找到跨文件依赖、引用是否准确、总输出 tokens、首 token 延迟和完整任务耗时;长上下文可用上限与实际有效检索范围需要分开记录。
- 视觉网页与图表。 固定网页截图、图表和问题,要求模型先复述页面结构,再提取数值,最后生成可执行的修改步骤。GLM 重点观察视频、图片、文件和文本混合输入能否保持上下文一致;QwenCloud 重点观察图片 / 视频输入、structured output 和工具调用能否稳定串联。
- 多轮工具调用。 固定工具清单和最大轮数,让两个模型完成同一项检索、代码修改或浏览器操作任务。记录失败重试次数、每轮首 token、输入和输出 tokens、总耗时、工具参数错误以及最终成本。这个记录比单一榜单分数更接近真实生产账单。
References
- 1Qwen3.8-Flash-Next
qwen.ai
- 2GLM-5.3-Flash
z.ai
- 3Qwen3.8-Flash 模型页
qwencloud.com
- 4GLM-5.3-Flash 官方开发文档
docs.z.ai
- 5GLM-5.3-Flash Artificial Analysis 模型页
artificialanalysis.ai
- 6Qwen3.8-Flash-Next 官方模型卡
huggingface.co
- 7Qwen3.8-Flash-Next GitHub 仓库
github.com
- 8GLM-5.3-Flash 官方模型卡
huggingface.co
- 9GLM-5.3-Flash 与 Qwen3.8-Flash-Next 比较
artificialanalysis.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.