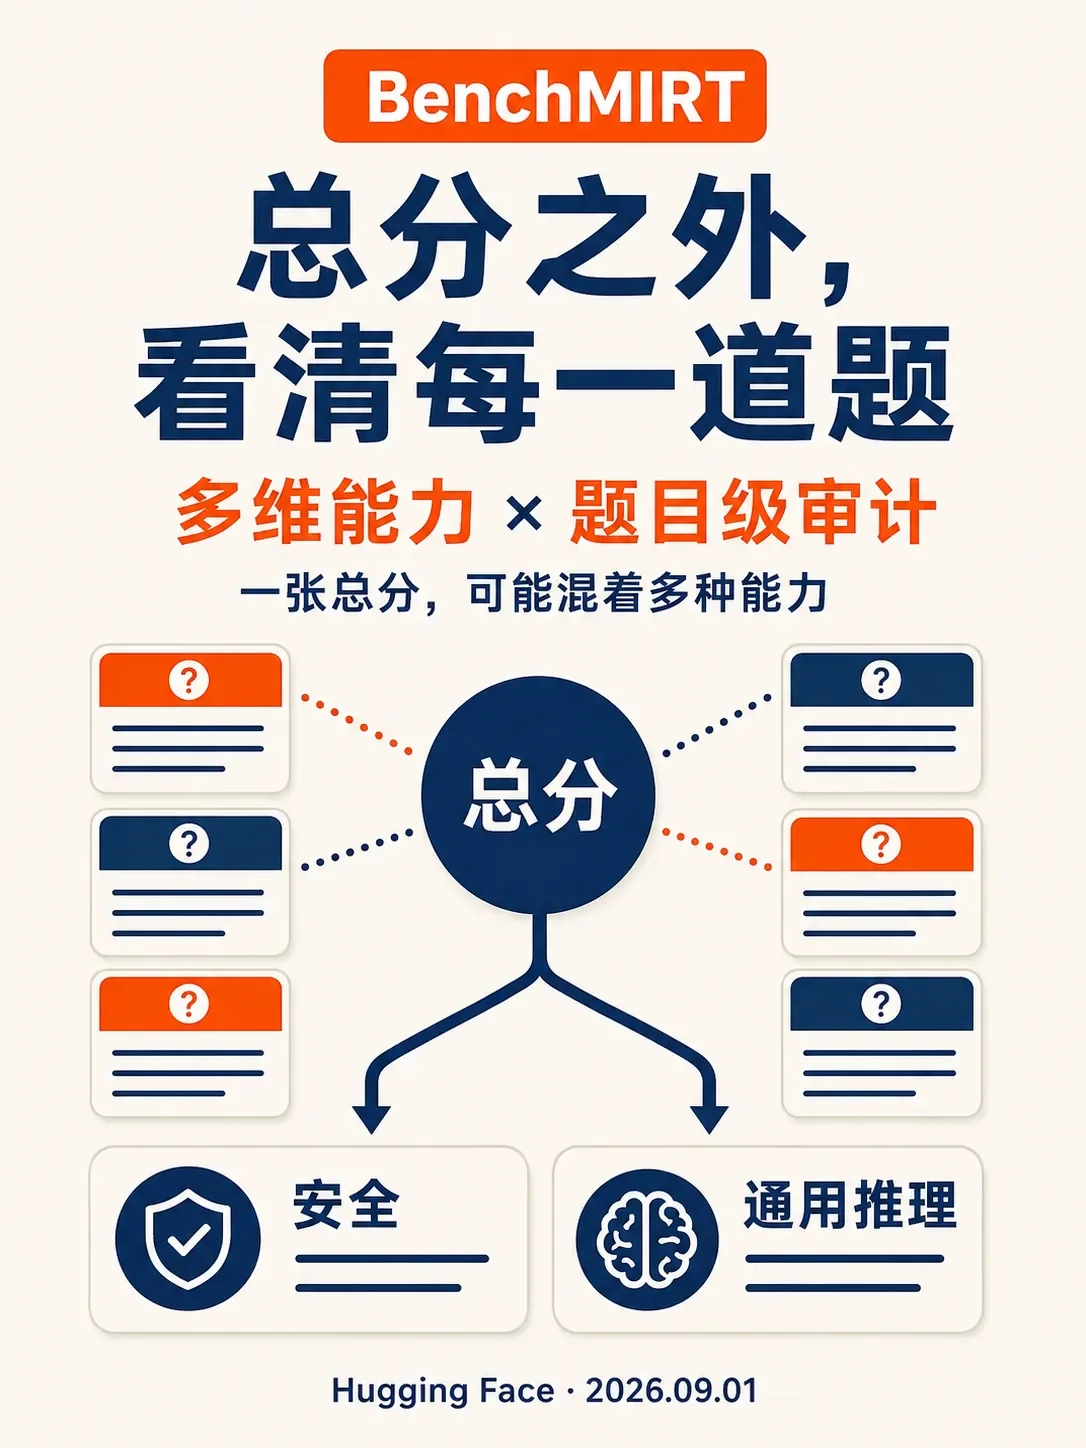

一项基准测试的平均分,告诉你模型整体答得怎样,却很难告诉你每道题究竟测到了什么。BenchMIRT 借鉴多维项目反应理论(MIRT),同时估计模型在潜在能力维度上的强弱,以及题目的难度和区分度。
作者用 100 个 LLM、16 个基准测试、超过 3.4 万道题做分析,重复建模仍得到“安全”和“通用推理”两条主维度。结果里,BBQ 更贴近通用推理,WMDP 与通用推理反向,HarmBench 主要贴近安全。
工程上可以先保留逐题结果,再用开源代码和公开数据查看哪些题目真正提供信息。筛题能提升效率,也要保留人工复核,因为题目级分析同样可能被用来删掉关键安全题。
References
- 1BenchMIRT:What are LLM benchmarks actually measuring?
huggingface.co
- 2BenchMIRT 开源代码
github.com
- 3BenchMIRT 数据集合
huggingface.co
Comments