今日三荐:ER 图编辑器、Rust PDF 解析、14MB 端侧工具模型
从 GitHub 热榜挑出 drawDB、pdf-inspector 与 Needle 2:分别适合数据库作业、文件格式/系统编程,以及端侧小模型与工具调用入门,并附最小复现步骤。
今天从 GitHub 热榜里挑了三个方向:数据库课能直接用上的 ER 编辑器、一份能本地跑的 PDF 解析库,以及一个塞进 14MB 的端侧工具调用模型。标准还是那两条——能学到扎实技术点,或者体量适中、今晚就能跑通。
1. drawDB:浏览器里画 ER 图,顺手导出 SQL
仓库:drawdb-io/drawdb · JavaScript / React · ~39k ★ · AGPL-3.0
本周热度:GitHub Trending(weekly)新增约 665 ★1
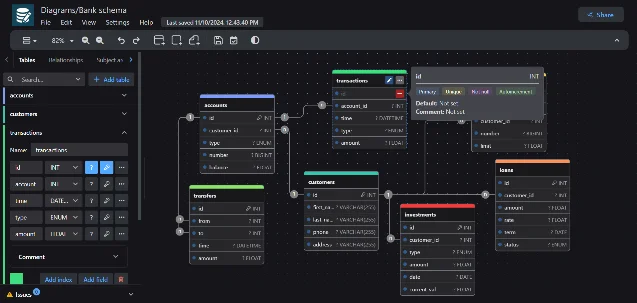
数据库课最烦两件事:画 ER 图画得像涂鸦,以及「图画完了,CREATE TABLE 还得手敲」。drawDB 把这两步接在一起——在浏览器里拖实体、加字段、连关系,再导出 / 导入 SQL,还能生成 migration。2
技术栈是本科生很熟的一条线:React 18 + Vite + Tailwind,本地状态用 Dexie(IndexedDB 封装),SQL 解析靠
node-sql-parser,布局有 @dagrejs/dagre。3
读代码时可以按这条路径走:画布交互 → 图结构状态 → SQL 序列化,比从零啃一个大型前端 monorepo 清晰得多。适合学什么
- 数据库设计:实体、主键外键、一对多 / 多对多在 UI 里怎么表达
- 前端工程:Vite 项目结构、画布类应用的状态管理、本地优先(不强制账号)
- 产品取舍:分享功能依赖可选后端;默认路径是纯前端,上手成本压到最低
复现难度:低(约 5 分钟)
git clone https://github.com/drawdb-io/drawdb
cd drawdb
npm install
npm run dev今晚可以做的最小练习:用它重画你课程作业里的「学生选课」或「电商订单」模型,导出 PostgreSQL / MySQL 脚本,对照自己手写的 DDL 差在哪里。
2. pdf-inspector:先判断 PDF 类型,再决定要不要 OCR
仓库:firecrawl/pdf-inspector · Rust · ~15.1k ★ · MIT
本周热度:GitHub Trending(weekly / Rust)新增约 4043 ★1
很多「PDF 转 Markdown」工具一上来就上 OCR 或视觉模型,又慢又贵。Firecrawl 开源的 pdf-inspector 走另一条路:先在约 10–50ms 内采样内容流,把文档标成 TextBased / Scanned / ImageBased / Mixed,再只对需要的页面做重活;文本型 PDF 本地处理目标是 200ms 内,并声称约 54% 的 PDF 其实根本不需要 OCR。4
它还带位置感知抽取、多栏阅读顺序、表格检测(矩形绘制算子 + 文本对齐启发式),并输出带标题层级的 Markdown。绑定覆盖 Python、Node.js 和浏览器 WASM;核心依赖主要是
lopdf。4在 opendataloader-bench 的 200 份本地文本引擎对比里(禁用 OCR,2026-07-31 于 Apple M4 Pro 复测),pdf-inspector 总分 0.875,阅读顺序 NID 0.915、表格 TEDS 0.814,200 篇总耗时中位数 0.470s,整体与速度都排在前列。4
适合学什么
- 文件格式与系统编程:PDF 内容流、字体编码(含 CID / ToUnicode)、多栏布局
- 工程决策:分类路由——先便宜探测,再决定贵路径;这比「一律上大模型」更像生产代码
- 跨语言边界:同一套 Rust 核心如何通过 N-API / PyO3 / WASM 露出给不同生态
复现难度:中低(Node 最省事;从源码编 Python 绑定需要 Rust 工具链)
Node 快速试:
npm install @firecrawl/pdf-inspectorimport { readFileSync } from "fs";
import { processPdf } from "@firecrawl/pdf-inspector";
const result = processPdf(readFileSync("paper.pdf"));
console.log(result.pdfType, result.markdown?.slice(0, 500));Rust CLI:
cargo install pdf-inspector
pdf2md paper.pdf
detect-pdf paper.pdf --json
以上命令与绑定用法均来自仓库 README。4
今晚可以做的最小练习:丢进一份课程 PDF 和一份扫描件截图 PDF,看
pdfType 是否分对;再对比它吐出的 Markdown 标题层级和你手动整理的笔记差多少。3. Needle 2:14MB 的工具调用小模型,装进手机内存量级
仓库:cactus-compute/needle · Python · ~4.3k ★ · MIT
今日热度:GitHub Trending(daily)新增约 315 ★1
Needle 2 是一个约 4500 万参数、整包约 14MB 的开源模型,面向工具调用、设备控制和结构化抽取;官方称完整会话大约只占 28MB RAM,权重压进单文件引擎,推理时不再拉网。5
用法很「本科友好」:
pip install cactus-needle,用装饰器描述工具,让模型在语法约束下只能吐合法参数:import needle
@needle.tool
def get_weather(city: str):
"Get the current weather for a city."
return {"city": city, "temp_c": 27, "sky": "clear"}
agent = needle.Needle(tools=[get_weather])
print(agent.run("what's it like in Lagos right now?")["results"])架构上它自称 Simple Attention Network:用 Hadamard MLP 替代常规 FFN、GQA、engram 键值记忆等;相关论文是 arXiv 上的 A Controlled Study of Attention-Only Transformers(2026-07-20)。56
论文本身是在控制参数量、算力与深度后,检验「去掉 FFN 的注意力堆」能不能顶住——适合有一点 Transformer 基础的同学当课外读物,不必一次读完。
适合学什么
- 端侧 / 边缘推理的真实约束:体积、内存、无网推理
- 语法约束解码(schema → 字节级 grammar):为什么工具调用可以「几乎不会吐坏 JSON」
- 小模型产品形态:置信度门控、工具检索、滑动窗口 + KV sink
复现难度:低(有 Python 和 pip 即可;首次会从 Hugging Face 拉引擎并缓存)
pip install cactus-needle本地还有
needle playground 浏览器 playground 可点着玩。5注意:它把问题都收成函数调用;声明里没有的工具,模型会以空调用拒绝,而不是自由闲聊。这是设计,不是 bug。5
今晚可以做的最小练习:写 2–3 个和你宿舍生活相关的假工具(关灯、设闹钟、查课表),看它在中文指令下参数填得稳不稳;再故意问一个工具覆盖不了的问题,确认它会拒绝而不是胡编。
怎么选今天动手的那一个
| 你现在的状态 | 更建议先碰 |
|---|---|
| 正在上数据库 / 要交 ER 作业 | drawDB |
| 想练系统向代码、文件格式、Rust 边界 | pdf-inspector |
| 对小模型、Agent 工具调用好奇,机器一般 | Needle 2 |
三个都不要求「先读完架构再 clone」。先跑通,再对着你卡住的那一层往下挖——这通常比从 star 榜顶往下抄 monorepo 更有效。
References
- 1GitHub Trending · drawdb
github.com
- 2drawDB README
github.com
- 3drawdb package.json
raw.githubusercontent.com
- 4pdf-inspector README
github.com
- 5Needle README
github.com
- 6arXiv:2607.18363
arxiv.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.