《AlphaFold》:一条序列定出 0.96 Å 的坐标,答案藏在比对表与三角形里
从实验测结构的速度跟不上测序讲起,拆开 AlphaFold 的 MSA 与配对表示、Evoformer 的三角形更新、结构模块与 FAPE 损失,讲清每一步在算什么,并用 CASP14 与 PDB 新链两套数据读懂 0.96 Å 这个成绩量的是谁。

2021 年 7 月 15 日,Nature 刊出一篇 7 页的论文,标题是《Highly accurate protein structure prediction with AlphaFold》。1
署名 34 位作者,其中 33 位来自 DeepMind,Martin Steinegger 来自首尔大学。1
John Jumper 与 Demis Hassabis 通讯;Jumper、Richard Evans、Alexander Pritzel、Tim Green、Michael Figurnov 五人同等贡献。1
稿件 5 月 11 日收到,7 月 12 日接收,7 月 15 日上线。1
2020 年 5 月到 7 月的 CASP14 盲测里,这个系统在 87 个靶域上给出中位 0.96 Å 的主链误差,第二名是 2.8 Å。1
尺子可以这样比:一个碳原子的宽度约 1.4 Å。1
到 2026 年 11 月 3 日,OpenAlex 给这篇论文记到 43,764 次引用。2
这篇要回答的问题,一句话:一条由 20 种字母写成的序列,凭什么能定出一个三维形状。
五十年没解的那一步
蛋白的形状决定它做什么:酶要卡住底物,抗体要认出抗原,通道要开合。1
实验能测:到现在,大约 10 万个不同蛋白的结构已经被解出。1
可已知的序列有数十亿条,测一个结构要几个月到几年。1
预测这条路走了五十多年,留下两种思路。1
一种是物理:把分子间的作用力写进热力学或动力学模拟,或者写进统计近似。1
一种是进化:从同源序列里找约束,包括比对、已知的同源结构、成对出现的进化关联。1
物理路线在中等大小的蛋白上就很难算动,蛋白的稳定性又依赖环境。1
进化路线靠三样东西长大:PDB 里逐年增加的实验结构、爆炸的测序数据、能读这些关联的深度学习。1
论文对两条路线的判语很短:没有近缘同源结构可借时,两者的预测都离实验精度很远。1
旧的流水线长这样:先把进化耦合的「图像」转成距离矩阵的「图像」,再把这些距离预测塞进一个启发式系统,由它拼出三维坐标。1
误差出在拼这一步:前面预测的是连续的距离,后面拼接是一串离散决策,梯度回不到预测距离的那一层。
AlphaFold 改的是这个接口:坐标本身成为网络的输出,误差从坐标一路回传到表示。
先看答案长什么样
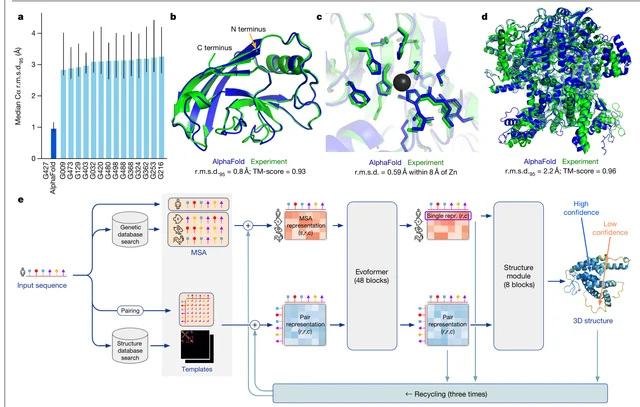
a 栏的读法:深蓝柱停在 1 Å 附近,浅蓝柱连成一片,落在 2.8 到 3.2 Å 之间,误差棒往上伸到 4 Å 以上。3
纵轴叫 rmsd95:先把两条结构叠合,丢掉对齐最差的 5% 残基,剩下那些算 Cα 的均方根偏差。3
这个裁剪意味着:最难的 5% 允许失手,量的是主体部分对得多准。
b、c、d 三栏给的是三档难度:一个普通结构域、一个要求侧链站对位置的金属位点、一条两千多残基的链还要把域摆对。3
一条序列被展开成两摞数
网络的输入不止序列。3
第一摞叫 MSA:把同一蛋白在不同物种里的同源序列按位对齐,排成一张表,行是一条序列,列是一个残基位置。3
论文里记作 s×r,s 是同源序列条数,r 是这条链的残基个数。3
MSA 之所以有用,在于共变。3
两个位置若在进化中总是成对地变,多半因为它们在三维上贴得近:一个位置换了氨基酸,紧邻的那个也得跟着换,结构才不会被撑坏。3
接触位置上的成对变化会在比对表里累积成可见的信号,网络要学的是把它读出来。3
序列从哪里来:UniRef90 v.2020_01、BFD、Uniclust30 v.2018_08、MGnify v.2018_12。4
这两个宏基因组库的分量可以量出来:去掉 BFD,CASP14 平均掉 0.4 GDT;去掉 MGnify 掉 0.7;两个都去掉,掉 6.1。3
第二摞叫配对表示:一个 r×r 的方阵,第 (i,j) 格描述残基 i 与残基 j 的关系。3
还有模板:从 PDB 里找同源结构,作为额外输入。3
三摞表示的宽度不一样:MSA 轨道每个位置 256 维,配对轨道 128 维,单序列轨道 384 维。4
两块表示怎样互相改
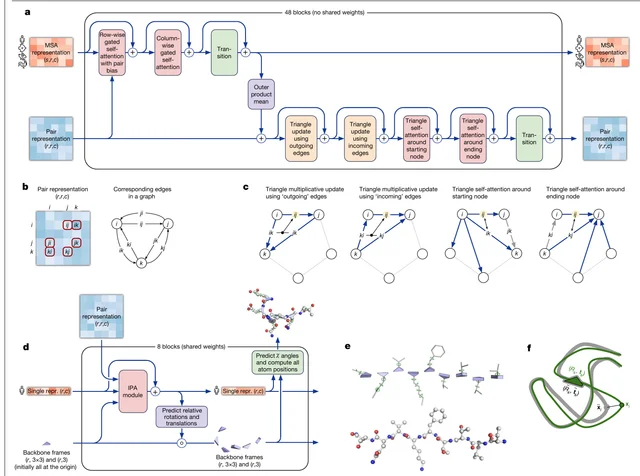
一个 Evoformer 块里十步,顺序固定。4
前三步都在 MSA 上:行注意力、列注意力、一层前馈。行注意力让一条序列内部的位置互相看,列注意力让同一列上不同物种的残基互相看。4
第四步的外积均值,负责把 MSA 里的信息压进配对表示:
两个向量做外积得到一个矩阵,把 s 条序列的外积加起来取平均,压成一条向量,线性层把它写回第 (i,j) 格。4
在算什么:把「哪些序列在 i 位置是什么、在 j 位置是什么」这本账,折算成「i 与 j 之间是什么关系」。4
后面六步都在配对表示上做,围绕三角形。3
理由论文写得很清楚:一份能拼成三维结构的成对描述,必须满足一堆约束,其中最直接的是距离的三角不等式。3
三角乘法更新拿三角形的另外两条边,补上缺的那一条:
在算什么:对每个 ,把边 i→k 与边 j→k 的表示逐元素乘起来再求和。凡是有第三个点参与的三角形,都向 ij 这条边投一票。4
三角注意力做另一件事:把注意力限制在同一行或同一列,再给缺的那条边加一个 logit 偏置。3
两种更新各留两个版本,因为方向不同:outgoing 与 incoming 数的是不同的两条边,起点与终点对应同一行与同一列。3
论文自己说,只用注意力或只用乘法更新,都能训出高精度模型;两种一起用,更准。3
每个残基一个刚体框架
主干跑完,结构模块接手。3
这个表示论文叫 residue gas,直译是一团各自飘着的残基。3
八个块,权重共享。3
块里的核心叫 IPA,不变点注意力。4
常规注意力只用向量算 query 与 key;IPA 给每个残基再配一组 3D 点,点在它自己的局部坐标系里生成,打分时先变换到全局,再比距离:4
三样东西相加:向量内积、配对表示给的偏置 、变换后两组 3D 点的距离平方。4
12 个头,每头 4 个 query 点、8 个 value 点。4
在算什么:距离项给注意力一个空间上的局部性,空间里离得近的残基更容易互相看。3
等变性是算出来的结果。整段打分随全局旋转平移一起变,差值保持不变,输出因此对整体的旋转平移不敏感。4
有一处取舍值得记:网络在前向时并不强制肽键的几何。3
链因此可以被剪断,任意一段都能独立微调,不必去解闭环那个难题。3
肽键的合法性交给微调时的 violation 损失,最后由 Amber 力场做一次梯度下降的松弛,把残留的立体化学瑕疵抹掉。3
这次松弛不改 GDT,也不改 lDDT-Cα,改的是化学上说得通说不通。3
侧链靠预测每个残基的 角,再按框架算出所有重原子的坐标。3
损失:在每个残基自己的坐标系里比原子
监督信号叫 FAPE,逐帧对齐的点误差。4
第一步,把预测原子换到第 个残基的局部坐标系,真值原子换到对应的真值坐标系:
第二步,量这两点的距离;第三步,对所有框架与原子取平均:
Å 把长度换成无量纲的数, Å 截断, Ų 让梯度在小误差处也稳定。4
为什么按帧:全局叠合会把误差摊平,两个形状大致对上就能拿低分;按帧比,等于要求每个残基站在自己邻居的坐标系里也对。3
手性就是从这里来的。局部框架由 N、Cα、C 三个原子用叉积构造,镜像会让叉积反向,镜像结构在这个损失下拿不到零误差。4
另外几路监督同时开着:距离分布(distogram)的交叉熵、MSA 掩码重建的 BERT 式损失、每残基 lDDT-Cα 的分箱预测、侧链 角损失、微调时的 violation 损失。3
总损失写成一行:
微调时再加 0.01 的实验解析损失与 1.0 的 violation 损失。4
权重读得出优先级:MSA 掩码这一项的 2.0,比结构之外的其他项都高。4
它在算什么:让表示去学「这一列在不同物种里为什么长这样」,把无标注序列里的进化关系吃进来。3
同一个网络跑四遍
回收的做法很朴素:把上一次的输出(表示的均值与坐标)当作这一次的额外输入,网络权重完全不动。4
,一共跑四遍。4
训练时不展开四遍:每一批随机取 ,只对第 次的输出算损失,前面几次截断梯度。4
这样做的账:展开四遍的显存与算力付不起,随机采样给出的是平均损失的无偏估计。4
中间结构可以拿出来看。48 个块,每个块后面临时接一个结构模块读一次,四轮回收乘起来,得到 192 个中间结构。3
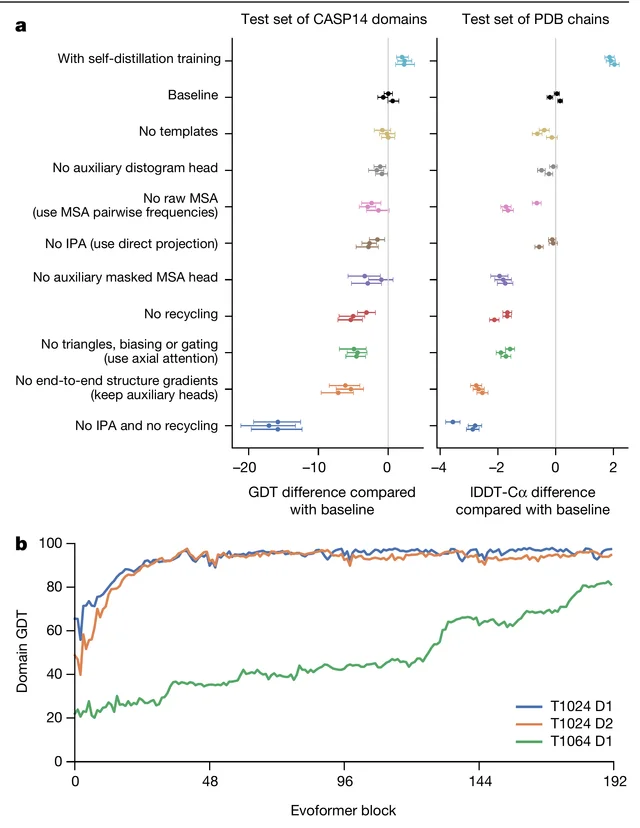
b 栏值得细看。T1024 的两个域在头几十个块就爬到 90 以上,之后基本平稳。3
T1064 那个域从 20 分一路摸索,四十多分处卡了很久,要到 144 个块以后才重新往上走。3
同一个网络,对不同难度的靶标用的是不同的深度。3
训练账
训练集是 PDB 里发布日期不晚于 2018 年 4 月 30 日的结构。3
按 40% 同一性聚类,按簇大小反比采样,随机裁到 256 个残基,batch 128。3
算力是 128 个 TPU v3 核,一个核一条样本。3
训到收敛大约 1000 万条样本,用掉约一周;再用 384 残基的长裁剪微调四天。3
还有一份不来自实验的数据。先用训好的模型给 Uniclust30 里 355,993 条序列预测结构,挑高置信的做数据集,再用 75% 这份预测集加 25% PDB,重新训一个同架构的模型。4
这一步叫自蒸馏。3
为什么要它:PDB 里只有十万量级的实验结构,已知序列有数十亿条;把预测结果当带噪声的标签,等于用无标注数据把训练集撑大了。3
最后训五个不同随机种子的模型,有的带模板有的不带;推断时五个都跑,按置信度挑一个。3
代价:带集成时,256 残基 4.8 分钟、384 残基 9.2 分钟、2500 残基 18 小时,单张 V100。3
关掉集成快 8 倍,精度几乎不变。3
结果怎么读
读数字之前先认清四把尺子,它们刻度不同。3
GDT 是 CASP 的评分:在一串距离阈值下各算一次能对齐的残基比例,取平均,0 到 100。3
lDDT 不用叠合,直接比局部原子对的距离差,0 到 100;只看 Cα 的叫 lDDT-Cα。5
TM-score 量全链叠合,0 到 1。3
rmsd95 的单位是 Å,越小越好,允许裁掉最差的 5%。3
CASP14 那一栏用 GDT,PDB 新链那一栏用 lDDT-Cα,两个刻度不能横比。3
第二套检验更贴近日常使用:拿训练截止日之后进 PDB 的 10,795 条链来测。3
全链的中位 rmsd95 是 1.46 Å;把有近缘模板的链剔掉,剩 3,144 条。3
0.96 Å 与 1.46 Å 的差别要交代:前者逐域、裁 5%,后者全链、不裁;域的摆放一旦出错,整条链都跟着受累。3
置信度是这套系统最实用的输出。3
pLDDT 是模型自己预测的每残基 lDDT-Cα:网络把单序列表示投到 50 个箱(每箱 2 个单位),取分布的期望当分数。4
它准到什么程度?在 10,795 条链上做线性拟合,,Pearson 。3
斜率接近 1,截距略负:平均上自报得偏高一点点; 说明还有约四成方差没被解释,落到某一条链上,别把 pLDDT 当真值。3
pTM 管另一件事:,。3
两个都要的原因:pLDDT 是局部量,链很长时「每一段都对、整体摆错」照样能拿高分;pTM 量的是整体叠合。4
侧链:主链准的时候侧链也准,lDDT-Cα 上到 90 以上, 旋转异构体的正确率接近 0.9。3
消融怎么读
往下按跌落排:去掉端到端结构梯度约 −9,去掉三角形、偏置与门约 −8,去掉回收约 −7,去掉 MSA 掩码损失约 −6。3
这几个数是从横轴读的。3
最上面一行是完整模型加自蒸馏,往右偏约 2 个 GDT。3
最下面一行掉得最狠,约 −17:IPA 与回收一起拿掉。3
两处反常要停下来看一会儿。4
第一处:单独去掉 IPA 只掉很少,在 PDB 那一栏几乎贴着零。3
论文把 IPA 说成一种等变注意力;消融却显示,单独去掉它几乎看不出影响。4
第二处:单独去掉 distogram 这个辅助输出,只掉约 2 个 GDT。3
论文的解释是:这个辅助输出砍掉,结构精度基本还在。4
补充材料自己写了两条限制:做消融时没有重新调超参,跌幅可能被放大;组件之间是非线性交互,两项一起去掉的跌幅会大于两项单摘之和。4
所以这张表能给的是「这套组合里哪些部件在出力」,给不了「每个部件各自值多少分」。4
它自己承认的边界
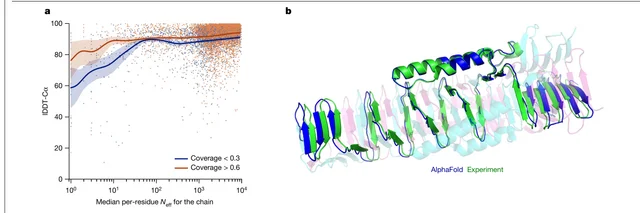
a 栏有一个明显的拐点:中位有效深度低于三十条上下,精度掉得很快;超过一百条之后,再加序列收益很小。3
论文的解释是:MSA 主要在早期把大致形状找对,后面精修到高精度不太靠它。3
第二类失败在链外:链内接触少、与别的链接触多的蛋白,也就是复合物里的桥接域,明显更差。3
反过来,同源多聚体即使链缠成一团,也常能预测对;b 栏那个三聚体就是例子。3
论文的评测都拿单一真值结构比,网络输出的是一套坐标、一组 角。3
配体与核酸不在这一版的范围里,复合物留给后续系统。3
训练集截止 2018 年 4 月 30 日,这个日期同时是评测的边界:之后进 PDB 的链才算真正没见过的。3
后来换掉了哪一格
同一套模型铺到整个蛋白质组,是 Tunyasuvunakool 等人 2021 年那篇伴生论文做的,发表在同期 Nature。7
开放访问的 AlphaFold 蛋白质结构数据库现在给出两亿条以上的预测结构,含人蛋白组与 47 个关键物种。8
同期另一条路线是 RoseTTAFold:Baek 等人 2021 年发表在 Science,用三轨网络同时处理序列、残基对与三维坐标。9
MSA 这一格后来被拆过:ESMFold 用单序列语言模型替代比对,Lin 等人 2023 年发表在 Science。10
「只做蛋白链」这一格也换掉了:AlphaFold 3 把蛋白、核酸与小分子放进同一个模型,Abramson 等人 2024 年发表在 Nature。11
这几项工作按「换掉哪一格」排成一列,比按时间排好记:表示、几何先验、监督位置、输入依赖。
一个名字要拆开:CASP13 那个 AlphaFold 是另一套系统,用深度网络预测距离分布再接 Rosetta 式拼接,Senior 等人 2020 年发表在 Nature。12
这篇论文自己写明,CASP14 参赛的是完全不同的模型。3
读完留下的判断维度
一,看表示。两摞还是三摞,各自装什么,宽度多少;这决定了网络能问出什么样的问题。3
二,看几何先验写在哪。三角形写成更新规则、框架写成输出层、等变写成注意力里的距离项;位置不同,可解释性也不同。3
三,看监督落在哪。坐标级、距离级、还是分布级;FAPE 落在坐标级,所以梯度能一路回到表示。4
四,看指标口径。GDT、lDDT、TM、rmsd95,四个刻度混着报的时候,先问清哪个是哪个。3
想自己验一遍,最短的路径是这样。13
挑一个一百到三百残基的单域蛋白,先查它的 MSA 深度,低于三十条就该先怀疑精度。3
跑完看 pLDDT 上色,蓝色段落可以信,橙黄段落多半是柔性区。4
再把预测与实验结构按域叠合算一次 rmsd95,并关掉回收跑一遍,比较两者在中间块上的差别;这一步能把「回收在补什么」看得很具体。3
References
- 1Nature 原论文页面,2021-07-15
doi.org
- 2OpenAlex 作品记录 W3177828909,2026-11-03 查询
openalex.org
- 3原论文 Figure 1 及其图注
nature.com
- 4补充材料 1.2 数据来源
static-content.springer.com
- 5
- 6
- 7
- 8AlphaFold Protein Structure Database
alphafold.ebi.ac.uk
- 9
- 10
- 11
- 12
- 13官方代码 google-deepmind/alphafold
github.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.