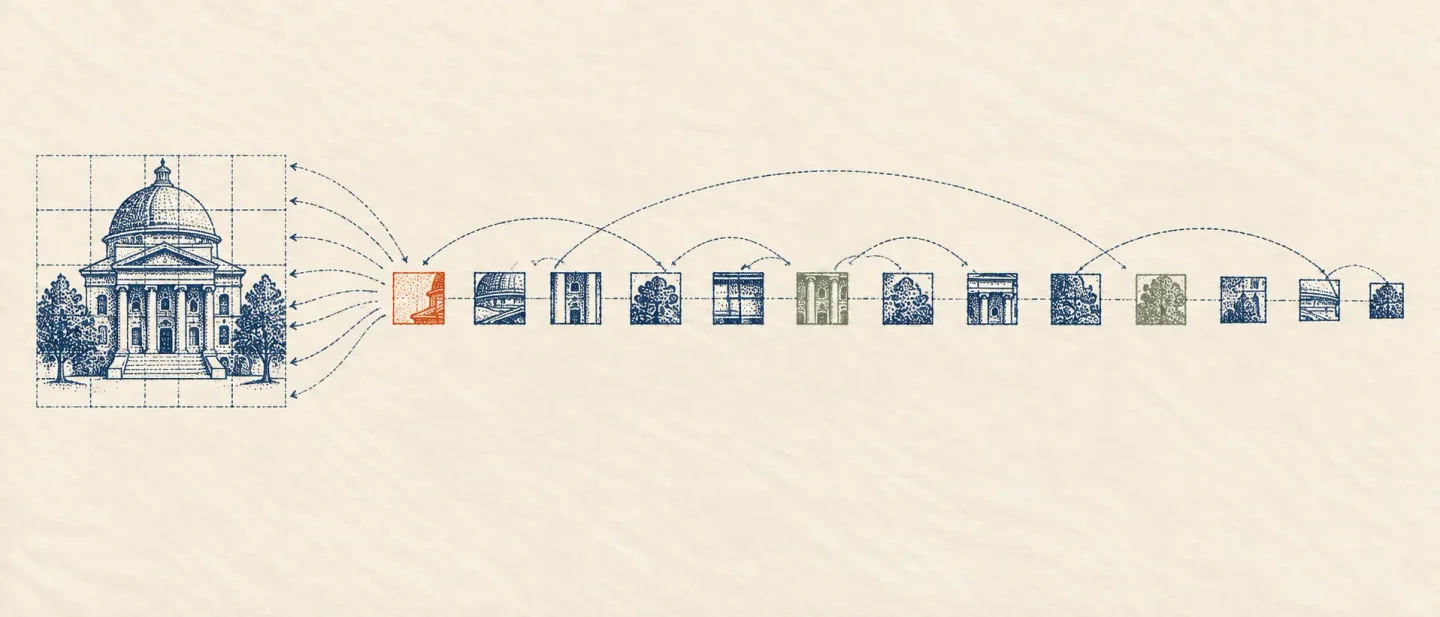
《ViT》:把图像读成一串词,数据规模如何换掉卷积的先验
从把图像切成 16×16 的方块讲起,拆解 ViT 的块嵌入、[class] 标记与位置嵌入,讲清全局注意力为什么需要更多数据才能补上卷积的先验,并用原论文的表与后续的 DeiT、Swin、MAE、CLIP、ConvNeXt 读懂它的能力、代价与边界。

2020 年 10 月 22 日,Google Research Brain Team 的 Alexey Dosovitskiy 与另外 11 位作者把《An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale》挂上 arXiv,编号 arXiv:2010.11929。论文在 2021 年 6 月 3 日完成最后一次修订,以会议论文的形式发表在 ICLR 2021。1
Transformer 在自然语言处理里已经是标准件。2017 年提出之后,BERT 那条「在大语料上预训练、再到具体任务上微调」的路线成了主流做法,模型规模一路涨到千亿参数。视觉这边的情况正好相反:图像识别的主力一直是卷积网络,从 LeNet 到 ResNet 都是。2
想把注意力用进图像的尝试并不少。它们要么把注意力块挂在卷积网络旁边,要么换成一种特殊的稀疏注意力模式;后一种在理论上是省算力的,却很难在现代加速器上跑快。所以在大规模图像识别里,仍然是 ResNet 一类的结构拿着最好的成绩。2
这篇论文要回答的问题很短:一个标准 Transformer,能不能只做最少的改动,直接拿来处理图像?
它给出的答案是能,而且交出一张很整齐的成绩单。在 3.03 亿张图的 JFT-300M 上预训练之后,最大的 ViT-H/14 在 ImageNet 上准确率 88.55%,在 19 项任务的 VTAB 基准上 77.63%;同一张表里,用同样数据集预训练的 ResNet 基线 BiT-L 是 87.54%,VTAB 上 76.29%。2
代价写在另一头。如果只在 ImageNet 那 130 万张图上训练,同一族模型会输给规模相当的 ResNet。论文把原因说得很直白:Transformer 缺少卷积网络自带的一些归纳偏置,数据不够时学不到该学的东西。它随后给出全文的核心判断——规模够大的训练可以压倒归纳偏置。2
「归纳偏置」这个词指的是模型结构自带、不用从数据里学的假设。卷积网络自带两条:互相影响的像素局限在邻域内(局部性),同一组卷积核在图像的任何位置含义相同(平移等变性)。这两条假设正好接近自然图像的统计规律,所以卷积网络在小数据上也能较快学到东西。ViT 把这两条几乎全部去掉,改成让模型自己在数据里学。
另外两个词先交代清楚。[class] 标记是加在序列最前面的一个可学习向量,编码器的输出里它那一位被当作整张图的表示,分类头就接在它上面;这个做法借自 BERT。位置嵌入是加到每块图像表示上的向量,用来告诉模型这一块落在图的哪个位置。
图像怎么变成一句话
标准 Transformer 收进来的是一串一维的词向量。图像是二维的,ViT 要做的第一件事就是把二维网格摊平成一串。
做法是把 224×224 的图像切成固定大小的小方块。默认边长取 16 像素,于是每张图得到 14×14=196 块。每一块拉平成一个 16×16×3=768 维的向量,再乘一个可学的投影矩阵压到模型的隐藏维度 D。这一步的输出叫图像块嵌入(patch embedding)。196 个块换来 196 个向量,这就是序列长度。
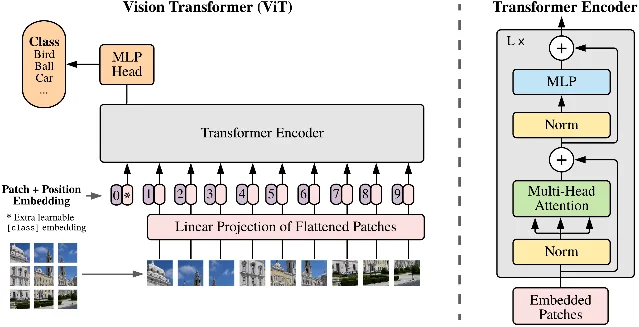
序列的开头还要补一个专门用来做分类的向量,也就是上面说的 [class] 标记。加上它之后,序列长度是 197。所有 197 个向量再加上位置嵌入,才送进编码器。
这里有三处值得停一下。
第一处是权重共享的去留。ViT 取消的是「局部感受野」和「位置无关的卷积核」,但投影矩阵 E 对每一块都用同一个——这条共享保留了。位置嵌入则是逐位置各自学的,197 个位置各有自己的向量。
第二处是投影在做什么。把 16×16×3 的块压到 D 维,本质上是在为「每个小方块里长什么样」找一组基。第 4.5 节把学到的投影核做主成分分析,得到的图像接近一组描述方块内部细结构的基函数。
第三处是位置嵌入为什么用一维。位置嵌入本来可以写成二维的(行一个、列一个),也可以写成相对位置。论文试了这几种,发现几乎没有差别,于是用了最简单的一维可学习版本。2 作者给的推测是:输入是块级的,二维分辨率本来就只有 14×14,比像素级的 224×224 小得多,怎么编码空间关系都差不多容易。
论文还交代了一条容易被忽略的性质。图像块之间的二维关系,只在这个模型的两个地方被手工写进去:开头切块的时候,以及微调换分辨率的时候。除此之外,位置嵌入在初始化时不含任何二维位置信息,块与块之间的空间关系全部要从数据里学。2
一层里在算什么
把序列拼好之后,模型本身几乎原样照搬原始 Transformer。输入构造写成一行:
方括号里是把 [class] 标记与 N 个投影后的块嵌入按顺序拼起来, 是那个共享的投影矩阵, 是位置嵌入。加上 之后, 就是送进编码器的那一串向量。
编码器的每一层由两个子层构成:
式 (2) 是混合步。归一化先做(LayerNorm),再进多头自注意力(MSA),最后把这一子层的输入加回输出,也就是残差。自注意力在这里做的是:每一个块算出一组权重,去加权求和所有块的信息。因为是全连接式的注意力,这一步是全局的——第 1 层里任意两个块就能直接交换信息。式 (3) 是逐位处理步:每个位置上的向量各自过一个两层 MLP,中间用 GELU 激活。这一步是局部的,也是平移等变的,和卷积网络里的逐点操作同性质。两个子层都带残差。
最后一层取出 [class] 那一位作为图像表示:
分类头就接在 上。预训练时它是一层隐藏层的 MLP,微调时换成一层线性层。
到这里可以直说 ViT 这一层的构成:全局混合(注意力,权重全部现学)+ 逐位置前馈(MLP,局部且平移等变)+ 前置归一化 + 残差。拿它和 ResNet 的一层对照,差别只有第一项——ResNet 用卷积做局部混合,卷积核位置无关;ViT 用注意力做全局混合,权重来自数据。后三项两边都有。
微调与高分辨率这一段值得单独记。预训练之后要转到下游数据集,做法是去掉原来的预测头,接上一个零初始化的线性层。一个常见技巧是在比预训练更高的分辨率上微调。ViT 处理这件事的方式是保持块大小不变——分辨率从 224 涨到 384,块数就从 196 涨到 729,序列变长。序列变长本身没问题,但预训练时的位置嵌入是按 196 个位置学的,直接搬过去就对不上了。论文的处理办法是按原来的位置做二维插值,把 197 个位置嵌入重采样成新的个数。这是这条路径上仅有的第二处手工注入二维先验的地方。
模型规格直接沿用 BERT 那一套,再加一个更大的档:
| 模型 | 层数 | 隐藏维度 D | MLP 维度 | 头数 | 参数量 |
|---|---|---|---|---|---|
| ViT-Base | 12 | 768 | 3072 | 12 | 86M |
| ViT-Large | 24 | 1024 | 4096 | 16 | 307M |
| ViT-Huge | 32 | 1280 | 5120 | 16 | 632M |
原论文 Table 1。命名里的数字是块边长,例如 ViT-L/16 表示 Large 规格配 16×16 的块。块越小,序列越长,算力开销越大。2
训练设置也一并记下:全部模型(包括 ResNet 基线)都用 Adam,、,批量 4096,权重衰减取 0.1;微调换回带动量的 SGD,批量 512。Table 2 的 ImageNet 结果在更高分辨率上微调,ViT-L/16 用 512,ViT-H/14 用 518,并用了系数 0.9999 的 Polyak 平均。2
实验怎么读(一):跟谁比、怎么比
比赛场地是三个规模差很多的数据集。ImageNet 是标准的 1000 类、130 万张图;ImageNet-21k 是它的超集,2.1 万类、1400 万张,公开可下载;JFT-300M 是 Google 内部的 1.8 万类、3.03 亿张图,不对外发布。评测则用 ImageNet(原始标签与清洗过的 ReaL 标签)、CIFAR-10/100、Oxford-IIIT Pets、Oxford Flowers-102,以及一个叫 VTAB 的 19 项任务套件。VTAB 专门测低数据迁移,每项任务只给 1000 个训练样本,分成自然图像、专业图像(医学、卫星)、结构化任务(需要几何理解,比如定位)三组。2
有两个评测口径要分开。微调准确率是把整个模型在下游数据上继续训练后的表现;少样本线性评测是冻住表示,只用一小部分训练样本解一个带正则的最小二乘问题,有闭式解。论文以微调为准,少样本线性评测用来做快速比较。2
算力这一列也有单位。表里报的是 TPUv3 核心日:一块 TPU v3 芯片有 2 个核心,用到的核心数乘训练天数就是这个量。它是预训练阶段的账,不含微调。2
| 模型 | 预训练数据 | ImageNet | ImageNet ReaL | CIFAR-100 | VTAB(19 项) | 预训练算力 |
|---|---|---|---|---|---|---|
| ViT-H/14 | JFT-300M | 88.55±0.04 | 90.72±0.05 | 94.55±0.04 | 77.63±0.23 | 2.5k |
| ViT-L/16 | JFT-300M | 87.76±0.03 | 90.54±0.03 | 93.90±0.05 | 76.28±0.46 | 0.68k |
| ViT-L/16 | ImageNet-21k | 85.30±0.02 | 88.62±0.05 | 93.25±0.05 | 72.72±0.21 | 0.23k |
| BiT-L(ResNet152x4) | JFT-300M | 87.54±0.02 | 90.54 | 93.51±0.08 | 76.29±1.70 | 9.9k |
| Noisy Student(EfficientNet-L2) | JFT-300M | 88.4/88.5* | 90.55 | — | — | 12.3k |
原论文 Table 2。数字是三次微调的平均值与标准差。星号是 Touvron 等 2020 后来报告的改进值,不是本文测得的。2
这张表有三处必须连口径一起读。
第一,Noisy Student 那一格。它写的是 88.4/88.5,后面带星号;88.5 那个成绩来自另一篇论文(Touvron 等 2020)报告的改进结果。把 88.55 与 88.5 摆在一起看时要知道,两个数字的来源不同。2
第二,算力列的比较优势比准确率的优势大得多。ViT-H/14 拿到 88.55%,用了 2.5k 核心日;Noisy Student 标称 88.4/88.5,用了 12.3k;BiT-L 是 87.54% 配 9.9k。同数据同架构族的内部对比更干净:ViT-L/16 在 JFT 上 0.68k,比 BiT-L 少一个数量级还多。用公开的 ImageNet-21k,ViT-L/16 只花 0.23k 核心日——论文说这相当于一台 8 核的标准云 TPUv3 训练大约 30 天。2
第三,也是最重要的一处,预训练效率不只由架构决定。这句话是论文自己写的:影响它的还有训练日程、优化器、权重衰减等因素。所以「ViT 更省算力」这个结论,在同一篇论文内部、同一套训练流程下的横向对比中最有说服力;跨论文比较时,架构只是变量之一。2
第 4.4 节做了一个更受控的版本,固定数据(全部用 JFT-300M),只比较表现与预训练算力。参与者是 7 个 ResNet、6 个 ViT 和 5 个混合模型(先用 ResNet 提特征,再把特征图当序列喂给 Transformer)。结论有三条:在「表现/算力」这条线上 ViT 普遍压过 ResNet,达到同样表现大约只用 1/2 到 1/4 的算力;混合模型在小算力段略好于纯 ViT,模型变大之后这点差距消失;在试过的范围内 ViT 还没饱和。2
实验怎么读(二):数据规模那条轴
上面那张表里藏着本期最值得带走的一条读数。把同一个模型放到三个规模递增的预训练集上,看它在 ImageNet 上的成绩怎么变:
| 预训练数据 | ViT-B/16 ImageNet | ViT-L/16 ImageNet | ViT-B/16 CIFAR-100 | ViT-L/16 CIFAR-100 |
|---|---|---|---|---|
| ImageNet(1.3M) | 77.91 | 76.53 | 87.13 | 86.35 |
| ImageNet-21k(14M) | 83.97 | 85.15 | 91.67 | 93.44 |
| JFT-300M(303M) | 84.15 | 87.12 | 91.87 | 94.04 |
原论文 Table 5(对应 Figure 4),微调分辨率 384。这里的 ImageNet 一列不含 Table 2 用到的 Polyak 平均与 512 分辨率。2
第一行是最反常的地方。只用 ImageNet 预训练时,大模型 ViT-L/16 反而比小模型 ViT-B/16 差(76.53 对 77.91)。这说明在这种数据规模下,模型变大带来的是过拟合,参数学不到有用的东西。到 ImageNet-21k,两者接近;只有到 JFT-300M,大模型才真正拉开差距。
论文还做了一组更干净的控制实验:在 JFT 的随机子集 9M、30M、90M 上训练,不加额外正则,超参保持一致,只报告训练中最好的验证准确率。结果是 ViT 在小数据子集上比算力相当的 ResNet 过拟合更严重。文中的例子是 ViT-B/32 略快于 ResNet50:在 9M 子集上明显更差,到 90M 以上又更好。2
这条轴就是「归纳偏置值多少数据」的直接读数:卷积网络从小数据里能榨出的东西,ViT 要靠更多数据自己学出来。同一张 Figure 4 里,BiT 各尺寸围出的表现区间在数据少时盖住 ViT,数据多时被穿过。
附录 D.2 补了一组缩放实验,回答「该往哪个方向放大」。基于一个 88 层、D=1024 的配置扫各个维度,结论是:加深度收益最大,到 64 层都还看得见,但 16 层之后回报开始递减;加宽度几乎没用;减小块边长(也就是拉长序列)收益稳健而且不增加参数。作者由此写道,算力可能比参数量更能预测性能。2
实验怎么读(三):模型在看哪里
准确率之外,第 4.5 节去看了模型的内部。有三个观察。
位置嵌入自己学出了二维结构。把 197 个位置嵌入两两算余弦相似度,能看到相近的块相似度更高,而且行、列结构浮现出来——同一行、同一列的块位置嵌入相近。这正好解释了前面那个结果:手工写进去的二维位置嵌入带不来增益,因为模型自己就学到了。2
注意力距离。用注意力权重算出「信息平均跨越多远」,这个量的意义相当于卷积网络里的感受野大小。结果显示:低层里不同头的差距很大,有的头已经在关注整幅图,有的头只在很局部的范围里看;随着层数加深,所有头的注意力距离都变大,网络后半段大多数头都在大范围地看。混合模型里那种强局部注意力反而不明显,作者推测它承担的功能类似 CNN 的前几层卷积。2
越省显存。附录 D.5 在 TPUv3 上实测了推理速度与单核能容纳的最大批量:速度上和同规模 ResNet 相当,但单核批量明显更大。作者同时提醒,块级注意力的算力随图像尺寸是双二次增长的,只有最大的模型在最高分辨率下才开始显出来。2
还有一组容易被略过的数字在附录 D.3。初次尝试用全局平均池化(GAP)替代 [class] 标记时表现很差,但作者查明原因完全在于两种做法需要不同的学习率,与是否多一个标记无关。这条说明在报告消融时,把学习率一起看清楚是有必要的。2
最后是自监督那一节,它的量级要交代清楚。论文模仿 BERT 的掩码语言模型做了一版掩码块预测:随机遮住 50% 的块嵌入(其中 80% 换成可学习的 [mask]、10% 换成另一块的嵌入、10% 保持不变),再让模型预测被遮住的块的平均颜色。ViT-B/16 用这套目标预训练后,ImageNet 上拿到 79.9%,比从头训练高 2 个百分点,比监督预训练低 4 个百分点。论文把它写成初步探索,并把对比式预训练留作未来工作。2
局限:哪几条不能从这篇推出来
第一,验证范围只到图像分类。论文结论一节把目标检测与分割列成待办,并提到 DETR 那类工作给出的线索。分类之外的能力,这篇给不出结论。
第二,最亮的那两行用了一个拿不到的数据集。JFT-300M 是 Google 内部数据,不对外发布;Table 2 里 ViT-H/14 与 ViT-L/16 的那几格无法直接复现。要复现得退到公开的 ImageNet-21k 那一行(85.30%)。2
第三,自监督那条路还差一截。79.9% 比监督预训练低 4 个百分点,论文自己把它定位成初步结果。
第四,算力优势的归因要留余地。预训练效率受训练日程、优化器、权重衰减影响,架构只是其中之一——这句话出自论文第 4.2 节。附录 D.1 还提供了一个具体例子:在这套设置里,连 ResNet 换用 Adam 也比 SGD 略好,这正是本文给所有 ResNet 基线换优化器的理由。换言之,ViT 与基线之间的差距里,混着一部分训练配方。
第五,全文没有定理。这篇论文给出的是架构、实验与经验规律,没有收敛性或泛化性的形式结论。
第六,图与表本身修订过。arXiv v2(也就是 ICLR camera-ready)修正了 Figure 5 与 Table 6 里 exaFLOPs 计算的错误,并说明模型的相对表现基本不受影响。1 引用这两个图上的绝对算力数值时,要用修订后的版本。
影响与延伸阅读:被换掉的是哪几件零件
回到前面那条拆法。ViT 的一层=全局混合 + 逐位置前馈 + 前置归一化 + 残差。把后面几年围绕它的工作放到这个坐标里,每一篇替换的是哪一件就很清楚。
DeiT(Touvron 等,arXiv:2012.12877)换的是「数据从哪来」。ViT 最亮的成绩依赖内部大库,DeiT 的目标就是只用 ImageNet 训练。它在一台机器上训练不到 3 天,86M 参数的无卷积模型单裁剪 ImageNet top-1 到 83.1%,不用任何外部数据;再加上一套针对 Transformer 的教师—学生蒸馏(在序列里多放一个蒸馏标记,让学生通过注意力向教师学,教师可以用卷积网络),最高到 85.2%。3
Swin Transformer(Liu 等,arXiv:2103.14030)换的是「混合的支撑范围」,也就是把局部性重新装回去。图像里的物体尺度变化大、像素分辨率高,全局注意力在这些场景下代价高。Swin 用层级化的结构加移位窗口,把自注意力限制在不重叠的局部窗口内,同时让窗口之间仍能交流,算力随图像尺寸线性增长。它给出 ImageNet-1K 87.3、COCO 检测 58.7 box AP、ADE20K 分割 53.5 mIoU,并成为通用的视觉骨干。4
MAE(He 等,arXiv:2111.06377)换的是预训练任务,走回自监督。它随机遮住输入图像的块再重建像素,用非对称的编码器—解码器结构(编码器只看可见的块,不带掩码标记),并发现遮掉 75% 这么高的比例才构成有意义的任务。ViT-Huge 仅用 ImageNet-1K 就到 87.8%,训练还快 3 倍以上,下游迁移超过监督预训练。5
CLIP(Radford 等,arXiv:2103.00020)换的是监督来源。它用 4 亿对图文,预训练任务是判断哪段文字配哪张图,之后用自然语言来指称视觉概念,实现零样本迁移。论文报告它在 ImageNet 上零样本即可追平原版 ResNet-50 的准确率,而那 128 万张训练图它一张都没用过。6
ConvNeXt(Liu 等,arXiv:2201.03545)是往回走的一篇,也是本文结论最直接的反驳。它指出:层级化 Transformer(比如 Swin)重新装进了好几种卷积的先验,这些混合方案的效果常被记在「Transformer 本身更优越」的账上。于是它把 ResNet 逐步现代化——朝 ViT 的设计选择改,包括块状前端、深度可分离卷积、倒瓶颈、GELU、LayerNorm 等——得到一族纯卷积模型 ConvNeXt,ImageNet top-1 到 87.8%,在 COCO 检测与 ADE20K 分割上超过 Swin。7
Raghu 等(arXiv:2108.08810)把问题从「谁更准」换到「内部是不是一回事」。它比较两种架构的内部表征结构,发现差别很大:ViT 各层表征更均匀;自注意力让它在低层就能聚合全局信息;残差连接把低层特征强烈地传到高层;ViT 较好地保留了输入的空间信息,不同分类头的选择带来可见影响。8
把这六篇放在同一个维度上看,被反复更换的是两样东西:信息在多大范围里混合(全局注意力、局部窗口、层级化),以及监督从哪里来(分类标签、图文对、重建目标)。ViT 自己把这两样都换了一遍,却把「哪一件零件贡献了多少准确率」这个问题留给了后来者。ConvNeXt 的做法正是把这个组合拆开逐项检验:如果把同样的设计选择交给卷积,分数一样能上去,那优势就不全在注意力身上。这篇论文没有做这一步。
读完留下的判断维度
一,先看数据规模,再看胜负。同一个模型在 ImageNet 上输给 ResNet、在 JFT-300M 上又赢,这两件事出自同一次实验。看到「新架构超过旧架构」,先确认比较发生在哪个数据规模上。
二,算力这一列要连口径一起读。核心日是预训练阶段的账;一张表里的速度或效率,往往来自本文的实测,而准确率可能抄自别处。哪一列是自测、哪一列是引用,决定了它能不能支撑「更高效」的说法。
三,训练配方是不是一起换了。优化器、权重衰减、微调分辨率、正则强度,任何一项动了,架构的功劳就要打折。这篇论文自己在第 4.2 节写了这句话,后来的 ConvNeXt 把它做成了实验。
四,消融表里看「最强」的幅度,不只看排名。有些改动在小数据集上只带来噪声级别的差距,在另一个数据集上才拉开(比如块边长的缩小与序列的拉长)。一个改动在哪个数据集上赢、赢多少,比它排第几更值得记。
References
- 1
- 2原论文第 1 节与第 2 节对这两条技术路线的交代
arxiv.org
- 3
- 4
- 5
- 6
- 7
- 8
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.