《GCN》:把谱卷积简化成一次邻居加权平均,140 个标签为什么够用
从图上没有网格这个困难出发,拆解 GCN 的两次近似与重归一化传播规则,讲清每类 20 个标签为什么够用,并用三张原表读懂它的准确率口径、消融幅度与适用边界。

2016 年 9 月 9 日,Thomas N. Kipf 与 Max Welling 把《Semi-Supervised Classification with Graph Convolutional Networks》挂上 arXiv,编号 arXiv:1609.02907。两位作者当时都在阿姆斯特丹大学,Welling 同时隶属加拿大高等研究院(CIFAR)。论文在 2017 年 2 月 22 日完成最后一次修订,并以会议论文的形式发表在 ICLR 2017。12
卷积神经网络在图像上成立,靠的是平移不变性:同一个 3×3 卷积核在左上角和右下角含义相同,因为图像是一个规则网格。图没有网格。一个节点有几个邻居并不固定,邻居之间没有先后顺序,把节点重新编号之后,邻接矩阵整张都变了。这篇论文要回答的问题是:在这样的数据上,"卷积"应该写成什么样子。
论文给出的答案落在一条很短的传播规则上,它的第一条实验证据也同样短。在 Cora 引文网络上,它每类只用 20 个标签——7 个类别加起来 140 个,占全部 2,708 篇文档的 5.2%——测试准确率达到 81.5%。换成同一份节点特征、完全不看图结构的 MLP,准确率只有 55.1%。训练到收敛用了 4 秒。3
两个名词先交代清楚。"节点分类"指给图里每个节点贴一个类别标签,在引文网络里就是判断每篇论文属于哪个主题。"半监督"指只有一小部分节点带标签,其余节点不带。这篇论文做的还是传导式(transductive)任务:训练时整张图都在场,测试节点的特征与连边一起参与计算。论文第 4.2 节自己就把范围限定在 transductive node classification 上。3
把改动压缩成一句话:论文把图上的谱卷积一路近似到只保留一阶项,再把邻接矩阵重归一化;到这一步,每一层只剩下一件事——把邻居的特征做一次加权平均,再乘一个可学的通道混合矩阵。
图上的卷积难在哪
先看图像上的卷积为什么能用。一个 3×3 的卷积核在图像上滑动,每个位置都用同一组 9 个权重去乘它覆盖的 9 个像素。这套做法成立的前提有两条:每个像素的邻居数量固定(图像边界除外),邻居还有固定的相对位置,左上、正上、右上各是哪一个清清楚楚。卷积核学到的"某个方向的边缘"因此可以在任意位置复用。
图把这两条前提一起打破。一个节点可以只连一条边,也可以连上万条;邻居之间没有上下左右的次序,交换两个邻居的位置不应该改变结果;节点编号本身是任意的,重新编号之后邻接矩阵整个换掉,模型给出的答案也不该跟着变。
谱图理论给过一个形式上很干净的答案。把节点上的信号记成向量 x ∈ R^N,N 是节点数,图上的卷积可以定义成"转到频域、乘滤波器、再转回来":
这里 U 是归一化图拉普拉斯 L = I_N − D^(−1/2)AD^(−1/2) 的特征向量矩阵,其中 A 是邻接矩阵,D 是度矩阵,Λ 是 L 的特征值组成的对角矩阵。Uᵀx 把信号转到频域,g_θ 是一个以特征值为输入的滤波器,最后再乘 U 转回节点域。图上的"低频"对应沿边变化缓慢的信号,所以这个定义等于说:卷积就是按图的连接结构,对信号做一次频率上的筛选。3
代价立刻出现。乘一次 U 是 O(N²) 的操作,而对 L 做特征分解本身在大图上就已经算不动。这条路要能用,必须绕开特征分解。
绕开的办法来自 Hammond 等 2011 的一个结果:把 g_θ(Λ) 用切比雪夫多项式展开、截断到 K 阶,
代回卷积的定义,得到
这一步换来两件东西。多项式里只剩 L 的乘方,而 L 的乘方作用在信号上等于沿边传播一次——K 阶多项式只依赖与中心节点距离不超过 K 跳的节点,这正是图上的"局部感受野"。同时,计算不再需要特征分解,复杂度降到与边数同阶的 O(|E|)。谱图卷积网络最早由 Bruna 等 2014 提出,Defferrard 等 2016 用这套 K 阶局部滤波器把它的计算量压了下来。45
两次简化:把 K 阶多项式压成一次归一化平均
论文从式 (5) 出发做了两次近似,每一次都把可调参数削掉一层。
第一次,把阶数取到最低的 K=1。切比雪夫展开在 K=1 时只剩两项,式 (5) 化成
每层只剩两个标量参数 θ′₀ 与 θ′₁,参数在整个图上共享。论文给这一步的理由有三条。滤波器的形状改由多层堆叠决定,不再被切比雪夫那一组基固定;参数更少,在度分布很宽的图(社交网络、引文网络、知识图谱都有这种特征)上更不容易过拟合;同样的计算预算下可以堆得更深,而更深通常意味着更强的建模能力。3
第二次近似更狠。论文认为网络参数会在训练中自行吸收尺度变化,于是直接取 λmax ≈ 2;为了进一步减少每层的参数与矩阵乘法次数,又令 θ = θ′₀ = −θ′₁,把两个参数并成一个:
到这一步,每一层只剩一个标量。
麻烦也随之而来。I_N + D^(−1/2)AD^(−1/2) 的特征值落在 [0, 2] 区间内,把这样一个算子反复作用在特征上,数值会不稳定,在深网络里表现为梯度爆炸或消失。
论文的修复办法叫重归一化技巧,写法只有一行:
两个动作各有含义。Ã = A + I_N 是给每个节点加一条连到自己的边,聚合时节点自己也被算进去,否则一层之后节点手上只剩邻居的信息。两侧各乘一次 D̃^(−1/2) 是在归一化:邻居 j 对节点 i 的贡献被压到 1/√(d_i d_j) 这个权重上,度数高的节点因为连边多、传递量大,被这个因子压下来。
把标量 θ 换成矩阵 Θ,因为它要同时处理 C 个输入通道、产出 F 个输出通道,就得到论文实际使用的一层:
X ∈ R^{N×C} 是这一层输入的节点特征矩阵,Θ ∈ R^{C×F} 是可学的滤波器参数,Z ∈ R^{N×F} 是输出。计算复杂度是 O(|E|FC),因为 Ã X 可以当作稀疏矩阵乘稠密矩阵来做。3
到这里可以直说这一层在算什么。Ã X 的每一行,是节点自己的特征向量与它所有邻居的特征向量的一次加权求和,权重只由两端的度决定,不参与学习。再乘 Θ,是把 C 个输入通道线性组合成 F 个输出通道,这一层里学出来的东西只有它。所以"图卷积"里的卷积部分,是一张由图的连接结构完全固定的加权平均矩阵;也正因为它是固定的,它可以在训练开始前算一次、存下来反复使用。
两层就够:140 个标签怎么撑起一张引文网络
把所有层拼起来,就是论文的逐层传播规则:
H^(0) = X 是输入的特征矩阵,W^(l) 是第 l 层的可学参数,σ 是激活函数,这篇用的是 ReLU。把 Â = D̃^(−1/2)ÃD̃^(−1/2) 预先算好之后,两层模型的整个前向过程只有一行:
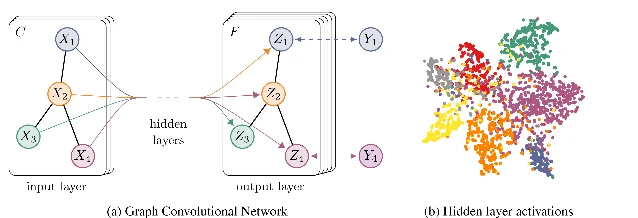
损失函数只在有标签的节点上计算:
𝒴_L 是带标签节点的集合。这里是理解全文最关键的一处:损失只落在 140 个节点上,图里其余节点根本没有出现在损失函数里。3
那 140 个标签为什么够用?梯度虽然只从带标签的节点出发,却有路走到不带标签的节点。前向计算时,一个带标签节点的输出用到了它两跳邻域里所有节点的特征,其中大部分没有标签;这些无标签节点的特征再通过各层共享的 W 影响那个输出。反向传播时,无标签节点的特征本身不会被更新,它们是输入而不是参数,但梯度要穿过它们所在的通路才能回到 W 上;W 一旦更新,无标签节点自己的隐表示也跟着改变。无标签节点没有出现在损失里,它们是被带标签节点的计算图牵进去的。这就是传导式的含义:训练时整张图都在场,测试节点和它们的边也参与了前向计算。3
训练细节值得一并记下。论文用全批量梯度下降,每一次迭代都把整个数据集放进网络,随机性靠 dropout 引入;实现用 TensorFlow 做稀疏—稠密矩阵乘,内存需求与边数同阶。这套做法的前提是整张图能装进显存,论文把小批量随机梯度下降留作未来工作。3
附录 A 给出了这条规则的另一种读法,也是理解它最短的一条路。图同构判定里的 1 维 Weisfeiler-Lehman 算法反复做同一件事:每个节点把邻居当前的着色加起来,经过一个哈希函数得到自己的新着色。论文把那个哈希函数换成一个可微的、带参数的函数,取归一化常数 c_ij = √(d_i d_j),得到的正是式 (2)。它据此写道,GCN 可以看成 1 维 WL 算法的一个可微、带参数的推广;原文在这一句里用了 loosely speaking。3
这个类比还解释了一件反直觉的事:即使权重随机初始化、完全不训练,一个三层 GCN 也是不错的节点特征提取器。附录 A.1 在 Zachary 空手道俱乐部网络(34 个节点、154 条边、四个类别)上做了演示,每个类别各给一个标签,输入只用节点自身的独热编码。3
实验怎么读:三张表、五种容易读错的数字
四份数据集的性质差别很大,先把它们放在一起看。引文网络里节点是文档,边是引用关系,特征是文档的稀疏词袋向量;训练时每类只用 20 个标签,但全部特征向量都参与计算。测试集固定为 1,000 个样例,另有 500 个带标签的验证样例只用来选超参数,不参与训练。NELL 是从知识图谱里抽出来的二部图,包含 55,864 个关系节点与 9,891 个实体节点,作者给每个关系节点一个独热表示,把特征扩到 61,278 维,每一类只给 1 个标签。3
| 数据集 | 类型 | 节点数 | 边数 | 类别数 | 特征数 | 标签率 |
|---|---|---|---|---|---|---|
| Citeseer | 引文网络 | 3,327 | 4,732 | 6 | 3,703 | 0.036 |
| Cora | 引文网络 | 2,708 | 5,429 | 7 | 1,433 | 0.052 |
| Pubmed | 引文网络 | 19,717 | 44,338 | 3 | 500 | 0.003 |
| NELL | 知识图谱 | 65,755 | 266,144 | 210 | 5,414 | 0.001 |
原论文 Table 1,统计口径沿用 Yang 等 2016 的设定。标签率是训练用到的有标签节点数除以节点总数。3
主结果在 Table 2:
| 方法 | Citeseer | Cora | Pubmed | NELL |
|---|---|---|---|---|
| ManiReg | 60.1 | 59.5 | 70.7 | 21.8 |
| SemiEmb | 59.6 | 59.0 | 71.1 | 26.7 |
| LP | 45.3 | 68.0 | 63.0 | 26.5 |
| DeepWalk | 43.2 | 67.2 | 65.3 | 58.1 |
| ICA | 69.1 | 75.1 | 73.9 | 23.1 |
| Planetoid* | 64.7 (26s) | 75.7 (13s) | 77.2 (25s) | 61.9 (185s) |
| GCN | 70.3 (7s) | 81.5 (4s) | 79.0 (38s) | 66.0 (48s) |
| GCN(另抽 10 个划分) | 67.9±0.5 | 80.1±0.5 | 78.9±0.7 | 58.4±1.7 |
原论文 Table 2。数字是分类准确率,单位是百分比;括号里是训练到收敛的墙钟时间,单位是秒。最后一行是同样规模下另外抽 10 个划分的平均值与标准误。3
第一处容易读错的是基线的来源。除 ICA 由本文作者自己跑了 100 次之外,ManiReg、SemiEmb、LP、DeepWalk 与 Planetoid* 的准确率都是从 Planetoid(Yang 等 2016)那篇论文里抄过来的;括号里的时间不同,那是作者拿 Planetoid 作者提供的代码,在同一台带 GPU 的机器上重新跑出来的。所以这张表里"准确率更高"和"跑得更快"的证据等级并不一样:后者是本文实测的,前者引用自别处。3
第二处是划分。主行那些数字,是在固定的那一个数据集划分上、用 100 次不同的随机权重初始化取平均得到的;最后一行才是另外抽 10 个同样规模的划分重做的结果。同一个模型、同一份数据,Cora 上从 81.5 掉到 80.1±0.5,差 1.4 个百分点,比标准误大一个量级;Citeseer 上从 70.3 掉到 67.9±0.5;NELL 上从 66.0 掉到 58.4±1.7,差 7.6 个百分点。表里那个 ±0.5 量的是初始化带来的方差,而划分带来的方差更大。读这张表的时候,把 81.5 与 80.1±0.5 放在一起看,比只看前者更接近实情。3
第三处是"图结构值多少分"。同一篇论文的 Table 3 里有一行多层感知机:它用同一份节点特征,但完全不看邻接矩阵。Cora 上它拿到 55.1,GCN 是 81.5,中间那 26 个百分点,是"图提供了多少信息"最直接的读数。换到 Pubmed,同一对比只剩 7.6 个百分点(71.4 对 79.0)——图结构带来的收益随数据集变化很大,这一点在宣传式的读法里常常被抹掉。3
Table 3 本身是五次不同传播模型的对照:
| 传播模型 | 传播写法 | Citeseer | Cora | Pubmed |
|---|---|---|---|---|
| 切比雪夫滤波器 K=3 | Σ θ′_k T_k(L̃)X | 69.8 | 79.5 | 74.4 |
| 切比雪夫滤波器 K=2 | Σ θ′_k T_k(L̃)X | 69.6 | 81.2 | 73.8 |
| 一阶模型(式 6) | XΘ₀ + D^(−1/2)AD^(−1/2)XΘ₁ | 68.3 | 80.0 | 77.5 |
| 单参数(式 7) | (I_N + D^(−1/2)AD^(−1/2))XΘ | 69.3 | 79.2 | 77.4 |
| 重归一化技巧(式 8) | D̃^(−1/2)ÃD̃^(−1/2)XΘ | 70.3 | 81.5 | 79.0 |
| 只用一阶项 | D^(−1/2)AD^(−1/2)XΘ | 68.7 | 80.5 | 77.8 |
| 多层感知机 | XΘ | 46.5 | 55.1 | 71.4 |
原论文 Table 3。每个变体在相同设置下跑 100 次、每次随机初始化权重之后取平均准确率;NELL 没有参与这组对照。3
第四处是"我最强"的幅度。Cora 上重归一化拿到 81.5,保留完整的切比雪夫 K=2 是 81.2,两者差 0.3 个百分点。在这个数据集上,两次简化与不简化几乎没有区别。真正的差距出现在 Pubmed:79.0 对 K=2 的 73.8 与 K=3 的 74.4,差 5 个百分点以上。论文第 7 节自己的说法是"在若干数据集上既提高了效率也提高了预测性能",措辞比"全面更好"要窄。被砍掉的那些参数在 Cora 上没能换来准确率,在 Pubmed 上换来了。3
第五处是自环。把重归一化之后的算子换成不带自环的 D^(−1/2)AD^(−1/2),三个引文网络上分别低 1.6、1.0、1.2 个百分点。方向一致,幅度不大,但它是可测的:Ã = A + I_N 这个改动本身在起作用。3
速度也要连口径一起读。Cora 上 GCN 用 4 秒对 Planetoid 的 13 秒,Citeseer 上 7 秒对 26 秒,NELL 上 48 秒对 185 秒;Pubmed 上反过来,GCN 用 38 秒,Planetoid 只要 25 秒。四个数据集里三个更快、一个更慢,"更快"只在逐项阅读时成立。3
局限:哪几条不能从这篇推出来
第一,也是最要紧的一条:这是传导式方法。训练时整张图在场,测试节点的特征和边一起参与了前向计算。一个新节点加入进来,按原样是用不了这个模型的,要么重训,要么另想办法。论文第 4.2 节把范围写在 transductive node classification 上,对归纳式能力没有给出结论。3
第二,内存与批量。全批量梯度下降让内存需求随数据集线性增长,论文把"小批量随机梯度下降"作为未来工作写在第 7.2 节。第 6.3 节的计时实验只在合成的随机图上做,其中有配置直接内存溢出,被图例用星号标出。能扩展到多大的图,在这篇论文里是方向,还称不上结果。3
第三,有向边与边特征。这套框架只处理无向图,加权或无权都可以。NELL 上有向的关系图之所以能用,是因为作者先把有向图改写成了无向二部图,把每条关系也变成一个节点。这是数据层面的改造,模型本身仍然只认无向图。3
第四,自环与邻居的联系等权,是一个没有经过检验的默认。式 (2) 里 Ã = A + I_N 意味着"我自己"与"我的每个邻居"被同等看待。论文在结尾提出可以把 I_N 的系数换成一个可学习或可调的 λ,但没有做实验。3
第五,理论地位。论文提供的是一条传播规则的动机——谱滤波的一阶截断,加上与 WL 算法的类比——其中没有定理。附录 A 那处对应关系的原文用了 loosely speaking,它是理解模型的一条捷径;关于模型能力的结论,论文没有给。
第六,两处没做的消融。Table 3 里,多层感知机那一行只有 XΘ,既没有传播也没有隐藏层;重归一化那一行同时有传播、逐层权重矩阵与 ReLU。两组之间隔着好几个变量,谁贡献了多少分不出来。另一处是表达能力:附录 A 把 GCN 比作 1 维 WL 算法的可微推广,等于暗示了一条上界,论文没有把它写成可判定的结论。
影响与延伸阅读:这条传播规则被换掉的四个部件
把式 (8) 拆开看,一层里只有三样东西:一个固定的传播算子 Â,一个可学的通道混合矩阵 Θ,一个逐元素的非线性 σ。后面几年里,被替换的都是其中某一样;替换之所以可以逐个进行,是因为 Â 在模型里的位置不参与参数学习,换掉它不会牵动 Θ。
前身那一侧,换掉的是滤波器这一块。Bruna 等 2014 在谱域定义卷积,Defferrard 等 2016 用切比雪夫多项式把它局部化,代价是每个滤波器要学一组 θ′_k 系数,还要指定阶数 K。GCN 把 K 收到 1、再压到一个标量,等于把"滤波器"这一块从模型里删掉,只留下传播。
GraphSAGE(Hamilton 等,NIPS 2017)换掉的是"整张图必须到场"。它为每个节点学的是一套从邻居采样并聚合的函数,节点不再各自持有一个独立向量,因此能给训练时没见过的节点算出表示。摘要里那句判断写得很直白:以往的方法"本质上是传导式的,不能自然泛化到未见过的节点"。6
GAT(Veličković 等,ICLR 2018)换掉的是"邻居的权重由度决定"。它用掩码自注意力给同一邻域里的不同邻居分配不同权重,摘要里说这样做同时绕开了好几件事:不需要昂贵的矩阵运算(比如求逆),也不依赖事先就知道图结构。在同一组 Cora、Citeseer、Pubmed 基准上,它报告了与当时最好结果持平或更好的成绩。7
SGC(Wu 等,ICML 2019)换掉的是非线性和逐层权重矩阵。它把相邻层的 W 合并、把 ReLU 去掉,模型退化成一个固定的低通滤波器加一个线性分类器;摘要的结论是,这些简化"在许多下游任务上并不损害准确率",速度还可以快两个数量级。这篇工作把 GCN 的问题反了过来:赢下来的那部分,是线性传播本身,还是 ReLU 与逐层 W?8
GIN(Xu 等,ICLR 2019)换掉的是"没有上界"这件事。它给出一个分析 GNN 表达能力的框架,证明 GCN、GraphSAGE 这类邻域聚合无法学会区分某些简单的图结构,并给出与 1 维 WL 测试同强、在该类模型里表达能力最高的架构。附录 A 那句"可微的 WL 推广",到这里被换成了一个可判定的边界。9
评价方式这一侧也在变。OGB(Hu 等,NeurIPS 2020)指出当时图机器学习在数据划分与评测协议上缺乏统一,于是给出大规模、面向应用的数据集与统一的划分和指标,并报告"在现实划分下的分布外泛化"仍是没有解决的问题。这与 Table 2 最后一行那条 80.1±0.5 是同一类麻烦:同规模的划分一换,数字就动。10
这些替换里有一点值得单独留下。GraphSAGE、GAT、SGC 三篇报告的实验都落在同一组引文网络基准上,改动却分别落在传播的支撑范围、传播的权重来源和传播之后的部分。它们能各改各的,正是因为式 (8) 把这几件事写成了可以分开的乘法。至于"谁贡献了准确率",这篇论文自己没有拆开。
读完留下的四个判断维度
一,先问"卷积"在这一篇里具体是什么形状。它的卷积部分是一张由邻接矩阵与度决定的稀疏加权平均矩阵,去代码里找那个传播算子,比看它被称为卷积更有用。整层里唯一学出来的东西只有通道混合矩阵。
二,把标签数量与评测协议一起读。140 个标签换来 81.5% 的前提,是测试节点的特征与连边在训练时就参与了计算。看到"极少标签取得高分"的结果,先确认它的评测走的是传导式还是归纳式。
三,一个数字要和它的分布一起看。81.5 与 80.1±0.5 出自同一张表,差 1.4 个百分点;报告的是哪一种方差,决定了这个数字能推广到多远。
四,消融表里看"最强"的幅度,不只看排名。Cora 上 81.5 对 81.2 是噪声级别的差距,Pubmed 上 79.0 对 73.8 才是这篇简化真正的证据。一个改动在哪个数据集上赢、赢多少,比它在表里排第几更值得记。
References
- 1
- 2ar5iv 转换页首部给出的作者机构
ar5iv.labs.arxiv.org
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.