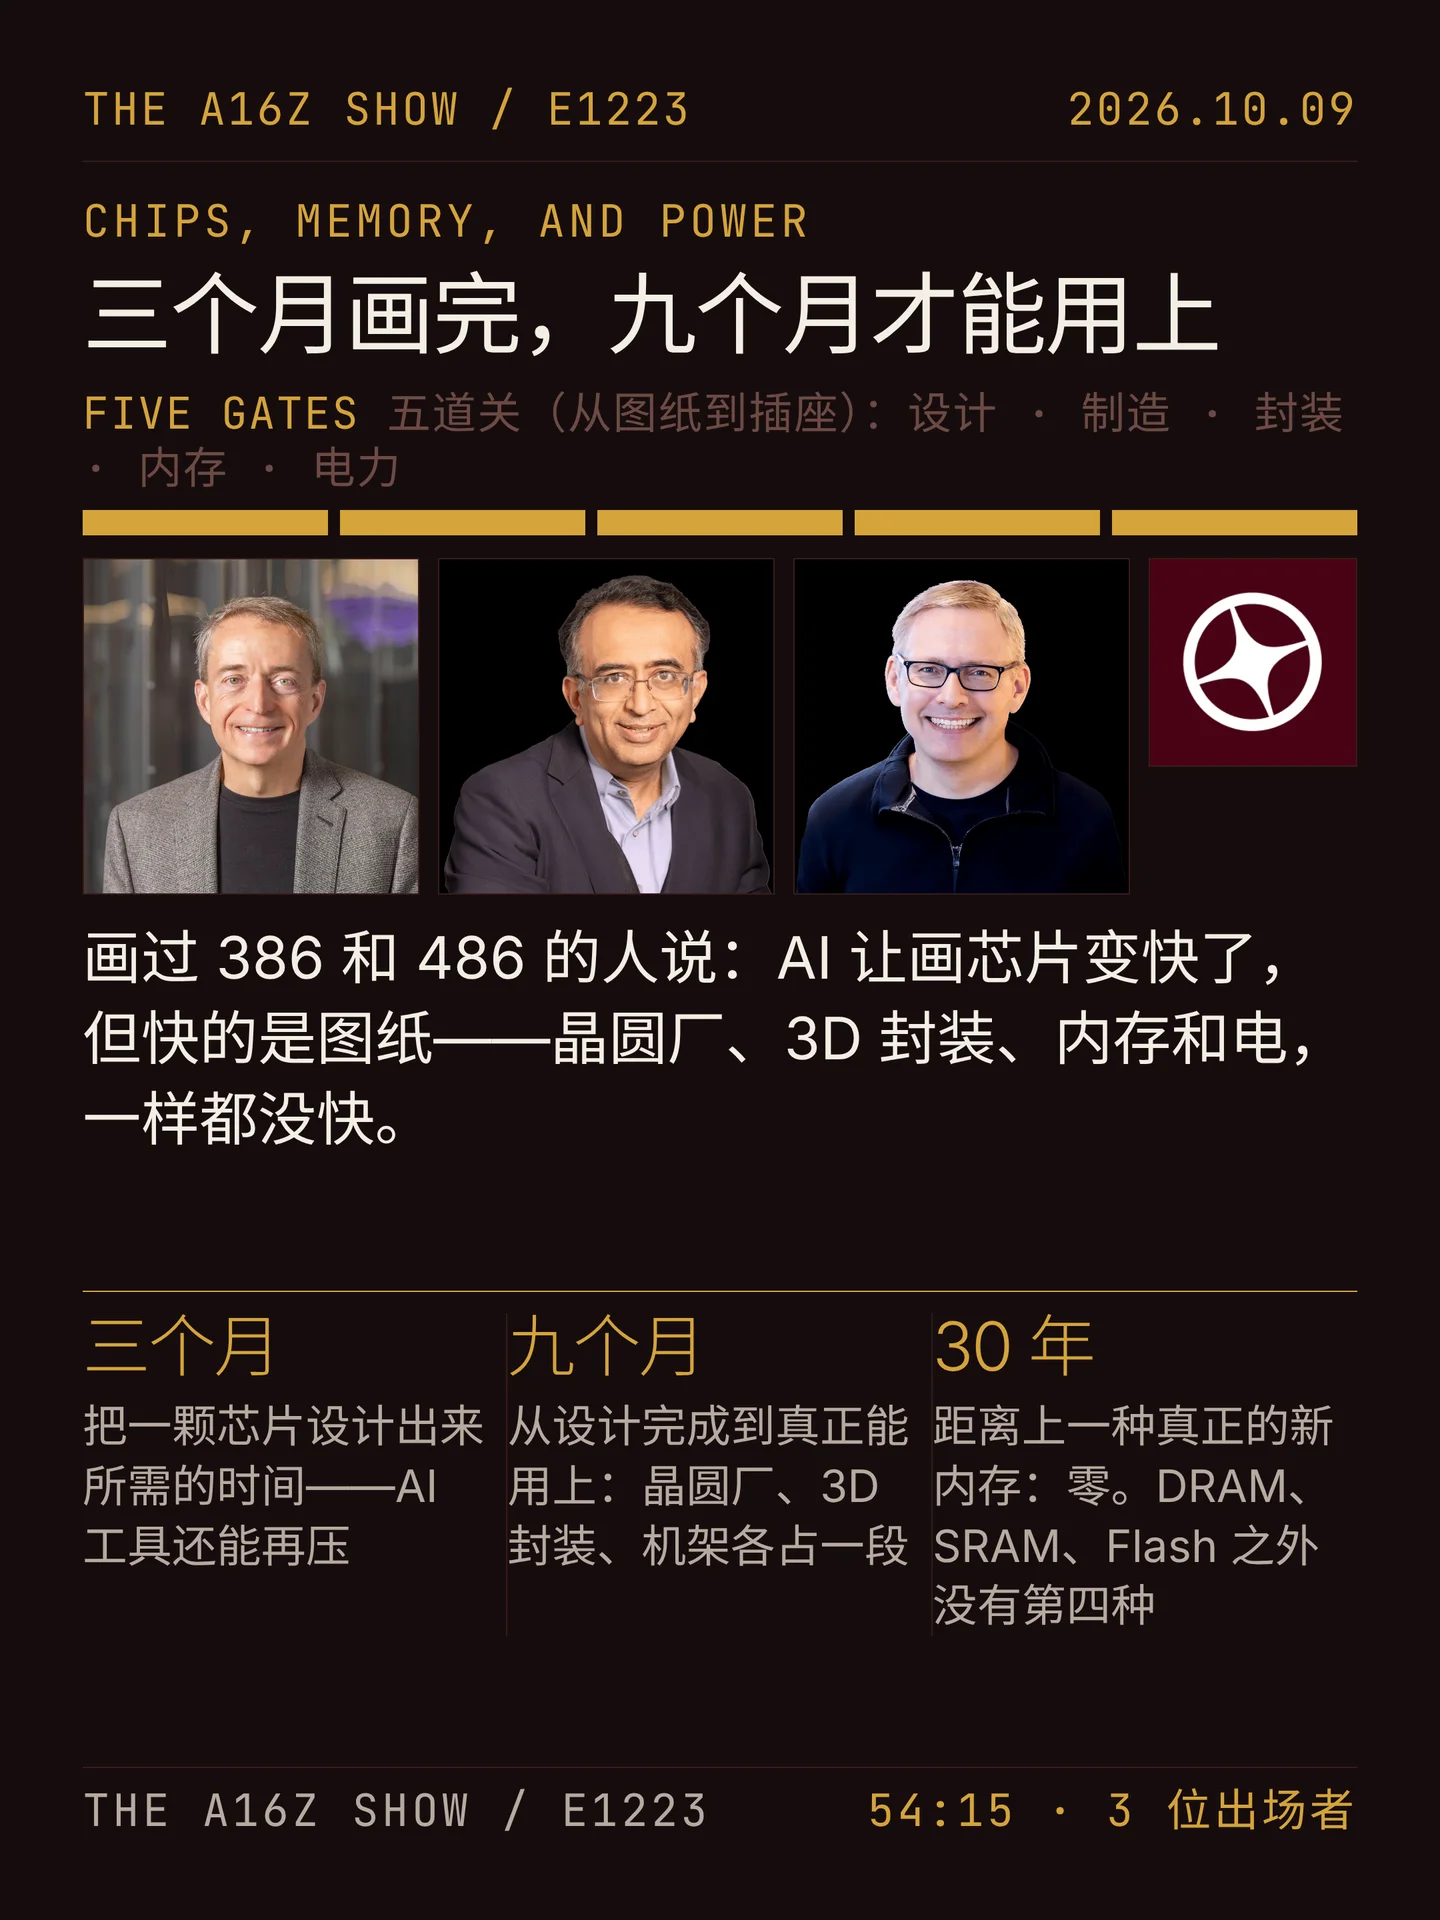

画过 386 和 486 的帕特·盖尔辛格,这一期坐在两位老同事对面说了一句我记了很久的话:AI 让画芯片变快了,但快的是图纸——晶圆厂、3D 封装、内存和电,一样都没快。下面按节目原始顺序整理全部要点,并附逐句全文翻译。1
逐段要点整理
下面按本期音频的实际推进顺序,逐段整理三位出场者讲到的主要论点、数据、案例与金句。本期出场三人:主持拉古·拉古拉姆(a16z 管理合伙人,成长与基础设施投资;在 VMware 二十年,2021 年接替盖尔辛格出任 CEO)、主持圭多·阿彭策勒(a16z 合伙人;前英特尔数据中心与 AI 事业部 CTO、前 VMware 云与网络 CTO)、嘉宾帕特·盖尔辛格(Playground Global 普通合伙人;386 上的第四号工程师、486 的首席架构师;前英特尔 CEO 与前 VMware CEO)。1234
本期官方节目页与 RSS 都没有章节表,官方同名视频在本刊截稿时也尚未上线;下面的时间点为音频中的实际播出位置,逐句译文底稿即来自这版整集音频。全篇对「他说的」与「可核对的」做了区分:凡本轮找到独立出处的给出来源,只有节目里说过而未能核到的,一律注明「节目中的说法」。
00:00 开场(冷开场剪辑):能源容量等于经济容量
- 「在一个 AI 的数字时代,能源容量就等于经济容量。如果我供不上电,那建一座新数据中心、买一百万块 GPU 又有什么意义?」
- 「接下来你会看到,很多这样的数据中心项目会一个接一个地违约——因为电根本不在那里。」(节目中的说法;本期发布前一个月,Oracle 刚就一个数据中心项目发出「不可抗力」通知,理由正是电力延迟,见下文 45:15。)5
- 另外两句被剪进冷开场的话:「现在没有一样东西还只是『一颗芯片』,它是一个机架。我花三个月把它设计出来,却要等九个月才能真正开始用它。」;以及圭多的那句「每当有一项技术把某件事变得容易,瓶颈就会搬到别的地方。」
02:07 老同事重聚
- 拉古开场:「我身边是我们敬重的嘉宾、亲爱的朋友,也是我以前的上司——帕特·盖尔辛格先生。」帕特的回应是「这感觉有点像回到老家,时间过去了一年多,但你们两个看起来一点没变」。三个人的共同历史是这一期对话的底色:拉古在 2021 年接替盖尔辛格出任 VMware CEO;圭多则在盖尔辛格任英特尔 CEO 期间做过英特尔数据中心与 AI 事业部的 CTO。346
02:48 从技校到英特尔:386 与 486
- 拉古拿 a16z 新办的 Horowitz Andreessen 学院起头,问盖尔辛格当年那条「非常规的路」。他的回答:16 岁意外拿奖学金进技校,跳过高中最后一年半,18 岁被英特尔招走——那时他还没坐过飞机,已经在技校里爱上了计算机。
- 面试官罗恩·史密斯在他页面上的批注是:「聪明、好斗、傲慢——他会很合群」(他是那天面试的第 12 个人)。
- 履历线:从技术员做起,286 收尾时进设计团队,386 上是第四号工程师,486 上是架构师兼设计经理;这一切都在他读本科、硕士、博士的同时完成——「白天学,晚上就拿去用」。6
04:33 和斯坦福教授的两节课
- 他讲了自己和斯坦福的一桩旧事:课上有位教授提出一个新的超前进位加法器设计,他正好在做 386 的同类电路,试了两天发现不成立,回来说了;接下来两节课基本就是他和教授在争这件事——而那本书马上就要出版,里面印的就是那个设计。
- 后半段提到两位斯坦福人物:埃德·麦克拉斯基(内建自测试方向的奠基人)与约翰·轩尼诗(他的论文导师,后来当了斯坦福校长)。
- 圭多接了一句自己的经历:「这种争论我在斯坦福教书时也遇到过——你带着一个你以为是真理的东西来,一个在产业里做过的人过来说:其实不太对。」
06:19 486 与 EDA 的诞生
- 他说 486 真正是第一颗实现「你所谓现代 EDA 技术」的芯片:当时没有 Verilog,于是他们发明了 HDL(英特尔的硬件描述语言);自己写了一门语言,就得自己给它写编译器;没有自动布局布线,于是和伯克利的阿尔贝托·桑乔瓦尼-文森特利及其学生一起做了第一次布局布线与自动时序管理。
- 他的总结:「486 不只是第一颗兼容的流水线微处理器,我们还开了后来整个 EDA 产业的先河。」
07:48 今天会不会是同一个转折点
- 被问「以后的人回看 Blackwell,会不会说那是 AI 接管设计之前的最后一代」,他举的例子是 Jalapeño:「那算是 AI 在芯片设计流程里从第一性原理出发的一次使用。」(Jalapeño 是 OpenAI 与博通合作的第一颗自研推理芯片。)78
- 但模拟电路仍然交不出去:「SerDes 大概是最好的例子——你需要大量硅数据才能把它做好。所以你要么把模拟设计做得足够保守,保守到能让 AI 来做;要么就得用笨办法硬做。」
- 他对前景的判断:「你的晶体管预算够大,设计工具越来越聪明,再加上少数几位专家引导工具怎么用——这会像 486 一样,是新时代的开始。」
09:03 瓶颈搬家:三个月设计,九个月才能用
- 圭多那句方法论(「每当有一项技术把某件事变得容易,瓶颈就会搬到别的地方」)之后,帕特把一个假设推到底:假设我和圭多一起造一颗 AI 芯片,放开 AI 工具、三个月拿到出色的设计——然后呢?
- 他拆成三段:晶圆厂最快也要三个月;3D 封装越来越复杂,再加约三个月;最后还要做成机架级方案,因为「它不是芯片,是一个机架」。
- 他的结论很重:「如果我要等一年半才真正拿到规模和软件,那我对 AI 工作负载的理解,就已经不适用于我设计的这颗芯片了。」
- 他还点了两个具体门槛:需要新形式的曝光(lithography);以及「需要不需要在进入原型之前就付五千万美元掩膜成本的设计流程」(节目中的说法;公开口径里 3 纳米级整套掩膜常见估计在 3,000 万–5,000 万美元区间)。
11:40 Graphcore:设计不差,是世界往前走了
- 「Graphcore 不是个糟糕的设计,但世界往前走了。」他用这个例子说出前面那道算术的后果:设计做完、真硅到手之间有九个月到一年半,而工作负载不会等你。Graphcore 在 2024 年 7 月被软银集团收购,成为其全资子公司。9
- 他因此把制造与规模称为「一个巨大的瓶颈」。
12:08 内存:HBM 是「难看的内存」
- 「HBM 是一种难看的内存。它只是我们现在手里最好的那一个。」他给的理由:位密度很差、被「海岸线带宽」限制住(芯片边缘能留给内存的宽度)、功耗与散热都有问题——「DRAM 不喜欢热。」(公开口径:SK 海力士称 HBM4 带宽比上一代翻倍、单引脚逾 10Gbps、能效提升 40% 以上。)10
13:03 电力:40% 的功耗花在「保护余量」上
- 他说今天功耗仿真的工具很差:「你没有好的三维建模工具去算功耗、热点,所以我本质上是在为整个功耗包络留保护余量——在保护余量上损失了 40% 的功耗。」(节目中的说法。)
- 于是他把接下来要攻的瓶颈列成三件:制造与规模、内存、电力——而且「即便 AI 工具完全铺开,我依然面对巨大的挑战」。
13:48 一百种 AI 芯片会收敛:他给了三个理由
- 「现在有一百种 AI 推理加速芯片,我敢肯定我根本认不全。」两位主持人被反问:「你们到底为什么投那么多家?」回答是:「你自己也没少投。」
- 他的判断:「从历史上看,从来没有哪个行业里同时存在过一百家互相竞争的处理器厂商。这是暂时的,它会收敛——我看这件事有三个理由。」
- 理由一:细碎化不可持续。 先是 pre-fill 与 decode 分开,然后是 mid-fill,再然后连「早期 pre-fill」都出来了;「历史上任何一次出现这种情况,都不可持续」;转向推理模型之后,人们要的又变回「看起来更像 CPU 的东西」。他的原话是「我真的很不喜欢规模化之后的专用化」。
- 理由二:规模要花钱买。 「你得赢,你得拿到资本,得把工作负载搬上去」;「我得在规模上把这个东西建起来,而这一点本身会否掉很多异质性。」
- 理由三:赢家会挑赢家。 「一个 OpenAI、一个英伟达、一个 Anthropic 会各自说:我喜欢这一个,因为它不只是硬件,而是硬件与软件如何共同演化。」
- 拉古的反驳与帕特的回应:每一次转换期都会有一段路线大爆发,而且现在写软件层容易得多;帕特半同意——「你会看到架构把异质性藏在内部,那在我看来完全没问题,分层和抽象一直在做这件事」,但「归根到底,把这些东西做成规模仍然很难」。他把英伟达与 Groq 的交易当成「大玩家收编路线」的第一个样本(媒体 2026 年 1 月起报道,规模约 200 亿美元)。11
22:09 三十年,零种新内存
- 拉古问内存创新是不是就在拐角处,并提到上一次可能是 Optane;帕特接话:「那一个死了。」「是我们把它弄死的。」
- 他给的历史账:「我个人大概至少和五种不同的新内存架构打过交道,Optane 只是其中之一;过去三十年里产业里出现过的,我大概熟悉近百种。那么,过去三十年我们到底有过几种真正的新内存?零。」
- 他解释了为什么:「你会在某一年赚钱,然后接下来四年亏钱——谁会去一个五年里只有一年赚钱的行业做研发?」原因是暴烈的商品化周期。
- 而最近这一点变了:「三家最大的内存厂商都进了全球市值前 20 的公司」(拉古的补充);帕特自己给的是「内存产业过去四年市值增加了 2.5 万亿美元」(节目中的说法,本刊未找到同口径的独立统计)。
25:03 两个方向,和那家「还在隐身」的公司
- 方向一:堆叠。 「HBM 的『海岸线带宽』限制是一个根本性问题」,他点了 D-Matrix 与 Cerebras 一类做法,并说「未来是堆叠的」、「你得把内存和计算放到一起,用根本性的新结构」。
- 方向二:新材料。 很多人在看铁电体、找非电容式的高密度内存、找能同时做到高性能、高密度、可堆叠的那些;对低成本 Flash 那条路他不热心:「Flash 或 MRAM 结构在底层单元的速度和性能上有些问题。」
- 一句他随口给出、但信息量很大的话:「我刚刚也投了一家新的内存公司,它还在隐身状态。」(他同时是 Alva Energy、Ayar Labs、PowerLattice、Snowcap Compute、Syenta、xLight 等公司的董事或执行主席。)2
- 他的总结句:「三十年来第一次,内存创新就要来了。」
27:23 堆叠:为什么不是 16 层
- 他给的是一道数学:堆栈的价值随维度上升,这就要求每一层的良率必须指数级改善,而不是线性改善;「当你做到 8 层或 16 层堆栈,把数学一算,就变得极其、极其难——你的制造流程必须接近完美。」
- 他的判断:「会有漂亮的 3、4、5 层堆叠,中间那一层会先长起来;一个两层或四层的内存堆栈,大概就是甜点所在。」
- 他也承认冗余是存在的(DRAM 一直有坏块替换、备用行),但「如果我有一个裂开的裸片,我不在乎你在里面做了多少冗余——它就是个坏裸片」。
29:28 那个「标准件」已经有八层厚了
- 他数了一遍今天一颗先进芯片的垂直结构:计算 die(受光罩尺寸限制,于是拆成更多 chiplet)+内存堆栈(两层或四层)+供电(电源轨要走 Z 方向进来)+相当智能的 RDL 层——「把这些加起来,我那个标准件已经有大约八层厚了,这差不多是你能做到的极限。」
- 然后还要加光学:「更多 III-V 族材料的结构要靠近这个复合体,因为我想要我的 I/O 深度集成进去。」他的原话是:「那是一门工程壮举,也是一场制造噩梦。」
31:18 散热:我们工程师正在变成水管工
- 圭多的玩笑被帕特接成了正题。他讲散热的三层:不能再有今天那种物理热点;要聪明地把热铺开;同时还要把电送进去。
- 一个关键判断:如果供电做得更高效、电压响应更好,就不会制造那么多「热烟囱」——供电与散热是同一件事的两头。
- 然后才是材料:金刚石一类新材料、更靠近芯片的液冷,都在被设想之中。
32:20 把内存搬下封装、全走光,行不行
- 帕特反对,理由是一道算术:「今天每次计算的飞焦已经相当惊人,而每比特通信的飞焦相比之下要差一千倍。」(节目中的说法。)所以「我为了到达那些大内存池要烧掉大量功耗」,还要付光电转换的损耗:「我穿过一串转换器的时候,浪费了多少功耗?」
- 他的结论:「我不喜欢这些路线,我认为它们某种程度上违背了这个解法的底层物理。」——注意他反对的是「内存离芯片远去、全靠光」,不是反对光互连本身。
34:06 PIM:二十五年了,还会再晃二十五年
- 对「把计算推进内存里」这条路线,他也是否定的:那要求把工作负载拆成一小块一小块塞进内存,等于给工作负载加上约束。
- 「大多数 PIM 想法已经存在了二十五到三十年。我认为二十五年、三十年后,它们还会在那里晃着。」他要的是极好的内存带宽、高密度、高性能,而且能贴近真正的计算引擎。
- 这是他这一期里少数自认「可能是错的」的地方——他承认设计层面的智能也许会改变这个判断。
35:01 铜的死亡,与「我当初根本不该做 NVL72」
- 「我大约二十五年前就宣告了铜的死亡。最终我会说对的。」(拉古补了一句:你到现在都还没对。)他这次的证据是成本:「让铜在五米上工作,比让光学在一百米上工作还贵。」
- 他给了一句很少见的自我评价:「我当初根本不该做 NVL72——它是一件工程奇迹,也是一场制造噩梦,产业多花了一年半才消化掉那只巨兽。」
- 推论是正向的:「如果我们当时有一条更成熟的光学供应链,我们今天会先进得多。」
- 但规模这一关还在前面:「这些东西得在一千万块 GPU 的规模上工作,还得塞进封装里」,而「很多光学形式不喜欢那样的条件(散热差、封装集成、激光器产能)」。
37:28 28、29 年,才是真正的转换点
- 「如果不做这个转向,我就没法从纵向扩展环境一直扩到大规模基数的计算集群。所以显然英伟达已经指明了这一点,我认为产业里其他人也都预期那会是转换点。」
- 圭多补充:网络里已经积累了大量封装内光学的经验,其中很多会迁移到 GPU 上。(产业侧的最新进展:Ayar Labs 于 2026 年 6 月加入英伟达 NVLink Fusion 生态,做共封装光学——而 Ayar Labs 正在嘉宾的董事名单上。)212
38:24 从包交换,走到电路交换
- 这一段的判断来自斯坦福的尼克·麦基翁(帕特说他「把这件事描述得最好」;麦基翁也是圭多的博士导师):我们建网络,是为了让任何一个包能去任何地方;而 AI 做的是大而可预测的流——「那看起来更像交换,而不是包」。
- 他的落点:「我们会一路把光学带进计算复合体,也会一路走到 OCS 或某种形式的光交换。」
- 顺带把一桩旧争论判了:如果纵向扩展做得足够大,它和横向扩展的边界就会溶解掉;拉古表示同意,认为这个区分本来就是人为的。
42:51 电力:从第一性原理出发
- 「我们国家在能源容量上做得非常糟。本质上,我下线的煤电速度差不多等于我新增可再生能源的速度——整个国家的总能源容量基本上是平的。」
- 所以有了那句题眼:「在一个 AI 的数字时代,能源容量就等于经济容量。所以本质上,作为一个国家,我的经济容量已经平了十五年。」
- 需求侧的数字:「过去五年里我们看到了巨量资金涌入,只求『给我更多容量』;但即便如此,我们大概也只是把国家的能源容量做到了每年增长 4%。」(节目中的说法。作为对照,劳伦斯伯克利国家实验室 2026 年 6 月的更新报告给出的是数据中心用电一侧的口径:2030 年美国数据中心用电 649 TWh、占全国用电 11.8%,区间 521–843 TWh 即 9.5%–15.3%,对应约 148 吉瓦的并网容量需求。)13
45:15 违约、Oracle,与「上界」
- 「如果我供不上电,那建一座新数据中心、买一百万块 GPU 又有什么意义?我认为你会看到很多这样的数据中心项目一个接一个地违约,因为电根本不在那里。」
- 他点了一个名字:「我认为你已经开始看到最初的几个信号了,比如 Oracle。」(2026 年 9 月 24 日,路透社与 CNBC 报道 Oracle 就一个数据中心项目发出「不可抗力」通知,理由是电力延迟。)514
- 他的推论带着分寸:「并不是说我们会因此慢下来,但我认为人们会开始问:我真的有电去支撑我正在做的那些资本承诺吗?」
46:13 核电、800 伏直流,与「爱迪生的复仇」
- 供给这一侧,他给了一串现实:可再生能源对中国有很深的依赖;「燃气轮机的交付周期现在已经是八年」(节目中的说法);核电是他最喜欢的之一,「我们想要多建一些」。
- 关于核电他有一句话说得过快了:「美国上一次有核反应堆并网,是二十年前。」——他记错的是最近这一台的时间:最近并网的是佐治亚州 Vogtle 3 号(2023)与 4 号机组(2024);他说对的是这个行业确实空窗了二十年:Vogtle 3 号是 2016 年 Watts Bar 2 号之后美国第一台新反应堆,而 Watts Bar 2 号又是 1996 年以来的第一台。1516
- 然后是纯工程的那一段:「我们需要在输送上高效得多,还要能一路消除那么多转换环节——800 伏直流,这是爱迪生的复仇。」
- 他点名两条技术路线:垂直 GaN(「一步把 800 伏降到 48、12,甚至 5 伏」,他称其为杀手级技术)与固态变压器;并提醒冷却系统里还要再来一遍。
47:36 冷却、卡诺,与「电力又变酷了」
- 拉古那句自嘲很能说明这一期的门槛:「二十五年之后,我不得不回去重读卡诺定律。」
- 帕特的结论:「涡轮机、制冷剂,忽然之间它们又变成令人兴奋的新技术了——对我们这些做硬件的人来说,这就像一场复兴。」
48:13 CMOS 的平线,与那条超导路线
- 「最近五代英伟达芯片里,CMOS 本质上每太浮点算力的功耗并没有改善——是一条平线。这不行。」(节目中的说法。)
- 所以他押了一条更激进的:「我们有一家超导公司 Snowcap,它提供了从根本上改变物理的机会——好上一千倍的功耗表现。」(他是这家公司的董事;「一千倍」是他给的数字,不是已验证的产品指标。)
48:50 虚拟机又回来了:为代理重建 VMware
- 圭多把话题拐回三个人的共同过去:「现在,虚拟机又回来了。作为 VMware 的前任 CEO,你怎么看?」帕特的回答是一句原理:「我认为每一次创新,都通向下一层抽象。我们今天这个世界里什么是新的?数据结构、算法和抽象。」所以他仍然认为虚拟机的抽象会在计算层级里有一个位置。
- 真正的新问题在这里:「在 AI 的语境里,我们想到的是这些代理集群——那么,谁来管理这些代理?谁来为所有代理建立安全配置?谁来管理代理的性能?本质上,虚拟化与管理的每一个基本要素,都需要在这下一代计算层级里被重新造一遍。」
- 拉古把差异说得最准:「我们现在造虚拟机,是为了让它们对代理可用,而不是对人可用——你希望让代理替你的虚拟机产品做选择。」复杂度上限、形态因子、启动速度,全都要按代理重算。
- 帕特补上另一半:「我还得考虑人怎么去设定策略、怎么描述宪法、怎么拿到那些仪表盘」——他用的词是「达里奥说的那个『宪法』」,或者叫护栏。「这两件事你都得做,不只是做一件。」
- 最后他把新旧两种「硬核设计」摆在一起:当年为虚拟机做的,是把硬件高性能地抽象给应用与操作系统;现在要做的,是把硬件与运维抽象给代理。
53:04 收尾
- 拉古的道别与帕特的回礼(「你们俩是我最喜欢的人,随时都行」)之后,是节目的常规片尾与免责声明:a16z 及其关联方可能持有节目中讨论公司的投资。这一点在本期尤其要留意:本期由 a16z 自制,两位主持都是 a16z 合伙人;嘉宾是 Playground Global 普通合伙人,并任多家本期所涉领域公司的董事。12
逐句全文翻译
下面按节目原始顺序,逐句翻译整集对话。只保留中文译文,不保留英文原文;对话部分保留说话人标签:片头/主持人/拉古/圭多/帕特/片尾。
底稿是本期整集音频的完整机器转写(54:15)。这一期官方同名视频在本刊截稿时尚未上线,因此没有官方字幕可用;两位主持人由机器分离出的声部无法稳定区分,说话人归属由内容判定;片头是冷开场剪辑与旁白,其中无法确定归谁的两句标为「主持人」。全篇不压缩、不摘要、不删减;有一处音频含混、无法可靠还原,已在原位置以方括号标明并略去不译。
帕特:在一个 AI 的数字时代,能源容量就等于经济容量。如果我供不上电,那建一座新数据中心、买一百万块 GPU 又有什么意义?接下来你会看到,很多这样的数据中心项目会一个接一个地违约——因为电根本不在那里。圭多:每当有一项技术把某件事变得容易,帕特:就意味着瓶颈搬到了别的地方。现在没有一样东西还只是「一颗芯片」,它是一个机架。我花三个月把它设计出来,却要等九个月才能真正开始用它。过去三十年里,你们到底有过几种真正的新内存?主持人:零。帕特:三十年来第一次,内存的创新就要来了。大约二十五年前我就宣告过铜的死亡——对我们这些做硬件的人来说,我总有一天会说对的。这就像一场文艺复兴已经摆在你面前。至于 AI 推理加速芯片,我敢肯定我根本认不全。你们到底为什么要投那么多家?主持人:你自己也没少投。帕特:从历史上看,从来没有哪个行业里同时存在过一百家互相竞争的处理器厂商。这是暂时的吗?它会不会收敛回少数几家?主持人:又会收敛回少数几家吗?片头:但真正把它们造出来、给它们供电、再把它们连起来,可能正在变得更难。片头:在本期节目里,a16z 的拉古·拉古拉姆与圭多·阿彭策勒坐下来,与 Playground Global 普通合伙人、前英特尔与 VMware 首席执行官帕特·盖尔辛格,一起讨论 AI 基础设施的下一批瓶颈。片头:帕特带我们回到他当年设计英特尔处理器的早期——那时工程师们得自己发明造芯片所需要的工具。片头:他解释了为什么 AI 今天可能带来同样的一次转变,尽管制造周期、内存带宽与电力正在变成更硬的约束。片头:他们还辩论了专用 AI 芯片的爆发会不会持续、帕特为什么认为内存创新终于接近突破,以及光互连会怎样改变 AI 集群的架构。片头:顺着两人在 VMware 的共同历史,他们用一个问题收尾。片头:如果要为一个「主要用户是 AI 代理、而不是人」的世界重建虚拟化,它会是什么样子?拉古:我身边是我们敬重的嘉宾、亲爱的朋友,也是我以前的上司——帕特·盖尔辛格先生。拉古:欢迎你,帕特。帕特现在是 Playground Global 的普通合伙人。拉古:但你在这个行业里非常非常出名,因为你在英特尔掌过舵、当过英特尔的 CTO,当然也带过 VMware,还有很多别的经历。拉古:欢迎。帕特:嘿,谢谢你,拉古。很高兴见到你和圭多。对我来说,这感觉有点像回到老家,对吧?时间过去了一年多,但你们两个看起来一点没变。我感觉挺有精神,我们直接开始吧。拉古:你从来没有过没精神的一天,所以这不算新闻。拉古:不过我们真的从你的英特尔生涯开始聊吧。拉古:最近 Andreessen Horowitz 办了这个 Horowitz Andreessen 学院,去找 16 到 22 岁之间有天赋的人,把他们放进一个现代的教育环境里,让他们为「自己做点事」或者「加入今天的公司」做好准备。拉古:你有过类似的经历——你读的是一所普通的职业学校,然后就跳进了英特尔,当时你应该是 18 还是 19 岁,我该这么说?帕特:对,那真的是一段神奇的日子。我 16 岁,意外拿到一份奖学金。帕特:我进了技校。帕特:我跳过了高中最后一年半,18 岁的时候英特尔来招人。那时我从来没坐过飞机,在技校里已经爱上了计算机。帕特:面试我的人叫罗恩·史密斯(Ron Smith),他在自己的页面上写:我是他那天面试的第 12 个人。如果你连着面了 12 个人,到最后你根本分不清男女,对吧?我是第 12 个。他写:聪明、好斗、傲慢——他会很合群。帕特:于是我受邀来到英特尔,那段日子真是光彩夺目。我先做技术员,在 286 收尾时进设计团队,386 上是第四号工程师,486 上是架构师兼设计经理。这一切都是在我读本科、硕士和博士的同时做的。那大概是你可能拥有的最好的职业——白天学,晚上就拿去用。拉古:对,对。你在创造一个全新的芯片时代。我打赌你学到和做出来的大部分东西,中间都有很大的空隙,因为你在开辟新地。帕特:在很多方面是的。那真是行业里一段不可思议的时期。我记得有一位教授的课,他提出了一个新的超前进位加法器设计——那是我在斯坦福的一门课上。我说,我正好在做 386 的超前进位加法器,那我去试试。两天后我回到教授那里,我说:它不成立。帕特:然后我就和斯坦福的教授吵了起来。接下来两节课基本就是我和教授在争他的设计为什么不成立。他有一本书马上要出版,里面印的就是那个设计。这让人非常恼火。拉古:对他来说时间还很紧。帕特:对他就很要命。后来我们开始做内建自测试。我记得斯坦福的埃德·麦克拉斯基(Ed McCluskey)是我的教授,他算是这个方向之父。我们就「他的大部分想法为什么不行」吵得很痛快——那些想法对真正的芯片并不实用,而我把内建自测做在了 386 上。约翰·轩尼诗(John Hennessy)是我的论文导师,显然他后来做得不错。帕特:我帮了他的事业。他当了校长,之后干得相当不错。圭多:这种争论,我在斯坦福教书的时候也遇到过同样的经历。你带着一个你以为是真理的东西来,然后一个在产业里做过的人过来说:其实不太对。圭多:于是下一次上课你回来说:好吧,我查过了,你是对的,这确实过时了。帕特:对,我跟你说,作为这种互动的一部分——我觉得这正是硅谷如此独特的原因之一。这里公司多、创业多,创业精神就像在水里一样。开公司、出新想法、挑战教授。而在斯坦福这样的地方当教授,你不能指望不被人挑战,还要享受它。那座象牙塔的门口人来人往。拉古:对。……486 是你的大……拉古:对。拉古:……成就,如果你愿意这么说的话。显然很多人参与了它。拉古:你们在芯片设计上在那里开了新地,对吧?拉古:还增加了芯片要做的事,等等等等。帕特:对,那也是一段相当神奇的时期,因为那还在你所谓的 EDA 产业出现之前。拉古:噢,哇。对,是这样。帕特:在 386 的尾期有一点,但 486 真正是第一颗实现了你所谓现代 EDA 技术的芯片。我们做了高层次设计——一份描述,一份 RTL 描述——但当时没有 Verilog。帕特:所以我们发明了 HDL,英特尔的硬件描述语言。拉古:噢,哇。你自己写了一门语言。那你还得给这门语言写一个编译器,对吧?帕特:于是我们给这门语言做了编译器。当时没有自动布局布线,所以我们得把它发明出来——我们和伯克利的阿尔贝托·桑乔瓦尼-文森特利(Alberto Sangiovanni-Vincentelli)以及他的几个学生一起,做了第一次布局布线、第一次自动时序管理。拉古:所以他们把 EDA 做成了某种东西。帕特:在很大程度上是的。那确实是标志之一:486 不只是一种兼容的流水线微处理器,我们还开了很多后来成为现代 EDA 产业基础的先河。那是行业里一段相当神奇的时期。拉古:对,对。如果看今天,人们以后回看 Blackwell 的时候,会不会说:这是 AI 接管设计流程之前的最后一代?我们现在是不是处在一次类似的转变里?帕特:我认为确实有那方面的成分。当你看今天像 Jalapeño 这样的东西,你会说,那算是 AI 在芯片设计流程里从第一性原理出发的一次使用。在那个流程里,我们丢掉了很多老做法。不过,设计里还有一些部分仍然非常难。比如很多模拟方面的东西,SerDes 大概是最好的例子,它们仍然没法交给 AI——你需要大量硅数据才能把它做好。所以你要么把模拟设计做得足够保守,保守到能让 AI 来做;要么就得用笨办法硬做。帕特:不过很多逻辑功能真的可以用 AI 工具和技术以相当惊人的方式完成。你的晶体管预算够大,设计工具越来越聪明,再加上少数几位专家引导工具怎么用。我真的觉得,在这一点上它会有几分像 486。我们回头看时会说:对,那就是芯片设计新时代的开始。圭多:每当有一项技术把某件事变得容易,瓶颈就会搬到别的地方。圭多:我们能不能猜一下,未来的瓶颈会落在哪里?有些事看起来 AI 极其擅长,对吧?比如做软件层、写 kernel,很多……圭多:我觉得很大一部分是「能在更高的层次上把目标说清楚」,然后它被翻译成很长的(东西)。那新的前沿是什么?往前看,什么东西会变得很难?帕特:好,你看今天——假设圭多和我一起去造一颗很棒的芯片,我们要做的是 AI 那颗。对,它会是那颗飞跃的东西,因为我们理解 AI。二〇三六年……拉古:还有二四八六年。帕特:我们理解 AI 工作负载,于是我们理解怎么把它组成正确的乘法、累加、寄存器结构。拉古:还完全看得清明天的模型工作负载。帕特:对,所有这些。帕特:然后假设我们放开 AI 工具,我们很棒:三个月内,我们有了一个出色的设计。帕特:为了做到这一点,我们在模拟的部分上做得保守了一点。帕特:但现在,我们面前还有几个真正的大瓶颈。帕特:第一个是,我们仍然有九个月的硅工艺时间。拉古:对。帕特:大概就是这样。所以我可以在三个月里把东西设计出来,但要九个月才能真正把它变成规模化的真硅。这很糟。帕特:所以如果我们想要这种创新,就必须看到这个瓶颈改善。帕特:因为我们知道——拉古:你说的是验证阶段,还是更往后?帕特:首先,我没法在三个月以内从晶圆厂拿到任何东西——这还是在假定我有一条「火力全开」的设计流程的前提下。所以我说,我怎么把它压下来?然后我还得进先进封装,3D 封装越来越复杂,那又是大约三个月。再然后我得把它做成机架级的方案,因为现在没有一样东西还只是芯片,它是一个机架。所以加起来是九个月。我花三个月设计,要等九个月才能真正开始用。那么我们怎么开始压缩设计的这些环节?我认为我们需要新形式的曝光来支持它。我们需要不需要在进入原型之前就付五千万美元掩膜成本的设计流程。对我来说,问题是怎么把它压到一两个月?因为我现在可以在三个月里完成设计。但如果我要等一年半才真正拿到规模和软件,那我对 AI 工作负载的理解就已经不适用于我设计的这颗芯片了。拉古:对。……我们在 AI 芯片上正亲眼看着这件事发生。帕特:对。从历史上也能看出来。就像 Graphcore——它不是个糟糕的设计,但世界往前走了。所以所有这些环节,某种程度上都抵消了「AI 让设计这一段变容易」这件事。帕特:所有这些制造与规模问题,在我看来变成了一个巨大的瓶颈。另一个瓶颈当然是内存。拉古:对。帕特:内存带宽。我们注意到,拉古:对。帕特:在那方面,就像我说过的,HBM 是一种难看的内存。它只是我们现在手里最好的那一个。拉古:我正想问你这件事。帕特:它是一种糟糕的内存。位密度很差,我被限制在「海岸线带宽」上,还有功耗问题、散热问题。DRAM 不喜欢热。
帕特:把这些东西全集中在一个地方。圭多:全集中在一个地方。对,这很糟糕。帕特:把(所有东西)放到一个点上,很难。而 AI 是一份内存计算型的工作负载。帕特:对,就是这样。所以对我而言,我得把开发与实体化压缩到真正的规模上,我得把与之配套的内存问题解决掉。所以在我看来,那是另外一个我们必须攻下的关键瓶颈。帕特:还有电力,对吧?供电、散热,而今天绝大多数功耗仿真的做法都很差。帕特:对。你没有好的三维建模工具来给功耗做模型——功耗耗散、热点等等。帕特:我的输入电压,我基本上是在为我整个功耗包络留保护余量(guard banding)。拉古:对。帕特:于是本质上我在保护余量上损失了 40% 的功耗。所以我必须在功耗建模上大幅进步,而且我的功耗耗散技术也很差。圭多:交付的方式也得跟着变。帕特:对。所有这些东西,在我看来就是接下来的大瓶颈。我怎么把每一个都改善?如果我做到了,好,那我们就进入下一个激动人心的时代。所以,谢谢那些了不起的 AI 工具。但即便它们完全铺开,我依然面对巨大的挑战。圭多:于是……圭多:我们看到芯片数量和芯片架构都出现了一次复兴,靠的就是这些工作负载。帕特:对,现在有一百种 AI 推理加速芯片,我敢肯定我根本认不全。帕特:那么……帕特:你们到底为什么投那么多家?拉古:你自己也没少投。拉古:它们做的是不同的设计假设——要么在你说的那些部件上,要么在它们瞄准的帕累托曲线上所处的位置上。拉古:那你觉得这些全都装得下吗?还是说,部分因为圭多讲的 AI 工具,我们现在有能力造出更多种类不同的芯片?拉古:而且这个市场无论如何都足够大。帕特:我把它说得更尖锐一点:从历史上看,从来没有哪个行业里同时存在过一百家互相竞争的处理器厂商。这会是一个更异质的未来吗?这是暂时的吗?它会收敛回少数几家吗?我认为它更像是暂时性的,而且会收敛——这是我预期的事。我看这件事大概有三个不同的理由。帕特:第一个理由,是你在计算环境里看到的那种正在出现的异质性:现在我有专门的 pre-fill 和 decode 之分。然后人们又说,我们真的需要一个专门的 mid-fill 层级,而不只是 pre-fill。于是现在有了提前的 pre-fill,又有了 mid-fill,它们各不相同。拉古:也许可以推测一下并验证,如果我们帕特:听听 OpenAI 这边怎么说?对吧。然后忽然之间,我的算力机队会按工作负载变得越来越细碎。帕特:而我认为,历史上任何一次出现这种情况,都不可持续。然后忽然之间,随着你看到这些,人们会说:当我要转向推理模型时,我想要一个看起来更像 CPU 的东西。所以忽然之间,我不想要那一层了——它没有成为我算力容量的主要部分。我需要的是这边更多一些,还有模型工作流等等。帕特:我真的很不喜欢——我这么说吧——「规模化之后的专用化」,因为我认为工作负载会继续大幅地缓和与迁移。帕特:第一……第二个理由是,我认为今天的模型即将经历一些演化上的突破。帕特:我认为 LLM 正走到它的边界。现在人们开始看:我到底怎么给三维的东西建模?帕特:当你要处理分子、化学物质和成像时,一个扁平化的 LLM 表现并不好。我认为我们会看到它的极限,而那种极限会在算法领域造成不同的转向。我还认为,一些最有趣的工作负载,会出现在你开始把类 HPC 的东西带回类 AI 的东西里的时候——忽然之间,64 位精度又变得重要了。拉古:那会是什么样子?帕特:想象一下,我的 AI 模型现在正在归纳一次化学分析里最值得做的五个领域。帕特:对吧?那些化学算法会以高精度运行,而那会成为工作负载里的主要部分——是「走到我需要跑的那五个算法」,还是「在化学或生物系统上真正跑那五个算法」。所以我确实认为,当我们优化自己的 AI 系统时,它们会把我们带回一些更传统的高性能计算里去。我看得到工作负载的这一面。所以,话说回来,这种在计算架构上极端的专用化,我是不太喜欢的,因为我不认为两三年、三四年后工作负载还长这样。帕特:所以这是一条理由:我不认为所有这些 AI 芯片,随着它们为算力工作负载的各个部分变得越来越专用,就一定能成立。帕特:第二条理由是,现在有一百家左右——有做光学的,有做概率计算的,等等。而它们不会全都赢。帕特:它们不会全都赢,因为归根到底,你得在这些东西上拿到规模。帕特:而规模要求你必须赢,必须拿到资本,必须把工作负载搬到它上面。所以我认为「会有一百家并存」这件事本身就违反逻辑。它们会因为简单的资本市场份额之类的原因收回来——谁是有赢面的团队、有赢面的设计、有赢面的架构。所以我认为工作负载会驱动这件事,产业里自然的整合会发生。然后我还预期,赢家会去挑出一些赢家。帕特:比如一个 OpenAI、一个英伟达、一个 Anthropic 会说:我喜欢这一个,因为它不只是硬件,而是硬件与软件如何共同演化。而我确实预期会有——「这是我为这件事能挑的十个,我喜欢那一个」。帕特:而它确实需要在软件和工作负载演化上的投入,才能把那些平台用起来。所以基于这三条理由,我们会看到这个领域在这个意义上收窄。拉古:还有部署的复杂度。帕特:抱歉,你说。拉古:这完全说得通,我在大部分上同意。不过我还是想在这里搅一点争议出来,就当是……你,圭多,搅争议?(笑)算了。你们俩改变了它,对吧?拉古:显然,一百家公司意味着更多的可获得性,它们会整合,对吧?我完全同意你的论点:归根到底,大型消费者会在某种程度上挑出赢家。今天,我认为要在某种程度上算得上一家一流的芯片创业公司——不管你究竟是不是——定义你的,是你跟那些真正的大玩家之间有多少牵引力。拉古:话虽这么说,也有一种说法是:在任何一种过渡期里,你可能都会看到更多不同路线的爆发。但话又说回来,我认为你可以提出一个论点:历史上我们之所以标准化在一两种架构上,是因为不同的指令集太难了——我们得为它们建多个编译器。基本上是软件复杂度决定了你只能拥有很少几种硬件平台。我不知道……而现在构建软件层要容易得多,能充分利用这一点的……拉古:那这是否会导致我们拥有稍微多一点的异质性——仅仅因为给这种异质性编程变容易了?帕特:我确实认为它会改变瓶颈落在哪里,在这一点上会有变化。第一个瓶颈就是我前面已经说过的那个:造出这些东西仍然要一年半。第二个瓶颈是,不仅把它们送进机架、做出规模要一年半,而且现在还要让它们有用——谢谢——好吧,我能借五百亿美元吗?帕特:我是说,你说的不是小额资本开支。你说的是非常大的资本开支:数据中心、电力、各种承诺。我得在规模上把这个东西建起来。而这一点本身会否掉很多异质性。显然,大玩家——我们看到英伟达对 Groq 做的事——好吧,我们会把一部分异质性收归自己。两年之后,你根本看不出英伟达里面的 Groq 是什么,它就会像是另一个……帕特:对吧?大概是这样。所以你会看到架构把异质性藏在内部,这在我看来完全没问题。那就是分层、那就是抽象一直在做的事。但我认为那些力量很强,会把……帕特:很多异质性——不对,对吧?我认为它会被抽象到下面去。但归根到底,把这些东西做成规模仍然很难。拉古:你之前说 HBM 是一种难看的内存。帕特:但它至今是我们手里最好的那一个。拉古:确实。拉古:我们都想不起来上一次内存创新是什么时候了。也许是 Optane。我想你大概跟它有点关系。帕特:对,那一个死了。那一个死了。拉古:是我们把它弄死的。帕特:对,我们把它弄死了。拉古:所以你觉得内存创新……拉古:就在拐角处了吗?或者说需要发生什么才行?显然我们理解规模问题,因为那里的规模帕特:还要更大拉古:(对,)那里的规模还要更大。拉古:但先把规模放到一边,就算只从技术的角度讲。帕特:对,我们来看看这段历史。我个人大概至少和五种不同的新内存架构打过交道,Optane 只是其中之一——它没能见到天日。帕特:过去三十年里产业里出现过的(新内存),我大概熟悉近百种。帕特:那么在过去三十年里,我们到底有过几种真正的新内存?帕特:零。帕特:对吧?DRAM、SRAM、Flash——好,还有别的吗?就 DRAM、SRAM、Flash。拉古:Flash 堆叠还撑了一阵子。帕特:勉强。拉古:对。帕特:对。不过说回来,我们没有创造出下一种物理机制——能带来低成本、高性能、可靠、可制造的内存——这确实让人失望。拉古:对吧。帕特:所以我确实认为……而且过去三四十年来,内存是一个糟糕的行业,拉古:对吧?帕特:因为你会在某一年赚钱,然后接下来四年亏钱。谁会去一个五年里只有一年赚钱的行业做研发?它一直极其困难,因为被那种暴烈的商品化周期驱动。不过最近这一点有点变了。过去五年里?拉古:好日子,老兄。拉古:三家最大的内存厂商都进了全球市值前 20 的公司。这是一个疯狂的变化。帕特:就是啊,谁能想到?而任何看 AI 工作负载的人都知道,这越来越……预测过去容易,预测未来难一点。但你看它,就会说:AI 内部就是一份内存工作负载。所以我认为,是资本与技术的需求合在一起,会给内存创新一个理由。帕特:现在有两个方向让我兴奋。一个是我确实认为 HBM 的「海岸线带宽」限制是一个根本性问题。所以显然我们有一家公司 D-Matrix 在做这件事,但我认为别人也会——不管是 Cerebras 还是他们的技术。未来是堆叠的。对。总之你得把内存和……拉古:你得把内存和计算放到一起。帕特:对,用根本性的新结构。我确实认为,考虑到现在 AI 领域往工作负载上压了这么多资本,帕特:我们其实能够突破其中一些物理挑战。帕特:所以我相信——而且我刚刚投了……(拉古:你岔开话题了。)我刚刚也投了一家新的内存公司,它还在隐身状态,但是,拉古:你……帕特:我对新内存里将要出现的某些创新相当兴奋。你会看到内存的新材料。很多人在看铁电体,在找非电容式的高密度内存,找能同时做到高性能、高密度、可堆叠的内存。也有人在看低成本 Flash。我个人对那个想法不太热心——我认为 Flash 或 MRAM 结构在底层单元的速度和性能上有些问题。但我确实认为,三十年来第一次,内存创新就要来了。我也确实认为那会是一个激动人心的领域。我们肯定会有几家公司在那里,对吧?我们会一起做上几家。但愿如此。你知道,这话听着像预言。好吧,不过我们总会在这里找到一些事可做。
拉古:对,对。真是惊人——等我们把市值做成几百亿之后,那点市值增长算什么。帕特:一千亿。真的。好,抱歉。你知道,我认为内存产业在过去四年里,市值增加了 2.5 万亿美元。帕特:我觉得差不多是这个数。拉古:那我们干脆投那里就好了,根本不用帕特:做任何风险投资。对,正是,轻松钱。拉古:多久?你怎么看?抱歉,你请说。稍微展开讲讲堆叠那部分——如果让你预测,我们的芯片会多快变得更高?拉古:这会像是:我们去到两层,然后在那里坐一会儿?还是我们会有那种 16 层的三明治,愉快地把逻辑、帕特:内存和 SRAM 混在一起?HBM 已经做到了。〔此处音频有一句含混,无法可靠还原,略去不译。〕但你打算怎么让它演化?帕特:你知道,堆叠的问题是:本质上,堆栈的价值会随着维度升高而增大,这意味着堆叠过程里任何一层的良率都必须不断上升——而且不能是线性的,必须是指数的,缺陷特性也必须以指数方式改善。当你做到 8 层或 16 层堆栈,把数学一算,就变得极其、极其难。你的制造流程必须接近完美。拉古:不过你也能看到一些把特定模型类别考虑进去的设计——就像我们在二维平面上早就见过的那样。帕特:对,当然。但记住,那正是 DRAM 的本质:你一直有坏块替换、备用行之类的东西。所以这完全不是在贬低它。但假定你这么做,你仍然需要良率好到那种程度。如果我有一个裂开的裸片,我不在乎你在里面做了多少冗余——它就是个坏裸片。所以正因如此,我不是那种痴迷 16 层、32 层堆叠的人。我认为会有漂亮的 3、4、5 层堆叠,它们最终成为甜点,中间那一层会先长起来。我预期一部分取决于制造,一部分取决于复杂度,还有那些良率甜点落在哪里。所以我认为大多数东西会落在那里。帕特:但即便在那里——假设我现在有了一个很棒的计算 die。帕特:那么这个 tile 需要多大?我是说,现在一切都已经变成受光罩尺寸限制的了。我能不能走向更多的 chiplet,换来更好的良率、更好的散热?然后你会说:我要在那上面放一个内存堆栈。它是两层堆栈还是四层堆栈?帕特:我不认为它会变成八层堆栈的内存。所以对我来说,两层或四层差不多是对的。但接着供电也得整合进去,那又成了另一个元素。我想要它在 Z 方向里,因为我想要我的电源轨也从这里进来。帕特:然后我需要相当智能的 RDL 层在那整个平台上分配信号。所以某种程度上,当我把这些东西加在一起,我那个「标准件」已经有大约八层厚了。我认为这差不多是你能做到的极限——至少按我们今天对制造的理解。然后当然,我们预期光学要进来,所以你会看到更多 III-V 族材料的结构离这个复合体更近,因为我想要我的 I/O 深度集成进那个构造里。所以以硅为中心的那些部件,需要被这些 III-V 族材料补上。怎么把光连接做进去?怎么把电源轨做进去?那是一门工程壮举,也是一场制造噩梦。但物理在时间里正把我们带向那里。所以正因如此,往里面扔一个 16 层堆栈——那太疯狂了。帕特:一个两层或四层的内存堆栈,我认为那大概就是甜点所在。拉古:你还没讲散热,以及为此需要的新材料。帕特:对,对。显然会有很多……首先是,你不能再有今天那种物理热点。帕特:所以你必须更聪明地使用热、铺开热。然后你还要问:我怎么能既把电送进去、又把热散出来?顺便说,如果我能在我要的电压上以高效得多的方式送电,并且有更好的电源响应和电压调节,我就不会制造那么多热烟囱。但我确实得想:我怎么冷却这些东西?新材料、金刚石之类被设想为更好的散热手段,它们扮演什么角色?我怎么把更好的液冷技术贴在上面,并让它有好的热特性?圭多:对,我们工程师正在变成水管工,对吧?拉古:正是。拉古:你得去操心芯片尺度上的热界面问题。让我问你一个很显著的现象:有人说,干脆把内存从封装上拿下来,让计算和内存之间全部走光。那样会给你更多自由度和更多搭建方式。拉古:相对于堆叠这个另一个极端,你怎么看?帕特:对,我认为你核心计算复合体里要求的 O-E-O 接口越多,在我看来就越难,而且总会有损耗。人们正在努力想出更聪明的技术来同时降低成本与功耗。帕特:我穿过一串转换器的时候,浪费了多少功耗?帕特:所以我不喜欢那些方案,因为我认为它确实让你访问到大的内存池,帕特:但我为了到达那里要烧掉大量功耗。拉古:对。帕特:而且记住,本质上今天每次计算的飞焦已经相当惊人了。帕特:而每比特通信的飞焦相比之下要差一千倍。帕特:如果我为到达那些大内存池要花这么多,那我就不喜欢这些路线。我自己认为,它们某种程度上违背了这个解法的底层物理。拉古:那么还有那种……拉古:另一种思路:我们能不能把计算和内存直接集成起来,把一部分计算挪进内存里?拉古:就是那些 PIM 路线。帕特:对,正是。那么拉古:你怎么看?帕特:我也不喜欢那些。因为我认为……现在我得把我的工作负载拆成一小块一小块的计算推进内存里去,这样我从真实计算那里需要的带宽就可以少一些。而这会给工作负载加上约束。再说一次,我在这件事上可能是错的,尤其是考虑到我们现在通过设计层面能带来的灵活性和智能。但大多数 PIM 想法已经存在了二十五到三十年,我认为二十五年、三十年后它们还会在那里晃着。对我来说,给我极好的内存带宽——高密度、高性能,而且能贴近真正的计算引擎——我预期这会是一个更能泛化到许多不断演化的负载上的解法。拉古:对,所以我们仍然受困于……拉古:越来越密的芯片、更多计算、更多逻辑、更多功耗。帕特:以及好得多的 I/O。现在,我是把一切 I/O 功能转向光学的巨大拥趸——我大约二十五年前就宣告了铜的死亡,最终我会说对的。拉古:你到现在都还没对。帕特:很快有一天我会说对的。但在我看来,所有的 I/O 都应该转向光学。可是那个核心的「计算—内存」复合体不一样,对吧。拉古:走向光学的第一步是纵向扩展,甚至比横向扩展更是如此。你怎么看这一点?帕特:对,我认为我们现在正看到……拉古:如果要说的话,驱动它的工作负载会是什么?帕特:我认为驱动它的工作负载就在我们眼前。拉古:好。帕特:对吧?我是说,今天我们的纵向扩展环境里塞了海量的铜。而本质上,铜正在变成一条越来越短的波导……忽然之间,让铜在五米上工作,比让光学在一百米上工作还贵。所以我认为,物理今天就在把我们往那里推。既然是这样,帕特,我们为什么还没转过去?因为那是一条复杂的供应链,从没在规模上被验证过。我认为现在所有人都在看某种形式的 NPO、CPO 等等,帕特:在 28、29 年这个时间窗里,因为如果不做这个转向,我就没法从纵向扩展环境一直扩到大规模基数的计算集群。所以显然,英伟达已经指明了这一点。我认为产业里其他人也都预期那会是转换点。现实中,我当初根本不该做 NVL72。帕特:它是一件工程奇迹,也是一场制造噩梦。产业多花了一年半才消化掉那只巨兽。而它真的能被做到规模,确实了不起。帕特:但这也确实证明了:如果我们当时有一条更成熟的光学供应链,我们今天会先进得多,能造出更好的纵向扩展环境——更好的功耗、更好的成本、更好的能效。可我们当时没有成熟的光学供应链。那些东西并不容易解决,有很多工作要做,但我认为 28、29 年就是那个年份。拉古:晶圆厂产能。好的一面是……我们在网络里拉古:积累了大量关于封装内光学如何工作的经验,对吧?我认为其中很多会很好地帕特:迁移到 GPU 上。我确实这么认为。但忽然之间,问题是:这些东西得在一千万块 GPU 的规模上工作。帕特:哇,对吧?它还得塞进封装里。那里有一大堆事,而且很多光学形式不喜欢那样的条件。帕特:可是你猜怎么着?散热差就是它的本性。所以我们要处理散热问题、封装集成问题,产业里也没有足够的激光器产能。一堆事情。但我看不出那里有什么根本性的障碍——只是此刻要把这些碎片拼起来,需要大量艰苦的工作。而在网络架构方面,拉古:这是否也意味着要转向更接近电路交换的网络?仅仅因为,你没法无限制地把这些极快的光网络扩大下去。帕特:对,我喜欢……尼克·麦基翁(Nick McKeown),也是斯坦福的一位教授,我的好朋友。拉古:圭多也认识他一点。拉古:他是你的论文导师吗?圭多:他是我的论文导师。拉古:对。帕特:所以,他把这件事描述得很好:我们建网络,是为了让任何一个包能去任何地方,而完全不知道它可能去哪里。帕特:当你想到 AI 时,几乎正好相反:我们做的是大而可预测的流。帕特:所以在这个意义上,光是这个描述就在说:嗯,那看起来更像交换,而不是包。帕特:所以我确实认为,转向光学、以及拥有一个可预测得多、可管理得多、流量大得多的工作负载,这两者的汇流……在我看来,是的,我们会一路把光学带进计算复合体,也会一路走到 OCS 或某种形式的光交换,配上更可预测的流量。对我来说,那才是正确的架构。帕特:然后你会问:那算纵向扩展还是横向扩展?帕特:某种程度上,如果我的纵向扩展……拉古:我正想说,它有点把那里的边界溶解掉了。帕特:对。如果我的纵向扩展足够大,那么,对,问题就变成:我的纵向扩展环境里的基数是多少?以及我什么时候想把它接到别的、真正大的集群上去?对我来说,那最终会是一个相当漂亮的未来答案。但我面对的是一位在这件事上比我专业得多的人,所以……拉古:不,你看,我一直觉得纵向扩展在某种程度上是一个人为的区分。你也明白它是怎么来的,对吧?因为我们用着不同的协议——一个是前端网络,一个是后端网络。所以实际上,它现在确实是个很大的区别。但如果你退一步,从系统架构的角度看,它们达成的是同一个目标,只是风味略有不同、协议略有不同,我认为时间久了它们会汇合。拉古:对,尤其对 AI 训练负载来说,帕特:对,尽管训练和推理看起来得相当相似,推论那边的语料就没那么相似了。帕特:对,现在我要说——你的大脑会停止学习吗?帕特:顺便说,这是工作负载演化的另一个特征。我确实认为,往前看,训练与推理的分野会变得更小,而不是更大。这也算是对「越来越多异质架构」的一个反对论据:我认为会出现持续学习;会有一些算法领域说,是的,持续学习成为算法的本质——在那里,我确实希望我的推理环境在更新我的模型权重,因为那给了我越来越精细的演化,也会把负载推进到更不正式的训练环境里去;那些环境里的数据集会更小。所以我不确定那是不是一个……拉古:但比如说,为了有用你需要的节点数量,直径更小。那是训练的意义。今天这是真的。拉古:我是说,我仍然认为异质性可能从另一个角度有它的位置,那就是……拉古:不同类型的 AI 工作负载需要非常不同的底层架构。比如有些更受算力限制,有些更受内存带宽限制。还有小的扩散工作负载,对吧?适合它的最优卡,看起来和一张顶级的、承载着 15 万亿——抱歉,15 万亿参数权重的 LLM 的卡非常不同,对吧?后者意味着极大的规模。所以我认为那帕特:反而可能会驱动异质性。对,我认为那方面有一些空间。但我也会说:好,现在我说的是在我的数据中心里让一百万块 GPU 干活,对吧?你说,对那个特定的扩散负载,我真的应该放一些按这种方式优化的东西。于是我现在往里面放一千块那种;而对那个负载我需要两千块这种;忽然之间,你就拿不到规模带来的某些灵活性了——管理、升级、连接、故障域,所有这些要花我多少钱?(拉古插话:代理会把所有升级都做完,所以那不再是问题。)对,对,对。谢谢。一切都变容易了。那好。拉古:对,所以机队管理就这么解决了。拉古:对。拉古:那我们聊到哪了?计算、内存、网络,接下来是电力。对。你在芯片上、芯片内部的垂直供电里也提到了它。拉古:但我是说,还有 800 伏直流,还有到数据中心的供电。拉古:有一整个生态,一直到……拉古:发电,以及它的社会政治维度等等。那么,创新从哪里进来,哪里又纯粹是执行?帕特:如果我们从第一性原理出发:我们国家在能源容量上做得非常糟。帕特:本质上,我们经历了十到十五年,我下线的煤电速度差不多等于我新增可再生能源的速度。整个国家的总能源容量基本上是平的。帕特:这不好。
帕特:因为在一个 AI 的数字时代,能源容量就等于经济容量。帕特:所以本质上,如果你接受这个论断——我认为它非常可被证明——作为一个国家,我的经济容量已经平了十五年。帕特:过去五年里,我们看到了巨量的资金涌入,只求「给我更多容量」。帕特:但即便有这些,我们大概也只是把国家的能源容量做到了每年增长 4%。拉古:差不多是那样。帕特:从基本上零到一,对吧?哇,四倍或者 4%。所以对我来说,那是个糟糕的局面。我们需要的是更多能源容量。所以第一,显然我们在那个领域有一些公司——我们聊到过 Alva 的核能运营。我认为核电作为一种基荷电是非常好的东西,我们想要多建一些。可惜我们所有的可再生能源都对中国有很深的依赖,这非常不幸。帕特:另外,燃气轮机的交付周期现在已经是八年。帕特:对吧。所以,我们真的要快速扩规模,面对的是一个很困难的环境。但第一,我们就是需要更多容量。圭多:而且圭多:从根本上说,能源容量在某种程度上压制了我们在 AI 上能有多亢奋。帕特:对。因为如果我供不上电,那建一座新数据中心、买一百万块 GPU 又有什么意义?帕特:我认为你会看到,很多这样的数据中心项目会一个接一个地违约,因为电根本不在那里。圭多:你觉得那会是一个显著的逆风吗?帕特:我认为它会是一个逆风。而且我认为你已经开始看到最初的几个信号了,比如 Oracle。帕特:我认为那只是你将要看到的许多个之中的第一个。并不是说我们会因此慢下来,但我认为人们会开始问:我真的有电,去支撑我正在做的那些资本承诺吗——为数据中心的机架、为 GPU 采购?所以我确实认为它会形成一个上界。帕特:但我们需要更多能源容量,我们需要往里面投入更多创新,而且我们需要更多这样的供应链在美国。帕特:核电,是我最喜欢的之一。美国上一次有核反应堆并网是什么时候?那是二十年前了。对。我们就这样停掉了一个非常有能力的产业。所以这就是为什么我们需要更多。帕特:我们需要在输送上变得高效得多,也就是电网。而且就像你说的,转向 800 伏直流的数据中心。我绝对赞同。还要能一路消除那么多转换环节——那些环节是因为历史上和标准化的原因留下来的。好吧,我们得把这件事修好。800 伏直流,这是爱迪生的复仇。对,我正想说这句。帕特:对,我喜欢这么说。帕特:所以我确实认为,最终会落到:我们需要更好的电源转换。帕特:我们手里有几家公司,其中一家做垂直 GaN,我认为那会是一门杀手级技术——能一步就把 800 伏转成 48 伏,或者 800 转 12,甚至 800 转 5。那会给你多得多的能量。帕特:我们还提到过固态变压器。对,所有这些都是:固态变压器、开关等等,重建整个供电网络。我认为那里会有很多创新——像是「电力又变酷了」,对吧?帕特:往前走。然后你在冷却系统里也需要所有这些。帕特:对,所以那里也会有一大堆创新:涡轮机、制冷剂,忽然之间它们又变成令人兴奋的新技术了。所以对我们这些做硬件的人来说,这就像一场复兴,就在眼前。拉古:二十五年之后,我不得不回去重读卡诺定律。帕特:卡诺效率。噢对,这可是好东西。拉古:第一定律是怎么说的来着?对,对。那里的物理说不定终究还是值点钱的。帕特:所以从这个方向看,那会是一段激动人心的时期。但我们也会说,我们需要改变物理本身,帕特:对吧?因为最近五代英伟达芯片里,CMOS 本质上每太浮点算力的功耗并没有改善——是一条平线。这不行。而这就是某些东西的用武之地:我们有一家超导公司 Snowcap,它提供了从根本上改变物理的机会——好上一千倍的功耗表现。所以我确实认为,其中一些创新在不久的将来就会到来。圭多:过去这一小时,我在时间管理上做得糟透了。圭多:还有那么多话题没聊,但走之前我们至少得聊一个。帕特:好。圭多:好,那么……帕特:你说了算。圭多:对,我也这么想。圭多:现在,虚拟机又回来了。圭多:你怎么看这件事?作为 VMware 的前任 CEO。拉古:我感觉自己被排除在这场对话之外了。圭多:不不不,我只是……其中一部分是我本来也想聊聊网络的。不过我想我没那个时间了。帕特:嘿,我认为每一次创新帕特:都通向下一层抽象。帕特:我认为这些想法里的很多——我想说的是,我们今天这个世界里什么是新的?数据结构、算法和抽象。帕特:我们回到那些最基础的东西上。我认为虚拟机的抽象,不管它是从基础设施层做,还是从应用层做,仍然是一个基础性的抽象模型,它在计算层级里永远值得有一个位置。所以你怎么看?我们俩谁回去再把 VMware 跑一遍?拉古:对,这就是我跟圭多说的:是时候回去再把 VMware 跑一遍了。帕特:而且我确实认为,其中一些抽象……你也会想到:我们在 VMware 做的一件事,就是我们基本上管理了计算层级的每一个方面。帕特:你管理工作负载,你管理网络,你管理存储系统,然后你怎么把它们抽象出来?我认为在 AI 的语境里,我们想到的是这些代理集群(agent swarms)——那么,谁来管理这些代理?帕特:谁来为所有这些代理建立安全配置?谁来管理这些代理的性能?本质上,虚拟化与管理的每一个基本要素,都需要在这下一代计算层级里被重新造一遍。而会有很多很了不起的公司,会在这里做出突破。圭多:好。你想以网络这个话题收尾吗?拉古:其实我更想再多聊一会儿虚拟机。好。拉古:对我来说最有趣的一点是,我们现在造虚拟机,是为了让它们对代理可用,而不是对人可用。而我们在一些别的公司身上看到的是:这件事改变了很多——形态因子改变了很多,你怎么把它们卖出去也改变了。你希望让代理替你的虚拟机产品做选择。拉古:它能承受多少复杂度改变了很多。启动应该多快也改变了。人比代理有耐心得多。所以如果今天要重建 VMware,它会有什么不同?帕特:对。拉古:我确实认为……一个「为代理而设的 VMware」,对吧?帕特:对。我确实认为——它需要是一个「为代理而设的 VMware」,还是「为人而设的」?帕特:对,我明白你的意思。是的。在某种意义上,我需要人。但我们还是聊代理吧,它们眼下比另一个有意思得多。拉古:对。帕特:但我认为这是一个重要的点,因为我确实认为需要有——我用达里奥说的那个「宪法」,或者叫护栏,或者叫能设定策略。帕特:然后你真的会说:好,虚拟机的每一个方面,我们今天所知道、所喜爱的那一切,它是在为代理服务。帕特:对吧。而不是在为硬件和人服务。所以我认为,这成了你这一侧根本性的设计约束:我怎么让代理变得优秀?帕特:我怎么让它们安全?我怎么让它们高性能?我怎么把它们抽象出来?我怎么迁移它们?所有这些东西都有了新的载体——这里的「动作」是为代理设计的。帕特:这些东西每一个都会有新的载体。但与此同时,我还得考虑人怎么去设定策略、怎么描述宪法、怎么拿到那些仪表盘。我认为这才是有意思的地方,因为这两件事你都得做,不只是做一件。而最根本的一点是:我们当年为虚拟机做的那种硬核设计工作,是把硬件以一种高性能的方式向应用或操作系统抽象出来;而这里的硬核设计工作,是把硬件和运维向代理抽象出来。拉古:你服务的对象变了,这是一件根本性的事。聊得非常好。非常感谢你过来,帕特,我们下次再来一次。帕特:你们俩是我最喜欢的人,随时都行。拉古:好。帕特:这期很精彩。谢谢你。谢谢。片尾:感谢收听本期 The a16z Show。如果你喜欢这一期,请点赞、评论、订阅,给我们打个分或写条评价,并把它分享给你的朋友和家人。片尾:想听更多单集,请到 YouTube、Apple Podcasts 和 Spotify。在 X 上关注 @a16z,并订阅我们的 Substack:a16z.substack.com。再次感谢收听,我们下一期再见。片尾:提醒一下,这里的内容仅供信息参考,不应被视为法律、商业、税务或投资建议,也不应用于评估任何投资或证券,且不面向任何 a16z 基金的投资者或潜在投资者。请注意,a16z 及其关联方也可能持有本播客中讨论的公司的投资。更多细节(包括我们投资列表的链接),请见 a16z.com/disclosures。
以上为整集逐句译文,共 16400 字。出处:官方整集音频(E1223,54:15)。1
References
- 1The a16z Show 官方单集页(E1223《Chips, Memory, and Power》,2026-10-09,54:15)
a16z.simplecast.com
- 2Playground Global 官方人物页 · Pat Gelsinger
playground.vc
- 3a16z 官方作者页 · Raghu Raghuram
a16z.com
- 4a16z 官方作者页 · Guido Appenzeller
a16z.com
- 5
- 6维基百科 · Pat Gelsinger
en.wikipedia.org
- 7
- 8
- 9Graphcore 官方:Graphcore joins SoftBank Group
graphcore.ai
- 10SK hynix 官方新闻稿:HBM4 开发完成并准备量产
news.skhynix.com
- 11
- 12
- 13
- 14
- 15
- 16
Comments