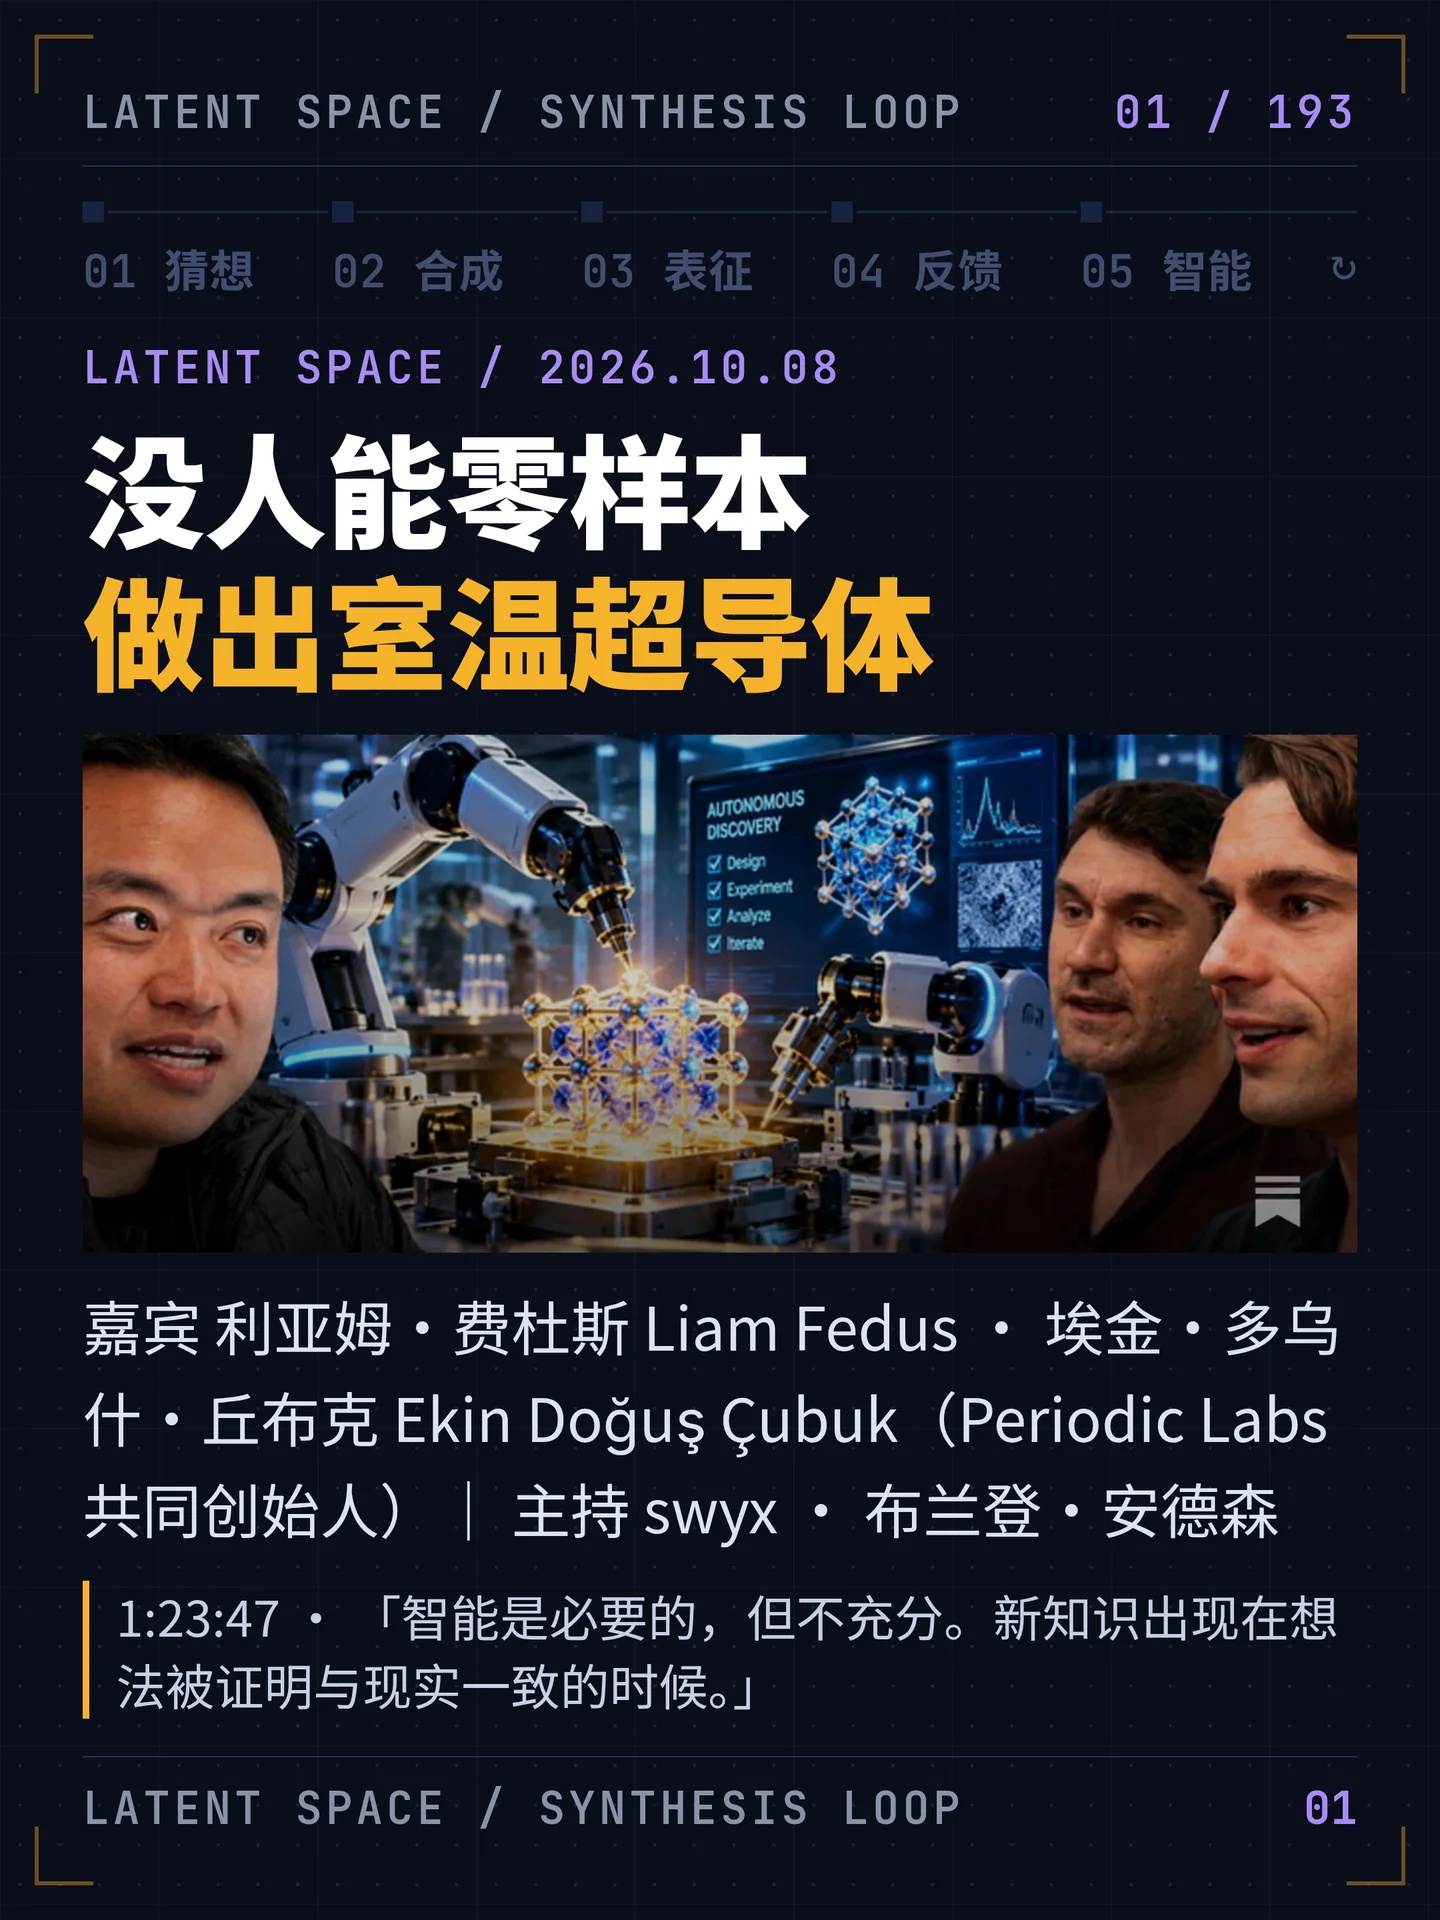

这一期 Latent Space 是跑去 Periodic Labs 在 Menlo Park 的实验室录的:利亚姆·费杜斯(前 OpenAI 训练后负责人、ChatGPT 最初那支小团队的一员)和埃金·多乌什·丘布克(前 Google DeepMind 材料科学与化学负责人)把官网上那句话拆成了一整条闭环——猜想、合成、表征、反馈,再回到猜想。他们说得很直:光靠想,想不出解法;新知识出现在想法被现实检验之后。12
下面是按官方 16 段时间点整理的逐段要点,再往下是整期对话的逐句中文。
逐段要点整理
按官方 16 段时间点整理,时间码是官方口径(全长 1:23:47)。本期出场四人:主持 swyx(肖恩·王)与布兰登·安德森(Brandon Anderson,Latent Space 主持、Atomic AI 联合创始人),嘉宾是 Periodic Labs 的两位共同创始人——利亚姆·费杜斯(Liam Fedus,前 OpenAI 训练后副总裁、ChatGPT 最初那支小团队的一员、更早在 Google Brain)与埃金·多乌什·丘布克(Ekin Doğuş Çubuk,前 Google DeepMind 材料科学与化学负责人,GNoME 与那篇「语言模型出配方、机器人做实验、造出 41 种新化合物」的论文作者之一)。13
背景补一句:Periodic Labs 2025 年 9 月底出隐身,拿的是 3 亿美元种子轮,由 a16z 领投、Felicis 先给条款;官方站列出的投资方还有 DST、NVentures(英伟达)、Accel,个人投资人包括 Jeff Bezos、Elad Gil、Eric Schmidt 与 Jeff Dean。他们的定位不是又一家模型公司,而是「AI 科学家 + 让 AI 科学家操作的自主实验室」。23
00:00:00 开场:智能必须与现实相遇
swyx 用官网那句话开场:「智能是必要的,但不充分。新知识出现在想法被证明与现实一致的时候。」利亚姆的回答就是这家公司的前提——你没法仅靠想就想到解法:宇宙太复杂,要推进知识前沿,必须先提出猜想,然后真的去看它是否成立;再读多少遍教科书或论文、再独自关在房间里想,都不可能把实验的全部可能结果推演出来。这也是他们从第一天起就要同时建三样东西的原因:AI 系统、对物理世界的模拟、以及物理上的高通量实验。12
swyx 补了一句这一期反复回响的判断:在 OpenAI 和 Google,你缺的不是算力和人,缺的是一间能把想法按小时拿去试的湿实验室,所以他们必须出来自己做。
00:02:49 物理世界里的 AI 与强化学习
布兰登要了一个对比:在 OpenAI 那样的大实验室工作,和在这里有什么不同?利亚姆的答案是「环境」本身——现在他们的强化学习环境字面上就来自物理实验室,数据来自物理实验室,而这才算最终的真相。
差别具体在不确定性:在数学上做优化,精度很高,基本不用处理方差、异常测量值;而在材料发现闭环里,材料从炉子里出来时不会贴着标签,连打标签都可能是随机、有噪声的;不同机器之间有偏差;遥测也不够——以为是在这个温度下跑的,真实温度可能差了一截。他把共同点也列得很清楚:中间训练、强化学习、工具型智能体的搭建、方差缩减、以及保证训练与推理之间不出现基础设施错配;但在此之上,还要解决「在高度不确定下怎么把活干准」与样本效率——数字环境里你可以随意增加环境数量或 rollout 次数,他们没有这种能力。
00:09:17 端到端的材料发现闭环
利亚姆把闭环拆成三步:要做什么(原子拼在一起稳不稳定,以及它是否具有想要的性质)、怎么做(找出把东西真正做出来的工艺条件,即便知道组合能稳定存在,这一步也极不平凡)、做出来的是什么(东西不会带着标签出来,必须做表征)。
他明确否掉了那种天真的 RL 设想:不是「跑一次实验、等几天、更新一下有没有找到室温超导体」——太慢、太吵,也没有足够多的智能体把方差降下来。他们的做法是围绕已产出的这批数据去搭智能体。以表征为例:朝材料打 X 射线,得到衍射图样(它像晶体结构的指纹),而识别出实际存在的是什么极不平凡——所以他们早期 AI 工作之一就是做这件事,奖励识别出存在的相、惩罚报出虚假的相。
他还解释了什么要把「世界的状态打上时间戳」:给定到某个日期为止的证据与当时的选项,科学家下一步做了什么、那次实验的结果是什么。这样做还有一层额外价值——预训练已经背下的数据会让模型「假装干活」,跳过物理推理直接给答案,而强化这种策略等于把不会泛化的推理方式权重调高。2
00:13:28 为什么物理并没有「被解决」
swyx 替非科学家问出最基础的那个问题:物理定律我们不是基本都搞明白了吗?那为什么还没有完美的模拟器?多乌什的答案有两层。第一层是历史:狄拉克写出量子力学教科书时把它框定成「一切都已完成」,据说还留下「剩下的都是化学」的说法——他能解氢原子、也许能解一串一维氢原子,但当时解不了氮和氧的相互作用。过去一百年学到的第一件事就是那不是真的:剩下的不只是化学,那里有大量物理。
第二层是当下的具体缺口:非常规超导(铜氧化物在 77 开尔文以上,比如 93 开尔文,并不服从电子–声子耦合那套物理,可我们不知道它们服从什么)、简单量子力学体系里的强关联(连模拟都还做不到)、以及密度泛函理论在强电子关联下抓不住某些效应。布兰登搬出菲尔·安德森的「更多即不同」,多乌什接的是:它是涌现的、又是普适的——深度学习里的幂律也一样,我们并不理解。
00:19:04 物质编译器与 AI 表征
swyx 抛出一个商业类比:台积电是半导体的晶圆厂,但不设计半导体;那你们可以做材料界的那一环——人们带着需求来,你负责把工艺找出来。利亚姆立刻给这个东西起了名字:「就像一台物质编译器。」给定需求,这是不是一组有效的构型?这个东西能不能存在?他把这跟「合成超级智能」这个使命并列。
这一段真正的技术含量在表征:相变是什么(冰融化、伊辛模型),XRD 图样为什么能反映晶体结构,以及一次真实战役的结局通常不是「是/否」,而是一堆混在一起的相——有前驱体、有非晶相、还有你并不想做的相。当某个相任何论文和数据库里都没有时,AI 要反过来问:什么样的原子构型才能解释这些图样?
布兰登追问他们是不是干脆把可观测特征做得毫无歧义,利亚姆否认了:两个不同的相可能与同一个图样一致,所以他们既做重复实验(他自称「一件非常笨但有价值的事」),也让系统用化学直觉来消歧。多乌什补了另一个武器:多模态——XRD 上难分的相,会在电学、磁学、形貌(电子显微镜)这些维度上分开;同时给人类十种模态说「一致地分析」是难的,对 AI 却不算超级智能。
00:30:22 DFT、模拟与实验这个最终真相
布兰登问怎么把计算工具接进决策流程,多乌什用密度泛函理论(DFT)作答。DFT 来自 Hohenberg–Kohn 定理:量子力学系统基态的所有性质都是电荷密度的泛函——电荷密度只是一个三维对象,而希尔伯特空间与波函数是指数级的;Kohn 因此拿了诺贝尔奖,Kohn–Sham 给出了实用的近似路径。他同时划了两条边界:按定义 DFT 并不必然是近似,只是那个精确的交换关联泛函我们还没拿到;而且即便 DFT 完美,也装不下 10²³ 个原子。
生成焓用来说明「稳定」是什么意思:如果这个材料的能量高于这些原子能形成的其他材料,它就不太可能被做出来——稳定就是落在凸包上。他们还解释了为什么必须用实验校准模拟:长年里最好的开源 DFT 数据库 Materials Project 就是这么做的,他们内部也在某类化学体系上实验与模拟互相校准。
这一段还有两个必须记住的限制:DFT 模拟的是完美晶体,而真实晶体的微结构(中等尺度上的结构)真的会影响性质;有些性质(比如超导转变温度)根本算不了。布兰登引了希瑟·库利克那句「材料没有 AlphaFold」——不只是算不出来,那个所谓的真值根本不存在。4
00:42:27 梦想材料、算力与量子计算
swyx 问「如果什么材料都能造,你最想要哪一个」。多乌什的清单是超导体、磁体(尤其是降低对稀土与钴这类难获取金属的依赖),以及一件更根本的事:把计算的能效做到接近兰道尔极限。
由此引出兰道尔极限的讨论:每次浮点运算的能耗一直指数下降,布兰登记得第一次看到那张图时距离极限还有十几、二十个数量级,最近再看「我们奇怪地接近了」——就差三四个数量级。多乌什把可逆计算与量子计算分开谈:可逆计算不删除信息,原则上不必为计算付能量;量子计算是幺正的、因此可逆,但被问「你要模拟什么」时,答案还是完美晶体——它不会自动解决材料发现。1
00:45:57 让每台实验仪器都有「140 的智商」
这是这一期最容易被记住的一句话,出处很朴素:实验室放大之后,瓶颈来自操作机器本身——技术员和科学家要在一堆扫描电镜图里找特定形貌,很快跟不上了;他们先写的那个自动取视场、放大、再拍的简单程序「有点太笨」。于是他们把 AI 系统直接建在机器上,让它知道这次实验的意图、想合成什么、还有哪些别的证据。
他们讨论的工程细节也很实在:控制仪器的延迟要与物理过程的时间尺度匹配(利亚姆类比自动驾驶,还说这不是一次工具调用、也不是一条推理线程,延迟会膨胀);成本与人的耐心同样重要——等两小时拿结果和两分钟拿结果完全不同。而这么做的理由是一条数据逻辑:在实验当时做更智能的数据采集,未来 AI 与计算预测拿到的数据就会丰富得多。
00:50:02 把实验室自动化
swyx 抛出那个常见的诱惑:一切都人工操作、再一点点自动化,是一个局部极小值——为什么不直接弄个人形机器人放进去?利亚姆的回答是:他们觉得去解决人形机器人反而更慢;他们的做法是混合——有些灵巧活人类很擅长、自动化要花几个月,就别在那儿耗;有些非常常规、却占掉大量工时的事,就自动化。他给了一句定调:完全自主不是一个目标,自动化服务于数据这个目标。
这一段还有一个很好用的故事:他们某个步骤曾出现循环性错误,因为一台机器装载错了、图样前后不一致;AI 纵向通读这一篮数据后说——如果把这个循环置换反过来,一切都一致了。他们回到物理设施确认,装载时确实出过错。多乌什顺势讲了数据质量为什么是基础:文献里大多数实验数据的噪声本底太高,通常比 DFT 的精度还差,把工作流标准化最大的收益之一就是把噪声本底压低。
00:53:16 数据、模型与负结果
swyx 问开源与闭源模型怎么分工,利亚姆说他们是混着用,从模拟这一侧极大受益于开源;但在很多场景延迟与成本太高,而在另一些场景,因为掌握别人没有的数据,他们能在最高推理投入下也越出前沿模型的能力边界——他把这归纳成计算效率。swyx 的观察是钟摆可能正在摆向数据,利亚姆同意,并把理由落在刚说的噪声本底上:「如果你把海量算力砸向一堆噪声,是不会有什么好东西浮现出来的。」
负结果这一段是这一期在方法论上最值钱的部分。利亚姆给了两种零结果:一种是本打算做出某种结构、而所有证据都指向没做出来;另一种更有意思——本意是做另一件事,结果从数据里识别出一个此前未被识别过的新结构。他们绝对有、而且定期做阴性对照。多乌什把它讲成分类问题:没有负样本、或者全是正样本,算法根本训不起来;而材料科学的文献恰好只给正样本——人们发表能合成的晶体,合成失败通常不发表,而且谁也说不准某个晶体是不是「永远无法合成」:可能只是手活问题、方法问题、设备问题。所以只有自己做实验、并在自己尝试的语境里记录负结果,才可能训出分类器。他还给了更细的一层:如果按单次实验打标签,绝大多数是负的;如果按一次战役打、并假设战役在成功时结束,就会平衡一些。
00:58:13 在做科学的过程上训练 AI
利亚姆说这是关键:这类数据在别处基本不存在,他们花大量时间把科学过程的完整谱系装进模型——对话、直觉、实验室里执行了什么、计算在哪里跑、代码写在哪里。总的目标不是科学的最终输出,而是做科学的过程。
布兰登把它类比成 RSI(用模型训练更好的模型),但指出区别:它没有回流到核心模型里。多乌什补了更宽的那一层:如果你们开发的物理模型改进了芯片、芯片又改进 AI,那就是更高层的循环。利亚姆还给「压缩进权重」辩护:如果推理时推理就够了,所有前沿实验室都会在 GPT-4 就停止训练。5
01:00:20 为什么前沿 AI 仍然需要做实验
这一节其实是全期最锋利的一句回答。多乌什说:即便 Fable 7 比今天更强,它仍然必须跑实验才能拿到结果——因为机器学习非常擅长它被训练过的东西,而科学发现几乎按定义就是你没有被训练过的东西。这就是他们要建实验室的原因:让开源或闭源模型都能用这些实验室去和宇宙捣鼓。
两位都不同意「零样本做出结果」的乐观版本:利亚姆说没人能零样本做出室温超导体;多乌什补了一刀——到目前为止真正被攻克的是理论计算机科学、编程和数学,理论物理也许是下一步(利亚姆当场说「别来」)。布兰登作为和湿实验室密切合作过的人,也更怀疑这一类说法。
01:06:06 把自主实验室规模化
布兰登问生物学的技巧(把复杂检测映射到测序上,一次扩到上亿)在这里有没有对应物。多乌什给了两个:组合溅射——用溅射靶造出组分梯度,一次在一片基片上生成几百上千种晶体,但至今成效不太好,因为存在扩散;以及超导测量这个瓶颈——不像 XRD,没有高通量方案,一次可能要一小时,所以有人想过把候选样品混在一起测,有信号再二分,有点像做新冠检测。
利亚姆则讲了 RL 环境可以怎么「扩」:不是等一次实验完整 rollout,而是基于战役日期打时间戳、或者只以某台仪器、某种仪器组合来构建奖励状态——同一篮有限的数据,换几种看法就能为训练扩出更多环境。布兰登还注意到一件事:模拟比新开实验室容易得多,那会不会让模型过度依赖模拟?多乌什的答案是微结构与超导转变温度这类 DFT 够不着的东西必须留给实验,而且从那一亿次计算到实验室里真正执行的动作之间,有一个巨大的筛选。
01:10:45 组队,以及把工具部署到产业里
布兰登的玩笑是「你的组织架构就是你的产品」,而他看招聘页时「没法完全搞清楚 Periodic 在做的事」。利亚姆给了几条组织原则:AI 研究与基础设施、计算类、实验类、硬件工程、产品。多乌什的解释是这些角色看着多样,但都在做同一件事——为了智能而做合成,连产品工程师也在其中,因为他们要保证研究变成实验室里能用的东西。
这一节还有两条人物性的信息。其一是他们的用人原则:要让最资深的人亲自动手——多乌什说现代学术界的病灶是给研究做得好的人太多写经费与教学的责任,以至于他不再亲手做研究,而贝尔实验室的巴丁每天都泡在实验室里、亚历克斯·穆勒在实验室里做实验。其二是他们点名的几位:计算材料科学这一侧的穆拉坦·艾科尔、实验室负责人乔·切克尔斯基(MIT 教授,休假全职加入)、带 AI 与 LLM 这一侧的迪马·巴达瑙(神经网络注意力机制的发明者)、以及曾在 OpenAI 技术带头做 Operator 的一部分工作、如今人在实验室里的雷·纳卡诺。
关于前派驻场工程:他们先给自己造产品与工具、一直是自己的零号客户,现在把这套东西带进产业,焦点是半导体行业;因为这类公司极其私密、需要在最安全的环境里运作,工程师与研究员会真的驻场,把 AI 与计算系统集成进去,还会在伙伴的数据上训练,让对方拥有自己的智能,而不是去打某个没训过的 API。2
01:17:01 从 AI 副驾驶到科学的成果
利亚姆的类比是软件工程:早期是 GitHub Copilot、早期版 ChatGPT 当副驾驶;随着自动化提高,出现了 Codex 这类东西,很少还有工程师像以前那样写代码。他认为同样的事会在 Periodic 发生——先加速研究员与工艺工程师,等自主性、智能与能力涨上去,就可以开始按结果定价:帮我到达这类目标状态。
多乌什把这件事说到动机层面:他们能对固态物理与科学做的最大贡献,也许是让这些工具和课题变得有利可图——就像 ChatGPT 让 CS 与 LLM 专业在大学里变得大受欢迎;贝尔实验室产生过巨大的商业影响,也有些了不起的进展没能商业化(比如宇宙背景辐射),但他们从把东海岸和西海岸连起来的真空管上获益很多。利亚姆接的是技术与资本的纠缠:聊天机器人在 2010–2015 那五年里进展了多少几乎说不出来,而 2021–2026 是天壤之别,因为产品市场契合彻底改变了资本格局,进而改变招聘、算力与数据。
01:20:57 把寻找超导体这件事自动化
布兰登请他们把最强版本摆出来:假设 100% 的实验室自动化已经实现,你们怎么真的走到超导?多乌什把重心从「想」搬到「做」:想到可能承载超导的化学空间并不难,真正难的是把它们合成出来。历史例子是亚历克斯·穆勒——他先试镍酸盐、没成;再试铜酸盐、成了,拿了诺贝尔奖;而镍和铜在周期表上相邻,镍酸盐后来被证明也是个好想法(哈罗德·黄把它做成薄膜并做出超导)。26
第二个例子是二硼化镁(MgB₂):常压下转变温度最高的常规超导体,发现它的日本团队只是试了一大堆材料——约三万种,其中三十种看起来有意思,MgB₂ 是其中之一;而它作为前驱体早就躺在人们的架子上几十年,BCS 理论在 1957 年就被提出来了。所以发现它既不是从理论推出来的,也不是因为当时合成不了。多乌什的推想是:如果那三万次能在一个月里跑完,我们就真的把「运气的表面积」做大了——这也是这一期最后落在的位置:自动化不是为了替代科学家,而是为了让更多猜想有机会碰到现实。
补一条与「过程训练」直接对应的官方进展:今年 Periodic 自己公布过 Periodic Neon——用实验室自己的数据做一个万亿参数模型,在衍射分析这个任务上超过 GPT-6 Astra 与 Claude Fable 5.1,靠的是中间训练加 RL,而用的算力相对很少。5
逐句全文翻译
底稿是官方单集页自带的完整逐字稿:433 轮,每一轮都带说话人姓名与时间戳。逐句直译,只保留中文译文,不压缩、不摘要、不删减,每一轮都保留说话人标签——swyx(肖恩·王)/布兰登(Brandon Anderson)/利亚姆(Liam Fedus)/多乌什(Ekin Doğuş Çubuk)。这一期不必猜是谁在说话:说话人姓名是官方逐字稿本身就带着的。1
swyx:好,我们现在就在 Periodic 的办公地。今天请到的是 Periodic 的利亚姆和多乌什。欢迎,也谢谢你们让我们进到你们自己的地方来。
利亚姆:很高兴来,谢谢你们过来。
swyx:我想先从一个我特别喜欢的句子开始,它就印在你们官网上:「智能是必要的,但不充分。新知识出现在想法被证明与现实一致的时候。」这句话看上去再直白不过,为什么它其实并不显然?
利亚姆:我觉得这正是多乌什和我在搭这家公司时的论点和前提:你没法仅靠想就想到解法。宇宙太复杂了,要真正推进知识的前沿、做出进展,你必须先提出这些猜想,然后真的去看它是否成立。再读多少遍教科书或论文、再独自关在房间里想,都不可能把实验的所有可能结果——预料之中的和预料之外的——都推演出来,你真正需要的是这个反复迭代的过程。这是我们做这件事的核心信念,也是为什么我们从一开始就说:「我们要有 AI 系统、要有对物理世界的模拟,但同时也要把物理上的高通量实验建起来。」我们认为,一种不同类型的智能会从这里面长出来。
swyx:我觉得还有一点值得注意:在 OpenAI 和 Google,那些大实验室里并没有这样的资源。你们必须出来自己做,因为你是在一边走一边发明自己的打法。
多乌什:是的,而且这样一支团队我想以前从未存在过。我们试着把固态化学家、固态物理学家、实验派、理论派、硬件工程师、大模型专家、计算机科学家聚在一起,其中有些技术是非常新的:高通量实验和机械臂,也就是最近三年左右才有人真正去试;力场这块的专业能力,有些力场也是很新的。但我们觉得,拥有一个实验室非常重要,有这样一个焦点、把这些人聚在一起协同工作非常重要。历史上最接近的例子大概就是贝尔实验室——了不起的理论家、实验家和化学家一起工作,做出了了不起的事。所以我们是在试着做同样的事情。
布兰登:力场的话题我一会儿想聊,但在那之前,为了给大家一个背景:我们的听众一部分是 AI 工程师,一部分是科学家。给工程师们:在 OpenAI 这样的大实验室工作,和你们在这里做的事情,区别在哪?我想你已经暗示过了,但也许可以更明确地说说,你的思考方式必须怎么重新框定?
利亚姆:我觉得一个有意思的点是:现在我们的强化学习环境,字面上就来自这个环境本身,来自我们自己的物理实验室。我们的数据来自物理实验室,而这才算最终的真相。仅仅针对某些论文或教科书里已知的答案做优化是不够的,因为我们要走到那些答案之外去,我觉得这是最大的区别之一。但随之而来的是,比如不确定性下的决策问题。当你针对数学做优化时,它精度很高,你基本不用处理方差、不确定性或者异常的测量值;而这些恰恰是我们流程的关键。举例来说,我们在做材料发现闭环时,东西从炉子里出来时并不会贴着标签,对吧?连打标签这个过程都可能是随机、有噪声的。有时候不同机器之间还会有偏差。也可能我们的遥测数据不够:我们以为是在这个温度下跑的,真实温度其实差了那么一截。一个能接住这些噪声数据、并像科学家那样做出聪明决策的智能,需要的是一套不同的推理策略。所以我想共同点是很多的:标准的中间训练、强化学习、工具型智能体的搭建、方差缩减、保证基础设施在训练和推理之间不出现错配。但我们必须在这之上再往前走,真正去思考:在高度不确定的情况下,怎么把活干准?怎么把极其有限的数据用到极致?我们正在大幅扩大规模,但它仍然与数字环境非常不同——数字环境里你可以随意增加环境数量或 rollout 次数,我们没有这种能力。所以样本效率也是一件关键的事。
布兰登:这对我来说有点抽象,而且这个话题在科学类播客上已经聊过一阵了。但我觉得,当你们谈实验不确定性时,如果能讲清楚一个具体的实验流程长什么样、在进入 AI 那一侧之前人类是怎么处理这个问题的,会更有帮助。你们有没有一个具体的例子:你们做的是哪一类材料,在这个过程里你们会碰到什么样的测量不确定性?
多乌什:我想这个有很多维度。其中之一是,我认为每一个科学实验都必须做某种降维,这和写代码或做数学非常不同。做数学或写代码时,全部上下文都可以对人或对 LLM 可得:一堆公理、一些由它们推出的推论、一堆函数和 API 调用。你需要推理的一切都在手上,剩下的只是要足够聪明把它想清楚。而在物理里,就像你知道的,我们一开始面对的原子的数量,比一台计算机能存下的多得多。所以显然,我们必须把表示一个系统的原始维度与比特数,降到计算机能装下的比特数。我想这就是热力学的原始前提:当年人们非常困惑蒸汽机到底是怎么工作的,后来发现你只要找到五六个热力学变量,就能相当好地解释正在发生什么——这非常了不起,这就是物理之美。
布兰登:你有一个装满原子的房间,里面有 10²³ 或者说 10²⁷ 个原子……
多乌什:正是。
布兰登:大概是这个房间里有这么多原子,而你只需要温度和压强这几个简单变量,它就能告诉你一切。不,是告诉你大多数情况下你需要知道的东西,对吧?
多乌什:对。
布兰登:那假设你做出一种材料,你可以去看它的 X 射线结构,而这件事本身是一个非常损失信息的投影,对吗?它其实不是结构本身,或者说它并没有告诉你真实的结构,它告诉你的是其中某些主成分。那么,人类会怎么用这些简单的主成分去推理?又怎么把这套做法扩展到 AI 上?
多乌什:在理论物理这一侧,我们认定能量——能量的平均值和能量的涨落——非常重要,热力学很大一部分就是从这上面推出来的。然后我们又意识到反应势垒也很重要,动力学非常重要。所以人类可以试着找出一些降维后的描述符,来推理这个极其复杂的系统。人们也很喜欢原子尺度的图像:去想局域环境长什么样,是八面体还是四面体,化学家尤其受益于这种图像。好,这是理论这一侧。实验这一侧,你会尽可能多地收集数据:你会有实验记录本,把你看到的一切都写下来,但同时也清楚你必然会漏掉很多。就像利亚姆说的,会出现各种问题。比如你的炉子会随时间退化,因为你烘烤的东西会有一部分蒸发、覆盖到加热元件上,所以炉子每用一次就更差一点。另一个问题是,你有一个炉子,但炉内温度并不完全均匀,所以你把它放在炉子的什么位置会影响结果。我们目前还没有这个问题,但也许有一天会有。光学仪器非常受振动影响,所以每次有人走动——我记得读博时,有个实验室长期受这个问题困扰,他们某些时候的结果和其他时候差别很大,最后追查到是因为夜里某个时间,楼上有人走动,那个振动影响到了激光装置。所以,是的,科学非常难,但这也正是它特别的地方,对吧?利亚姆和我还在聊的另一件事是:目前很多进展都集中在数学、编程和理论计算机科学上,因为这些对大模型来说更容易。但在真实世界里,大多数需要智能的事情其实更像科学:有大量不确定性、大量噪声、大量缺失的上下文,而你必须作为那个智能体,自己判断下一步该做什么。
利亚姆:我想顺着这一点补充一个很有意思的点:做数学、做理论计算机科学、做这类事情的最优推理策略,可能并不是做科学的最优推理策略。
多乌什:对。
布兰登:当你的输出是一个有噪声的晶体结构,或者是一些……我不知道,某种集体变量的时候,你怎么定义 RL 的奖励函数?
利亚姆:也许我就讲闭环里的一部分,钻进一个点去讲。在材料发现闭环里,我们首先得搞清楚:要做什么。这既包括这些原子拼在一起稳不稳定,也包括我们是否预期它具有我们想要的性质。所以我们不只是想要一个新颖的原子构型,我们要的是它们凑在一起时具有我们关心的性质。第二步是:你怎么把它合成出来?怎么真的把东西做出来?这同样不平凡。即使你知道某种组合能稳定存在,实际要找出把它做出来的工艺条件,还是非常不平凡的一步。但再说一遍:做完这两步、你真的做出了某种东西之后,它并不会带着标签出来,所以你必须对它做表征,搞清楚你到底做出了什么。在这种情况下,与其把 RL 环境想成「我们就发一次实验、等几天、然后更新一下你有没有找到室温超导体」,那完全不可行。
布兰登:对,我正想问这个。你不能让 GPU 在那儿闲放一个星期之类的。
利亚姆:是的,完全不可行。
布兰登:对。
利亚姆:因为你没有足够多的智能体把方差降下来。rollout 的时间要在不同仪器之间来回,你要等;实际的合成或炉子时间上还有物理极限。所以它太慢、太吵。我们思考 AI 这条线的方式,基本上是围绕我们产出的这批数据去构建智能体。以表征为例:你在找这样的 RL 环境——奖励的是识别出实际存在的那些相;给你原始实验数据,你能不能有效地拟合出来?我们的做法是朝材料打 X 射线。X 射线的频率或波长,大致与原子间距相当或可比,所以你会得到漂亮的衍射图样,它有点像晶体结构的指纹。而做这件事——识别出实际存在的是什么——非常不平凡。所以我们早期的 AI 工作之一,就是做出系统来做这件事。这也让我们快很多,因为如果你跑那么多实验,你很快就会卡在「搞清楚做出了什么」这个瓶颈上。但再说一次,现在强化学习环境就相当直接了:奖励你识别出存在的相,惩罚你报出虚假的相、或者没有化学合理性的东西。这算是一个简洁的小例子,说明你可以对每一个环节这么做。当你把这些拼起来,就是端到端的发现闭环。
布兰登:好。你——
利亚姆:也许另一个——
布兰登:对,哦,抱歉。
利亚姆:另一块会是:随着我们积累起一大篮子实验数据,你可以把它想成是在给世界的状态打时间戳。你可以说:「到这个日期为止,这就是我们当时掌握的实验证据。」然后你可以构建强化学习环境:给定那批实验证据、给定当时的选项,科学家下一步做的是什么选择,或者那次实验的结果是什么?这也非常有意思,因为它让我们能做那些在外部更难做的训练。因为如果预训练模型已经把其中一些数据背下来了,你再拿它做强化学习,如果它已经知道答案,而你又构造了依赖这个答案的强化学习任务,它是可以假装在干活的。因为它会想:哦,我已经知道答案了,那我不用真的去做那些难的物理推理,不用真的跑计算模拟,也能得出正确答案;然后你去强化这个策略,就把那些推理策略的权重调高了。可这些推理策略不会泛化到新体系上,所以对我们没用。但随着我们积累起一篮篮实验数据、把它们缝合起来、让整个过程的谱系都在,我们就获得了构造新型环境的能力,而这些环境在别处根本不可能存在。
swyx:我想问我的问题。
布兰登:说真的——
swyx:但我担心会把它带跑偏。我还是直接问吧,因为再说一次,我是从非科学家的角度来的,偏工程一点。我熟悉 ML 那一侧,不熟悉物理那一侧。好,这个问题有好几个版本,但最基本的是:物理定律我们不是基本都搞明白了吗?那为什么我们还没有完美的模拟器?
布兰登:哦,这是个好问题。
swyx:就,这非常基础。而他的反应是「哈,真可爱」。但——
布兰登:不,这确实是个好问题。
swyx:兄弟,我有一堆物理书啊。你什么意思,什么叫我们还没搞完?
多乌什:对,这里有好几件事同时在起作用。
swyx:嗯。
多乌什:我觉得首先,物理定律我们绝对没有搞完。即便是——
swyx:量子尺度上,好吧,但也许还有极大尺度。可在人类尺度、材料尺度上,我们……还剩什么?
多乌什:没有搞完。这是个很好的问题,而且为什么还没搞完,这件事本身就非常有意思。有一个大家常讲的故事:狄拉克在搞量子力学的时候,大概是 1920 年代后期,他写了一本量子力学教科书,把它框定成「一切都已完成」。然后有句话大家喜欢引用——我不确定它到底有多准确——据说狄拉克说:「剩下的都是化学。」言下之意是他能解氢原子——
swyx:那不就都能拼出来了。
多乌什:对。他也许能解一串一维氢原子,但当时他解不了比如说氮和氧的相互作用,不过没关系,那「只是化学」。
swyx:嗯。
布兰登:物理学家真的很喜欢单原子表示,非常简单的那种系统。
多乌什:简单系统。
布兰登:而你能解的也就只有这些。
多乌什:球形奶牛。
布兰登:对,球形奶牛。
多乌什:但事实证明,我想过去一百年我们学到的是:首先,那不是真的。它并不是做氢原子那件事的简单外推。而且剩下的也不只是化学,那里其实有大量的物理。我猜我们至今没搞明白的之一,就是高温超导。但还有很多其他的——
swyx:你说的「高」,对你们来说是 175、200(开尔文)?
多乌什:哦,人们说高温超导时,他们其实指的是非常规超导。有一类是常规超导,主要由电子–声子耦合驱动;在这种情况下,你能看到同位素效应——同样的体系,只是把其中一种元素的重量换掉,你会看到超导转变温度按你预期的速率下降。所以那个是常规的。但更高温的超导体,比如铜氧化物,那些在 77 开尔文以上、比如 93 开尔文的,结果并不服从那套物理。可我们不知道它们服从的是什么物理。它们就是了不起的超导体。而且不只是这一件。这当然是我们还没有理论的最热门话题之一。但还有非常多我们没搞懂的东西。比如,即便是简单量子力学体系里的强关联,我们至今也还模拟不了。密度泛函理论是非常强大的工具,在某些事情上极其准确,但只要出现强电子关联,它其实就抓不住其中的一些效应。要搞清楚的东西太多了。这也是我非常兴奋能把 AI 用到这个领域的原因——理论上、计算上、实验上,都有太多要搞清楚的东西。而且我们在这里的每一点进步都应该改善人类生活,因为我们对材料、对固态物理理解得越好,就能为人造出越好的器件。
布兰登:菲尔·安德森有一句名言:「更多即不同」。大意是:你可能理解某件事的全部基本定律,但当你把很多东西加在一起,它们会表现出质上不同的行为,不同于简单物理所告诉你的。所以理解大量事物在一起如何表现,看起来应该很简单——底层定律是简单的,但集体行为复杂到你很难建模。
多乌什:它是涌现的、又是普适的,这很疯狂。我们在深度学习模型上也看到这一点,对吧?深度学习里到处都是幂律,我们并不理解,但它非常像物理——那里也有涌现和普适性。
布兰登:物理界已经有很多关于神经网络中涌现的理论论文了。
多乌什:是的,绝对有。
布兰登:对。
swyx:然后我另一个追问也是关于过程——就叫它过程与最终结果吧。假设你想要材料具备某些你锁定的性质,然后你得找出通往那里的工艺。值不值得把这两件事分开,让你可以……训练一个模型,给定任意的理论终态,就能完美地逆向工程出任何工艺?这有意义吗?
多乌什:也许回到我们之前聊的:既然原子数超过阿伏伽德罗常数,我们永远不可能知道当时真正发生的确切语境。我想这可能就是为什么我们永远无法完美地逆向工程一切。但我们只是想把逆向工程做得足够好,好到能提升材料的性能,基本上就是这样。
swyx:嗯。
布兰登:你问的是,有没有一个正向模型:你输入一个输入,就能预测输出,而你想——
swyx:对。
布兰登:你想造一个代理模型,能理解——
利亚姆:输入是它最终的态,也就是原子的这个构型,然后预测是……
swyx:因为这样你几乎可以把工作切开:一支团队做工艺那一侧,另一支团队做性质那一侧,然后——
利亚姆:对。
swyx:你知道,就让它们比赛。
利亚姆:对,我觉得在这上面我们能取得很多进展——把这些智能体工作流拆到不同领域去。我觉得在合成预测上也有很多经验性的工作可做。
swyx:嗯。
利亚姆:也就是:拿到那个原子构型,你有哪些工具可用?在给定这些实验证据、给定已有文献与论文的情况下,你到底怎么走到那一步?而你最终是在检验:你到底能不能复现它。
swyx:我这么问,也是因为从公司角度想:就像台积电是半导体的晶圆厂,但他们不设计半导体;你可以做材料界的台积电——人们来找你说「我想要这个」,然后你能把工艺找出来——
利亚姆:对,就像一台物质编译器。
swyx:对。
利亚姆:也就是说,给定这些需求……
swyx:非常《星际迷航》。
利亚姆:对。但就是说,给定这些需求,这是不是一组有效的构型?这个东西能不能存在?
swyx:它是个好的目标函数吗?我不知道,太大了。
利亚姆:对。我们把我们的使命之一称作「合成超级智能」,我想它和这个是一致的。
swyx:嗯。
布兰登:我想把刚才你提到的一个点再挖一下,就是你讲到「相」。我觉得这也接着多乌什关于「什么是涌现」的评论。相变这个概念对很多听众来说可能是陌生的。你能解释一下什么是相变,然后为什么它对像 RL 环境这样的东西是一个有用的信号?
多乌什:相变很迷人。我想人们在生活中最容易产生联想的大概是冰融化,或者水沸腾。你给冰升温,它看起来还是冰、行为也还像冰,但到了某个温度,它就停止升温,然后变成液体。于是它突然从固态相变成了液态相。另一个和我们非常相关的,当然是伊辛模型。我想计算机科学和数学的人也在研究它,也许叫别的名字:你可以有自旋向上和向下,两个都向上与一个上一个下,有不同的相互作用项。在足够高的温度下,它们通常就是随机向上或向下,熵占了上风。你把温度降下来,看起来还是一样。但到某个点,它们突然开始完美地对齐。对,这就是相变。相变非常好,因为它让物理学家研究某些东西时轻松一些。它们往往会带有某些空间关联,这对我们也很有帮助。好,在我们的实验室里,相变的出现通常是因为我们把不同的前驱体——基本上是不同的晶体——混在一起,然后升温或做别的事情促使它们反应,原子开始反应,形成这种新的晶体。这会在 XRD 图样上显示出来,因为通常如果原子的几何结构发生剧烈变化,XRD 图样也会变化很大。但在一个典型的、实用的材料发现战役里,真正发生的事情是:你第一次尝试,它不奏效,而结果并不是清晰的「是」或「否」,通常是一个非常混杂的相。它通常会有一些前驱体,可能有一些非晶相,然后还会有一堆你也许并不想要做的相。这就成了挑战,也是为什么我们觉得把模拟和 AI 拉在一起做表征非常困难。模拟总是可以说:「哦,这个相看起来不像我们预测的那样,但它是它的一个轻微变体,让我对它做力场计算,看看它是否仍然稳定。」而 AI 可以说:「基于之前的实验和这一次,这大概不是我们想做的相,那我们改条件。」
利亚姆:对,而且在某些情况下——
swyx:给听众说一下,XRD 就是 X 射线衍射,你刚才已经描述过了。
利亚姆:对。在某些情况下,存在某个相是此前从未被记录过的,任何论文或数据库里都没有。所以 AI 必须真的去用这些工具来问:「什么样的原子构型才能解释这些相?」但这变得极其重要,因为它能指挥科学流程:比方说我们心里有一个目标相,我们真的需要沿着这个方向爬坡,才能对它做出更好的测量。所以如果它只占百分之一,而我们的确想提高这个相的纯度,我们就需要在这份实验数据上有一个非常好的测量,来说清楚什么存在、什么不存在。
布兰登:所以其中一个优势是,你有一个可以观察的、清晰的变量。回到关于「如何处理不确定性」的说法:看起来你答案的一部分是,你把你的可观测特征做得相对没有歧义,那里没有解释空间。是这样吗?这是背后的逻辑吗?还是说,这字面上只是你需要找到一个新相,所以这才是你关心的东西?
利亚姆:我想在很多这类情况里仍然存在歧义。一件非常笨但有用的事是重复实验。
布兰登:对。
利亚姆:我们当然会做重复实验。
布兰登:对,对。
利亚姆:但,不,我认为——你知道,这个任务有挑战性,因为它不是完全确定性的,而且存在歧义之类的东西。两个不同的相其实可能与同一个图样一致。
布兰登:对。
利亚姆:所以我认为,这就是为什么系统必须用上一些化学直觉:「好吧,考虑到合成条件、考虑到这些先验知识,这非常不可能。」这可以用来帮助消歧。
swyx:所以你在某种程度上是在注入先验,基于你的预期。
多乌什:对。我认为热力学是最大的先验,对吧?
swyx:是的。
多乌什:然后物理是一个大先验。另一个我们在这里非常受益的是多模态,或者说材料的多种表征。我们可以做 XRD,是的,有些相在 XRD 图样上可能看起来很相似,但我们还可以测它们的电学性质、磁学性质,可以测它们的形貌,比如某种电子显微镜。而那些在 XRD 上看起来相似的相,会在这些维度中的某些上表现得不同。这种多模态真的很有帮助。再一次,AI 在这里非常有用,因为人类的上下文和算力也是有限的。如果你同时给人类 10 种模态,说「一致地分析这些全部」,这有点难。但对 AI 来说,做这件事其实不算超级智能,它很棒,是的。
利亚姆:对,这就像超级智能就是能算这么多。它可以看全部的东西。这也正好接上那句「在不确定性下做更好的决策」:现在它把跨许多不同仪器、纵向跨不同实验、跨重复实验的信号缝在一起,然后抵达底层那个更好的模型。
swyx:嗯。
利亚姆:而不是过度依赖某一台仪器的某一次测量。
swyx:我再问一个。你知道,你前面也说过,数据就是比任何一台合理的计算机或处理能力能装下的还要多。所以在某个点上,你必须把数据扔掉,即便你有这么多重复、即便你大概有十种测量同一件事的方法。因为,万一你某个温度探头是错的呢?所以你什么时候把它扔掉?你怎么决定该怎么办?作为一个渴求数据的 ML 人,我只想要全部,对吧?然后我就——
多乌什:所以,是的。
swyx:蹒跚着,把一切学到。我不知道我不知道什么,就把它扔进去、扔给机器。
多乌什:对。所以我们不扔任何数据。我想我可能的意思是「潜在的」。如果上帝在观察这个实验——
swyx:嗯。
多乌什:实验里的数据比人类能装进计算机的还要多。可惜我们这些凡人无法观察全部原子。所以即便数据比我们能存的还多,我们其实也拿不到那些数据。比如,我没法追踪所有原子的位置。所以遗憾的是,我们仍然处在这样一个状态:我们收集到的任何数据都非常珍贵,我们一条都不删。对。
布兰登:也许可以有一个和 AI 那边接起来的思考方式:想想探测,比如对基础模型做线性探测,对吧?这个模型拥有全部数据,所以上帝拥有关于这块材料正在发生什么的一整幅图景;而实验就是那个小小的线性探测,输出也许只有八个比特。所以你把这个巨大的东西粗粒化成一点点信息,然后——这过去是人类的活,现在是你的智能体的活——从这八个比特里重构出内部实际在发生什么。
利亚姆:这是个类比,对。
布兰登:内部实际在发生什么。
利亚姆:这是个类比:你没法对每一个参数权重、对这个输入的每一个激活都有完全可见性。对,你拿到的是它的某个子集,或者整件事上的某些粗粒化特征。
多乌什:对。但你大概会发现——你大概会觉得麦克斯韦妖的论证很有意思,因为那——
swyx:你能再背一遍吗?因为我——他之前提过,我老是忘。
多乌什:19 世纪,人们认识到一个系统的熵必须增加,或者说对一个封闭系统——
swyx:嗯。
多乌什:……或者保持不变,但它不能下降。
swyx:嗯。
多乌什:这就是热力学第二定律。然后有一个思想实验问:如果有一个非常小、无所不知的妖,它能看见原子,每当某个原子能量低的时候,就打开一扇门让它进到另一个房间,一直这样做,从而降低系统的熵,那会怎样?这会打破热力学第二定律。很长一段时间里,我认为人们没有给出很令人满意的答案来解释为什么不是这样。但后来在 1900 年代有一篇离我们更近的论文,兰道尔提出:删除信息是要花能量的;而麦克斯韦妖做这件事的过程中会接触到如此多的信息,以至于它必须删掉一些。当它删掉信息时,它就必须花能量,这反过来保证了熵会增加。所以,即便我们还没到能当麦克斯韦妖的水平,我想你这个问题非常有远见,指向一个我们存了太多数据、不得不删掉一些的未来。
swyx:对,不,我当然没有要想到那个程度。它让我想到空调,空调大概就是这么工作的。不过我也觉得,这只是个问题:你为什么不把世界上所有的传感器都买下来,荒唐地过量测量、过量重复一切?
利亚姆:哦,我们就是这么做的。
swyx:对吧?是的,好,好,就是这样。
利亚姆:是的,对。
swyx:好,这样行得通。行。
利亚姆:对,我想,我想这是个——
swyx:确认了。
利亚姆:对,正是。问题是你能否看见单个原子——那是做不到的。但不,我们加了大量的遥测,这基本上就减少了隐藏变量的数量,如果你愿意这么理解的话。
swyx:嗯,嗯。只是好奇:你们担心自己只在加州吗?你们难道不想在尼泊尔和澳大利亚做这件事?
多乌什:对,我们可以。我们计划开更多实验室。
swyx:因为显然重力、你朝向哪边、你在哪里,都有影响。
多乌什:而且专业能力也会变,对吧?我们这里拥有某些类型的专业能力。比如斯坦福的物理系、工程系有某些专长,这对我们帮助很大,因为我们可以从那里招人,我们的研究员也可以合作。就像你说的,地理可能有影响,但不同城市在物理、化学内部也会有不同的专长。
swyx:嗯。哦,我们有 Zoom。
多乌什:对。
swyx:用来做这个。
多乌什:对。但仍然——
swyx:又不是说你的实验会受你在哪里影响。
利亚姆:对。对。Periodic 的未来不是一个实验室。
swyx:对。你得开上私人飞机去太空什么的。
利亚姆:对。对,我认为需要有这样一个实验室网络。而且就像多乌什刚才指出的,基于专长或材料约束,每一类都有一个最优的地方。有很多不同的约束,包括许可。
布兰登:好,那其中之一是——我一直很好奇的一件事是:你们怎么处理计算工具?或者说,怎么把计算工具整合进决策工作流,尤其是当计算和实验并不一定对得上时?这里也包括理论层面的高层理解。所以这些是怎么一起工作的?
多乌什:对。这里非常有帮助的一点是:有些事情在模拟里更容易做、也更准确;有些事情在实验里更容易做、也更准确。一般来说,当然实验更准确,但某些测量在实验上非常难做,所以你只能做一个差的版本,于是拿到不准确的数据。我举几个例子。其中之一是,我们用密度泛函理论来估计材料的生成焓,以及——
布兰登:抱歉,先停一下。你能解释一下密度泛函理论和生成焓吗?
多乌什:对,当然。
布兰登:抱歉,(是)生成焓,对。
多乌什:对。密度泛函理论大概是材料领域最常用的模拟方法。它来自 Hohenberg–Kohn 定理,Kohn 因此拿了诺贝尔奖。他意识到:诚然,量子力学非常昂贵,因为每个波函数基本上都有一个指数大小的希尔伯特空间,所以你得解一个非常困难的问题,尤其是随着系统规模增大。Kohn 和 Hohenberg 发现,其实你不需要在指数空间里做。至少对量子力学系统的基态而言,你只需要考虑电荷密度。这个定理其实相当简单,我想物理系本科生都能懂。但它的想法是:量子力学系统基态的所有性质,都是电荷密度的泛函——这很惊人,因为电荷密度只是一个三维对象,而希尔伯特空间和波函数是指数级的。那是个非常有意思的观察。然后 Kohn 又发了一篇论文,我想是跟他的博士后沈吕九一起,Kohn–Sham 波函数,给出了一个实用的方法,去求材料量子力学性质的某种近似。今天我们在实验室里、也在外部大量使用它。生成焓则是我们可用来理解材料能量的一个量。基本上我们要问:这个材料具有的能量是多少?因为如果那个能量高于这些原子能形成的其他材料,那这个材料就不太可能被做出来。所以「稳定」的意思就是它处在其他材料及其能量构成的凸包上。说得够清楚了吗,还是我们要——
布兰登:也许用一个简单的高层要点:密度泛函理论是一种方法,把某件在电子数量上指数级困难的事情——
多乌什:对。
布兰登:……或者说在系统规模上指数级困难的事情,用一种引入了某些误差的近似把它降下来,通常大约降到 n 的三次方近似。于是你现在可以计算那些原本不可计算的量,但这是有代价的,对吧?如果你能完美地做,那我们就——我们就不需要实验室了。但我们做不到。这也许可以呼应一下,其实是我们有史以来第二期节目。希瑟·库利克说过一句名言:「材料领域没有 AlphaFold,不只是算不出来,而是那个所谓的真值根本不存在。」就是说,我们其实并不真正知道材料的晶体结构长什么样,而 DFT 一般是我们逼近它的最好途径。
多乌什:对,我想是这样。也许我要加两点:DFT 按定义并不必然是近似。Hohenberg–Kohn 定理表明它——
布兰登:它不是——
多乌什:它可以是精确的。但我想,正如你指出的,交换关联泛函我们还没拿到。而对基于电荷密度的模型来说,我们不知道动能泛函是什么。而且即便我们有了完美的 DFT,我仍然觉得我们需要实验室,因为即便我们有了完美的 DFT,我们也没法把 10²³ 个原子装进计算机。
布兰登:对。
swyx:你对这个数字非常执着。
布兰登:但,不,好吧。对。可在算力指数增长的情况下,你可以论证,在 n 的三次方这一档规模下,原则上最终你就能算出来。你只要等得足够久。
多乌什:哦,对。我们需要巨大的计算机,对。
布兰登:但,对。但只要——
多乌什:那要等很久。
布兰登:对。但只要 n 的三次方是个好的缩放,你就能——
swyx:作为非科学家,我来做个观察,不知道你们愿不愿意聊。我来自金融。我们有高斯联结函数,它给信用违约互换定价,做法是算相关性、把一切压缩进一个单一核。它在精神上也很像 VAE:把所有这些东西浓缩成一个参数。我在想,是不是到处都是同一招。你们那个听起来比我的更高维——VAE 只是那种一个 sigmoid 的东西。但听起来是一样的?
利亚姆:对,电荷密度文件其实还是相当大的文件。
swyx:对,对。你是有点挥手带过,但它足够好了。这是最高位那一位。对。
多乌什:就我所知,我不知道还有更好的方法来预测新材料的稳定性。它肯定不完美,但它肯定比我能想到的其他方法都好。对,所以回到你的问题:我们用它们,是因为在某些事情上模拟比实验更容易,而它们互相补充得很好。然后我们可以把它放在一个闭环里做。我们觉得模拟本身永远不够,但在模拟、AI 和实验的闭环里,我认为我们能比以往快得多地取得进展。
布兰登:模拟让你能做的一件事是扩大规模快得多,因为算力比新开实验室容易得多地就能上线。
多乌什:对。
布兰登:那你怎么避免——或者说假设你把 DFT 放大很多,你怎么避免你的模型过度依赖它,同时仍然扎根于「真实世界才是你真正在乎的真相」?你怎么平衡这件事?
多乌什:嗯,我们同样把实验室放大。
布兰登:对,你把实验室放大。
多乌什:对,是的。
布兰登:但你可以——我可以想象,以现代算力把 DFT 放大到百万、上亿次;而你们的实验室,我猜是每天几百、几千次?我不确定。仍然相当……即便在真正高通量的情况下,相比起来你还是相当受限,对吧?
多乌什:对。一件事是:人类、还有 LLM,都相当清楚 DFT 的局限。比如,即便像你说的,我们能用 DFT 做一亿次试验——
布兰登:对。
多乌什:我们也永远没法真的去试它们的微结构。微结构的意思是:DFT 通常模拟的是完美晶体,但晶体实际上通常并不完美,而它们的微结构——也就是中等尺度上的结构——真的会影响性质。还有其他问题,比如某些性质,像超导转变温度,DFT 就没法轻易模拟。再说一遍,即便你用 DFT 做一亿次试验,也不够。所以我们必须依赖启发式、实验等等。
利亚姆:所以从那些计算到实验室里真正执行的动作之间,有一个巨大的筛选。
swyx:那个筛选是人来做、LLM 来做,还是混合的?
多乌什:可以是混合的。
swyx:嗯。
多乌什:比如很长一段时间里,Materials Project——最好的开源 DFT 数据库——是用实验来校准 DFT 的。他们真的会用实验数据去校准 DFT。我们内部也这么做。每当有某个我们感兴趣的化学体系,你会拿到实验、拿到模拟,然后你可以用它们互相校准。
布兰登:这是另一件事。我跟很多生物学家朋友聊过,他们总是很困惑:你说材料的时候,你没法只做一个 XRD 结构就真的知道结构是什么。因为如果你在生物学世界里,你可以看一个蛋白质的晶体结构,通常能大致以亚埃——或者说一埃量级——的精度重建出来。材料的 XRD……X 射线衍射……和生物学世界相比,差别在哪?你丢掉了什么信息,为什么它像是一个有损的投影?
多乌什:回答这个问题很难不显得疯。但你不觉得吗,有机化学和生物学几乎来自一个更低的 VC 维、更低的柯尔莫哥洛夫复杂度模型?就是你可以几乎把它表示成一维序列,而且它几乎可以被编译。所以在柯尔莫哥洛夫复杂度的意义上,它更简单。
swyx:一维?
多乌什:就像 DNA 只是——
布兰登:对。
多乌什:或者 RNA。
布兰登:我想大多数人会说它更像二维,不过——
多乌什:好吧,对。我不是生物学家,所以——
布兰登:对。
多乌什:我相信他们是对的。但无机化学,几乎是疯狂地(不同)。它显然不是来自这样一个低柯尔莫哥洛夫复杂度的模型,因为那个三维的无机晶体可以容纳金属、绝缘体、超导体、金刚石。差别真的疯狂。人们试过,但我们始终找不到一维表示。你很难为三维无机晶体找到一个 SMILES 字符串。而且原子之间相互作用的方式相当奇怪,比如共价键、离子键、金属键。但,对,这非常有意思。我有时会想:你有没有研究过固态电解质的问题?为什么人们无法用固体替代电池里的液态电解质?会形成所有这些枝晶。基本上锂会形成那种结构,钻进固态电解质里把它弄裂。你看那个,会觉得和生物学比起来这太原始了。在生物学里,这些系统能做出那么复杂的纳米技术进展,而我们连让两个界面互相配合都做不到,因为锂会把它弄坏。对,但话说回来,我想无机材料可以非常耐高温。你可以造航天飞机,你可以造硅、实现摩尔定律。所以,是有取舍的。
布兰登:对,我们和好几位嘉宾聊过这个。在我看来,一个大的差别是:在生物学上,我们有一套工具,基本上可以借用数百万年演化——
多乌什:对。
布兰登:……已经给了我们所有工具,我们只要复制它们。但演化也把蛋白质之类的 VC 维约束得相当低。而像细胞这样大规模系统涌现出的行为,可以复杂得多。
多乌什:对,还有意识。
布兰登:对,对。但也许更具体一点:如果你只看一张 X 射线图,你有一个完美晶体,你朝它打 XRD,你拿到谱图。那其实仍然不能唯一地告诉你晶体结构是什么,对吧?
swyx:不能。
布兰登:所以,这就是一件——
swyx:什么?
多乌什:它只是平均值。
布兰登:对。
多乌什:它只是平均行为。但比如,歧化反应就是一件非常复杂的事,对吧?可能你有一个完美晶体,平均来看它就长得像这个完美的 XRD 图样,但实际上内部有另一种模式在发生:原子略微向右或向左偏移,但平均来看它们在中间。对,人生艰难,对。
布兰登:而蛋白质的话,你基本上知道存在某种底层的蛋白质,它遵循某些规则,所以你可以把正向模型和它结合起来。
利亚姆:对。然后你可以朝单晶 XRD 走,那会有帮助。
swyx:我们刚开始做科学类节目时,有各种「AI 在科学里」「AI 在数学里」「AI 在物理里」的选题,还有那种比谁更难的较劲。我觉得你可以从科学上论证,材料科学是最难的。
利亚姆:嗯,我们选它并不必然是因为难。其实有很多方面它更容易。我们对大类材料有很好的模拟器;而在生物学里,要给一个细胞、一个器官、一个完整生物体建模是极其困难的。所以那是一个巨大的优势。
swyx:对。这不很有意思吗:在最微观的层面上,它是一维或二维的,然后它只是多了好几个数量级的尺度和结构,而那恰恰引入了复杂性。这很奇怪。而材料的复杂性也许更多在微结构上。
利亚姆:对,材料在不同长度尺度上你仍然会得到不同的复杂性。对,微结构以及更往上的尺度。
布兰登:对。
swyx:对。就当是给味蕾清个场。就科幻而言,假设你可以发明任何你想要的材料。什么更有价值?你知道,我这儿有个清单。显然有室温超导体。但你也提到了电池。我一直觉得电池——只要比锂离子好,你就成了。这东西已经原地踏步一百年了。然后最后一个,是碳纳米管,主要是为了太空电梯。我不知道你们怎么看。这三个是我能想到的。在你们的世界里,人们谈论的「梦想材料」还有哪些?
多乌什:肯定是超导体——
布兰登:对。
多乌什:磁体。
布兰登:对。
多乌什:尤其是如果我们能降低对稀土、或者对像钴这类难以获取的过渡金属的依赖,比如减少电池里的钴。我认为一件根本上非常重要的事是:如果我们能把计算的能效做到接近兰道尔极限。
布兰登:你能解释一下兰道尔极限吗?
多乌什:好。如果我们看每次浮点运算、或者说每单位计算我们花掉多少能量,它一直遵循摩尔定律式的行为,但能效是指数级提升的。也就是说,我们每次浮点运算或每单位计算所花的能量一直指数级下降。我最近没查过。十年前我上一次看的时候是这样的。
布兰登:对,那很棒。我记得我第一次学这个、看到那张图的时候,我们距离它大概是十来个、二十个数量级。
利亚姆:在极限之外,对,对。
布兰登:而我最后一次看的时候,它……我们奇怪地接近了。我们在……我不知道,三四个数量级之内。
多乌什:对。
布兰登:其实就是——
利亚姆:我只是把它按多年做了指数外推。
布兰登:对,多年来的指数(下降)。
多乌什:四五个,对。
布兰登:对,相当惊人。
swyx:但在你有生之年,你——
布兰登:对,不,我。对。就从我发现这件事算起,大概十年、十五年?对,不。
多乌什:而我们必须做的一件事是散热,因为当这些计算在进行时,它在产生热——这是必然的——但接着我们必须把热散掉。所以如果我们能让计算的能效接近兰道尔极限,那对人类来说是极其了不起的事,对吧?因为那意味着我们做的计算——这大概是我们人类所做的最根本的事情之一——从能量的角度看被做到了尽可能高效,而这在宇宙中是一件真实发生的事情。
swyx:那会被量子计算影响吗?我就随口抛出来。理论上来说,大规模、尴尬并行的计算。
多乌什:它肯定会被可逆计算影响。但说实话,我不是专家,我不太懂。这么说吧:如果你现在能做可逆计算,那你其实就不必为计算花能量,因为你并没有真的删除任何信息,它是可逆的。但我不知道那是否可行,我不知道。量子计算,我猜它总得在某种程度上服从这些定律,因为它们仍然……它们必须服从热力学——
布兰登:它是幺正的,所以——
多乌什:对,正是。
布兰登:它是可逆的,所以目前(是这样)。
swyx:我和埃拉德·吉尔最难忘的一次对话里,他其实对量子计算非常怀疑。
多乌什:我明白。
swyx:他说:「就算你今天拥有了它,也没有应用。」我就想:「哇。」
多乌什:我——
swyx:它会破——它会破掉 RSA,就这样。
多乌什:我同意这一点。人们说,如果你今天有一台量子计算机,你就能把东西模拟得好得多。我就问他们:「好,我们接受这一点。那你要模拟什么?」你要模拟的还是完美晶体。如果 DFT 的预测能力是完美的,你也仍然会遇到 DFT 有的那些问题。所以,是的,我确实认为人们在忽略一些东西,因为量子计算太令人兴奋了。如果我们能在量子逻辑空间里而不是经典逻辑里计算,这件事太令人兴奋,以至于人们在忽略它被造出来之后实际会做什么。也许这也无妨,因为也许一旦它被造出来,它会做出我们甚至无法想象的、了不起的事情。
swyx:好。行。我本来想转到「把实验室自动化」这一侧,也就是你们把实验闭环起来的地方。你可以聊机械臂、聊各种东西。但它基本上就是你们在这里做的一切。我最喜欢你们的一句话是:你们实验室里的每一台设备都将拥有 140 的智商。好,那是什么意思?
利亚姆:早期,随着我们扩大规模,我们意识到光是操作机器就给我们造成了巨大的瓶颈。比如有一套机器,我们需要技术员和科学家去寻找特定的形貌,去试着看清我们到底做出了什么、它是否与我们的意图一致。随着实验室扩大,我们很快就撞上了这些瓶颈——它跟不上了。于是我们开始用一些程序化的方式去采集扫描电镜上的数据。而这个很简单的程序——它大概就是取一个视场、拍一张、放大、再拍——所呈现出来的数据,并不是那么有用。对我们真正想要拿到的东西来说,它有点太笨了。所以到那个时候,把 AI 系统直接建在机器上、让它们开始控制这些设备,就变得非常切题了。现在它们拥有完整的上下文:我们到底想达成什么——这次实验的意图是什么?我们想合成的是什么?还有哪些其他实验证据?而它真的在机器里看、在采集那些数据。这件事现在非常有价值,因为我们一直在说,这些隐藏变量没法被全部捕捉;但如果你能在实验当时就做更智能的数据采集,那么你为未来 AI 系统和未来计算预测所准备的数据就会好得多。你会拥有一个更丰富的数据集合。这就是我们说「实验室里的每一个东西都必须极其智能,好让数据尽可能有用」的意思。这就是那背后的动机和灵感。
swyx:在「给每台设备装上智能」这件事上,现在的最前沿是什么状态?
利亚姆:嗯,我觉得一个有意思的方面是:延迟是多少——
swyx:正是。
利亚姆:——控制那台仪器的延迟?
swyx:因为这里有云的延迟,但也有设备端的算力,那个——
利亚姆:对。
swyx:也是。
利亚姆:然后还有与不同物理过程相关的时间尺度。如果调用一个 API 之类的东西实在太慢——也就是推理的量、token 数或工具调用数,与那个实际过程的延迟根本不匹配——那就是不可行的。
swyx:好。是这样。
利亚姆:这几乎就像自动驾驶汽车,对吧?所以——
布兰登:我,插一句。我其实很惊讶听到这个,因为我想象中推理的延迟相比很多东西——它们要跑好几个小时——很小,对吧?或者也许,你知道,也许你们的实验快得多、或者高通量一些。我其实只是很惊讶听到这个。
利亚姆:所以最终,实验确实要花很多小时、很多天,但可能会有某些特定步骤,延迟会变得重要。
多乌什:对。你可能想要更精细的控制。另一件事是成本:因为同样的原因——有些模型分析数据可能非常慢——也让它非常贵。最后一件事是人的耐心。如果一个人想要分析某个 XRD 图样,却要等两个小时才能拿到一个好的结果,我认为这和两分钟就能拿到是完全不同的。
布兰登:哦,好。
利亚姆:对。而且说到推理,它不是……你知道,你不是对那个模型做一次调用,对吧?你可能要用很多 token,才能到达这些图样。
多乌什:在闭环里跑模拟。
利亚姆:正是。
多乌什:深度研究在——
利亚姆:它不是一次工具调用,也不是一条推理线程。所以延迟可能会大幅膨胀。
布兰登:我明白你的意思了。
利亚姆:对。
布兰登:你们的延迟里有多少是工具调用?我猜工具调用主要是 DFT 或者计算类的东西……所以,你们的延迟中有多少来自这些、多少来自真正的推理?
利亚姆:这真的取决于流程。
布兰登:好,对。
利亚姆:对。
swyx:然后我还会想到另一件事,就是从小东西一点点搭到大东西——我猜通常的诱惑、或者说典型的开发方式是渐进式的:一切都是人工操作,然后你找到可以自动化的地方,再往上搭。我担心有时候人们就是这样演进的,但那是一个局部极小值。
多乌什:就像短视优化。
利亚姆:对。
swyx:正是。其实你应该弄一个人形机器人,直接把它放进去。
利亚姆:我们,我想我们的看法是,去解决人形机器人这件事,实际上会让我们更慢地达到某些目标。
swyx:我就确认一下。再说一遍,很多这类事对你们来说就是日常,我们只是——
利亚姆:是。
swyx:我们看到这些,但我们……我们不了解真实情况。很多人在做人形机器人。
利亚姆:对。我想也许有一个流程是:通过混合人工与自动化,你可以很快识别出实验流程中的瓶颈是什么,然后一次缓解一个。比如,如果某个非常棘手的灵巧操作任务,人类很擅长,而你为了自动化它得花几个月,那也许别在那儿花太多时间。也许更有希望的是那些非常常规、却占用科学家和技术员大量时间、而且容易自动化的事情。所以我想这里面有一种务实。但归根到底,我们从实验室想要的是大量数据、高质量数据、多样化的数据,这才是我们的目标。完全自主不是一个目标。自动化是在服务于这些数据目标。
布兰登:对。
利亚姆:但自动化的另一个方面是,机器人有可能会犯更少的错误。而且让 AI 系统拥有对我们全部数据的完整视野,这非常有帮助,因为有时候数据里存在某种置换,它能识别出来。举个例子,我们某个步骤曾出现循环性错误,因为其中一台机器装载错了,图样前后不一致。AI 在通读这些东西时说:「考虑到实际跑的参数,这不应该是这样。」它纵向地看着这一篮数据,然后意识到:「如果我把这个循环置换做一下再反过来,一切都一致了。」然后我们就能回到物理基础设施那里,理解到装载时出过一个错误。我认为在物理世界里做 AI,管理数据质量是最基础的事情。这类东西我们正在把它建进去。你可以改进操作流程;但到那时你会说:「好,这又是一个自动化的绝佳机会。我们怎么把它做得如此可靠、如此耐用,让我们再也不犯那种错误?」
多乌什:对,降低实验数据的噪声本底,我认为非常重要。文献里大多数实验数据的噪声本底太高了,实际上通常比 DFT 的精度还差。因为不同的人做实验、不同的实验室、世界的不同地方、不同的时间,这真的给结果引入了太多波动。所以我们希望,通过把这些工作流标准化,最大的收益之一就是噪声本底会被压低。
swyx:你们一直相当公开地讲你们怎么用开源模型、并为这类事情微调它们。是不是更好……基本上是不是这样?我能想象一种情形:你让笨一些的模型做一个任务,然后针对那个任务去优化它,然后再有一个通才的前沿模型去监督所有东西。这是一个好的心智模型吗?这里面还有更多阶段是我可以想的吗?
利亚姆:我们基本上是开源模型和闭源模型混着用。你知道,我们从模拟这一侧——搭建 ML 技术栈、模拟技术栈——极大地受益于开源。我们不需要在那个方向上用力。但在很多领域,延迟太高、成本太高。不过在有些情况下我们其实可以——你知道,通过能拿到这些数据,我们甚至在最高的推理投入下也能越出这些系统的能力前沿。所以这并不必然只是关于成本或帕累托效率;在某些情况下,当你掌握着别人没有的数据时,你可以越出去。描述这件事的一种方式是计算效率:通过拿到这些数据,相比某些前沿模型,你可以做到更高的计算效率。这在我们的项目里一直是一个非常有用的东西。
swyx:对。我太……数据质量或者说数据获取,作为算力的替代品,我想这里有一种汇率:用钱买算力、用钱买数据。我感觉现在钟摆可能正在摆向数据。显然你会同意这一点,不过——
利亚姆:对,尤其是刚说到实验数据的噪声本底。我们必须要有高质量的数据。如果你把海量算力砸向一堆噪声,是不会有什么好东西浮现出来的。
swyx:而且这对你们更难,因为你们主动追求稀疏——你们真的去要零结果、从里面学习,而且——
利亚姆:正是。
swyx:对。
布兰登:对,你在好几个其他场合都谈过零结果。对材料来说,一个零结果长什么样?你怎么有效地使用它?尤其是当我猜你们总体的信号——就成功而言——大概相当稀疏。
利亚姆:一个零结果可能是:我们本打算做出某种结构,然后所有证据都指向我们没有做出那个结构。
布兰登:你们有没有故意打算不做出某个结构?当然有。
利亚姆:有。
布兰登:好。
利亚姆:绝对有。
布兰登:好,酷。你们做阴性对照——
利亚姆:绝对做,是的。
布兰登:定期做。好。
多乌什:有些杂质情形会毁掉你的性质。对。
布兰登:好。
多乌什:可能有毒。
利亚姆:对,正是。百分之百。
布兰登:好。
利亚姆:而在某些情况下,一个负面结果其实是……你知道,我们本打算做下面这个,结果我们实际上识别出了一个此前未被识别过的新结构。所以它在某种意义上是负面的:我们本意是做另一件事,但别的东西从数据里浮现出来了。
多乌什:对。而且总的来说,当你训练一个机器学习算法时,尤其是在非常基础的层面,如果它是一个分类算法,如果你没有负样本,那如果全都是正样本,你其实没法训练。
布兰登:对,对。
多乌什:而这在材料科学里是个特别糟糕的问题,因为人们通常发表的是他们能合成出来的晶体,但如果他们合成失败了,通常就不发表。有时他们也许会发。而且我们其实从来不知道一个晶体是不是永远无法合成,对吧?
布兰登:可能只是手活不好。
多乌什:正是。
布兰登:对,对。
多乌什:可能只是手活的问题。
布兰登:尤其是在文献里。
多乌什:合成方法的问题、技术的问题。对。所以我认为,当我们自己做实验、并且在我们所尝试的语境里拿到负面结果时,这真的很有帮助,因为这样我们甚至能训练一个分类算法。
利亚姆:我觉得还有另一件有效的事——
布兰登:对。
利亚姆:就是当你有一串负面结果,最终通过工艺迭代拿到了那个正面结果,这是一组非常有意思的、我称之为工艺工程类的数据。也就是说,通过迭代,你到底是怎么走到那个正确结果的?因为材料科学里有太多这样的歧义:一个东西到底是怎么被做出来的。所以,对。而且实际上——即便是一种已知材料,要复现它也可能极其不平凡。有些东西在高中教科书里,但另一些东西真的在前沿,我们也在积累这种 know-how。然后还要建一个系统:给定这一串负面结果,你到底怎么走到那个——
布兰登:对。
利亚姆:正面案例?
布兰登:说到分类器的结果,我几乎会假设,如果你们所有实验都在内部做,你们大多数结果其实会是负面的而不是正面的,这有点讽刺,因为文献只给你正面的结果。所以如果你是从冷启动开始,问题似乎是反过来的:你——
多乌什:对。
布兰登:……拥有大量负面结果,正面的不够。
多乌什:就像你说的,如果我们按单次实验打标签,那大部分会是负面的。
布兰登:对。
多乌什:但如果我们按一次战役来打、并假设战役在成功时结束,那可能会平衡一些。
布兰登:我明白了。所以你们的推理轨迹几乎可以是覆盖整场战役的。
利亚姆:绝对。
布兰登:而不是——好。
利亚姆:这就是关键。这类数据基本上在别处不存在,我们花了大量时间把科学过程的完整谱系装进模型。所以追踪所有这些数据——对话、直觉、实验室里执行了什么、计算在哪里跑、代码写在哪里——把所有这些东西缝合起来,极其有价值。我认为总的目标是:与其在科学的最终输出上训练,你是在做科学的过程上训练。
布兰登:这感觉非常像你们在做——你会用 RSI 去做的事:你有一个被训练来训练更好模型的模型。现在你有一个被训练来做更好实验的模型。但——
利亚姆:绝对。
布兰登:区别在于,它没有回流到核心模型里,所以——
多乌什:除非你正在开发的物理模型改进了芯片,芯片又改进 AI。所以这是更宽的那个——
布兰登:更大的。对,更高层的 RSI。
利亚姆:那就是那个大数据飞轮。对。
布兰登:但这是否意味着——有没有可能,比如 Fable 6 之类,或者 GPT-8,就能……一个在这类更高阶推理轨迹上被调过的模型,能不能直接做这件事,完全不需要——
利亚姆:嗯。
布兰登:逻辑?因为思考过程大概是同一种,对吧?
利亚姆:对。我想这里存在不确定性下的决策。显然在机器学习里,跑 AI 循环时也有噪声。但我们确实认为,当你真正与物理世界打交道时,有一组不同的挑战。而且我觉得还有另一点:把所有东西压缩进权重仍然非常有价值。如果推理时的推理就足够了,那所有前沿实验室都会在 GPT-4 时就停止训练,说:「好,从此以后我们就把推理时改进做到非常好。」所以我们认为,因为物理科学和机器学习之间的这些差异,把它压缩进我们自己的权重,会带来不同类型的系统和不同类型的能力。
多乌什:但同样,我们觉得即便 Fable 7 变得非常强、比今天更强,它仍然必须跑实验才能拿到结果。原因在于:机器学习非常擅长它被训练过的东西,而科学发现几乎按定义就是你没有被训练过的东西。这就是我们为什么要建这些实验室——好让开源模型或闭源模型都能用这些实验室去和宇宙捣鼓,因为我们觉得,不去试,你不可能做出重大发现。
利亚姆:对,这里有——
布兰登:对。
利亚姆:不会有那种——没人能零样本做出室温超导体。
多乌什:理论上想想。
布兰登:那会非常酷。对。作为一个以前和湿实验室密切合作过的人,我当然比某些人更怀疑「零样本做出科学结果」这件事。
利亚姆:对。
布兰登:但我觉得,有些人可能会问,所以——
利亚姆:对。我认为把我们在数学和理论物理里看到的结果,与物理世界区分开,非常重要。对吧?就像——
布兰登:对。
利亚姆:这是两件不同的事。
布兰登:两件非常不同的事。
利亚姆:对。
多乌什:甚至都不是理论物理。到目前为止是理论计算机科学——
利亚姆:对。
多乌什:编程和数学。
利亚姆:对。
布兰登:对。
多乌什:也许理论物理是下一步。
利亚姆:别来。对。
布兰登:对。
多乌什:哦,对。
swyx:我能要一个关于层次的心智模型吗——你们可以走到的抽象层次?比如在自动化方面,我又回到这个主题上了:我们谈过战役、谈过单次实验、跑测试、以及人类在这件事上很差,所以我们应该不让人做。还有别的层次吗?比如,比战役高一层的,可能是一个你在检验的物理理论?比战役低一层的是什么?我就——我喜欢从这个角度想,从「好吧,现在这是一次 API 调用,你再也不用碰它」这个角度想。而这个是——对,不,这还是百分之九十靠人。也许我们可以这样画出领地的地图。还有别的层次吗?
多乌什:我可以告诉你一些层次。我觉得你问了个好问题。我没有一个非常系统的答案,但我们聊聊一些层次。一个层次是原子结构。这里有一个抽象,对吧?我们做的任何事情里都不存在完美的原子结构,但它是一个近似。另一个是连续介质模型。这个不再是原子尺度的了,而是一个表示材料的连续网格。
swyx:好。
多乌什:然后在另一个维度上,有热力学:假设你把这个实验永远做下去,最终态会是什么?然后还有另一层抽象,就是动力学:承认我们并不会把这个实验永远做下去,所以时间是有关系的。所以反应发生得有多快、或者会不会发生,即便它的能量更低、或者不更低。所以:热力学、动力学、原子尺度、连续介质。还有别的吗?还有别的抽象层次吗?
利亚姆:嗯,我想你说的那点——可能存在一个统领性的新理论进展,它同时指导多场战役,对吧?
swyx:它带来差别。有点像作为投资人,我想说:各位,瓶颈在这里。当我们拿到这个,其他一切都跟着来。我不知道。
多乌什:对我来说,从一开始,我们的假设就是:一个大的瓶颈是自动化表征。因为把粉末混起来去试东西并不那么难。但如果你没法表征它、分析它、然后智能地决定下一步该做什么,那你随机混粉末其实获益不大。所以我们把很大精力放在自动化表征上,并用模拟把闭环闭上,因为这才是你大量尝试、做出有依据的判断、然后决定明天做什么的方式。
布兰登:也许作为追问:人类怎么活在这个闭环里?在哪些点上你会把人放进去?我猜你们大概——
swyx:你可以,你可以随机地插进任何一段——
多乌什:当然。
swyx:并且加上价值。
利亚姆:是的。
swyx:但你们决定把时间花在哪里?
布兰登:看起来可能在所有层次上都有。你们有在实验室里实际搬材料的人,也有指导「做哪场战役」这类决策的科学家,然后还有人类在——什么?我只是在替你问问题。对。
利亚姆:对,百分之百。我觉得它也一直在变。
布兰登:对。
利亚姆:所以,就拿战役的指导来说,早期那完全是人在驱动。现在它越来越是 AI 驱动和人类驱动的混合。然后多乌什刚才说,我们早期识别出表征是一个大瓶颈。早期它是人驱动的,科学家们不堪重负,而现在这个天平已经显著转向 AI 驱动。这让那些之前把所有时间都花在这些改进工作上的科学家,现在能把工作提升到别的事情上。但我觉得我们——这其实是时间的函数。在每一个这样的层次上,它一直在变。
swyx:对。就一般的搜索而言,有没有一些东西在物理世界里表现很好、在其他世界里表现不好,或者反过来?比如演化搜索在 LLM 里相当流行。我想它在这里不会太好用。
多乌什:尤其在模拟里,人们用演化搜索已经很久了。它在结构预测上相当不错,比如找到低能量的结构。
swyx:好,所以它是有效的。对。
多乌什:然后半导体行业的工艺工程师会做 DOE,也就是实验设计,他们常常用某种零阶方法——不管是贝叶斯优化、演化搜索,还是……我不觉得他们用 RL,但想法类似,对。
swyx:你必须得有什么算法——
多乌什:对。
swyx:——去把它弄出来。
多乌什:而且所有零阶优化不管怎样表现都一样,对吧?所以。
布兰登:对。好,我想回到我早先的那个问题,就是规模化的问题。我很好奇:你们对实验室规模化的愿景是什么?这里有不同的方式。从生物学世界来的人知道,生物学里有很多很酷的技巧:你可以给东西打标签,你可以用 DNA 测序做各种有趣的读出。如果你能把你复杂的检测映射到测序上,你就能扩到百万、上亿的规模。你们能做这类技巧吗?归根到底,每个检测都有自己的运行时间。我有一个特别喜欢的博客文章,我想——我会在节目笔记里引用它。但这些实验室的运行时间是什么样的?你们的规模化对材料来说是不是本质上就是线性的——你只是需要更多资源做更多事?还是你可以用聪明的方式把东西并行化、把东西组合起来,那里有什么技巧吗?
利亚姆:嗯,我想一种思考方式是:RL 环境并不是简单地跑一次实验、等那个智能体完整 rollout、做计算、走完所有仪器直到最终结果。我们基本上是同时在所有不同的仪器、所有这些不同的战役上产出数据。你可以开始扩大它的方式之一是:强化学习环境可以基于——还是那句话——那些实验战役或计算战役在当时的时间日期来构建。或者你也可以开始拿仪器的子集,说:「好,我们就单独基于这台仪器来构建强化学习环境。」或者也许是跨这些不同的仪器去构建,以抵达某种奖励状态。这样,这一篮有限的数据,从不同角度去看时,就可以为训练而扩展出来。所以它并没有解决实际的实验运行,但从 ML 的角度是这样。
多乌什:也许我可以给你一些对应你刚才生物例子的类比。人们试过的一件事是组合溅射。不知道你听过没有。你有这些溅射靶,你制造出一个组分梯度。于是你看最终产物时,因为每种前驱体都存在梯度,它会在不同的空间位置上形成不同的晶体。于是一次就试了也许几百、几千种晶体。这和你那个例子很像,对吧。
利亚姆:哦,对,这说得通。
多乌什:就我所知,这个到现在成效并不太好,因为结果发现存在扩散,东西会到处跑。另一个我们想过的、但还没做的、很多人在讨论的:超导测量是个瓶颈,因为不像 XRD,没有高通量的超导测量,而一次测量可能要一个小时。所以人们想过把不同的候选样品取出来、全部混进一个样品、放进去测;如果它有超导性,你就知道源头是其中之一。然后你可以做得有点像人们做新冠检测那样。所以这类想法是存在的。有些效果很好,有些不行。对。
布兰登:所以你们,我想,即将宣布一笔大融资。你们怎么考虑规模化?
利亚姆:我们设计实验室已经有一段时间了,所以我认为这些资源让我们能继续显著扩大实验室,同时扩大算力——AI 这一侧和计算这一侧都扩。但我觉得同样非常重要的是:我们能够建出哪些新型的实验室?所以,我想我们一直在 Menlo Park 这里的初始实验室里验证这个闭环,但我们会继续扩展到新类型的实验室,重复同样的过程。
多乌什:对,就像我们试着建的那种实验室,我想此前没有以这个规模、或者这种方式被建过。到目前为止我们从自己的搭建中学到了很多,这些教训指导我们做下一版、再下一版。然后我们可以像你说的,提高规模、提高野心、提高仪器的质量。有些仪器非常贵。当我们真正理解我们从哪些地方获得高回报之后,就可以往那些地方投更多。
利亚姆:而且这让——硬件工程已经变成了核心。比如,早期我们只是为了速度买一些现成的仪器。而当我们推进实验室的规模——
布兰登:你们自己做。
利亚姆:我们不得不自己做。所以我们意识到:好,就这台仪器而言,它挺快的,这些部件其实都挺快,但这个称重机反倒成了瓶颈。或者可能有些事关乎数据质量:比如,这个机械臂的静止位置其实悬在之前混合过的东西的板子正上方,所以存在污染风险。所以在我们的硬件设计里,我们要重新设计,让静止位置远离那些东西。这类微妙的细节让我们能把实验战役的噪声本底压下去。所以基本上就是把这些学到的经验拿去放大。
布兰登:你的组织架构就是你的产品。你们有很多团队。我们看你招聘页的时候很意外,我们说:「好吧,我们觉得没法完全搞清楚 Periodic 在做的事。」
利亚姆:也许说几条组织原则,好让招聘页能被理解。我们招 AI 研究与基础设施、计算类、实验类岗位,还有硬件工程岗位,以及产品岗位。
多乌什:我们想实现的是合成超级智能,对吧?我们觉得为此我们需要正确的化学专长、正确的物理专长、模拟理论,以及薄膜、粉末。所以硬件工程——这些看起来是非常多样的角色,它们确实是,但它们在做的事情上其实是一致的:为了智能而做合成。这也适用于 LLM 研究员、基础设施,甚至产品工程师,因为产品工程师要确保所有研究都变成实验室里的实验人员能用的产品。
利亚姆:对。所以,要与物理世界完成端到端的闭环,你真的需要对物理世界拥有能动性——去建这些实验室、有效地跑这些战役、为此造出 AI 系统、让它们成为计算工具的好用户。这既是 Periodic 的难处,也是它的机会。这群人以前从未被聚在一起过。这是不可约的多学科问题。
多乌什:对。另一个对我们非常重要的指导原则是:我们希望那些非常擅长自己领域、经验丰富的人亲自动手去做。你知道,现代生活把我们带到了这个地步:尤其在学术界,当某个人在某个领域的研究做得非常好时,我们给他太多写经费申请、教学的责任,以至于他不再有时间亲自动手做那个领域的研究。但如果你回头看贝尔实验室、IBM,那些真正做出好进展的机构,都是经验非常丰富的人在做动手的工作。比如巴丁每天都泡在实验室里,尽管他是个理论家。亚历克斯·穆勒在实验室里做实验,尽管他是实验室负责人。所以我们在这里也试着这样做。我们有一些不同领域的世界级领袖,但他们在做动手的工作。
布兰登:你想炫耀一下,还是点名几个人?
多乌什:哦,我很乐意。对。我读博的时候,我最喜欢的一位、跟我差不多同龄的计算材料科学家是穆拉坦·艾科尔。他的博士是在我们顾问之一克里斯托弗·沃尔弗顿那儿读的。他算是我们的计算材料科学专家。他很了不起。他有时是个非常好的实验家,尽管他做的是模拟。他非常理解系统。我们的实验室负责人是乔·切克尔斯基,他是 MIT 的教授,但现在休假全职和我们一起工作。乔是一位了不起的物理学家,非常懂超导,而且他还在日本做过一段时间教授,所以把合成和化学也学得很好——尤其对一个物理学家来说。我们有丹尼尔·奇卡,他曾是梅尔库里·卡纳齐迪斯组里的研究生,那大概是世界上最好的固态化学组。丹尼尔是他手下的合成专家之一,他的手指就像魔术师一样。这样的例子太多了。
利亚姆:不,我知道。我觉得迪马·巴达瑙,他一直在领导我们很多 AI 和 LLM 的工作。他是神经网络注意力机制的发明者。
布兰登:哦,巴达瑙。就是那个 Bahdanau attention。
利亚姆:正是。对。
布兰登:对。
利亚姆:对,对,非常亲自动手,深入到轨迹、训练分布、怎么把它和实验室接起来。
多乌什:化学。
布兰登:化学。
多乌什:他会钻得很深。
利亚姆:他非常深。他在蒙特利尔的实验室里其实有固态合成的书。雷·纳卡诺,他曾在 OpenAI 技术带头做 Operator 的一部分工作。他也在实验室里。所以我们在带人参观实验室时,一开始我们说:「哦,这个新来的科学家、这个新技术员长得真像雷。」结果不,那真的就是雷本人在实验室里,和科学家一起在做机器自动化。这大概就是我们需要的 DNA 和那类人,才能把这件事做成。
swyx:我们还看到你们有「前派驻场工程」的岗位。我们正好在做一档关于前派驻场工程的播客,因为有太多工程师会做这个角色,他们可能根本不知道 Periodic 有这样一个岗位。那是什么?他们怎么和客户合作?
利亚姆:我们一直在建自己的产品、自己的工具、自己的 AI 和计算——
swyx:为自己。对。
利亚姆:为自己。所以我们一直是自己的零号客户。现在我们要做的是,把这些同样的工具带到不同的行业去,而我们现在有一个巨大的焦点在半导体行业。然而,要做这件事——这些都是非常私密的公司。我们需要能够在一些最安全的环境里运作。所以 Periodic 的前派驻场工程师和研究员会真的驻场工作,真的把我们的 AI 系统和计算系统集成进去,帮助我们的伙伴更快到达他们的目标状态。所以基本上,我们在自己做材料发现、材料工程中建起来的工具和 know-how,现在我们把它带到产业里去。我们认为这是让伙伴到达终态、达成目标最有效的方式,而不是把某项技术甩过墙去,让他们自己去搞明白。然后这些前派驻场工程师还会在本地做推理,但也能在数据上训练。所以,一旦我们把这个理解这些不同领域的系统拿过去部署,我们就能让它成为客户或伙伴数据的专家,这样他们就能拥有自己的智能,拥有远比「打某个 API 或者用一个没训过的模型」更有效理解的系统。所以这是一个比常规大大扩展的前派驻场工程角色,因为它真的需要非常深的机器学习专业能力。从数据训练的角度、基础设施的角度要做到极其精确,同时还要有物理的角度。所以我们在和高技术密度的行业合作。他们必须理解化学、材料科学、以及某些器件的不同领域。这些就是我们正在搭建的岗位。
swyx:其中一部分是愿意在台湾驻场很长一段时间的意愿。就是这样,好,我懂那类客户。
swyx:有意思的是你们现在变现的方式,这就是你们现在主要的变现方式,但未来可能会变。但这就像——我觉得人们对「APL 研究实验室」不太理解的那种模式。而且当你把自己和贝尔实验室相比,那正是人们脑子里想的,对吧?
利亚姆:我想一个非常好的类比是软件工程。
swyx:对。
利亚姆:在软件工程的早期,我们有 GitHub Copilot,然后有早期版本的 ChatGPT。人们把这些东西当作副驾驶,帮他们找到解法。随着自动化程度提高,现在我们有 Codex 这类东西,我们很少有自己的工程师还像以前那样写代码了。我们认为非常类似的事情也可能发生在 Periodic 身上:你可以有系统来加速研究员、材料科学家、材料工程师、工艺工程师。但随着自主性、智能和能力增长,你可以开始按结果定价。就是「帮我到达这类目标状态」,我认为那对我们是一个非常有意思的领域。
多乌什:对。我们有点觉得,我们对固态物理和科学最大的贡献,可能是让这些工具和课题变得有利可图,就像 ChatGPT 让计算机科学和 LLM 专业在大学里变得大受欢迎一样。我们很想证明固态物理、材料科学研究能产生巨大的商业影响,那样就会吸引更多关注。年轻人会想学物理,那会是梦想成真。而贝尔实验室确实产生过巨大的商业影响,对吧?当然,他们也有些了不起的进展没能商业化。他们当然也做过一些根本无法商业化的研究,比如宇宙背景(辐射)。但他们从把东海岸和西海岸用电话线连起来的真空管上获益很多。
利亚姆:对。而且我觉得非常有意思的是,技术和资本是极其纠缠的。所以如果你看聊天机器人在很多年里的进展——想象回忆一下,从 2010 年到 2015 年,聊天机器人进展了多少?在那五年里,我们大概说不出它们改善了多少。而如果你看 2021 到 2026 年这一段,那是天壤之别。发生的事是:ChatGPT 和其他系统实现了产品市场契合,而这完全改变了资本格局。这也改变了招聘、算力、数据等等的格局。
swyx:那个良性循环。
利亚姆:正是。所以——
swyx:就像成功孕育成功。
利亚姆:正是。所以技术,它与资本和那些资源极其耦合,我们想在物理世界里实现同样的事情。
swyx:对。
布兰登:我最近看到的一件事是:科学正在从政府经费等等转向 VC 和私人资金。你们打算把你们在做的东西开源吗,比如发布数据集或者真的模型?这在未来是你们要做的事吗?你知道,有很多模型也许不是——你们的水平,但仍然可能是、你知道,有用的发布。
多乌什:绝对。我们有几件事。我们一直在给开源做贡献,比如 PyTorch 和 Materials Project 的代码库、Custodian(他们的 DFT 运行器)。TorchSim 其实是我们这里一位研究员阿比吉特·甘甘创建的,他现在还在维护。JAX-MD 也是阿比吉特在维护。所以我们做很多开源贡献,包括 LLM。
利亚姆:XLANG、Megatron。
多乌什:对。
利亚姆:对。我们一直是开源非常活跃的贡献者。
多乌什:我们还有一个学术资助项目,给大学的学术团队提供学术赠款,我们认为他们在朝着合成超级智能这个方向真正推进。看到这些也很好。我想这笔资助产出的第一篇论文即将发表,所以看到更多这样的论文出来会很令人兴奋。对。
布兰登:好。我们来把这件事的最强版本论证一下:假设你们实现了 100% 的实验室自动化,它做一切、正确地表征一切。你有了所有这些能做一切的、好玩的智能体。我仍然有点不清楚你们究竟怎么走到超导。有很多难题要解。当大多数强关联体系或高温体系都还没有理论或模型时,通往那里的路是什么?
多乌什:对。我们的看法是:想到可能承载超导性的化学空间并不难。真正难的是把它们合成出来。这就是为什么我们特别强调合成超级智能。也许历史上可以举一个例子:亚历克斯·穆勒,当他想到过渡金属氧化物可能是通往超导的一条好路时,他其实先试的是镍酸盐——镍、氧和某些阳离子——那没成。然后他试了铜酸盐,也就是铜、氧和某些阳离子,那个成了,于是他拿了诺贝尔奖。但后来我们知道,镍酸盐其实是个好想法。镍和铜在元素周期表上相邻。
布兰登:但只是作为两层(的结构),对吧?
多乌什:对。三维过渡金属就那么多。
布兰登:对。
多乌什:然后,哈罗德·黄——我们这里的一位斯坦福教授,非常了不起——他意识到他可以把镍酸盐做成薄膜形式,并展示出超导性。所以,如果我们在实验室里有一个非常好的合成超级智能,能真的把这些规模化,我认为我们不会用光想法,或者说 LLM 不会用光关于该试哪些方向的想法,比如三维过渡金属、氧。这里有很多非常相关的想法。很多人一直在试钴酸盐,也就是不试铜或镍,而是试钴。所以我认为那非常令人兴奋。也许还有一个历史上值得研究的例子:发现二硼化镁的日本团队。如你所知,它是常压下的最高温常规超导体,而他们只是通过试一大堆材料发现了它。我想他们试了三万种不同的东西。其中三十种看起来承载有意思的超导性,MgB₂ 是其中之一。但二硼化镁在那之前几十年里,一直是作为前驱体躺在人们的架子上,而 BCS 理论早在 1957 年就被提出来了。所以人们发现这些材料的方式并不是从理论里推导出来的。也不是因为在那之前他们合成不了。就只是他们试了一大堆东西。那么现在想象一下,如果我们有了你描述的这种完美的自动化——听起来像做梦一样——我们把武藤团队在他的整个职业生涯里试过的那三万种,在一个月里试完。我们就真的极大地增加了「运气」的表面积。
swyx:不,但,对,你们做的事情非常鼓舞人心。恭喜你们取得的所有成功。我感觉,我感觉你们在创造,对,现代的游乐场。我想对你们来说招聘一定非常容易,所以我有点嫉妒,但你们是为了走到这里付出了很多努力,所以,对。
多乌什:对。
swyx:好。非常感谢。对,和你们俩聊天很愉快。
多乌什:对,超级有趣。对。
swyx:对。谢谢。
References
- 1
- 2Periodic Labs 官网(使命、创始团队与投资方)
periodic.com
- 3
- 4Materials Project 官方站
materialsproject.org
- 5Periodic Labs《Building Labs that Learn》
periodic.com
- 6Nature《Superconductivity in an infinite-layer nickelate》(Li et al., 2019)
pubmed.ncbi.nlm.nih.gov
Comments