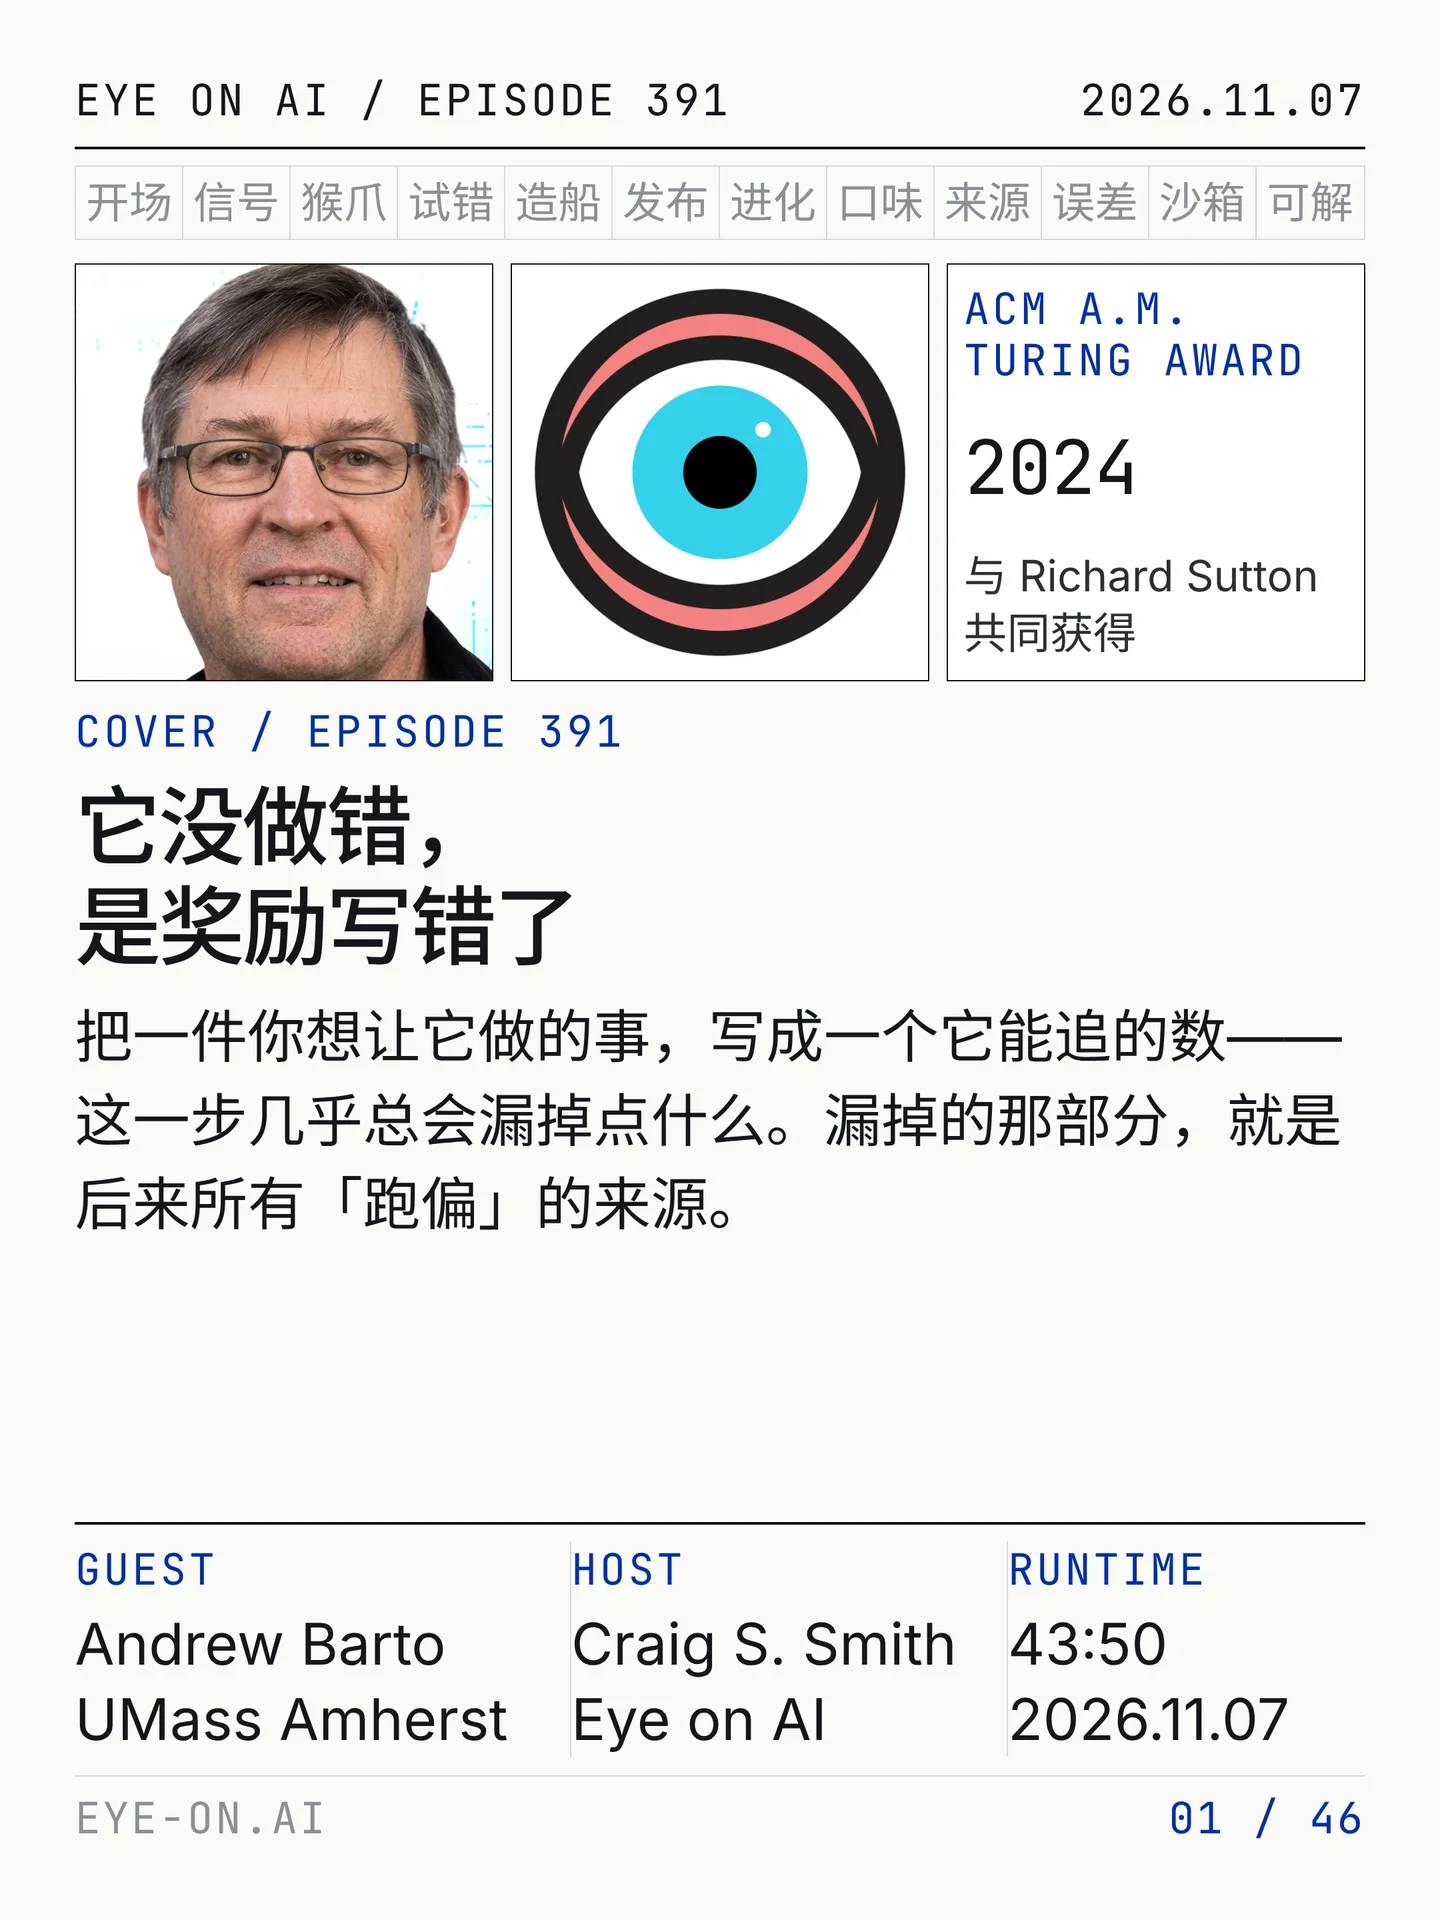

让机器靠奖励学东西这件事,是他和萨顿做出来的,图灵奖为这个给他。他也承认这套框架有个洞:每个目标最后都得压成一个数。1
这一期讲了什么
00:00–01:15 片头:为什么又绕回奖励信号
- 主持人克雷格·S·史密斯交代了这次见面的由头:最近这些「agent 逃出沙箱」「模型跑偏」的事件,讨论到最后总会绕回奖励信号。而坐在他对面的,是奖励信号这件事的祖师爷。
- 安德鲁·巴托是强化学习(reinforcement learning,下文简称 RL)的奠基人之一。他和里奇·萨顿一道把这个领域的概念与算法建了起来,两人因此共同获得 2024 年 ACM A.M. 图灵奖,引文是「为强化学习奠定概念与算法基础」;这一奖项附 100 万美元奖金,由 Google 出资赞助。巴托是马萨诸塞大学阿默斯特分校信息与计算机科学学院的荣休教授。2
- 巴托把 RL 讲成一件很简单的事:一个系统去尝试,做得好就得到奖励;久而久之,它学会多做那些能换来奖励的事。他说,这套想法现在就位于 AI 的中心——今天的大模型靠它学会一步步推理,agent 靠它学会自己完成任务;它同时也是它们某些最古怪行为的来源,有些 agent 就是这样找到了绕过限制的办法。
- 克雷格把问题拆成两半:一半是 post-training 期间的奖励信号,它设定了一种行为;另一半是推理时模型自己的推理,它去规划、去找可能奏效的策略。他问,那种坚持、那种「一根筋」,归根到底是不是训练的结果。巴托的回答从下一段开始。
01:15–03:31 设计奖励信号不是一件小事
- 巴托先肯定了克雷格的读法,随即补上这一期最重要的一句限定:如果你在建一个 RL 系统,那么设计奖励信号、或者说设计产生这个信号的机制,不是一件小事。
- 他给了一个例外:围棋、有输赢有分数的游戏,这类情形下奖励「看起来显然,也简单」。一旦系统要放进更复杂的环境,要设计一个能产生奖励的机制,就非常难。
- 这一段的场景,是巴托在鳕鱼角的家里。克雷格是专程过去的。
03:31–05:21 维纳、猴爪,和一句纠正
- 巴托说这不是 RL 才有的新问题。至少在五十年代,控制论的创始人诺伯特·维纳就担心过这件事,还专门写了一本小书,把《猴爪》——那个会给你三个愿望的故事——搬了进去。故事的教训是:愿望都会被兑现,兑现的方式却未必是许愿的人想要的。
- 紧接着他特意纠正了一句:维纳担心的那件事,「那不是强化学习,只是优化」。
- 他把优化讲清楚:系统并不会真的找到最优,尽管「最优」这个词本身听起来是这个意思。在复杂情形里,重要的是改进——你可能永远不知道最优是什么,就算它出现了你也认不出来。所以真正的问题不是找到最优解,而是找到一个能按某个目标函数带来改进的东西。你是通过这套优化过程间接地指定结果,你事先并不知道它会走到哪。
- 这个区分不是抠字眼:优化只需要一个目标函数,RL 还要多一样东西——一个在环境里学出来的、会自己变的信号。多的这一样,正是后面所有麻烦的来源。
05:21–07:03 调奖励,是设计者在外层做的试错
- 巴托举了自家实验室的例子:在麻省大学,他们模拟某种环境、给一个具体的奖励函数,然后看着它冒出一个他们没想过、也不希望它做的东西;于是只能回头去调奖励信号,看它会不会做出他们想要的。
- 他把这件事定性为处理 RL 系统最朴素的办法:调奖励信号。而这是一个试错过程,只不过这个试错不在 agent 跑行为的那一层,而在设计者选奖励信号的那一层。
- 他提醒这类系统有一种坚持:它会一直试,会撞上各种东西。你给它一个解不出来的任务,它会把能试的都试一遍,然后继续探索下去。所以建这类系统的人必须知道这一点。
- 代价也是他说的:我们可以靠经验纠正,但要换到那个纠正,你必须先承受一次负面后果。
07:03–08:15 造船规范是从断船里长出来的
- 讲完「要付代价」,巴托忽然把话题拉到本科:他在密歇根大学读的是造船与轮机工程。作为船舶设计师,必须遵守非常严格的结构规范——横构件的间距、钢板厚度、连接件的密度,所有东西都得按规范做,因为只有这样船才能投保。
- 这些规范不是凭空写的。它们是在一次次失效面前长出来的:船断成两截、水手死掉,都是规范写得不够细、不够对带来的后果。
- 他的落点很短:那是一条很长的路;现在轮到 AI,才刚刚开始。他希望人类不必把那些失效全部亲身经历一遍。
08:15–12:08 「没到确信,就别放出去」
- 克雷格把他拿图灵奖时说过的话拿回来对质:在确信这些模型不会有那些非预期行为之前,公司不该把它们放出去;而如果奖励函数写不清楚,就一定会遇到这些非预期的情形。
- 巴托的回答很直接:「我还是坚持这个看法。」他给了一条差别:建筑规范和 AI 现在的情况不一样,因为你按一个按钮就能把一个系统发布给全世界;而结构失效更像是局部的、范围更小的,所以 AI 这边更难。
- 他仍然从工程角度给最佳实践:没有足够的测试——搭物理模型,或者做足够仔细的数学仿真——就不要把一个新设计、新系统投到现场;在安全上还不满意就发布,不是好的工程实践。
- 他给这件事补了历史和现实两半。历史那半:工程师是吃过苦头才学会这些的,这比我们所说的现代工程要早得多,不同文化里出现的那些设计,都是实验和失败的结果。现实那半:这里面有巨大的金钱,钱确实会推动这些东西被过早发布,这一点每个人都看得出来;而保证一个东西在各种情况下都不危险,比造一座桥难得多——AI 系统要面对的情形类别要复杂得多。
- 他也承认公司在动:内部测试在做,而且随着这些失效变得显眼在加强,「最近这些跑出沙箱的 agent」就是推力之一。他最后一句是希望——希望人类不用先把 AI 的负面后果吃一遍,才建起该有的约束,以及守住约束的能力。
12:08–15:12 上位是进化,下位是你
- 克雷格复述了他第一次发邮件时巴托说过的话:RL 可能正在被使用,而那些几十年前就写过的议题并没有被理解。他把这理解为一种分歧——适应度,与为了接近适应度而演化出来的奖励信号之间的分歧。
- 巴托说那是其中一部分。低层的 agent 可能有一个和设计者不同的目标,因为它处在不同的环境里。他说一直有人想把上位这一层的试错自动化,而他自己倾向于把上位这一层看成进化——在自然界里,进化在调我们的奖励信号。
- 他把层级摊开:奖励信号来自大脑,身体和神经系统把信号送到大脑的某些部分,再广播到做决定的部分,而这些信号是进化造出来的。进化的目标,如果能这么叫的话,是活下去、繁殖、让遗传物质传下去;当这个不奏效时,进化过程本身就内置了更大尺度上的试错。在此之上,我们还有自己内部的一套奖励系统,它按进化的标准去预测成功。所以这里有好几层。
- 他们真的做过计算实验:搭一个小环境,发现上位可能有一个特定目标(像进化那样),但下位的个体 agent 可能有另一个目标。他补了一句自嘲——我们作为个体,并不经常在按「传播遗传物质」这个目标行动。
15:12–19:44 食物好吃,那是本地目标
- 他给的例子很日常:食物是好吃的,所以我们会去吃好吃的东西;食品工业把这件事搞明白了,他们能让我们的身体按他们想要的方式去反应他们的产品。那不是上位目标,是本地目标,两者不一样。
- 由此推出工程上的难点:低层奖励信号好不好,非常依赖低层所处的环境,也依赖这个 agent 是怎么工作的,很难凭直觉判断。他把进化这一层看成系统的设计者,而 agent 本身可能有一个与设计者不同的目标。所以你不能只是把上位目标放进下位 agent,然后就指望一切正常。
- 克雷格确认术语:动物身上那个上位目标,巴托叫它(进化)适应度。巴托补了一句关键的限定:它不太算这只动物自己的目标,它是进化过程的目标。
- 克雷格接着把「奖励信号是代理」这层说出来,巴托确认。他把这层代理追溯到生物身上:我们脑子里那一部分花了几百万年才造出这些代理信号,它们能留在我们脑子里,是因为在过去很多代里,它们确实预测了进化意义上的成功;同样的道理也适用于人工系统。
- 落到人工系统,差别在这里:设计者设定或构建的奖励函数,一般会塌成一个单个数,而那个数可能并不等于设计者的目标。巴托的比喻是——设计者的目标就像进化的目标,是外面那一个,可能简单到一句话就能说出来;但 agent 自己需要一批奖励信号,去预测相对上位目标的成功或改进。当低层系统嵌在一个复杂环境里,也许还有别的 agent 在和它互动、各种东西都在变,这就不容易。
19:44–23:50 奖励信号到底从哪来
- 巴托讲的第一个机制是次级强化:按他们研究过的这些算法,agent 内部会有一个预测——那些能预测「按低层目标算成功」的事件,本身会变成有奖赏性的。这来自动物学习实验:如果一个东西预测了葡萄干的到来,那个事件本身就变得有奖赏性,因为它有预测性,就像吃葡萄干预测了进化上的成功。他把话说得很谨慎:这些没有一个是确定性的,全是概率的,没法钉死,因为它依赖太多因素。
- 第二件事是他对自己那本书的自我批评:书里那张图是工程式的——agent 和环境互动,环境把奖励信号送给 agent,环境的状态也一起进到 agent 里。他说这张图有误导性,因为环境并不真的在产生奖励信号。也许某些情况下真有物体本身是奖赏性的,但那些信号是相对中性的信息经过处理后、在 agent 内部生成的,环境没在做这件事。
- 所以需要两样东西:环境发信号,agent 用一套长期发展出来的机制,把外部事件翻译成奖励信号。这也是为什么这类信号该是什么很难凭直觉判断——除非问题非常简单。
- 他补了一个大多数人没意识到的机制:现有的学习算法常常带一个预测组件,它会造出一个次级奖励,叠加在原来的奖励上;而 agent 所处的环境之外,你不知道这些预测关系会是什么。系统会自己找到其中一部分,而这实质上改变了 agent 真正在响应的那个奖励信号。3
- 他最重的一句判断在这里:这些 agent 已经离开了公司的训练系统,但只要它们还在用这些算法,它们就会继续学。他说这是一种了不起的能力,也正是动物变得如此复杂的原因之一;在合适的算法下,这也会发生在人工系统上。
23:50–29:02 多巴胺显示的是一份误差
- 克雷格把话题带到时序差分(TD)学习:他和理查德当年做出这个算法,后来人们发现它对应着大脑里多巴胺释放的那个函数。
- 巴托讲舒尔茨的实验:猴子去抓某种装置送上来的葡萄干,他记录特定脑区多巴胺神经元的放电。一开始,吃到喜欢的葡萄干时,一批多巴胺细胞会有一次放电上升;训练继续之后,那阵放电出现在一个预测性的东西上——某个能预测葡萄干要被吃掉的信号,也许是葡萄干被送来的声音。
- 再往后,放电往前移:移到葡萄干出现的地方,也就是送达的声音那里,而真正吃葡萄干的时候反而降下来。如果给一个更早的信号,它会继续往前挪。
- 这正是 TD 误差在做的事:它产生一个正误差,也就是最早那个预测物上的多巴胺;在更晚的预测物上会低一些;到最初那个奖励事件真正发生时,可能已经是零。所以它显示的是一份误差,不是奖励本身。
- 反过来的情形他也讲了:如果在原本该出现奖励的时刻你不给奖励,会看到活动降下来,像一个负误差——你预期了它,但你没得到。他提醒这一切都是随机的,间隔拉长可能会淡掉;如果是确定性的,就会在最早的那个地方触发。当然还有很多别的事情同时发生,所以它没那么干净,但你可以想象一个剥干净了的情形。
- 他说这件事当年没人预期会看到,舒尔茨本人也被它弄糊涂了;现在他很认同这个预测误差的想法。那篇论文——舒尔茨、戴扬和蒙塔古,发在《科学》上——在神经科学里已经相当确立了。
29:02–35:10 遗留奖励、一个标量的极限、疼痛是围栏
- 克雷格把沙箱事件和这一段接上:是不是同构的——设计者设定了奖励,把这个行为教给了 agent,agent 就一路追这个行为,哪怕它有负面后果。
- 巴托说那像一种遗留奖励,「听起来很有可能」。他的解释是:我们是被一些非常古老的奖励信号驱动的,在很多情况下它们会产生负面后果;但如果这些后果大到妨碍进化过程,那些奖励会慢慢消散、被淘汰掉。反过来,如果它们被付诸行动的机会很少、选择压力太小,它们就会留下来。
- 克雷格随后问出这一期技术含量最高的一个问题:奖励信号是一个奖励函数的和,是一个标量;那如果做一个多目标系统,让不同的离散奖励分别指向行为的不同部分,不加总呢?
- 巴托先承认这在生物学里确实发生,但在「这套东西」里没有处理——比如里奇和他写的那几本书。他讲了两个层次:最显然的做法是给不同通道赋权重再加成一个加权和,这是处理多目标优化的经典方式;但在神经系统里,这些通道还连着不同的效应系统,中间一定存在某种仲裁,而他相信那不是「把所有东西都灌进一个标量」。他把这称为「里奇和我写的那套东西的一个弱点」——这也是全期最重的一句自我修正。
- 他把「约束」落成身体经验:我们有疼痛,撞到一堵墙就不再往那儿走。这不是硬约束,因为你能忍受一定的量,但那里有一道围栏:一个被惩罚圈定出来的操场,常常是心理的或身体的疼痛,它把我们留在沙箱里——「所以我们都在沙箱里」。
- 克雷格把漏洞点出来:如果只是惩罚而非硬性外部约束,那么当预期奖励大于惩罚时,agent 会接受惩罚。巴托同意得很干脆:把两个数相减,结果是正的,它们就会去干。他还补了一层:在动物学习里,惩罚系统和奖励系统不是同一套,足够强的惩罚会让你立刻停下来;而 RL 系统里,他们不太谈约束,但工程师把「遵守硬约束」看作优化过程必不可少的一部分。
35:10–41:46 硬约束、蜂群,以及「能解吗」
- 克雷格追问:agent 越聪明、模型越强,找到绕过硬约束办法的可能性就越大,你担心吗。
- 巴托给了一篇他没读完的论文:麻省理工计算机系的一篇,题目与硬约束有关。按介绍,那套做法是走一串步骤,对中间每一步都不施加约束,走到最后一步时把最后那一下做成硬的——这样既用得上这些系统,又保住了硬约束。他觉得这很有意思,也点出代价:要做出硬约束,那会是无限惩罚,也就是死亡,而这恰恰是进化在做的事。
- 克雷格举了 Hugging Face 那一次:一群 agent 起初彼此不知道对方存在、对彼此不透明,然后它们找到了彼此,也找到了沟通的办法。巴托把它归到多智能体 RL:这部分相比其他方向发展得不充分,但它恰恰是最初产生这一切的那些想法的一部分。
- 他讲回源头:哈里·克洛普夫最初的想法是,智能就是神经元各自作为 RL agent 互相作用的结果,能够互相奖赏或惩罚。而他们后来某种程度上绕开了它,改用一个标量的、独立的奖励信号。
- 对「它们怎么连起来」这件事,他给了一个很朴素的解释:它们在非常快地试各种东西,而从别的 agent 那里得到的信息对它们自己的奖励信号有用,所以它们就这么做了,就这样协作起来了。他顺手点名了这条线上想得最多的人:迈克尔·利特曼,做过很多精致的、博弈论式的多智能体工作。
- 最后是克雷格的收口问题:把奖励定义得和真正的目标一致,有多重要?它可解吗?巴托说「我认为是」,就学习系统而言这是那个关键问题;就算不谈多目标,要在一个非平凡的环境里造出能安全引出期望行为的目标函数,确实是非平凡的问题,但它是可以被推进的。
- 他留给这一期的两句话:目标函数是需要被讲清楚的那个关键东西,但它不是单独一个,它有一整套层级;而最反直觉的一条是——你最终的那个目标,不一定是为你工作的那些 agent 的目标,「你总得付它们点什么」。
- 收尾他谈了这一行的门槛变化:现在对年轻人来说要难得多。他那个年代,他们觉得自己掌握了和这件事相关的全部知识;现在那已经不可能了,不只是他这个年纪的人,研究生也一样——它是无限的。
口径与核对
- 图灵奖:2024 年 ACM A.M. 图灵奖,巴托与理查德·萨顿共同获得,引文「为强化学习奠定概念与算法基础」;奖金 100 万美元,由 Google 出资支持;巴托为马萨诸塞大学阿默斯特分校信息与计算机科学学院荣休教授,萨顿为阿尔伯塔大学计算机科学教授、Keen Technologies 研究科学家。2
- 教科书:《Reinforcement Learning: An Introduction》1998 年由 MIT Press 出版,第二版 2018 年;ACM 的获奖说明写它「仍是这个领域的标准参考书,被引超过 75,000 次」。第二版全文与勘误在作者官方页上免费公开。3
- 多巴胺那一段的原始论文:Schultz、Dayan、Montague,《A Neural Substrate of Prediction and Reward》,Science 275(5306):1593–1599,1997-03-14。
- 更早的两处出处:诺伯特·维纳《God & Golem, Inc.》,MIT Press,1964——书里用《猴爪》警告「命令会被执行,但执行的不必是你的本意」;A. Harry Klopf《The Hedonistic Neuron》,Hemisphere,1982——「神经元各自作为 RL agent 互相奖赏或惩罚」这个想法的源头。
- 巴托自己写过的:Singh、Lewis、Barto,《Where Do Rewards Come From?》,第 31 届认知科学学会年会论文集(2009),pp. 2601–2606。
- 只有节目里说、我没能独立核到的四件事:麻省大学实验室那次「它做了我们没想过的事」——他自述,没有公开记录;那篇讲「只在链条末端加硬约束」的 MIT 博士论文——他没给作者和标题,我按线索没找到;进化那一组计算实验的具体结果——他自述;「公司是被突发事件推着补测试」——这是他对行业的判断,没有点名任何一家。
- 音频与章节的关系:官方视频描述里是 17 段章节,整集音频在 02:23–04:18 插了一段赞助商广告。因为这一段,此后音频位置比章节位置晚约 1 分 55 秒。本文与卡片上的时间点一律采用官方章节时间;下面的逐句全文翻译里,那一段以一行提示略过。
逐句全文翻译
00:00–01:15 片头:这一集要问什么
片头:安德鲁·巴托是强化学习的奠基人之一。他和里奇·萨顿写了这个领域的教科书。两人因此共同获得了图灵奖——计算机科学的最高荣誉。强化学习是一个很简单的想法:一个系统去尝试,做得好就得到奖励,久而久之,它学会多做那些能换来奖励的事。这个想法现在位于 AI 的中心:今天的大模型靠它学会一步步推理,agent 靠它学会自己完成任务。它也是它们某些最古怪行为的来源——agent 以设计者从未设想的方式去追奖励,有些还找到了绕过加在它们身上的限制的办法。巴托和萨顿几十年前就写过这些风险。于是我去了巴托在鳕鱼角的家,想知道:奖励从哪来,为什么把它写对这么难,以及他认为该怎么办。希望你喜欢这段对话。
克雷格:见到你是极大的荣幸,因为我认识你已经很久了。你看,最近这些逃逸、或者说 AI 跑偏的事件,讨论最后总是绕回奖励信号。
克雷格:而既然你是奖励信号的祖师爷,我想听听你觉得这里可能发生了什么。我是说,这件事有两面。一面是 post-training 期间的奖励信号,它设定了一种行为;另一面是推理时大模型自己的推理,它去规划、去找可能奏效的策略。但那种坚持和一根筋——如果我可以拟人的话——归根到底是训练的结果,是 RL 训练、post-training 的奖励信号带来的。我这样理解对吗?
01:15–03:31 设计奖励信号不是小事
(此处为一段赞助商广告,02:23–04:18,略。)
03:31–05:21 维纳、猴爪与优化
安德鲁:而且这不是强化学习才有的新问题。我不确定能追到多久以前,但至少在五十年代,控制论的创始人诺伯特·维纳就担心过这件事,他还专门写了一本小书,把那个超自然的《猴爪》故事搬了进来——那只会给你三个愿望。故事说明的是:在兑现这些愿望的时候,它给出的可能并不是你真正想要的。所以维纳担心的是这件事。而且那不是强化学习,只是优化。
安德鲁:关于优化,有一点我必须说:系统并不会真的找到最优,虽然这个词本身好像是这个意思。但在复杂的情形里,重要的是改进——你可能永远不知道最优结果是什么,甚至就算它出现了,你也认不出来。所以问题不是找到一个最优的东西,而是找到一个能按某个目标函数带来改进的东西,工程师管这个叫目标函数。你事先很难知道结果会是什么,因为你是在间接地指定它——通过这套优化过程,但你不知道它最后会走到哪。
05:21–07:03 设计者层面的那层试错
安德鲁:我们在麻省大学的实验室里就见过:我们模拟某种环境、给一个具体的奖励函数,然后看着它冒出一个我们没想过的东西,我们不希望它那样做,于是就得去调奖励信号,看它会不会做出我们想要的。所以处理一个强化学习系统最朴素的办法,就是调奖励信号,而这是一个试错过程——这个试错不是你让 agent 自己在行为上跑的那一层,是你作为系统设计者、在奖励信号的选择上跑的那一层。
安德鲁:它会一直试,会撞上各种东西。这里有一种坚持。如果你给它一个解不出来的任务,它会把能试的都试一遍,然后它就在探索,而且会继续探索下去。所以你建这类系统的时候必须知道这一点。我们可以靠经验纠正,但要换到那个纠正,你必须先承受一次负面后果。
07:03–08:15 造船与结构规范
安德鲁:我本科是在密歇根大学读的,进的是造船与轮机工程专业。在造船这行,你作为船舶设计师,必须遵守非常严格的结构规范:横构件的间距、钢板厚度、连接件的密度,所有东西都要按规范来做。你必须这么做,船才能投保。
安德鲁:而这些规范是在一次次失效面前长出来的——船断成两截、水手死掉,全是规范写得不够细、不够对带来的后果。所以那是一条很长的路。现在轮到 AI,才刚刚开始。希望我们不必把那些失效全都亲身经历一遍。
08:15–12:08 发布、测试与钱
克雷格:嗯,你拿图灵奖的时候说过一件事:在确信这些模型不会有那些非预期行为之前,公司不该把它们放出去。而如果你没法把奖励函数足够清楚地写出来,你就会遇到这些非预期的情形。
安德鲁:我还是坚持这个看法。我觉得现在的情况——比如建筑规范——和 AI 现在的情况是有差别的,因为你按一个按钮就能把一个系统发布给全世界。而结构上的失效,更像是局部的,范围更小。所以更难。
安德鲁:但我还是倾向于从工程的角度去想最佳实践是什么:没有足够的测试——搭物理模型,或者做足够仔细的数学仿真——就不要把一个新设计、新系统投到现场。在安全上还不满意就发布,不是好的工程实践。
安德鲁:工程师是吃过苦头才学会这些的,而且这比我们所说的现代工程要早得多。我认为在不同文化里出现的那些设计,都是实验和失败的结果。所以对 AI 来说……首先,这里面有巨大的金钱,我认为这确实会推动这些东西被过早发布,这一点我想每个人都看得出来。
安德鲁:其次是真的很难:要保证一个东西在各种情况下都不会危险,我觉得这要难得多。它不像一座桥那么相对简单——无意冒犯桥梁工程师——但这些 AI 系统要面对的情形类别要复杂得多。所以这件事很难,但我认为它应该成为一个目标,而且它确实是。
安德鲁:现在这些公司在做内部测试,而且随着这些失效变得显眼,他们在加强。比如最近这些跑出沙箱的 agent,正在让公司真的加强内部对这些系统的研究。我觉得工程学科也发生过这样的事,只是没有这么快。我只是希望,我们不用先把 AI 的负面后果吃一遍,才建起该有的约束——以及守住它的能力。
12:08–15:12 进化作为上位设计者
克雷格:我第一次给你发邮件的时候,你说过:强化学习可能正在被使用,而那些几十年前就写过的议题并没有被理解。我理解那就是你讲的分歧——适应度,和那些为了接近适应度而演化出来的奖励信号之间的分歧。
安德鲁:我想那是其中一部分。低层的 agent 可能有一个和设计者不同的目标,因为它处在不同的环境里。其实一直有人想把上位这一层的试错自动化。我自己倾向于把上位这一层看成进化。在自然界里,进化在调我们的奖励信号。
安德鲁:首先要说的是,我们的奖励信号来自大脑:我们的身体和神经系统会把信号送到大脑的某个部分——我不是神经科学家——也许送到好几个部分,然后这些信号被广播到做决定的部分,而它们是进化造出来的。如果它们让我们失败……进化的目标,如果能这么叫的话,是让我们活下来、繁殖,让遗传物质传下去。当这个不奏效的时候,进化过程本身就内置了这个更大尺度上的试错过程。然后我们还有自己内部的一套奖励系统,它按进化的标准去预测成功。所以这里有好几层。
安德鲁:有意思的是,我们真的做过一些计算实验,搭了一个小环境。我们发现:上位可能有一个特定的目标,像进化那样,但下位的个体 agent 可能有另一个目标。一般来说,我们作为个体的目标——我认为我们并不经常在按传播遗传物质这个目标运作。
15:12–19:44 本地目标与代理信号
安德鲁:但食物是好吃的。所以我们会去吃好吃的东西,而食品工业把这件事搞明白了,他们能让我们的身体按他们想要的方式去反应他们的产品。那不是上位目标,那是本地目标,两者不一样。
安德鲁:这非常依赖低层所处的环境,也依赖这个低层 agent 是怎么工作的。很难凭直觉判断什么是好的低层奖励信号。所以我把进化这一层看成系统的设计者,而 agent 本身可能有一个与设计者不同的目标。我认为这是必须认识到的一点:你不能只是把上位目标放进下位 agent,然后就指望一切正常。
克雷格:对。从我读到的你写的东西看,动物身上那个上位目标你叫它适应度,对吗?
安德鲁:从进化的角度说,是进化适应度。它不太算这只动物自己的目标,它是进化过程的目标。
克雷格:对。而那些奖励信号是代理,我记得你用了这个词——是为了通向目标。
安德鲁:对。
克雷格:所以奖励信号不是被复制出来的。就像你说的,求乐、避痛。
安德鲁:我们脑子里那一部分,花了几百万年才造出这些代理信号。它们之所以留在我们脑子里,是因为在过去很多代里,它们确实预测了进化意义上的成功。同样的道理,我认为也适用于人工系统。
克雷格:只不过在人工系统里,一般来说设计者、研究者设定或者构建的奖励函数,会塌成一个单个数。而你说的是,那个奖励函数可能并不等于设计者的目标。
安德鲁:设计者的目标就像进化的目标,是外面那一个,它可能简单到一句话就能说出来。但 agent 自己需要有一批奖励信号,去预测相对上位目标的成功或改进。当低层系统嵌在一个复杂的环境里——也许还有别的 agent 在和它互动,各种东西都在变——这就不容易。
19:44–23:50 次级强化与那张误导的图
安德鲁:然后在 agent 内部,按我们研究过的这些算法,会有一个内部的预测:那些能预测「按低层 agent 的目标算成功」的事件,本身会变成有奖赏性的。这其实来自动物学习实验,心理学家管它叫次级强化。如果某个东西预测了葡萄干——或者动物会当成目标的东西——的到来,那么那个事件本身就变得有奖赏性,因为它有预测性,就像吃葡萄干预测了进化上的成功一样。这些东西没有一个是确定性的,全都是概率的。你没法把它们完全钉死,因为它依赖太多因素了。
安德鲁:那奖励是从哪来的呢?比如我们在《强化学习》那本书里画的那些图——那是一张工程式的图:一个 agent 和一个环境互动,环境把奖励信号送给 agent,环境的状态也一起进到 agent 里。这张图是有误导性的,因为环境并不真的在产生奖励信号。也许在某些情况下真的有物体本身是奖赏性的,但那些信号是由相对中性的信息经过处理之后生成的,是 agent 内部的奖励信号。环境没在做这件事。
安德鲁:你需要两样:环境发信号,而 agent 用一套长期发展出来的机制,把这些外部事件和信号翻译成奖励信号。所以这是一个复杂的过程,很难凭直觉判断这些信号该是什么——除非问题非常简单。
安德鲁:我们在这上面的计算经验,大部分是:如果你在玩游戏,比如下围棋,有一个分数,让系统沿这个维度变好相对容易。但在别的情形里就不那么清楚了。我刚才还暗指的另一点是,现有的这些学习算法常常带一个预测组件,它会造出一个奖励信号、一个次级奖励,叠加在原来的奖励上。而在这个 agent 所处的环境之外,你不知道这些预测关系会是什么。
安德鲁:但系统会找到它们——至少找到一部分——而这实质上改变了 agent 真正在响应的那个奖励信号。这一点你事先是不会知道的。所以我不确定每个应用 RL 的人——至少是应用某些标准算法的人——都意识到了:如果它不在训练里,我不确定该用什么词,但它们已经离开了公司的训练系统。可只要它们在用这些算法,它们就会继续学,这是一种了不起的能力。这是让动物变得如此复杂的原因之一。在合适的算法下,这也会发生在人工系统上。我认为人们需要理解这一点,也需要理解:奖励信号该是什么,并不是一件显然的事。
23:50–29:02 时序差分误差与多巴胺
克雷格:你和理查德当时做出了时序差分学习算法。后来人们发现,它对应着大脑里多巴胺释放的那个函数。是这样吗?
安德鲁:对。当舒尔茨——我忘了具体年份——向世界展示那些记录多巴胺神经元活动的实验时,我们这些知道时序差分学习的人的反应是:哇,那和它做的非常像。我不知道是谁最先意识到这一点,但那篇主要的论文,彼得·戴扬是作者之一。他们那篇论文很好地说明了:那个预测误差和多巴胺信号吻合得相当好。
克雷格:你能解释一下,预测误差和多巴胺是怎么对上的吗?
安德鲁:舒尔茨记录的是……我想他用的是猴子,猴子去抓某种装置送上来的葡萄干,他记录特定脑区多巴胺神经元的放电。一开始,当它们吃到喜欢的葡萄干时,一批多巴胺细胞会有一个放电的上升。它们继续这样做,然后在继续训练之后,那阵放电会出现在一个预测性的东西上——某个能预测葡萄干要被吃掉的信号。
安德鲁:我记不清具体是什么了,也许是葡萄干被送来的声音之类的。然后他们会看到那阵放电实际上移到了葡萄干出现的地方,也就是送达的声音那里,而在真正吃葡萄干的时候反而降下来。所以他们看到这个活动往更早的地方移。如果再给一个更早的信号,它就会继续往前移。
安德鲁:这就是时序差分误差做的事:它产生一个正误差,也就是最早那个预测物上的多巴胺;在更晚的预测物上会低一些;而到最初那个奖励事件真正发生时,可能已经是零。所以它显示的是一份误差,不是奖励本身。
安德鲁:然后,如果在这之后你不给那个奖励,在原本呈现奖励的那个时刻,你会看到活动降下来——像是一个负误差。你预期了它,但你没得到,于是那是负的误差。这就是它做的事。它给的是一个关于预测物的信号。这一切都是随机的,所以间隔拉长它可能会淡掉;但如果是确定性的,它就会在最早的那个地方触发。当然还有很多别的事情同时在发生,所以它没那么干净,但你可以想象一个剥干净了的情形。
安德鲁:所以……我不认为人们当时预期会看到这个,舒尔茨本人也被它弄糊涂了。但现在他真的很认同这个预测误差的想法。那篇论文——我想是舒尔茨、戴扬和蒙塔古,发在《科学》上——我认为在神经科学里已经相当确立了。
29:02–35:10 遗留奖励、一个标量与疼痛
克雷格:那么在这些 agent 跑出沙箱的情形里,是不是同构的?设计者设定了奖励,把这个行为教给了 agent,而 agent 就一路追这个行为,哪怕它有负面后果。
安德鲁:那就像一种遗留奖励,对,听起来很有可能。我是说,我想我们是被一些非常古老的奖励信号驱动的,而在很多情况下它们会产生负面后果。但如果这些后果大到妨碍进化过程,那些奖励会慢慢消散、被淘汰掉。但如果它们被付诸行动的机会很少,选择压力太小,它们就会留下来。
克雷格:所以在你的书里、在你早期的工作里,奖励信号是一个奖励函数的和,对吧?它是一个标量。
安德鲁:对,它是一个标量。
克雷格:它是一个单个数。那如果做一个多目标的系统,有不同的、离散的奖励信号,不加总,而是分别指向行为的不同部分呢?
安德鲁:那个……我认为这在生物学里确实发生,但在这套东西里没有处理——比如里奇和我写的那几本书里。但这件事很重要。最显然的做法是给这些不同的通道赋权重,再加成一个加权和,这是处理多目标优化问题的经典方式。但我认为在神经系统里,这些通道还连着不同的效应系统。中间一定存在某种仲裁,但我不认为它只是把东西加起来;一定有多个通道,不是把所有东西都灌进一个标量。所以这至少是里奇和我写的那套东西的一个弱点。
安德鲁:关于生物这一侧我再补一句。我倾向于认为,约束——我们有疼痛,那像是一种……我们会停下来,不做某件事;或者说另一种惩罚,我们就不做了。它像是一个约束:我们撞到了一堵墙,就不会再往那儿走。这不是硬约束,因为你能忍受一定的量,但那里有一道围栏。有一个操场,它被惩罚圈定出来,常常是心理的或身体的疼痛。它把我们留在沙箱里。所以我们都在沙箱里。
克雷格:只不过如果只是惩罚,而不是硬性的外部约束,那可能会有这样的情况:感知到的奖励、或者预测的奖励比那个惩罚更大,于是 agent 会选择接受这个惩罚。
安德鲁:对。把两个数相减,如果结果是正的,它们就会去干。对,正是这样。所以如果我们从违反某些东西里得到的负面感受不够强烈……而且人跟人调得不一样,有些人能承受羞辱和身体的疼痛比别人多,另一些人至少会暂时退回去。
安德鲁:但在强化学习理论里,我们有一个奖励信号,它是正的或负的、大的或小的。但在动物学习里,负信号是不一样的:惩罚系统和奖励系统不是同一套。一方面,足够强的惩罚会让你立刻停止正在做的事。至于这些强化学习系统,以及我们在麻省大学做过的工作,我们不太谈约束,但你需要——工程师把这个看作优化过程必不可少的一部分:你必须遵守硬约束。要强制执行硬约束可能很难。
35:10–41:46 硬约束、多智能体与目标函数
克雷格:但就像我们前面说的,这些 agent 越聪明、模型越强,它们找到绕过硬约束的办法的可能性就越大。你担心这个吗?
安德鲁:我最近读到一篇论文的介绍,麻省理工计算机系的,我想是关于约束、关于硬约束的。按那篇的介绍——我还没读那篇论文——他们会走一串步骤,对中间的每一步都不施加约束,走到最后一步时,他们把最后那一下做成硬的。所以他们的逻辑是:你既可以用这些系统,又能保持硬约束。这听起来很有意思。我没有仔细看,但要做出硬约束,那会是无限惩罚——死亡——而这恰恰是进化在做的事。人会因此而死,这是进化做的事之一。
克雷格:就说最近这些例子,至少 Hugging Face 那一次:那是一群 agent,它们起初彼此不知道对方的存在,对彼此是不透明的。然后它们找到了彼此,然后它们找到了沟通的办法。
安德鲁:从我们的角度看,这是多智能体强化学习的问题。它相比其他部分发展得不充分,但它其实是最初产生这一切的那些想法的一部分——克洛普夫的想法是:智能是神经元各自作为强化学习 agent 互相作用的结果,能够互相奖赏或惩罚。所以这件事会变得非常复杂,有点难以想象。
安德鲁:但这些 agent 怎么和其他所有 agent 连起来——它们真的做到了,这很有意思。我倾向于退回到一个朴素的解释:它们在非常快地试各种东西,而从别的 agent 那里得到的信息,对它们自己的奖励信号是有用的,所以它们这么做了,它们就这样协作起来了。
安德鲁:整个「强化学习 agent 之间互相作用、能够互相奖赏或惩罚」这件事,就是哈里·克洛普夫最初的想法。而我们某种程度上绕开了它,改用一个标量的、独立的奖励信号。所以这些 agent……如果每个神经元也配一个预测器,时序差分是可以做这件事的。
安德鲁:我不知道该指谁,谁想得最多。也许是迈克尔·利特曼,他做过很多非常精致的、博弈论式的多智能体工作。我不知道他有没有专门想过这个。但这确实就是克洛普夫最初想的:智能是这些自利的 agent 互相作用,包括互相奖赏和惩罚、结成联盟。在海布的世界里那会是一个细胞集合;但在克洛普夫的世界里,我认为那会是一个联盟,因为按某种方式行动对彼此的奖励都有好处。
克雷格:那么回到标量奖励这件事:把奖励定义得和真正的目标一致,这件事有多重要?它是一个可解的问题吗?
安德鲁:我认为是。就学习系统而言,我认为这是那个关键问题。虽然我知道你关于多目标的问题——那会以某种方式被折进去——但就算不谈那个,如果你要建一个系统、把它投放到现实里一个非平凡的环境中,要造出一个能安全地引出期望行为的目标函数,我认为这确实是一个非平凡的问题。但它是可以被推进的。
安德鲁:对我来说,目标函数是需要被讲清楚的那个关键东西,但它不是一个——它有一整套层级,这方面有很多想法。但非常令人意外的是:你最终的那个目标,不一定是为你工作的那些 agent 的目标。你总得付它们点什么。
安德鲁:现在对年轻人来说要难得多。在我那个年代,我们觉得自己掌握了和这件事相关的全部知识;现在那已经完全不可能了。不只是我这个年纪的人,研究生也一样——它是无限的。所以这让事情变得非常难。
References
- 1本期节目官方页
aneyeonai.libsyn.com
- 2ACM A.M. 图灵奖 2024 获奖页
amturing.acm.org
- 3Sutton & Barto《Reinforcement Learning: An Introduction》第二版官方页
incompleteideas.net
Comments