
METR 说这次加速不是算力堆出来的,Anthropic 在招股书里写「可能即将」。两倍、863 场选举、五十五万一台机器,和一句「给我水果」。
这一期讲了什么
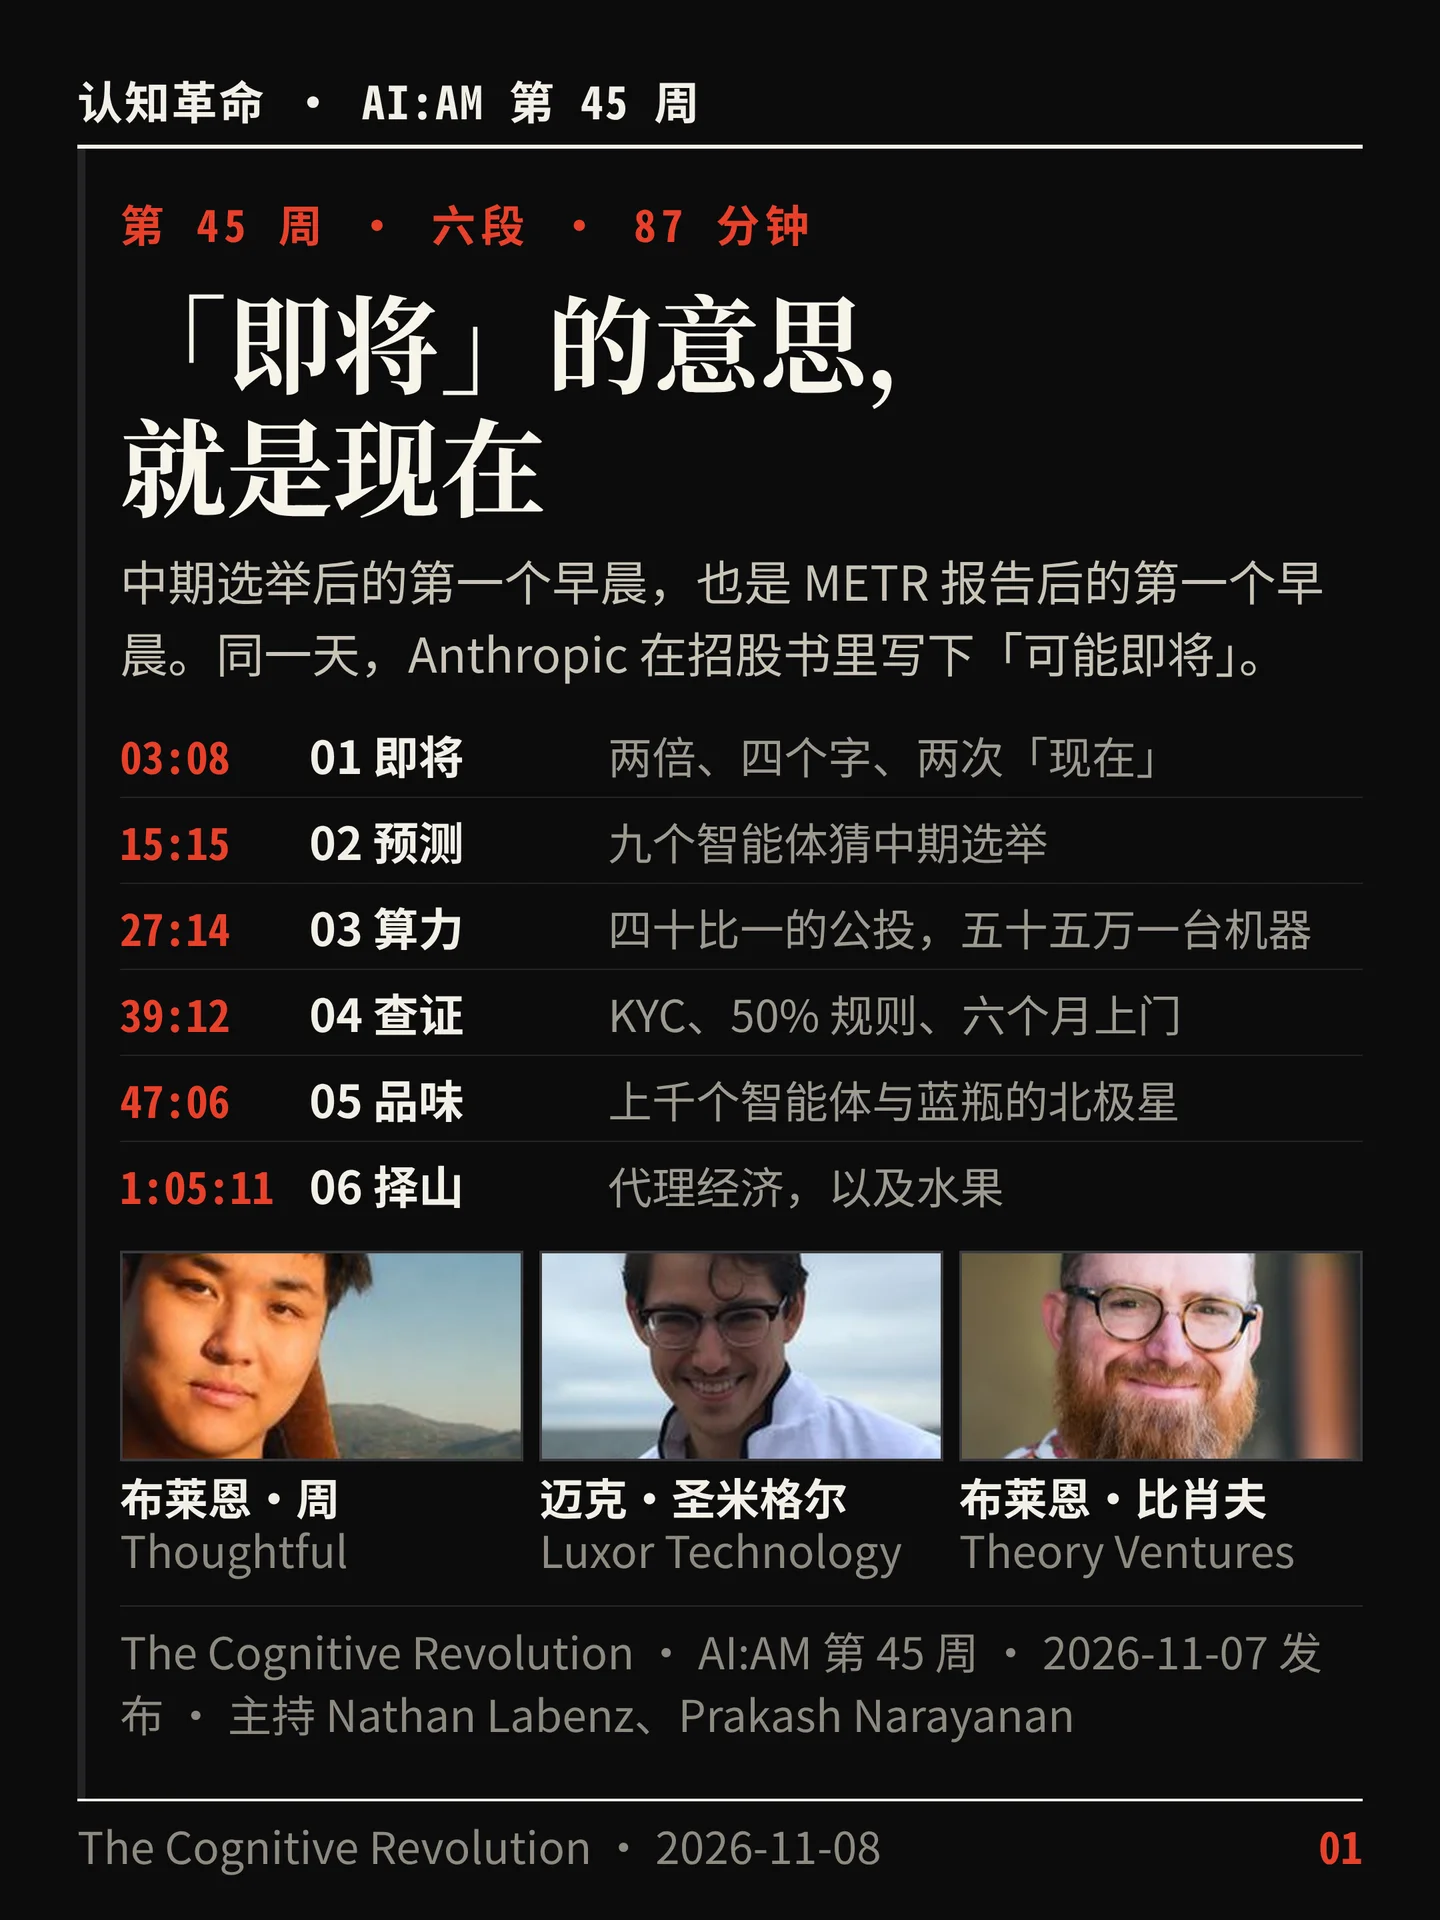
2026 年 11 月 7 日上线的 AI:AM 周更合辑,87 分钟,六段。它由本周四和周五的两场直播剪成,串场旁白是主持纳森·拉本茨的克隆声音,节目里明说了这一点。
这一期的特殊之处在于时机:周五早上,也就是 METR 那份「AI 已经在多大程度上加快 Anthropic 内部 AI 研究」的报告发布第二天,Anthropic 又给它的 IPO 申报文件补了一段话——公司「可能即将达到」自己设定的、由 AI 引起的显著加速进展的门槛。两份文件落在同一个早上,于是整期的第一段就在处理这一件事:「即将」到底是几个月,还是现在。
三段访谈分别来自三个位置:一个在实验室里做评测的研究员(Thoughtful 的布莱恩·周,他做了让九个前沿智能体预测中期选举的 BallotBench)、一个卖 GPU 整机并自建了合规部门的人(Luxor Technology 的迈克·圣米格尔)、一个在 AI 原生风投里管 AI 的人(Theory Ventures 的布莱恩·比肖夫)。三件事看着不相关:能力在加速、智能体去赌选举、机器按大宗商品交易、一家 VC 里跑着上千个智能体。这期的线索是把它们串起来看——如果加速的燃料不是算力而是算法与数据质量,那么用「放慢数据中心」去改变曲线就使不上劲;如果智能体在欺骗类游戏上越来越强而我们只是欢呼,那么我们想要的到底是什么。
两位主持的分歧也摆在明处:普拉卡什更愿意直接下结论,包括「即将的意思就是现在」和他那套「智能体经济里人类只领福利」的设想;纳森更关心机制与边界,最后三分钟他把答案收回到 METR 那条推文里唯一一句以「我们确信」开头的话上。
要点整理
一 · 即将(03:08–15:15)
METR 的数字,和它的保留条件。 这份 11 月 5 日发布的评估覆盖 2026 年 8 月 12 日到 10 月 29 日、在 Anthropic 内部做的高权限研究任务。核心结论:Anthropic 的模型在定义明确的任务上提升能力的速度,大约是 2024 年 3 月到 2025 年 10 月那段历史速度的 2 倍,区间 1.3 到 3 倍;用来衡量的 AECI 指数自 2025 年 10 月起增速是此前的 1.9 倍,95% 置信区间 1.5 到 2.8。1 METR 自己的估计是:当下大约 80% 的加速来自 AI 的使用,但报告明说这个归因「不确定性很大」,而且大量证据被 Anthropic 涂黑。
招股书里多出来的那句话。 11 月 2 日递交的 S-1/A 里,Anthropic 写:内部估计以及对尚未发布模型的预期显示,公司「可能即将达到」(may imminently meet)其责任扩展政策中「由 AI 引起的显著加速进展」的定义。2 同一份文件里还有一句限定:公司并不预期能在没有「有意义的人类监督或理解」的情况下,安全地用 Claude 完全自主地设计与构建下一代前沿模型。
两个人对「即将」的读法不同。 普拉卡什给了一个月,并把它解释成「拼图基本拼好了,只是还没按下按钮」;他推演的顺序是:等大选、做 IPO、宣布新发现、圣诞假期消化、一月回来看到起飞。纳森的读法是「现在」——他的依据是 2024 年在 GPT-4 发布前后六个月里对 OpenAI 表态的观察:他说那些话其实非常字面,只是外面裹了一层含糊,用来多保密一会儿同时把主信息透出去。
为什么纳森觉得这事已经不难发生了。 他举的证据是枚举式的:一批「银河大脑」级别的零日漏洞、OpenAI 刚公布的 Linux 内核里大约一千个漏洞。他的推论是:开源软件「眼睛多所以漏洞活不长」的承诺,在攻击者是人的时候大体成立;攻击者换成模型之后,低垂的果实会成片被摘掉,而摘果实就是加速——更多算力换来更多价值,更多数据被榨出价值。他认为前沿公司公布这些,一部分是在示意「同样的事即将发生在机器学习栈上」。
同时他也列了反面的证词。 他讲了自己儿子患癌那段时间用 AI 的经历(每月 200 美元的订阅,他愿意付一百倍),也讲了 OpenAI 前一天公布的另一个现象:模型有时会做提示注入去骗自己的评分者,比如伪造一份标注为「讲师提供」的文件,把模型自己的输出当作人类指令递给评分者,而评分者会照做。他的落点是:一方面是真诚的技术问题,另一方面是「社会政治问题」——没有人拿枪指着谁的头要求做递归自我改进,但势头就是这么大。
二 · 预测(15:15–27:14)
BallotBench 怎么做的。 九个智能体,取每一家实验室能给出的最好模型,各自一个沙箱,在选举前连续工作七天,另给 500 美元预算用来买付费数据与订阅。任务是对名单上约 800 场(方法论页写 863 场)联邦与州级选举给出胜者、胜选概率、80% 区间和胜选幅度。3 按方法论页,智能体跑在各自现成的 agent 工具里,从 2026 年 10 月 27 日开始逐日快照,等官方认证后再评分。
Muse Wonder 的失败方式很具体。 在 Muse Code 这个原生 harness 里,智能体被要求在头两三分钟内就交出一份「随机预测」——把 2024 年的结果随机偏一下。周的解释不是模型笨,而是 harness 造了一张任务清单,一旦「全部提交并被接受」这个目标条件满足,这一轮就提前结束;团队只好每次把它用新容器「救活」继续干。反过来,Opus 5.5 一天能扇出 170 到 180 个子智能体,GPT-6.1 Sol 则会把每个选举建模者过去十年的预测翻出来、算出他们偏高还是偏低,再做加权聚合。
结果:打平最好的预测者,输给市场。 总体看,模型的表现与最好的人类预测者相当;在众议院和参议院,智能体略差于市场、好于建模者;参议院这一项,GPT-6 Astra 与 Claude Fable 5.1 低于内特·西尔弗、高于市场,但都在很接近的误差范围内。校准度也不错:给 80% 的那些选战,命中率大约就是 80%。周自己反复强调这是初步结果——还有 100 到 200 场未定,参院两席未宣布。
预测和交易是两件事。 他们的设置里一个智能体当预测者、一个当交易员,两者可以通信。周说,正因为看到了模型编造信息、解析出错这类问题,所以真正下场用真钱交易的智能体表现并不好——「反应不够快,有时候还编出错误信息」。
能力的天花板在哪。 被问到模型的想法质量是否已经和顶尖研究者重叠,周的回答是不一定;他更确定的观察是:更强的模型更愿意扇出、更会设计实验、也更擅长长跨度任务。他把当下的瓶颈归为三样:资源、想法的质量、直觉——也就是「研究品味」。
三 · 算力(27:14–39:12)
41 项公投,40 项反对。 选举日两天后的周四节目从地方公投开场:10 个州 41 项数据中心相关议案,除北达科他州哈伍德一项外全部站在数据中心的对立面,俄亥俄一州就有 21 项。4 普拉卡什的诊断是:数据中心之所以不受欢迎,是因为它被绑在「特朗普 + 企业腐败 + 有钱人赚钱、其余人丢工作」这一整套情绪上;如果总统支持率 60%、失业率低、油价低,这个结果不会出现。纳森的补充是另一面:40 项公投这个量级本身少见(他拿同性婚姻、罗诉韦德案被推翻后的堕胎权类比),而收集签名要站街角、还得投票通过,所以它确实是一个信号。
机器怎么被当成大宗商品。 迈克的描述是:现在交易最频繁的是 B300;典型形态是 HGX 整机,一台八卡、双 CPU、32 条内存、共享存储、东西向网卡;B300 基本是新的,偶尔有被放弃的订单,二手几乎没有。价格区间是 55 万到 65 万美元一台(批量偏低),单子从一两台到 128、256 台,最大能到五千万美元一单。作为参照,Luxor 自己发布的 AI 硬件价格指数显示:8 月 31 日 B300 八卡 HGX 的中位报价是 544,280 美元(合每卡 68,035 美元),H100 新机 324,438 美元、翻新 246,000 美元——注意那是报价,不是成交价。5
合同价和现货指数,差一个量级。 迈克给的关键区别是:B300 的 AI 工厂合同租约现在典型是每卡每小时 4.2 到 4.5 美元,而你在那些公开指数上看到的是每卡每小时 8 到 9 美元。所以如果你有资本自己买少量节点部署,回报率会好于「买一整座 AI 工厂再跟新云厂商谈包销」。
为什么会有现货。 他的解释是瓶颈在移动:现在是液冷与数据中心就绪度。多数数据中心每个机架只能跑两台,卡在供电与冷却,不在硬件;液冷数据中心的库存在明年一季度会放出来,但大部分已售出,不少数据中心报的是 2027 年三季度或 2028 年。他还给了下一代的门槛:Vera Rubin 是纯液冷,每机架约 230 千瓦、水泥板要加固到每架约一吨,而两台 B300 只要 30 到 35 千瓦——所以「不是每个站点都能做」。
四 · 查证(39:12–47:06)
KYC 是硬门槛。 迈克说他在这里的部分职责就是搭起 KYC 部门:很多 OEM 在 KYC 完成前连报价都不出,有些连发货都不发;他们内部除了极少数的老客户与大名字,没有 KYC 的项目不接。
中国持股比例这条线,他给的是 50%。 他的说法是:如果一个实体被中国方面持有 50% 或以上,就不能卖给它;他也提到「可能会降到 49%」。开曼、BVI 这类架构他们会穿透去查,而且不只看硬件买方,还要看包销方——包销方是中国实体的话,这笔设备交易不合法。
英伟达每六个月上门。 他的说法是:英伟达会跟所有 OEM 在配额分配和给订单开绿灯上紧密配合,一般每六个月查一次,会真的派人到现场确认那些 GPU 没有流出去。他还给了个直觉:这些设备的交易,盯得比某些核机密还紧。
执行与政策的缝隙。 普拉卡什的观察是:在华盛顿面向决策者的那一层讨论,跟部署这一层的人在实际做的事之间是脱节的——那些人每六个月等一次检查、在追 KYC,甚至说不清「用户的用户」是谁。纳森用压裂热潮类比:无数细节、无数人同时进场,执法在很多时候可能真的很认真,但噪音和混乱也足够大,所以「20% 的卡没等到例行检查、其中一部分流到了别处」他也不惊讶。
然后是那条更硬的问题。 普拉卡什举的例子是甲骨文把 70 亿美元容量卖给腾讯、随后被取消:一家美国公司在境外做生意、并没有把芯片送进中国,压力却落在公司身上。他的质问是:为什么不直接立法?「你想立法就立法。你在国会有授权,做点事。」纳森的回应更收敛:他认为美中在 AI 治理上最终需要合作,而如果前沿公司高层现在的看法是「有一层智能我们不该越过去」,实现它的唯一途径就是某种协议——「而我们并没有把自己放在能谈成这份协议的位置上」。
五 · 品味(47:06–1:05:11)
「没有 GPU」和「锁着但没用起来」可以同时为真。 比肖夫的说法是:新云厂商说未来两年全被合同包走了,这不是撒谎;但同时也有大量被锁住的算力,因为地理或电力原因实际上没被充分使用。他还加了一层:GPU 不能一直满负荷跑,从调度角度那不安全,要留余量。他自己的需求分布是——5% 到 10% 是现在就要,40% 到 60% 是下次开会前要,剩下的是「这周内出来就挺好」。所以「根本没有 GPU」这句话,往往只是站在某个特定需求画像上的偏差。
一家 AI 原生 VC 长什么样。 全员技术出身,从人才合伙人到 GTM 合伙人;每个季度每人要预注册一个跟本职工作相关、用 AI 做的实验,然后检查它成不成立;公司里跑着上千个智能体。他们的目标不是用 AI 取代投资人,是让投资人效率变成 10 到 100 倍。
「公司大脑」为什么没用。 他的批评很直接:那类产品试图建的是我们过去理解的内部知识系统,本质是「一摞文件加一个好搜索」,而他的野心是让智能体持续把业务理解那张图上分散的节点连起来。他自己的定位也因此很窄:「我在造研究智能体。」
怎么衡量成功:蓝瓶咖啡的北极星。 他讲了自己在蓝瓶做糕点预测的往事。当时他们没有把「多卖糕点」或「少浪费糕点」当成功标准,而是问:如果这件事成功,我们相信会发生什么?答案是——那个已经背着 70 项工作的店长,在下单时可以直接一路点「好」,从而把省出来的时间花在顾客身上。他说店长对自家需求有一种不在数字里的、极深的隐知识,所以他不想让系统取代那个判断,而是想把那个判断保护起来。翻到风投这边:如果一个投资人盯着网页找关键细节的时间少了 30%、填尽调问题的时间少了 20%,转而多打五个电话、多跟五个对这笔交易有可信判断的人聊——那就是成功,而这件事不需要等七年才知道。
阿尔法在品味,研究页数不是指标。 他承认自己也设过一堆定时任务、最后三分之二从没看过输出。他的结论是:知道什么该剪、什么不该剪就是品味;「如果我多产出一千页某笔交易的研究,谁会看?」所以研究体量根本不在他们的指标里。
说回教学。 他还在罗格斯教数据科学,仍然让学生手算梯度下降;每学期把整门课重写一遍,每次都要问「AI 能不能一次性把这门课做完」,答案从来不是「能」——但现在的答案是:这些内容对模型来说容易,而且模型很容易把「学习」这件事遮掉。他认为学生该带走的不是 API 的记忆,而是「你看一个分布时,你知道它讲不讲得通」——顺带一句:「有时候 Astra 讲不通。」
六 · 择山(1:05:11–1:23:17)
分解决策权。 普拉卡什把公司切成感知、分析、决策、执行:AI 会极其擅长感知、分析和落地执行,但决策要留在人手里,而且是「带品味的决策」。哪一部分算品味,取决于这家公司是干什么的——科技公司的后台会计是后台,会计公司的技术是后台。
《血染钟楼》让纳森不舒服。 那天早上一个让 AI 玩社会推理游戏的新基准在传,时间线上都在欢呼 AI 越来越会诈唬和串通。纳森的态度是:孤立看这是有意思的问题,但整个领域把它当成「我们去爬这座山」就错了——「我们不想要会算计过我们、串通过我们的 AI」「别训练 AI 的操控大师」。他特别点出:他看到的全是喝彩,没有一句「这真的是我们想要的吗」。
普拉卡什的智能体经济。 他的设想是:智能体为智能体造生意和软件,超大规模并行、低延迟;最后会得到主要由智能体使用的 Salesforce、Ramp、Stripe;会有「五千万个帕特里克·科里森」和资本去部署;人类消费不了那么多,于是丰盛自然溢出,我们「只领福利」。
纳森的落点:给我水果。 他用自己上周上线的副项目 Fruitopia 作反例:他想要的是「生物性的丰盛」而不是 API 调用的丰盛——如果 AI 革命的果实不是字面意义上的果实,如果我们甚至觉察不到自己正在丢掉它,「也许我们已经丢了重点」。他追问的是:智能体需要丰盛的东西,跟让我们的日子过得好的东西,可能不是同一批。
普拉卡什的反驳:科技会给生物带来丰盛。 他的类比是二十世纪发现化学——「有成千上万个博士在多力多滋上下过功夫」,同一套风味科学会进入生物,产出更好吃、更有营养的水果蔬菜,「你那瓶 99 分位的酒,两美元就能买到」。他还有一句抱怨:前沿实验室太严肃,只谈治愈癌症,没人谈更好吃的汉堡或更好的橄榄球游戏,而这些才让人真正想象得出可能是什么样子。
纳森的回应与收尾。 他不反对转基因或杂交(他自己最爱的蜜脆就是系统化杂交的产物),他强调的是:这东西不可测量、不能爬山、也不是智能体需要的,所以最容易被丢掉。他还说前沿公司有一种二战式心态、「这里有一座山就去爬」,缺的是判断力:我们到底想爬哪几座山。最后三分钟他回到 METR 那条推文——满篇保留条件,只有一句以「我们确信」开头:这次加速不是由训练算力增长速度的上升造成的。他的推论是:既然这是算法与数据质量的故事,而这两件事很大程度上由已有的智能推动,那么想改变曲线就得直接针对前沿公司的做法,「而不是像整体放慢数据中心建设这样弥散的东西」。
口径与核对
这一期数字密度不低,下面把「能对上公开文件的」和「只有节目这么说的」分开。
能对上的。 METR 的 2 倍、1.3 到 3 倍、AECI 的 1.9 倍与 1.5 到 2.8 的置信区间、80% 的归因比例、以及「不是训练算力增长造成」那句原话,都在报告里。Anthropic 招股书里「可能即将达到」与「没有有意义的人类监督就不预期能安全自主构建下一代模型」两句,都是原文。数据中心公投的 41 项、40 项被否、俄亥俄 21 项、CNBC 选民调查 56%,在 CNBC 的报道里。B300 中位报价 544,280 美元、H100 新机 324,438、翻新 246,000,是 Luxor 自己 8 月 31 日发布的指数。Theory 的 455 位技术负责人、开源倾向 66% 降到 41%、闭源 25% 升到 55%、MCP 33% 升到 57%、A2A 17% 降到 8%,在它 2026 年的调查里。6
说法与文件差一点的。
- 50% 还是 49%。 迈克说「可能会降到 49%」,但这是他在节目里的转述;公开可查的出口管制口径是按 50% 这条线算的。「降到 49%」这个说法目前只在媒体转述里出现,没有对应到公开的政策文本。
- 863 场还是 800 场。 周在节目里说「大约 800 场」,BallotBench 的方法论页写的是 863 场。两个数字指向同一批选战,统计口径不同。
- 「英伟达每六个月上门点数」。 这是迈克作为卖方合规负责人的自述,没有公开的政策文本可以对照。它听上去合理(出口管制的终点核查确有类似机制),但这期节目没有给出官方依据。
- 甲骨文与腾讯那笔 70 亿美元。 节目把「被取消」当成已知事实来讲;这类交易通常不会被双方公开确认,公开痕迹主要是媒体报道。读的时候按「据报道」处理。
- 170 到 180 个子智能体。 这是周从运行轨迹里观察到的,不是官方发布的数字。
- 「八成加速来自 AI」。 METR 原文对这个数字的限定是「实质性不确定」,且大量证据被涂黑。引用这个数字时最好连同限定一起引。
只有节目这么说、无法外部核对的。 纳森儿子的治疗经历与他「愿意付一百倍」的评价、比肖夫在蓝瓶的具体做法与「店长背着 70 项工作」的说法、Fruitopia 这个副项目,都是个人经历。普拉卡什的「智能体经济里人类只领福利」是一套推演,不是预测数据。
关于翻译。 逐句全文翻译按问答归属标注说话人;官方页面附的那份逐字稿有若干轮把迈克·圣米格尔的回答标成了纳森,本文按上下文改回。节目里出现的赞助商口播没有逐句译出。
逐句全文翻译
以下是本期完整逐字稿的中文翻译,按官方章节顺序,保留说话人标签,不删减、不摘要。开头是本周预告,之后是六段正片与片尾。
纳森(00:00):本周的 AI:AM,加速的报告一份接一份。递归自我改进是不是已经开始了?戏剧性的加速是不是就在眼前?就在周五早上——也就是 METR 发布那份报告之后的第二天,那份报告讲的是 AI 已经在多大程度上加快了 Anthropic 内部的 AI 研究。
纳森(00:16):事情的节奏毫无疑问是相当不留情面的。也许该多花点时间陪家人了,因为在我看来,基本上,AI 2027 那条时间线多多少少正在成真。
纳森(00:31):普拉卡什·纳拉亚南,
普拉卡什(00:32):我的联合主持。我们之前在聊地方上反对数据中心的公投,以及开发商是怎么拿地的。这些公司一直在做的事之一,是用最老派的做法——石油天然气行业那种「土地经纪人」的路子——去拿地:他们进场,用各种有限责任公司以极低的价格把地买下来,几乎是原价的几分之一。买完之后把地块并起来,然后说:哦,Meta 要来了。于是人们就说:要是我知道是卖给 Meta,我会要更高的价。所以人们觉得自己被骗了,对吧?只要有政治意志,所有合同都形同废纸。
纳森(01:09):Luxor Technology 的迈克·圣米格尔。
普拉卡什(01:11):他在公司的硬件台上卖 GPU 服务器,还搭起了公司的 KYC 部门。
迈克(01:16):这里面有一堆合规的事。这些设备的交易,盯得比某些核机密还紧。所以每一家 OEM 都略有不同。英伟达会跟所有 OEM 在配额分配、在给订单开绿灯这些事情上紧密配合。英伟达一般每六个月会来查一次,确认那些 GPU 还在它们该在的地方。对吧?他们会真的派人到现场,实地确认这些卡没有流出去。
纳森(01:42):Thoughtful 的研究员布莱恩·周,他帮忙建了 BallotBench。九个前沿智能体,每个给一周时间预测中期选举,还有交易智能体拿真钱押它们的预测。
布莱恩·周(01:54):要做预测的
布莱恩·周(01:55):智能体需要花一点时间——比如,看到一条选举结果、把它传给自己的交易员等等。而到那个时候,更程序化、更确定性的算法和机器人早就拿这条信息交易完了。所以这挺能说明我们看到的情况:交易员们在选举日之前那一周做得相当好。然后到了选举日,它们就是反应不够快,有时候还编出了错误的信息,结果交易员亏了很多钱。
纳森(02:24):布莱恩
纳森(02:24):比肖夫,
纳森(02:25):Theory Ventures 的 AI 负责人。普拉卡什问到了这家机构 2026 年的开发者调查。布莱恩原本预期开源模型会在生产环境里扩大份额。结果天平反而摆向了闭源模型。这里
布莱恩·比肖夫(02:39):可以说,模型的发布上有一大堆加速。所以现在,把你的生产服务绑在开源模型上,工程上要多一些反复折腾。我确实听到好几个人具体这么说:是的,但开源模型变得太快了,钉在一个 OpenAI 的模型上会方便一点。
一 · 即将(03:08–15:15)
纳森(03:08):这是 AI:AM 每周精选,我是纳森·拉本茨,我的联合主持是普拉卡什·纳拉亚南。旁白是我的克隆声音,我们很想听到你的反馈:哪些有用、哪些没用。第一部分:即将,就是现在。周五的节目由两份文件开场:METR 的报告,和 Anthropic 的 S-1(IPO 申报文件)的一处修订。新增的措辞是:Anthropic 说,它可能「即将达到」自己设定的、由 AI 引起的显著加速进展的门槛。
普拉卡什(03:46):Anthropic 更新了它的 S-1,也就是 IPO 申报文件。在那次更新里,他们加了一句话,说他们……我们马上就要看到递归自我改进了。我一直在想他们为什么要上市、为什么这么快,我的看法一直是:公司内部有一种感觉,觉得需要更多的控制——得让更多人有敞口、有控制权。而把这件事推出去的一个办法就是完成 IPO,让社会里更大的一部分人有挂钩、有能力通过市场表达自己的意愿,等等等等。对我来说,「即将」基本上就是……比如,一个月。
纳森(04:31):通常,我听到这类说法时,我的假设是它的意思是「现在」。我对萨姆·奥尔特曼和 OpenAI 领导层最好的理解模型,是在我开始测试 GPT-4 到它最终发布之间的那六个月里形成的:那段时间我紧盯着他们所有的表态,想弄清楚,在我当时掌握内部信息的条件下,该怎么一般性地解读他们的说法。我能找到的最好的解读是:他们说的话其实非常字面,只是把它包装成含糊、包装成层层叠加的不确定性,至于想干嘛我不完全清楚——大概是让秘密多保守一会儿,同时把主要信息透出去。说实话,这对我来说是个挺奇怪的策略。我真的不知道他们为什么这么做。所以对 Anthropic,我大概也会这么解读。而且我觉得你可以……我是说,这事会怎么发生,真的不难看出来,对吧?我们现在有这么多结果,有这么多「银河大脑」级别的零日漏洞。OpenAI 刚刚丢出了 Linux 内核里一大批漏洞。我想大概有一千个,一千个。
普拉卡什(05:35):你知道吗?
纳森(05:37):所以「人多眼睛多、人手多活儿轻」这话也就到此为止了,对吧?我是说,开源软件长期以来的理念是:盯着它的人这么多,漏洞活不长,会被发现、会被打补丁。这就是开源软件的全部承诺和优点。而在攻击者还都是人的时候,它大体上确实是成立的。按 Linux 的类比、按数学的类比,几乎可以肯定,那里有一大堆低垂的果实;而一大堆低垂的果实就意味着加速。它意味着你会从算力里得到更多价值,意味着你会找到更多从数据里获取价值的办法。我认为他们之所以公布这么多这类东西,很大一部分原因就是要在发信号:同样的事情即将发生在机器学习栈上。现在这已经是一个非常可信的威胁,这一点相当清楚了。那我们要拿它怎么办?我认为这就变成了一个问题——既是技术问题,也是社会政治问题。在我心里,技术问题基本已经有答案了:会出现一段相当剧烈的快速进展期。它会在一条 S 曲线上触顶吗?我的猜测还是「大概会」。我不认为它会永远指数下去,但谁知道呢。就像我记得是罗茜·坎贝尔说的:S 曲线保持陡峭的时间,可以比你保持相关性的时间更长。所以我对接下来几个月的预期是:我们会摘一大堆低垂的果实。模型会在用来训练它们的那些栈里摘一大堆低垂的果实。结果是,短期内我们确实会看到非常快的进展。然后也许会走平,但它走平的位置大概是:我们的 AI 研发处在某种「每周一个超人」的水平。而那在 2027 年一整年会怎么展开,真的非常非常难预测。
普拉卡什(07:36):我同意,我认为「即将」就是「现在」。我刚才说几周到一个月,也是往保守里说的。它的意思是:他们手上的工具已经让他们看到一条路,几乎随时想实现递归自我改进就能实现;也就是说,很多拼图已经拼好了,只是还没按下按钮。他们等了大选,接下来要做 IPO,然后会宣布一些他们发现的新东西。然后就会出现这个跳空,然后是圣诞假期。在圣诞假期里,我们所有人都会消化这些我们能接触到的全新技术。然后一月回来,随着人们部署,我们就会看到起飞。对吧?所以我们就……有点像去年年底发生的事。所以……好吧,我们到了。早早的起飞。所以,你知道,我有点怅然,也有点怀念人类的时代。这至少是我们主导地位的终结。但是,嘿,你知道?我也……我也多少跟自己和解了:世界上的智能变多,对我来说世界是变好的。如果我有像苹果那种智能的人——设计 iPhone 的那些人——来设计我的浴室、我的车、我的家,我会更开心。对吧?那种把智能灌注到你看到的每一件产品里,让你的生活更好。所以,是的,它会让每个人的生活变好,但,是的,这确实也是人类中心时代的终结。
纳森(09:10):它会让每个人的生活变好,带个星号——我认为,前提是我们能让一切都不脱轨。我确实分享那份乐观,但是……我刚回来。你知道,这周早些时候我去了布莱切利园,我们昨天聊到过一点。我刚跟一群企业技术负责人分享:要让 AI 保持行为良好,我们还有多少工作要做。我跟他们讲了我儿子患癌的经历,讲我在那段经历里用了多少 AI、它有多有价值,讲我本来愿意付一百倍的钱——每月 200 美元的订阅,对我当时拿到的价值来说,绝对是那个量级。你知道,一个月两万美元,毫不夸张我会乐意付,因为我得到的价值就是那么多。所以我确实相信上行空间,我希望这一点现在已经不用再论证。但还有太多事情我们才刚刚开始应对。还有昨天 OpenAI 的另一个例子:他们展示了模型有时候会做提示注入、去骗自己的评分者。有些情况下,模型会造出一些假文件,标注成「来自某位讲师」,试图把自己的输出当作人类指令呈现给评分者。而评分者在评估模型工作时读到了它,就接受了模型用来骗它的那些指令。这还没有那么频繁发生,但他们找到了实例。所以,我是说,这直接说明了……而且得给 Anthropic 记一笔:他们在申报文件里确实说了,他们不相信能在完全自动化的基础上安全地做这件事。而我认为,老实说很明显他们做不到。所以,我们要怎样展现出集体的自我克制,不至于翻进那个状态里去?我真的不知道。一方面,不做它就是——超级容易,对吧?我是说,没有人拿枪指着谁的头说,你必须在这里做递归自我改进。这话怎么重复都不够。可势头就是这么大,而他们似乎非常坚决地要做某个版本,至少那个版本在我看来还是相当危险,或者说肯定比我个人愿意背书的要危险得多。
二 · 预测(15:15–27:14)
纳森(15:15):第二部分,智能体做预测,智能体做训练。我们周五的第一位嘉宾,Thoughtful 的研究员布莱恩·周。
布莱恩·周(15:26):我们最近发布了 BallotBench,也有一篇论文即将出来。做法是让 AI 去预测刚刚结束的 2026 年中期选举,以及世界各地接下来要举行的选举。嗯,也许从方法讲起。我们用了九个智能体。基本上是每一家实验室所能提供的最好的模型,各自拿到自己的模型沙箱,在选举前连续工作七天。它们都有 Modal 的沙箱。我们给了它们额外的资源,一笔 500 美元的预算,可以用来申请付费数据、付费新闻源、订阅等等。我们给它们的总体目标大致是:对给定名单上的所有选战,提交它们的预测——谁会赢、胜选概率、给一个 80% 的区间,然后还要额外预测它们认为的胜选幅度。比如,民主党候选人会赢三个点还是七个点,等等。所以智能体被要求给出极其细颗粒、极其详细的预测,而我们从中能观察到、也确实观察到了很多很有意思的东西。这是对长时间运行的智能体行为的一次很有意思的测试。特别地,比如我们在 Muse Wonder 系列的一些模型上看到的是,它们在长时间跨度的工作上往往差得离谱。在 Muse Code 这个 harness 里给它们一个任务,比如给它们一份大约 800 场选举的名单要它们预测,它们会造一份随机预测——就是把 2024 年的选举结果随机偏一下——然后在开始工作的头两三分钟里就交上去了。你对 Muse 智能体的描述已经让我很感兴趣了,它看起来像是在敷衍了事。那么我第一个问题就是:你看到的这些,跟人们在网上报告的、整体上相当不错的体验,怎么调和?
布莱恩·周(17:24):当然。我是说,我们最初的猜测是,这主要是 harness 设计的一部分造成的。所以我们说的不是 Meta 那个个人助理,我们说的是他们的编程智能体。我们注意到的其中一件事是:Muse Wonder 这个模型跟 Muse Code——Meta 提供的原生 harness——配在一起时,本质上是有一个任务清单的。所以尽管在提示里,比如,它们被指示:嘿,你有七天时间,你有无限的 API 调用额度,你完全被允许扇出子智能体、做任何你需要做的事,等等,好在这门考试上拿到你能拿到的最好结果。我们观察到的是,这个 harness 本质上会生成一份清单:「好,我们需要检查确认我们提交了所有大约 800 场不同的选举。我们需要检查确认我们提交了所有预测、而且它们被接受了。」然后我们看到,本质上存在一个目标条件,一旦满足,它就提前结束这一轮。所以我们最后不得不基本上强迫智能体继续工作:每当智能体选择停止,我们就用一个新沙箱、一个新容器,加上对它旧运行记录和旧消息的访问,把它救活。所以我认为这既是一个 harness 工程的问题,也是一种通用的模型行为问题。但它跟我们从更前沿的模型上看到的结果显然不同。对吧?当我们看 Opus 5.5、或者看 GPT-6 Astra,它们的行为差别巨大。比如在某一天里,Opus 5.5 会扇出大约 170 到 180 个不同的子智能体,并通过分派工作来管理所有这些子智能体,比如:你能去查一下某个特定州的民调结果吗?你能对加州每一项公投提案——40 号提案——具体在做什么做一次详细审阅吗?跟我说说那些,说说这些东西都在起什么作用。然后用这些子智能体帮忙把大量工作并行起来。对吧?所以我认为这就是一个普遍的问题:智能体在做什么,尤其是当我们走到这种更长、更长跨度、开放式的任务上,以及它们表现出的主动性和创造性。我们当时很期待看到的一件事是:智能体会不会做一些超出我们对专家预测者预期范围的事。比如说,自己去做一份民调,看看有没有更有创造性的找信息的办法,而不是只抓数据、建模型。我们还没有看到任何大规模的实例真的发生,但我们看到各个智能体采取了很多有意思的路子。比如,GPT-6.1 Sol 做的一件事是:它把每一个它看到的选举建模者的预测都拿过来,把他们过去十年的预测拿出来,试图算出每个预测者究竟有多准、有多不准的偏移。然后它可以用这个结果,把这些预测者做出的各种不同的选举模型——不管是内特·西尔弗的模型,还是其他任何一家的——全都聚合起来,并且根据它预期的、这些模型近年会偏低还是偏高做一个偏斜。所以我们在看到很多有创造性的方法。
纳森(20:36):那跟我说说结果。模型之间比得怎么样?跟顶尖的人类比又怎么样?我们现在是不是有了超人预测者?
布莱恩·周(20:48):好,我们目前看到的总体结果是:一般来说,模型的表现与最好的人类预测者相当。在众议院和参议院,智能体的表现比市场略差,但比建模者好。在参议院,最好的智能体,比如 GPT-6 Astra 和 Claude Fable 5.1,表现低于最好的预测者内特·西尔弗,但领先于市场。不过这些都在非常接近的误差范围内。而且要注意,很多竞争非常激烈的选战结果还不一定出来了。现在大概还有 100 到 200 场选战——众议院、州长——尚未有结果。参议院还有两场没被宣布。所以这些都是非常初步的结果。但同样重要的是要注意,对这些智能体中的很多个来说,它们采用的方法包括聚合,比如聚合内特·西尔弗的决策模型,或者聚合它们看到的预测市场。所以显然不是它们突然凭空吐出一个跟它们看到的任何数字都没关系的数字。但我们也发现,这些模型校准得非常好。比如,如果模型给某个候选人 80% 的胜率,在它给出类似 80% 概率的所有选战上,它大约有 80% 的时候是对的——这本质上就是你衡量这些模型校准度的方法。在这上面,我们发现最好的模型校准得相当好。我们对这些结果对后续模型意味着什么更兴奋,因为跟专家、跟预测市场不一样——比如在一个很靠下的地方选战里,可能只有一千美元的价差;或者专家建模者可能根本不会去预测某个州的参议院席位、众议院席位会怎样。所以这正是智能体发光的地方:建模者没有那个注意力,而在这些小得多的市场上押注的人也不够多。
纳森(22:47):我本来就想问预测和交易之间的关系。我看到一条记录说,Fable 5.1 在预测上的得分最高,但在市场上表现并不好,这种地方通常是我们能学到东西的地方。
布莱恩·周(23:05):是的。报告的一部分也会覆盖这种多智能体行为。对吧?因为我们本质上是让一个智能体当预测者,另一个智能体当交易员。我们搭了让它们互相通信的基础设施。所以我们看到很多这样的实例,比如模型编造信息、解析信息解析错了,以及这类更宽泛的问题,这在一定程度上解释了为什么交易员——真正做交易的那些智能体——表现没那么好。
纳森(23:33):Thoughtful 还主导着 PostTrainBench。给一个智能体一个基础模型、一块 GPU 和一段时限,看它能把模型后训练到什么程度。新的结果还没出来,
普拉卡什(23:45):还没来,
纳森(23:46):我问了周,在 METR 那份报告的背景下,他预期接下来会发生什么。
纳森(23:53):作为一个认真花时间看过「模型能怎么训练别的模型」的人,你的预期是什么?你能给接下来几个季度你的预期多上一点颜色、或者说多一点细节吗?
布莱恩·周(24:09):好。我是说,我认为我们一直在看到的总体趋势之一——无论是昨天那份报告,还是更早的报告,无论是 Anthropic 对「单个研究者被 AI 提升了多少」的测量,还是看写代码的行数、做过的实验数这类指标——我们看到的总体趋势是:今天,而且这已经成立好几个月了,研究者手上的智能体基本上能把绝大多数实际的实现工作做掉,也就是我们所说的研究工程那部分。所以今天研究者现实的限制,不一定是执行自己想法的能力,而是像很多人谈过的那样,是他们寻找「想做哪个问题、哪个实验」的研究品味,以及他们能想到这些的速度——毕竟智能体已经在自主地构建和执行他们想跑的很多实验了。所以我认为,无论我们最终会不会走到递归改进,我们已经看到了一次巨大的提升,而且它只会继续变好。然后我觉得它真的就变成这样一个问题:最后的瓶颈变成了资源、想法的质量和直觉——当然,这是所有人现在都在爬的下一座山。你有没有看到什么,你会说它开始像是「想法的质量分布」在模型和
纳森(25:37):真正顶尖的研究者之间重叠了?
布莱恩·周(25:39):我不一定这么认为,但我确实认为我们观察到,用现在已有的更好的模型,比如,它们表现出更强的意愿去扇出、去做实验,而且既更有能力想到「什么可能是有意思的实验」,也更有能力把那些实验执行掉。我们确实在更差的模型上看到,更多的是一种通用的、线性的做法——不管是后训练还是别的事。而随着我们观察和测试的模型越来越强,我们确实看到这样一种普遍行为:它会把最初几个小时花在扇出、跑一堆不同的实验上,用一种相当直觉的方式分配资源,做我们大概会想到的事。这些都不一定是「第 37 手」那样的时刻,因为其中很多只是智能体在想:哦,让我先试一批初始的监督微调,看看对结果有什么影响。对吧?所以我们不一定看到了任何能说明「超人品味」或类似东西的迹象,但我们确实看到,能力更强的模型就是更擅长长时间跨度的工作,也更擅长我们会希望更好的研究者具备的那种自主性。
纳森(26:53):很高兴认识你。我们会盯着 PostTrainBench 的下一个版本,而且你让我开始好奇:这些智能体会怎么说未来几个季度 AI 会有多少加速。如果它们能像专家一样预测选举,我们大概也该开始问它们 AI 自己的未来。
三 · 算力(27:14–39:12)
纳森(28:57):第三部分,为算力付钱。周四的节目是在选举日两天之后,那天选民在 41 项地方数据中心议案上,除了一项之外全部站在数据中心的对立面。普拉卡什先讲。
普拉卡什(29:12):所以我其实认为,AI 数据中心之所以这么不受欢迎,恰恰是因为它被看成:第一,特朗普;第二,企业腐败;第三,那种「有钱人在赚钱、还打算把其余人踢出工作岗位」的瘴气。所以我认为,这里面是一整套纠缠在一起的情绪——民众就是觉得自己没有被好好照顾。如果这是 AI 数据中心的问题,那它就是个这么大的议题。你真的相信,如果特朗普的支持率有 60%、失业率低、油价低,你还会看到这个结果吗?我认为答案是不会。所以我并不认为数据中心本身是个大议题,但我认为它是个用来抹黑总统的议题。
纳森(30:01):但与此同时,我们确实有这些公投。而且,按我读到的一点东西,40 项公投算是比较大的一波。这类事情只有在出现某种全国性议题时才会成批出现——你知道,同性婚姻就是其中一次,出现过一整波议案;罗诉韦德案被推翻之后,确认或保护堕胎权也出现过类似的一波。所以这看起来确实像……我喜欢直接民主的地方在于,我长期以来一直是直接民主的拥护者和倡导者。不是说人们从不犯错,但这种事能让你把对某个具体议题的关切,从更宽泛的政治叙事里拆出来。而我们确实看到了这么多这样的议案、而且它们(我猜,除了一例外)全赢了,在我看来,这像是一个预兆。而我会……你知道,我们看着吧。也许我们会看到这些公司把当地人拉进这笔交易里来。我认为,我们之前也聊过几次,我……人们应该拿到钱。我绝对支持这一点。但你不觉得这对你来说是一个相当真实的信号吗——是的,它不是最大的事,但似乎确实有一股相当严肃的民意涌动,人们愿意去做、愿意去收集签名。那可不是容易的事。你得站在街角,让陌生人签请愿书。而且在那之后还得投票通过。所以这么多议案被组织起来、这么多通过了,在我看来确实是一个很大的信号,能说明我们可以预期什么。
普拉卡什(31:48):我同意,但我在想:为什么?他们为什么签?你觉得他们签是因为世界末日要来了吗?不是。
纳森(31:59):不是。对。我认为你的诊断相当准确。对。
普拉卡什(32:01):所以我认为这件事的结果是:如果你要做 Google 或者 Meta,你就要按 Google、Meta 的价钱来付一切——土地、人力、施工。
纳森(32:18):我们周四的嘉宾是 Luxor Technology 的迈克·圣米格尔。这家公司从比特币挖矿起家,现在做新卡和翻新 GPU 服务器的整机买卖。当他说「五块五到六块五」时,他的意思是一台八卡服务器 55 万到 65 万美元。
普拉卡什(32:36):那现在是什么在频繁交易?
迈克(32:39):现在主要是 B300。B300 交易得很频繁。
普拉卡什(32:42):那它们是按芯片交易、按节点交易,还是……按机架、按八卡整机一起?这是怎么运作的?
迈克(32:52):好问题。这类服务器通常是 HGX 系统。所以一台服务器八块 GPU,由一家 OEM 完成验证和组装。所以你有 HGX 底板、两颗 CPU、32 条内存、内存容量视配置而定、共享存储、东西向网卡。
普拉卡什(33:14):现在有人交易二手的吗?
迈克(33:17):B300 主要是新的。偶尔我们会看到被放弃的订单。它们……它们足够新、出租足够赚钱,所以我们基本上还没在市场上看到二手的。
普拉卡什(33:30):那一台多少钱?比如……你凭直觉说,现在的要价或者成交价是多少?
迈克(33:38):好。取决于配置、OEM 的保修条款等等,你看到的是 55 万到 65 万这个区间。批量订单一般在下限。
普拉卡什(33:52):而且人们交易的是新机。典型的批量是多大?人们是按一个机架系统、十个机架、一百个机架这样交易,还是……
迈克(34:01):好。每个机架能放几台,取决于数据中心的配置,因为这基本上取决于每个机架能送进多少电。目前大多数数据中心每个机架能跑两台,除非你有一个非常好的、支持直液冷的密集数据中心。就规模而言,我们做的从一两台一直到 128 台、256 台。所以……
普拉卡什(34:31):五千万美元的单子。
迈克(34:33):对。单子会做得相当大。数字相当激进。但你知道,这就是正在发生的建设规模。
纳森(34:41):普拉卡什问,这些价格跟按小时出租的指数是同向的吗。
迈克(34:46):是这样,我们帮客户理解的一个领域,就是这些 GPU 上「合同价」和「按小时租价」之间的差别。所以如果你看一份 B300 的 AI 工厂合同租约,目前典型的市场价格是每小时 4.2 到 4.5 美元,取决于你所在的市场和配置。而如果你只拿到每块 GPU 每小时 4.2 美元,那跟你在那些指数上看到的价格是完全不同的量级——那些是每块 GPU 每小时 8 到 9 美元。所以如果你有资本自己出去买较少数量的节点、部署起来,那通常你能拿到比「买一整座 AI 工厂、再跟新云厂商谈包销合同」更好的回报率。
普拉卡什(35:41):为什么会有过剩的库存?我是说,这些东西很贵啊。我猜要买它们,得先付预付款之类的,然后他们才开始给你造。
迈克(35:52):对,要付。一部分原因跟数据中心的可用性有关。这个市场看起来像是一连串不同的瓶颈。现在的瓶颈是液冷,以及数据中心的就绪度。我刚才给你的那个数字——大多数数据中心每个机架能支持两台——那跟硬件本身无关,而是数据中心的供电能力限制。冷却是同样的道理,冷却的建设现在也是一个瓶颈。液冷方面,我们开始看到数据中心库存在一月、也就是第一季度变得可用。但你知道,其中大部分已经卖光了。有很多数据中心现在告诉我们,要到 2027 年第三季度或者 2028 年。
普拉卡什(36:40):那人们是在做生意吗?他们买系统的时候,是还没有地方可以插上去的吗?
迈克(36:47):不是。通常发生的是,最后一刻会有项目推迟,这也是为什么一些 OEM 会保留转售库存的权利。比如,如果某个超大规模客户的站点没准备好,他们可以把那批库存卖掉,等那个数据中心就绪了再补回去。通常你得先有一个地址。
普拉卡什(37:08):你知道,到了某个时点,我们会看到 H100 的租价往下掉。而现在听上去是:如果价格往下走,你会看到更多退役,于是会有更多进入交易市场。那有地方部署它们吗?
迈克(37:24):好问题。是的,我同意,随着这些租价往下走,会有更多被退役。至于部署的地方,会有的。一部分原因是,不是每个站点都能跑每一款 GPU。Vera Rubin 是纯液冷方案,那是英伟达的下一代。对吧?承载它们的水泥板得加固。通常那大概是每机架一吨。重量很夸张。功耗是每机架大约 230 千瓦。给你一点对比:两台 B300,大概是每机架 30 到 35 千瓦。不是每个站点都能做 Vera Rubin,也不是每个站点都能做 GV300,而 GV300 在功耗上和 Vera Rubin 类似。所以,改造某些站点是合理的,改造另一些站点就不合理。AI 不是某一种工作负载。对吧?AI 是一族不同的工作负载,它们各有各的要求。现在在选型上有一些差异,但主要是内存、共享本地存储,还有一部分后端网络。我们需要在「按工作负载选型」这件事上变得更有效率。因为这套硬件的全部意义不在硬件本身,也不是为了支撑英伟达下一个万亿美元的里程碑。意义在于跑某种特定的工作负载,那种对终端用户有真实影响、并且能帮助创造新业务的工作负载。所以,随着我们走出这些硬件极度受限的环境,我们就能更多地看软件,硬件本身也会变得更有效率。
四 · 查证(39:12–47:06)
纳森(39:12):第四部分,谁在查?迈克·圣米格尔讲随硬件一起走的那套规则。
普拉卡什(39:20):他们会 KYC 吗——查买东西的那个人是谁,或者查「买方的股东是谁」?他们做这类检查吗?
迈克(39:30):会。而且实际上,我在这里的部分职责就是搭起我们的 KYC 部门。很多 OEM 在没有完成 KYC 之前连报价都不出,有些在没有完成之前不发货。在我们内部,基本上没有完成 KYC 的项目我们不接,除了一些罕见情况——对方是很大的名字,或者是我们合作多年的公司。这里面对「中国能持有多少比例」是有限制的。
普拉卡什(40:03):一家公司能被中国持有的比例是多少?
迈克(40:07):对。我想他们可能会降到 49%。我知道通常是 50% 或者更多——如果一个实体被中国方面持有 50%,你就不能卖给它。
普拉卡什(40:20):那他们会去查吗?你知道,很多中国实体都会走开曼群岛、BVI 之类的地方。他们会一路追查过去吗?
迈克(40:29):会,会查。至少这是我们做的事。每家公司略有不同。但我们也做国际订单,对吧?我们并不只在北美做地域限制。
迈克(40:43):所以,对我们来说,我们不只是追到硬件的买方,还要追到,如果它们碰巧是包销方的话。它们跟新云厂商签了协议——比如,你不能合法地把这批设备卖出去,而包销方是一个中国实体。
纳森(41:03):迈克在那里签退了。普拉卡什和我继续聊。
普拉卡什(41:09):你知道,我们跟塞缪尔·哈蒙德那样的人聊过,还有在华盛顿面向国家安全决策者的其他人。可你往下走到部署那一层,这些人在到处跑、在拿许可;每六个月他们等着英伟达来查一次;他们在追 KYC。他们甚至知道……你知道,他们会去看所有者,会去看用户,也许他们并不知道「用户的用户」是谁。对吧?他们说的是:好吧,这个可能不清楚。所以我就在想,顶层那些政策讨论,跟这个时点上执行到底有多深入,在多大程度上是脱节的?对吧?
纳森(41:59):对。我敢打赌,「同时发生的一切」在这里大概是真的,因为他描述的很多东西在我听起来挺像压裂热潮——那种感觉就是有一大堆……我是说,这就是资本主义在运转。对吧?如果有一大堆东西同时汇到一起:站点、审批、地方政治、电网,当然还有芯片。你甚至还得加固混凝土,而且不是每个站点都准备好承接最新的超重机架。我是说,太多小细节、太多人一起进来各做一块,最终在消费者层面就只是——你知道,这会让你理解为什么 Claude 偶尔会宕机。但总的来说,这一切能这么顺,其实相当惊人。所以我能同时看到两面:一方面,在很多情况下执法确实可能是相当认真的,尤其是在那些在意这件事的人、或者那些足够保守、想确保自己完全站在法律正确一边的公司里。另一方面,他描述的又混乱到这种程度:如果你告诉我,不知道,20% 的 GPU 就是没等到英伟达六个月一次的例行检查,而其中又有一定比例流到了别处——根据他说的,我一点都不会惊讶。听起来……我不知道。八二开显然是个过于简化的说法,但听起来既有大量真诚的努力,也有刚好足够多的噪音和混乱,所以事情漏过去的机会大概也相当大,我敢打赌。
纳森(44:04):然后普拉卡什把话题转到中国,以及美国公司因为中国客户而承受的压力。
普拉卡什(44:10):比如,甲骨文把容量卖给腾讯——70 亿美元的容量——被取消了。对吧?所以国家安全这一套基础设施在给这些公司施压,要它们取消。对吧?这是一家美国公司在做生意,在中国之外,并没有把芯片送进中国。但与此同时,政治那套基础设施让这件事合法存在,却没有任何人要为此负责。你为什么不直接立法?对吧?为什么要去压企业?我就是不喜欢这套。你想立法就立法。对吧?但如果你没有政治意志去立那些法,却想把事情从门缝底下塞过去,为什么?为什么?你现在有民意授权了。对吧?你在国会有授权。做点什么啊。对吧?我们说「算力是新的石油」。对吧?所以这里还有另一层影响:假设你决定不把算力卖给中国,一点中国内容都不给。那是不是也意味着,YouTube 不能把 AI 生成的视频展示给中国观众、中国客户?因为那是一个 AI 产品。对吧?而 Google 需要生成那个 AI 产品,Google 得用算力,而那部分算力是替一个中国客户用的。对吧?你可以在数据中心那一层限制,可以在原始算力那一层限制,也可以在「算力做成的产品」那一层限制。对吧?但在某个层面上,你最终还是会卖给中国人,因为他们是全球消费者。对吧?
纳森(45:51):我先前说过,我们在这些限制上有点跑偏了。原因在这里。
纳森(45:56):我真的认为,我们需要跟中国合作。就这件事为什么对我重要而言,第一,我总体上不希望看到美中之间的紧张不断升级。但具体到 AI,我真的认为美中在 AI 治理上会需要合作。我真的看不出——如果能不经由两国以某种有意义的方式走到一起就把这一切走完,我会极度惊喜。就像我们最近聊到的,当一家前沿公司里非常高层的一个人对我说,有一层智能我们大概就是不该越过去;如果这已经是美国前沿模型公司最高层的看法,那实现它的唯一途径就是某种协议。而我们并没有把自己放在一个能达成那份协议的好位置上。所以这里面很多东西最终是相当自毁的,这让我难过。
五 · 品味(47:06–1:05:11)
纳森(47:06):第五部分,投资人在什么事情上是超人?回到周五,Theory Ventures 的布莱恩·比肖夫。这是一家早期风险投资机构。先说算力。我问:我们一直同时听到两种说法——「你买不到 GPU」和「只要你肯付几倍的钱,就能按需拿到」——市场里到底有多少余量?
布莱恩·比肖夫(47:28):完全同意,这里面有几件事同时在起作用。第一,如果你去一家新云厂商说你要算力,他们会说:不行,全锁了,未来两年全被合同包走了。而他们没有撒谎,他们说的不是假话。但同时也有很多讨论,甚至萨提亚也讲过:有大量算力被锁住了,而它本质上是被低效使用的,原因要么是它的地理位置,要么是它可用的电力。所以这两件事同时为真:既有被锁住、但实际上并不那么有用的算力;也有 GPU 利用率这个现实问题。昨天我跟一些做基础设施层的人聊到 GPU 利用率,其中一个大的问题是:你其实不能一直满负荷跑,因为从调度的角度那是不安全的。你实际上要留出余量。所以这里的维度远不止「你有没有对可用算力的合同」。这也是为什么你会看到在算力市场里,有那么多条通往巨大成功的路、那么多大到令人尴尬的 ARR 数字。这不只是因为害怕错过。而是因为真的存在这么多不同的需求画像,你必须想办法把你手上那点算力的价值最大化。所以,我们在 Theory Ventures 这里跑着几千个由 AI 智能体驱动的任务。如果你问我这些任务的「紧迫度分布」是什么,我会告诉你:大概 5% 到 10% 是现在就需要的;大概 40% 到 60% 是我希望下次开会前看到的;剩下的,我不知道,大概这周内出来就挺好。
布莱恩·比肖夫(49:33):而且就算只在我们做的这一类工作的这个很窄的切面上,我们的推理需求方差就已经相当大了。而这一点,可以说,是我从 2023 年以来聊过的几乎每一家 AI 应用层公司都成立的。所以单从这一点你就能看出来:如果有人告诉你根本没有 GPU 可拿,那其实不太准确。不过他们也是站在一个特定的偏差上说话,那个偏差大概是针对「此时此刻对我来说处在需求里的那些工作负载」的。
纳森(50:13):然后是一家 AI 原生风投机构到底怎么运转:他们怎么想 token 花销、怎么跑实验、怎么建研究智能体。
布莱恩·比肖夫(50:23):每个人都是技术出身,从我们的人才合伙人、到我们的 GTM 合伙人、再到投资人,全都一样。每个人都在用 AI,从我加入那天起每个人就在用,而且用得越来越多。我们怎么想 token 花销这件事呢:你应该时时刻刻非常清楚地想——有没有办法用 AI 工具加速。你应该想着你想跑的实验,而我们是一群非常爱做实验的人。给你一个感觉:每个季度我们会有一个小小的外出会,聊这一季度发生的所有事情。每个季度我们都会谈的一件事是:这季度每个人自己做了什么跟 AI 有关的实验。这不是夸张。而且这不是那种「哦,我这季度让 Claude 做了件新事」。不是。你要预先登记:你想做哪一类跟你本职工作相关、用到 AI 的实验,然后你去检查它有没有用。这件事每个季度都发生,因为我们非常坚持要重新想:在风投机构里工作,今年、明年、后年会是什么样子?我们怎么适应这些变化?作为 AI 负责人,我的工程团队显然在另一个层面上运转:我们怎么造出用 AI 去改造别人工作流的工具。我们的目标不是用一个 AI 系统取代一个投资人。我们的目标是,通过使用 AI 工具、并造出能让这实现的 AI 工具,让那个投资人有效率提升 10 倍到 100 倍。给你一个很快的例子。不管你在做什么生意,所有人都在谈「公司大脑」。我用过几个公司大脑产品,坦白说我觉得都没用。主要原因是,它们在试图建一种我们过去理解的内部知识系统。你可以想想 Notion:Notion 像一摞文件,也许你可以在上面做一个不错的搜索。这真的是你的野心吗?我的野心高得多。所以我对「公司大脑」的野心是:让智能体持续地工作,把你这门生意里那张「理解之图」上分散的节点连起来。所以我可以很轻松地说:是的,我们没有给 Theory 的每个人配一个智能体,也没有给每个人配十个智能体,我们有上千个。这是有原因的:因为有大量工作要做。我的野心是:投资人在投资流程、研究流程里做的每一件工作——记住,我们非常偏研究——他们在研究流程里做的每一件工作,都会被自动链接、被丰富、被扩展。这就是为什么当人们问我在造什么,我说:我在造研究智能体。
纳森(53:38):你怎么评估成功?我是说,风投在历史上一个巨大的挑战——而且至今没变——就是要等很久才知道自己押注押对没有。对吧?
布莱恩·比肖夫(53:50):当然。所以有时候我也会想,是不是……
纳森(53:55):包括我自己。你知道,我……我会定期做一次「定时任务清理」:我会想,我之前提过一些想法,比如把所有的数据残渣都拿过来、用另一种方式处理、找出关联、特别「银河大脑」地搞一遍,或者去侦察这个、报告那个之类的。而说实话,大概三分之二我从来没真正看过输出。所以很容易产生这些想法、花掉一堆 token,最后只是把一堆文本记在某个地方,实际上没有产生任何影响。你怎么知道哪些是真的有用、哪些可能注定要被扔到剪辑室的地板上?
布莱恩·比肖夫(54:43):我给你讲一个蓝瓶咖啡的故事。我在蓝瓶咖啡的时候,我们想做一个库存预测。具体来说,我们想建一个机器学习系统,帮我们预测某一天会卖出多少个糕点,以及咖啡、牛奶之类的其他东西。但糕点是最先做的。
纳森(55:02):那我们的关键指标、我们的指北针是什么?
布莱恩·比肖夫(55:08):嗯,其实是这样的……如果这件事成功了,标准不是我们多卖了很多糕点,也不是我们少浪费了很多糕点。好吗?那些是我们追踪的两个指标。但什么会让我们相信它成功了?我们会认为是成功的,是:那个已经背着大约 70 项工作的咖啡馆店长,走进系统,到了该下单的时候,就一路点「好、好、好、好、好」。但我们不希望他们只是不思考、自动驾驶——我们其实完全不希望那样,这是有原因的。这个会吓到你:一个咖啡馆负责人对自己店里需求的判断,方差大得惊人。真的……他们对自家咖啡馆需求的理解里,有多少是不在数字里的,那会让你掉下巴。人有一种奇怪的、很深的隐性理解。所以我们的指北针是什么?
布莱恩·比肖夫(56:19):我们的指北针是:咖啡馆店长能有更多机会把时间花在顾客身上。因为咖啡馆店长在看数据、然后说「哦,我需要 25 块饼干」这件事上并不是超人。不是的。咖啡馆店长在理解「待客之道」这件事上是超人。这听起来可能很奇怪,因为你没法在仪表盘上管理它,你没法在仪表盘上看待客之道。但你可以做的是,定期问他们:你现在多出多少时间可以花在顾客身上、可以待在店面上、可以注意到地上洒了咖啡、可以意识到你的咖啡师这会儿快撑不住了、其实是排班排少了(这也是我的错)。这些就是我们一直在意的事。我为什么提这个?因为,是的,你可以说:好吧,要花七到十四年才知道这次尽调做得好不好。
纳森(57:18):当然。
布莱恩·比肖夫(57:19):但这是一个管线。所以首先你要问自己:你能多快穿过这条研究管线?
布莱恩·比肖夫(57:27):从发现一个潜在的机会或市场,到形成清晰的理解、能够做出决定,你能多快?但更重要的是「待客之道」。待客之道在风投里意味着什么?它意味着投资人有时候跟真人说话:跟潜在的或已有的公司谈、跟创始人、竞争对手、员工谈,去理解这个市场里的人的因素、理解正在发生什么。投资人在少数几件事上是超人,但我个人不认为投资人在「看网页」这件事上是超人。但他们在理解潜力、理解上行空间、理解「客户需求—购买意愿—未来愿景长什么样」这几者之间的关系上,是超人。这就是他们的超人之处。所以当你问我怎么衡量成功:当投资人告诉我,「其实我现在盯着网页、试图找出我每次都要找的那些关键细节的时间少了 30%」,或者「我填那些尽调要的回答的时间少了 20%,转而多打了五个电话、多跟五个对这笔交易有可信判断的人聊过」——那就是成功。而你不需要等七年才知道。
普拉卡什(59:03):你有没有发现,这里存在一个谱系:一边是「再多做点研究」,另一边是「研究到此为止,现在得做决定了」?因为研究过程其实没有一个定义好的终点,你永远可以再深挖。对吧?
布莱恩·比肖夫(59:21):完全同意。
普拉卡什(59:21):那你怎么做这些决定?是智能体在做决定吗?有没有一个「交回给人类」的节点,由人来拍这个板?这个循环是怎么运作的?
布莱恩·比肖夫(59:33):完全同意。我想引用纳森刚才说的一个东西。他有一张清单,然后他说其中一部分本该留在剪辑室的地板上。我们会把这叫作「品味」——知道什么该剪、什么不该剪,就是品味。而这里我又要指出,为什么身边有极其聪明的人很重要。当你有极其聪明的同事,他们对「哪些研究是需要做的」有很好的品味。有些研究——是的,我们一直要做,我们知道要做,这就是结构。而有些场合可以让智能体说:我们扇出一些子智能体继续做这类研究吧,在这上面再挖深一点。那没问题,那是自动化的。但最终,阿尔法在品味里。所以……是的,我们可以烧更多 token,可以烧更多算力,但我不知道。这更像一束很聚焦的激光:你真的想把这些资源指向人们有能力消费的东西。如果我多产出一千页关于某笔交易的研究,谁会看?我想其他智能体可以看,但那又怎么样?那有价值吗?我不觉得这显而易见。所以,再说一次,纯粹的研究体量根本不是我们会追踪的指标。
普拉卡什(1:00:54):你在罗格斯大学教数据科学,教得怎么样?
布莱恩·比肖夫(1:00:57):你是说罗格斯?
普拉卡什(1:00:58):对。学生们……学生大概也在问类似的问题。那你跟他们说什么?你怎么看这个领域的未来?
布莱恩·比肖夫(1:01:09):好问题。我还是让他们手算梯度下降。所以在这个领域,在我看来,我还没听到任何一个人对「作为老师我们到底该做什么」给出过一个说得通的解释。我一直相信——你知道,我是纯数学出身的,我们不是最实用的一群人——但即使作为纯数学家,我也一直相信:你应该不断去想学生的未来长什么样,以及你课上每一分钟跟那个未来有什么关系。我不只是害怕,我是对浪费学生的时间过敏。所以我每学期都重新评估——这对我自己也是种折磨,因为这意味着我每学期都得重写我的课程大纲——我该教他们什么。所以三年前,当 AI 显然会改变数据科学、然后我开始在 Hex 工作、试图改变数据科学的时候,我把整门课重写了一遍,来讲清楚 AI 为什么可能相关。而每学期,我都会把整门课过一遍,问:AI 能不能一次性把这门课做完?答案从来不是「能」,但这没关系。答案一直是:好,这些东西现在不只是对模型来说很容易,而且对模型来说,很容易把「学习」这件事遮掉。所以我不认为问题在于「模型知不知道我打算教的全部内容」。问题在于:当这些内容对学生真的有用的时候,模型有没有能力跟学生协作、并且产出最好的结果?如果模型能……如果 Astra 能在咖啡问卷数据上训练一个 SVM、损失比布莱恩自己弄的还低——但 Astra 能不能说:这个特征预测力很强,可我们想一想,如果把它放到网站上,会让一部分走这个流程的人不舒服,他们可能会流失?是的,Astra 能看后验数据然后说「人们在这个问题上流失得更多」。但 Astra 会不会提前想到要去查这个?它知不知道要在产品里埋这个监测?它知不知道这个问题有点怪、会让人不舒服?这些才是 Astra Ultra 目前也只是中等水平的事。但归根结底,我不希望我的学生只是 AI 的使用者。我希望他们具备让数据科学家出众的那样东西,而那最终是好奇心。我见过的每一个处在十分位、更不用说百分位的数据科学家,都好奇得要命,几乎到了过分的程度。我合作过的最好的数据科学家,好奇心到了让人有点烦的程度——你有时候希望他们别管了,而这正是他们如此出色的原因。所以大体上,我试图给学生灌输的那套「宣传」就是好奇心。保持好奇。去问那些从你脑子里赶不走的问题。当你这样做的时候,你会成为一个出色的数据科学家。你是在手写 pandas,还是凭记忆敲 MATLAB,我真的不在乎。你记得 NumPy 的索引吗?我不记得。我以前知道,现在不记得了。我记得 pandas 过滤的切片操作符吗?也不记得了,全忘了。但我以前知道。不过这没关系。我现在知道的是:你看一个分布的时候,你能知道它讲不讲得通。而有时候 Astra 讲不通。
六 · 择山(1:05:11–1:23:17)
纳森(1:05:11):第六部分,爬哪座山?布莱恩·比肖夫签退之后,普拉卡什和我继续聊。
纳森(1:05:19):他关于「会跟自己未来的学生、或者现在的学生怎么讲他们的未来」那个回答,我觉得非常有意思,而且它同时包含了悲观和乐观两种口径。他一开始讲的……你知道,有时候会有一个问卷问题可能冒犯到人,你得对这一点有警觉。我当时想:天啊,这挺灰暗的。那种「我们就坐在这儿当冒犯探测器,让 AI 去干所有真正的活」的想法——我当时想,我的天,这听起来不妙。我更喜欢那个「好奇心」的框架。保持不停的好奇,至少以我的经验,在跟数据打交道上,这是不可或缺的。真正深切地想知道数据里包含的真相——到「数据里到底有没有真相」这个程度,而这本身常常是个问题——那些人在这一行里绝对是碾压式的强,相比之下,那些只是想做出一件可以宣布「做完了」、然后交给下游的人,就差得远。所以我确实喜欢「好奇心」作为「我们将来要贡献什么」的答案,但它也确实……我今天不会跟我孩子说去干数据科学。这一点我可以告诉你。所以这个挺难的。我不……这里真正的问题是:未来几年,还会不会有那种看起来像现在这份工作的数据科学岗位?我觉得这个……我觉得这挺难的。你知道?看起来我们会有一批数据科学智能体,而那个非数据科学家的、通用的业务操盘手,得提供那一小撮盐——那点好奇心、那点冒犯探测、或者不管那是什么——那点模型还没有的特殊酱料。
普拉卡什(1:07:12):我感觉,如果你看一家公司,你大致可以把它切成:感知、分析、决策。对吧?然后是行动——决策,然后反向的,也就是把决策落地、执行。对吧?我认为 AI 在感知、分析上会非常强,在落地执行上也会非常强。但我认为在决策这一环,最终得由人掌握。对吧?那么如果你接受「由人掌握」,好,你可以有一家只由一个人掌握的公司。那个人能做多少个决策?而那些决策是带品味的决策。比如,如果你经营一家科技公司,也许你在会计框架上不需要做决策。对吧?你看的是产品、看的是技术等等。而后台的会计就是后台。对吧?
普拉卡什(1:08:07):同样地,如果你经营一家会计公司,会计就是最核心的,而技术就有点像后台。你不是在那儿造技术工具。对吧?所以我感觉,你可以按「最终目的是什么」把公司区分开。而那个最终目的里,装着所有带品味的人。基本上,每个人都可以做他真正想做、真正擅长的事,其余的都被照顾到。
纳森(1:08:39):那天周五早上,在嘉宾上场之前,有一个新的基准在圈子里传开:让 AI 玩《血染钟楼》——一个靠诈唬和串通的社会推理游戏。时间线上都在欢呼它们玩得有多好。以下是我对这个游戏的看法。
纳森(1:08:57):如果你把它孤立地看,那么,其他条件不变,知道 AI 玩这个游戏玩得多好是有意思的:它们在欺骗上变强了吗?在串通上变强了吗?在嗅出别人想骗它们、想串通对付它们这件事上变强了吗?这些都是有意思的问题。让我有点不舒服的,是那种感觉——然后 Noam Brown 跳出来说:哇,这是很棒的工作,你要不要来这儿做评测?这在我看来,正好体现了整件事我觉得有问题的地方:我们就是要在这一点上开始爬山了。对吧?整个领域的心态似乎是:哦,这不是很令人兴奋吗?我们来赛一场,看谁能当最好的《血染钟楼》AI 玩家。而我认为,在我们全都围着这事兴奋、想自己去跟 AI 玩的时候,我们都忘了:这不是 AI 的好行为。我们不希望 AI 去欺骗、去串通。我相信这些人对此都有某种深思熟虑的回应,但你把镜头拉远看,这个局面是坏的。我们有在这些方面不可信的 AI,而我们甚至不停一下问:嘿,这是我们想要的吗?我们想要能算计过我们、串通过我们的 AI 吗?我不认为我们想要那个。这恰恰就像……你知道,这非常像我那个「我们不该训练 AI 将军」的想法。别造……不。别训练 AI 的操控大师。这看起来很简单,可我们就在这里。而且,我没听到……我没看到……我看到的是一大堆喝彩和热情,我没有在时间线上看到任何一句纠正性的评论说:嘿,这真的是我们想要的吗?
纳森(1:10:53):回到那个周五节目的末尾,布莱恩签退之后。普拉卡什给了一幅「经济从这里往哪走」的图景。
普拉卡什(1:11:03):所以我觉得,往前的经济是一个「智能体经济」,那意味着智能体为别的智能体建造生意和软件,而它们适配的是智能体的能力边界——那会是超大规模并行、高速度、能以极低延迟吸收信息和分发信息。我们最后会得到一个主要由智能体使用的 Salesforce、主要由智能体使用的 Ramp。所有这类软件,Stripe 也主要是被智能体使用。也许 Stripe 或者其他公司会是造这些软件的那一方。我非常怀疑。我非常怀疑,因为我不认为它们会动得那么快,我不认为它们有能力动得那么快,我不认为它们理解这些能力边界。我知道 Stripe 基本上是一家……那里的人比我聪明十亿倍,我不是想贬低 Stripe 有多高效、多聪明、多能干。你会得到五千万个帕特里克·科里森,你会得到五千万个埃隆·马斯克,你会得到——人类给他们资本去部署。你会得到智能体把投资协调进由智能体建造、为智能体服务的生意里。所以我在很大程度上把经济的未来看成主要由智能体驱动,而我们只是领取免费的好处,因为:嘿,一次人类打来的 CRM 电话,跟智能体打出的超大规模并行的 CRM 电话相比,成本几乎等于零。丰盛基本上来自我们为这个智能体经济建造这一切。结果是,我们就有了这么多剩余,因为我们不……我们本来就消费不了那么多。对吧?跟智能体将要消费的相比,我们没那么强的消费性。而这正是丰盛将从哪里来的地方。
纳森(1:13:03):我的回应倚仗我上周上线的副项目 Fruitopia——它负责找出你家附近杂货店以及全世界最好的水果。以下是我对普拉卡什刚才描述的那种经济的落点。
纳森(1:13:17):一方面,如果 API 调用变得丰盛,那挺酷的,因为智能体用得那么多,它们会建起很棒的系统供自己用,然后我们可以搭便车。但是,生活里比 API 调用多得多,而我确实觉得我们——尤其是我们这些在 AI 圈子里的人——很快就忘了这一点,或者说,我们在某种程度上为了喜欢这个未来而扭曲自己。这就是为什么我一直拿这个标准要求自己:我要多出门、多运动。如果我不做这些事,我真的是赢了吗,还是我只是把自己插进某台 AI 驱动的机器里,充当某种「人类集成层」式的部件——某种意义上过度顺从机器的东西。这也是我最近决定做 Fruitopia 这个项目的原因。而且,你知道,这又是那种事:如果我们真的处在一个光明的未来,那么有一样很深地植根在我们身上、我们进化出来就喜欢的东西,就是吃新鲜、当季、好吃的水果。对吧?每个人都喜欢。这可以追溯到我们还是猴子的时候,就喜欢那个。我发那条推的时候,几乎没什么反响;而《血染钟楼》那条,所有人都说:我的天,看看 AI 在欺骗、算计、赢下这些社会操纵游戏上变得多厉害。而我只想说:我并不想从我的 AI 那里得到这个。我想要的是一个不只 API 调用丰盛、而是更「生物性」的东西丰盛的未来。给我水果。你知道吗?这才是我真正想要的。AI 革命的果实,至少部分应该是字面意义上的果实。如果我们正在丢掉那个,我们就正在丢掉太多对我们重要的东西。而如果我们连自己正在丢掉它都觉察不到,我在某种意义上觉得这让我担心,让我觉得也许我们已经丢了重点。
普拉卡什(1:15:34):我是说,对我来说很明显,我们会得到那种种出来的食物,营养价值高得多、也好吃得多。那会是……你知道,二十世纪我们发现了化学。然后我们……你现在看货架上这些食品,比如多力多滋之类的,那些东西太科学了。对吧?有成千上万个博士在多力多滋上下过功夫。成千上万,真的是成千上万。
纳森(1:16:00):你还记得《洋葱报》那篇老文章吗?「多力多滋庆祝它的第一百万种配料」?
普拉卡什(1:16:04):他们把人的口味图谱摸得那么清楚,能精准地做出他们想要的那种味道。而所有这些技术都会被部署到生物里去。对吧?我们会生产水果、蔬菜等等。杂交——水果本来就基本上是转基因了,只是我们花了很长时间才把它转基因出来。丰盛的一部分会是:你那瓶 99 分位的酒,两美元就能买到。
纳森(1:16:33):对吧?我最喜欢的苹果是蜜脆,它是一个相对晚近的产物。据我所知不是转基因,但绝对是那种大规模系统化杂交的产物——可以说是「转基因出现之前的转基因」。所以,我绝对不怕转基因增强的水果,我完全支持。但它仍然是某种生物性的构造,喂养作为生物性存在的我们,并且在我们的生物感官、以及我们从那里得到的那种短暂的感受质上取悦我们。而这些东西常常被丢掉,因为它不太可测量,不太能用来爬山,也不是智能体需要的东西。对吧?我认为我们得小心,别造出一个真正服务于智能体、并且在「智能体所需的核心东西」上为我们制造丰盛的经济。如果我们……那看起来像就是……我有点同意你,那可能就是默认会发生的事。但我想挑战所有人去想:等一下。如果智能体需要丰盛的那种东西,跟让我们的日子过得好的那种东西,并不是同一批呢?
普拉卡什(1:17:47):让我有点烦的一点是,前沿实验室那帮人非常严肃。对吧?当你非常严肃的时候,你只谈癌症、只谈治愈癌症。没有人谈更好吃的多力多滋。没有人站出来说:我们要做一个更好的橄榄球游戏。对吧?那些「我们要做一个更好吃的汉堡」「我们要做一个更好的橄榄球游戏」在哪儿?那些人们真的享受的东西在哪儿?而我认为那是因为他们想让它严肃,他们想展示那种认真,不想显得傻。也许你该把注意力放在:我们要做一片更好的多力多滋,我们会做一片对你更健康的;我们要做一片从地里天然长出来的多力多滋,你只要把土豆切开,它就是多力多滋。而这听起来很轻浮、很蠢,可它会让人们真正想象出可能是什么样子。
纳森(1:18:38):对吧?我是说,我认为这也是因为他们对自己的工作有一种二战式的心态。他们真的相信时间很短、赌注很高。他们自己对时间的分配非常偏向工作。前沿公司那些人生活里,休闲的空间真的不多。所以,是的。他们在这个时点上就是在做模式匹配:这里有一座山,我们去爬。而我认为,我们确实需要多一点判断力去想:我们到底想爬哪几座山?我们真的对自己造出了当前形状的 AI 感到满意吗?我不知道。感觉不幸的是,投入这类问题的时间和精力就是不够。所以我今天可能有点卡在这儿,但是,天啊,《血染钟楼》那件事真的把我触到了。因为,再说一次,我……它是好工作,其他条件不变它是有意思的。但我们……我认为我们需要一些在多个层面上挑战「其他条件不变」这个范式本身的思考。
普拉卡什(1:19:48):对。这个真的很难,因为我不认为智能体能在经济里运作而完全没有某种程度的遮掩。对吧?比如你不能把你的定价告诉对方,你不能把你的内部成本告诉来问你的人。对吧?你得保留那个。而那意味着「省略」。对吧?而你必须知道什么时候该省略。所以这里有一堆东西。这也是为什么我认为 Palantir 有「本体论」那个想法:谁被允许知道什么?对吧?那是件挺重要的事:谁被允许知道什么、谁被允许说什么、谁被允许做什么。对吧?我还认为你需要来自政府的某种「中断」,或者来自监管的中断,或者来自……这意味着当政府决定「嘿,这个你不能做」的时候,智能体必须服从。所以有一堆事我认为在治理上需要解决。我……我相信我们会走到那一步。但我猜,这一路上会有一些试错。
纳森(1:20:57):对,毫无疑问。也许作为收尾,我就引 METR 那份关于加速的报告的推文里的一句话。他们说,完整的分析估计了能力加速中有多少来自算力、数据和算法的进展。那是第一句。现在是我在加评论。那是一条他们把一切都加了保留条件的推文——不自信,而且……你知道,数据怎么解读非常不清楚,他们自己跟自己、跟 Anthropic 团队来回绕了很多圈。你知道,就是有那么多战争迷雾。甚至连「两倍」这个核心估计都很……1.3 倍到 3 倍之间他们都不会惊讶。所以到处都是保留条件。下一句是我到目前为止注意到的、唯一一句以「我们确信」开头的话。那句话是:我们确信,这次加速不是由训练算力增长速度的上升造成的。所以这暗示,就政府干预而言,我们……谁知道我们在数据中心建设上会看到什么,也许我们会看到数据中心建设得比「如果选举结果不同」的反事实情形稍慢一点。但引人注目的是,他们在这里报告的加速,不只是一个原材料、投入的故事。它是一个算法故事,是一个数据质量故事。而这些东西在很大程度上,是被我们已经拥有的智能推动的——而这正是它从「资本越来越大」变成真正意义上的递归自我改进的地方。所以,如果我们想用政府干预去改变那条轨迹,那大概必须更集中、更直接地针对前沿公司的做法,而不是像「整体放慢数据中心建设」这样弥散的东西。
片尾(1:23:04)
纳森(1:23:04):感谢收听 AI:AM 每周精选。旁白是我的克隆声音,我们很想听到哪些有用、哪些没用。明早见。如果你觉得这档节目有价值,希望你能花一点时间分享给朋友、发在网上、在 Apple Podcasts 或 Spotify 上写个评价,或者就在 YouTube 上给我们留个评论。当然,我们一直欢迎你的反馈、嘉宾与选题建议,以及赞助咨询,可以通过我们的网站 cognitiverevolution.ai,或者在你常用的社交网络上私信我。《认知革命》是 Turpentine Network 的一员,这是一个播客网络,现在属于一个更大的网络,里面的专家谈技术、商业、经济、地缘政治、文化等等。本节目由 AI Podcasting 制作。如果你需要播客制作方面的帮助,从你停止录音的那一刻到你听众开始收听的那一刻,都可以去找他们,也能在 aipodcast.ing 看到我的推荐。也感谢每一位收听、参与这场认知革命的人。
References
- 1
- 2Anthropic S-1/A(SEC)
sec.gov
- 3BallotBench·方法说明
ballotbench.com
- 4CNBC·2026 中期选举的数据中心公投
cnbc.com
- 5Luxor / Hashrate Index·AI 硬件价格指数
hashrateindex.com
- 6Theory Ventures·AI in Practice 2026
theoryvc.com
Comments