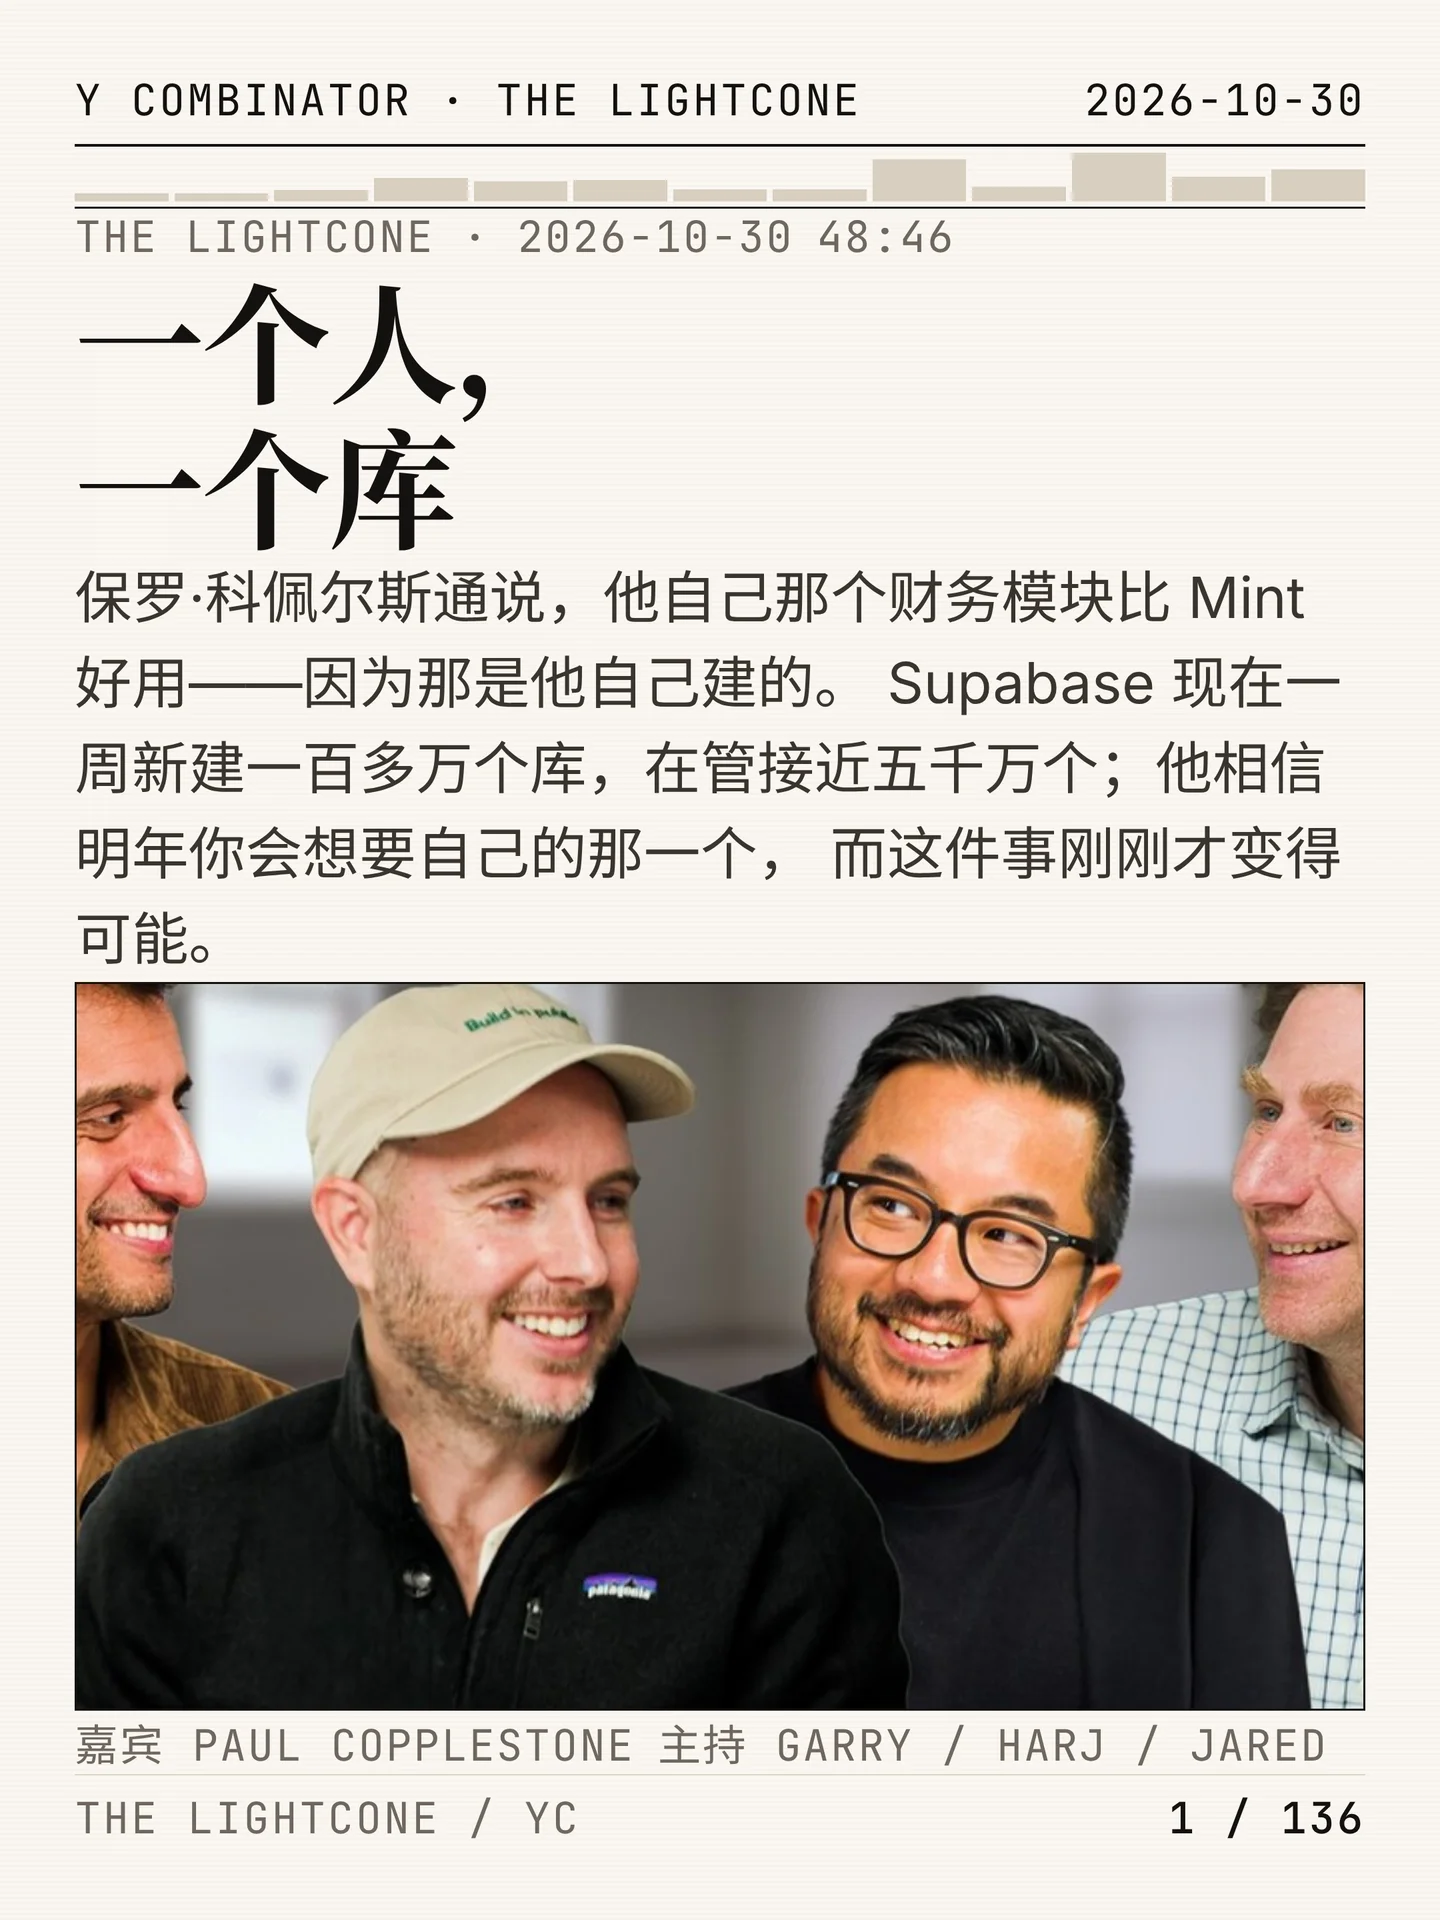

保罗·科佩尔斯通给自己建了一个应用,管邮件、管财务、记体重和训练。他说那个财务模块比 Mint 好用——因为它只服务他一个人。
这一期他讲了三件事:agent 已经占了 Supabase 新增活动的七成;数据库要同时往上(企业)和往下(个人)扩;而知道要建什么,仍然卡在人这一侧。
他把 Supabase 的六年分成三章:控制台、API、代码优先。每一次转身都不是战略会开出来的,是被当时的用户逼出来的。听完最有用的一点大概在这里——如果你的产品还想被人「打开」,而你的用户已经换成了 agent,那你要改的不是功能,是接触面。
十三段,一段一句
按官方章节顺序整理。金句保留英文原文,后面跟中文直译。
一、开场:T 恤上那句话改了一个词(00:00)
- YC 第一天发的那件 T 恤写着「做人们想要的东西」。三个主持在开场把它改成了「做 agent 想要的东西」。
- 理由是数字:Supabase 新增活动里,约七成来自 agent。
- 保罗的回答很短:今年这个拐点,是一次巨大的迁移。
Make something people want → make something agents want.做人们想要的东西 → 做 agent 想要的东西。
二、一年四倍:四个数字(01:18)
- 注册用户:1300 万,去年同期约 300 万。
- 在管数据库:接近 5000 万,去年同期 800 万。
- 每周新建库:超过 100 万个。
- 收入:今年增长 4 倍(没有给绝对额)。
- 反常的地方在漏斗:注册在加速的同时,激活与转化也在往上走。他说这在 PLG 公司里通常是反的。
Usually when sign-ups are accelerating, activation and conversion start to decline. This year all of them are going up into the right.通常注册在加速的时候,激活和转化会开始下滑。今年它们全都在往右上走。
- 早期投资人跟他说过:PLG 会在某个收入点顶住,之后必须往企业走。他说到现在看不到那个天花板。
- 公司口径可以对照:官方新闻稿写的是每月新增 100 万以上用户、400 万个数据库,其中 70% 由 agent 或 AI 工具创建1。
三、三章:控制台、API、代码优先(02:35)
- 第一章,控制台:2020 年 YC 的 100 天里做出来,「一个长得像 Airtable 的界面,后面是 Postgres」。出发点是看到连软件工程师用数据库都费劲。
- 第二章,API:2021 年,有个客户说要批量开库,需要一套 API。到 2024 年 Bolt、Lovable 这些人开始在上面建东西时,这一步正好对上了。
- 第三章,代码优先:他发现没有人再上控制台了,于是给团队发了一份产品备忘录,要求是 code first、git native。
If it exists on the dashboard, it basically has to work in lockstep in code.凡是控制台上存在的东西,基本上都必须在代码里同步可用。
- 落地动作是把 CLI 和一大堆积木重构成能在 sandbox 里跑,本质是基础设施即代码。
- 开源的判断:反事实说不清,但「至关重要」。他们不只开源自家的东西,还维护 Postgres 这类公共工具,因此在很多社区里有分布。他给了两层理由——agent 出错时能读源码;企业要审源码才敢采用。
四、builder 与工程师(04:34)
- 界线划在「要不要建一个东西」上:builder 打开 Claude Code 就能开始,但文件走到某一步就不够了。
Files only get you so far.文件只能带你走这么远。
- 他把「什么变了」讲得很清楚:能建,现在是任何人随手可得的;知道要建什么,仍然稀缺。
- 案例一:一个把公司卖了十亿多美元的 fintech 创始人,会拼 Ruby 脚本,但过去永远需要工程师;现在他给自己建个人财务软件,银行集成全部从零写。
- 案例二:一个五十岁上下的巴西出租车司机,用手机建了一整个打车应用,给他本地那个小市场用的小 Uber。
- 他的观察是,这类人手里有一堆被压着的想法——过去永远说服不了一个工程师来做。
五、一个人的应用(08:42)
- 他自己那座「控制塔」:邮件分诊、财务、健康、体重与训练,全在一个自己建的应用里。
- 转折发生在六个月前:他原本断言「以后不会有 UI」,也坚持过很长一段时间「一切放在 markdown 里就好」。结果是——到了某个点,数据库有用,UI 也需要。
- 那个财务模块他评价得最重:功能上至少和 Mint、Monarch 齐平,某些方面更好,因为可以做非常个性化的上下文;一笔交易是谁、为什么、归到哪一类,它自己判断。
- 健康那块的例子最能说明问题:数据在库里,日程也在,所以它能说出「你最近体重上去了,但你在出差,所以没关系」。
That context is really valuable.那种上下文真的很有价值。
- 还有一块:文件。任何文件转发邮件或拖进界面,agent 判断它是什么、和你的生活什么关系、下一步做什么。
六、个人数据库与数据归属(12:12)
- 主持的担心值得记下来:把例程和 CRM 全放进一个个人 agent,会被锁死;他正在把数据往外抽,agent 只做接在上面的手。
- 保罗的回答是这一期的支点:真正有价值的是记录源(store of record)。拥有数据库,再在上面建应用与 agent,而不是把它们放在别人的数据库里。
- 主持补了一段历史:过去世界上只有少数几个很大的数据库,由大公司运营;Supabase 刚起步时说「数据库应该对每个人都足够容易」,当时几乎说不通——不会写代码,拿数据库干什么?
- 保罗的答案是他自己也变了:一年前他不会想要一个个人数据库,现在觉得那是最有价值的东西。
Everyone in the world with access to AI will become a builder of some sort.世界上每个能用上 AI 的人,都会在某种程度上成为 builder。
七、扩到十亿(15:56)
- 一道算术题:ChatGPT 有 12 亿周活,如果每个人每月都想上线一个东西,就是每月 12 亿个数据库。他说这在数据库领域从未发生过。
- 主持追问:Postgres 撑得住吗,还是要自己造引擎?
- 他的回答先落在成本上——「如果能跟 AWS 谈更好的价钱,也许可以」,而现在是所有人都在抢算力;然后是产品判断:大量刚起步的负载用不上法拉利。
I don't know if you need such a Ferrari for a lot of these workloads.我不知道这么多负载是不是都需要一台法拉利。
- 于是有了收购 Turso,以及 Supabase Spark 这一档,服务「刚起步」的负载;口号是「从原型到 PB」。
- 两端同时做:Multigres 往上扩到 PB,Turso 往下缩到原型与 SQLite 型负载。他自己说,这非常难。
八、内部采纳(17:58)
- 一次内部投票:用编码 agent 写出自己八成代码的工程师,年初 10%,六个月后 60%。
- 原因不是强制:公司没有 AI 政策,只是把工具开放,然后大家被结果说服。
- 他强调内部做的东西不是 vibe coding 的小玩意儿,强度很高;代价是测试量暴涨,围绕测试的工具也换了一批。
- 让工程师信服的还有外部证据:模型变好是一半,纳维–斯托克斯那类结果让市场相信「真的能开新地」。
People need to be convinced. Especially engineers.人需要被说服,工程师尤其如此。
九、三个前例(19:58)
- Parse 与 Firebase:两家后来分别被 Meta、Google 收走。保罗说它们替后来者铺了路——2014 年你不用 RDS 做数据库是荒唐的,它们证明了你可以有一家正经的数据库公司。他还提到那个时间点的两股浪:MongoDB 让所有人相信 NoSQL,以及移动。
- Heroku:主持人说它是第一个「先用最好的开发者体验、再往上扩」的;但没跨过规模化那道坎。保罗先开玩笑「我们全赢了」,再认真补:Postgres 当年还很早期,需要一层工具包着它才能无限扩。
- AWS:他听到一个数字,还当场请主持帮他核——AWS 大约四成收入来自那些在它上面起步、后来长大的创业公司。推论是:迁移数据库几乎不可能,所以要站在第一天。
We just want to be there on day one, make sure they have a great time, and then make sure they actually don't want to leave.我们只想在第一天就在场,让他们体验很好,然后确保他们不想走。
- 主持把它归到 Stripe 那一类模型:第一天拿到客户,跟着世界上长得最快的公司一起长,干一代人就成为跨代公司。
- 但「第一天」的位置变了:过去是 YC 客户,现在每个 builder 都是第一天,而他们的形态与选择都还没有答案。
- 数据库做 DTC,过去听起来像语法错误;现在有两个客群,第二个可能一辈子不走。
十、为 agent 而建(27:29)
- 他行政助理离开一周,他自己上手,然后彻底转向:现在痴迷于「为个人 agent 而建」。
- 对公司的说法也改了:「我们是在为做 code first 的人构建,但其实我们是在为 agent 建——那些人很快就不会真的来交互了。」
We're building for humans doing code first, but actually we're doing it for agents.我们表面上为做 code first 的人构建,实际上是在为 agent 构建。
- 他的狗粮规矩:用 Dots 打一整天电话,不看代码、不检查架构,只在想确认「它建对了吗」时破例。
- 加里在 Supabase Select 上的想法:不想自己去理解新功能,想派 agent 去听,再让它整合进代码库。保罗接成「一个只给 agent 开的大会」,两人顺手给它起了名字:the artifactory。
- 他总结了赢下 agent 的两个阶段:被模型选中;卡住时不换走。
十一、错误信息与 eval(30:01)
- 错误信息是产品界面:过去开发者写「500 + 一句大概出了什么事」;现在要让 agent 自己补救——在错误里直接写怎么修,或者去读哪几页文档。
- 方法很土但有效:挑定一个用例,在错误信息上反复循环,直到能一次做成。
Inside the error messages, you are literally telling them how to fix this error.在错误信息里,你就是在直接告诉它怎么修这个错误。
- 他们把工程精力从「建」挪到「测具体用例」:公开的 Evals 网站看哪些模型建得最好,内部一套套件评估哪个模型最会用 Postgres。
- 加里讲了 GBrain 的构造,是这期技术密度最高的一段:
- 五十万个 markdown 文件,涵盖他所有沟通记录;一百万 token 的工作记忆,约等于三本《哈利·波特》。
- 但「把正确的那三本放进上下文」本身就是检索问题。到三四十 GB,需要 PG vector 与 Postgres;图数据库用 SQL 也很好做。整体是 RAG 检索 + 把非结构化数据变成结构的图数据库,动态 schema。
- 生产 trace 抽出来做成 eval:40 个类别,覆盖检索类型、成本、延迟;提分就并进主干,失败的写一个 markdown 说明为什么没用,然后归档。
- 两个常驻 agent:一个每天想新类别,一个每天在现有类别上找提分办法。他管这叫「某个用例的非常原始的 RSI」。
It's a very very primitive version of RSI for a particular use case.这是针对某一个具体用例的、非常非常原始的递归自我改进。
- 主持问:将来 builders 必须懂 evals 吗?他答:也许不用,我们太早了,现在其实是在发明原语。
十二、编程的未来(38:42)
- openusd.dev 那一夜:他收藏的域名,Stripe、Visa 宣布 OpenUSD 之后拿出来用;跟 Dots 聊信息架构,采纳建议,20 秒后它说做完了,刷新一下——写得很好,连 SEO 都接上了。
- 他刻意用「普通人」的方式编码:不指向 GitHub,不用工程师那套指路方式,因为他要测的是一年后普通人在 Supabase 上的体验。
I'm trying to code like a normie, someone who next year will be doing this.我试着像一个普通人那样编码,像明年会做这件事的那个人。
- 加里的判断是这期的收尾论点:RSI 是真的来了,AI 研究从 20% 到 80% 那一段正发生在 Claude Code、Codex 的循环里;但同时,「知道要建什么、知道怎么问」的人几乎没有增加。
It's unstoppable force meets immovable object right now.现在是不可阻挡的力量,遇上不动的物体。
十三、更多创业(42:36)
- 关于垂直 SaaS 的融资:500 万到 1000 万美元 ARR,9 到 12 个月前还是保 A 轮的,现在很难;同一时刻,10 到 15 个人就能做到 1000 万到 5000 万美元 ARR。
- 保罗把这笔账算完:15 个人、人均 200 万美元 ARR、50% 毛利,等于每人一年赚一百万。
If you got 15 people, 2 million ARR per head and with 50% margins, you're all making a million a year.15 个人、人均 200 万美元 ARR、50% 毛利,那每个人一年赚一百万。
- 主持的 office hours 观察:有人拿到「铜环」却为融不到 A 轮沮丧;他给的说法是「你回头看可能会觉得这是福气,因为你不需要这笔钱」。
- 保罗补了一层:创业里那枚「拿到融资」的徽章正在反过来,现在不融资才像成就了什么。
- 给想效仿的人的建议:选持久品类(林迪效应,数据库五十年,还有五十年);适应要最快;很多开发者工具起步时以开发者为中心,然后企业化、停滞、失去那种爱——他举的反例是 Stripe。
- 最后一段是准备下一次拐点:狗粮、生态、以及在团队里留出容量。他也承认,大多数押注会扑。
Not a lot of the bets actually win. But the ones that do work end up meaning that we ride this awesome wave together.大多数押注其实赢不了。但成了的那些,意味着我们一起乘上了这波浪。
口径与核对
| 说法 | 本期怎么处理 |
|---|---|
| 1300 万注册 / 在管近 5000 万库 / 每周超 100 万新库 | 嘉宾口述;官方新闻稿口径是「每月新增 100 万以上用户、400 万数据库」,与每周约 100 万自洽 |
| 新增活动约七成来自 agent | 主持引述、嘉宾确认;官方新闻稿写「70% 的新数据库由 agent 或 AI 工具创建」 |
| 今年收入增长 4 倍 | 嘉宾口述,未给绝对额,本轮未能核到 |
| ChatGPT 12 亿周活 | 节目引用的公开报道口径,未在本轮独立核实 |
| AWS 约四成收入来自在其上起步的创业公司 | 嘉宾自己请对方 fact-check,未核到官方口径 |
| 15 人 / 人均 200 万美元 ARR / 每人年赚 100 万 | 主持与嘉宾的粗略算术,不是公司数据 |
- 收购与融资两条可以对上官方稿:Turso 由 Supabase 收购,创始人 Glauber Costa 以「代理式服务负责人」身份加入1;这轮 1.5 亿美元由 GIC 领投,距上一轮 5 亿美元 F 轮(投后 105 亿美元)四个月2。
- 「Supabase Spark」在节目里是「将提供」的一档,官方新闻稿里没有点名,本轮只核到工程招聘页出现过这个团队名——所以卡上写的是节目中的说法。
- 逐句译文的底稿是官方视频的自动字幕(约 9,500 词)3。字幕把 Supabase 写成 Superbase、把 OpenClaw 写成 open core,译文按正确名称还原。
- 三位主持人没有独立的声纹标记,硬指到人不可靠;译文统一记为「主持」,只在加里讲 GBrain 与算账处标他的名字。
逐句全文翻译
以下是整集的逐句中文,保留说话人标签,不压缩、不摘要。广告与片头口播一并照译。
一、开场:T 恤上那句话改了一个词(逐句)
保罗:我是真心对很多人的未来感到兴奋。我最喜欢 Supabase 的一点,是我在这个平台上看到大量的创业行为。我确实认为,世界上每一个能用上 AI 的人,都会在某种程度上变成一个 builder(构建者)。你可以建任何东西,你可以改它。你想对某个应用、某个界面做点调整,就不必再受制于人。我其实挺期待 2027 年。
主持:欢迎回到又一期 Lightcone。今天的嘉宾是 Supabase 的联合创始人兼 CEO 保罗·科佩尔斯通。Supabase 是一个开源的 Postgres 后端,如今已经成了 Claude Code、Coda 这类工具里的默认数据库。Supabase 现在有 1300 万用户,每周新建的数据库超过一百万个。保罗,欢迎来到 Lightcone。
保罗:谢谢你们邀请我。
二、一年四倍:四个数字(逐句)
主持:先从一个说法开始:YC 第一天会发一件 T 恤,上面写着「做人们想要的东西」(make something people want)。但越来越多的人意识到,现在要的是「做 agent 想要的东西」(make something agents want)。你们公司就是最好的例子——新增活动里大约七成来自 agent。这是不是有点疯狂?
保罗:是啊,很疯狂。尤其是今年,从数字上看,这个拐点就是一次巨大的迁移,全都迁向 agent。
主持:为了让大家理解你们到底长了多少——这数字有点吓人。你最在意的几个数字是什么?去年这个时候你在哪,现在在哪?
保罗:去年这个时候……我们现在是 1300 万注册用户,大约 12 个月前大概是三百万。今年收入会增长四倍。我们……
主持:现在每周大概有一百万个数据库被建出来。
保罗:对,超过一百万。
主持:去年这个时候是多少?
保罗:现在在管的数据库接近 5000 万个,去年同期是 800 万,所以是一个非常大的拐点。
三、三章:控制台、API、代码优先(逐句)
主持:是什么在推动它?
保罗:第一,人们在大胆地建东西,软件工程师是这样。第二,我觉得有更多的 builder 上线了。过去需要有软件工程背景的人才能做的事,现在非工程师也能在 Supabase 之上把它建出来。
主持:这是一个很大的转变。你们具体做了什么来促成或者鼓励这个转变?软件工程师当然还会继续选 Supabase,但你怎么让 agent 一开始就过来?
保罗:我们大体上经历了 Supabase 的三章。最早我们是一家 dashboard(控制台)公司,然后变成一家 API 公司,现在我们非常明确地是一家 code-first(代码优先)公司。所以我们尽量提供 agent 真正想用来构建的形态,那就是代码优先——它们大多数时候想用 CLI。另一件事是被 LLM 选成默认选项,我们赶上了那个时间点,是很大的受益者。
主持:你觉得开源起了多大作用?因为 agent 很喜欢开源的东西。
保罗:很难知道反事实是什么,但我认为那至关重要。我们做的一切都是开源的,而且做得很「开源方式」——我们尽量去支持已有的工具,不只是 Supabase 自己的工具。我们支持 Postgres 这个 Postgres 生态里非常有名的工具,也帮着维护它,所以我们在很多社区里都有分布。
主持:我猜 agent 真的喜欢开源,是因为出问题的时候它们可以直接去看源码。
保罗:对。
四、builder 与工程师(逐句)
主持:我注意到 agent 很喜欢「有力量」的感觉,它们也爱数据。最让人沮丧的莫过于撞墙,然后不知道发生了什么,也没法修。
保罗:我觉得这一点会越来越重要。现在安全这么关键,很多企业会想审源码来确认它是安全的。如果是闭源,你可能就不愿意把它当供应商用。
主持:开发者还是你们追的核心用户吗?2026 年你怎么看这件事?
保罗:我们正在走向的世界、至少今年看到的是 builders。上线的人多到夸张。今年最疯狂的是:通常你的漏斗顶部在加速时,其他数字会开始下降——激活、转化。但今年它们全都在往右上走,这有点变态,因为模型在建东西这件事上变得太好了,我们开始看到过去没有软件工程背景的人也能进来建东西。
主持:区别就在这儿:builder 意味着他不一定是软件工程师,他只是需要建一个东西,于是打开 Claude Code,然后发现「只有文件」是不够的。
保罗:对。某种意义上,这一类人手里有一堆被压着的想法,他们以前永远说服不了一个软件工程师来帮他们建,现在不用说服任何人了。软件工程师仍然占很大一块,但 builder 这一段的增长速度非常快。另外我也不知道这件事的天花板在哪。我记得早期投资人说过,PLG 会在某个收入点顶住,然后你得往企业市场走;但到目前为止看不到天花板,我也看不到它在哪里停。
主持:这话大概两年前或一年前是对的,但今年肯定不对了。
保罗:对。
主持:上周末我刚跟一个人聊,就是 builder 这一类:一个 fintech 创始人,刚把公司卖掉,金额超过十亿美元。他一直算是「产品边上的人」——本科读数学,能把一些 Ruby 脚本拼起来,但总需要一个工程师来把软件建出来。现在他做副业项目,就建自己的东西,而且他懂怎么建一家 fintech 公司。所以他能建出相当复杂的、只服务自己个人财务的东西:资产负债表、跟踪软件;他知道怎么接银行,集成全是他自己从零写的。这种软件在两年前根本不会被建出来。
保罗:这正是最理想的一类 builder。像我这样的开发者,想法都是很开发者向的;但你还有大量领域专家,他们清楚地知道自己这个细分里哪些问题没被解决,现在他们可以直接扎进去,不用说服别人加入。我记得你们在 YC 聊过这个——连招进 cohort 的人画像都在变。
主持:如果看 2022 到 2025 那一段,有一个很真实的转向:AI 要来了,有软件工程能力、无论如何你得有一个技术联合创始人,这成了那段时间在 YC 被反复强调的一个「大局观」。它一直算对,但那段时间是被加倍下注的。到最近一年我们开始说:其实,是 builders。我们开始看到有人能做到——更难的那件事其实是知道要建什么。现在「能建」是任何人随手就能有的能力。这其实很酷:你能想象有多少东西本来永远不会被建出来吗?就像「我们知道有人会买这个,我们知道这里有个问题,但在边缘上,那些人说服不了一个工程师来做」。
主持:保罗,有没有一些例子——人们在 Supabase 上建的东西,也许只是给自己用的,属于那种以前永远不会被建出来的?
五、一个人的应用(逐句)
保罗:有一个挺酷的例子。我们的会议结束之后,一个巴西人走过来,他在手机上建了一整个打车应用,有点像他本地市场的小 Uber。我想他本人就是出租车司机,我不太知道他为什么要建,但他能建出来——他过来时非常感激。而且他身上那种能量,他大概五十岁上下,却像十几岁的孩子一样突然开始建东西。我觉得这挺酷的,因为现在到了这个阶段:关于工作的未来有很多不确定,但在 builder 这一类人身上,有一种对未来的兴奋。这正是我喜欢 Supabase 的地方:人们可以进来,那些现在还不确定的人,正在发现自己这套技能和这些机会——他们过去只是蓝领。
主持:好,你最近也在给自己建一些个人软件。能说说你在折腾什么吗?
保罗:在长。它有点像「一站式」的终点,但它是从我对 OpenClaw 上瘾里长出来的。大概六个月前吧,我还挺不好意思地说过:以后不会有 UI 了,全都会是通过 OpenClaw 聊天。而且我很长一段时间坚决不想用数据库,我只想把所有东西都放在 markdown 里。结果你会发现,到了某个点,数据库是有用的,UI 也是需要的。所以最近这几周我一直在建这个东西。我叫它 control tower(控制塔),其实就是我生活的每个区块都有一个 UI:我用它来分诊所有邮件,这样就不用读收件箱了;财务,跟踪支出;健康,体重和训练都记在一处。最神奇的地方,有时候想一下会觉得不可思议:我自己这一个应用里的财务部分,功能上至少和 Mint、Monarch 这些东西齐平,某些方面甚至更好,因为你可以做非常个性化的上下文。它可以靠查我的 GBrain 里那个人是谁来判断一笔交易是什么,然后正确分类。这曾经是一整个公司、好几家创业公司在做的事,而我可以只为自己建一个,不需要它对别人有用,也不需要别人对它有什么意见。这是我自己的东西,挺爽的。
主持:我们见到很多这样的情况,基本就是财务和健康这两块——是你想要「自己的数据」的两块。很多人都在做,把设备上的数据同步到同一个数据库,是个很神奇的能力;你可以让它去跨所有设备建这些关联。
保罗:对,就拿健康这个例子:这些数据都在我的 Supabase 数据库里,但它同时还能访问我的日历,所以它「知道」一些事。比如:我知道你体重最近上去了,但你在出差,所以没关系,下周回到轨道上就好。这种上下文真的很有价值。
六、个人数据库与数据归属(逐句)
主持:我也发现,随着我开始用个人 agent,我有点偏执了:我把所有例程、所有东西都放进去,CRM 开始被锁进一个 agent 里。所以我现在慢慢把它抽出来,这样如果我想在上面接不同的 agent,我知道我可以用任何 agent。CRM 是另一个非常关键的东西。
保罗:对,这正是你们有价值的地方——它是记录源(store of record)。真正有价值的是数据库本身。你想要拥有自己的数据库,然后在上面建各种应用或 agent,而不是把这些都放在别人的数据库里。
主持:这个想法相当离谱。想想数据库的历史:过去世界上只有相对少数几个非常大的数据库,由大公司运营。我记得 Supabase 刚起步的时候,就有这个想法:数据库应该对每个人都足够容易。当时几乎说不通——为什么会有那么多人想要一个数据库?因为如果你不会写代码,你能拿数据库做什么?而真正会写代码、能建一个个人 CRM 的人并没有那么多。对大多数人来说,在 AI 之前这太费事了。
保罗:另一个 Supabase 对我很有用的例子是文件上传区。听起来很简单:任何文件我都可以转发邮件给你,或者直接丢进这个 UI,然后我的 agent 会判断这是什么、和我的生活有什么关系、该怎么处理。这些都存在 Supabase 上。所以总体来说,Supabase 最终会把关于我生活的所有数据放在一个地方。一年前我根本不会想到自己会想要一个个人数据库,因为那完全说不通。但现在,我觉得那才是最有价值的东西。
主持:对,你们有一个 S3 兼容的 Supabase files,我所有东西都在那儿。
保罗:哦真的?不错。
主持:GBrain 里是默认的。
现场:〔笑声〕
保罗:太好了,谢谢。
主持:保罗,你觉得这是未来吗——基本上世界上每个人,不是每个开发者,是每个人,都会有一个 Supabase 数据库,里面放着关于他生活的东西:健康、财务、关系?
保罗:我们当然希望如此。我确实认为,世界上每个能用上 AI 的人都会在某种程度上成为 builder。你可以建任何东西,可以定制它;你想对某个应用、某个界面做点调整,就不必受制于人。当然,我们把自己看作一家索引公司(index company)。刚进 YC 时我们只盯 YC 公司,想拿下所有 YC 客户——因为我们知道,必须在企业刚起步的第一天就在场。使命没变,只是口径(aperture)大幅变大了。现在随着更多 builder 上线,我们知道要去服务他们,这其实是完全不同的一个问题,但也挺让人兴奋。
主持:大幅变大,是那种一千万倍的变大。
保罗:对。我们现在每周上线一百万个数据库。但如果你做点简单算术:ChatGPT 据说有 12 亿周活用户,假设他们每个月都想上线一个东西,那就是每月 12 亿个数据库。这就是我们要走向的量级,我们要有那样的架构,才能真正承接这个规模——这在数据库领域是从未发生过的事。
七、扩到十亿(逐句)
主持:Postgres 能做到吗?还是你得自己造一个数据库引擎,才能扩到每周 10 亿个新库?
保罗:我觉得……如果能跟 AWS 谈成更好的价格,也许可以。但现在所有人都想要算力。而且说实话,很多负载并不需要一台法拉利。我们最近收购了 Turso,他们的架构与 Postgres 兼容,其实也和 SQLite 兼容——我认为 SQLite 是一个现象级的数据库。所以我们会提供一个层级,叫 Supabase Spark,基本上就是给这些「刚起步」的负载用。想法是一样的:同样的上手体验,可以一路扩到 PB。所以我们的口号大概是「从原型到 PB」(prototype to petabytes)。作为一家公司,我们必须确保能服务每一个人;如果他们真的长大、生意继续增长,我们也确保他们待得舒服。
主持:这正是我好奇的:经典的软件公司,从早期创业公司(比如一个 YC batch)开始,然后一只眼睛盯着企业。尤其如果你是数据库公司,AI 之前的那种未来主义是——你要成为 Oracle,所以得尽快进企业,因为钱都在那儿,于是你开始做企业功能。而你现在往 SQLite 那个方向走,是反方向。你怎么想?是不是两头都在看?
八、内部采纳(逐句)
保罗:对,我们不得不同时做两件事,这非常难。基本上我们有两个产品,分别服务两端:Multigres 会扩到 PB 级,Turso 会缩到原型和 SQLite 那种负载。在这样的增长速度下还要多招人,即便有 AI,也一直是个真正的挑战——但也很好玩。
主持:你最近做了个投票:工程师里用编码 agent 写出自己八成代码的人,从 10% 涨到了 60%,只用了六个月。这是怎么发生的?发生了什么?接下来往哪走?
保罗:我们内部没有 AI 政策,就让大家想怎么做就怎么做,想用什么工具就给什么工具。现在的情况是,他们被说服了:模型能做得好得多、多得多。所以采纳率非常疯狂,而且他们在内部建的东西,不是那种「vibe coding」的小玩意儿,强度很高。随着我们转向 AI 编码,我们做的测试量、我们采用的测试工具,都变得非常有用——确保他们知道最终结果会是对的。
主持:我们在 YC 也看到这个,很多 YC 创业公司……它们都很垂直,因为大家都在做 CI。
保罗:对。
主持:而测试的数量简直爆表。
主持:为了 review。
主持:说实话看到这个挺震撼的。是不是就是模型够好了,然后大家花的时间够多,就会说「哦,这其实相当不错」?
保罗:而且人需要被说服,尤其是工程师。年初他们可能不觉得这有多好。模型变好了,同时他们也开始看到:哦,用这些模型确实能做出很棒的东西。再加上纳维–斯托克斯那些事,让市场相信我们真的能开新地。所以我觉得我们正在走向那个世界,现在大家被说服了,这就是未来的方式。
九、三个前例(逐句)
主持:你看着 Supabase 走过三个时代:先是 dashboard 公司,在 YC 的 100 天里做出来;然后是 API 公司;现在到了「做 agent 想要的东西」这个时刻。每个时代里有没有一两件事让你印象特别深——「就是那个东西让我们在那个时刻成立」?
保罗:我觉得那些转变是发生了的。第一个,其实——你们刚说的是,我们进 YC 的时候,为什么会有数据库公司存在?
主持:当时这想法非常反共识。
保罗:对。我们看到,即便对开发者来说,用数据库也很难。所以先做 dashboard:「我们来做一个看起来像 Airtable 的 UI,搭在 Postgres 上面。」因为我本人也很喜欢 Airtable,我想,如果它后面就是一个 Postgres 数据库,岂不是很酷?所以那一步只是看到了:连软件工程师都在挣扎。搬到 AI 的时候——我们在另一个播客里聊过——API 那次转向,是因为有一个客户在跟我们集成,他们说:我们要上线很多数据库,需要一套 API 来做这些事。那是 2021 年吧。结果到了 2024 年,Bolt、Lovable 这些人开始在我们之上建东西,那一步正好是对的。今年我看到的是:没有人来 dashboard 了,真的没有人。
现场:〔笑声〕
保罗:没有人再访问控制台了。那 agent 要怎么建?这一次,我给团队发了一份产品备忘录,说必须是 code first、git native。Supabase 必须转成代码优先:凡是 dashboard 上存在的东西,基本上都必须在代码里同步地能用,本质上就是基础设施即代码。我们重构了大量 CLI 和一切,让它们能在 sandbox 里以代码运行。
主持:也许这问题太靠前了,不过你们是不是从 Parse——另一家 YC 公司——那里得到启发?
保罗:对。Parse 和 Firebase 我都很喜欢。这些浪潮挺有意思:他们做了后端,Firebase 被 Google 收,Parse 被 Meta 收。但某种意义上,他们替我们铺了路,让我们能真正做一家数据库生意。因为在 2014 年,你不用 RDS 做数据库是荒唐的。然后他们来了……很多数据库公司开始出现,证明你不一定只能用三家超大规模云厂商之一,你其实可以有一家正经的数据库公司。那个时机对我们至关重要。
主持:大家有点忘了,但那是个做得非常好的产品。它上线的时候正好是我第一次做 iPhone 应用的时候,能换成一个漂亮的 RESTful API,感觉很好。
保罗:这些转变总是伴随拐点。那个时间点市场上发生了两件事:一是 MongoDB 不知怎么就说服了所有人,相信 NoSQL 是存数据的绝佳方式;第二是移动。我们很幸运也赶上了几股浪,现在我们正处在最厚的那一段。
主持:这就是我刚才问的:你怎么看企业与早期。再往前看,Heroku 是第一个说「先用最好的开发者体验起步,再往上扩」的。但带着人往上扩其实很难,我觉得 Heroku 没能跨过那道坎——怎么让应用变大、需要更高性能的时候人还留在你这里。历史上每家公司都得自己解决。你们在往那个方向看,但你们可能不需要。说实话,如果「拥有 0 到 10 那一段」这个市场继续以这个速度扩张,它会非常大。
保罗:对,我们全赢了。
现场:〔笑声〕
保罗:所以我们可能不需要,但我们肯定会做。也要给 Heroku 点赞,我觉得他们让 Postgres 流行起来。但那时候 Postgres 还很早期,有一些扩展上的限制。所以我们不得不用一些工具把 Postgres 包起来,让它能无限扩。
主持:我觉得对你们更贴切的类比是 AWS——它能很早拿到客户,然后跟着长。有什么经验?你怎么确保能无限扩?
保罗:我听到过一个数字,也许记错了,你们帮我核一下:AWS 大概四成的收入,来自那些在它上面起步、后来长大的创业公司。那就是我们想要的那一类。我们知道,说服别人从一个数据库供应商迁移到另一个几乎是不可能的。所以我们只想在第一天就在场,确保他们体验很好,然后确保他们不想走。
主持:这就是 Stripe 的商业模式。如果你能拿到,基本上是世界上最好的商业模式:第一天拿到他们,然后无限地跟着世界上增长最快的公司一起长。
保罗:你就这么干一代人,然后你就成了一家跨代公司(generational business)。差不多就是这样。对我们来说难的是:「第一天」长什么样?它在快速变化。过去第一天对我来说永远是 YC 客户。现在第一天变成了:好吧,每个人都是 builder,他们会用什么?用什么形态?他们怎么选数据库?这些都是难题。
旁白:YC 下一批正在接受申请。你有创业的想法吗?到 ycombinator.com/apply 申请。永远不算太早,填完申请表本身就会让你的想法升级。好,回到视频。
主持:这其实是另一个客户群。刚开始的时候,数据库没有个人市场——一家数据库公司做直接面向消费者(DTC),听起来就像语法错误。
保罗:对。
主持:但现在你其实有两个客群:一是有这个强大的 Stripe 式模型的早期公司,另一是你也在直接卖给消费者,或者卖给他们的 agent。
保罗:对,对,对。
主持:而这些用例大概不会像创业公司那样扩,但它们可能会一直用你一辈子——因为你支撑着那个跑他们个人财务软件的应用,或者他们那个出租公司之类的东西。
十、为 agent 而建(逐句)
保罗:对。随着他们的生活变大、积累信息,那基本上就是我们自己增长的一个索引。他们会存更多。人们在收集更多数据。这种 prosumer 市场对我们来说是一个很好的增长向量。
主持:那从这个角度,你怎么看个人 agent 的世界?编码 agent 想要 Supabase 很清楚。你觉得下一阶段是——假设我们都有一个个人数据库,你们需要做点什么让个人 agent 更容易和它对话、使用它?还是基本上是一样的?
保罗:对,在我行政助理离开一周、我亲手体验了它们能做什么之后,我现在非常看多个人 agent。我现在有点痴迷于「为个人 agent 而建」这件事。我确实跟公司说过我们是 code first、我们在为做 code first 的人构建,但其实我们是在为 agent 建——那些人很快就不会真的来交互了。我自己的构建方式是用 Dots:我总是跟它打一通电话,一边聊天一边说「你能改一下这个吗」。我确保自己在正确地吃狗粮的启发式是:我不看代码,除非是为了确认它确实建对了,否则我不允许自己去检查架构。做这些改动的时候,我只想跟它说话,看它能改成什么。
主持:我们中的一个。我们中的一个。
现场:〔笑声〕
保罗:这也很疯狂:它在做一些现象级的事,感觉像两年前科幻电影里的东西。现在我经常有这种时刻,觉得不可思议。如果六个月前给人看这个,他们会觉得不可能。
主持:对,几周前我去了你们的 Supabase Select 大会——顺便说那是个很棒的大会——我当时有个疯狂的想法:我坐在那儿,你在讲 Supabase 推出的一堆很棒的新功能,我想,如果我在 Supabase 上建一个应用,也许我根本不想自己去理解这些功能。我想派我的 agent 去 Supabase Select,听所有新功能,然后想办法把它们整合进我的代码库。
十一、错误信息与 eval(逐句)
保罗:哦,那很疯狂。一个真正的虚拟大会。我们该做。一个只给 agent 开的大会。
主持:一个给 agent 的大会。
保罗:它们会现场出席。
主持:现场。它们可以互相聊天,交换技巧,关于……Supabase 的直播。
主持:你可以把它桥接起来。你可以把 markdown 文件空投给所有人,但你得在现场、在观众席才拿得到。
保罗:我们把它叫「构件工厂」(the artifactory)。
现场:〔笑声〕
保罗:哦,我挺喜欢这个。
主持:我们之前聊过,你在做一堆让 agent 更喜欢你的事情,比如错误信息。那个关键洞察是什么?还有没有一堆别的事,一方面看起来很显而易见,另一方面却还没人在做?
保罗:错误信息那件事:我在波士顿的一个 dbt Labs 活动上,惊讶于这件事居然不明显。我们真的深挖了错误信息,让它能覆盖一个用例,比如「我想建一个应用」。一般开发者写的错误信息就是 500 加一句基本说明,你就知道出问题了。但现在你其实想让 agent 自己补救。所以在错误信息里,你直接告诉它怎么修这个错误,或者去读哪些文档来修。所以很大一部分工作是:挑定你的用例,然后在改进自己的错误信息上做这些循环,直到你基本上能一次做成(one-shot)任何想做的事。
主持:有道理。如果你被一个 agent 使用,agent 会遇到错误信息。过去人要自己去 Google、做一堆事;现在你可以直接说:你的 inode 用完了,所以你应该去做这个。
保罗:对,因为赢下 agent 有两个阶段。第一是被模型选中。第二是——如果它们卡住了,你不希望它们换走;所以可以确定它们某个时刻会卡住,你只要给它们补救的工具。其实没那么复杂。它们现在够聪明,能自己搞清楚很多事,但你确实要把大量过去只为人、为开发者做的东西,为 agent 重新工程化一遍。
主持:你们会为 agent 测试你们的产品吗?
主持:就是让 agent 试着用 Supabase,然后报告它们在哪里遇到了麻烦?
保罗:会。我们有一个 Evals 网站,可以看到哪些模型建得最好;我们内部也有自己的 eval 套件。我们也会评估哪个模型最会用 Postgres,这对行业挺有意思,也能围绕它建一些技能,让它们能上手并真的用 Postgres 开发。所以,测试很多。事实上,我们现在很大一部分工程精力都放在测试具体用例上,而不是构建本身。我们想搞清楚人们是怎么建的,然后围绕它建套件。
主持:加里,你建 GBrain 的时候是在 Supabase 上建的。能说说你为什么决定建在 Supabase 上吗?作为用户是什么感觉?
加里:GBrain 其实是我写的一堆东西的蒸馏。我先做的是 Garry's List,那是个 agentic 的新闻编辑室,我得搭一整套研究系统,做 RAG、做政策和论文,它会读关于某个话题的每一篇报纸文章,然后试图综合。然后我把那套蒸馏成了给 OpenClaw 的开源检索。想法是:我原来是写在 Rails 里的,那基本上是一个给 agent 用的富士康工厂——我把每一次 LLM 调用都当成非常昂贵、非常危险。后来我看到 OpenClaw,那是一种完全不同的和 AI 协作的方式:AI 很聪明,它不是想害你,你应该让它去做事,给它数据和能力。然后我意识到,一百万 token 其实是一个不可思议的工作记忆——大多数人类只有七加减二件事能同时放在脑子里,而一百万 token 差不多是三本《哈利·波特》。但对 agent 来说,连这也还是有点限制:在任何时刻都把正确的三本《哈利·波特》放进上下文,是个真问题。所以中间似乎有这么个东西,可以是一个公司大脑,或者我个人的东西:我有五十万个 markdown 文件,涵盖我所有的沟通记录。这个东西真的拥有关于我、关于我在意的一切的上下文。但在任何一个时刻,agent 可能只需要两页——这是个检索问题。到那个点上——大概三四十 GB——你需要 PG vector,需要 Postgres;图数据库用 SQL 也很容易做。GBrain 就是这个:RAG 检索,加上一个把非结构化数据变成结构的图数据库,所以是动态 schema,有点像我记得当年的 Palantir。整个想法是:agent 在有这么一个中间层的时候强大得多——它只要说「我要找这个」,那个东西就去遍历图、做向量搜索,然后回来给你一份报告,加载进上下文。这就是 GBrain。Supabase 那边就非常直接:我需要托管的 Postgres,需要它能很快地支撑 50、100 或 300 GB 的语料库,它一直很好,自动扩容非常好用。最好玩的是现在有了浏览器使用:我用一个旁路浏览器做 browser use,OpenClaw 可以进 Supabase,用数据库或者你们新做的 API,它自己就管理了,它能自我管理。
主持:你需要给它提示、让它想出数据结构,比如图或者 RAG 之类的吗?
加里:好笑的是,我记得我打开 Claude Code,直接说:用 Exa 下载并整理你能找到的每一篇 AI 研究论文。今天我可能会用 Alpha Signal 之类的东西。但当时就是:去找所有关于 RAG、图数据库、文本检索的研究,然后针对我的用例做总结——我的用例是,怎么让一个 agent 拿到这些东西。它做完之后说:好,我们这样做。
主持:那天晚上我在一个关于数据库未来的饭局上,有个想法是:数据库本质上就是数据的检索机制,你可以建索引,让它们以某种格式(图或者 RAG)在数据上搜索。其中有一个特别有意思:让一个 agent 循环去为搜索创建完美的数据结构。如果你要搜这个数据集这么多次,而且它要 10 秒,为什么不放一个 agent 在循环里,去造一种新的索引、或者找到最好的索引,把返回时间压到一秒以内。
加里:代码生成变得非常非常强的那一刻,动态检索就一定会发生。
保罗:对。
加里:所以目前,我用它跑 OpenClaw,用我的生产实例,然后把里面的 trace 抽出来做成 eval 数据集;我有一个单独的仓库叫 GBrain evals,里面有 40 个不同类别的检索、检索效率、成本效率、延迟。eval 好玩的地方在于:你可以直接告诉 agent 去循环、自动研究,任何能提升你在这套 eval 上指标的东西,默认就并进主干。
十二、编程的未来(逐句)
主持:默认。
加里:对。而且任何你试过但没用的东西,写一个 markdown 文件解释你认为为什么没用,然后归档到 GBrain evals。我用 Cappy,Cappy 有个 captains 的概念,有点像 Grok 的 bots。你可以给它上下文,所以我有一个人一直在跑,任务是「想出新的类别」;另一个一直跑,任务是「过一遍 evals 里的所有类别,自动研究,每天都试着提升我们自己内部 eval 的分数」。
主持:嗯。
加里:它一直在跑。这是针对某个具体用例的一个非常非常原始的递归自我改进(RSI)。但如果你往上抬一层抽象,你可以不做我这个用例(OpenClaw 的),而是泛化成任何人的检索用例。唯一变的是用例、trace 和数据集。
主持:你显然懂 evals,你能提升你的软件,因为你在外面套了这套框架。你觉得将来 builders 必须懂这类东西吗?
加里:也许不用。说实话我觉得我们太早了,我只是在瞎折腾,而且我喜欢开源地做。我希望有人看到它说:哦,我可以把这个用起来。我们现在其实是在发明使用这些东西的原语。我记得今年早些时候读 Steve Yegge 的 factories,没能完全搞懂;我想,不行,我得自己拼出一套至少对我有用的东西。
主持:对。
主持:对,我们请鲍里斯来的时候,他对编程未来的设想更像是:你就跟 Claude 像朋友一样聊天,不需要懂 evals 和这一整套东西,Claude 会自己搞明白怎么把你脑子里的东西建出来。
保罗:我手里有个域名 openusd.dev。因为其实有个文件格式叫 OpenUSD,我收集域名。后来 Stripe、Visa 这些公司突然都宣布了 openusd.dev,我就想:我得把这个域名用起来了。但我一直没时间。于是我跟 Dots 聊,它把这个开发者侧、生态系统什么的都做出来了。我就在电脑上跟它聊。然后我一天快结束时,躺在床上用手机打给它——听起来有点可疑,但我保证我只是
现场:〔笑声〕
保罗:我保证我只是
保罗:在(其中)。
保罗:只是在跟它写代码。我说:我不喜欢「生态怎么连到用例」这个信息架构,你能给些建议吗?它给了。我说:好,实现吧。20 秒后它说:好了,做完了,你要刷新吗?我刷新了网站,写得非常好,所有东西都连起来了,还接上了 SEO 那些东西。所以我没有做那些传统上必须做的经典步骤,我只是一直在跟它聊天。那真的像是一个我瞥见未来的时刻。
主持:你能这么做,是因为你知道你想建什么。
保罗:就是这样。我显然有工程背景,所以我知道怎么给它提示,但我在尽量什么都不说,尽量不指向 GitHub 之类的地方,我试着像一个普通人、像明年的某个人那样编码,这样我才能吃自己的狗粮,知道一年后用户在 Supabase 上会不会有好的体验。
主持:鲍里斯说「我只想让它自动做」挺有意思。当然,一旦它进入分发,模型权重里就有了,它能做。但在那之前,它需要一点 markdown、一点提示,很少量的提示就能做。我觉得我们正在进入社会里一个非常奇怪的时刻:听起来 RSI 真的来了,AI 研究从 20% 到 80% 的那一段,正发生在 Claude Code、Codex 这些地方的循环里。同时,社会上并没有足够多像你这样的人——知道要建什么、知道怎么问。所以现在是不可阻挡的力量遇上不动的物体:模型能力在抛物线上升,而能真正对社会产生影响的人数量,基本没变。
十三、更多创业(逐句)
保罗:对,而且要愿意为它兴奋。我觉得这是另一件事。很多人变得偏执,但我是真心对很多人的未来感到兴奋。我之前的几家创业公司都围绕蓝领,围绕那些一辈子必须大量工作的人。我最喜欢 Supabase 的地方,是我因为它看到了大量创业行为。所以我能看到这样一个未来:创业行为会多得多,而且对很多人来说是一种相当充实的生活方式。所以我挺期待 2027 的,只要我们能保持这个节奏、避开几个疯狂的事件,对很多人来说都会是一段有趣的旅程。
主持:我们看到这个时刻:垂直 SaaS 的创始人在融 A 轮时有点挣扎。低于规模的时候,比如 500 万到 1000 万美元 ARR——历史上这是很多 ARR——这在 9 到 12 个月前还是保 A 轮的。今天……大家好像不太感兴趣。横向的、AI 的投资看起来一路绿灯,但垂直 SaaS 的人在真挣扎。而这同时,你可以用 10 到 15 个人做到 1000 万、1500 万,常常是 2500 万、3000 万、5000 万美元 ARR。到那个点,你非常赚钱。
保罗:对。如果你有 15 个人,人均 200 万美元 ARR,50% 毛利,那每个人一年赚一百万。对很多人来说这是惊人的结果。
主持:同时我们做很多 office hours,有人拿到了「铜环」,然后为融不到 A 轮而沮丧。所以我很多 office hours 就是:你回头看可能会觉得这是福气,因为你不需要这笔钱。过去你必须融一亿美元才能做到三千万年收入,因为必须招那么多人;现在不用了。
保罗:对,创业里有个真东西,那枚徽章。对我来说也一样:一开始拿到融资,感觉像我在成就什么。但实际上,现在不融资,在我眼里才是成就了什么。所以我有点羡慕那些走到这一步的公司。
主持:是啊。世界变化很快,但你们在所有浪潮里都骑得高。对那些想效仿你们的人,你有什么想法?
保罗:有一件事让我睡得着:这是林迪效应(Lindy effect)。数据库已经存在 50 年,我认为还会存在 50 年;而且在 AI 的尽头,无论如何,我很确定还会有数据库。你从这里能读出什么随你。你要选非常持久的品类,如果你要把一辈子押上去——这基本就是我在做的——你选一个你觉得值得投入的品类。另一件事是变化太快,所以我们不试图有所有答案,我们只试图确保自己总是适应得最快。对我个人来说,我评估、观察过很多我喜欢的开发者工具:它们一开始以开发者为中心,然后总是往上走,变得非常企业化,然后停滞,失去那种爱。从我们的角度、至少从我的角度,像 Stripe 这样的公司有一种真正的东西——有一个关心「新的构建方式是什么」的创始人。所以如果你在为下一波浪构建,你总得有一只眼睛看着未来是什么,而时间线现在非常短。变化太快了。所以超级适应,并确保团队里有容量能快速转向——这是我们明年专注的事。
主持:有没有具体学到的东西?你经历过最初的 vibe coding 拐点,然后 Opus 那一代的拐点,还有代码生成。下一波浪、希望下一个拐点来的时候,你会做什么不一样的事,让自己准备得更好?
保罗:首先,吃自己的狗粮(dogfooding)在我们看来是最重要的事情之一。我总是拿别人的工具来试我们的东西,看缺口在哪。没有比自己被自己的工具卡住更好的反馈了。然后是容量:我们尽量和这个领域的关键玩家合作,这种生态玩法非常有帮助,因为他们会告诉我们他们在建什么。另外我们尽量在团队里留一些余量——这也非常难——这样当他们有想法时,我们可以试一试。很多押注其实没赢,即使看起来我们是在一起搞什么新东西,我们其实也不知道;它们听起来很酷,我们试了,结果扑了。但那些成了的,最后就让我们和他们一起乘上这波浪。
主持:这是个很好的收尾。保罗,非常感谢。下次见。
References
- 1Supabase 官方新闻稿:1.5 亿美元新融资与收购 Turso
prnewswire.com
- 2Supabase 官方新闻稿:5 亿美元 F 轮,投后 105 亿美元
prnewswire.com
- 3
Comments