OpenAI 的 8 个科研计算案例:Agent 加速了代码,验证仍由人把关
OpenAI 汇总 8 个主要来自生命科学的科研计算项目,显示 coding agent 能显著压低实现成本,但科学正确性验证和长期维护责任仍然由人承担。

先看结论
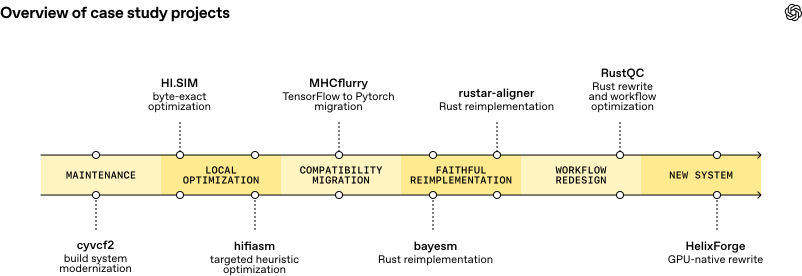
OpenAI 7 月 28 日发布的「Scientific computing in the age of agentic AI」汇总了 8 个主要来自生命科学的科研计算项目:5 个只使用 Codex,3 个同时使用 Codex 和 Claude Code。案例从改造构建流程、局部优化,到语言迁移、GPU 原生重写和新工具开发,覆盖的不是同一种任务,也不是同一套基准。1
报告给出的共同判断很收敛:coding agent 已经能把大量实现劳动压下去,但验收科学正确性、解释差异、决定是否发布,以及为发布后的代码安排维护责任,仍然需要人。读者可以从 OpenAI 官方文章 和 完整 PDF 实地报告 看到案例原文与方法细节。
这不是统一协议下的 agent 能力评测。项目在事前并没有按同一实验设计开展,报告是对已完成工作的回顾性汇总;作者核对了内部一致性和部分公开产物,但没有独立复现每个 benchmark。因此,下面的速度和一致性数字是具体项目的贡献者报告结果,不能直接横向比较成「某个模型提升了多少」。2
8 个案例,四种验收逻辑
报告中的项目可以按「改动之后要保留什么」来理解。保留字节级输出的项目,和允许改变实现但必须保留科学行为的项目,验收负担完全不同。
| 案例 | 主要改动 | 贡献者报告的结果 | 主要验收方式 |
|---|---|---|---|
| MHCflurry | TensorFlow/Keras 迁移到 PyTorch | 发布 MHCflurry 2.2.0,旧权重可直接加载;315 个 allele-peptide 组合上的预测量在小误差范围内一致 | 与原 TensorFlow 后端比较 affinity、processing、presentation 及 percentile ranks 2 |
| rustar-aligner、svb、kuva | STAR 的 Rust 忠实重写,以及新的压缩和绘图库 | rustar-aligner 在 10,000 条酵母 RNA-seq reads 上与 STAR 的关键字段一致率为 99.815%(单端)和 99.883%(双端);svb 比常用库快 1.7 至 2.9 倍 | 逐 read 对照 position、CIGAR、MAPQ 等字段,并做工作流、字节兼容和代码检查 2 |
| RustQC 及相关重写 | 把 15 个 RNA-seq 质控工具合并为单次 Rust 流程,同时重写 FastQC 与 Trim Galore | 在 1.86 亿 reads 数据集上,顺序运行时间从 15 小时 34 分降到 14 分 54 秒,磁盘流量从 2.5 TB 降到 0.1 TB;输出保持数值等价 | 真实测序数据、原工具输出和下游工作流兼容性 2 |
| HelixForge | 把变异插入流程改成 GPU 原生实现 | 编辑阶段快 98.6 倍,端到端快 59.6 倍;mutation-frequency error 从 0.076 降到 0.034 | 在一个 donor、10 Mb 区域上检查变异准确性和 synthetic artifact 2 |
| hifiasm | 优化长读长基因组组装的热点路径 | 合成数据运行时间降低 25.1%,人类 chr20 真实数据降低 14.7% | 留出的合成 benchmark、预设 read-ordering 阈值和真实读段 2 |
| cyvcf2 | 现代化 VCF 读写库的安装、测试和发布流程 | 更新包元数据、CI、发布流程并引入 scikit-build-core,保持 VCF 处理行为 | 构建、部署和原有处理行为检查;报告没有给出独立数值基准 2 |
| bayesm | 用 Rust 重写部分贝叶斯模型和采样器,并加入 HART、HMC/NUTS 扩展 | 基础重写满足 posterior-agreement 容差;扩展初版出现缺陷,修正后通过收敛与 simulation-based calibration 检查 | 后验均值、收敛诊断、仿真校准和与原实现对照 2 |
| HI.SIM | 在保持输出完全一致的前提下做局部优化 | 四个 workload 的总运行时间降低 30.97%,输出 byte-identical | 字节级输出一致性和四组 workload benchmark;这是 8 个案例中几乎没有初始提示后人工介入的例外 2 |
这张表里最容易被忽略的差别,是结果数字和验收标准必须一起读。RustQC 的「约 60 倍」来自流程重构与工具合并,HelixForge 的「59.6 倍」来自特定 GPU 原生路径,HI.SIM 的「30.97%」则建立在 byte-identical 这个很强的约束上。它们都说明工程改造可以更快,但没有组成一个能回答「agent 普遍提升多少」的实验。
验证把人重新拉回主流程
报告的三个共同观察,可以压缩成一条因果关系:改动范围越大、科学行为变化越多,人工验证越难;代理越能快速产出初版,人就越需要提前定义验收目标,并在中间结果出现后解释差异。小范围维护可以用精确输出或现有测试检查,流程重构和新功能则要比较真实数据、数值结果、下游工作流或预先写好的科学性质。2
MHCflurry 是较干净的例子。迁移到 PyTorch 不是把代码编译通过就结束,而是要求原来发布的模型权重不变,并在 315 个 allele-peptide 组合上逐项比较多个输出。这个目标把「实现是否完成」转换成了一个外部可检查的问题,代理才有可能围绕它反复修正。2
bayesm 则说明,合理的数字也可能掩盖错误。HMC/NUTS 和 HART 扩展的第一版结果看起来有说服力,但后续的收敛诊断、simulation-based calibration 和原实现对照发现了缺陷。HelixForge 还出现过一次相反方向的问题:由下采样造成的审计假阳性,让团队一度怀疑 GPU 实现,后来才发现问题在验证程序本身。测试框架不是自动获得的真理,它也需要被人检查。2
这也是为什么报告把「agent 自己说已经完成」视为弱证据。除 HI.SIM 外,其余 7 个案例都由人定义代表性数据、下游量和成功门槛,再决定证据是否足以支持发布。初版实现往往很快,最后处理边界条件、细微数值差异和真实规模数据中的异常,反而消耗最多时间。2
真实数据还会改变速度结论。hifiasm 在合成数据上提速 25.1%,换成人类 chr20 读段后是 14.7%;RustQC 也需要在真实测序规模上验证,才能暴露最小数据集看不到的边界情况。合成 benchmark 适合快速迭代,不能替代代表性数据。
工程加速不等于科学产出
这份报告最有价值的地方,不是它列出了几个漂亮的加速数字,而是把 agent 能做的工作拆成了几个具体层次。
第一层是维护和迁移。改包、补测试、更新依赖、把 API 从一种框架搬到另一种框架,这些工作长期消耗科研人员时间,却通常没有新的论文产出。MHCflurry 和 cyvcf2 说明,代理可以降低这类工作的固定成本。
第二层是性能优化。RustQC、HelixForge、hifiasm 和 HI.SIM 的结果显示,代理可以参与算法、内存、I/O、GPU 路径等更深的改动。但这些项目都把性能目标和科学等价、输出一致性或领域指标绑定在一起,速度本身不是验收结果。
第三层是新能力和新系统。svb、kuva、bayesm 的扩展以及 HelixForge 都超出了简单的代码搬运。此时没有总能照抄的旧实现,团队要先决定什么算正确,再决定如何测试。报告也因此把「问题定义、系统设计、验收标准和差异解释」视为人类工作的中心,而不是把人描述成只负责最后点一下确认。
便宜的重写带来维护问题
科研软件的生命周期不会在代码跑通时结束。成熟工具往往有未写进文档的兼容约定、用户习惯和下游依赖,原维护者知道这些隐性条件。代理降低了另起炉灶的成本,却也让团队更容易产生多个看起来相似的实现,用户和维护者的注意力可能因此被分散。2
报告里的处理方式各不相同。MHCflurry 的迁移留在原项目中,cyvcf2 的改动交给原维护者评估;FastQC-Rust 找到性能改进后,又把一部分改动移植回上游 Java 实现。STAR 原项目已经不再积极维护,rustar-aligner 则转入 scverse,并与 nf-core 做流水线集成,让后续支持不依赖单一贡献者。技术方案不同,判断标准是一致的:发布前就要明确兼容性、许可证、归属、bug 处理和谁负责维护。2
读科研 Agent 结果时先问四个问题
- 验收目标是什么? 是 byte-identical、数值容差、旧模型预测、下游结果,还是只有「看起来合理」?目标越具体,结果越容易复核。
- 测试数据够真实吗? 小型或合成数据能缩短迭代,但要看真实规模数据是否保住了速度和科学行为。
- 验证程序本身查过吗? bayesm 和 HelixForge 都说明,错误可能来自实现,也可能来自审计与 benchmark。
- 发布后谁负责? 没有清晰维护者的重写,即使速度更快,也可能只增加一份无人照看的代码。
OpenAI 这份报告支持的判断很具体:coding agent 已经能成为科研软件团队的工程增量,尤其适合目标清楚、结果可外部检查的任务;它还没有证明模型可以独立承担科学正确性和长期维护责任。真正转移的是实现劳动,验收与 stewardship 仍是项目能否进入科研工作流的门槛。
References
- 1
- 2
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.