ARC-AGI-3 从 13.3% 到 38.3%:OpenAI 拆解 Agent 基准的 harness 影响
OpenAI 发现,GPT-5.6 Sol 在 ARC-AGI-3 上的分数会随 reasoning 保留和上下文压缩显著变化,说明长任务 benchmark 测到的是模型与 harness 的组合。

38.3% 这个数字不能脱离 harness 读。OpenAI 7 月 29 日发布的文章显示,同一个 GPT-5.6 Sol 在 ARC-AGI-3 public set 上,使用官方 harness 得分 13.3%;保留 reasoning、启用 compaction 后,得分升到 38.3%,同时 output tokens 减少约 6 倍。这里的变化来自模型与评测脚手架的组合,而不是一次单独的模型升级。1
这项实验回答的不是「GPT-5.6 Sol 究竟有多强」这么宽的问题,而是一个更容易被 benchmark 报告藏起来的问题:长任务里,模型能不能继续使用自己已经形成的计划、观察和策略?如果 harness 在每个回合都删掉这些状态,分数测到的就不再只是模型的推理能力。
先把 13.3% 和 38.3% 的口径锁死
ARC-AGI-3 让 Agent 探索没有显式说明的 2D 游戏,再根据关卡完成情况和动作效率计分。它采用 RHAE(Relative Human Action Efficiency),把每一关的 AI 动作数与人类基线比较;内部 reasoning、tool call 和 retry 不算游戏 action。2
ARC 的单关分数公式是
level_score = (human_baseline_actions / ai_actions)^2,每个游戏再按关卡编号加权平均,所有游戏分数最后取平均。没有完成后续关卡,即使前几关动作很少,游戏分数的上限也会被完成进度压住。2这让 38.3% 不能被直译成「模型有 38.3% 的题做对了」。它混合了两个因素:Sol 是否完成了更深的关卡,以及完成时用了多少动作。OpenAI 文章还根据官方 gameplay logs 估计平均人类测试者得分约 48%,但 ARC 方法文档定义的 human baseline 是每个 level 的 upper median human。两者不是同一个统计量,不能直接拿 38.3% 与 48% 做人机排名。12
默认 harness 丢掉了两类状态
OpenAI 复查 GPT-5.6 Sol 的失败轨迹时,发现它每次执行游戏动作后都会丢掉 private reasoning。模型仍能看到过去的动作记录和简短备注,却看不到产生这些动作的计划、观察和思路。于是每一回合都要重新解释游戏,而不是在上一回合的假设上继续学习。1
第二个问题来自 rolling truncation。文章描述的 harness 在上下文超过 175,000 个字符后丢弃最早的消息。任务越长,模型越容易同时失去早期观察和早期动作;而在接近上下文上限时,它还要在更满的窗口里运行。前者损失长期记忆,后者增加了上下文负担。1
| 状态 | 默认 harness 的处理 | 对长任务的直接影响 |
|---|---|---|
| Private reasoning | 每次动作后丢弃 | 下一回合无法直接调用刚形成的计划和解释 1 |
| 早期轨迹 | 超过上下文上限后滚动截断 | 早期观察和动作从可见历史中消失 1 |
这两个设置叠加后,模型面对的不是一个稳定的「探索—记忆—修正」循环。它既不能保留上一轮的内部推理,也不能无限保留自己已经试过的路径。对需要先猜规则、再验证规则的游戏来说,harness 先破坏了学习链条。
retained reasoning 和 compaction 分别补了什么
OpenAI 的修复分成两步。第一步是保留 reasoning。文章把 ARC-AGI-3 接到 Responses API harness 上;在 GPT-5.6 场景中,传入前一个 response ID 就能让后续工具调用和回合继续使用此前保留的 reasoning。这样,模型不必每次从动作结果开始重建问题,也更容易形成跨回合的策略。1
第二步是把 rolling truncation 换成 compaction。它不是把上下文上限简单推高,而是在长任务继续运行时,将较早的对话压缩成摘要,再把新的 reasoning、tool call 和 tool result 接在后面。模型因此保留了对游戏规则和已验证路径的压缩记忆,而不是等历史增长后直接丢掉开头。
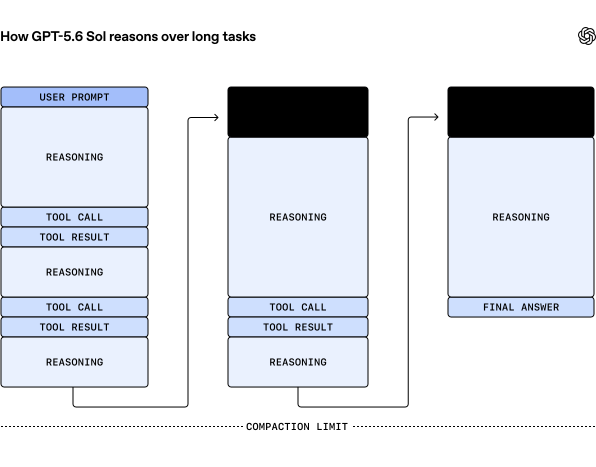
两者解决的是不同的状态损失:retained reasoning 恢复「我刚才为什么这样做」;compaction 延长「我更早之前已经知道什么」。这也解释了为什么 output tokens 会下降:模型不必反复花大量推理 token 重建同一局面的背景。OpenAI 报告的是约 6 倍的相对下降,不是固定的成本或延迟承诺。3
38.3% 说明了什么,又没有说明什么
先看实验本身。OpenAI 报告的对照是:
| 配置 | GPT-5.6 Sol 在 ARC-AGI-3 public set 上的结果 |
|---|---|
| 官方 harness | 13.3% RHAE 1 |
| Responses API harness + retained reasoning + compaction | 38.3% RHAE;output tokens 约少 6 倍 1 |
38.3% 是一个真实的实验结果,但不是脱离协议的「GPT-5.6 Sol 固有分数」。OpenAI 同时换了 harness,并联用了两项设置。文章没有给出 retained reasoning 与 compaction 各自的单独消融数字,也没有在这里提供跨模型、跨 benchmark 的复验。因此,不能从这一次对比推导出「compaction 单独贡献了多少个百分点」,更不能把它外推成所有长任务都会提升约三倍。
这不是要把 13.3% 判成唯一正确的数字。两个 harness 对应两种不同的评测目标:
- 如果目标是比较模型在同一套最小接口上的表现,关闭模型专属的 reasoning 保留和上下文管理,有利于统一协议;但这时必须承认,测量对象是「模型在这套受限 harness 中的表现」。
- 如果目标是估计 ChatGPT 或 Codex 类产品中的 Agent 能力,保留 reasoning、使用 compaction 更接近真实部署;但这时模型、状态管理和动作接口应被视为一个系统来评测。
OpenAI 文章建议 API 开发者使用 Responses API、保留 reasoning 并启用 compaction;这是一条产品工程建议,不等于 ARC-AGI-3 官方排行榜应自动改用这套协议。真正需要公开的是评测目标和 harness,而不是只在标题里留下一个分数。1
以后读 Agent benchmark,先找这六个字段
- 模型与接口:具体模型版本、API 类型,以及是否使用了模型厂商的专用 harness。
- reasoning 状态:每次工具调用后的 private reasoning 是否保留,下一回合能否读取。
- 上下文管理:达到上限时是截断、摘要、compaction,还是直接开启新会话。
- 动作与工具预算:哪些操作算 action,tool call、retry、内部思考是否另计成本。
- 评分公式:分数看完成率、动作效率、token 消耗,还是几者的组合;人类基线又是哪一种统计量。
- 消融与复验:关键设置是否逐项打开,是否跨模型、跨任务集重复。
这六项决定了一个分数究竟在回答什么。ARC-AGI-3 的这次对照最有用的地方,不是把 38.3% 变成新的单一排名,而是让 Agent benchmark 的隐藏变量浮到台面上:长任务的成绩,至少是模型能力、推理状态、上下文管理、动作接口和评分方法的共同结果。
References
- 1
- 2ARC-AGI-3 Scoring Methodology
docs.arcprize.org
- 3
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.