同一个任务,$0.29 与 $2.13:agent 的账单记在四行上
一份价目表给不出一次 agent 任务的账单:同一批任务换一套外壳,单任务成本从 $0.29 到 $2.13,而 KV 缓存读取占了 API 成本的八成。文章把开销拆成四行,给出四种成本口径的换算条件,以及 11 月 1 日起新出现的按次计费项。
10 月 20 日凌晨,Artificial Analysis 放出了 DeepSeek V4.1-Flash 1017 的评测结果。
他们给出的单任务成本是 $0.26,综合分 45 1。
同一条帖子里还有两个数:MiMo-V2.6-Pro 46 分、$0.13;GPT-6.1 Sol 48 分、$0.21 1。
分数更高的那两款,任务成本都更低。
一个小时后,另一份材料给出了更大的倍数。
arXiv 上有一篇预印本,讲的是 agent 的执行外壳。外壳指 harness,承载模型、决定它怎么调工具与推进流程的那层程序。
它在 HealthBench Professional 的 53 个共同任务上做了配对比较:同一个模型、同一批任务,直接作答与加外壳各跑一遍 2。
加了外壳之后,单任务推理成本从 $0.29 涨到 $2.13,平均耗时从 0.59 分钟涨到 6.80 分钟 2。
总分比直接作答高 19.89 分,任务级中位数却降了 1.46 分 2。
这两份材料都在讲分数与账单的关系,方向却相反。
前一份里,分数高的模型任务成本更低;后一份里,分数涨了,账单也涨了七倍。
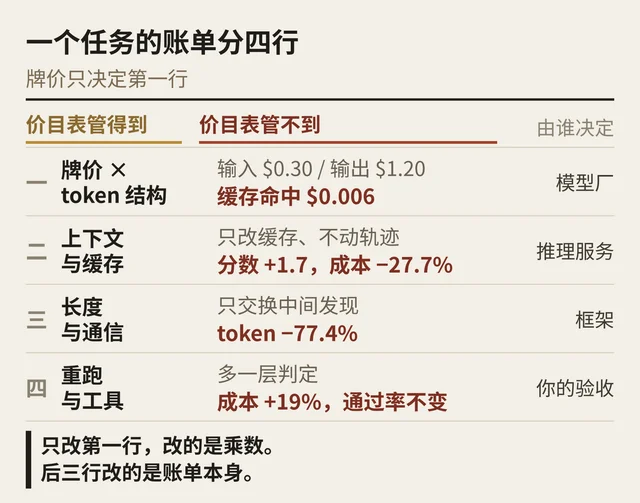
一次 agent 任务的开销分四行记。牌价乘 token 结构是第一行,上下文与缓存是第二行。
长度与通信是第三行,重跑与工具调用是第四行。
价目表上只印了第一行。
这一周的材料,把后三行各自的价码摆了出来。
四个成本,每个有自己的分母
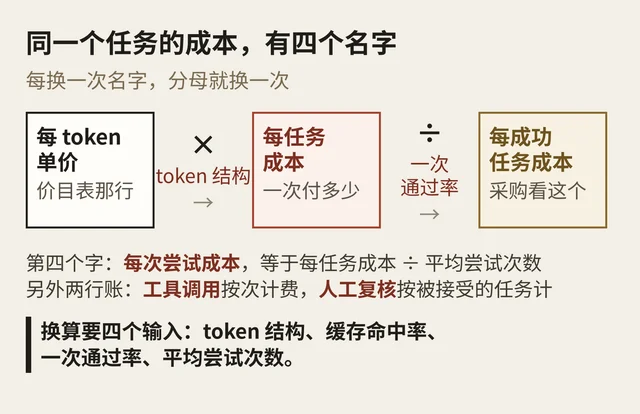
「成本」这个词,在 agent 上至少指四件事。
每百万 token、每任务、每成功任务、每次尝试,四个名字的分母各不相同。
Artificial Analysis 报的是每任务成本。算法是把五类 token 分别计价。
输入、缓存命中、缓存写入、推理、回答各按各的价格算,再除以任务数,按该项在指数里的占比加权 3。
缓存写入单独列一项。改上下文时写进去的缓存,本身就在账单上。
本周出现的四个数,记的其实是四件事。
后两个是变化率,本身不带分母。
把它们和前两个放进同一张表比大小,会得出互相矛盾的结论。
第一行:牌价,与它管不到的部分
先从牌价说起,因为它最容易查。
DeepSeek V4.1-Flash 1017 在第一方 API 上的价格是输入 $0.30、输出 $1.20 每百万 token,谷时半价 1。
缓存命中价 $0.006 每百万,相当于打了 98% 的折扣 1。
按这组数字算一笔示意账。一个任务读进 100 万 token,全按未命中价付是 $0.30。
九成命中缓存的话,账单约 $0.035,低 88%。
同样的输入量、同样的模型,账单差出一个量级。差别全在命中率。
命中率取决于外壳怎么切上下文,也取决于推理服务敢不敢复用。牌价只是这条式子里最前面那个乘数。
回到开篇那三个模型。排序错位的原因在 token 结构:一个任务要读多少、写多少、能不能命中缓存。
省 token 的模型,单价可能更贵,账单更便宜。
价格这一行,本周还多了一个变化:它开始与特定外壳绑定。
DeepSeek 在 10 月 17 日的更新里写明,新版针对 DeepSeek Harness、腾讯 CodeBuddy 与 WorkBuddy 做了专项优化 8。
选型的第一句话,从「多少钱」变成「在哪个壳里多少钱」。
第二行:上下文与缓存,账单最大的一行
这一行有多重,本周第一次被人称出来。
那篇论文叫 Cache Engineering for Agents 6。
它给了一个此前很少被量出来的比例:在一个 100 题的 agent 基准上,KV 缓存(模型算过的上下文中间状态)读取占总 API 成本的 82.4% 6。
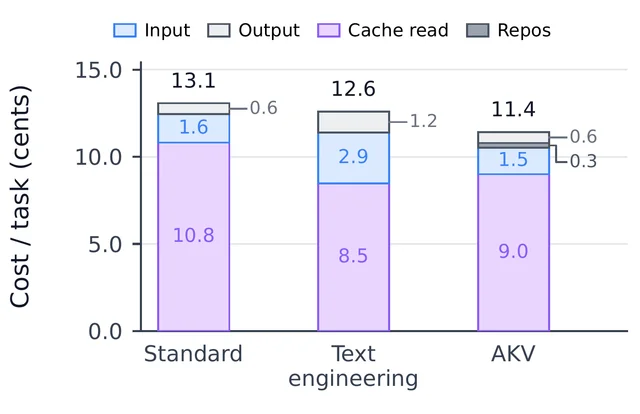
机制很具体。轨迹一旦被裁剪或摘要,前缀就变了,后面算好的缓存随之作废,服务端得重做一次预填充(prefill)。
修剪上下文省下的 token,可能被作废缓存的重算吃回去。
论文的做法是把动作挪到缓存层:轨迹不动,直接丢弃或重新定位缓存条目(drop / repos)。
在 3 个模型 × 4 个 agent 基准上,这套策略相对「按阈值触发摘要」的常见做法,平均分高 1.7,平均成本低 27.7% 6。
论文同时给了一个前提:同一段 token 序列在不同缓存操作下会产生不同状态,只靠前缀匹配会复用错 6。
落到工程上,推理服务要把缓存当成有状态对象管理。
只改应用层也有一份收益。TraceLite 把不断变长的轨迹压成图像式表示,去掉冗余。
相对完整送入轨迹的做法,它把每任务输入 token 从 289,507 降到 193,827,降 33.05%;API 成本降 21.30% 9。
在 SWE-bench Verified 上,它的解决率是 78.25%,也是这篇评测过的几种压缩做法里最高的 9。
两条路的分工值得记住。缓存工程要求推理服务配合,改的是钱最多那一项;轨迹压缩在应用层就能做,改的是送进去的量。
先做哪个,取决于你有没有权限动服务端。
这两份结果的边界也清楚。Cache Engineering 只测了 3 个模型、4 个基准,上下文上限 128K。
TraceLite 的精度权衡用的是自建语义评分,结论绑在 SWE 类 agent 上 9。
第三行:读多少,和别的 agent 交换什么
一个任务读多少 token、跟别的 agent 交换什么,直接决定这一行的账单。本周有两组数字说明幅度。
第一组是长度的分布。FlashNext-RL 在训练长时程 agent 时报出了 rollout(一次完整执行轨迹)的长度分位。
中位 29K token,p90(第 90 百分位)61K,p99 108K,部分轨迹触到 131,072 的上限 10。
更关键的是长尾。超过 64K 的轨迹只占条数的 7.7%,却吃掉 19% 的 token 10。
按中位数留预算,会系统性地低估账单。
第二组是通信结构。Muffin 比较了多 agent 之间两种交换方式。
一种是轮流发言、共享完整轨迹;另一种是异步共享中间发现,把私有推理留在各自上下文里 7。
后者在 20 个基准设置里有 17 个拿到最佳准确率;相对多 agent 辩论法,准确率高 19.2 个百分点、token 少 77.4% 7。
它的限定:用的是开源底座模型,任务集中在有标准答案的推理类基准 7。
如果机器是自己跑的,这一行还要再算一次。
AgentLens 在同一台机器上共置多个 agent 做测量,发现峰值内存的方差里,框架身份解释 52.95%,任务内容只解释 4.22% 11。
差距到进程层更直观。完成同一个抽象工具调用,MetaGPT 要起 117.2 个进程,CAMEL 只要 3.0 个,差 39 倍 11。
论文用框架指纹加运行时阶段信号做 cgroup(Linux 的资源控制组)协调。
被保护任务的 P95 分配延迟因此压到 5.7–7.1 毫秒,比静态分配好 2.1 到 2.6 倍 11。
这篇只有一位作者,重放实验也只做了 3 组共置对。它给出的口径是:容量按框架算,任务量只占很小一份。
第四行:换一套外壳,分数和账单一起变
同样是改外壳,本周三篇论文给出了三个方向。
第一篇是开篇那篇。它的评测覆盖终端任务、临床应答、应用构建与科学问答四类。
在 Terminal-Bench 2.1 上,它通过 89 个任务中的 83 个,93.26% 2。
能看清单价的是临床那一组:HealthBench Professional 的 53 个共同任务,四种配置各跑一遍。
配对的聚合分比直接作答高 19.89 分,任务级中位数变化 −1.46 分;单任务推理成本从 $0.29 涨到 $2.13 2。
两个数方向相反,含义很直接。
总分的上涨来自少数任务从失败翻身,多数任务略降一点。同一次替换,在报表上和在单题上是两件事。
论文报出的耗时涨得更快:从 0.59 分钟到 6.80 分钟,接近 11 倍 2。
第二篇给出了成本档位。HarnessPro 把外壳演化成轻、中、重三档。
重档相对 RHO 这套对照外壳,平均通过率高 2.0 个百分点,平均单任务成本低 26.1% 4。
在 SWE-Bench Pro 上,它拿到 79.0%,对照是 80.0%;分数低一个点,单任务成本从 $2.68 降到 $1.26,低 53% 4。
这份结果的限定不少:只测了两个模型与 Codex、Claude Code 两套外壳,成本按作者自列价目计算。
外壳候选靠 LLM 生成测试来筛,属于无标签设定,与官方测试通过率是两套口径 4。
第三篇走的是稳定性的路。RiseHarness 固定模型权重,只改外壳。
它专挑「同配置下有时成有时败」的任务下手,把 Terminal-Bench Hard 的 Pass@1 从 56.75% 提到 64.00% 12。
三篇方向不同,共同点落在同一处:外壳是独立的成本与能力变量,收益要两头同时记。
还有一个容易忽略的中间态。HarnessPro 在中等档自我迭代时,通过率从 70.0% 升到 77.0%,平均成本从 $1.57 升到 $1.66 4。
这一档的分数与成本同时上升,演化出来的外壳未必朝省钱的方向走。
花了钱没买到分的地方
有的层加进去,成本涨,分数不动。本周有一篇论文把这个负结果做得很干净。
它在确定性决策点插入一个小的「决策模型」,负责判断该停、该验、还是该换路。
在 21 个留出任务、315 次试验上,每次尝试成本涨了 19%,几何均值比 1.19,95% 置信区间 1.02 到 1.36 5。
按单次金额算,每次尝试平均多花 $0.029,其中 $0.011 花在第一条验证消息之后 5。
通过率两边完全一样,73.0% 对 73.0% 5。
它离线看挺准,AUROC(判别力指标,0.5 等于抛硬币)0.78。问题在概率校准。
当 87% 的运行实际通过时,模型给出的「已完成」平均概率只有 0.50,于是它反复让 agent 去验证本来已经正确的活 5。
所有试验里,没有任何一个控制器选择过放弃一次运行。
这篇是单作者工作,做了预注册,也把与预设方案的偏离列了出来;样本是 1 个终端 agent 模型、21 个任务 5。
也有花钱买到分的例子,只是代价能算清楚。RoleFlow 用单次编辑的反事实对照演化多角色结构。
它在 7 个基准上平均 67.1 分,比最强的多 agent 对照高 4.7 分,代价是每道训练题的链执行次数从 9.1 升到 13.5 13。
把尺度拉到企业侧,本周还有一组数。Gartner 在 10 月 19 日发布调查,样本 2,002 名 CIO 与技术高管,调查期是 2026 年 5 月到 7 月 14。
13% 称自己的企业已经实现显著或转型价值 14。
Gartner 另给出单个用例的成功概率为五分之一 14。这个数按用例算,与上面那个按企业自报的 13% 量的不是一件事。
58% 说来自 AI 的降本压力在上升,51% 预计 AI 会抬高技术栈的总拥有成本 14。
有「AI 试点不进入生产就停掉」这类规则的组织占 31%,有「停掉低价值项目」规则的占 17% 14。
有前一类规则的组织,成为 Gartner 所称 vanguard 的可能性是其他组织的 2.3 倍;有后一类的,是 2.6 倍 14。
做了人机协作岗位重设计的只有 4% 14。
Gartner 自己写明这是相关性,vanguard 是按业绩与 CEO 感知自定义的分组。
这份调查讲的是企业整体 AI,没有拆到 agent 这一层。它能提供的是一个分母:企业侧报出来的价值实现比例。
为什么两个团队算出来的账不一样
把每次尝试成本换算成每成功任务成本,需要知道一次通过率。
DoorDash 那份工业报告给了完整的一组。56,000 多个 feature flag(功能开关)、623 个仓库,取 50 个待清理的样本。
45 个产出的删除 PR(合并请求)被工程师接受,占 90% 15。
50 个里有 31 个一次通过,占 62%;14 个小改后通过,占 28%;5 个失败,占 10% 15。
单次平均成本 $4.79,中位 $3.49,平均耗时 13.8 分钟 15。
按复杂度分,简单任务 $2.69、中等 $3.46、复杂 $6.20 15。
接近四成的量要返工。这部分人工不在 $4.79 里,却落在每一单的真实成本上。
第二个差别在样本。同一批数据换个任务集,排序就可能变。
SWE-Bench Pro V2 把 642 个任务的「解决或未解决」做方差分解。
任务身份解释 31.7%,模型解释 2.65%,外壳解释 0.29%,模型与外壳的交互 0.36%;剩下 65.0% 是同一任务不同次运行之间的波动 16。
这个结果和前面「改外壳能提分」同时成立。它说的是另一件事:单次运行里,噪声比配置差异大得多。
拿一次分数比较两个方案,多数时候在比噪声。
第三个差别在测量成本本身。给每个角色选模型,本质是在质量与成本之间找一条前沿,而把前沿测出来要花钱。
Which Model for Which Role 把评估成本也算进搜索里。
它用约 10% 的穷举评估预算就恢复了大部分真实前沿 17。
在 BIRD Dev 上,假阳性为零,也就是没有一个不在真实前沿上的配置被误判为最优 17。
作者写明这是搜索预算层面的结论,选出的配置在下游业务上是否同样最优,未做证明 17。
工具调用开始单独计价
本周还有一件与账单结构直接相关的事:token 之外,开始出现按次收费的行。
DeepSeek 在 10 月 17 日的更新里把 Search 与 Fetch 两个接口对外开放,定价都是 5 元 / 千次 8。
在 DeepSeek Harness、Claude Code、Codex 里使用 DeepSeek API 时,服务端工具调用已经会访问这两个接口。
对 Search 与 Fetch 的调用目前不计费。2026 年 11 月 1 日 00:00 起,它们按次收取 8。
这是本周唯一一个给出计费切换时间的动作。跑在这些外壳里的任务,账单会多出一栏。
OpenAI 那边动的是计费结构。10 月 22 日正式可用的 Decisions API,输入 $0.10 每百万 token,缓存输入 $0.01。
输出 token 不计费,单请求最多可提 400 个问题 18。
输出不计费,是因为这类「有界答案」的输出很短。按用途裁剪计费项,本身就是价格设计的一部分。
10 月 23 日凌晨,Agentic AI Foundation 一次性收下四个项目。
四个分别是 Anthropic 的 Agent Skills、OpenAI 的 Open Responses。
另外两个是 Hugging Face 的 OpenEnv 与阿里的 OpenSandbox。
基金会成立一年,项目数从 3 个增到 10 个,这次新增的是其中四个 19。
官方把这四层写得很清楚:agent 怎么获得新能力、应用怎么跨厂商调模型、在哪里训练与评测、在哪里安全运行 19。
预算表要留两栏,一栏按 token,一栏按调用次数。换算率要按自己的流程估。
成熟度分层
| 维度 | 本周现状 | 建议落点 | 动作窗口 | 判断 |
|---|---|---|---|---|
| 缓存与上下文 | KV 缓存读取占 API 成本 82.4% 6 | 先量自己的缓存命中率,再决定压缩还是改缓存 | 现在:应用层压缩可先做 | 已落地:机制清楚,收益可测 |
| 外壳的成本档位 | 同批任务换外壳,成本可涨 7.3 倍,也可降 53% 24 | 改外壳时把分数与账单并列记,跑多次看波动 | 现在:换配置即可对比 | 快速扩张:做法可行,口径未统一 |
| 记账口径 | 每任务、每成功任务、每次尝试三个分母并存 15 | 采购口径统一到每成功任务,把重跑与人工复核算进去 | 现在:改一张表 | 已落地:只需改分母 |
| 单次运行的波动 | 任务与运行的残差解释 65.0% 的方差 16 | 任何比较都跑多次,报区间而不是单点 | 现在:加重复次数 | 容易被高估:拿一次分数定方案 |
| 工具计费 | Search / Fetch 5 元每千次,11 月 1 日起在三个外壳内计费 8 | 预算按 token 与调用次数两栏留,换算率按自己的流程估 | 11 月 1 日前 | 快速扩张:计价已公布,用量未公开 |
| 多层判定 | 插入决策模型让每次尝试贵 19%,通过率不变 5 | 每一层新增的判定单独记账,按通过率验收 | 现在:先做小规模对照 | 容易被高估:判定看着更稳,买不到成功率 |
| 模型与外壳绑定 | 新模型明确针对三套外壳做专项优化 8 | 选型按「模型 × 外壳」的组合测,不按模型单测 | 现在:组合测一轮 | 快速扩张:厂商已在做,口径未成标准 |
现在就能算清楚的四件事
- 先把分母改对。 把「每次多少钱」换成「每个被接受的结果多少钱」,用自己场景里的一次通过率去除 15。
- 先动上下文,再考虑换模型。 缓存与压缩的收益在应用层就能拿到,换模型的收益要先扣掉 token 结构的差 69。
- 预算按分位留。 p90 是 61K,p99 是 108K;超过 64K 的轨迹只占 7.7%,却吃掉 19% 的 token 10。
- 新增的每一层都要单独验收。 判定、验证、控制器都记自己的成本与通过率变化,哪一边没动就该考虑撤掉 5。
未来 6–12 个月
先记下 11 月 1 日:DeepSeek 的 Search 与 Fetch 从那天起在三个主流外壳里按次收费 8。
它会把工具调用变成一项可观测的支出。
按这一周的走势推,接下来有三件事会先发生。
第一,缓存管理会从应用技巧变成服务能力。82.4% 这个比例一旦被更多团队测出来,推理服务会把缓存作为可操作对象开放出来 6。
第二,成本会像准确率一样进排行榜。Artificial Analysis 已经在用每任务成本给模型排位,五类 token 分别计价 3。
结论
回到 $0.29 与 $2.13 这两个数。它们差七倍,用的是同一套权重。
论文没有把这笔差额拆成单项。它同时报出耗时涨了近 11 倍,多出来的是调用轮次。
这些轮次来自外壳安排的规划与复核。价目表上找不到它们。
所以第一件事很简单:把自己系统里一个任务的钱按四行拆开。
先看缓存与上下文那一行——本周唯一一份完整的成本拆分里,它占了八成。然后,才是选模型。
References
- 1
- 2
- 3Artificial Analysis 的模型对比与成本口径
artificialanalysis.ai
- 4
- 5
- 6Cache Engineering for Agents
arxiv.org
- 7
- 8DeepSeek V4.1 Flash 新版本发布说明
api-docs.deepseek.com
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19Agentic AI Foundation Announces Four New Projects
linuxfoundation.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.