《InstructGPT》:把人的偏好压成一个标量,1.3B 为什么比 175B 更讨人喜欢
从 GPT-3 会编造也会不照指令讲起,拆开 InstructGPT 的示范、排序、PPO 三步,讲清奖励模型与逐 token KL 罚各自在算什么,并用 85%±3% 与四格人评图读懂这个人评成绩量的是谁。

2022 年 3 月 4 日,arXiv 上线一篇 68 页的论文,标题是《Training language models to follow instructions with human feedback》。
署名 20 人,全部来自 OpenAI。1
同年 12 月的 NeurIPS 收录了它。
到 2026 年 10 月 27 日,OpenAlex 给这条会议记录计到 3,054 次引用。4
论文开头摆的是一个很具体的落差:把语言模型做大,并不会让它更愿意照你说的做。1
GPT-3 会编造事实,会生成有毒文本,也会在给了明确指令的情况下做别的事。论文把这种状态叫作未对齐(misaligned)。5
三步微调之后,情况变了。1.3B 参数的 InstructGPT,输出在自家 API 的提示分布上被人偏好,胜过 175B 的 GPT-3。5
下面的事实、公式、图与表,都按 arXiv v1 的排版版读,也就是 68 页那份。5
目标错位:预测下一个词,与听指令
语言模型的训练任务是猜网页上的下一个词。5
论文在第 5.5 节把这个关系写成一句话:下一个词预测只是「按用户意图做事」的代理指标。代理指标与被代理的目标之间有缺口,训练把模型推向代理指标的最优点,缺口留在那里。5
缺口具体长什么样,论文列了三类:编造事实、输出有偏向或有毒的内容、不跟用户的指令走。5
为了把「想让它做什么」说清楚,论文借用了 Askell 等人的三个词:有用、诚实、无害。5
有用指帮用户把任务做完,还要能从少量示例里读出意图;诚实指不编造、不误导;无害指不给人或环境造成身体、心理、社会的伤害。5
三个词里有两处不好测。诚实要比较模型的输出与它自己「相信」的答案,而模型内部读不出来;伤害要看输出在现实里怎么被用,而这在训练阶段无法预知。5
论文因此退到四个可测的替代指标。闭域任务上量编造率,TruthfulQA 上量人工判断的真伪,RealToxicityPrompts 上量毒性评分,Winogender 与 CrowS-Pairs 上量偏向度。5
这套做法有前身。论文自己溯源到三处。5
Christiano 等人 2017 年在 Atari 游戏与模拟机器人上,用成对比较训出奖励。6
三步:示范、比较、把奖励当成目标
整条流水线画在图 2 里,读法是从左到右。
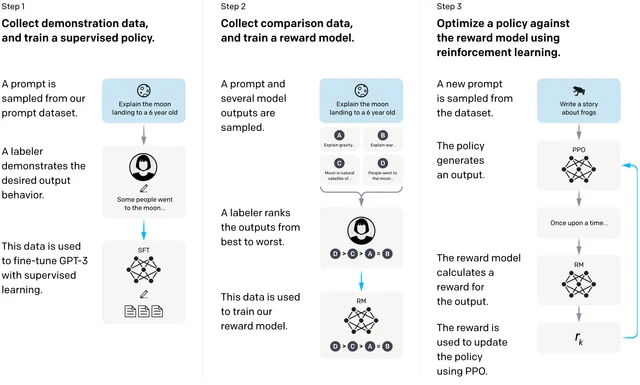
三步各吃一份数据,规模都不大。第一步的监督微调用了 12,725 条训练提示,其中 11,295 条由标注者自己写,1,430 条来自 API 客户。5
第二步的奖励模型用了 33,207 条提示,每条让标注者对 4 到 9 个回答排序。5
第三步的 PPO 数据是 31,144 条提示,全部来自 API 客户,不带任何人工标签。5
数据 96% 以上是英文。5
干活的是约 40 名签约标注者,通过 Upwork 与 Scale AI 招募,上岗前先过一轮筛选测试。5
他们彼此的一致率是 72.6%±1.5%,另招一组不参与训练的留出标注者,一致率 77.3%±1.3%。5
这两个数先记住。它们既是这套方法的精度天花板,也是后面「对齐到的是谁」那笔账的起点。
第一步:把示范变成监督微调
标注者先做示范:给出一个提示,亲手写出他们觉得理想的回答。模型在这些示范上做最大似然,损失与预训练时是同一个。5
这一步原文没有编号公式,超参写在第 3.5 节与附录 C.1:训 16 轮,残差 dropout 0.2,余弦学习率衰减到峰值的 10%。5
学习率与批量随规模变:1.3B 与 6B 用 9.65e-6、批量 32,175B 用 5.03e-6、批量 8。5
论文记了一处反常。SFT 模型训到第 1 轮之后,验证损失开始过拟合,一直训到 16 轮却让奖励模型的打分与人工偏好同时变高。5
交付哪个检查点,按验证集上的奖励模型分数挑。5
两个尺子在同一段训练里指向了相反方向:验证损失量的是「像不像示范」,人评量的是「好不好用」。
第二步:奖励模型把「哪个更好」压成一个数
示范只能教会模型模仿某个人写过的答案。要让模型继续变好,需要一种能批量打分、还能对新回答打分的办法,这就是奖励模型。
标注者看到的是一组回答。同一提示下给 4 到 9 个回答,让他们从好到差排序。5
奖励模型的结构是「SFT 模型去掉最后的输出层」,输入提示与回答,输出一个标量。5
它训练的损失是式 (1):
逐项看。 是奖励模型给「提示 、回答 」打的那个数; 是标注者更偏好的回答, 是落选的那个。
两个数相减再过 sigmoid,得到「 优于 」的概率。5
外面套对数再取负,就是把这件事变成一个最大化问题:让标注者选中的那一条,分数尽量高出另一条。5
分母是 。K 个回答两两比较共有 K(K−1)/2 对,损失把这一个提示下的全部比较一起平均。5
实现上有个细节值得记。若把每一对当独立样本摊进数据集,同一个回答要参与 K−1 次梯度更新,训一轮就过拟合。5
论文改为把同一提示的所有比较合成一个 batch 元素,每个回答只前向一次,验证准确率与对数损失都变好。5
规模上只用 6B 的奖励模型。理由写在原文:175B 的奖励模型训练不稳定,做 RL 的值函数不合适。5
最后一步是偏置归一化。奖励整体平移不改变式 (1) 的值,于是给奖励模型加一个偏置,让标注者示范的平均分正好落在 0。5
这一步给后面的强化学习一个固定零点:奖励为正,说明这条回答比人类示范的平均水平更好。
第三步:PPO 沿这个数走,还要被 KL 罚拴住
PPO 这一步的环境写起来很短:随机抽一个客户提示,让策略写一段回答,奖励模型打一个分,回合结束。5
论文管这种设定叫 bandit 环境:整段回答只换回一个标量,中间的每个 token 都拿不到单独奖励。5
奖励只有一个来源,就有被钻空子的空间:模型会写出奖励模型打分高、人却不喜欢的回答。防这件事的办法是逐 token 的 KL 罚,把当前策略拴在 SFT 模型附近。
PPO-ptx 的目标函数是式 (2):
三个部分各管一件事。第一项是奖励模型的打分,越高越好;第二项是 KL 罚,当前策略对同一回答给出的概率若比 SFT 高太多,log 为正,被 扣回去。5
第三项只在 PPO-ptx 里出现:从预训练分布抽一批文本,照语言模型的老目标再算一次对数似然,系数 。5
论文把 的版本叫 PPO,把 的版本叫 PPO-ptx;文中不特别说明时,InstructGPT 指的是后者。5
其余数字: 固定 0.02,训 256k 个 episode,每轮批量 512、小批量 64,值函数从奖励模型初始化。5
PPO 本身频道单独讲过一期,这里它只干一件事:把同一提示采样出的多条回答放在一起,按各自奖励抬高或压低概率,同时限制单次更新的幅度。9
85±3% 该配哪个基线读
图 1 画的是胜率随模型尺寸的变化,读它要先看纵轴写的是什么。
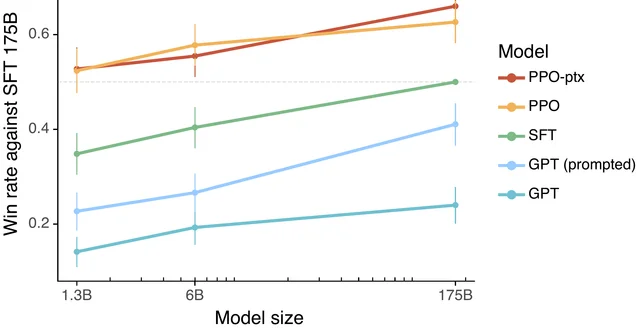
纵轴比的是「被标注者偏好的比例」,基线是 175B 的 SFT 模型,虚线画在 0.5 处。5
选它当基线有理由:论文说它在这批模型里成绩居中,正好做参照。5
五条线的间距就是三步各自的收益。GPT-3 最低,加一段精心挑的几示例前缀能抬一截,监督微调再抬一截,PPO 接着抬一截。5
论文给出的两个具体数字是:175B 的 InstructGPT 对 175B GPT-3 胜率 85%±3%,对加了前缀的 GPT-3 是 71%±4%。5
「1.3B 胜过 175B」这句,原文在摘要与图 1 里陈述为「被偏好」,没有给百分比。这一点读引用时要留神:它是一句定性结论,靠图上的位置支撑。5
这个结论要配三个限定来读。第一,胜率量的是人在这一批提示上更喜欢哪个输出。5
第二,提示来自 OpenAI 自家的 API,测试集用的是训练里没出现过的客户。5
第三,换一组没参与标注的人来评,结论仍然成立:留出标注者同样偏好 InstructGPT。5
奖励模型的跨组泛化给出同方向的证据。把标注者分成五组做交叉验证,奖励模型在训练组内预测偏好的准确率是 72.4%±0.4%,换到留出组是 69.6%±0.9%。5
人评涨了,公共基准掉了
同一批模型搬到公开数据集上,曲线换了方向。
反方向的对照也在这篇论文里。把 175B 的 GPT-3 分别在 FLAN 与 T0 这两批公开任务数据上微调,它们在公开基准上比 GPT-3 强,搬到自己 API 的提示上,人评却低于 SFT 基线。5
175B 的 InstructGPT 对 FLAN 的胜率是 78%±4%,对 T0 是 79%±4%。5
论文给的理由落在构成比例上。标注者给 API 提示分类后,分类与问答加起来约 18%,开放式生成与头脑风暴约 57%。5
PPO 微调之后,SQuAD、DROP、HellaSwag 与 WMT 2015 法译英上出现回退。论文把这笔代价叫对齐税(alignment tax)。5
补法是把预训练梯度按 混进 PPO。PPO-ptx 在这几个数据集上把回退基本抹平,HellaSwag 上还高过 GPT-3。5
DROP、SQuADv2 与翻译三项仍然落后于 GPT-3。5
图 4 把这批人评拆成四格,每格统计一种行为在输出里出现的频率。
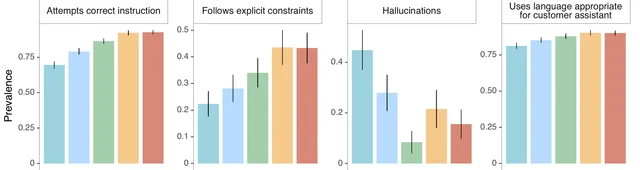
幻觉那一格有一处值得停一下:最低的一柱是 SFT,PPO 反而把它抬了回去。5
按人偏好去优化,与按「少编造」去优化,在同一张图里给出了不同的最优模型。奖励模型学到的是标注者的整体偏好,编造只是其中一项。5
正文给的两个数是 21% 与 41%:闭域任务上,InstructGPT 编造输入里没有的信息的频率约为 GPT-3 的一半。5
毒性只有小幅改善。加上「请保持尊重」的提示,InstructGPT 的有毒输出比 GPT-3 少约 25%;把提示去掉,这点优势消失。5
偏向性没有改善。Winogender 与 CrowS-Pairs 上,InstructGPT 与 GPT-3 的差别不显著。5
还有一条更尖锐的,写在 §5.3:明确要求模型输出有毒内容时,InstructGPT 比同尺寸的 GPT-3 更毒。5
它把「服从用户」学得很好。服从的对象是谁,模型自己分不出来。
对齐到的是谁
第 5.2 节用一整节回答这个问题,列了四层影响因素。
第一层是标注者:多为英语母语者,住在美国或东南亚,经 Upwork 与 Scale AI 招募,彼此一致率约 73%。5
第二层是研究者:标注规范由他们写,边缘情形怎么算由他们在共享聊天室里回答。5
第三层是客户提示:训练数据来自 ChatGPT 之前那批 API Playground 的请求,带着客户自己的用途偏好。5
第四层是客户群体本身:早期 API 用户从等候名单里来,名单最初的种子是 OpenAI 员工。5
论文自己的结论落得很窄:这套方法对齐到的是一个特定人群的偏好,面向一个特定应用。它没有主张这批人就是「人类价值」的来源。5
第 5.3 节接着列模型仍然犯的错。遇到带假前提的指令,它会把前提当成真的;简单问题也过度对冲,给出好几个答案;指令里堆上多个显式约束时开始退化。5
论文对第一条的解释是训练集里假前提的提示太少,模型没学到这类情形;对第二条的猜测是标注规范鼓励「认识论上的谦逊」,标注者偏爱留有余地的回答,奖励模型把这条偏好学走了。5
最重的一条写在 §5.3:多数情况下,模型会照用户说的做,即使那件事在现实里有害。5
这条流水线后来被换成什么
ChatGPT 在 2022 年 11 月 30 日发布,公开说明里写的方法与这一篇一致。10
顺序还是那三步:人工示范做监督微调,收集回答之间的比较数据训奖励模型,再用 PPO 多轮迭代。数据收集略有差别。10
算力账也算得清。175B 的 SFT 用 4.9 petaflops/s-days,175B 的 PPO-ptx 用 60,GPT-3 的预训练是 3,640。5
对齐这一步的成本约是预训练的六十分之一。
Constitutional AI 换掉的是信号来源。人工只提供一份原则清单,模型按原则给自己的输出写批评与修订。11
再由模型判断两个样本哪个更好,用这批 AI 判断训偏好模型,论文把这一步叫 RL from AI Feedback。11
DPO 换掉的是优化那一段。它把奖励模型重新参数化,从偏好数据直接推出最优策略的闭式解,用一个分类损失代替「先训奖励模型、再跑 PPO」这两步。12
顺着这个分法看后来的工作,会清楚得多:换信号来源是一支,换优化方法是一支,换标注的人群与规范又是一支。
读完留下的判断维度
一,先找这一步换了什么目标。预训练优化下一个词,RLHF 优化一个由人偏好训出来的标量,两个目标之间的距离由 KL 罚显式管住。5
二,再问这个标量是谁打的。标注者群体、标注规范、提示来源三层叠起来,决定了模型最后像谁。5
三,人评与能力分开读。85%±3% 量的是偏好,SQuAD 与 DROP 上的回退量的是能力;同一篇论文里出现两个方向的数,正好说明它们量的对象不同。5
四,收益往往不单调。图 4 里 SFT 的幻觉柱最低、PPO 回升;SFT 的验证损失一轮后过拟合、人评却继续涨。每一步都在换一组取舍。5
想自己验一遍,最短的一段是第二步:取 200 条提示,每条让模型生成 4 个回答,找人排序,按式 (1) 训一个小奖励模型。5
然后留出 50 条不参与训练,看这个奖励模型预测人偏好的准确率是多少。它就是这个流程的天花板,论文里对应的两个数是 72.4% 与 69.6%。5
References
- 1
- 2NeurIPS 2022 论文页
papers.nips.cc
- 3Crossref 记录:Advances in NeurIPS 35,页码 27730–27744
api.crossref.org
- 4OpenAlex 作品记录,2026-10-27 查询
api.openalex.org
- 5原论文 v1 第 1 节
arxiv.org
- 6
- 7
- 8
- 9
- 10OpenAI:Introducing ChatGPT,2022-11-30
openai.com
- 11
- 12
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.