《AlphaGo》:让网络给出先验与估值,围棋的搜索空间怎么被收窄
从围棋的分支数与深度讲起,拆解 AlphaGo 的四段训练流水线、策略网络与价值网络的三个更新式,以及把先验、模拟与估值装进同一棵搜索树的方式,并用内部循环赛的 Elo、消融与算力对照读懂它的战绩各自量的是谁。

2015 年 11 月 11 日,《Mastering the game of Go with deep neural networks and tree search》投到 Nature,论文在 2016 年 1 月 5 日被接受,1 月 28 日出版,刊在 529 卷 7587 期,484 至 489 页。12
论文署名 20 人,David Silver 与 Aja Huang 并列第一作者,主要单位是伦敦的 Google DeepMind;John Nham 与 Ilya Sutskever 兼属山景城的 Google。1
论文报告的那场对局发生在 2015 年 10 月 5 日到 9 日,对手樊麾(Fan Hui)是职业二段,也是 2013、2014、2015 三年的欧洲围棋冠军。1 2016 年 3 月,AlphaGo 在首尔与李世石下了五番棋,四胜一负;这是论文出版两个月之后的事,属于这套方法的后续成绩。3
本期的公式、表格与图都按 Nature 正式版的 PDF 读,两张正文图也从这一版的页面里取。1
围棋为什么难:两条通用的减负原则
论文开篇把困难写成一条递推式。完美信息的对局都有一条最优价值函数 v*(s),它决定每个局面在双方完美应对下的结果,可以递归地算出来——代价是遍历大约 b^d 个着法序列,b 是每一步的平均分支数,d 是对局长度。论文给出的两组数字是:国际象棋 b≈35、d≈80,围棋 b≈250、d≈150。1
分支数差一个数量级,深度差近一倍,指数叠起来就是围棋与国际象棋之间那道二十年没被跨过的沟。国际象棋、西洋跳棋、黑白棋都靠深度优先搜索加 alpha–beta 剪枝在 1990 年代前后达到了超人水平,同一条路在围棋上一直没有走通。1
论文把可用的办法归成两条通用原则。第一条砍深度:在一个局面 s 处截断子树,用一个近似价值函数 v(s)≈v*(s) 代替下面的整片搜索。第二条砍宽度:不枚举全部着法,而是从一个策略 p(a|s) 里采样,只走概率高的那几步。1
蒙特卡洛树搜索(Monte Carlo tree search,MCTS)把第二条原则做成了搜索本身。一次模拟从根节点一路走到终局、不回溯,每一步都按当前的统计量选子节点;模拟次数越多,树长得越大,节点上的估值越准,用来选路的策略也随之改进。2006 年前后,Coulom 给出了这类搜索的具体形式,Kocsis 与 Szepesvári 提出的 UCT 则被证明在模拟次数趋于无穷时收敛到最优价值函数。1
论文在方法一节里写明,当时最强的围棋程序都建立在 MCTS 之上,再用线性组合的棋形特征训练出一个策略,把搜索收窄到一条高概率着法的束上。这条路线走到的位置是强业余水平。1
把卷积网络放进围棋也不是这篇论文第一次做的事。论文引用的一项同期工作在四十多万个局面上训练卷积网络来预测人类着法,不带任何搜索时对开源程序 Pachi 赢 11%,对稍弱的 Fuego 赢 12%。1
这篇论文要换掉的正是两条原则里那个「近似」:深度靠一个价值网络来截断,宽度靠一个策略网络来收窄,两个网络都从对局数据里训出来,再交给同一棵搜索树使用。
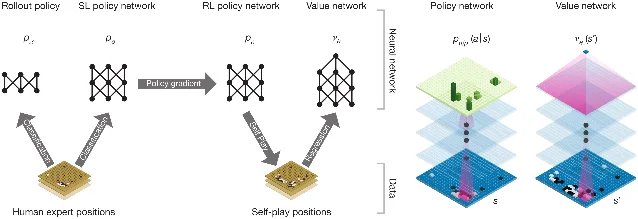
四个组件和一条训练流水线
棋盘在这套系统里是一张 19×19 的图像,每个交叉点用若干张二值平面描述,一共 48 张:石色(我方、对方、空)、这个点有几口气、这一手能提掉对方几子、是否自填眼、这一手的征子是否成立,等等,全部由围棋规则直接算出来。价值网络在这 48 张之外再多给一张「当前该谁下」的平面。1
走子策略 pπ(rollout policy)是四个组件里最便宜的一个,也是唯一一个不用卷积网络的:它是基于局部棋形的线性 softmax,特征可以用增量方式算出来——上一手周围 12 个点的菱形棋形、候选着点周围 3×3 的棋形,按石色和气的多少编码。论文在 Tygem 服务器上 800 万个人类局面里训练它。它预测人类着法的准确率只有 24.2%,单次选点耗时约 2 微秒。1
这份粗糙有专门的用处。搜索里的每一次模拟都要走到终局,落子几十手到几百手;只有微秒级的策略才撑得起速度——论文记录,一个 CPU 线程在空棋盘上每秒能跑大约 1000 次模拟。作为对照,主策略网络做一次前向要 3 毫秒,比它慢三个数量级。1
监督策略网络 pσ 是四个组件里第一个真正下棋的。它是一个 13 层卷积网络:输入 19×19×48 的特征堆叠,第一层用 5×5 卷积加整流非线性,第二到第十二层用 3×3 卷积,最后一层用 1×1 卷积加 softmax,输出棋盘上每一个合法着点的概率。论文比赛用的版本每层 192 个滤波器。1
训练数据是 KGS 围棋服务器上 6 段到 9 段人类棋手的 16 万局、2940 万个局面,其中 35.4% 是让子局;前 100 万个局面留作测试集,其余 2840 万个用于训练,每个局面再扩增出 8 个方向上的旋转与镜像。在这份测试集上,pσ 预测人类着法的准确率是 57.0%(用全部特征)和 55.7%(只用原始棋盘与着法历史),论文同时给出当时其他研究组公开的最好成绩 44.4%。1
强化学习策略网络 pρ 的结构与 pσ 完全相同,权重从 pσ 出发(ρ=σ),改用策略梯度继续训练。每一轮取 128 局并行对局,对手从历史版本里随机抽;每 500 次迭代把当前参数加进对手池。这么安排是为了让训练对手不断变化,避免只跟「现在的自己」下棋。论文报告,pρ 与 pσ 直接对局时 pρ 赢超过 80%;不带搜索地对 Pachi 下,pρ 赢 85%。1
价值网络 vθ 的结构与前两个共享大部分,区别在输出端:它最后接一个 256 个整流单元的全连接层和一个 tanh 单元,输出一个标量,估计的是当前局面下当前方的胜率。1
每一步在算什么:三个更新式与一次采样修正
四个组件各自只有一个更新式,形式都很短。
监督策略网络的训练是分类:拿人类棋手在某局面选的着法当标签,最大化它的对数似然。
式 (1) 里 s 是局面,a 是人类棋手选的那一手,pσ(a|s) 是网络给这个着点的概率。梯度上升的方向就是让「人类会走的那一手」的概率变大。论文用的批量是 16 个局面,初始步长 0.003、每 8000 万步减半,不用动量,在 50 块 GPU 上异步训练约 3 周、共 3.4 亿步。1
强化学习策略网络的目标换成了胜负本身:
式 (2) 里 z 是一局棋的最终结果,赢记 +1、输记 −1;t 是这局棋里的时间步。凡是通往胜利的着法,概率往上抬,通往失败的着法往下压。论文的实现里给这一项减去了一个基线以降低方差——第一次跑流水线时基线取 0,第二次改用价值网络的输出。这个网络用 50 块 GPU 训了 1 万批、每批 128 局,约一天。1
价值网络做的是回归,目标是把「这个局面的胜负」当一个数来拟合:
式 (3) 里 z 还是那局棋的最终结果,vθ(s) 是网络对当前局面的胜率估计,括号里是两者的差。整个更新就是把预测误差乘以输出对参数的导数,是标准的均方误差梯度下降。1
式 (3) 简单,数据怎么造才是这一步的难点,论文为此单独写了一段。直接拿完整对局里的每一个局面当样本,价值网络会去记整盘棋的结果,原因是同一局里相邻的两个局面只差一颗子,两者高度相关,回归标签却是同一个终局结果——网络学到的是「这盘棋谁赢」,而它该学的是「这个局面谁占优」。论文给出的证据是两个数字:这样训出来的网络在训练集上的均方误差是 0.19,在测试集上是 0.37。1
作者改成一局只取一个局面:先用监督策略网络走一段,随机插一手,再让强化学习策略网络走完,最后只把插曲之后的那个局面和终局结果收进数据集。三千万局各出一个局面,训练集与测试集上的均方误差变成 0.226 与 0.234,两个数靠在一起,说明过拟合被压下去了。1
论文还量了这笔买卖的性价比:单次调用 vθ 得到的局面评估精度,接近用强化学习策略网络跑一百次蒙特卡洛模拟的水平,而计算量少 1.5 万倍。这个数字是后面搜索里让价值网络承担叶子评估的依据。1
搜索怎么把四个组件装进同一棵树
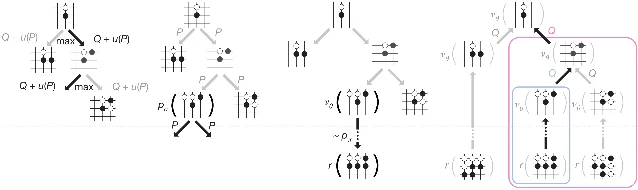
论文的搜索叫异步策略与价值蒙特卡洛树搜索(asynchronous policy and value MCTS,APV-MCTS),它的每一个节点对应一个局面,每一条边 (s,a) 对应一个着法,边上存五组量:策略网络给的先验概率 P(s,a)、网络估值与模拟各自累计的访问次数 Nv 与 Nr、两条路各自累计的价值 Wv 与 Wr,以及它们合成后的行动价值 Q(s,a)。1
一次模拟从根出发往下走,每一步都在当前局面上挑一条边:
式 (4) 里的 u 是搜索的探索项,它由两个量相乘。P(s,a) 是策略网络给这条边的先验:网络看好哪一手,哪一手在没被走过时就更值得试。分式让这个加成随访问次数衰减:同一条边被反复走过,N_r 变大,u 变小,搜索转而去看别的分支。两项合起来的效果是——先按先验找路,试得越多越依赖实测的 Q。论文在方法里把常数 c_puct 定在 5。1
走到叶子节点之后,这个局面被评估两次。一次交给价值网络,一次交给一次走到终局的模拟,两次结果按一个权重合成:
式 (5) 里 vθ(sL) 是价值网络对叶子的胜率估计,zL 是这次模拟走到终局后算出的胜负,λ 取 0.5。论文在正文里说明了为什么要两路一起用:价值网络近似的是「让强但慢得不可用的那个策略下棋」的结果,速度快的模拟则能把弱一些的走子策略下出的棋准确算完;两条路子补的东西不一样。1
回传时两条路各记各的。模拟的胜负在每一步更新 Nr 与 Wr;价值网络的输出在叶子评估完成后另走一遍回传,更新 Nv 与 Wv。行动价值本身也是混合的:
式 (6) 让 Q 里同时含「网络怎么看」和「模拟走下来怎么样」两种证据。多线程搜同一棵树时,论文用虚拟损失(n_vl=3)先假装这条边输了若干局,避免几个线程同时钻进同一条变化;一条边的模拟次数超过阈值(n_thr=40)时,它的后继局面才被加进树,先放一个占位的先验,等策略网络算完再替换成真正的 P。1
一局棋里的每一步都重复这套流程,搜索结束后取访问次数最多的那一手。论文给的理由是:访问次数是许多次模拟的平均结果,个别偏高的 Q 值不容易把它带偏。对手落子之后,树里对应的子树连同统计量一起保留,成为下一手的起点。论文还给了一个认输条件:当根节点上最大的 Q 低于 −0.8(大约对应不到 10% 的胜率)时,程序认输。1
这棵树里有一处容易被跳过的反常,论文自己写在了方法一节里:更强的策略网络放进搜索反而更差。pρ 与 pσ 直接对局时赢超过 80%,但 AlphaGo 里用的先验来自 pσ。作者给的解释是,人类棋手会给出一批有希望的下法,而策略梯度只朝单个最佳着法优化。同一段里还有一条方向相反的观察:用 pρ 的轨迹训出来的价值网络 vθ≈v^{pρ},比用 pσ 训出来的更好用。把两句放在一起,先验这一格要的是覆盖面,估值那一格要的是准确性。1
实验怎么读(一):Elo 是相对量,先看对手是谁
论文用内部循环赛评估棋力,成绩记成 Elo 分。单机版 AlphaGo 与其他围棋程序下了 495 局,赢 494 局,胜率 99.8%;为了加大难度,还让对手先摆四颗子,在这个条件下 AlphaGo 对 Crazy Stone 赢 77%、对 Zen 赢 86%、对 Pachi 赢 99%。分布式版 AlphaGo 与单机版对局,赢 77%,对其他程序全胜。1
这张表里最需要解释的是分母。同场竞技的七个程序,等级分从高到低是:单机 AlphaGo 2890、Crazy Stone 1929、Zen 1888、Pachi 1298、Fuego 1148、GnuGo 431,分布式 AlphaGo 是 3140。它们各自的硬件是:单机 AlphaGo 用 48 个 CPU 加 8 块 GPU,分布式版用 1202 个 CPU 加 176 块 GPU,Crazy Stone 用 32 个 CPU,Zen 用 8 个,Pachi 用 16 个,GnuGo 只用 1 个。所有程序每步最多 5 秒。1
Elo 是相对量,只有配上锚点才有意义。论文把整张表的刻度锚定在樊麾身上:取他在投稿日的 BayesElo 等级分 2908 作为基准点。论文自己给出了换算关系——230 分的差距对应 79% 的胜率,大致相当于 KGS 上的一个业余段位。按这个换算,单机 AlphaGo 与最强的外部程序 Crazy Stone 之间隔着 961 分,比一个段位宽得多。1
分布式版与单机版之间那 250 分同样要看清它换的是什么:CPU 从 48 加到 1202,GPU 从 8 加到 176,而 EDA Table 11 的交叉表显示分布式版对单机版的胜率是 77% [70; 82]。这 250 分的来源是算力的增加。1
看这张表还要带上时限口径。所有程序都是每步最多 5 秒,而对樊麾的十盘棋用的是更长时限:正式局每方 1 小时加三次 30 秒读秒,非正式局只有读秒。论文把十盘对局的结果并进内部锦标赛时,写下的是「忽略时限差异」这一句——提高樊麾那一格的精度,靠的是把他并进一张用别的时间控制测出来的表里。1
实验怎么读(二):拆掉哪个组件,棋力掉多少
论文另外做了一组只换组件的对照,同一台 48 CPU 加 8 GPU 的机器、每步 5 秒,把四个组件拆开重新组合。完整版(先验用 pσ、叶子用 vθ 与模拟按 λ=0.5 混合)是 2890 分。去掉模拟、只留价值网络(λ=0)是 2177 分。去掉价值网络、只留模拟(λ=1)是 2416 分。把策略网络也拿掉、先验全靠树上的占位值,三种组合分别是 2077、1655、1457 分。最后一行最值得单独记:只保留策略网络、完全不做搜索,是 1517 分。1
这组数字里有两处需要连起来读。第一处,混合评估比两路单独用都好:完整版对其他变体的胜率都在 95% 以上。第二处,只看价值网络、完全不要模拟的版本(2177 分)已经超过所有外部围棋程序——论文由此说,价值网络可以替代蒙特卡洛评估。把这两处放在一起,价值网络提供的是「贵但准」的评估,模拟提供的是「便宜但粗」的评估,两者的取舍就是 λ 在调的东西。1
网络规模那一组对照能解释一个常见的误读。同为单机版,128、192、256 个滤波器三档的测试准确率是 54.6%、55.4%、55.9%,直接对局(双方都不搜索)时对基准网络分别赢 36%、50%、67%——越大越强,符合直觉。但把 8 重对称的显式集成也加上,准确率提到 57.0%,这个版本进 AlphaGo 之后只赢 5%。原因写在表里:它一次前向要 55.3 毫秒,是 192 滤波器版本的十倍以上,同样 5 秒里它评估的局面数少得多。搜索里的强弱取决于「一次评估多准」乘上「这段时间能评估几次」。1
算力那组对照给出的是同一条账的另一半。单机上搜索线程从 1 加到 40,Elo 依次是 2203、2393、2564、2665、2778、2867、2890;线程数不变、GPU 从 8 块减到 1 块,Elo 掉到 2181。分布式版本线程从 12 加到 64(CPU 428 到 1920、GPU 64 到 280),Elo 是 2937、3079、3140、3168。1
三条趋势叠在一起,读法是:40 线程相对 32 线程只涨 23 分,加线程的边际收益已经很小;8 块 GPU 减到 1 块掉 709 分,网络评估这一侧的算力比搜索线程更值钱;分布式再加到 64 线程只多 28 分,更宽的扩展同样开始饱和。1
局限:这五盘棋和这张表各自证明了什么
对手的等级是第一条。论文的正式对局只有五盘,对手樊麾是欧洲冠军、职业二段,不在当时世界最顶尖的几位棋手之列。论文自己在正文里划的线是 full-sized game(19×19 完整棋盘、不让子)上的职业棋手,这个限定词要跟着结论一起读。1
样本量是第二条。十盘棋里正式对局五盘(5-0),非正式对局五盘(3-2),比赛条件由樊麾事先选定。五盘棋能支撑的结论强度有限,论文给出的区间是表里的 95% Agresti–Coull 置信区间。1
第三条关于摘要里那句最强的比较。论文说「不带任何前瞻搜索,神经网络就下到了当时最强 MCTS 程序的水平」——这句话里被比较的是其他围棋程序,它们的水平在表里是 431 到 1929 分。把这句话读成「网络单独下棋已经达到职业水平」,超出了它比较的对象。1
第四条关于价值网络的适用范围。vθ 拟合的是策略 pρ 自己走出来的那些局面上的价值(v^{pρ}(s)),论文把这一点写在目标里;换成另一套走子分布,这个估值不保证仍然准。搜索里 λ=0 那一行掉的 713 分,量的是「只用价值网络、不要模拟」在同一套策略下的结果。1
第五条关于先验的来源。pσ 的训练目标是预测 KGS 6 段到 9 段棋手的落子,这套先验的上限由人类棋谱的覆盖面决定;论文自己也把「用人类专家棋谱做监督学习」写成流水线的第一级。后来被替换掉的第一格,正是这里。1
第六条是算力账,它决定了这套方法能不能被复制。监督策略网络的训练用了约 3.4 亿个训练步、耗时约 3 周、跑在 50 块 GPU 上;强化学习策略网络是一天;价值网络是 5000 万批量、约一周,同样 50 块 GPU。搜索端单机要 48 个 CPU 加 8 块 GPU,拿 3140 分那一版要 1202 个 CPU 加 176 块 GPU。1
第七条关于理论。论文给出的是结构、超参和实验结果;搜索收敛性的依据来自 Kocsis 与 Szepesvári 2006 的 UCT,那篇被引用为第 12 条。1
影响与延伸:后来被换掉的是哪一格
把这篇论文拆成四个位置,看得更清楚:先验从哪里来(人类棋谱→pσ)、走子模拟用什么(线性棋形→pπ)、叶子怎么估值(价值网络与模拟按 λ 混合)、搜索怎么使用这些量(式 (4) 的 Q+u)。后面两年最有名的两篇工作,换的都是前两格。
AlphaGo Zero(Nature 550:354–359,2017 年 10 月,DOI 10.1038/nature24270)把监督学习这一整级去掉了。论文摘要写明它「只靠强化学习,不使用人类数据、指导或棋规之外的知识」,一个网络同时预测自己的落子选择和自己的胜负;从 tabula rasa 出发的它,对本文这个已经赢过冠军的 AlphaGo 取得 100 比 0。先验那一格的答案因此从人类棋谱换成了它自己走过的棋。45
AlphaZero(Science 362(6419):1140–1144,2018 年 12 月,DOI 10.1126/science.aar6404;预印本 arXiv:1712.01815,2017 年 12 月 5 日)换掉的是棋盘本身带来的先验。它从随机对局开始,除规则之外不给任何领域知识,在 24 小时内就在国际象棋、将棋和围棋上都达到超人类水平,并分别击败了这三个棋类各自的世界冠军程序。本文里那 48 张手工特征平面和「围棋棋盘」这个前提,在这一格上被整体替换。67
读完留下的判断维度
一,先给每一个数字找到它的分母。99.8% 的分母是其他围棋程序,5-0 的分母是一位职业二段,2890 和 3140 是同一种方法在两套硬件上的分数。三个数字混用,就会把「赢过程序」读成「赢过所有人类」。
二,在搜索系统里,「哪个组件单独更强」和「哪个组件更适合放进搜索」是两个问题。pρ 直接对局赢 pσ 超过 80%,进搜索做先验的却是 pσ。
三,先验与估值要的东西方向相反。先验需要覆盖面,所以用会给出多种下法的 pσ;估值需要准确,所以用优化过胜负的 pρ 轨迹去训价值网络。
四,训练数据里的相关性会决定模型学到什么。同一局的相邻局面共享一个终局标签,价值网络于是记住了这盘棋的结果;改成每局只取一个局面,训练误差 0.226 与测试误差 0.234 才靠到一起。
五,算力账要落到具体那一段。8 块 GPU 减到 1 块掉 709 分,40 个搜索线程加满也只比 32 个多 23 分;在同一篇论文里,这两处的边际收益差了两个数量级。
References
- 1
- 2PubMed 收录记录:Nature 2016 Jan 28;529(7587):484-9
pubmed.ncbi.nlm.nih.gov
- 3
- 4
- 5
- 6
- 7
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.