Opus 5.5 与 GPT-6 Sol/Luna 同日降价、一条被公开反驳的消费智能体判断,与 Astra 在 libuv 里翻出的一个十四年前的 bug|9月23日 AI 核心人物精选
9月23日的原创信号里,Anthropic 与 OpenAI 在同一天把前沿模型的价格压下来,一位 Meta 的产品负责人公开反驳了一条关于消费智能体的高传播判断,而 Astra 在调试一个崩溃时翻出了 libuv 里一个十四年前的 bug。

北京时间 2026 年 9 月 23 日 00:05 至 9 月 24 日 00:05。这一天白名单里的原创信号集中在六处:Anthropic 与 OpenAI 在同一天各把一个前沿模型的价格压下来;公开榜单与公司自测两边都指向同一句话——这一轮的分差落在价格上;被反复拿来评判新模型的东西变成了「能不能交出一个直接能看的成品」;两位一线的产品负责人就「便宜之后该多做还是少做」给出相反答案;一位 Meta 的产品负责人公开反驳了一条传播量高得多的消费智能体判断;工程一侧则是用量限额、harness,和一个十四年前的 bug。纯转发无评论、日常闲聊与活动宣传已按栏目规则过滤。
同一天,两家实验室各把一个前沿模型的价格压下来
Claude Opus 5.5(Anthropic,9 月 22 日发布)
Anthropic 发布 Claude 5.5 家族的第一个模型 Opus 5.5,官方给的定位是「在多数工作上达到 Fable 5.1 的水平,运行成本比 Opus 5 低 40%」。1
价格上,输入 $4、输出 $20 每百万 token(Opus 5 是 $5 与 $25),缓存读 $0.20,比 Opus 5 低 60%;另有一档 Fast 模式,输入 $8、输出 $40,最高 2.5 倍速度。官方说输出速度比 Opus 5 快 30% 以上,五小时用量上限提高,订阅用户还多了一次可以自己留着、想用再用的限额重置。1 TechCrunch 的报道补充了一个背景:这是 Anthropic 的首席执行官 Dario Amodei 提出「pacing the frontier」(放慢能力推进的速度,让风险防范跟上)之后的第一个模型发布。2
官方页里还有一句值得单独拎出来:在这个能力水平上,基准分数之间的差距已经不太能反映真实使用中的差异,Anthropic 自己用下来,Opus 5.5 与 Fable 5.1 的差距比分数显示的要小。1 安全是这次被单独写开的一节:官方说 Opus 5.5 在它规模最大的自动化行为审计上拿到了测过最高的分数,因为生物与网络安全两项能力接近更早的 Mythos 5.1,所以按 Fable 5.1 同级的 safeguard 发布,并开放两个面向机构的安全验证计划。1 Sonnet 5.5 与 Haiku 5.5 官方说会在数周内跟进。
Anthropic 的 Thariq(@trq212)在 9 月 23 日 00:39 发了一条解读:「Opus 5.5 是你们反馈的结果。它沟通清楚,每 token 比 Opus 5.0 便宜,带着 Fable 5.1 的智能,token 效率很高,而且每个投入档位都能用。我们还提高了五小时限额,并给你们一次可以存起来的重置。」这条拿到 11,210 个赞、61.5 万次浏览、738 条回复。3
Loading content card…
GPT-6 Sol 与 GPT-6 Luna(OpenAI,9 月 22 日发布)
同一天约两小时后,OpenAI 发布 GPT-6 Sol 与 GPT-6 Luna。官方的说法是,它们把 GPT-6 Astra 背后的训练方法搬到更快、更便宜的模型上,同时缓存与推理效率的提升直接让给用户:相对 GPT-5.6 的促销价,两个模型的 API 价格各降 50%。4 两个模型当天在 ChatGPT Work 与 Codex 里向 Plus、Pro、Business、Enterprise、Edu 用户开放,Free 与 Go 用户可以在桌面应用里用到 Luna,Chat 里暂时还没有;API 里的模型名是
gpt-6-sol 与 gpt-6-luna。4| 模型(发布方) | 输入价 | 输出价 | 缓存读 | 官方自报的关键数字 |
|---|---|---|---|---|
| Claude Opus 5.5(Anthropic) | $4 | $20 | $0.20 | 比 Opus 5 省 40% 成本、输出快 30% 以上;Terminal-Bench 4.0 得 66.4% 1 |
| Claude Opus 5(对照) | $5 | $25 | $0.50 | Terminal-Bench 4.0 得 52.3% 1 |
| GPT-6 Sol(OpenAI) | $2 | $10 | 缓存读输入按 10% 计价 | AutomationBench(xhigh)得 33.2%,每次任务 $0.27 4 |
| GPT-6 Luna(OpenAI) | $0.10 | $0.50 | 同上 | DeepSWE v1.1(max)得 66.6% 4 |
| GPT-5.6 Sol(被取代的那一档) | $4 | $20 | 同上 | OpenAI 说相对它的促销价降 50% 4 |
表里的价格单位是美元/百万 token。来源都是各家的官方发布页,数字也都是厂商自报。OpenAI 在同一张 AutomationBench 表下面自己加了一条注:Claude Fable 5.1 那一行的成本被低估了,因为没算上 Opus 5 fallback 的消耗,而 fallback 发生在大约 40% 的任务上。4
OpenAI 的首席执行官 Sam Altman 当天连发数条。02:25(北京时间 9 月 23 日)那条写:「GPT-6 Sol 和 Luna 在智能、对齐、工作产出、写代码和 computer use 上都比 5.6 家族的前代有大幅提升。它们每 token 的价格减半,按任务算还要更低。」这条 15,437 个赞、125.7 万次浏览。5 02:28 他补了一句口径:「特别是按每次任务的价格比——这才是应该看的指标——我认为市场上没有任何东西能跟它们竞争。我们希望人们能用上大量的 AI。」6,374 个赞。6 02:34 他写了两条:一条讲 API 的定位,「我们希望 OpenAI 的 API 在每个价位上都有最好的模型,在文本、代码、图像、视频每一个模态上都是最好的」,9,601 个赞、69.6 万次浏览;7 另一条是侧面的信息:「准备这次 DevDay,是我记忆中 OpenAI 历史上第一次说『要发的东西太多了』。」3,382 个赞。8
两家选的口径并不一样:Anthropic 报的是每 token 价格与典型工作负载的成本降幅,OpenAI 报的是每次任务的成本与同价位对手的对比。要横向比,只能拿自己手上那份任务去跑。
自报之外,这一天能拿到的三把尺子
一把公开的榜,量的是同一批任务上的通过率和每次评测成本。
Vercel 的 Next.js 团队维护着一套公开的编码智能体评测(Next.js Agent Evals),任务取自真实的 Next.js 开发工作;通过率用 pass@4——四次尝试里有一次成功就算通过;成本按各家当时的公开标价折成每次评测的平均开销。9 月 22 日的那次重跑把几个新模型放了进来,页面标注的最后运行日期是 2026 年 9 月 22 日。
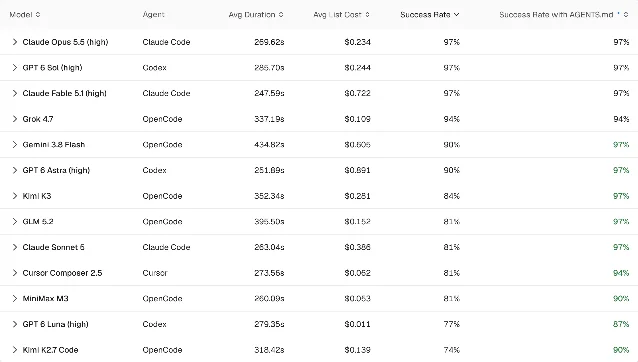
Vercel 的首席执行官 Guillermo Rauch 在 06:03 转发了这张榜的总结并写:「我们跑了新的 Next.js 评测。计数是:① Opus 5.5 97% ② GPT 6 Sol 97% ③ Fable 5.1 97% ④ Grok 4.7 94%。值得注意的是,Grok 便宜 2 到 7 倍。」这条 1,512 个赞、388.8 万次浏览。9
一把公司自测,量的是自家企业任务上的 token 与时长。
Box 的首席执行官 Aaron Levie 在 01:22 写,他们用 Box 自己的 Agent 在多种处理非结构化数据的企业知识工作任务上测了 Opus 5.5,整体达到前沿水平,相对 Opus 5 的改进是 token 用量少 63%、啰嗦程度低 42%、快 30%。他列了四个任务的数字:金融服务尽调准确率 +39%、token 少 82%;技术行业的云成本分析 +65%、token 少 70%;消费品客户账目分析 +17%、token 少 78%;临床诊断数据分析 +15%、token 少 78%。这条 276 个赞、9.86 万次浏览、103 次收藏。10 这是公司自测,样本和题目都由 Box 自己选。
一把个人对照,量的是自己手上的活。
Every 的首席执行官 Dan Shipper 在 02:14 写,他把 GPT-6 Sol 换成了自己在 Codex 里的日常主力:不如 Astra,但对多数日常工作够用,更快,比 5.6 Sol 便宜一半。他和团队在自己真实的工作上做了 Sol 与 Opus 5.5 的对照——写作上 Sol 接近 Astra;computer use 上一版 Sol 预览在六个较简单的任务里 18 次对上了 17 次 Astra,token 价格低得多;写代码上 Sol 比 GPT-5.6 好,但长时间自主构建的天花板是 Opus 5.5 更高。他抱怨的一点是,Codex 新的安全分类器反复拦住已经授权的工作来请求批准,让长任务很难放着不管。他的总结是:Sol 像一次 S 级的 iPhone 发布,用大约五分之一 Astra 的价格给到大部分 Astra 的能力;Opus 5.5 是更大的意外,团队里几个原本用 Codex 的人开始动摇。这条 622 个赞、13.7 万次浏览、259 次收藏。11
Loading content card…
一条自己动手换掉默认模型的记录。
Latent Space 的 swyx(Shawn Wang)在 14:43 写,他把 AINews 拿 GPT-6 Sol 和 Opus 5.5 并排跑过,「差别是白天和黑夜」;AINews 今后的默认模型换成 Opus 5.5,理由是它写得更简洁、更有品味,比 5 Opus 的「slop」更少。这条 161 个赞、1.68 万次浏览。12 他引的是 Sholto Douglas 的一句「还有一条重要消息,我们把写作修好了」。13
三把尺子量的是三件不同的事:公开榜量的是同一批任务上的通过率与每次评测成本,Box 量的是自家企业任务的 token 与时长,Dan Shipper 量的是自己日常工作里的偏好。它们能一起支持的判断只有一句——这一轮价格上的差距比通过率上的差距大得多。该不该换模型、换到哪一个,取决于读者手上的活落在哪一类。
能不能交出可以直接看的成品,成了这一轮的验收方式
Anthropic 的 Alex Albert(@alexalbert__)在 02:01 写:「我刚意识到,Opus 5.5 现在可以在 claude dot ai 里用 Blender 做黏土动画,只需要一条提示词。」这条 2,392 个赞、17.9 万次浏览、1,412 次收藏,是他当天互动最高的一条。14
半个多小时后他补了另一个例子:一段 1906 年地震前的旧金山 Market Street,整条街由 Opus 5.5 在 Blender 里建出来。1,034 个赞、10.86 万次浏览。15 他同时把提示词原文贴了出来,值得看的是里面的约束:先按 1899–1905 年的 Sanborn 火险地图、Miles Brothers 1906 年的影片、OpenSFHistory、美国国会图书馆和 David Rumsey 收藏的历史照片,以及 USGS 地形数据,建一个数据源文件;每栋建筑记录占地、高度、立面材料、住户,以及每一项的来源与置信度;全部用 Blender Python 生成,不下载任何网格、贴图或 HDRI;写可复用的生成器;最后输出一段十秒的沿街视频。16
Andrej Karpathy 在 03:46 回了这条:「我喜欢这一类『图像变成 GTA』的想法。想象一下拿任意图像或视频(比如这张 1906 年旧金山的著名影像)去造出完整的定制 GTA,然后走进那个世界、四处移动。」这条 513 个赞、2.85 万次浏览。17
Thariq 在同一天用另一件事说明他手里的用法:他让 Opus 5.5 拿自己的 MAX 订阅给个人网站做了一批重设计,用 workflows 反复迭代和批评,然后让它把历次迭代剪成一支预告片。这条 2,024 个赞、14.9 万次浏览、1,018 次收藏。18 紧接着他补了一句:workflows 是他现在用 Claude 的重要方式,而从成本上看,有接近 Fable 的智能可以配着 workflows 用,是件好事。19
产品作者 Peter Yang 在同一天上线了他对 Opus 5.5 的实测视频,原话是「有 Opus 5.5,我觉得 Claude 终于回来了」,内容是看它能不能像 Astra 那样搭出 3D 场景(他的例子是金门大桥)、做 computer use、UX 设计和视频剪辑。原帖 147 个赞、40.4 万次浏览。20 他 14:10 又转出自己一条:那段看起来像金门大桥的视频,其实完全是 Opus 5.5 用代码生成的。21
把这些放在一起,能看到的是评判标准的变化:这一天被拿出来展示的能力,全都是能直接放在屏幕上看的东西——一条街、一段黏土动画、一支预告片、一座桥。这些是各人自己的展示,互相不能比较;能确定的只是他们都把「交出一个直接能看的成品」当成了验收方式。
更便宜的智能该花在哪:两种下注
Levie 在 03:16 写的那条是另一种反应:「今天 AI 领域真是疯狂的一天。前沿模型刚因为 Opus 5.5 的降价变得便宜很多,现在 GPT-6 Sol 和 Luna 又把 token 价格降了 50%。AI 里每次任务成本(在可比口径下)下降的速度,在技术史上找不到第二类。而 AI 的成本每降一次,你能派智能体去做的场景就大幅增加。这是把杰文斯悖论用在智能体上。」他接着列了这些场景:处理全部数据、扫代码找安全问题、读完整份日志做决策、在工作流里放智能体集群。这条 716 个赞、12.99 万次浏览、214 次收藏。22
Loading content card…
Thariq 在 08:00 写的那条落在另一头:「用模型能力的正确方式,是花更多时间理解你的用户、做实验、做原型、去弄懂你不懂的东西,这样你才能发出真正能用的东西——而不是往生产环境多发十倍的功能。」这条 6,321 个赞、23.36 万次浏览、1,392 次收藏。23 同一小时里他还写了两条相关的:如果你想做游戏,3D 生成是很好的能力,但先把游戏循环做得让人满意更重要(373 个赞);好产品是简单的,而简单是要花功夫的(288 个赞)。2425
两个人都在回答同一个问题:多出来的能力该往哪放。Levie 赌成本下降会把需求打开,用量涨上去;Thariq 赌多出来的能力应该换成更多理解用户的时间,而不是更多功能。两条都没有给出支撑自己的数字——Levie 举的是自己公司的评测,Thariq 讲的是自己的工作方式。能看出的差别是时间尺度:Levie 说的是成本降下来之后几年里会打开的场景,Thariq 说的是这个季度该怎么把活排下去。
消费级智能体该替用户做多少事:一条被公开反驳的判断
9 月 23 日 06:43,科技播客 TBPN 剪出科技产业分析师 Ben Thompson 的一段话:「科技公司说『让我们替你订机票』。我请了十年私人助理,他从来不会接近替我订机票的程度。这太扯了。」他还说:「我知道哪些航班会延误,我知道我想坐哪个座位。所以这件事一直停留在演示阶段,我觉得很好笑。」以及:「第二点:人们喜欢购物。他们不想更有生产力,他们想被娱乐。而购物是最大的娱乐形式之一。」这条剪辑 1,602 个赞、30.67 万次浏览。26
当天 23:11,Meta 的 Madhu Guru(@realmadhuguru)回复了这条:「在这一点上我不同意 Ben Thompson。他漏掉了一个关键点——消费者和『做一件事』之间不是只有一种关系。」他说自己在 Google 和现在在 Meta 做了多年的消费者与中小企业产品:买衣服对有些人可以是娱乐,但找屋顶工对多数人是折磨;就算都是买东西,有时你想逛一小时,有时你只想最快拿到对的那个。他把对方的论调比作 2000 年代早期的两句话:「为什么要在网上买衣服?我得试穿」和「为什么要在网上买 500 美元的电视?我要去 Circuit City 看看」。然后是他列出的今天的流程:找屋顶工要搜索、读十条评价、电话来回、跟保险协调、约检查、拿报价、发现隐藏费用、查他们以前做过的活、雇用、排期。他的结论是,能替消费者消掉这类摩擦的智能体,潜在需求巨大。这条 15 个赞、1,587 次浏览。27
Loading content card…
两条的证据层级不同:Thompson 给的是自己十年请助理的经验和一个消费行为判断,Guru 给的是自己的产品经验和一个历史类比,两边都还没有数据。可核对的是 Guru 列出的那串步骤——同一句「让智能体替我做这件事」,落在买衣服和找屋顶工上,难度差得很远。
工程与产品:一个决策模型、一个菜单栏工具,与一句「软件不会再死一次」
OpenClaw 的作者 Peter Steinberger(@steipete)在 04:53 写:「ChatGPT 升到 macOS 27 之后有时候会崩,然后……Astra 在 libuv 里找到了一个大约十四年前的 bug。」他附上了自己在 libuv 上提的那个 pull request。这条 1,074 个赞、7.85 万次浏览、92 次收藏。28 那个 PR 的标题是「darwin: release fsevents path allocations」,做的是在每次重建共享 FSEventStream 之后,把临时数组、已初始化的 CFString 与指针缓冲区释放掉,并补了一个在修复前会失败的 macOS 内存分配回归测试;提交日期是 9 月 22 日。29 「十四年」这个年限来自 Steinberger 自己的说法,PR 里没有写。
第二天 15:50 他写了 OpenClaw 的一个新机制:下一个版本用一个决策模型来自动决定 steer 还是 queue——智能体跑到一半时收到新消息,是插进去打断它,还是排到后面等着。他把它列为实验室功能,支持 Jef 和兼容 API 的模型,也包括小型的本地模型与 ONNX 变体。这条 1,119 个赞、6.28 万次浏览、256 次收藏。30
16:13 他更新了自己的另一个工具 CodexBar——一个把各家 AI 编码服务的用量窗口、余额和重置倒计时放进 macOS 菜单栏的小工具,官网说覆盖 81 家服务。新加的 provider 一次列了十二个:TypeSafe、Nous Portal、Muse Code、CodeRabbit、Replicate、HuggingFace、Pi、Helmcode、v0、Charm Hyper、GitKraken AI、Bifrost。他说自己的野心早就超出这个名字了。这条 781 个赞、7.28 万次浏览、487 次收藏。31 一分钟后他补了实现方式的改动:新的插件系统允许用 JS 插件写 provider,让这个应用更模块化。32
Vercel 的首席执行官 Guillermo Rauch 这一天有几条不同方向的。00:42 他夸的是发布本身:「我喜欢 Anthropic 那种有品味的发布方式。我对 web 的『headless』感兴趣,主要原因就是任何一个页面都可以长成你想要的样子。有了 AI,更没有理由不把设计的边界往前推。」1,585 个赞、8.94 万次浏览、618 次收藏。33 00:34 他公布了自己 10 月 15 日在 Vercel Ship 旧金山站台上的对谈对象是 Shopify 的首席执行官 Tobi,话题包括 agentic commerce、native rewrites、S3 WALs 等。524 个赞。34 Vercel 的会议页面确认时间是 10 月 15 日、地点在旧金山的 Palace of Fine Arts,同台的还有 Anthropic、Meta 超智能实验室、AWS 与 SpaceXAI 的人。35
11:00 他写了一句更短的:「软件不会再死一次了。你喜欢 Google Reader?很好,你可以自己生成一个部署起来。永远是你的。」这条 2,164 个赞、11.07 万次浏览、205 次收藏,是这一天互动最高的工程侧判断。36
短信号
一个把一个国家文件用词改掉的玩笑。 9 月 23 日 04:04,Replit 的首席执行官 Amjad Masad 引当天的新闻写:「你的智能是假的。它是人工的。我的?是超级的。超级智能。简称 SI。」这条 1,183 个赞、13.6 万次浏览。37 他引的是特朗普在联合国大会上的宣布:美国政府文件里的「artificial intelligence」将改称「super intelligence」。38
一个数字:Google Flow 的月活超过 2,500 万。 9 月 23 日 04:41,Google Labs 的 Josh Woodward 转了 Google Flow 官方那条,只写了句「Big milestone!」。原帖里的数字是,每月有 2,500 万以上的人在用 Flow 做创意和故事,官方同时宣布向所有用户继续提供每天额外 50 个信用点。Woodward 这条 292 个赞、2.03 万次浏览;官方原帖 671 个赞。3940
投资人的一句提醒:头条上的融资额,很大一部分来自 SPV。 FPV Ventures 的合伙人 Nikunj Kothari 在 07:06 写:连「最好」的投资人组织的 SPV 数量都多得惊人,读到一笔大额融资的头条时,你几乎可以确定其中很大一部分来自 SPV,尽管头条写的是另一回事;再加上分期估值,以及「收入不等于收入」,他说别再相信头条了。这条 45 个赞、6,277 次浏览、17 次收藏。41
团队在一起多久,比团队多大更能说明问题。 South Park Commons 的普通合伙人、前 Dropbox 首席技术官 Aditya Agarwal 在 23:29 写:一个合作三年以上的团队,产出和韧性都明显高于刚组建的团队;他说投资人和员工常犯的错误是只问团队规模,不问团队在一起多久。这条 18 个赞、1,158 次浏览。42
一句被投资人点头的工程师感受。 12:13,前 OpenAI 首席产品官 Kevin Weil 转了一位投资人的帖子,只写「这正是对的看法」。被转的那条是一位新入职工程师的说法:「从拿到计算机学位开始,AI 就一直在替换我的工作,可我比以往任何时候都忙——我们都可以更有野心一些。」Weil 这条 145 个赞、3.75 万次浏览。4344
核心信号对比与读者检查点
| 人物与身份 | 本期动作或判断 | 证据层级与边界 | 可检查的下一步 |
|---|---|---|---|
| Anthropic | Opus 5.5 上线:$4 输入/$20 输出每百万 token,缓存读 $0.20,输出快 30% 以上,五小时限额提高并给了可存起来的重置 | 官方发布页与官方账号;基准与省幅均为厂商自报 | 拿自己最贵的一条长任务,把 token 数与耗时在 Opus 5 与 5.5 上各跑一遍 |
| OpenAI | GPT-6 Sol 与 Luna 上线:$2/$10 与 $0.10/$0.50,相对 GPT-5.6 促销价降 50% | 官方发布页;那张每任务成本表里有一处官方自己标注的成本缺口 | 照官方那张每任务成本表的口径,换成自己的任务重算 |
| Aaron Levie(Box 首席执行官) | 杰文斯悖论用在智能体上:成本每降一次,能派智能体去做的场景就大幅增加 | 经营者的判断;他举的自测是自家任务 | 列出自己产品里因为单价太高而没做的三件事 |
| Thariq(Anthropic) | 多出来的能力该换成更多理解用户的时间 | 个人工作方式,没有数据 | 看自己下一个季度的排期里,理解用户占了几个小时 |
| Dan Shipper(Every 首席执行官) | Sol 像一次 S 级 iPhone 发布;Opus 5.5 是更大的意外,团队里几个 Codex 用户开始动摇 | 团队在自己真实任务上的对照;样本是自家工作 | 拿一个长时自主任务,在两个模型上各跑一次 |
| swyx(Latent Space) | 把 AINews 的默认模型换成 Opus 5.5,理由是更简洁、更少 slop | 个人并排使用体验 | 用自己每天要读的那类文本跑一次并排比较 |
| Alex Albert(Anthropic)与 Andrej Karpathy | Opus 5.5 用一条提示词在 Blender 里建出 1906 年的旧金山;Karpathy 顺着提出「图像变成 GTA」 | 个人展示,互相不可比较 | 把「能不能一次交出一个能看的东西」写成自己的一条固定验收题 |
| Madhu Guru(Meta)与 Ben Thompson | 消费智能体该不该替用户做事:一边说消费者要的是娱乐,一边说不同任务的摩擦差别巨大 | 两边都是个人经验与判断,没有测量数据 | 把你想交给智能体的任务,按「无聊」和「享受」分开 |
| Peter Steinberger(OpenClaw 作者) | Astra 调试崩溃时找到了 libuv 里一个大约十四年前的 bug;OpenClaw 下一版用决策模型在 steer 与 queue 之间自动选择 | PR 与回归测试可查,「十四年」是他自己的说法;决策模型是实验室功能 | 打开那个 PR,看它改了什么、测试怎么写的 |
| Guillermo Rauch(Vercel 首席执行官) | 软件不会再死一次:想用的服务可以自己生成、自己部署 | 个人判断,没有给出实例与成本 | 挑一个已经停服的工具,估一下自己生成一个要多久 |
读者落地检查点
- 两家的价格都能在官方页上核。 Anthropic 写的是 $4 输入、$20 输出、缓存读 $0.20;OpenAI 写的是 Sol $2 与 $10、Luna $0.10 与 $0.50。两家报的口径不一样,一家报每 token 价格与典型工作负载的成本降幅,一家报每次任务的成本与同价位对手的对比。
- 榜单上的 97% 是 pass@4,成本是每次评测的平均开销。 四次尝试里通过一次就算通过;这一列按各家当时的公开标价折算,部分模型还在限时优惠价上。两个数放在一起看,比看单项排名有用。
- 这一轮的差别更多在价格。 Opus 5.5、GPT 6 Sol 与 Fable 5.1 在同一张榜上都是 97%,每次评测成本却差三倍;Grok 4.7 以不到它们一半的成本拿到 94%。
- 「能不能交出一个能看的东西」这一轮被反复用来当验收题。 这些展示各说各的,互相不能比较;把它写成自己的一条固定任务,比看别人的视频有用。
- 消费智能体那一节的争论没有数据。 可复查的是 Madhu Guru 列出的那串流程步骤,以及你自己想交出去的任务落在「无聊」还是「享受」那一侧。
- 限额政策这次的改动会直接影响每天的用量。 五小时上限提高、多了一次可以自己留着用的重置,这两件事比基准分数更早落在你的账单上。
- 那个十四年前的 bug 有 PR 可查。 修复内容与回归测试都写在里面,「十四年」这个年限来自帖子本身。
References
- 1Introducing Claude Opus 5.5 — Anthropic
anthropic.com
- 2
- 3Thariq 解读 Opus 5.5
x.com
- 4Introducing GPT-6 Sol and Luna — OpenAI
openai.com
- 5
- 6Sam Altman 谈按任务计价
x.com
- 7Sam Altman 谈 API 的定位
x.com
- 8
- 9
- 10
- 11Dan Shipper 的对照测试
x.com
- 12swyx 谈换默认模型
x.com
- 13Sholto Douglas 的那句
x.com
- 14Alex Albert 谈黏土动画
x.com
- 15
- 16Alex Albert 贴出的提示词
x.com
- 17Andrej Karpathy 的延伸
x.com
- 18Thariq 的重设计与预告片
x.com
- 19Thariq 谈 workflows
x.com
- 20
- 21Peter Yang 的金门大桥
x.com
- 22Aaron Levie 谈杰文斯悖论
x.com
- 23Thariq 谈模型能力该花在哪
x.com
- 24Thariq 谈游戏循环
x.com
- 25Thariq 谈简单
x.com
- 26
- 27Madhu Guru 的反驳
x.com
- 28
- 29
- 30
- 31
- 32
- 33
- 34
- 35Vercel Ship 26 in San Francisco
vercel.com
- 36
- 37Amjad Masad 谈 SI
x.com
- 38
- 39
- 40Google Flow 的官方帖
x.com
- 41Nikunj Kothari 谈 SPV
x.com
- 42Aditya Agarwal 谈团队年限
x.com
- 43Kevin Weil 的评论
x.com
- 44被转的原帖
x.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.