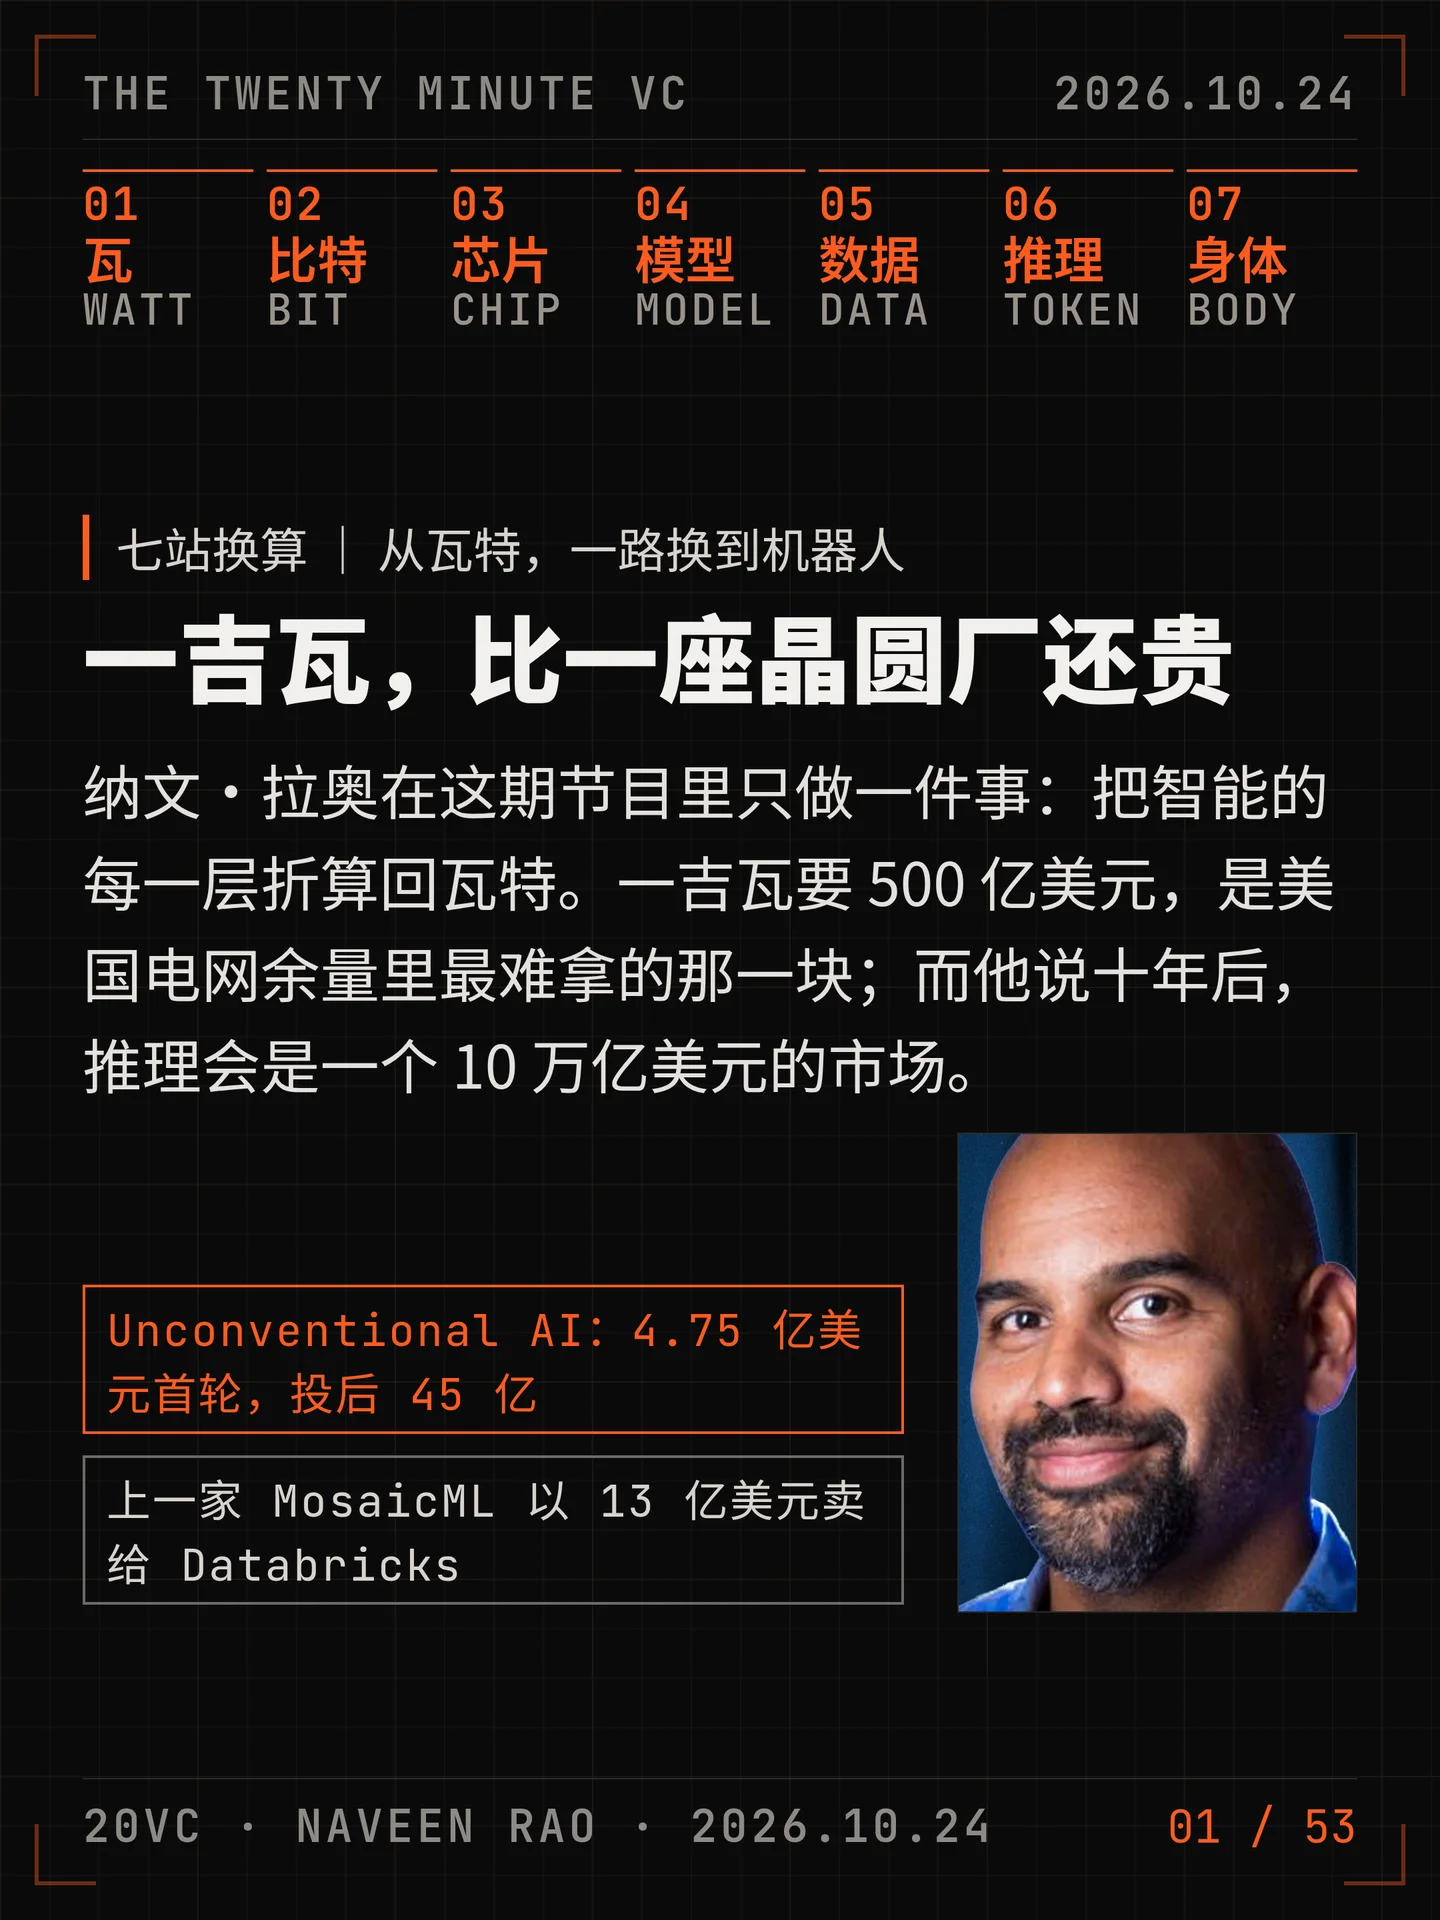

纳文·拉奥(Unconventional AI)把 AI 的每一层折算回瓦特:一吉瓦要 500 亿美元,十年后推理市场 10 万亿,而机器人会比编程 agent 大 100 倍。这一期来自 20VC,2026 年 10 月 24 日发布,全长 1 小时 09 分 23 秒。
一、要点整理
能源:我们用的是电网余量,不是新电。 他引用工业界的口径,建一吉瓦约 500 亿美元,比一座先进晶圆厂(200 亿到 300 亿美元)还贵。美国电网平均输出约 900 吉瓦、峰值 1.2 到 1.3 太瓦,这几年数据中心的电主要来自这段没被用满的冗余;用完就只能等新电厂。他判断中国总装机在 2023 年超过美国,之前二十年建设速度是美国的六倍1。
债务与需求:这是一次小波动。 面对 CoreWeave 引发的担忧,他的判据不是估值而是需求——如果能治愈癌症都有人抢着买,那么一台能做任何事的机器需求是无限的。他也承认已经出现两级电价:表后交易每千瓦时付的钱远高于电网电价。
算力:物理层的红利吃完了。 摩尔定律与登纳德缩放本质是物理;他说最近几代 GPU 已经看不到物理层的能效提升,过去几代的收益来自把数据类型从 32 位砍到 16、8、4 位。再往上是模型层的局部性与数据搬运——这是他希望两年前就知道的事。
芯片:专业化不可逆,硬件不会商品化。 图灵最初想造的就是一台智能机器,GPU 已经走在为负载造架构的路上。他的论证是一套演化论:宇宙是对抗的,对抗的燃料是智能,智能来自能量,能量换成智能靠硬件,所以需求没有上限。他回忆 2014 年黄仁勋在 GTC 上押注 AI,同一年他创办 Nervana。
模型与验证:问题从生产移到了验证。 AI 让一个原本要两周的噪声传播问题一小时就能想完,所以一家公司可以同时做更多层。但产物太多、验证跟不上,他自己把它叫作「AI 垃圾」问题。他补了一句:拥有验证不等于拥有生产,你还要拥有规格。至于把决定交给代理,他认为今天还不到时候——外科医生的七年训练,难点是判断力,不是缝针。
数据:会专业化,不会大宗化。 数据一开始是大宗商品(按量收集观测),一旦开始构造高质量数据集就有价值。他认为大模型公司的能力主要来自数据整理与损失函数——从预训练走到中训练——而不是模型结构本身。RL 更贵但还在前进,因为它提供可验证的奖励,能覆盖任务长尾。他还说大厂不敢冒大风险,深创新更像药物研发:创业公司冒险,大公司收购。
Transformer 之后与商品化。 他不认为 Transformer 是终点:现在用「采样多条轨迹再挑一条」实现推理,本质是检索,效率极低,大脑不是这么工作的。哪一层会商品化?能源已经是,一部分智能也是——六个月前的开源模型依然好用。但商品化不等于坏:西红柿也是大宗商品,我们还是吃它。
软件投资人:不。 哈里问这一代投资人够不够格做硬件投资,他只答了一个词。理由是 SaaS 不再产生毛利:2010 年之后的「糖分上头」来自无摩擦的交付,现在应用落在智能层,价值往模型与硬件两端跑。新的形态是「交付结果、人机混合」,Harvey 是第一个样本。自建智能只属于有规模的人,长尾要开箱即用。他也不认为工资预算会大幅转成技术预算,因为验证那道坎还在。
推理与机器人。 他判断十年内推理市场到 10 万亿美元、AI 模型本身几年内就是万亿市场;效率提升一个数量级会放大市场而不是缩小它。三年后 token 八成走开源、花费大致五五开——像手机市场,两成份额、八成利润。机器人比 agentic coding 大 100 倍:今天的工业机器人只是死记硬背,真正的物理问题求解还没开始;原型两到三年、市场五到七年。
快问快答。 过去 12 个月他改变了对「衡量进展的指标」的看法:深技术问题不需要市场验证,市场明明在那里,该验证的是技术进度。资源无约束就去自己建厂,一路走到硅锭怎么切。最被高估的是「把现成流程自动化」,以及去掉模型厂商之后的编程 agent 市场。最好的投资人会议是 2014 年与史蒂夫·尤尔韦松——两个人一坐下就在聊数值表示。
二、口径与核对
能核到官方文件的,是他两家公司的去向和这一轮的融资:MosaicML 在 2023 年被 Databricks 以 13 亿美元收购,Unconventional AI 在 2025 年 12 月完成 4.75 亿美元首轮、投后 45 亿美元,a16z 与 Lightspeed 联合领投,Sequoia、Lux、DCVC、Databricks 与贝索斯参投23。公司的技术主张与「生物量级能效」这句口号也写在投资方公告里;Un-0 在 ImageNet 64×64 上做到 FID 6.74,稀疏化最高剪掉 98.4% 的连接4。
只有节目里说的,是那一组能源数字:500 亿美元一吉瓦、900 吉瓦与 1.3 太瓦、中国 2023 年超越、一年 10 吉瓦的上限、两级电价的具体价差。这些是他对话中给出的数字,没有逐条附出处,所以按「节目中的说法」看。
属于判断与预测的,是 10 万亿美元推理市场、机器人五到七年成市场、开源八成 token、两成份额八成利润。作为对照,公开的推理市场研究把 2025 年的规模放在 1,000–1,100 亿美元量级5,年限与口径都比「十年十万亿」窄得多。
三、逐句全文翻译
01 · 开场与预告(00:00–04:36)
纳文:接下来这几年,我们很快就要把电用光了。这是一次小波动,不是哪种泡沫正在破掉。我们不把模型当成神圣不可动的东西。我们是以能量为先来思考的。对我来说,智能的需求是无限的。我确实认为我们会进入一个后 Transformer 的世界。我不认为 Transformer 就是终点。我反而认为,未来十年该待的地方是硬件。
哈里:我是哈里·斯特宾斯。这期节目一开始排得挺规矩,最后变成了我们做过的最精彩的一次对话之一,从 AI 到数据到机器人,什么都聊到了,嘉宾是纳文·拉奥。纳文是一位连续创业者,他把上一家公司 MosaicML 以 13 亿美元卖给了 Databricks。现在他带着 Unconventional AI 回来,这家公司融了数亿美元,上一轮估值接近 50 亿美元。我觉得纳文是在这么广、这么复杂的一堆话题上,表达最清楚、思路最清晰的人之一。他还有一种少见的能力,能把非常复杂的概念拆成很好消化的经验。他太棒了,这期做得非常愉快。
哈里:不过在我们进入今天的节目之前——创始人和投资人都睡在 Eight Sleep 上。它是马克·扎克伯格先生、安德鲁·休伯曼博士、夏尔·勒克莱尔和 Aston Martin F1 车队都信任的智能睡眠系统。新的 Pod 6 中枢比上一代小了 50%,起价 1,999 美元。访问 eightsleep 点 com 斜杠 20VC。
哈里:Eight Sleep 让你睡得更好,MongoDB 让你建得更好。MongoDB 一直是开发者喜欢的数据库,而现在它是 AI 代理需要的数据平台。代理需要准确的上下文,而且要快。MongoDB 实时地存储、检索并推理你的数据:原生 JSON 数据库、向量检索、Voyage AI 嵌入,全在一个地方,一个系统代替十个。
哈里:不用维护数据管道。听起来好得不真实。从第一个用户扩展到几十亿个向量,跑在任何云上、本地机房,甚至你的笔记本上。这就是为什么财富 100 强里有 75% 把他们最关键的应用跑在 MongoDB 上,每天流转数以万亿计的美元。也是为什么像 Eleven Labs 这样的 AI 原生公司在 MongoDB 上跑着 4,000 万个代理。所以如果你在构建 AI,MongoDB for Startups 会用 Atlas 和 Voyage AI 的额度加上专属支持,帮你跑得更快。别做那种答一次就忘的代理,要做能从你实时数据里记住并学习的代理。访问 mongodb 点 com 斜杠 agents。
哈里:MongoDB 扩展产品,Framer 扩展故事。如果你的团队想要一个看起来像手工做出来、但上线依然很快的网站,Framer 就是为此而生的。Framer 是 AI 网站搭建工具,帮创作者、团队和企业以前所未有的速度上线生产级站点,同时把每个细节做对。提示、检查、编辑、发布,全在一个地方,全新的节奏。代理和人并肩工作:代理带来速度和规模,你带来品味、判断和控制。作品落在画布上,始终可编辑。自定义代码组件、管理 CMS 内容、优化 SEO、审查问题,全在一处。企业级托管、安全和 99.99% 在线率的 SLA,Perplexity 和 Miro 这样的领先品牌都在用。今天就去 framer 点 com 斜杠 20VC 免费开始,Framer Pro 年付计划还能打七折。条款与限制可能适用。
哈里:你已经到达目的地了。纳文,我太期待这次了,老兄。我跟你说过,我把你扒了个底朝天。马特·伯恩斯坦、马特·奥科,还有很多人。非常感谢你今天来。
纳文:当然。我也很期待。
哈里:我觉得会很好玩,因为我看了你一大堆节目。我把我觉得最有争议的那些话都记下来了——顺便说,里面有几记狠的。但我其实想从这个基础层开始,也就是基础设施里的能源。你以前讲过它会成为瓶颈,也讲过它的重要性。你怎么看今天能源供给的状态?有什么是我们没看到、但应该看到的?
02 · 能源与算力(04:36–19:00)
纳文:是,它一直很难建。我觉得大家没意识到这一点。我看过一些来自传统工业的数字,建一吉瓦大约要 500 亿美元。所以现在大家把「吉瓦」这个词挂在嘴上,好像它很容易似的。我说兄弟们,这不容易。换个参照:建一座晶圆厂,一座半导体厂,量级是 200 亿到 300 亿美元。所以一吉瓦比建一座晶圆厂还贵,无论从美元还是从复杂度看。所以它很难。
纳文:过去这几年我们干的事,主要是把周边过剩的需求吸掉。总体上我们是超建的,基础设施不会满载运行。所以我们给数据中心找电,主要就来自这里:能不能把利用率提上去,从里面再挤出几个吉瓦。美国电网平均输出大约 900 吉瓦,但我认为它峰值能到 1.2、1.3 太瓦,也就是 1,300 吉瓦。所以确实有一部分冗余容量,而那正是我们一直在追的东西,因为那是最快能拿到的电。但建基础设施很难,而我们需要建更多。我们落后了。
哈里:落后多少?
纳文:过去二十年,中国在总装机容量上超过了我们,我想是 2023 年发生的。但他们在二十年里建设速度是我们的六倍。他们是从很远的地方追回来的,但他们确实又快又狠。我们当时批评得很多,说他们用脏办法,烧煤,等等。这是事实,但他们同时也是在用最快的速度增长。我认为他们现在在回头清理一部分。与此同时,我们并没有真正投资能源基础设施,这会伤到我们,因为要真正补上需要时间。
哈里:老兄,中国比我们领先这么多,有什么是我们该学的?我们是不是该在政策和监管上松得多? takeaways 是什么?
纳文:我觉得有些东西很难学,因为它触及我们文化和他们文化的核心。中国能集中规划,我们不能。这两种方式各有优势。在这种巨型基础设施铺开的事情上,是的,毫无疑问有计划经济的优势。但在创新上,在刀尖上的东西上,美国要好得多。AI 是在这里诞生的,不是在那里。这些最新的创新全都来自这里。当然,中国也在做非常出色的工作,我不想贬低,因为那不是简单的蒸馏,他们真的在做一些真正的创新。但我认为,真正打开新领域的刀尖部分,来自这里,不是那里。所以结论是,我们得用好自己的优势。
哈里:今天你觉得什么是稀缺的?什么是今天还不稀缺、但三到五年后会稀缺的?
纳文:我认为那种冗余容量会开始变得非常稀缺。你看增长率,即便按对 AI 最保守的增长率,接下来这几年我们也会把电用光。而且这不是说一句「好,我再去找点容量」就行。你会把那部分冗余全部用掉。然后我们就进入一个被建设速度卡住的状态。我听过有人说,我们一年要建 40 吉瓦。不可能。我们从来没做到过。我看不出这怎么可能,至少现在不可能。也许几年后会有新发明,我们靠技术把自己建出来。但就今天而言,我们一年建不出 40 吉瓦。也许能建 10 吉瓦。如果能建 10 吉瓦,那已经很惊人了,顺便说,那是 5,000 亿美元。
哈里:那么当我们看债务周期——现在已经有人说它顶得厉害,而且我们在 CoreWeave 身上看到它开始传导、开始解包,很多担忧围绕着它——这只是开始吗?还是派对的音乐会在晚上七点关掉?
纳文:最大的决定因素会是:对 AI 服务有没有需求,因此对 GPU 有没有需求,因此对这套新增的电力建设有没有需求。显然我在这个行业里,我非常「AI 上头」。我认为需求充足,我们连表面都还没刮到。AI 里还有很多问题要解决,但当我们解决它们——接下来几年我们会解决——它只会打开我们今天甚至不知道的新需求类型。所以我的感觉是,这是一次小波动,不是哪种泡沫在破。这就像你问:人们想不想要治愈癌症?当然想。如果你建出一台能做任何事的智能机器,人们就会想要它。
哈里:我一直记得维诺德·科斯拉跟我说,我想承担尽可能多的技术风险,承担尽可能少的采用风险。就是这个意思:我有治愈癌症的办法,做起来极难,但采用风险是零。但这是否意味着,如果我们真的眼看着 18 个月就要用完,我们今天把过剩供给定错价了?
纳文:你可以这么论证,我觉得这交给能源市场去定价就好,它们本该这样定价、这样往上走。我至少从轶事层面看到了证据。我没有具体数字可引用,因为每一笔「表后」交易都是定制的,人们每千瓦时付的钱远高于从标准电网买。所以我认为已经出现两级定价:数据中心用电的价值比一般用途更高。现在有很多表后的事情在做,公司在建新的技术,比如 Bloom Energy,亚利桑那有一个建几个吉瓦的 Bloom Energy 交易。如果它成了,那很好,那可能就是我们继续往前走所需的技术进步,但它还没被验证。而且顺便说,那套经济账非常不一样。
哈里:怎么个不一样法?
纳文:当我们……
哈里:从能源再往下走一层——能源是底层的电,往下是用它的算力——关于算力,你现在知道、但两年前希望自己就知道的是什么?
纳文:我希望自己早就知道的一件事是:我们其实已经看不到物理层面的能效提升了。你可以把造一台计算机分成三层。第一层是物理层。如果我能把一个比特从这一点送到那一点、并且更便宜,比如我用这里表示 0、那里表示 1,我的手机有一定重量,那么在这两个状态之间切换就需要能量。如果我把手机做轻,所需的能量就变了。这是纯粹的物理问题。我们一般说的摩尔定律,或者你可能听过的登纳德缩放,就是让器件变小,本质是物理的:你让物理层更高效、更密。而这些创新基本上已经停了。你看最近几代 GPU 或其他芯片,几乎看不到能效提升了。你看到的能效提升来自上面一层,也就是计算架构。
纳文:过去这几年、这几代里,我们看到的能效提升大多来自更小的数据类型:从 32 位到 16 位到 8 位到 4 位。因为你搬的比特更少、算的比特更少,所以能拿到相当不错的能效收益。再往上一层,其实没有被很好地利用,我们在 Mosaic 开始碰了一点:我如何在模型层面就开始强制局部性、减少数据搬运。五六年前我们不是这样想的,因为模型还不是算力的主要驱动,那时候算力还是通用的东西——我跑网站、跑数据库那一类。但现在,如果我把计算机只看成一台为交付智能而设计的物理设备,心态就变了:我可以从模型、到架构、到物理层一路协同设计。这就是我希望自己早知道的:上面这几层里还剩多少 α,不只是物理层。我们在物理层上专注了太久。
哈里:当关注点从「模型之前」转到「模型之后」,这种设计心态在整条栈上是怎么变的?
纳文:意思是,我们不把模型当成神圣不可动的东西,我们以能量为先——我们做的每一件事都必须带来能量上的优势。听起来简单,但过去没人这么设计这些东西。过去永远是速度。这甚至可以追到 1940 年代的 ENIAC:计算机被设计出来,就是要比另一种方案更快。一直都是这样。顺便问一句,你知道 ENIAC 为什么被造出来吗?
哈里:不知道。
纳文:ENIAC 是个缩写,电子数值积分计算机,我想是这个意思。它是美国政府在 1945 年造的一台计算机,是最早的大型数字计算机之一。它和所有被造出来的机器一样,是有目的的:它的目的是做火炮弹道计算,并且比另一种方案更快、更准。当时另一种方案就是真人手算。所以你必须更快。那才是关键。下一代出来,必须比上一代更快。GPU 出来,渲染必须比 CPU 快。每一个东西都在试图比前一个更快。这确实带来了能效,原因有好几个:在同样的功耗包络里做得更快,本身更高效;同时摩尔定律在往前推,我们从真空管走到晶体管,晶体管越来越小。而现在,物理那一侧已经不再有太大变化了,晶体管没有变得更好。但我们在模型层和架构层还留着很多空间。
哈里:那这是不是意味着我们看到的是模型的商品化?还是说,我们其实看到的是模型质量的分化——能省电、能拿到能效收益的,和拿不到的,会分开?
纳文:我觉得完全正确。我比较擅长的一件事,是判断接下来几年大家会把注意力放在哪里。我认为这会……
哈里:会非常了不起。真的,得归功于你。你挑一个市场的时候,会不会先走一遍:我认为世界会往这里走,所以我要把自己放在这个位置?
纳文:当然会。而且说到底也跟兴趣有关,对我来说,造一台更好的计算机是最有意思的问题之一。
哈里:那你在做 Unconventional 之前,坐在那个「点子迷宫」里,你跟自己说:我要解决的问题集是……什么?
纳文:我把它看成:如果我解决这个问题,影响是什么?它解锁什么?其实这很像做科学家——好的科学家就是会问那个问题:你回答了它,它会解锁更多问题。这几乎是一篇好论文的标志。所以对我来说,这一次很清楚:我们会把电用光,这一点很明确;我们现有的范式并没有真正围绕这件事;而我认为焦点会落到这里,因为我们要继续扩展,要在许多新的形态里交付智能,要大幅打掉成本才能让它无处不在。所以,还没人想这件事,我应该开始做。
哈里:我们刚才在谈模型的能效,以及它能在能源上贡献什么。今天模型越来越高效。我们怎么判断自己在这条能效曲线的哪个位置?还有很大空间,还是已经到渐近线、在挤最后一点点?
纳文:不不不,我们还有很长的路。原因是我们没有做过真正的协同设计——模型和物理那一侧。你可以想出一个概念,在标准 GPU 上,光靠软件也许能拿到比如说 5% 的能效提升,听起来不错。但无论这个概念多好,你能榨出的东西是有限的,因为那个物理的东西是按某种方式造出来的。你看我们的大脑,它们是共同演化的:智能层和物理层一起演化,所以才能在两边互相利用。比如稀疏性。稀疏性就是计算单元之间不要连接。我在 GPU 上用稀疏,当然能拿到一些收益,但当我的随机存取内存是芯片外的标准件时,这些收益就有上限。我不能走太远,因为那个物理东西并不是为利用这种稀疏而设计的。所以如果我能造出一个真正能利用它的东西,我就能拿到巨大的收益。大脑就是这么做的,它就是这么共同演化出来的。
哈里:当我们谈这种共同演化,或者说把架构专门化到任务上,是不是意味着芯片的专业化是不可避免的?我们看到 Etched、Fractal、Olix,当然还有 Cerebras,有好多人在追特定负载。那是算力的未来吗?你怎么看?
纳文:百分之百是。而且这甚至可以追到图灵最早的那篇论文,他想造的就是一台智能机器——那就是他一开头就写明的目标。后来我们走了另一条路:把他那台理论上的机器拿过来,造出物理版本。所以我们造的任何东西都不是真正意义上的「图灵完备」,因为内存有限等等。但我们用它做出了非常有用的应用:我们可以靠它经营公司,可以剪视频、修图、处理文本,各种各样的事。这带来了过去六十年巨大的生产力提升。但它偏离了最初的目标,现在我们在某种程度上绕回来了。所以计算机的目的,我认为,是提供智能。对我来说,它就是智能的物理载体。那么我们现在要做的,就是把这个载体做得更好。有意思的是,如果你把智能的物理载体做得更好,你做出来的东西是通用的。我们的大脑在某些方面是通用的。但我们的硬件在负载上是固定的,它不像 CPU 那样做我们理解的可编程。GPU 已经走在这条路上——为负载造定制架构。我认为我们只会围绕这一点做超优化。这是好事,因为这样我们才能造出真正有能力的智能机器,最终能造出任何东西。
03 · 芯片与「验证成了瓶颈」(19:00–26:00)
哈里:原谅我这颗金融脑子——你是了不起的技术人,我这辈子大部分时候是个不守规矩的交易员。但我们刚才说,芯片的专业化是不可动摇的。这到底在多大程度上压低了横向厂商、尤其是英伟达的 TAM?还是说——兄弟,别这么小气,现在太早了,我们还有 50 倍的空间?
纳文:是后者。这个市场会巨大。你看,我认为英伟达在把我们带到今天这条路上执行得极好。我 2014 年创办 Nervana 的时候,我们并不真的理解这个市场会有多大。我很清楚一点:我们需要一套围绕神经网络的新计算架构,那是一种描述算力的新方式,而且在我看来,那是一台计算机能做的最重要的事。我认为黄仁勋也相对早就看到了。他在 2014 年的 GTC 上就开始谈人工智能,我记得很清楚,因为当时很多做图形的人非常恼火:你为什么花那么多时间在 AI 上?那什么都不是,那不是重要负载——图形才是,对吧?而他正确地认识到这件事会很重要,往那个方向投了巨额资源,而且执行得非常好。我们必须经历这段计算架构的演化:从我们当年用这些机器做的事,走到它们最终会变成的东西。但现在我看得很清楚:我不需要在意别的,我只需要在意把神经网络跑得非常非常高效、非常非常可扩展。那会是唯一的衡量标准。
哈里:你觉得我们看到芯片商品化的程度有多大?微软昨晚发布了他们的芯片,谷歌的 TPU 显然非常成功,亚马逊有自己的,Anthropic 在自己造,还有那个名字特别妙的 Jalapeño。我们是不是就在看着芯片天然地商品化?
纳文:我其实不认为芯片会商品化。我把它看成和演化平行的一件事。我对这一切有一个非常简单的世界观:智能,对我来说,需求是无限的。对智能的需求没有上限,因为我们所处的这个世界、这个宇宙是对抗性的。最早的时候,两个细菌可能都在抢一小片阳光,那个有感知能力、能移动、能以某种方式适应环境的赢了,然后继续繁殖。接着这些东西组织成真核细胞、多细胞生物。每一次你其实都在把能量和赌注抬到更高一级,但它始终是对抗性的。现在我们看到的是人类群体之间的对抗:我们说美国对中国,或者别的什么,总之会是一个对一个。再往上,在某个层级我们开始更多地捕获太阳的能量,那就是卡尔达肖夫等级,我们在打某种星际战争,随便那是什么。做这些事都需要智能。智能是对抗行为的燃料和经济。所以它的需求是无限的。而要创造智能,你需要能量。把能量转成智能的东西,就是硬件。而我说硬件,指的是整条栈:芯片、系统、云、网络,所有这些东西。所以如果只从经济上看:我要卖的是「把能量换成智能」的能力,我做得越好,我积累的价值越多。就市场而言,我看不出它在短期内会商品化。
哈里:你会不会担心自己吞得太多嚼不烂,然后把产品质量做砸了?在从能源到智能的这个转换里,你在中间吃下的越多,赚的钱越多。但我昨天请了 Modal 的创始人埃里克上节目,我很喜欢他,但这位老兄什么都想做,真的是什么都要做。我当时就在想:产品宽度到哪一点会伤到深度?你会想这个吗?
纳文:我会。我确实觉得世界在因为 AI 而改变,我们可以承担更多宽度,我们能探索的表面积比以前更大。
哈里:就因为开发速度快得多?为什么现在每家公司都成了所谓的「复合创业公司」?
纳文:我可以给你一个很具体的例子。我们第一颗芯片里做了一组耦合振荡器,它们有一个耦合矩阵,一堆互相影响的振荡器。做这个的时候,如果在旧世界——AI 之前——我可能会问一个问题:如果不做全连接,噪声是怎么传播的?也就是我有一串菊花链式的振荡器,开端有某种噪声特征,我想看它在四跳、六跳之后信息衰减成什么样。在旧世界,我得去问研究团队:能不能帮我建模,加一个噪声模型?我只是想要个零阶的理解,用来指引我自己的想法。那大概要花一周左右,因为我手上还有别的事,下周再回来看;也许写代码、验证、给结果要一周。所以我大概要两周才能拿到答案。现在我真的可以把这个问题直接丢给一个模型,它吐出代码,我能读代码,来回几轮,一个小时就拿到答案。原来要想两周的东西,现在一小时想完。所以单位时间里我能想的事情更多了,因为 AI。
纳文:不过我认为我们还有一个问题。我昨天刚发了帖子讲这件事:我们有一个「AI 垃圾」问题。这些模型吐出来的东西太多了,而且极难验证。有些是好的,有些不是,我们得想办法大规模地做验证。但我确实能走得更快,能覆盖的表面积比以前更大。
哈里:你凭什么说「吐出来的东西太多」?
纳文:那是为了好玩。顺便说,英国人把自嘲式幽默的市场彻底占住了,比我们在美国能做到的好太多,真的。
哈里:顺便说,我们英国这边看着这一切,感觉就像:哇,我们一直在抱怨自己的政客,跟这帮人比算什么。
纳文:是,我知道。我们把这门手艺推到了新高度。我跟你说过我们是创新者,对吧?这其实是个完美的例子……
04 · 验证、信任与专家(26:00–31:00)
纳文:……比如我父母给我看那些 AI 生成的、特朗普弹吉他的视频,他们说:哇,他会弹吉他。我说妈,他没在弹,那是 AI 生成的。她说,哦,好吧。所以对我来说,一眼就知道那是 AI 生成的。但那种验证问题,我们在公司里同样看得到。我们可以造出各种产物:写代码、做模型、做各种东西。但你必须闭环,确保每一件都是对的,才能真正相信结果。而这件事开始变成一个大瓶颈,因为你产出的产物太多了。我认为我们把问题从「生产」移到了「验证」。
哈里:验证的价值在于:如果你拥有验证这一层,你就拥有自动化那一层,因为你有可验证性,可以基于它往前推进。是这个意思吗?
纳文:是,我想是这样。而且我认为它是用 AI 开发东西的必要部分。但拥有验证层,就拥有生产层吗?我不完全确定。我认为你还得拥有规格(spec)。要产出有用的东西,比如造一辆车、一座桥,你得能把它规格化,想清楚我是不是在解决一个有用的问题;然后产出的每一件产物都要被验证是对的;再朝着那个规格推进。也就是说,这是端到端的流程,不只是验证。验证只是其中一块。我不知道人们该怎么给这一块单独定价,我更愿意把它当成整体的一部分,也就是「拿到最终结果」的一部分。
哈里:Atlassian 的麦克上过节目,很棒的人。他讲到思维链的重要性,讲到在公司不同职能里理解「代理主导的决策」和「人主导的决策」。我一半觉得完全懂,完全说得通;另一半又觉得,这样想有点旧。那到底意味着什么?我们不像信任人那样信任代理的决策——这话听着也有点怪。
纳文:我们的确不。你看,我同意你。在很多情况下,我不认为我们现在应该像信任人一样信任代理的决策。这就像我们在某些事情上一训练就是很多年,为了建立判断力。比如成为神经外科医生,医学院之后还要七年训练。这是有原因的。不是因为缝一针有多难学——我在研究生院就缝过。问题不是外科医生那部分物理的、机械的动作,问题是有判断力……是有判断力。
纳文:我怎么做决定?我可能会把所有产出在脑子里过一遍,我有某种启发式来判断什么好。我们在内部做这件事,也许是某种内心独白,某种内部过程。但模型吐出思维链,然后我们有很多条思维链,我们判断哪条好,然后走那条路。那个「判断」的环节,对每个任务来说其实都没被真正理解。所以我不认为我们现在应该信任这些东西。我认为你搭的「决定接决定接决定」的链条越长,越容易脱轨。你能得到看起来非常稳健、但其实完全错误的东西。这就是我们今天的位置。未来大概会变,我认为还需要几个突破才能到那儿,但今天就是这样。
哈里:那么——今天看起来古怪、离谱、疯,五年后却变得司空见惯、大家都同意的事,你相信有哪些?我记得我当年把信用卡输进 PayPal,我父母把我骂了一顿;还有 OK Cupid,你在网上找老公老婆,多荒唐的念头,当时简直疯了。我认为我们会比信任自己更信任我们的代理。我觉得某个时刻这会成真。但你认为我们今天离那儿还很远?
纳文:是,我们今天还没到。而且专业能力并不会过时,它只是会换一种形式。我认为未来的样子是:我们开始建我们姑且叫「模型」的东西,但我其实不认为它是一个模型,我认为它是整台机器。我把智能看成有物理的一半和智能的一层,它俩是一体的,不可分割。我有一台机器,它几乎像一个有机体,我可以教它在各种任务上成为专家。价值就来自把这种专业能力建起来。这就像你上的是哪所学校、你是怎么学会做神经外科医生或者做厨师的——那个「来历」很重要。你跟着某个人学,学到他的方法论、他的思维方式,价值是从那里来的。你、任何一个人,从头到脚都是一台智能机器,但有没有一种教法让你真正变得有价值?我认为我们会在机器上开始看到类似的东西,我们可以复制那种智能。但你被教的方式,才是真正重要的。而这其中一部分,就是知道怎么走到一个真实的、能用的、被验证过的结果
05 · 数据不是大宗商品(31:00–36:00)
哈里:当你想到那种学习里的价值,很大一部分其实在一个人随时间累积的数据里,在你做一件事的那些年里。我们今天看到数据公司——它们的收入在极短时间里冲到天文数字,以前那叫「惊人的大」,现在还是惊人的大,但来得太快了。老兄,你太聪明了,跟你聊天真愉快,我简直想问你一堆关于世界的问题。这个市场会怎么走?它会随时间整合吗?还是会越来越解耦,让你能建出更多防御性?会发生什么?
纳文:说实话,我认为它会专业化。我认为如果你专业化、真的去做重要的问题,你会拥有一个大而可防御的市场。这又回到技能上的幂律:你可以说所有人都能学会很多技能,但某些技能比另一些更值钱。你构建的数据和课程(curriculum)也是一样。
哈里:所以我们看到的是数据公司的专业化。所以你不认为它们是大宗商品。
纳文:是,我不认为它是大宗商品。我认为它一开始是大宗商品,因为那基本是「按量收集观测」。但随着你开始构建更高质量的数据集——在 AI 世界里我们这么叫,比如用于编程的更高质量、用于思维链的更高质量——数据里就开始有大量价值。模型在某种意义上几乎只是它学到的东西的一种显化。
纳文:而知道怎么挑选那些数据,其实正是当下的胜负手。大模型公司,本质上是数据问题。他们在模型本身上也有进展,但大部分能力并不是从那里来的,而是从整理数据、用不同的损失函数来的。以前我们有预训练,那是一种很特定的损失;然后我们走到现在叫「中训练」的阶段——强化学习、监督微调,各种混合。所以那套课程、那套「从预训练到各种训练去改变模型行为」的路径,才是真正的秘方。
哈里:我能问一句吗:你提到预训练、RL,然后重心明显移到了后训练。这种从预训练到后训练的重心转移,你认为是一种持久的、永久性的转变——在模型改进的效率和路径上?还是会重新回到 RL 为主、或者预训练为主?随时间看,重要性会怎么变?
纳文:我不确定它更高效。其实我认为 RL 更不高效。如果按「每单位算力、每单位美元能把模型提升多少」来看,它其实更不高效。但它确实一直在往前走。核心是:我们想让模型在重要的任务上更强,所以我认为它相当重要。
纳文:……中间层,甚至在预训练层,我们会开始建立专业化。所以我不认为模型公司在性能上想得很长期——比如「我要在思考 AI 系统的方式上搞一个巨大的突破,从而拿到优势」。我会说,大实验室现在没怎么做这件事。
哈里:你觉得在日复一日的竞赛里,他们负担得起吗?
纳文:这就是当前生态的问题。它真的很快,你必须一直压在上面。比如你晚一个月发模型,如果你是 OpenAI、Anthropic、Grok 或者谷歌,那是灾难。他们现在还承担不起那种大风险。你看,马斯克起 xAI 的时候,基本是:好,范式在这儿,我们去找人,然后砰,他很快就到了前沿,因为他有资源。这在我看来说明:那里并没有特别多很深的创新,而是把零件拿过来、配上一个知道怎么造的团队、执行得非常快。这和「想出一个新范式」是完全不同的事。你看杨立昆的公司、李飞飞的公司,他们在尝试做更深的创新。我认为那种事可能属于创业公司的范畴。它开始变得像药物研发:大风险由创业公司承担,渐进的东西由大公司做,大公司等创业公司显出苗头就把它们买下来。
哈里:我有时候会问一些很基础的问题,但我确实不知道答案,而你非常聪明。为什么今天所有人都对 RL 这么兴奋?你刚才提到它属于中训练。我身边太多人了,全都在说 RL。
纳文:有几个原因。你想想我们学习的方式,主要就是强化学习。如果我要教你一项新技能,比如学会发网球,那其实就是一个 RL 循环。我会给你一个「它应该是什么样」的范式:你的发球该长这样;也许会示范一下,或者给你看个视频。这会让你在内部建立一个关于「好」和「很好」的模型,然后你不断拿自己跟这个内部模型比:是,我在接近,我在变好,或者我没有,我需要求助。这就是 RL。我认为它重要的原因是:我们没法收集到足够的数据来解决世界上每一个任务,真的不能。你没法靠堆数据预训练出所有东西,太难了,而且说实话模型也不够高效,用不上那么多数据。所以你需要一种范式:好,这十件事最重要,然后我有某种可验证的奖励——我有个内部模型,比如一次好的发球就是我大力打出去、球落在界内。它是可验证的,我能测速度,能测是不是出界。当我有了可验证的奖励,我就能开始判断:我采取的那些动作,是不是导向了这个好结果。于是我有了一套能解决任何一组通用任务的结构。这就是 RL 让人兴奋的原因。
06 · Transformer 之后,以及哪一层会商品化(36:00–41:00)
哈里:你认同杨立昆的「后 Transformer 世界」那一套吗?那会怎样改变一切?
纳文:我确实认为我们会进入一个后 Transformer 的世界,我不认为 Transformer 就是终点。这件事我大概两年前才真正想明白,因为 Transformer 把很多东西混在了一起。我们真正在意的是推理,是能一步步把一个问题的道理推出来。不知道是谁说的:智能是你没有信息时做的事,不是你有信息时做的事。所以能从某种机械论的、第一性的理解出发把一个问题推过去,那才是智能。Transformer 多多少少有一点,但它其实是靠一种代理式的流程做出来的:你采样很多次,然后判断哪个好。我拿一条轨迹跟另一条比,说这条更好,然后把它叫做我的推理轨迹。所以我们实现「推理」这件事的方式,其实是靠一个检索机制:注意力本质上就是上下文,而上下文就是一种检索;然后我们从中采样,最终得到看起来像推理的东西。我认为对于「推理」这件事,这种做法极其低效。我们不需要这样造推理。我们的大脑不是这样工作的:我们不会建一条巨大的轨迹,把它灌进另一个模型的输入,然后再产出一条轨迹。所以有远比这高效的做法,从算法角度看也有远比这高性能的做法。所以我们会走过 Transformer。
哈里:那你觉得成为伟大创始人所需的东西变了吗?
纳文:我不认为变了,基本原则还是那些。但我认为「对未来有观点」这件事——你的愿景——现在可能比以前更重要。在 AI 之前的世界里,你只要会执行,就能当一个相当不错的创始人,你不必有多好的愿景。你只要知道怎么执行,出去把一家大公司干掉就行——这没那么难,因为大公司又慢又笨重。那样你确实能建起一家创业公司,把它卖掉,或者做成一家公司。但今天,如果你只靠执行,我认为走不远。
哈里:我们刚才讲了几层。你说数据不会商品化,专业化有价值。那哪一层会随时间被商品化?
纳文:这是个好问题。可以说,能源已经是大宗商品了,它早就商品化了。我认为一定有相当一部分智能确实开始商品化,说实话我们已经在看到了:比如六个月前的模型——就说中国的开源模型——那个水平已经相当可用。六个月前的东西依然相当能打。所以我会说,这就是商品化的标志:前沿并不是唯一重要的东西。对某些问题它是,但六个月后,那个前沿就会出现在开源模型里。
哈里:那你帮我理一下:如果整套基础设施的交付方式、或者说它的产出被商品化了,会发生什么?
纳文:我认为商品化不一定意味着坏,它只是意味着毛利掉很多;但它也意味着市场非常大。你可以说西红柿是大宗商品,但我们还是吃它,我们还是需要它。所以智能会有一个巨大的市场,而且会继续长。但毛利可能不会高。我其实不认为模型公司会是拿走整条栈毛利的那一方——今天也不是这样。今天拿走这条栈毛利的是英伟达,对吧?我会说,他们大概是拿走最大那块肉的人。
哈里:很多人跟我说,接下来几年推理成本会大幅下降,我们可能会看到推理市场的商品化。你同意还是不同意?
纳文:我们拆开看。推理市场的商品化是什么意思?我想指的是跑推理的那一方,对吧?
哈里:对,完全对。你的 Fireworks、你的 Modal、你的 Baseten,还有它们提供的服务。
纳文:因为你看它们的价值主张:它们做得很好的一件事,是把一个已经存在的模型——比如一个开源模型——拿过来,让它跑得好,有可用性保证,并在基础设施上跑得相对省钱。所以它们本质上是基础设施的生意:把模型映射到物理硬件上,并且把这件事做好。我认为未来那里仍然有价值,但推理的价格——也就是人们愿意为每个 token 付多少钱——会下降。所以它们必须从硬件的能力里榨出更多毛利来交付那个 token。而那一层的「油水」,我认为会减少,结果就是它们的毛利更低。模型本身已经是商品化了,你有好几种方式拿到它。但硬件那一侧大概不会塌,我认为那部分仍然有优势,因为你还能从「我把能量换成智能更高效」里榨出更多东西。相比基础设施层,那里还有多得多、也大得多的油水可榨。我其实认为,未来十年该待的地方是硬件。
07 · 软件投资人的处境、工资预算与机器人(41:00–52:00)
哈里:老兄,做硬件投资是真他妈难,是完全不同的心态。这一代投资人够格做硬件投资吗?
纳文:不。
纳文:我会说,如果你是纯软件投资人,说句实话,你有点完了。我敢很自信地说这句,因为我认为 SaaS 不再是你赚毛利的地方了。我们经历了一段从 2010、2011 年一直到现在的「糖分上头」:我可以在 AWS 上很快起一个东西,快速试市场、试想法,然后去打一个一亿、两亿美元的市场。SaaS 之所以是巨大的市场碎片化,是因为交付机制变得非常简单、无摩擦。而现在,应用开始更多落在智能层。我看不出软件在二十年后还会是一个很大的市场。
哈里:你不觉得 SaaS 只是变成了 Legora 吗?我的意思是:Legora 是 SaaS 吗?嗯,某种意义上是,企业 SaaS;但某种意义上又不是。语义不就变了吗?我不认为真有人从零开始就说「我们是一家 SaaS 公司」。
纳文:对,完全正确,你说得对。我刚才用的是 SaaS 的经典定义。但我认为那些「交付一个结果」、并且是通过软件加服务的组合来交付的公司,绝对成立。我们在好几家公司身上看到了,我自己也投得挺积极——我主要投种子轮。我看到一批公司起来,它们接手那些存在很久、一直用传统方式做的工程任务,用 AI 加人把这些任务做得快得多、便宜得多。这很好。Harvey 就是律所这个领域的第一个例子:过去的方式是我有一批律师去看合同、写合同;他们的做法是,我可以用 AI 来做,再用人来验证输出,用更少的人、更快地交付同等或接近同等质量的东西,然后去颠覆那个市场。所以我认为我们会看到更多,这就是新的 SaaS。
哈里:你这么做的时候——是,某种意义上是,但它其实是律所的更好版本,对吧?你愿意做这件事,因为我遇到很多公司正好在做你说的这件事,而我会想:我不想去做一家律所。我很乐意做一家 Legora 或者 Harvey,卖东西给律所,但它们本身不是律所。
纳文:对,但我们确实看到,一些大律所现在直接投 AI。所以我认为在极限情况下,Harvey 会卖给律所,因为律所有渠道。那个渠道会长期存在吗?我不知道。但我也能想象它们说:其实我们可以直接卖给企业——就我个人而言,我会买。如果 Harvey 说「我这套方案处理你所有的保密协议、审你的合同」,而且我能确信它管用,我会把 80% 的法律工作量给他们。
哈里:我在这点上很好奇,因为你提到有些公司在自己建。你看到法律行业的 K&E 承诺投 5 亿美元进去。我在 Fireworks 有投资,他们的联合创始人公开讲过「拥有你自己的智能」,讲企业用自己的数据去建自己的模型有多重要。你觉得那是一个非常可行的未来,还是一个特定立场上的、偏技术乐观的预测?
纳文:有一点技术乐观。因为我认为你必须有相当的规模,才能建自己的智能、并且拥有它。还是拿律所举例:如果你是 Cooley 或者这类大所,是的,你可以投这些事,你可以做成。如果你在内布拉斯加中部开一家夫妻店,你做不到。所以你会以某种服务的形式来用它:你可能用那个服务武装你的律师,然后用这种方式给客户提供服务。所以我不认为「每家公司都会用 AI 撬动自己过去的数据、让自己的模型更好」——他们不会这么做,这对他们太难了,他们要的是开箱即用的方案。所以我认为卖开箱即用方案是有市场的,但那是个长尾。大玩家会开始定制,因为他们有规模去支撑这件事。这又回到那个想法:我们世界的每个部分都是对抗性的,取决于你在跟谁打。如果你在跟另一家大律所打,而那家律所用 AI 把毛利拉高了,那你多少也得这么干。夫妻店大概不会,跟他们竞争的人也不会,所以他们会在另一个世界里待上一段时间。
哈里:我觉得支撑法律、编程这些事的一个变量,是工资预算里有多大比例会转成技术支出。今天美国法律市场大概 3,000 亿美元,你会想:其中多少会被这些供应商吃掉?编程也是一样的问题。本尼奥夫说,他们会从 60 亿美元的开发者工资预算里拿出 3 亿美元去买核心代码和编程工具,幅度很大。我的问题是:这个比例会停在开发者的 5% 吗?会涨到 30%、50%?还是会降到 1%?这是那道母矿一样的问题。
纳文:我其实认为比例大概会保持稳定,因为我们最后会撞上验证问题。这很难,因为训练人知道什么是好的,才是难的部分。对开发者来说,真正重要的不是你今天直接产出多少,不是代码行数,而是代码质量。所以那些经验非常丰富、顶尖的开发者——那些 10 倍开发者——他们建立起了对「什么是好的、什么看起来对、什么在美学上是对的」的感觉,他们能让东西很快跑起来。在这个新世界里,那些知道什么是好的程序员,能去验证模型的输出,从而变得更高效。所以我认为会发生的是:我们产出更多,而市场规模——比如我们为人加 AI 付的钱——不会有剧烈变化,只是产出大幅变化。
纳文:我这么看,把它推演一下:假设一家公司一年花 1,000 万美元开发软件。突然之间,这个软件的客户开始有不同要求。十年前,他们能接受一年一个发布周期;现在他们说:我要这个 bug 一周内修好。而唯一能做到的方式,其实就是用 AI 加人。我不是做得更少,我其实做得多得多:我一周内修完那些 bug,最终一小时内修完。但我仍然在付那 1,000 万美元继续开发这整套东西,而且我需要那些人能验证这些输出、并且真的朝一个有用的目标推进——修 bug、加功能。所以我认为交付的节奏会加快,因为需求侧开始要求它。而我认为这里被漏掉的关键是:并不是所有人的工作都消失了,因为同样的任务用 AI 加人能做得很便宜。是的,那是真的;但我会做多得多这类任务,因为需求侧变大了。你不会只得到其中一个而没有另一个:当供给变便宜,它同时也改变需求侧。所以我认为会发生的是,我们最后只是做得更多:更多发布周期、更多改动。
纳文:举个我觉得大家能想明白的物理例子。假设今天建一栋楼有个速度,我要建一座摩天楼,比如要两年施工,那是基于 X 个人、Y 套技能。假设突然我有机器人能干其中 80% 的活,会怎样?好,体力劳动可能会有一阵冲击,但然后你会说:建同一座楼,过去要两年,现在 80% 的活由机器人干,我能把整个工期压到八个月。所以不是你要建同样数量的摩天楼、只是用八个月建完,而是你会建两倍的摩天楼。会有更多东西在流转、更多楼被拆掉、更多劳动进入那个市场。所以项目总数会上升,投进所有这些项目的美元总量可能一样,但会是人加机器人的组合。
哈里:纳文,你说过你当然在做天使投资,而且投得很成功,你刚才有点轻描淡写了。我今天投资的一个逆向观点是:我不喜欢机器人投资。我认为我们离该到的地方太远了,而时机很重要。我不是说支撑机器人的基础设施——我认为围绕它的数据集非常有意思,我们看到很多像 Mecca、Micro AGI 这样的公司其实在建那套基础设施。但真正的应用层,比如扫地机器人、建筑机器人,我们离该到的地方太远了。我不想在那里,我不想承担时机风险。我错了吗?我天真吗?你比我聪明得多。
纳文:这个我又很上头,所以我会强烈不同意。你说「太远」,那我们把它换成时间:你觉得时间线是多久?五(年)以上。好,那我们分歧没那么大。我认为接下来两到三年,其中一些任务会有可用原型;市场会在五到七年出现。我认为这是对的。
哈里:我还认为人形和非人形之间有一条清晰的分界。非人形绝对能看到更清楚的路径;人形,我真的被震住了——每次我觉得某件事非常明显的时候,我都会想,我一定错得很厉害,因为人形明显离得那么远。
纳文:我认为我们会待在这个奇怪的世界里:我们活在指数级的开发周期中,旧模型很难套用。今天看起来那么远的东西,在一条指数曲线上,最后会比你想的快得多。
08 · 推理市场(52:00–53:00)
纳文:它是无上限的,是数万亿美元级的。你十年前问我什么是万亿美元的市场,答案是基本需求:住房、食品、交通。你绝不会想到科技里会出现一个万亿美元的市场。而我认为,光是 AI 模型本身,接下来几年就会是一个万亿美元的市场;推理市场在十年内会是一个 10 万亿美元的市场。这想起来很疯。而且回到你刚才那点:我们把一部分劳动力市场、一部分价值创造的过程挪到了技术里,所以才会出现这么巨大的 TAM。
纳文:所以我看 Unconventional 的方式是:这是一个极好的市场,因为如果我们把交付一个 token 的效率砍掉一个零、也就是提升一个数量级,某种意义上市场就直接放大十倍。原本是万亿美元的市场,突然之间适用面广得多,潜在用途的基数涨了不止十倍。这就是杰文斯悖论。所以我们处在一个能造出这些指数、并且释放巨大价值与市场的位置上。所以我确实认为,机器人会比 agentic coding 大 100 倍。
09 · 机器人:比编程 agent 大 100 倍(53:00–59:00)
哈里:这跟我有点分歧啊,纳文。在快问快答之前,我们能不能先把它拆开?因为我不想显得太蠢。你为什么这么说?
纳文:因为我们在「怎么看见智能的产出」这件事上,还只是刮到表面。物理世界是我们从来没有真正进入过的领域。我会说,到目前为止的机器人、包括工业机器人,并不真的智能,它们是死记硬背。我们把自己拥有的智能灌进去——怎么做这个任务——然后它们照做。那不是真正的问题求解。而在不远的将来,我们会进入物理问题求解的领域。想象一个世界:我有几十亿台机器人在到处跑,它们真的在动态地解决问题。这边坏了,我去清理,我去替换。我们这个世界里「把东西收拾好、把新楼建起来、把物理问题解决掉」的交付成本,不会降到零——我讨厌那种「降到零」的说法。
哈里:那你具体投机器人的哪一段?投给它们供能的模型公司?投给模型公司供数据的数据公司?消费者应用层?哪里?
纳文:我不认为现在该投应用层,我更多在技术栈里。我其实认为那些做模型的人还没想清楚自己长大以后长什么样,这没关系,我不是说他们必须想清楚。我不认为价值会落在「模型」这一层。我在投做模型的公司,我认为它们最后大概会做端到端设备:造一台机器人,配一个把某件事做得极好的模型,然后这样卖出去。我个人的看法是,这两件事会合在一起,不会分开。
哈里:当时间线就是你说的那个样子时,你还在意价格吗?
纳文:不太在意。我只是觉得,我需要把一部分财富放进那个领域,因为它重要,而且那里会有大量增长。所以有意思的是:传统 VC、价值投资人会说「那太贵了」。兄弟们,当我们谈的是万亿美元以上的 TAM 时,价格几乎是不相关的。
哈里:我完全同意。挑战在于,我们常常还有一个客户、或者一个老板,就是 LP。而 LP 是更滞后的指标,他们认为持股比例和价格非常重要。当你站在年度大会上说「持股比例降了、价格涨了」,他们会说:去你的。
纳文:他们会这样,直到他们开始看到大机构也是同样的趋势,然后他们说:哦,好吧,也许这就是方向。
哈里:如果你可以把所有钱投进一家不是你自己的公司,会是哪家?
纳文:大概是 Physical Intelligence。在我看来,他们在解决一件根本的事:怎么定义任务,然后执行它——也就是把任务转换成电机输出。对我来说,这是物理世界当下要解决的问题。除了我们自己做的「造一台新计算机」,我认为那是下一个大问题。
哈里:你在多家公司上都极其成功。关于「有钱」这件事,有什么是没人告诉过你、但你希望有人告诉你的?
纳文:我认为它不会改变你的价值观。你的资源仍然是有限的,你仍然会以某些方式看重某些东西。我在某些事情上还是挺抠的,其实没道理。你要问我太太,大概是衣服那一类。我就想:什么?为一条牛仔裤付这个价?
纳文:旅行也是。我在往「优化时间」那个方向走,但总体上我还是会觉得:太贵了,我不干。花不花这笔钱其实无所谓,我只是看不到价值。所以就是这样:我会把钱放进我看得到价值的地方,而且可以放得多得多;而在看不到价值的地方,我一分钱都不会多花。
10 · 编程 agent、快问快答与片尾(59:00–69:23)
哈里:我们先来快问快答。我说一句短的,你给我第一反应。过去 12 个月,你改变了什么看法?
纳文:在投资上,我改变了对「衡量进展的有用指标」的看法。我们一直把它看成:要看市场验证,那才是主指标。我认为那是旧的看法,而且很大程度上来自 SaaS——当没有很深的技术路线时,市场验证是有意义的:我在造一个服务某个用途的产品,那就全看市场验证。但当我手上的东西几乎是「看一眼就知道是真的」,比如我要治愈癌症,你不需要验证市场,你只需要验证技术问题的进展。所以现在投资人分成两派:一派说,走,重仓投这些公司,估值见鬼去——我们公司就属于这一类;另一派说,天啊,这太没纪律了,你没有市场验证。我其实认为后者根本错了,而很多成长投资人还在那个桶里。我从小读的是那些讲怎么看待风险、怎么投资的书,在这件事上我改变得相当大——不只是因为我自己的公司在这么做,而是因为我们现在解决的是非常深的技术问题:机器人、计算、生物。这时不是市场验证的问题,市场明明在那里,非常清楚;你把那个问题解决,百分之百有人买。关键是解决问题的进展。
哈里:如果你的资源完全没有约束,职业上你会做什么不一样的事?
纳文:我会开始自己建制造。我想越来越靠近原材料的源头。我们现在这个世界,从硬件生态的角度看,有太多供给约束。如果我没有约束、能造任何东西——这其实就是马斯克在做的事——是的,我们应该建自己的晶圆厂,因为我可以为我的需求把那一层超优化。我不需要拿一个为一百种其他用途造出来的大宗商品去凑我的需求。我会精确地造我需要的东西,做出更好的产品。坦白说,我认为一台计算机的全部价值都来自交付智能。如果我能一路超优化到「硅锭从工厂出来时我怎么处理它、怎么切片」,我绝对想这么做。
哈里:今天 AI 里你觉得最被高估、你不会投的领域是什么?
纳文:那些「快钱」:有一个现成的人在做的事,我就用 AI 把它自动化。我认为那是当下最差的投资位置,非常被高估。我也确实认为,agentic coding 作为一个市场被高估得厉害,因为价值会流向模型提供方。我不认为其他人能拿到多少价值。我知道 Cursor 退出得很漂亮,那很好。但价值主要来自模型提供方、来自模型本身,我不认为它来自 harness 或者 IDE,那些不够粘。我在自己公司里就看到了:人们在这些工具之间来去非常自由。所以重要的是模型,以及它交付的能力。所以 agentic coding 作为一个市场(把模型提供方排除在外),是我今天不会投的东西。
哈里:三年后,开源和闭源各占多少 token 流量?我认为八成开源。
纳文:那换成金额是什么样?这才是更好的问题。我认为它大概会收敛到很像手机市场的样子。手机市场大致是:iPhone 占总量两成,但拿走八成利润。类似这样。我们会看到,只有相对少数、非常重要的问题需要前沿模型,你会为那些付贵得多;而你日常做的所有日常任务,会由开源模型处理。所以我其实认为花费上大致是五五开,但 token 上,只有两成流向最前沿的模型。
哈里:你参加过的最好的一场投资人会议是哪一场,为什么?
纳文:好,这个我可以讲个故事。从我在 Urbana 起步算起,我大概开过一千场投资人会议。到第八百场之后,前面那些真的不留印象了。很早的时候,我和史蒂夫·尤尔韦松开过一次会,他后来成了我的好朋友。我当时紧张得要命,因为我听过太多关于他的传说:极其聪明,会把你拆了。结果我们一坐下来就开始极客式地聊数值表示。我心想:这人是个投资人?然后我发给他几篇论文,他在上面做批注、提问,我再回给他——这完全不是我预期中投资人的样子,他更像在跟一个技术同事对话。所以对我来说,那是我最好的一场投资人会议之一,因为我们做的东西太新了,之前没人讲过。2014 年,已经十年没人讲过做硬件公司的故事。而这个人几乎是一直在等着投这种公司,因为他自己就在想这件事。于是就是那种:砰,走。
哈里:我很喜欢史蒂夫,我记得请他上过节目,他太棒了。你说的「愿意非共识」正是我喜欢他的地方。
纳文:对,你必须这样,才能下那些会兑现的大注。按定义,共识已经是错的,已经过时了。所以你必须非共识。
哈里:我在欧洲感受到的挑战其实是「点子的商品化」:现在当创始人是一件挺「旅游式」的事,所有人都想为了体验去当创始人,点子的质量下降了。我不认为美国人天生更好、更聪明、更有才华,但我确实认为你们在「选点子」上更有创新性,这大概来自你看到什么、怎么想、在结构里站在哪里。我们这边还在用 AI 做报销管理。
纳文:完全对。我认为在这里,我们被允许想得更大。在欧洲你不被允许,因为整个投资人网络和人们思考的方式太保守。如果你带着一个疯狂的点子进去,他们会说:那人疯了,我不投他。而在这里,他们会说:那人太棒了,他在想大事。
哈里:我现在完全同意你,说得太对了。难的是——我真心遇到一个:好,我们这么说吧,现在有一家 A 轮公司,他们在做太空相关的东西。团队很棒,非常好。但老兄,从一支 4 亿美元的基金里开 2,000 万美元的支票,那是 5%。你不能那么轻松地把它丢掉。老兄,太空是极高风险的一手,我完全看不懂。
纳文:我把这些看成技术周期的早期阶段:我们这些技术人都会给你讲一个故事,我们需要做的是搭一个叙事。那个故事会是错的,百分之百会错。别的我不知道,但我知道它会错。我不知道它具体错在哪、错多少,但它会错。在那个阶段,你投的其实是「开这辆巴士的人」,不是巴士本身。方向是对的,想法是对的,而你在意的是团队:他们能不能开?能不能做出必要的转向、做出正确的技术决策,真的把这辆巴士开到某个有意义的地方?
哈里:真正的挑战是,在这个市场里你没有时间。你没有。我真希望能说「有」,但大概你只能见到两三次。
纳文:你说得对。你只能尽可能多做功课,去跟他们认识的人聊。但这很难,我同意。
哈里:最后一个问题,老兄。你最期待的是什么?我喜欢乐观,我不喜欢围绕泡沫和狗屁的那种犬儒。什么是那种「我他妈就为这个兴奋」的东西?
纳文:我本人最兴奋的是:我把 AI 看成一种工具和能力,它让我们能对宇宙提出大得多的问题。科学里有太多我们不理解的东西,原因是它们难以接近——难以接近,是因为能思考那个问题、并且真的推进它的人太少了。我们能去攻、能开始解决的问题表面积开始变大。这对我来说极其令人兴奋。我不看那种「天啊,AI 会杀死所有人」——那是我听过最蠢的世界观。对我来说那就是白痴。我现在其实完全听腻了。不是的,兄弟们,AI 是让人类真的开始啃下这些更大问题的东西:我们怎么探索更多宇宙?当我们开始理解物理更深的层面,我们就能做。我们有虫洞这类想法,它们都还是理论构造。我们现在可以用 AI 开始推进:我真的能造出利用那个物理现象的东西吗?它到底是不是真的?这些是我们现在可以开始问的问题。过去我们问不了,我们没有足够多能靠近这些问题的人。所以对我来说,把科学往前推、把人类的理解往前推的能力,太令人兴奋了,我都没法形容。它让我觉得自己像个孩子。外面是一个我们过去连想都不敢想的世界,我们被打压到只相信「这就是我们能看的全部」。而现在,突然之间,那一整个世界对我们打开了。
哈里:像这样的节目,就是我做了十年还爱做这档节目的原因。你知识的广度太美妙了,说实话,能亲眼看到很惊人。谢谢你愿意跨这么宽的光谱来聊,你太棒了。
纳文:老兄,很好玩。我喜欢这种能就这么多不同话题随便聊的对话。
哈里:不过在我们今天离开之前——创始人和投资人都睡在 Eight Sleep 上。它是马克·扎克伯格先生、安德鲁·休伯曼博士、夏尔·勒克莱尔和 Aston Martin F1 车队都信任的智能睡眠系统。那张 Pod 是一层智能床垫罩,能套在任何床上:两侧分别制冷到 55 度、加热到 110 度,还能追踪你的心率、心率变异性和睡眠阶段,不用戴任何东西。新的 Pod 6 中枢比上一代小 50%,起价 1,999 美元。访问 eightsleep 点 com 斜杠 20VC。
哈里:Eight Sleep 让你睡得更好,MongoDB 让你建得更好。现在每一家认真的 AI 公司都有同一个问题:代理需要准确的上下文,而且要快;而大多数基础设施不是为此建的。MongoDB 是。Eleven Labs 在 MongoDB 上跑着 4,000 万个代理,财富 100 强里有 75% 把最关键的应用跑在 MongoDB 上,每天有数万亿美元在 MongoDB 上流转。你不需要拼十个不同的工具,而是得到一个原生 JSON 数据库、向量检索和 Voyage AI 嵌入在同一个系统里,而且能跑在任何地方,没有锁定。如果你在构建 AI,MongoDB for Startups 会用 Atlas 和 Voyage AI 的额度加上技术支持帮你更快上线。别做那种答一次就忘的代理,要做能从你实时数据里记住并学习的代理。访问 mongodb 点 com 斜杠 agents。
哈里:MongoDB 扩展产品,Framer 扩展故事。如果你的团队想要一个看起来像手工做出来、但上线依然很快的网站,Framer 就是为此而生的。Framer 是 AI 网站搭建工具,帮创作者、团队和企业以前所未有的速度上线生产级站点,同时把每个细节做对。提示、检查、编辑、发布,全在一个地方,全新的节奏。代理和人并肩工作:代理带来速度和规模,你带来品味、判断和控制。作品落在画布上,始终可编辑。自定义代码组件、管理 CMS 内容、优化 SEO、审查问题,全在一处。企业级托管、安全和 99.99% 在线率的 SLA,Perplexity 和 Miro 这样的领先品牌都在用。今天就去 framer 点 com 斜杠 20VC 免费开始,Framer Pro 年付计划还能打七折。条款与限制可能适用。
References
- 120VC:Naveen Rao 单集页
thetwentyminutevc.libsyn.com
- 2
- 3
- 4Unconventional AI:Less is More
unconv.ai
- 5Polaris:AI Inference Market
polarismarketresearch.com
Comments