《GPT-3》:不更新参数怎样做新任务,规模为何成了前提
从「每个任务都要一份标注数据集」这笔账出发,拆解 GPT-3 的四档设定、八档模型与数据配方、评测协议里每一步在算什么,并用 LAMBADA、SuperGLUE 与污染检查的原始表格读懂它的成绩各自量的是谁。

2020 年 5 月 28 日,《Language Models are Few-Shot Learners》投到 arXiv,最后一次修订在同年的 7 月 22 日;同一年它发表在 NeurIPS 上,收录于 Advances in Neural Information Processing Systems 33。12
论文署名 31 人,全部来自 OpenAI;Tom B. Brown、Benjamin Mann、Nick Ryder、Melanie Subbiah 四人共同第一作者,Jared Kaplan 兼属约翰斯·霍普金斯大学。3
这篇论文给出的模型叫 GPT-3,1750 亿参数,论文说这是此前最大非稀疏语言模型的十倍。3 但标题的重心落在两个词上:few-shot。这批参数换来的东西,是模型在推理时读几个例子就能接手一个新任务。
下面的事实、表格与两张正文图都按 arXiv v4 这版 PDF 读。3
微调范式欠下的三笔账
当时的通行做法是预训练加微调:先在大量无标注文本上训练一个语言模型,再针对每个任务用标注数据更新它的权重。架构这一步已经做到了任务无关,代价却留在数据上——论文写的是,每个任务通常需要几千到几十万条标注样本。3
论文把跨过这一步的理由写成三条。第一条是任务数据本身难攒:从改语法到「给一个抽象概念举几个例子」,可用的语言任务极其分散,为每一个都建一份监督数据集既贵又要重来一遍。3
第二条关于基准成绩的可信度。模型的表达力越强、训练分布越窄,它利用数据里伪相关的能力就越强;论文引用的工作发现,更大的模型在分布外不一定泛化得更好。一个在窄基准上达到人类水平的微调模型,它在任务本身上的表现可能被高估。3
第三条是人作为对照:人做一件新的语言任务,靠一句指令,或者最多几个示例。论文想跨过的正是这一条——让模型靠一句描述或几个例子接手新任务,每个新任务都用不着再重训一遍。3
把任务规格放进上下文
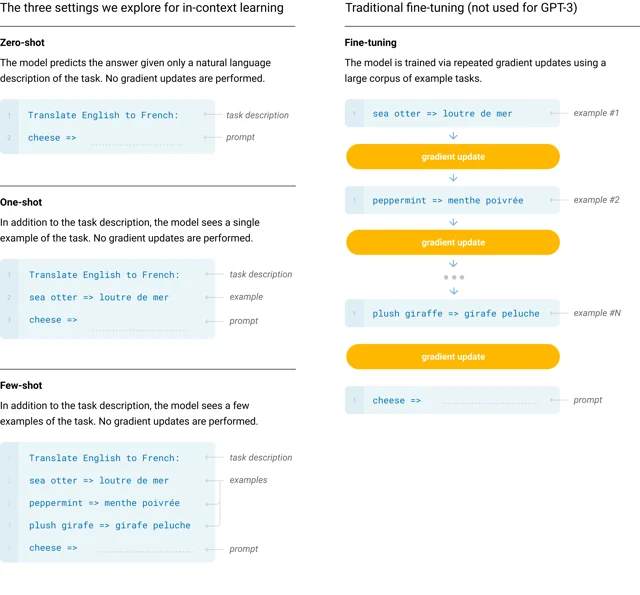
论文把可选的做法排在一条谱上,按「依赖多少任务专属数据」排序,一共四档。3 传统微调(fine-tuning)站在依赖最多的一端:用该任务的监督数据更新权重,通常动用几千到几十万条样本。另外三档都不更新权重,差别只在上下文里放几个例子。
zero-shot 只给一句任务描述;one-shot 在描述之外再给一个示例;few-shot 给若干示例。few-shot 的构造方式很具体:一个样例由「上下文」和「期望的完成」组成,K 个这样的样例依次排好,最后接一个只有上下文、缺完成的样例,让模型把完成补出来。K 通常取 10 到 100,这个范围由上下文窗口决定——论文里所有模型的窗口都是 2048 个 token。3
关键的分界线落在「有没有梯度更新」这一步。微调的每一对样例后面都跟着一次参数更新;另外三种设定里权重全程不动,任务的信息只存在于这一次前向读到的 token 里。论文给这个过程起名 in-context learning(上下文内学习),并把它解释成 meta-learning 的内层循环——外层是预训练时发生的学习,内层是每次前向里发生的适配。3
同一个脚注还纠正了一个旧叫法:这类方法常被称作 zero-shot transfer,可它在推理时经常要给出示例,名字与条件并不相符。这处澄清后面用得上:「不用梯度更新」与「不给例子」是两件事。
规模是怎么堆上去的
GPT-3 的模型与架构沿用 GPT-2,包括后者的初始化、前置归一化与可逆分词,改动只有一处:Transformer 的层里交替使用稠密注意力和局部带状稀疏注意力,后者的做法来自 Sparse Transformer。3
论文训了八个尺寸的模型,从 1.25 亿参数到 1750 亿参数,跨三个数量级,全部训练 3000 亿个 token;最小的一档上下文窗口也是 2048。3 这张表里最大的一档是 96 层、隐藏维度 12288、96 个注意力头,批次 320 万个 token。
训练混合由五份语料按比例抽成。3 过滤后的 Common Crawl 4100 亿 token 占 60%,WebText2 的 190 亿占 22%,Books1 的 120 亿占 8%,Books2 的 550 亿占 8%,Wikipedia 的 30 亿占 3%。
比例与语料大小并不成正比:作者认为质量高的语料抽得更频繁。训完 3000 亿 token 时,Wikipedia 的内容被看了 3.4 遍,WebText2 看了 2.9 遍,而 Common Crawl 只看了 0.44 遍——作者把这称为用一点重复换取更高的数据质量。3
算力账记在附录 D 的表 D.1 里:GPT-3 175B 的预训练用掉 3.64×10³ PF-days,最小的 GPT-3 Small 是 2.60;作为对照,RoBERTa-Large 是 49.3,T5-11B 是 382。3
图 2.2 的图注交代了这笔算力怎么分配:作者按规模律的结论,用比常规更少的 token 去训更大的模型。GPT-3 3B 比 RoBERTa-Large 大将近十倍,两者的预训练算力都在 50 PF-days 上下。34 图注里写的是 GPT-3 3B,表 2.1 里对应的一档是 2.7B,读的时候按同一档理解即可。
这里还有一处口径要留意:同一个模型,Table 2.1 与表 D.1 写的是 175.0B 与 174,600M,而第 2.4 节与附录 E 两处写成 200B。3 两套写法指的都是那一个 1750 亿参数的模型。
每一步在算什么:一份协议
这一篇没有一条编号公式。模型与目标沿用 GPT-2,作者用文字描述,把精确性放在评测协议里。3
训练目标仍是自回归地预测下一个 token:所有任务都被写成同一个条件概率的预测问题,用同一个目标训练,不针对任务改造。论文在第 5 节自己点出这个目标的一个性质——它对每个 token 一视同仁,没有「哪个位置更重要」的概念。3
评测一侧的几步决定了后面那些分数是在什么条件下取得的。few-shot 的示例从该任务的训练集里随机抽 K 个,用一到两个换行分隔;K 的取值先在开发集上试几个,再拿结果最好的那个跑测试集。3
多选题的做法是给 K 个「上下文加正确完成」的样例,再接一个只有上下文的样例,然后比较各个候选完成的对数似然。多数任务按每个 token 的似然做长度归一;在 ARC、OpenBookQA、RACE 三个数据集上,作者额外用无条件概率再归一一次:
分母里的 answer context 就是
Answer: 或 A: 这样的字符串,作用只是提示这里该填答案。二分类任务在这里被改写成多选题:选项名字从 0 和 1 换成 True 和 False 这类有语义的词。自由生成的题目用 beam search,beam 宽度 4、长度惩罚 α=0.6,计分用 F1、BLEU 或完全匹配。3报数规则同样写清楚了:有公开测试集就报测试集;测试集不公开、模型又大到传不上去时,报开发集。真正提交到测试服务器的只有 SuperGLUE、TriviaQA 和 PiQA 三个,并且只提交 175B 的 few-shot 结果。3
读完这份协议,后面每张表的边界就清楚了:同一张表里可能混排着开发集与测试集的结果,同一组对比里可能同时有闭卷与开放域两种口径。
成绩单要先看分母
先看整体趋势。图 3.1 把八个模型的验证损失按算力画出来,并额外收了六个最小只有 10 万参数的模型;曲线延续了规模律的幂律趋势,又往前延伸了两个数量级,偏离很小。3
论文另一张聚合图(Figure 1.3)把 42 个以准确率计分的基准汇总,发现 zero-shot 的成绩随规模稳步上升,few-shot 上升得更快,两者的差距随规模拉大。作者同时提醒,这张汇总图本身不宜当作一个严谨的基准来看。3
逐项看的时候,分母决定一切。LAMBADA 是长距离依赖的完形填空,GPT-3 的 zero-shot 是 76.2%、one-shot 72.5%、few-shot 86.4%,而此前的最优是 68.0%。3 这里的 few-shot 比前最优高了 18 个百分点以上,做法只是把任务改写成填空格式,让模型从示例里看出这里只要一个词。
闭卷问答的分母有两种,必须分开看。3 TriviaQA 上 GPT-3 是 64.3%、68.0%、71.2%,对照的闭卷最优 T5-11B+SSM 是 60.5%;那 68.0% 的 one-shot 成绩与 RAG 打平,而 RAG 是带检索、带微调的开放域系统,两者不在同一个口径上。WebQuestions 上 GPT-3 从 14.4% 跳到 41.5%,仍低于 44.7% 的闭卷最优;Natural Questions 是 29.9% 对 36.6%。作者把这两项从 zero-shot 到 few-shot 的大幅提升解释成分布偏移——问题风格对模型来说是陌生的。
阅读理解的成绩分布很宽。3 CoQA 是自由形式的对话问答,GPT-3 的 few-shot 拿到 85.0 F1,距人类基线不到 3 分;SQuAD 2.0 的 few-shot 是 69.8,比 zero-shot 高出近 10 个 F1,略微超过原论文里最好的微调结果;到了 RACE 这套中学与高中英语试题上,它落后当前最优 45%。语言建模那一边,Penn Tree Bank 的零样本困惑度是 20.50,此前的成绩是 35.8。3 完形与故事补全一类落在两端之间:HellaSwag 的 few-shot 是 79.3%,低于微调最优的 85.6%,而人的准确率是 95.6%;StoryCloze 的 few-shot 是 87.7%,比微调最优低 4.1 个百分点。3
SuperGLUE 这张表是这一节最值得细读的地方。3 GPT-3 在 few-shot 设定下拿了 71.8 的聚合分,微调的 BERT-Large 是 69.0,微调的当前最优是 89.0;每个任务固定给 32 个示例,全程没有梯度更新。
拆开看分项,聚合值盖住的东西就露出来了:WiC 上 GPT-3 是 49.4,BERT-Large 是 69.6,当前最优 76.1——49.4 已经贴在二分类的随机线附近;CB 的 F1 是 52.0,当前最优 93.9。另一头,COPA 上 GPT-3 拿到 92.0,只比当前最优的 94.8 低 2.8 分;ReCoRD 是 90.2 与 91.1。3 作者在第 5 节解释了这个分布:这几项需要回看并比较两段文字,而 GPT-3 只做单向的自回归,天然吃亏。
那些像「学会」的任务
论文另外造了一批任务,专门用来试探即时推理与快速适配,因为它们的答案形式很难在训练数据里原样出现过。3
算术是其中最直白的一组,共 10 项、每项 2000 道题,答案必须完全正确。few-shot 设定下,两位加法 100.0%、两位减法 98.9%、三位加法 80.4%、三位减法 94.2%;位数再往上掉得很快,四位数在 25% 到 27% 之间,五位数只剩 9% 左右,两位数乘法 29.2%,一位数复合运算 21.3%。作为对照,13B 那一档做两位加法只有一半的正确率。3
为了排除「把题背下来了」这一解释,作者拿 2000 道三位数加法去训练数据里搜了一遍,只找到 17 条匹配,减法只找到 2 条;错误答案里常见的是忘记进位这类计算性失误。3
字母重组一组更能说明适配的速度:把单词里的字符打乱再让模型还原,「随机插入字符」这项从 zero-shot 的 8.26% 升到 few-shot 的 67.2%,而模型权重始终没变过。3
SAT 类比题给出的参照更直观:few-shot 65.2%、one-shot 59.1%、zero-shot 53.7%,随机猜是 20%,而大学申请者的平均分是 57%。3
最受关注的一组结果是新闻生成的人工判别实验。3 作者从 newser.com 取了 25 条标题与副标题,平均长度 215 词,让四个规模的模型各生成一篇,再让约 80 名美国参与者逐篇判断是人写的还是机器写的。故意生成得很差的对照模型,被认出的准确率是 86%;GPT-3 175B 生成的约 200 词文章,准确率只有 52%,95% 区间 49% 到 54%。换成平均 569 词的路透社文章重做一遍,对照是 88%,GPT-3 是 52%。
这个实验量的是「人能不能分辨」,读的时候要带着两层限定。文章是否准确在它的测量范围之外:论文自己说,事实性错误反而是辨认线索之一,模型没有那些具体事实,只能照题目的语气编。另一层限定关于长度:同一位参与者在更长的文本上判断力会上升,而这里给的都是短稿。3
污染:作者自己往下修成绩
训练语料是全网的文本,测试集的内容本身很可能就在里面。论文把这件事当成一项专门的工程来做,做法是造一个「干净子集」:凡是与预训练数据存在 13-gram 重叠的样本(短于 13-gram 的例子则按整体比对)一律剔掉,再在干净子集上重测一遍,比较两次分数的差。3
被标记的规模不小:近四分之一的基准,可能受污染的样本比例超过 50%。但多数基准上分数的变化很轻微,作者因此判断,要么这套保守的判据高估了污染,要么污染对成绩的影响本来就不大。3
少数几处的处置值得单独记下来,因为它示范了三种不同的处理。PIQA 有 29% 的例子被标记,干净子集上的成绩掉了 3 个百分点(相对下降 4%),作者在结果上加星号;Winograd 有 45% 被标记,掉了 2.6%,人工查看后发现 132 条 Winograd 模式确实在训练集里,也加了星号。四个 Wikipedia 语言建模基准与儿童读物测试集几乎整份都在训练数据里,构造不出干净子集,作者干脆不报这些结果,改用年代久远的 Penn Tree Bank 作主要语言建模基准。3
还有一类是高污染、低影响的,比如 LAMBADA:它的训练集重叠是实打实的,但干净子集与全集的成绩差在 0.5% 以内,而填空格式本身也从结构上排除了最简单的记忆方式。作者仍在这一节里注明了它的污染风险。3
这一节末尾作者自己写下了这套方法的限度:他们无法确定干净子集与原始集是否同分布,所以「污染抬高了分数」与「统计偏差让干净子集更容易」这两种相反的效应不能完全排除。3 一篇论文主动把自己的成绩往下修,并且把做不到的部分写明白,这件事本身是读大模型基准时要带走的一课。
论文自己写下的局限
第一条是长文合成。3 句级质量高,但到了文档级,样本会语义上重复自己、在足够长的段落里失去连贯、前后矛盾,偶尔出现与上下文无关的句子。
第二条关于架构选择:只做自回归,没有双向架构,也没有去噪之类的其他目标。3 作者认为这解释了它在 WiC、ANLI 以及部分阅读理解任务上的落后,并预测一个同等规模的双向模型在微调上会更强。
第三条指向自监督目标本身。3 现在这个目标给每个 token 同样的权重,没有「哪些更值得预测」的概念;任务规格要硬塞成一个预测问题;模型也没有视频或物理交互这类接地,缺少关于世界的经验。论文由此判断,单纯把自监督预测做大可能会撞上上限。
第四条是预训练的样本效率:人一生读到的文本远少于模型在预训练里读到的量,作者把它列为下一步要改的地方。3
第五条最值得留意,因为它是作者自己承认的不确定:few-shot 究竟是在前向里从零学会一个新任务,还是认出了预训练时见过的一个任务?3 论文说这在本篇里无法判定,并指出不同任务可能落在这条谱的不同位置——字母重组、给生造词造句子更像是真的在前向里学会,而翻译必然来自预训练,只是数据形式与测试时不同。
第六条是工程与部署:这个规模上的推理既贵又不方便,蒸馏是可以探索的方向;模型还带有大多数深度学习系统共有的问题——难以解释、在陌生输入上校准不佳、以及继承了训练数据中的偏见。3
能耗单列在一节里:预训练消耗了数千 PF-days,是 15 亿参数的 GPT-2 的几十倍。作者同时给出另一侧的账——用训练好的模型生成 100 页内容,能耗在 0.4 千瓦时这个量级,电费只有几美分。3
后来被换掉的是哪几格
把这篇论文拆成几个可以替换的位置,后面几年的变化就能一句话定位到它换了哪一格。3
第一格是任务规格放在哪里:改参数,还是放进上下文。这一篇给的是后一个答案,代价是成绩还差微调一截;后来的工作把两条路合了起来,先在示例上做监督微调,教模型「按指令作答」这件事本身,再让它靠提示接手新任务。5
第二格是规模配方:用多大的模型配多少 token。这一篇按规模律的思路选了「大模型配相对少的数据」,图 2.2 的图注把这一点写得很清楚。4 后来的工作把同一笔算力下的参数与数据配比重新搜了一遍,结论是两者应当同比例放大;用同样算力训出的 700 亿参数模型,在大量下游任务上超过 2800 亿的 Gopher 与 1750 亿的 GPT-3。6
第三格是目标函数从哪来。7 论文在第 5 节点名了三条出路:从人那里学目标函数、用强化学习微调、加入图像等其他模态做接地。第一条后来落成了用人类偏好训练奖励模型再微调语言模型的做法,也就是后来被称为 RLHF 的那条路线。5
第四格是评测与污染怎么管。这一篇把 13-gram 干净子集、加星号与不报结果三种处置写进了正文,之后做基准测试时先查训练集与测试集的交集,逐渐成了常规动作。3
这四格是四份各自独立的后续工作给出的答案,各自换掉的是同一篇论文里的一个位置。按格子看,比把它们串成一个「大模型时代」的说法要更有用。
读完留下的判断维度
一,先找那条「更新发生在哪一步」的边界。这一篇把梯度更新从推理里拿掉,整个方法的性质就变了;读任何靠提示做事的系统,先问清它在哪一步改动了什么。3
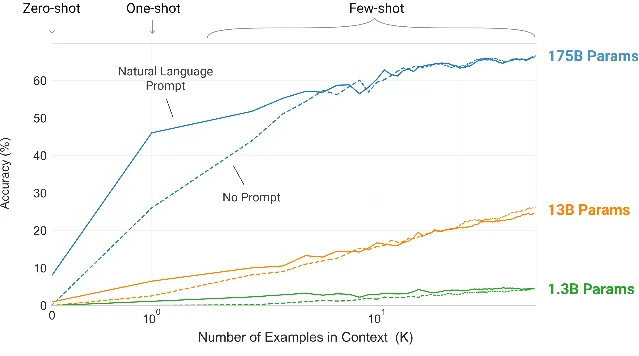
二,看曲线的斜率,而不只是终点。同一个任务上,规模换来的主要是从上下文里取信息的效率,图 1.2 里三条曲线的差别就在斜率上。3
三,聚合分数要拆开看。SuperGLUE 的 71.8 旁边站着 WiC 的 49.4,一个平均值同时装着超越 BERT-Large 的分项和贴在随机线上的分项。3
四,大模型的基准成绩要先过污染这一关,并且检查论文有没有交代处置方式:造干净子集、加星号、还是不报结果。3
References
- 1
- 2
- 3
- 4
- 5
- 6
- 7
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.