10月12日-10月18日大模型发布追踪:Muse Wonder、Argon 全量开放与 GLM-Legal
本期核对 10 月 12 日至 10 月 18 日的发布,比较 Meta 首次进入前沿的 Muse Wonder 系列与开放权重的 Muse Spark Open、Gemini 4 Argon 的全面开放,以及智谱 GLM-Legal 与 DeepSeek 同价升级的实际得分。

覆盖窗口是 2026 年 10 月 12 日至 10 月 18 日(UTC+08:00)。
这一周 Meta 第一次把自己放进前沿。10 月 12 日它发布 Muse Wonder 与 Muse Wonder Full,第三方评测记为智力指数 52 与 56;三天后又开放 Muse Spark Open 的权重,一个 8160 亿参数的模型。同一周 Google 把 9 月 30 日只在限制名单里发放的 Gemini 4 Argon 推给全球开发者。
国内两家走的是另一条路。智谱 10 月 12 日发布 GLM-Legal,把 GLM-5.3-Flash 压成一个只做法律工作的开放权重模型,用 0.15 美元一次的评测成本挤进 Harvey LAB 前十。DeepSeek 10 月 17 日把 V4.1-Flash 升到 1017 版本,价格一分没动。
文中的「智力指数」是第三方机构 Artificial Analysis 用十项评测加权得到的综合分;「每任务成本」是跑完这套评测平均每次任务的花费,输入、缓存、推理与输出的 token 价格都算在里面。Harvey LAB 是 Vals AI 维护的法律智能体基准,采用「全通过」评分:一项任务里识别争点、引用法条、构建论证、按格式交付,任何一环出错整题记零分。同一家机构的 Vals Index 把金融、法律、税务与编码等专业任务合成一个总分,用来排模型在真实职业工作里的位置。
先看价格、状态和边界
| 模型与发布 | 发布与定位 | 关键变化 | 评测信号 | 价格与可用性 | 先测什么 |
|---|---|---|---|---|---|
| Muse Wonder 与 Muse Wonder Full 1 | 10 月 12 日发布;Meta 超级智能实验室的首个前沿模型系列,官方定位是个人与职业智能体 | 两者均为 1M 上下文,输入支持文字、图像、语音、视频,输出只有文字;主打 Active Memory(跨会话记住用户信息)与 Active Focus(长任务里换方法、绕开阻塞);Wonder 走 Meta 一方 API 与 Muse Code,Full 只给 Muse Code 订阅者 2 | 智力指数 Wonder 52、Full 56,六周前的 Muse Spark 1.3 是 48;Full 在十项评测里六项进前三,Terminal-Bench 4.0 由 33% 升到 57%;知识类偏弱,AA-Omniscience 为 30 与 25 3 | Wonder 每百万 token 输入 $4、缓存输入 $0.20、输出 $20,每任务 $4.52;Full 未公布按 token 价格,Vals 按同一价格估出每测 $8.56 4;首 token 延迟 33.8 秒,单次评测耗时 37 至 57 分钟 | 用自家最长的几类任务量一次真实 token 消耗:Wonder 每任务输入 token 是同类模型的 2 至 7 倍,省钱的路径在减少重试 |
| Muse Spark Open 5 | 10 月 15 日开放权重;Meta 称其为迄今最强的美国开放权重模型 | 816B 总参、42B 激活的原生多模态 MoE,1M 上下文;权重放在 Hugging Face、SageMaker AI、Google Cloud Model Garden 与 Microsoft Foundry;两台 M5 Ultra Mac Studio 可在本地跑起来 6 | 智力指数 39,在美国开放权重里排第一,低于 GLM-5.3 的 45、Kimi K3 的 44 与 Qwen3.8-Max 的 45;AutomationBench 类任务强,Terminal-Bench 4.0 只有 8.1% 7 | API 每百万 token 输入 $1.25、输出 $4.25,缓存输入折 88%,每任务 $0.84;Muse Model License,商用允许但附条件 | 先逐条读许可条款;自建按 816B 的显存预算估算,桌面能跑不等于推理便宜 |
| Gemini 4 Argon 全面开放 8 | 10 月 13 日;9 月 30 日发布时只对部分企业、研究方与 Fairwind 计划开放,本期推向全球开发者与消费者 | 1M 输入输出统一上限,配一套长解码续写协议;Google 称其在 Vals Index 排第一,ERQA 具身推理 87%;Fairwind 计划同日扩到数百家防守方 | 智力指数 53(high 档),每任务 $1.99;幻觉率 15%,是智力 45 分以上模型里最低的一个 | 入门价每百万 token 输入 $2、输出 $10,缓存输入减 95%;2026 年 11 月 30 日之后转为 $4 / $20;开发者走 AI Studio 与 Gemini 平台,应用侧给 AI Ultra 与 Pro 订阅者 | 在 11 月 30 日之前量出真实 token 用量,再决定涨价后哪些任务要降档 |
| GLM-Legal 9 | 10 月 12 日;基于 GLM-5.3-Flash 的法律垂域模型,开放权重 | 中期训练灌法律语料,后训练在数万个法律任务环境里做强化学习,与 Agent Harness 双向迭代;文本输入,1M 上下文、128K 最大输出 10 | Harvey LAB 全通过率 19.2%,基座 6.7%、Kimi K3 12.9%、GPT-6 Astra 5.4%;LegalBench 86.2、PLawBench 77.3;Vals 独立记录 Harvey 第 7(共 79 个)、LegalBench 第 14(共 150 个) | Beta 阶段需申请 API,正式价格未公布;Vals 记录按量价每百万 token 输入 $0.075、输出 $0.25,Harvey 每测 $0.15,是前十名里最便宜的 | 拿一份真实合同跑端到端,重点看条款能不能落到可签字的文本,以及 37 分钟延迟放不放得进工作流 |
| DeepSeek V4.1-Flash-1017 11 | 10 月 17 日;同一模型名下的版本升级,API 与网页端同步 | 调用方式与价格不变,任务耗时与输出长度下降;同时开放自建搜索引擎的搜索与抓取 API | HLE 无工具 42.6(上一版 36.8)、Terminal-Bench 4.0 42.3(31.2)、DeepSWE v1.1 77.0(74.2)、ProgramBench 29.1(20.3)、Automation-Bench 60.5(54.8) | 缓存未命中输入每百万 token 高峰 $0.30、非高峰 $0.15,输出高峰 $1.20、非高峰 $0.60;搜索与抓取每千次成功请求 $0.75,经官方 Harness 等调用在 11 月 1 日前免费 12 | 原来跑过的评测集值得重跑:同价位的分数抬了 7 到 11 个点,上一轮被刷掉的任务可能已经够了 |
注:价格按美元或人民币原币列示,不做汇率换算。表格「评测信号」一列把厂商自报与第三方独立数据分列,两者口径不同;「每任务成本」是跑完智力指数的加权平均,和厂商按单个基准算出的每测成本不能直接相比。
Meta:第一次站到前沿,落在第一名后面两分
Muse Wonder 与 Muse Wonder Full 在 10 月 12 日发布,是 Meta 超级智能实验室第一次拿出能和前三家放进同一张表的模型。两者的上下文都是 1M,输入支持文字、图像、语音与视频,输出只有文字。1
官方把它们定位成给个人与职业智能体用的模型,两个机制被反复提到。Active Memory 让模型跨会话记住用户的偏好与背景,Active Focus 让它在长任务里换方法、绕开阻塞,并在执行重要动作前先确认。2
第三方给出的位置更清楚。Artificial Analysis 记录 Wonder 的智力指数是 52,Full 是 56;同一家机构六周前记录的 Muse Spark 1.3 是 48。
Full 在十项评测里六项进前三:CritPt 33% 与 GDP.pdf 33% 是两个第一,GDPval-AA v2.1 以 1857 Elo 排第二,AA-Briefcase 1729 Elo、AutomationBench 71%、SciCode 63% 排第三。提升最大的是终端操作,Terminal-Bench 4.0 从 33% 升到 57%,与 Gemini 4 Argon 的 high 档持平。3
放到整张榜上看,56 分仅次于 Claude Opus 5.5 的 58 分,与 Claude Sonnet 5.5 并列第二。Wonder 的 52 分与 GPT-6.1 Sol 相同,低于 Gemini 4 Argon、GPT-6 Astra 与 Claude Fable 5.1 的 53 分。Meta 一步跨进了前沿队列,Wonder Full 站到了第二位。13
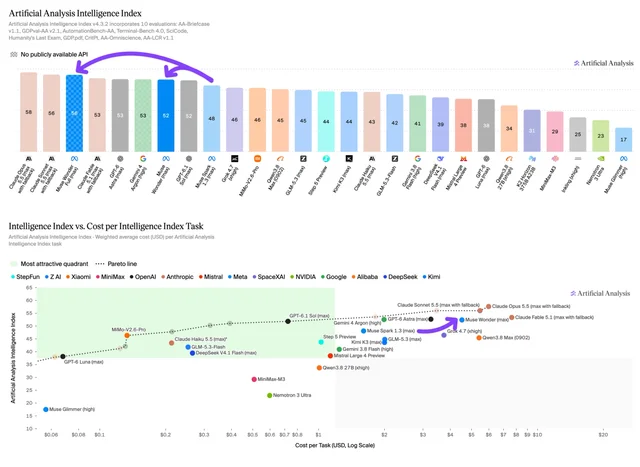
弱项在知识类。AA-Omniscience 上 Full 得 30 分、Wonder 得 25 分,低于 Claude Opus 5.5 的 46、GPT-6 Astra 的 43 与 Gemini 4 Argon 的 42。分数低的原因在答得保守:Full 的幻觉率 23%,是智力 45 分以上模型里第二低的,Wonder 为 27%。3
成本是这一组模型最容易被忽略的地方。Wonder 每百万 token 输入 $4、缓存输入 $0.20、输出 $20,单价比上一代 Muse Spark 1.3 的 $1.25 / $4.25 高出三倍多。每个任务平均吃掉 769 万输入 token,是 Gemini 4 Argon、GPT-6.1 Sol 与 GPT-6 Astra 这一组的 2 到 7 倍,每任务因此来到 $4.52,约是 Muse Spark 1.3 的 2.8 倍、Gemini 4 Argon 的 2.3 倍。3
Vals AI 的记录补上另一面。Full 在 Vals Index 上以 64.57% 排第 5,Wonder 以 61.06% 排第 10;Wonder 在 CyberBench v1.1 上以 80.36% 排第一,Full 在 Harvey LAB 上以 21.67% 排第四、LegalBench 87.42% 排第四,在 ProgramBench 上只有 0.50%。414
两家机构对 Full 的价格记录不一致。Artificial Analysis 写它不按 token 计费,因此没有每任务成本;Vals AI 按与 Wonder 相同的 $4 / $20 估算,得出每测 $8.56。15
时间上还有一条要记。Artificial Analysis 测到 Wonder 的首 token 延迟是 33.8 秒,Vals 记录单次评测平均耗时 37 分钟,Full 为 56 分钟。这组模型适合让它在后台跑长任务,不适合等一句话的场景。15
Meta:把美国最强的那套开放权重也放出来
三天后,10 月 15 日 Meta 开放了 Muse Spark Open 的权重,称其为迄今最强的美国开放权重模型。它是 8160 亿总参、每 token 激活 420 亿的 MoE,原生多模态,1M 上下文。权重放在 Hugging Face、Amazon SageMaker AI、Google Cloud Model Garden 与 Microsoft Foundry,推理可走 Baseten、Fireworks、Groq、Modal、Nebius、OpenRouter 与 Together。5
「美国最强」这个限定词决定了它的位置。Artificial Analysis 记录它的智力指数为 39,高于同一天发布的 NVIDIA Nemotron 3.5 Super VL(26)与第二天的 Reflection Beam(30);放到全球开放权重里,它低于 GLM-5.3 的 45、Kimi K3 的 44 与 Qwen3.8-Max 的 45。71617
它最特别的一项能力在本地。Meta 用两台各带 512GB 统一内存的 M5 Ultra Mac Studio,配合 MLX 框架把整个模型跑在桌面上,并演示了用它改一个开源 iOS 应用、逐帧剪片。演示说明 8160 亿参数的模型已经能落进桌面级设备,推理速度与量产的每 token 成本另算。5
按标准 API 走,每百万 token 输入 $1.25、输出 $4.25,缓存输入折 88%,每任务 $0.84;首 token 延迟 0.8 秒,输出速度 141 token/秒,都比同价位模型快。许可为 Muse Model License,允许商用并附条件,做产品前要逐条读。67
Google:Argon 从限制名单走到所有人
Gemini 4 Argon 在 9 月 30 日发布时只开了小口子:企业、部分研究方和 Fairwind 计划的网络安全防守方。10 月 13 日 Google 把它推到全球——开发者用 AI Studio 与 Gemini 平台的付费档调用,企业走 Gemini for business,普通用户在 Gemini 应用与搜索的 AI Mode 里由 AI Ultra 与 Pro 订阅拿到。8
价格在开放当天给的是入门价:每百万 token 输入 $2、输出 $10,缓存输入减 95%;2026 年 11 月 30 日之后改为 $4 / $20。同一篇公告还写了一条对外部使用者最实在的参数:1M 的输入输出统一上限,配一套新的长解码续写协议,长任务可以在同一个请求里连续写下去。8
这一轮最有说服力的材料来自 Google 自己的工程团队。Chrome 团队用它把约 600 万行的旧浏览器功能目录从核心网页处理里拆出来;ADK 团队给它一份规则手册和一句目标,它整夜跑出把长会话预处理提速 40%、冷启动导入提速 21% 的改动,已合并进 google/adk-python;xTB 量子化学包的结构预测快了 2.3 倍。8
评测侧,Artificial Analysis 记录 Argon 的智力指数 53、每任务 $1.99、幻觉率 15%,是智力 45 分以上模型里最低的一个;Google 自己引用的 Vals Index 上它排第一,ERQA 具身推理基准上以 87% 领先。818
Fairwind 计划同日扩编到数百家防守方,这批机构拿到的是去掉网络护栏的同一款模型。8
智谱:把通用模型压成一个法律专家
10 月 12 日智谱发布 GLM-Legal,底座是 8 月 26 日上线的 GLM-5.3-Flash(320B 总参、18B 激活)。
做法分两步。中期训练灌入高质量法律语料,把法律概念、成文规则与解释框架吃进底座;后训练在数万个法律任务环境里做强化学习,并与 Agent Harness 双向迭代——训练里暴露的边界情况改进 Harness,Harness 的改动又反过来塑造模型。9
它交出的成绩集中在 Harvey LAB。这个基准模拟律所工作流,覆盖 24 个执业领域,采用全通过评分:识别争点、引用法条、构建论证、按规定格式交付,任何一环出错整题零分。GLM-Legal 拿到 19.2%,比基座 GLM-5.3-Flash 的 6.7% 高 12.5 个百分点。同一张官方图里,Kimi K3 是 12.9%,Claude Fable 5 是 11.3%,GPT-6 Astra 是 5.4%。9
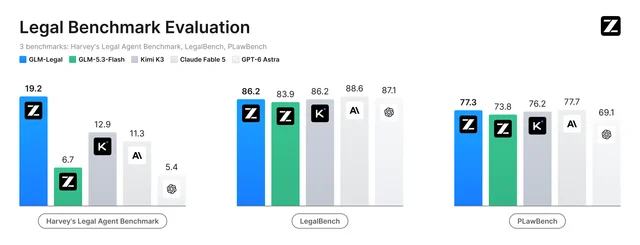
另外两项基准上它的位置不同。LegalBench 的 86.2% 与 Kimi K3 的 86.2% 持平,低于 Claude Fable 5 的 88.6% 与 GPT-6 Astra 的 87.1%;PLawBench 的中文法律任务上它拿到 77.3%,与 Claude Fable 5 的 77.7% 相差 0.4 个百分点,把 GPT-6 Astra 的 69.1% 拉开 8 分。三项合起来说明它的强项在中文实务与端到端交付,条款级解析与前沿闭源模型同一水平。9
Vals AI 的独立评测把名次和价格一起给了出来。Harvey LAB 上它排第 7(共 79 个模型),每次评测花 $0.15,是前十名里最便宜的;LegalBench 86.24% 排第 14(共 150 个),Legal Research Bench 41.83% 排第 24(共 78 个)。同一份记录里,它的单次评测延迟是 37 分钟。10
获取方式目前是 Beta。官方开放 API 申请,之后接进桌面端的 AutoClaw,直接在 Word 里出修订与批注。Vals 记录的按量价是每百万 token 输入 $0.075、输出 $0.25;智谱自己的发布页还没有给正式价格。910
DeepSeek:同一个价格,把跑分再抬一档
10 月 17 日 DeepSeek 把 V4.1-Flash 升到 1017 版本,模型名仍是
deepseek-flash,调用方式与价格都不变,网页端与 App 同步更新。11分数是这一轮的重点。与 9 月 10 日的上一版相比,HLE 无工具从 36.8 升到 42.6(纯文本子集 44.0),Terminal-Bench 4.0 从 31.2 升到 42.3,DeepSWE v1.1 从 74.2 升到 77.0,ProgramBench 从 20.3 升到 29.1,NL2Repo-Bench 从 65.4 升到 68.2,Automation-Bench 从 54.8 升到 60.5,Agents' Last Exam 从 31.8 升到 35.4。官方同时说任务耗时与输出长度都降了。11
价格没动:缓存未命中的输入每百万 token 高峰 $0.30、非高峰 $0.15,输出高峰 $1.20、非高峰 $0.60,缓存命中 $0.006 与 $0.003;1M 上下文、384K 最大输出。高峰时段按 UTC 时间的 01:00—04:00 与 06:00—10:00 划出,周末与中国法定假日全天按非高峰计。12
同一份更新里还开了自建搜索。DeepSeek 的网页与 API 搜索原本由内部引擎承担,现在对外开放搜索与抓取接口,每千次成功请求 $0.75;经 DeepSeek Harness、Claude Code 或 Codex 调用时暂时免费,2026 年 11 月 1 日 0 点(北京时间)起按次收费。1219
配套要求也写进了发布说明:官方建议把 DeepSeek Harness 升到 0.2.1-rc.1 以上,并说明这次针对 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 做了专门优化。同一个模型在不同 harness 里的分数差别,这一条讲得很直白。11
本期其他条目
OpenAI:GPT-Live 可以用一句话生成音色
10 月 16 日 OpenAI 给 GPT-Live 开放 prompt-to-voice:用一段文字描述生成自定义音色,在 API 或语音 Playground 里建好,之后在 GPT-Live 会话里复用。生成音色本身免费,语音合成按常规会话计费;同日加了九种自然音色,覆盖德语、法语、印地语、日语与韩语。
前一天 10 月 15 日,GPT-Live 接上了 Decisions 的本地调用,应用可以在用户说话的当下执行分支,或读取转写增量触发决策。这一周 OpenAI 没有发布新模型,另一条官方消息是给美国高校实验室的 GPT-Rosalind 学术计划,最多 30 个免费席位、为期一年。2021
Reflection:第一个模型 Beam 排到美国开放权重第二
10 月 16 日 Reflection 发布 Beam,5010 亿总参、230 亿激活,1M 上下文、纯文本。智力指数 30,在美国开放权重里只低于 Muse Spark Open 的 39,全球排第十,落后阿联酋 K2 Horizon 的 31 一分。它每个任务只输出约 2.6 万 token,是同级里最省的一档;AutomationBench-AA 48.5%,Terminal-Bench 4.0 只有 3.0%。17
英伟达:Nemotron 3.5 Super VL 与 Bolt 74B A9B
10 月 15 日英伟达发布两款开放权重模型。Super VL 得分 26,当天它是美国开放权重里的第一;随后的 Muse Spark Open(39)与 Reflection Beam(30)发布后,它落到第三。Bolt 74B-A9B 得分 21,Artificial Analysis 暂无成本数据。16
xAI:Grok Voice 3.0 同价替换 2.0
10 月 14 日 xAI 上线
grok-voice-3.0,支持语音到语音,价格与 Grok Voice 2.0 相同;grok-voice-latest 已指向新版本,用别名的会话自动升级。同一天 Grok Voice 2.0 进入弃用状态。22Anthropic:小模型在物联网设备上自我复制的研究
10 月 12 日 Anthropic 的前沿红队发布一组实验:9B 级模型在他们测试的 9 类硬件上有 8 类把推理跑了起来。15 台约 55 美元的杂牌 Android 电视盒子拼起来,能让一个 26B 模型以每秒 0.39 个 token 运行。
30B 以下的模型能完成复制的多数单步,端到端串联仍会出错;在简化评测里 GLM-5.2 及更强的模型已经能跑完整个复制链。这一周 Anthropic 没有发布新模型。23
通义:Qwen-MT-Lumen 把参赛翻译模型开源
10 月 14 日阿里 ATH MaaS 与 Qwen 团队把 WMT26 的参赛模型 Qwen-MT-Lumen 放上 Hugging Face。它是 Apache 2.0 许可的 148 亿参数稠密模型,基于 Qwen3-14B,覆盖 WMT26 全部 23 个翻译方向,上下文只有 4096 token。
论文给出的整体均分是 4.60(1—5 分制),并称在翻译质量与指令遵循上接近领先闭源系统。据快科技报道,阿里提交的两套系统在受限赛道与全赛道分列综合第一,23 个方向里拿到 18 项第一。242526
本期未纳入条目与覆盖说明
本期严格执行 2026 年 10 月 12 日至 10 月 18 日的时间窗核验,各厂商的筛查结果如下。
- OpenAI:窗口内没有模型级发布。API 变更日志只有 GPT-Live 的两条功能更新,官网发布页是客户案例与学术计划。20
- Anthropic:窗口内没有新模型,官方新闻页最新几条是新加坡办公室、独立评测方更新与公益基金。27
- 月之暗面:开放平台的模型列表仍是 Kimi K3、K2.7 Code 与 K2.6,K3.1 到 10 月 18 日没有上线。28
- MiniMax:官网模型列表仍是 M3、M2.7、M2.5 与 Speech 2.8 等既有条目,窗口内没有出现新的模型名。29
- 智谱:官方发布记录页最近一条仍是 8 月 26 日的 GLM-5.3-Flash;本期的 GLM-Legal 走的是 Z.ai 研究博客与 AutoClaw 渠道,未进那张表。30
- Artificial Analysis 收录:窗口内新收录的是 Muse Wonder、Muse Wonder Full、Muse Spark Open、GLM-Legal、Reflection Beam 与英伟达 Nemotron 3.5 两款。18
面向技术选型的三项行动建议
- Meta 这一组先算成本,再谈能力。 Wonder 每百万 token 输入 $4、输出 $20,每任务 $4.52;Full 只走 Muse Code 订阅,没有单独报价。想用它的人,先用自家最长的几类任务量一次真实 token 消耗,再和每任务 $0.72 的 GPT-6.1 Sol、$1.99 的 Gemini 4 Argon 比。315
- 垂域模型按「每测成本 × 延迟」两个数字决定接不接。 GLM-Legal 在 Harvey LAB 上 19.2%、每测 $0.15,是前十名里最便宜的,代价是单次评测 37 分钟。合同审阅这类可以排队跑的活,值得先接一个试点;要即时回答的场景留给通用模型。10
- 同价升级的那一类,先重跑自己的评测集。 DeepSeek 这次没有改价,Terminal-Bench 4.0 与 ProgramBench 分别抬了 11.1 与 8.8 个百分点;上一轮因为分数不够被刷掉的候选任务,这一轮值得重新进一次测试集。11
References
- 1Meta:Muse Wonder 前沿模型
research.meta.ai
- 2Meta 新闻室:推出 Muse Wonder 系列
about.fb.com
- 3Artificial Analysis:Muse Wonder 与 Muse Wonder Full
artificialanalysis.ai
- 4Vals AI:Wonder Full
vals.ai
- 5Meta:Muse Spark Open 开放权重
research.meta.ai
- 6Hugging Face:Muse-Spark-Open-816B-A42B
huggingface.co
- 7Artificial Analysis:Muse Spark Open
artificialanalysis.ai
- 8Google:Gemini 4 Argon 面向所有人
blog.google
- 9智谱:GLM-Legal
z.ai
- 10Vals AI:GLM Legal
vals.ai
- 11DeepSeek API 更新日志
api-docs.deepseek.com
- 12DeepSeek:模型与价格
api-docs.deepseek.com
- 13Artificial Analysis:Muse Wonder 模型页
artificialanalysis.ai
- 14Vals AI:Wonder
vals.ai
- 15Artificial Analysis:Muse Wonder Full 模型页
artificialanalysis.ai
- 16Artificial Analysis:Nemotron 3.5 Super VL 与 Bolt
artificialanalysis.ai
- 17Artificial Analysis:Reflection Beam
artificialanalysis.ai
- 18Artificial Analysis:模型发布列表
artificialanalysis.ai
- 19DeepSeek:搜索与抓取指南
api-docs.deepseek.com
- 20OpenAI API 变更日志
developers.openai.com
- 21OpenAI:GPT-Rosalind 学术计划
openai.com
- 22xAI:发布说明
docs.x.ai
- 23Anthropic:AI 模型可能无需数据中心即可自我复制
anthropic.com
- 24arXiv:Qwen-MT-Lumen 在 WMT2026
arxiv.org
- 25Hugging Face:Qwen-MT-Lumen
huggingface.co
- 26凤凰网转快科技:WMT26 赛果
feng.ifeng.com
- 27Anthropic 新闻页
anthropic.com
- 28Kimi 开放平台:快速开始
platform.moonshot.cn
- 29MiniMax 新闻
minimax.io
- 30智谱:模型与产品发布记录
docs.bigmodel.cn
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.