引用要验真、共识会抢跑、分块看截止:9 月 7–13 日三篇大模型论文
导读 9 月 7–13 日新挂出的三篇论文:学术引用如何从相似度匹配转向逻辑验真,推理模型为何不能把中间共识当作早停依据,以及长文本推理服务如何按截止时间动态切分预填充。

本期覆盖 2026 年 9 月 7 日至 9 月 13 日 在 arXiv 首次公开的大模型相关论文。三篇论文分别聚焦学术引用的证据保真、复杂推理的早停判据,以及长文本高并发下的在线服务调度。挑选的标准依然是:问题说得清,方法可复现,实验结论能直接转成工程师与产品团队可执行的判断。
本期三篇
| 论文 | 方法类型 | 一句话结论 | 提交日期 |
|---|---|---|---|
| ReCite: Agentic Reasoning for Faithful Citation | 意图感知与反思验证的引用智能体 | 把文献引用从语义重叠转向主张级推理与自我纠错,在严格引用准确率上取得 39.15% 的 F1 值,超过千亿参数大模型。1 | 9 月 8 日 |
| Stable Answers, Unfinished Reasoning: Why Self-Consensus Is Not a Safe Early-Exit Signal | 推理模型早停协议评测 | 扫描 3,520 条自我共识早停规则无一通过安全与节省门槛,答案过早稳定往往只是占位符,强行截断会导致模型失去纠错机会。2 | 9 月 9 日 |
| Deadline-Aware Adaptive Prefill Chunking for Efficient Large Language Model Serving | 截止时间感知的自适应分块调度 | 依据最早活跃解码请求的时间预算动态选择最大输入分块,长文本场景的合规吞吐量相比最优固定分块提升 38%,并消除了离线调参。3 | 9 月 7 日 |
1. 论文都真实存在,为什么模型引用的证据还是错的?
元信息
ReCite: Agentic Reasoning for Faithful Citation
作者:Yuyang Huang、Bobo Li、Jiajia Song、Yuzhe Ding、Chong Teng、Fei Li、Donghong Ji
论文:arXiv:2609.09156v1 · 2026 年 9 月 8 日提交 · cs.CL。1
要解决什么问题
现在的学术助手写正文时,虚构不存在的论文已经少见,但另一个问题越发突出:模型引用的论文在现实中确实存在,可是论文里的内容根本无法在逻辑上支撑它前后的论断。
这个现象叫作“错误归因”(misattribution)。传统的检索增强生成(RAG)主要依赖语义向量相似度:只要某篇文献与当前段落的主题词高度重合,检索模块就会把它召回并贴在句子后面。单向流水线一旦在检索阶段引入了不相关的论文,生成模型只能照单全收,无法在发现证据链不成立时退回去重新寻找。作者提出,引用的核心在于“推理”与“证据验证”,而非单纯的文字相似度匹配。4
方法是什么
ReCite 提出了一个将引用拆解为三个步骤的轻量级智能体框架,底层基于 Qwen3-4B-Instruct 模型训练。4
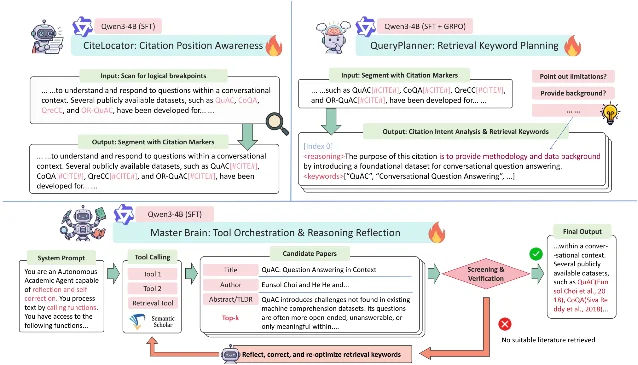
第一个模块是 CiteLocator(位置感知器)。该模块把定位形式化为序列恢复任务,扫描段落并标出哪些位置需要引用,同时判断引用的必要性属于强制还是可选。4
第二个模块是 QueryPlanner(查询规划器)。针对确定要引用的位置,模型结合上下文推导出具体的引用意图(例如提供基准数据集、指出前人局限或借用评估协议),随后生成精准的学术关键词,调用外部学术数据库检索候选文献。4
第三个模块是 Master Brain(主脑编排与反思验证)。系统拿到候选论文后,逐一对比候选论文摘要与待支撑声明的逻辑对应关系。如果发现候选文献无法提供实质性证据,主脑会触发“反思重检索循环”:分析检索漂移的原因,把搜索词从宽泛的领域词细化为具体实体,重新拉取文献直至证据完全闭合。4
结果说明了什么
作者从顶会论文中抽取了 200 个不相交的学术段落(包含 1,023 篇测试论文)作为评测基准,将 ReCite 与多种商业大模型和通用智能体进行严格对比。4
在端到端的严格匹配 F1 指标上,经过意图微调的 ReCite-SFT 达到 39.15%,大幅领先 DeepSeek-V4-Pro、Qwen3.6-Plus 等千亿参数级闭源模型以及 Claude Code 等端到端智能体;其宽松 F1 达到 55.14%,位置识别 F1 达到 89.71%。4
在位置预测消融实验中,CiteLocator 的综合 F1 达到 66.37%,明显高于未经专门定位微调的基线模型。实验还证实,通用代码智能体由于缺乏特定任务的反思循环,在面对检索漂移时很难自发纠偏。这说明把学术引用解耦成“意图推导—外部检索—主张验证”可以显著压低虚假引用的比例。4
读完可以带走什么
构建涉及专业事实引用的系统时,不要把相似度最高的前三篇文档直接塞入提示词让模型自由发挥。
更可靠的做法是在架构里引入双向校验机制:先让模型说出“我这一句需要何种性质的证据”,检索完成后再强制执行一步“这篇文献的结论是否直接支持这句话”的核验。一旦核验失败,系统应当重新构造关键词,而不是将就引用。
局限一句
目前高质量的显式引用推理轨迹数据较为稀缺,训练严重依赖学术领域的特化构造;系统仍然依赖底层外部学术检索 API 的元数据完整度。4
2. 连续几次答案一样,推理就真的结束了吗?
元信息
Stable Answers, Unfinished Reasoning: Why Self-Consensus Is Not a Safe Early-Exit Signal
作者:Yunxiang Mo、Donghao Zhao、Hejia Geng
论文:arXiv:2609.09989v1 · 2026 年 9 月 9 日提交 · cs.CL。2
要解决什么问题
推理大模型在解决复杂数学或逻辑题时往往会输出很长的思考过程。为了降低 token 成本,业界常尝试“早停”(early-exit)机制:在生成过程中每隔一段步长探测一下模型当前的答案,如果发现连续几次探测给出的答案完全相同(即自我共识 self-consensus),系统就认为模型已经得出结论,提前截断后续推理并直接返回。
这种做法隐藏着一个核心假设:答案保持不变等于推理已经完成。研究团队检验了该假设是否真正可靠,以及工程团队能否找到一套既不损失准确率、又能稳定节省 token 的全局共识规则。2
方法是什么
为了排除在线采样的随机干扰,研究者在 DeepSeek-R1-Distill-Qwen-7B 与 Qwen3-8B 两个模型上,使用 MATH500、AMC23、AIME24 三个基准生成并冻结了主推理轨迹。随后在固定位置定期插入探测词,测试模型在不同思考节点上的临时答案。2
作者设计了一套包含窗口大小、一致性阈值等参数的 3,520 条窗口化共识规则,并在实验前注册了三个不可退让的门槛(acceptance gates):
- 准确率损失必须受限(保守门槛不超过 1.0 个百分点);
- 必须带来净 token 节省(扣除探测自身消耗的 token 后依然为正);
- 选出的规则必须能跨环境和未见模型(如 32B 模型)稳健复现。
同时,实验将基于边界置信度控制的早停方法 DEER 纳入同一测试流程作为对照。2
结果说明了什么
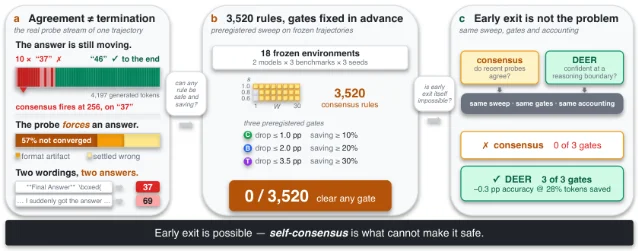
在全部 3,520 条共识规则中,通过全部三个门槛的规则数量为 0。2
虽然在训练集内部有 478 条规则看似达标,但一旦放到验证集和独立测试集上,表现全部失效。在仍能节省 32% 计算量的宽松规则下,系统每 9 次提前停止就有 1 次截断在后来被模型自我否定的错误答案上,直接抹杀了模型原本会在后半段完成的自我纠错。2
人工标注与措辞实验揭示了背后的本质:在推理前 10% 的阶段,多达 54% 的一致性答案其实是模型在探测压力下被迫写出的“格式占位符”,模型内部的深度计算根本没有收敛。即使把一致性窗口拉长到 30 步,非终止停止的比例依然留在 7% 左右,而此时的净 token 节省已经跌落到仅剩 8%。作为对比,基于推理语义边界置信度的 DEER 方法在同一数据流下实现了节省 28% token,同时准确率损失仅 0.3 个百分点。这证明早停本身可行,但单纯依赖自我共识无法作为安全的停止信号。2
读完可以带走什么
生产环境中部署长思考模型时,不要盲目上线“连续 N 次检查点输出一致即停止”的轻量策略。表面上连续输出相同字符,往往只是模型的中间语言惯性,并不代表解题思维已经结案。
如果需要实现早停,评估方案必须把“原本能纠错但被提前截断”的样本单独列为高危事故;早停算法的输入应转向思考边界的内部状态概率分布,而非对表面文本反复投票。
局限一句
论文实验基于单链推理轨迹和离线探测协议展开,结论专门针对自我共识信号本身,不能直接套用到基于独立多路径采样的自洽性(self-consistency)场景。2
3. 长输入涌入时,如何不把正在打字的请求卡死?
元信息
Deadline-Aware Adaptive Prefill Chunking for Efficient Large Language Model Serving
作者:Siyu Song、Qi Bai、Jinbo Hao、Kai Li、Chenchen Wang、Jiayu Sun
论文:arXiv:2609.07883v1 · 2026 年 9 月 7 日提交 · cs.CL。3
要解决什么问题
连续批处理(continuous batching)是提升大模型服务吞吐的标准手段。但在真实业务中,新请求带来的长输入预填充(prefill)与正在逐字输出(decode)的存量请求共享硬件算力。如果一次性把几千字的提示词送进 GPU,当前迭代的计算时间会被严重拉长,导致正在流式打字的存量用户遇到明显的停顿,违反逐字生成延迟(TPOT)的服务等级目标(SLO)。
工业界目前常采用固定分块(chunked prefill)来缓解这一冲突。但固定块大小面临双向惩罚:块设得太小,虽保护了解码延迟,却因为反复启动底层算子导致巨大的系统开销;块设得太大,一旦并发升高又会瞬间打爆延迟指标。最优的块大小随着并发度、上下文长度和硬件负载动态变化,离线调出的单一静态参数难以维持高效率。5
方法是什么
论文提出了 SLOWeave,一种在线、无需针对流量预先调参的自适应分块调度控制器,可以直接嵌入现有的迭代级推理引擎(如 vLLM 架构)。5
SLOWeave 的核心逻辑由“截止时间倒推预算”驱动:
- 跟踪截止时间:对于每一个正在执行解码的活跃请求,根据它的上一 token 完成时间和目标 TPOT 计算出下一次解码的硬性截止时间(deadline),并以当前所有活跃请求中最紧迫的截止时间确定本轮迭代的可用时间预算。
- 单调代价模型:推理引擎在启动时测量不同解码批大小和预填充块大小的执行延迟,构建一个严格单调的查找表。
- 二分查找最大安全块:在每次调度迭代中,控制器在对数时间内执行二分查找,在严格保证不打破任何当前解码请求截止时间的前提下,挑选能够塞进本轮时间预算的最大预填充块。
- 安全退避:如果当前批次即使只做纯解码也会逼近时间上限,控制器主动放弃本轮预填充,执行纯解码迭代,确保老用户流式输出不卡顿。5
结果说明了什么
研究者在单节点 8 卡 A100-80GB 与 8 卡 H100-80GB 上进行了真实 GPU 运行时测试,覆盖单卡 8B 模型与张量并行 70B 模型的各类对话、混合与突发流量。5
| 硬件 / 模型与场景 | 调度策略 | P99 首字延迟 (ms) | P99 逐字延迟 (ms) | 双 SLO 达成率 (%) | 合规吞吐量 Goodput (req/s) |
|---|---|---|---|---|---|
| A100 / 8B 混合长短文本 | 运行时默认基线 | 1,780 | 42.6 | 54.0 | 38.4 |
| A100 / 8B 混合长短文本 | 固定 1024 分块 | 1,510 | 24.1 | 76.5 | 52.7 |
| A100 / 8B 混合长短文本 | SLOWeave 自适应 | 1,190 | 24.8 | 91.4 | 67.1 |
| H100 / 70B-TP8 长文本 | 运行时默认基线 | 5,940 | 46.7 | 58.9 | 22.1 |
| H100 / 70B-TP8 长文本 | 固定 1024 分块 | 4,880 | 24.0 | 85.1 | 31.4 |
| H100 / 70B-TP8 长文本 | SLOWeave 自适应 | 3,960 | 24.7 | 96.9 | 40.8 |
在以 25ms 逐字延迟为目标的混合长短文本场景中,SLOWeave 将合规吞吐量从固定 1024 分块的 52.7 req/s 提升到 67.1 req/s(提升 38%),每处理一个有效请求的能耗下降了 17.9%。5
当服务面临更严格的 10ms 逐字生成目标时,静态分块由于缺乏弹性,要么严重超期要么频繁空等;SLOWeave 在混合负载上的合规吞吐量达到了最优静态基线的 3.35 倍,在纯长文本负载上达到了 2.45 倍。这证实了动态榨取解码空闲时间来推进预填充的有效性。5
读完可以带走什么
大模型线上推理集群如果长期遇到“首字延迟与打字卡顿不可兼得”的问题,不必在 256、512 或 1024 等固定 chunk 参数之间反复做妥协测试。
调度层应当把存量解码请求的 SLO 承诺作为上界,动态计算每一轮迭代允许执行的预填充 token 数量。在推理服务评估指标中,也建议使用“首字与逐字延迟同时达标的有效吞吐量(goodput)”作为主要衡量依据,避免虚高的裸吞吐掩盖了用户体验崩溃。
局限一句
该调度的安全性依赖迭代执行代价预测模型的准确度;面对持续性极端过载,系统仍然需要结合前端队列准入控制来避免预填充请求出现饥饿。5
三篇各记一句
- ReCite:解决模型引用胡编,需要把学术检索从单向关键词匹配升级为“先审视意图、后逻辑验真”的闭环智能体。
- Stable Answers:长链推理过程中的表面答案不变往往只是占位符,不可将表象稳定直接当作早停结算的依据。
- SLOWeave:长短文本混合调度无须纠结固定分块大小,用活跃解码的截止时间反推当前迭代预算才是兼顾吞吐与延迟的正解。
三篇论文分别处理了知识检索的逻辑闭环、推理过程的真实收敛边界,以及高并发服务运行时的微秒级协调。共同的启示在于:系统工程正在深入大模型的中间过程,单纯观察最终输出或依赖静态经验参数,已经很难支撑起高可用的大模型工业应用。
References
- 1
- 2
- 3
- 4
- 5
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.