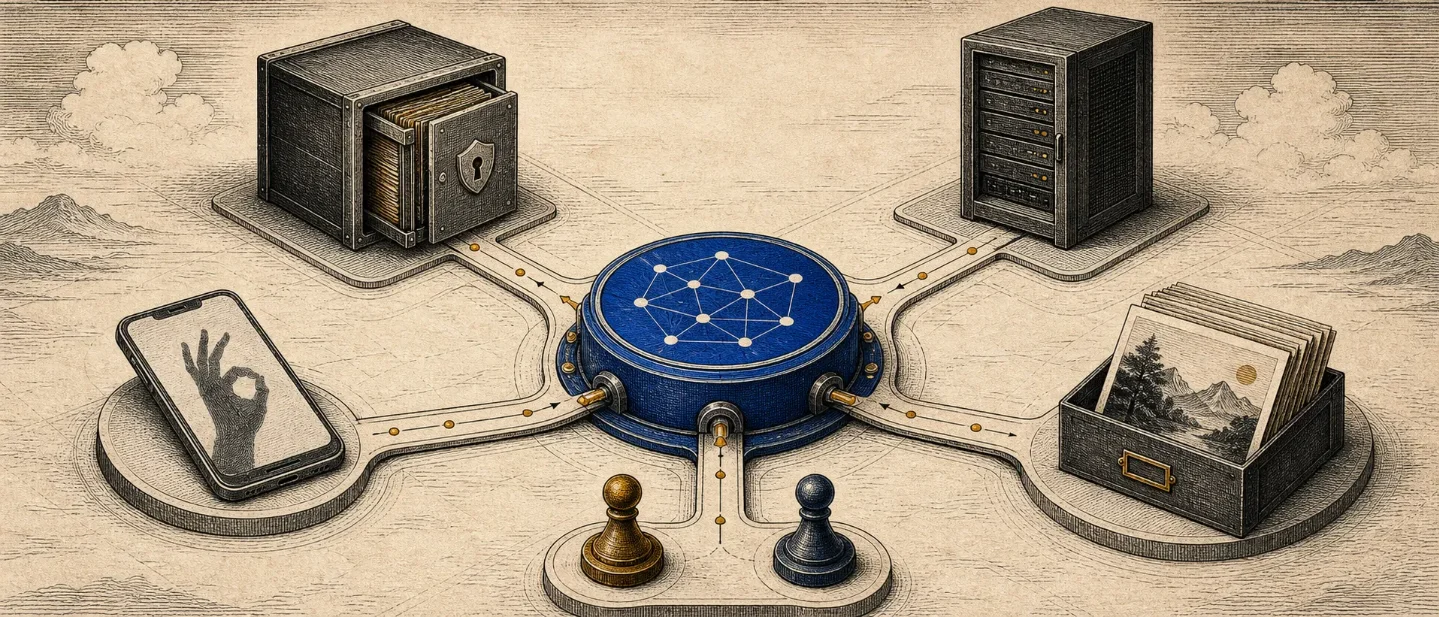
8月13日 AI 要闻 Top 5:漏洞数据库、手语输入与私有模型一起下沉
截至8月13日08:00,NIST启动国家漏洞数据库现代化征询,Google把手语转文字带到手机,Oracle推出私有大模型服务,研究则提醒基准分数可能受措辞影响。
截至 2026 年 8 月 13 日 08:00(伦敦时间),本期覆盖 8 月 12 日公开、且在截止时间前可核实的 AI 动态。排序按对企业部署、公共治理和模型使用方式的现实影响,不按传播声量排序。
先看结论:
- NIST 向全行业征集意见,准备重做美国国家漏洞数据库:AI 让漏洞发现、分级和修复进入近实时自动化阶段,NVD 也要从静态漏洞目录转向更连续、更有上下文的基础设施。1
- Google DeepMind 把手语转文字带到手机端:SL2T 首先支持 ASL(美国手语)到英语,在 Pixel 11 的 Gboard 和 Live Transcribe 中使用,手语输入开始进入普通移动交互。2
- Oracle 发布私有大语言模型服务:企业可以在自己的数据中心、私有云甚至隔离网络中运行开放权重模型,并用兼容 OpenAI API 的方式接入聊天、RAG(检索增强生成)和智能体工作流。3
- 一篇新研究提醒:模型基准分数可能高度依赖题目措辞:BenchDrift 在 8 个模型、3 个基准上测试意义不变的改写,发现强模型因改写丢分的幅度反而更大。4
- MIT 学生把农产品现货谈判做成多智能体市场:NegotiateAI 在 182,812 次模拟中报告超过 90% 的成交率,单次撮合、谈判和人工审批流程约 22 秒;但真实买卖双方的受控试点尚未开始。5
1. NIST:NVD 将从漏洞目录转向持续管理系统
美国国家标准与技术研究院(NIST)8 月 12 日发布信息征集公告,讨论如何在 AI 和机器可读安全数据快速增长的环境下改造国家漏洞数据库(NVD)。NVD 是美国政府的标准化漏洞管理数据仓库,安全工具和企业流程会用它来识别、分发、排序和修复软件漏洞。6
NIST 想征集的不是一份新模型清单,而是整套工作流的意见:哪些环节适合 AI 自动化,哪些必须保留人工复核;怎样改进风险排序、机器可读数据、产品识别和自动修复;怎样让结果更透明、可审计。意见提交截止 2026 年 10 月 13 日。6
NIST 还披露,已经开始开发名为 V-etalon 的工具,用 AI 丰富漏洞信息,但工具尚未正式发布。1
为何重要: 企业安全团队未来接收的可能不再只是「某漏洞严重程度几分」,而是结合资产、版本、威胁和修复状态的动态优先级。标准一旦变化,漏洞扫描器、合规系统和补丁流程都可能需要跟着改;但这次还是征求意见,不是已经生效的新规则。
2. Google DeepMind:手语输入进入 Gboard 和 Live Transcribe
Google DeepMind 发布手语转文字模型 SL2T,首批把美国手语(ASL)翻译成英语,并接入 Pixel 11 的 Gboard 和 Live Transcribe。用户可以像语音听写一样对着手机打手语,用于搜索、写消息、写文档,或向 Gemini 提问;Google 称更多设备和语言将在后续加入。2
模型训练使用了超过 10 万小时、50 多种手语的数据。设备端先把视频转换成手部、身体和面部的姿态坐标,再把坐标序列发给服务器翻译,原始视频可以立即丢弃。Google 在 FLEURS-ASL 测试集上报告 SL2T 的 BLEURT 得分为 70,并特别处理左撇子、单手手语和非手语输入等问题。2
边界: Google 自己列出了罕见手势、快速拼指、被动句和缺少上下文时态等错误。模型目前先覆盖 ASL 到英语,不能把「支持手语」理解成已经覆盖全球 200 多种手语。
为何重要: 这次变化不在于又多了一个翻译模型,而在于手语开始成为手机的直接输入方式。对产品团队来说,真正的难点也从单纯的识别准确率扩展到隐私、延迟、方言、单手操作和社区参与式评估。
3. Oracle:本地模型服务开始对接企业既有 AI 应用
Oracle 在 Private AI Services Container 26.2 中加入 Private Large Language Model Service。它支持在客户数据中心、私有云、公有云租户或隔离网络中运行开放权重模型,提示词、代码和文档可以留在客户控制的基础设施内。3
服务提供兼容 OpenAI API 的 REST 接口,底层使用
llama.cpp 或 vLLM。Oracle 随容器提供 Ministral-3-3B-Reasoning-2512,也允许客户下载其他兼容模型;它可以接入聊天客户端、RAG 工具、编程智能体和自主智能体。客户不按 Token 向 Oracle 付费,但必须自己提供运行所需的 CPU 或 GPU。7为何重要: 「不把数据送给第三方」开始从采购口号变成可部署的技术选项。代价也被写得很清楚:企业承担硬件、模型运维、并发性能和安全防护。Oracle 文档还说明,vLLM 和
llama.cpp 不能同时在一个容器中运行,单个容器实例也只支持一个对应运行时的模型,这不是无条件的本地化替代方案。4. BenchDrift:基准分数会被题目措辞推着走
arXiv 8 月 12 日收录论文《The Wording Effect: Quantifying Two-Way Drift in LLM Benchmark Performance》。作者用 BenchDrift 生成保持含义和答案不变的改写,沿语言、指代、语用和结构四个维度测试 8 个模型在 GSM8K、MMLU 和 MATH-Hard 上的表现。4
论文报告了两个结果。第一,改写可能让原本答错的题变对,也可能让原本答对的题变错;模型能力变强后,措辞敏感性并没有消失,强模型「丢掉的正确答案」反而明显多于「捡回的正确答案」。第二,不同模型大体认同哪些改写最容易造成损失,说明脆弱性部分来自改写方式,而不只来自某个模型。4
为何重要: 一个漂亮的榜单分数,可能只说明模型在那种措辞下答得好。评测和采购测试需要加入意义不变的改写、真实业务表达和置信度变化;这篇论文是预印本,结果应视为研究发现,不是对所有模型和任务的最终结论。
5. MIT:多智能体谈判离真实交易还差一个试点
MIT 的 Generative AI Lab 与农产品交易平台 iTradeNetwork 合作,做出 NegotiateAI。卖方发布库存,买方发布需求,系统先按价格、数量、时间、地点和质量判断是否存在可能成交区间;随后不同 AI 智能体并行谈判,Orchestrator(总协调智能体)比较多个谈判房间的预期价值,最后交给人工主管批准、修改或拒绝。5
MIT 页面称,系统在 182,812 次模拟中达成协议的比例超过 90%,放弃率为 5%,从撮合到人工审批约 22 秒。这个设计的关键不是让一个聊天机器人讨价还价,而是让多个代理同时处理库存、价格和交付约束,再由人保留最终决定权。5
边界: 这些数字来自模拟,MIT 页面把下一步写成与真实供应商和买家的受控试点。90% 的成交率也不是市场收益率,不能直接推导出更高利润或更少损耗。
为何重要: 企业智能体的价值开始从「会不会回答」转向「能否在多方约束下完成一笔可审批的业务」。上线前必须验证的变量包括真实价格波动、异常订单、代理之间的博弈、人工审批负担,以及出了错由谁承担责任。
今天的共同信号
五条消息指向同一个变化:AI 正从单点模型变成嵌入现有系统的工作组件。NIST 在改安全数据基础设施,Google 把手语模型放进手机输入链路,Oracle 把开放权重模型放进企业私有环境,MIT 把多个智能体接进交易流程;BenchDrift 则提醒我们,衡量这些系统时不能只看一个固定问法下的分数。
今天真正需要追踪的不是模型又增加了多少参数,而是四个可验证条件:能否接入已有流程,关键步骤能否复核,数据和权限是否留在边界内,评测能否覆盖真实表达与异常情况。
References
- 1
- 2Google DeepMind:Putting sign language AI into users’ hands
deepmind.google
- 3Oracle:Announcing the Private Large Language Model Service
blogs.oracle.com
- 4
- 5
- 6NIST Federal Register RFI
federalregister.gov
- 7Oracle 文档:Use the Private Large Language Model Service
docs.oracle.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.