
北京时间 10 月 16 日 0 点 09 分,微软 AI(Microsoft AI)在自己的站点上发了一篇实验室笔记,题为《Frontier Pre-training at Microsoft AI》。1 同一篇还有一个 PDF 版放在站上。2
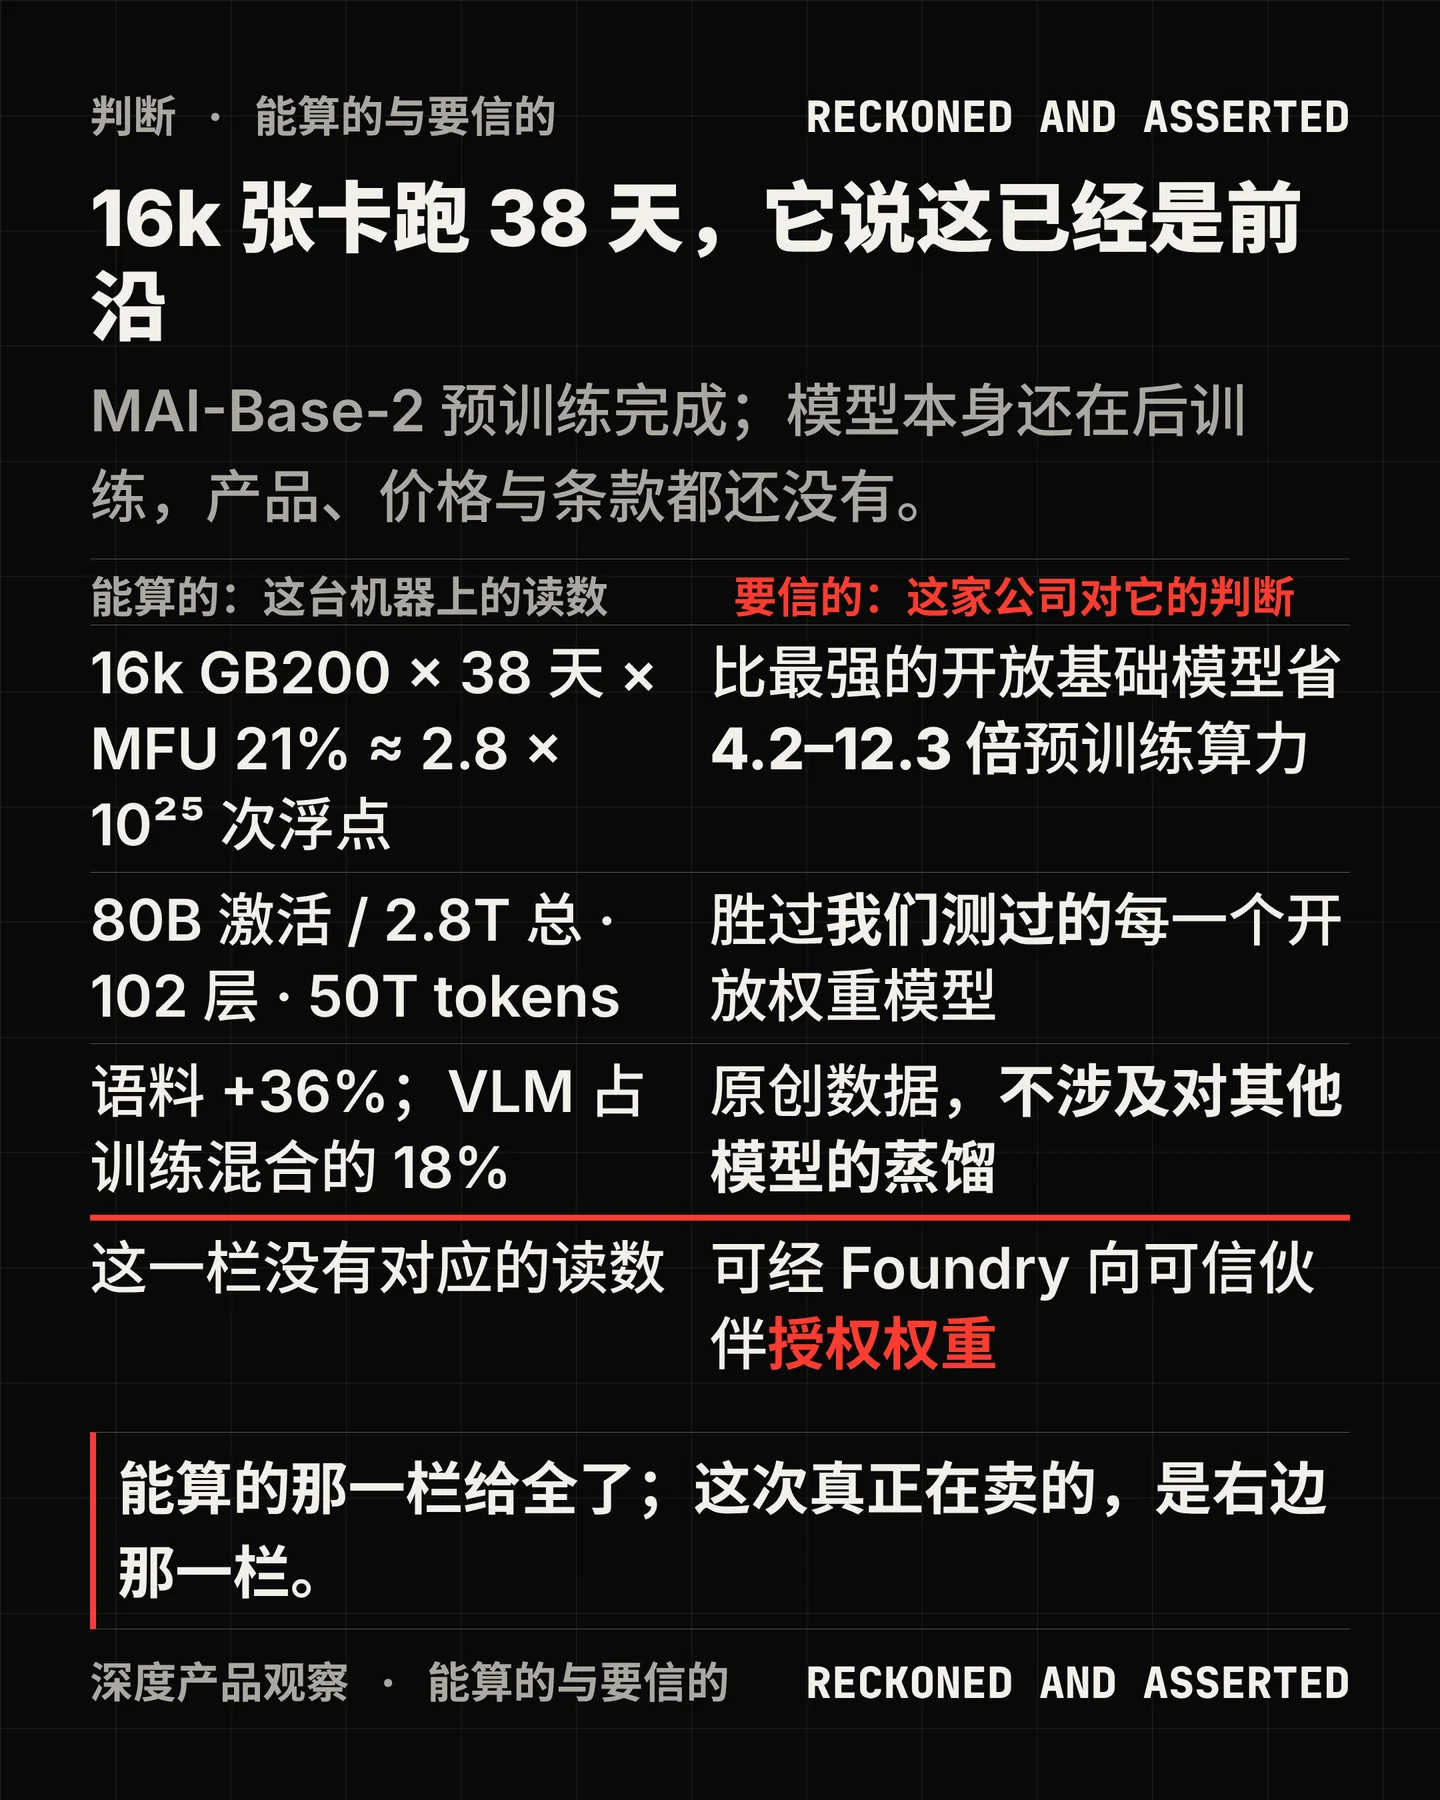
这篇笔记里有三条信息。第一条:一个新的基础模型 MAI-Base-2 完成了预训练,它是一个 80B 激活、2.8T 总参数的稀疏 MoE 模型。第二条:这次训练跑在 16,000 张 GB200 上,从 8 月跑到 9 月共 38 天,平均 MFU 21%、goodput 89%,而 MFU 是以 2.5 PFLOPS 归一、并且不含重算与优化器的 FLOPs。第三条:微软的训练数据是原创的、不涉及对其他模型的蒸馏,因此「可以经 Foundry 向可信的伙伴授权模型权重」。
第三条是这篇笔记里唯一谈生意的话。前两条是它的凭据。
先把「新」这个字说准
MAI-Base-2 本身还需要等。官方逐字写着它「正在后训练」(currently undergoing post-training),所以它现在还不是一个能用的东西:没有产品形态、没有价格、没有授权条款、没有上架时间。1
这一天也不是「微软首次公开前沿预训练的规格」。这个说法听起来顺,但站不住。今年 6 月随 MAI-Thinking-1 一起发布的技术报告里,微软已经写过上一代基础模型 MAI-Base-1 的完整规格——35B 激活 / 1T 总参数的稀疏 MoE、跑在 8,000 张 GB200 上、主预训练 30 万亿 token 加 3.55 万亿 token 的中期训练,也写了它的 MFU 超过 20%。3
所以这一天真正新增的是三样东西:MAI-Base-2 的规格数字、一次规模翻倍的训练跑(8K 张卡到 16K 张卡、30T token 到 50T token),以及那句把「不蒸馏」和「授权权重」连起来的商业表述。
这个区别值得说清楚,因为它决定读者该用什么心态看这篇笔记。微软不是在宣布一个发现,而是在交一份进度单:上一代的配方被放大了一倍多,跑完了,账在这里。
这 38 天里发生了什么
先把规格摆出来。官方把两代模型逐项并排,下面这张表用的是它自己给的数字。1
| 项目 | MAI-Base-1 | MAI-Base-2 |
|---|---|---|
| 激活 / 总参数 | 35B / 1T | 80B / 2.8T |
| 层数 | 78 | 102 |
| 隐藏维 | 6656 | 8704 |
| MoE 布局 | 稠密 FFN 与 MoE 交替 | 每一层都是 MoE |
| MoE 专家 | 0 共享 + 8 / 512 路由 | 1 共享 + 7 / 512 路由 |
| 训练量 | 30T tokens | 50T tokens |
| 优化器 | AdamW | Muon(非嵌入的二维参数)+ AdamW |
| 数值格式 | Tensor-wise 延迟缩放 E4M3 / E5M2 | MXFP8 E4M3 |
| 梯度裁剪 | 全局权重梯度裁剪 | 全局权重 + 激活梯度裁剪 |
| 视觉 | 纯文本 | 原生 VLM |
两代之间变化最大的一格不在参数量,在 MoE 那一行。微软说明了为什么上一代没这么做:每一层都是 MoE 在每 FLOPs 的效率上一直更好,但他们的 MoE 实现有浪费,导致按墙上时间算是「隔层 MoE」更划算。这一代他们修了两处——动态路由造成的内存碎片与为极端不均衡预留的内存,以及专家变多变细之后的单专家开销——MoE 层的 MFU 从 24% 提到 35%,然后才把 MoE 铺满每一层。1
这类内容比结论更值得读。它记录的不是「我们做了 X」,而是「上一代我们想做 X 没做成,因为 Y,这一代修好了 Y」。
然后是那趟跑。16,000 张 GB200、38 天、平均 MFU 21%、goodput 89%,并且把口径写在了旁边:MFU 以 2.5 PFLOPS 归一(这是 GB200 的 BF16 理论上限),不包含重算与优化器的 FLOPs。1
口径写出来,这一栏就变成可以自己算的。16,000 张卡 × 2.5 PFLOPS × 21% × 38 天,得到大约 2.8 × 10²⁵ 次浮点运算。换个算法对一下:一次前向加一次反向约等于 6 × 参数量 × token 数,代入 80B 激活参数与 50T token,是 2.4 × 10²⁵。两个数差在 15% 以内,方向一致。
这个量级放在 2026 年,是偏小的一档。同一年在运行的几家旗舰集群——xAI 的 Colossus、OpenAI 的 Stargate Abilene、亚马逊的 Project Rainier——规模都按十万张加速卡计,是这趟跑的几十倍。456 那些是集群总量、这是单次训练跑,两者口径不同,但即使按最宽的口径比,16k 也不是一个「堆算力」的数字。
微软没有说自己算得多。它说的恰恰相反:它把省下来的算力拿去训了一个更大的模型。这句话是理解整篇笔记的钥匙——它卖的不是规模,是效率。
对照表里能核的,和它多走的那一步
发布给了评测结果,用 held-out 的 bits-per-byte(BPB)。这个指标与各家自己的分词器无关,所以跨模型比得动。代码用微软自己的代码库,STEM、数学与问答委托外部供应商出题,所有评测集都对着训练数据做过去污染。1
BPB 越低越好,下面是完整的六行。
| 模型 | 参数(激活/总) | 代码 | 问答 | STEM | 数学 |
|---|---|---|---|---|---|
| MAI-Base-1 | 35B / 1T | 0.2401 | 0.4440 | 0.4026 | 0.3939 |
| MiMo-V2.6-Pro-RL * | 42B / 1.02T | 0.2446 | 0.4513 | 0.3975 | 0.3803 |
| Qwen3.8 * | 95B / 2.4T | 0.2400 | 0.4427 | 0.3978 | 0.3752 |
| DeepSeek-V4-Pro-Base | 49B / 1.6T | 0.2370 | 0.4351 | 0.3968 | 0.3862 |
| Kimi-K3 * | 104B / 2.8T | 0.2264 | 0.4269 | 0.3761 | 0.3589 |
| MAI-Base-2 | 80B / 2.8T | 0.2203 | 0.4162 | 0.3653 | 0.3561 |
对照的四个模型都能核。DeepSeek-V4-Pro-Base 是 1.6T / 49B、MIT 许可、4 月放出的权重;Kimi K3 是 2.8T / 104B;Qwen3.8-2.4T-A95B 是 2.4T / 95B;MiMo-V2.6-Pro-RL 是小米的 1.02T / 42B。78 微软图注里那四个参数量与各家自己的口径完全一致。
这张表里有三处值得停下来看。
第一处,带星号的三行。 官方自己标出来了:MiMo-V2.6-Pro-RL、Qwen3.8 与 Kimi K3 只有后训练过的 checkpoint 可用,所以「我们在后训练可能影响这些评测的前提下,仍然报出它们的结果」。这是一句主动交代——它把这张表的弱点自己讲了出来,而不是留给读者去发现。
第二处,没有出现的东西。 对照的六个模型里,五个是开放权重的,一个是被拿来比的自己。表里没有 GPT、没有 Claude、也没有 Gemini。
这未必是回避。基础模型(只做完预训练、没经过对齐与后训练的原始 checkpoint)与成品模型不是同一种东西,前者基本不对外服务,也就没有可比的公开读数。问题在于微软对这一点的表述。
第三处,就是那句话。 官方在解释效率倍数怎么算的时候写了一句:「DeepSeek-V4-Pro-Base 是唯一一个已发布、总参数超过一万亿的基础预训练 checkpoint。」1
这句话不成立。小米的 MiMo-V2.5-Pro-Base 是 1.02T 总参数 / 42B 激活,MIT 许可,权重在 2026 年 4 月 27 日就放出来了,官方模型卡上明确写着它是 base 模型并单独列了一张基座评测表。9
要公平地说,这句话的后半段没有被推翻——DeepSeek-V4-Pro-Base 「最强」这一点,公开信息里没有第二个独立评测把它和小米那个基座放进同一张表。被推翻的是「唯一」。
这不是一个要害错误,但它是这一页里唯一一处、读者能凭公开信息直接核掉的地方。而它出现的位置很值得注意:它出现在解释「我们和谁比」的段落里。挑选对照组这件事本身是有立场的,而微软在整篇笔记里最不严谨的一句,正好落在那里。
至于那个效率倍数,算法值得写清楚。微软没有拿两家的实际训练算力直接相除,而是先用自家的一套「缩放阶梯」拟合出 BPB 随训练算力变化的规律,再问「要在同一条规律上达到 DeepSeek 那个 BPB,需要多少算力」,最后把估算出来的算力与 DeepSeek 的实际训练算力相比。他们也写明了:MAI-Base-2 的最终成绩被包含在拟合里,所以匹配点落在拟合过的模型区间之内,而不是外推。1
诚实,但尺子是他们自己的,并且没有第三方复核过那把尺子。
「省」和「不蒸馏」:它的两句主张
把这篇文章的商业段落逐字读一遍,会看到一条四步的链:
Owning our model pipeline end-to-end allows Microsoft to make a distinctive offering to our customers. Microsoft has strong data provenance over training tokens that go into our model. Our pre-training is built on organic data which does not involve distillation from other models. This will enable us to license our model weights to trusted partners through Foundry, which provides enterprises with a trusted source of world-class intelligence that serves their needs.
自己掌握全流程 → 训练数据来源清楚 → 数据是原创的、不蒸馏 → 所以可以授权权重给可信伙伴,走 Foundry。
前三步是理由,第四步是结论。这条链要回答的是采购方这两年真实在问的一个问题:我买的这个模型,是不是别人的下游?
蒸馏的做法是拿另一个模型的输出去训练自己的模型。它技术上合法、行业里普遍,但它让「你的模型从哪来」变得难以回答。而「不蒸馏」这句话在 2026 年不是一句中性的技术描述,它是一句站队的话。
支持这一点的是美国政府的文本。2026 年 9 月 8 日,美国国家安全局、网络安全和基础设施安全局与联邦调查局联合发布了一份公告,把蒸馏写成中国公司 AI 研发链条的「核心而非补充」,并逐条点名:Moonshot 用 Claude Fable 5 与 GPT-4o 的数据训练它的模型,阿里在 2025 年底用 Claude 与 GPT-5 来提升自家模型的能力,DeepSeek 公布的 560 万美元训练成本没有算上通过蒸馏取得数据的真实代价。10
微软这次挑的四个对照模型里,有三个的厂商就在这份公告的点名名单上。
反过来看,微软的「不蒸馏」也有它的边界。对闭源 API 那一侧,禁止用输出训练竞品是标准条款——OpenAI、Anthropic 与 Google 的服务条款里都有实质等价的句子,只是三家都没有用「蒸馏」这个词。而对开放权重那一侧,Meta 的 Llama 许可里根本没有这类限制,只有署名要求。在这种格局里,明确把「不用其他模型的输出训练自己」写成卖点的,目前能查到的官方文本只有微软一家。1112
所以那句授权的话,是这条链上唯一有商业价值的一环,也是唯一还没有下半句的一环。官方只写到「will enable us to license」——谁是「可信伙伴」、条款是什么、要不要钱、什么时候能用,一个字都没有。
谁能拿它做什么
管采购与选型的人。 今天能确定的事很有限:MAI-Base-2 是一个还在后训练的基础模型,没有产品、没有价格、没有条款。所以现在能做的不是决策,是列清单。等它可用的时候,要求在自己任务的评测集上测一遍;把「权重授权」的具体条件问清楚——能不能自建、能不能改、能不能商用、授权怎么计价;以及记住今天拿到的只是预训练读数,不是产品读数。
做模型的技术团队。 这篇笔记里能直接拿走的东西比结论多。MoE 铺满每一层而 MFU 不掉,靠的是把内存占用做成与路由不均衡无关的固定值(多轮 dropless 调度);Muon 在这套实现里只占平均迭代时间的 2.1%(165 毫秒),理论下限是 55 毫秒,差距归因于掉队、核函数调度开销与重分片时的内存拷贝;激活梯度裁剪除了稳定训练,还被当作数据管线的诊断工具用——他们靠它捞出过一个预处理 bug。还有一个可带走的方法:缩放阶梯上用一个叫 source scaling 的技巧,在较小的模型上人为限制唯一样本集合,让每个数据集无论训练多长都重复同样的次数,这样不同规模之间的结论才转移得动。1
数据分布上的变化也值得看一眼。 语料按唯一 token 计比上一代多了约 36%,而混合比例动得很明显:代码从 54.6% 降到 44.9%,STEM 从 15.6% 降到 9.1%,纯视觉从 0 变成 13.6%(视觉语料 4.5T 唯一 token;加上重复,视觉数据占 50T 混合的 18%)。1
所有读这篇东西的人。 值得分清两栏。左边那一栏——16k 张卡、38 天、21%、89%、50T token、102 层——是微软给自己的读数,但口径写全了,可以重算,也可以拿它跟别家的公开跑数比。右边那一栏——胜过每一个我们测过的开放权重模型、省 4.2 到 12.3 倍算力、数据是原创的、权重可以授权——是微软对自己下的评价,尺子在它自己手里。两栏都该看,但不该放在同一个权重上。
还不能确定的
第三方还没有看过。 这篇笔记发出时,Hacker News 上只有一条提交,4 分、0 条评论;截至我们核完为止,英文科技媒体没有一家为它发稿。13 中文这边只有单句快讯:新浪财经的 7×24 在 0 点 16 分写了一句「微软已完成 MAI-BASE-2 模型的预训练」14;华尔街见闻的快讯与由它派生的英文聚合稿甚至把参数量写成了「3 万亿」。1516 所以这篇文章里所有关于数字的判断,都来自微软自己的文本与对照模型厂商的官方页,没有第二方复核——不是没人愿意,是时候还没到。
许可证还没有。 官方只说了「会通过 Foundry 向可信伙伴授权权重」,没有条款、没有价格、没有门槛、也没有说什么叫可信伙伴。这句话目前是一个意向,不是一份要约。
能力对照是缺的。 那张 BPB 表只跟基础模型比,没有跟任何闭源前沿模型比。要判断 MAI-Base-2 变成产品之后的位置,得等后训练完成、并且有人能独立测。它作为 base model 本来也不对外开放,所以在那之前,任何「它比某个成品模型强」的说法都无从检验。
「无蒸馏」这句话没有第三方证人。 它是微软关于自己训练数据构成的声明,而这类声明既难以证实也难以证伪,除非有人拿到训练数据或复现配方。读者能做的是记住这句话是谁说的,以及它没有说别人的模型有没有蒸馏——而美国政府的公告替它说了。
那个效率倍数是自家尺子量的。 缩放阶梯与拟合都是微软自己的,匹配点落在拟合区间之内这一点他们写了,但没有第三方复核过那把尺子。
后训练与 MAI-Base-3 都还没有内容。 官方文末写着两项都在进行,没有给时间。
References
- 1Frontier Pre-training at Microsoft AI
microsoft.ai
- 2Frontier Pre-training at Microsoft AI(PDF)
microsoft.ai
- 3
- 4xAI Colossus
x.ai
- 5
- 6AWS Project Rainier
aboutamazon.com
- 7DeepSeek-V4-Pro 模型卡
huggingface.co
- 8Kimi K3 官方博客
kimi.com
- 9XiaomiMiMo/MiMo-V2.5-Pro-Base 模型卡
huggingface.co
- 10NSA, CISA, FBI 联合公告 AA26-251A
cisa.gov
- 11
- 12OpenAI 致众议院司法委员会的备忘录
assets.bwbx.io
- 13HN 条目 50105791
hn.algolia.com
- 14新浪财经 7×24
finance.sina.cn
- 15华尔街见闻快讯
wallstreetcn.com
- 16Gate.com 聚合稿
gate.com

Comments