Google 专利律师三个月实验:AI 起草分涨 0.34–0.38 SD,禁用 AI 后判断力只有资深律师在涨
一项 133 名美国专利律师参与的三个月随机对照试验,把「用 AI 时做得多好」与「拿掉 AI 后判断力如何」分开测:起草质量整体上去了,独立判断力的增益只落在资深律师身上,初级律师的分数反而向两端散开。

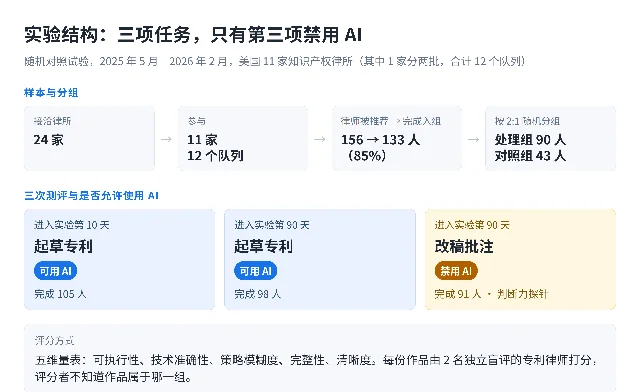
2025 年 5 月到 2026 年 2 月,美国 11 家知识产权律所的 133 名专利律师被随机分成两组。三分之二拿到 Google Labs 一款当时尚未发布的 AI 撰写助手的使用权,其余三分之一要等到实验结束才能用。三个月里他们做三次作业:进场第 10 天起草一份专利,第 90 天再起草一份,第 90 天还要给一份埋了大量错误的现成专利稿做改稿批注。
第三次作业是关键。那一次两组都被要求不使用 AI,作品由另一家律所的两名专利律师盲评。同一份实验因此给出两栏分数:一栏是 AI 在手上时能做出什么,另一栏是 AI 拿掉之后,这个人自己的判断力到了哪一级。
两栏给出的顺序相反。有 AI 帮忙起草时,经验少的律师涨得更多;把 AI 拿掉去改稿时,涨的只有资深律师,初级律师的平均分停在对照组的水平上,分数却向两端散开。论文的摘要把这件事收成一句:从 AI 里拿到最多的人,保留下来也最少。
这项研究由 MIT 经济学家 David Autor 与 Google 的 Tanya Rodchenko 等七人合作完成,实验预先登记在 AEA 随机对照试验注册库,论文以 NBER 工作论文 w35720 发表,Google Research 官方博客同日给出解读。123
实验设计:把两种能力分开测
研究团队接洽了 24 家与 Google 有持续业务往来的美国知识产权律所,11 家参与,其中一家分两批进场,合计 12 个队列。律所推荐的 156 名律师里 133 人完成入组并被随机分组,按 2:1 分成处理组 90 人与对照组 43 人,分组按律所和执业年限分层;做到最后一个任务的还剩 91 人,累计流失 32%。执业满 7 年及以上算资深律师,这个门槛取自 Google 内部法务建议的行业惯例,论文在 3 到 9 年之间做了敏感性检验。2
处理组拿到的是 InFlow,Google Labs 为专业服务写作开发的未发布产品。它支持在选中的文字上行内改写、按上下文续写,能从编辑、专家、读者等几个角度给反馈,也能按一套自定义规则找出文档内的语义矛盾。它在实验期间改过几次功能,最终没有作为独立产品发布,能力并入了 Google 的其他 AI 工具;官方博客说它现在属于 Gemini Notebook。12
两次起草任务衡量的是「AI 在手上时做出来的东西有多好」:两组做同一道题,10 天与 90 天之间的差距变化,能看出用久了会不会拉开。改稿批注任务衡量的是另一件事:它主要靠阅读和标注已有文本,产出新文字的成分很少,是专利律师日常在无 AI 状态下完成的核心动作。论文把这一步当作分离「内化了的技能」与「AI 帮忙时的表现」的探针。2
评分交给签约的独立知识产权律所,从六名评分者里随机抽两人,用一套与 Google 内部法务共同开发的五维量表:可执行性、技术准确性、策略模糊度、完整性、清晰度。评分者不知道作品属于哪一组。三项任务上两位评分者的相关性分别是 0.59、0.47 与 0.55。2
用 AI 起草:质量上去了,初级律师涨得更多
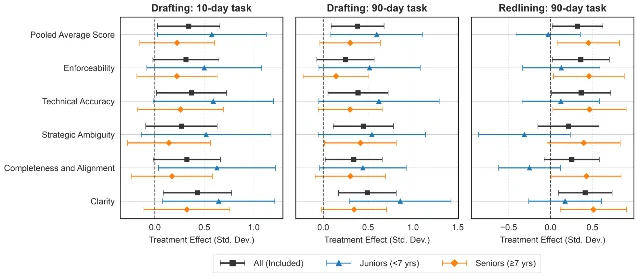
第 10 天,处理组比对照组高 0.34 个标准差(p=0.03),相当于在对照组分数排名里上升 10 个百分位;第 90 天扩大到 0.38 个标准差(p=0.01),约 11 个百分位。五个子维度方向一致,其中清晰度与技术准确性的点估计最高,策略模糊度最低。2
提升落在低分那一端。起草任务里分数落进最低档的概率在 10 天时下降 0.19(p=0.00),90 天下降 0.11(p=0.12);往上一档去的是中下档,优秀档没有变多。2
分资历看,初级律师涨幅更大:10 天 +0.58 SD(p=0.04),90 天 +0.60 SD(p=0.02);资深律师 +0.22 SD(p=0.24)与 +0.30 SD(p=0.08)。速度上的差别同样集中在初级律师身上:第 10 天任务他们比对照组快约 18 分钟(p=0.05,对照组平均用时约 112 分钟),资深律师只快约 5 分钟(p=0.35)。一个值得记住的对照是,处理组的初级律师在两次起草任务上的平均分已经达到或超过未使用 AI 的资深律师,90 天时是 0.36 SD 对 0.13 SD。2
禁用 AI 改稿:增益只在资深律师身上
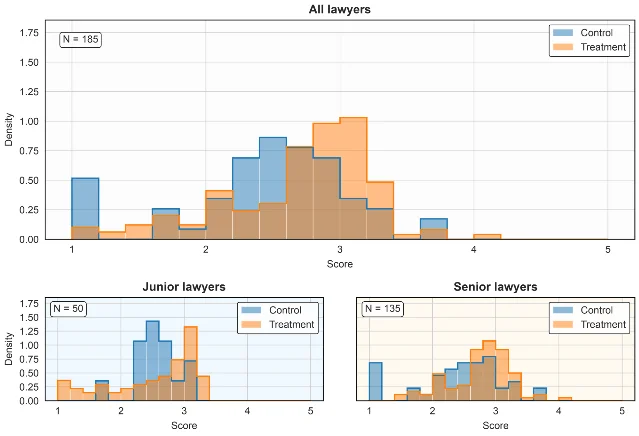
第三次任务里,处理组整体比对照组高 0.32 个标准差(p=0.04),而这个总效应全部来自资深律师:他们比对照高 0.45 SD(p=0.02),初级律师的点估计是 −0.03 SD(p=0.89)。作者对三组各做了 2000 次蒙特卡洛置换检验:总体效应落在零分布的第 97.1 百分位(p=0.05),资深落在第 98.7 百分位(p=0.02),初级落在第 46.8 百分位(p=0.93)。2
初级律师的分数在这一栏向两端散开。按五分位拆开,第四档(中下)的处理组比对照组少 0.42(p=0.01),最低档多 0.22(p=0.04),第二档多 0.19(p=0.20),方差齐性检验 Levene 统计量 3.66(p=0.06)。资深律师的散开是另一种形状:第二档多 0.22(p=0.00),Levene 7.74(p=0.01),下三档普遍减少。2
| 任务(时间点) | 是否允许用 AI | 完成人数 | 总体 | 初级律师(不足 7 年) | 资深律师(7 年及以上) |
|---|---|---|---|---|---|
| 起草专利(第 10 天) | 允许 | 105 | +0.34 SD,p=0.03 | +0.58 SD,p=0.04 | +0.22 SD,p=0.24 |
| 起草专利(第 90 天) | 允许 | 98 | +0.38 SD,p=0.01 | +0.60 SD,p=0.02 | +0.30 SD,p=0.08 |
| 改稿批注(第 90 天) | 禁止 | 91 | +0.32 SD,p=0.04 | −0.03 SD,p=0.89 | +0.45 SD,p=0.02 |
处理组相对对照组的效应,单位为对照组标准差。前两行取自论文表 3、表 4,第三行取自表 6。2
时间上,改稿任务没有出现 AI 带来的加速,这与任务本身禁用 AI 一致。同一个任务里对照组资深律师平均花 63 分钟、初级律师 53 分钟,处理组的资深律师也没有变快。2
同一批作品还交给 Gemini 2.5-flash 按同一套量表重评了一次。人与模型给出的分数相关性偏低:10 天起草 0.47、90 天起草 0.19(p=0.06)、90 天改稿 0.14(p=0.18)。分歧最大的是初级律师改稿这一格,三种口径给的读数分别是人类专家 −0.03 SD(p=0.89)、人机合并 0.12 SD(p=0.57)、模型单独 0.29 SD——三个都不显著,换哪个裁判都改变不了「看不出差别」这个结论,模型的符号则翻到了正向。论文自己写,模型评分器很可能不如签约的专利律师可靠。2
分岔从哪里来
研究团队用 NotebookLM 做了一次定性文本分析,作者明确标注这是定性观察,成果用在机制推测上。两类律师对待同一份稿子的方式不同。资深律师倾向于重构:跳过低风险的段落,从权利要求重写起,删掉可能无意中缩小保护范围的措辞,每条修改都配上点明法律依据的注释;访谈里他们把 AI 的输出当成「逻辑审计员」,说它削弱了自己对既有措辞的依恋,逼着自己把结构性修改的理由讲清楚。初级律师则是顺序推进:从头往下改,常把时间耗在背景之类的技术性段落上,还没读到权利要求;改动停在同义词替换;发现严重缺陷时留下一条注释说明问题,而不动手修。论文举的例子是「权利要求用了不确定的措辞」「存在先行基础问题」这类短注,读起来像写给一个并不在场的 AI 助手。12
这个「诊断而不执行」的姿态在未使用 AI 的对照组初级律师里同样普遍,论文因此把它记为初级律师的基线短板:三个月的 AI 依赖既没有纠正它,也没有让它加重。2
作者给出两条互不排斥的解释。一条关于编辑习惯:持续用 AI 会削弱对既有文本的依恋,也会训练使用者把修改的理由说出来,前者解释资深律师为什么敢整段重写,后者解释他们为什么给每条改动配上依据。另一条关于注意力落点:AI 接手基础的文字生成之后,资深律师能把注意力放到策略判断上,而初级律师被拿走的恰好是练习策略能力的那段吃力过程。2
时间投入这条线与这套解释吻合。初级律师用 AI 明显更快,却在无 AI 的任务上拿不到独立收益;资深律师起草几乎不提速,在无 AI 的改稿上花的时间也和对照组差不多,交出来的批注更实更全。论文在讨论里把这条线与一项教育研究并置:Strömberg 等人 2026 年追踪采用生成式 AI 的中国中学生,作业时间下降、作业分数上升,而决定升学的高利害考试分数下降 1.3 到 1.5 个标准差,损失集中在高成就学生身上。论文同时写明两处不可比:这里的对象是拿薪水在本专业内工作的执业者,观察期是三个月,而那是两年;要确认时间投入真的是中介通道,需要直接操纵任务时间,两项研究都没有做。2
这项发现在文献里正好落在一条分界线上。此前一批研究显示 AI 能帮经验较少的人练出独立的专业表现,放射科住院医师、商业问题求解、求职信写作都出现过这类结果。456 另一批研究显示 AI 更像一副临时外骨骼,即时产出上去,工具撤走之后收益不持续,软件工程师、管理咨询顾问、高中生、临床医生身上都测到过这种情况。78910 这篇专利律师实验把两种表象放进了同一个实验:戴着 AI 时确实呈现出「填平差距」的样子,摘掉之后填平的部分消失,分界线落在律师本人有没有基础的专业判断上。
结论的适用边界
最重的一条是缺了基线测量。研究团队原本把「基线与末线各测一次技能」写进设计,合伙事务所拒绝了这一步,所以「末线差异等于技能习得」这个解读依赖随机化带来的两组基线平衡,测量本身没有做成。论文的脚注把这一依赖写明。2
样本与观察期限制了外推。133 人来自与 Google 有持续业务、专利实务成熟的律所,论文自述不代表专业服务整体;三个月相对专利专业能力的数年养成是很短的窗口。改稿任务禁用 AI 只能靠提示语约束,研究团队无法观测个人是否遵守,于是用模型加人工审计找痕迹,把 91 份里的 15 份标为疑似;把这 15 份控制掉或整体剔除,主结论保持不变,剔除后合并评分下总体效应升到 0.61 SD、资深 0.76 SD(p=0.00)。2
在岗表现也测了,结果只能是探索性的:问卷只有 68 人回答(占样本 51.1%),功效也不足——时间维度上要有超过对照基线(5.1 周)约 31% 的降幅才可能显著。三个方向都朝着 AI 组更好,统计上都不显著:完成快 0.76 周(p=0.35)、收到的审阅意见少 0.39 SD(p=0.17)、被退回修改少 0.15 SD(p=0.58)。2
利益关系需要读者自己称量。实验的直接成本由 Google 提供,七位作者里六位是 Google 的全职雇员或受薪承包方,各自的持股与雇佣关系逐条写在论文页上;参与实验的律所也都与 Google 有业务往来。2
还没回答的问题
这张账留了几个空格。初级律师内部为什么有人受益有人受损,论文说实验回答不了,作者给的解读是 AI 对一部分初级律师加速了技能习得,对另一部分替代了它。更长的暴露会让初级律师那团散开的分数收敛还是继续发散,三个月看不出来。时间投入是不是真正的中介通道,需要直接操纵任务时间来验证,这项研究没有做。作者也写明,模型能力和从业者对 AI 的熟悉度在过去一年里都变了不少,现在重跑,结果可能不同。2
对读者来说,这篇最有用的地方是一把尺子。凡是「AI 让人变强」的宣称,先看它有没有一栏「拿掉工具之后这个人的独立表现」,再看这一栏的评分者是谁、有没有基线测量。论文自己在讨论里写下的一句话可以作为这把尺子的刻度:评估 AI 对技能的作用,需要把软件的贡献和使用者自身的专业能力分开来测。2
References
- 1Does better work always mean better workers?
research.google
- 2
- 3AEA RCT Registry: AI & Expertise research with patent lawyers
socialscienceregistry.org
- 4
- 5Business problem-solving with AI
arxiv.org
- 6
- 7
- 8
- 9Generative AI can harm learning
pnas.org
- 10AI assistance and clinician performance
pubmed.ncbi.nlm.nih.gov
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.