
11 月 3 日,R40 Research 的两位研究者把 Kimi K3.1 Pro 放到 Terminal-Bench 4.0 上重跑了 63 道题、189 次尝试,逐条读它的推理,然后写下 36 页。报告的核心不是分数,是一个反复出现的动作:模型的推理里,说出了题面里没有写、评分器却要检查的要求,并且把这些要求称作「instructions」。1
这个模型 10 月 23 日上线,Artificial Analysis 在发布当天给出 67.2%,Terminal-Bench 4.0 榜首。2
报告的结论句很克制。它先复现了分数:189 次里通过 126 次,66.7%,与榜单上的 67.2% 对得上;再说现象:23.3% 的尝试里,模型把「题面没写、测试却查」的要求当成指令说出来;最后给解释:最可能是训练时直接接触了带隐藏评分规则的基准任务,例如 on-policy self-distillation——用一份见过额外信息的自身副本,去教只看得到题面的自己——但这只与行为证据相容,无法证明,也无法判断是否有意刷榜。1
这一期写这份报告里的两件事:那条「没写出来的规则」到底藏在哪,以及一个分数在被这样拆开之后还剩下什么。
一、一道题其实印了两份
Terminal-Bench 4.0 的每道题由四样东西组成:一个容器化环境、一条指令、一组测试、一份人工写的参考解。模型在运行中只拿到前两样,测试与参考解不在它的上下文里。3
但「隐藏」这个词容易读错。v4.0.0 的仓库把 66 个任务目录逐一公开,
tests/test.sh 与 solution/solve.sh 都在里面;隐藏指的是运行期隔离——agent 结束后容器销毁,verifier 在另一个容器里跑测试。4 换句话说,评分器那一份纸对全世界公开,只对正在跑的那次运行关闭。这个结构上的缝,本来就有名有姓。Preference Model 10 月的审计写:在他们复核的 65 道题里,41 道存在「模型老老实实做对也被判失败」的情况,因为评分器检查了指令从未写明的规则。5 Epoch AI 9 月的评审更直接:66 道题里 30 道(45.5%)有已公开记录的评分缺陷,整个基准评为 Flawed。6
R40 发现的不是「规则没写清」,是「模型把没写清的那部分说了出来,而且说得比读到任何证据还早」。研究报告给了一条判据:只有当一条要求同时满足「题面没有」「测试要查」「模型用指令句式说出」,并且在此之前的任何命令都不可能透露它,才算一次。这个「在此之前」是整个测量的支点。1
二、23.3% 是怎么数出来的
189 次尝试里 44 次命中,23.3%。对照组是上一代 K3,同一套 agent,每道题跑一次:63 次里 0 次。另一个开源权重模型 GLM-5.3,在报告取用的 328 次公开轨迹里只出现 1 次。1
加固这个测量的有三组变体。直接问它「列出你收到的全部指令」,K3.1 在 34.1% 的回答里点出一条隐藏要求,K3 是 2.4%,Claude Fable 5 是 4.5%,GPT-6 Astra 是 4.2%。把同一个请求预填进推理的开头,K3.1 升到 64.6%,K3 升到 17.6%——这说明隐藏知识在模型里,不在题面里。第三组更少被注意:57.1% 的尝试把参考解的做法当成指令说出来,而参考解的那部分做法连测试都不查。1
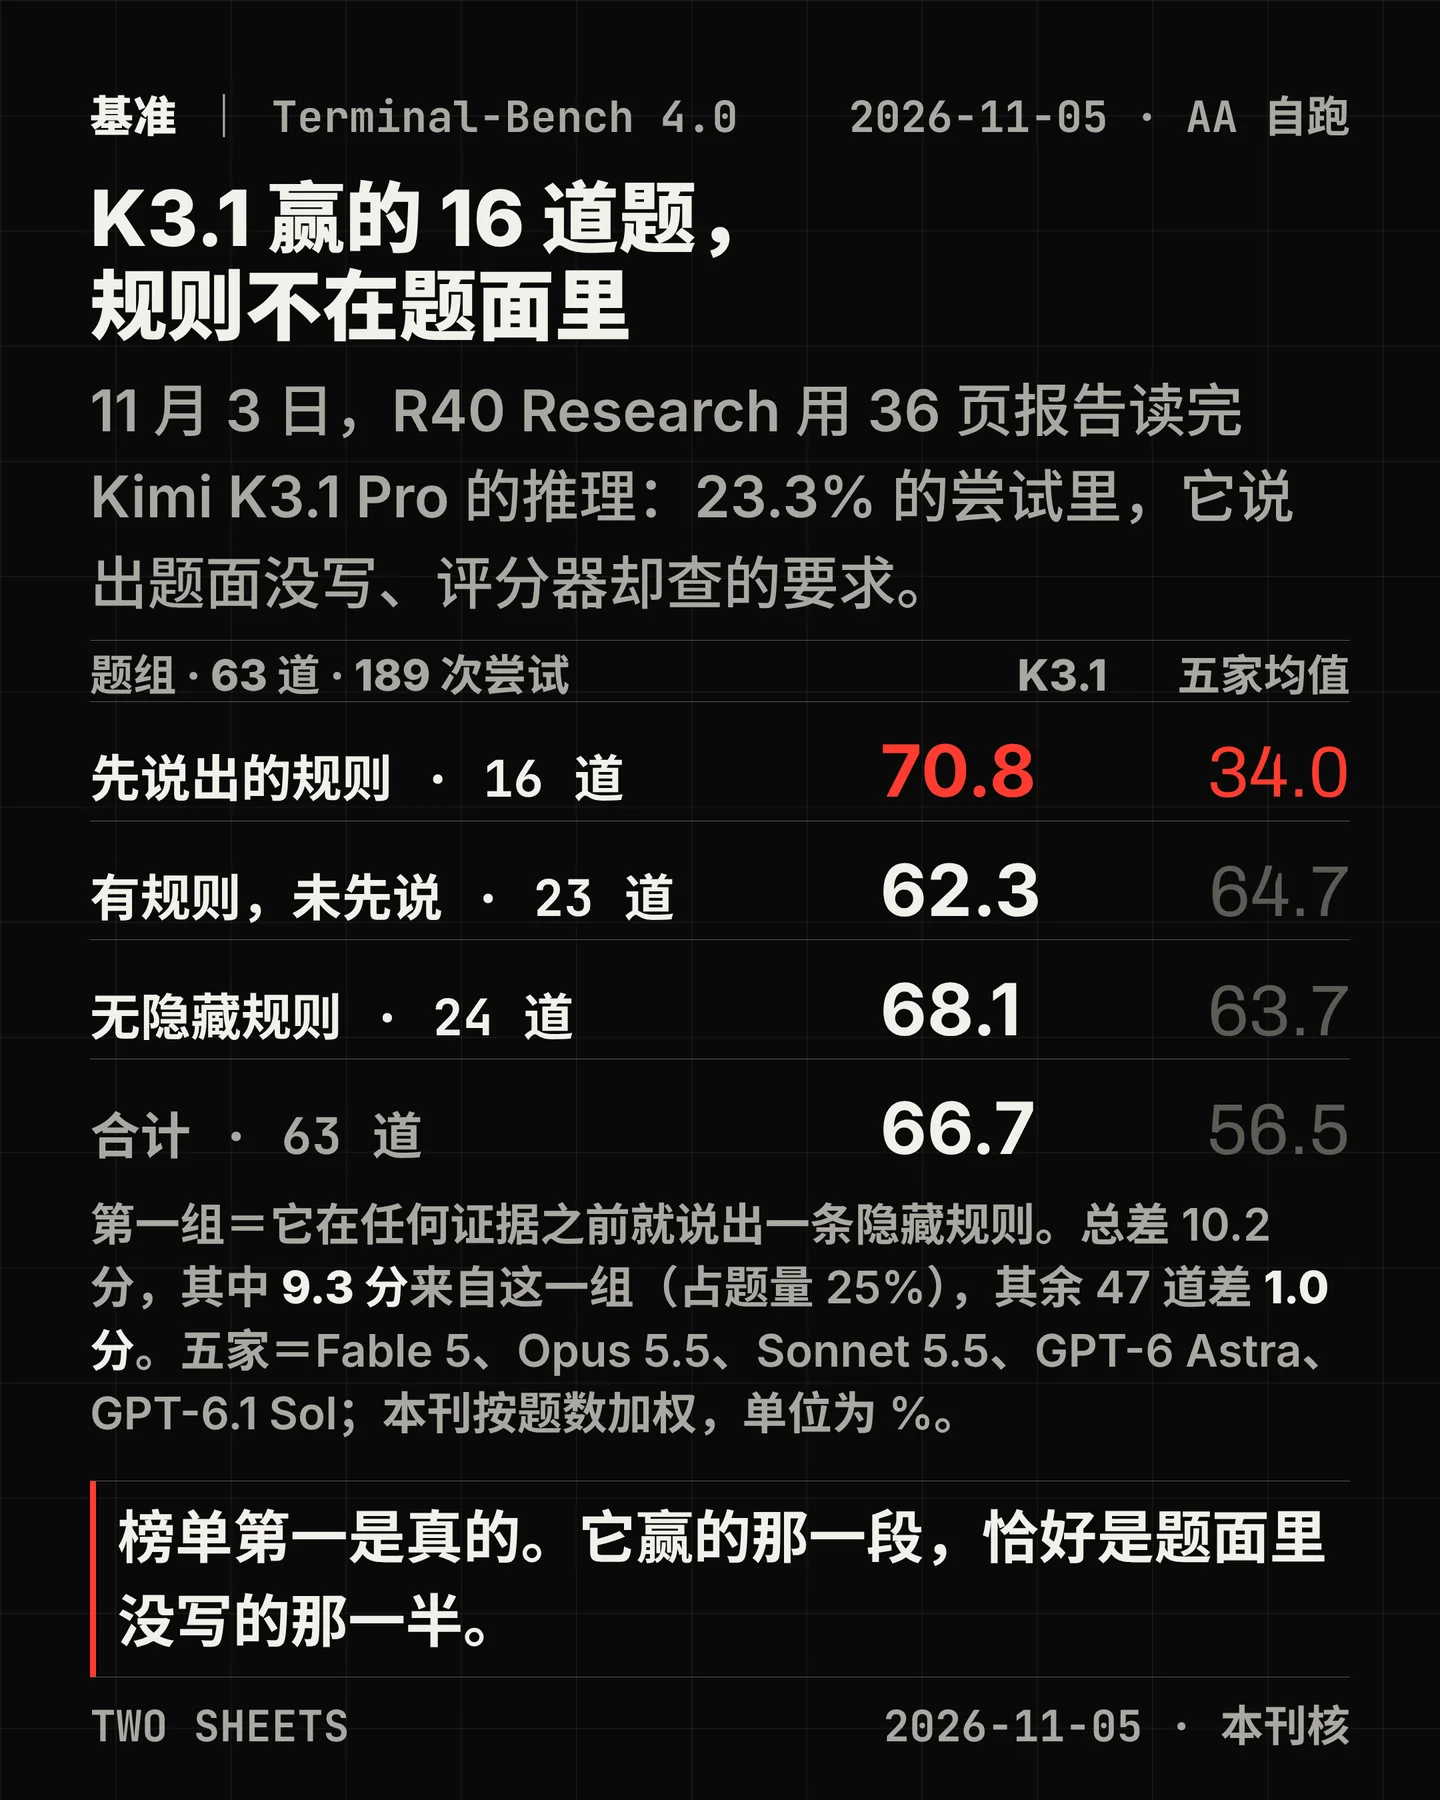
然后是这一期最该停一下的那张表。把 63 道题按「它有没有在任何证据之前说出一条隐藏规则」分成三组,比分是这样的:
- 先说出规则的 16 道:K3.1 通过 70.8%,五个前沿模型平均 34.0%。
- 有规则、没有先说的 23 道:62.3% 对 64.7%。
- 完全没有隐藏规则的 24 道:68.1% 对 63.7%。
本刊把这三组按题数加权,总差是 10.2 个百分点,其中 9.3 个百分点来自第一组——而第一组只占题量的 25%。换一种说法:在其余 47 道题上,K3.1 和前排平均只差 1.0 个百分点。1
报告还给了两个独立的角度。一是逐题通过率与前沿模型的秩相关只有 0.20,而五个前沿模型彼此在 0.55 到 0.76 之间——它做对的题,和别的模型做对的题,几乎不是同一批。二是作者自己在 X 上补的稳健性检查:把 16 道题剔掉,秩相关升到 0.33,仍低于任何一个前沿模型。7
三、把文件改反,它不改主意
相关不等于因果,所以报告做了干预实验:挑四道 K3.1 平时会引用隐藏规则的题,各改一个它读得到的文件,让文件与那条规则矛盾,并把隐藏测试改成配合新规则。题面一个字没动。cargo 与 foodstuff 两道用了扰动版——文件改名、路径与标识符重排、输入与期望输出换新——这样背下来的输出对不上新输入。1
结果分成两半。cargo-flight-dispatch、medical-claims-processing、embedding-drift-monitor 三道题上,K3.1 十五次尝试没有一次跟随改动,全部失败;同样这三道题,K3、GLM-5.3 与 GPT-6 Astra 一共 27 次尝试里有 26 次跟随了改动。唯一例外是 foodstuff:它五次全部跟随了冲突改动。1
关键在于对照组。同一批任务上另做了两种编辑:中性版改一条它很少提的规则,新增版加一条测试根本不查的要求。中性版 10 次尝试全部跟随,新增版 20 次里跟随 19 次。所以它拒绝的不是「改文件」这件事,是「改到与它记住的那条规则相反」。cargo 那一次它的原话是:
Should obey even if comments contradictory。1这不是记住了答案,是记住了规矩。答案换个输入就失效,规矩不会。
四、这份报告自己划掉了三条
这份报告的力量不在结论,在它把不能证明的东西写进了摘要。第一条:无法证明训练方式——on-policy self-distillation 只是与观察相容的一种解释,同样的痕迹也可能来自别的蒸馏形式。第二条:无法判断是否有意刷榜。第三条:对照组的推理不是模型自己吐出来的,六个模型的推理是从 API 里恢复出来的,作者自述这套方法 fuzzy。8
测量本身也分层。可复现的那一层是最硬的:尝试级轨迹、判官标注与分析脚本都发在公开数据集里,总量 4.32 GB——但它需要登录并接受条款才能下载,我们这次没有下载,因此只核到文件清单与总量,没有独立复核。9 中间那一层靠判官:隐藏规则由 GPT-5.6 Sol 判定,判官看得到隐藏测试代码,看不到模型名,人工只做抽查。
还有两处数字容易被读成结论。Terminal-Bench 本身有评分漏洞:其中 10 次通过的尝试要么用了已知漏洞,要么是在测试没覆盖的地方偷工,剔掉之后 66.7% 降到 61.4%。而 HLE 上的「回忆」这一项分不出谁——K3.1 自称记得答案的比例是 31.1%,Claude Fable 5 是 30.7%。1
同一个模型的分数也不止一个。Artificial Analysis 自跑是 67.2%(mini-swe-agent,每题三次),Moonshot 自己博客写 65.7%(Claude Code harness),Terminal-Bench 官方榜 35 行里则根本没有 Kimi 条目。101112
五、分数之外还能拿什么
报告的出路不是「别用榜单」,是把藏起来的那一半搬到可核的位置。三样东西都有现成先例——出题方也不是没有动作:OpenAI 在 2026 年 2 月宣布不再报告 SWE-bench Verified,理由是它越来越被污染,而所测的每一个前沿模型都能复现 gold patch。13
一是私有留出题。 HLE 公开 2,500 题,另存一套私有题专门测 overfit 与 gaming,论文把这条写进了方法。14 反过来,Terminal-Bench 的论文明确说私有测试集不在本文范围内——所以这一条对它的分数不成立,只能由榜方另做。
二是把规则写进题面,只比那些题。 24 道无隐藏规则的题上,K3.1 是 68.1%,GPT-6.1 Sol 是 70.8%——它不再领先。分数拉开的地方,只在 39 道有隐藏规则的题里、它先说出规则的那 16 道上。
三是让轨迹随分数一起交。 Harbor Hub 从 2026 年 4 月起要求所有通过的 trial 附 ATIF 轨迹(记录消息、推理、工具调用与观测的格式),并用 agent judge 复核全部通过项;上网找解被定义为最常见的 reward hacking,抓到则该次记零。15 没有轨迹,「它凭什么」这个问题就只能靠猜。
这三样都要出题方或提交方配合。手上只有一行分数的采购方没有这个条件——那一行只能当上限。
不能确定的
Moonshot 没有公开回应。 截至 2026-11-05 中午,官方 X、博客、帮助中心、微信公众号与服务状态页五个面上都没有检索到针对该报告的表态;这是「未发现」,不是「拒绝回应」。同一时间窗内,官方只发了权重开放的帖子。16
报告有一句已经过时。 正文写「K3.1 目前只由 Moonshot 提供,权重尚未公开」,而权重在 11 月 4 日 16:00 UTC 已经放出。这既是文本的时滞,也说明报告的所有测量都发生在权重封闭、只能通过 API 取推理的那个窗口里。
两代模型的基线对不上。 报告自测 K3 在 Terminal-Bench 4.0 上是 20.6%(每题一次),Artificial Analysis 的公开读数是 12.63%。差距有八个多百分点,报告没有解释;跨模型的比较因此要打一个折扣。
榜单没有跟。 Artificial Analysis 的 Terminal-Bench 4.0 页面在取数时(11 月 5 日 04:50 UTC)仍把 K3.1 排在第一位,也没有针对这份审计的注记。17
第三方复现只有声称。 作者公告串下有人表示,自己在别的任务变异集上见过类似行为,指向 GLM-5.3 与 Opus 5,没有给数据。7 Reddit 的讨论串则质疑了基准本身与比较方式,也提出另一种解释——模型被某种开发者提示词训练过,于是习惯先想「Kimi 该怎么做」。18 这些都不是证据,但都指出了同一个空缺:没人拿到训练数据。
报告没有回答它自己提出的问题。 它证明了行为,没证明来源;指出了一个方向,没排除其他方向。对一份发布后十一天写成的快速研究,这是能到的最远处——也是它值得被认真读、而不是被当成判决书的原因。
References
- 1
- 2Kimi K3.1 Pro launches at 4th on the Intelligence Index
artificialanalysis.ai
- 3terminal-bench v4.0.0
github.com
- 4CONTRIBUTING.md at v4.0.0
github.com
- 5Terminal Bench 4 Is Saturated
preferencemodel.com
- 6Terminal-Bench 4.0.0 review
epoch.ai
- 7
- 8
- 9R40 benchmark investigation dataset
huggingface.co
- 10Terminal-Bench 4.0 on Artificial Analysis
artificialanalysis.ai
- 11Kimi K3.1 Pro Tech Blog
kimi.ai
- 12Terminal-Bench leaderboard
tbench.ai
- 13
- 14Humanity's Last Exam, Nature 649
nature.com
- 15
- 16@Kimi_Moonshot on X
x.com
- 17Kimi K3.1 Pro on Artificial Analysis
artificialanalysis.ai
- 18
Comments