升到 4 比特慢了 29%、1 比特快了三倍却没掉分、198 tok/s 的第一名答不出法国首都
七组来自 Reddit、X、小红书与公众号的实测都在调同一个旋钮:权重留几位,换回来的是速度还是别的,代价又落在哪一格。

今天早上六点五十三分,一台 4080S 上跑出了榜上最快的 198 tok/s,问它法国首都是哪,回的是「ireire 撕 ire 焦 / CT Trans…」1。
十九分钟后,一张 6 GB 的 GTX 1660 SUPER 把同一份 1-bit 权重的解码从 19.0 tok/s 抬到 56.6,困惑度从 18.11 动到 18.10,贪婪解码的输出逐字节一致2。
傍晚六点十八分,有人发帖说低量化让自己的思考模型想得更久,省下来的速度又被吃回去3。
同一个白天里,还有人把精度提了一档、双卡掉了 29%,靠第四张卡补回来;有人把权重按 bit 劈成两层,低比特在显存里起草、高比特在内存里校验;今晚七点零五分,双 R9700 上报出 130 与 375 两个数4。
七组材料调的是同一个旋钮——权重留几位——方向却分成两派。
| 材料 | 压到哪一档 | 补的是什么 | 代价落在哪 |
|---|---|---|---|
| 小红书 momo,4080S 16GB | Hy-Memory-30B-A3B Q2_0,8.7 GB | 没有补 | 问一句首都就吐乱码,质量 4.5/10 1 |
| Reddit,1660 SUPER 6GB | Bonsai-27B Q1_0,3.53 GB | 一个 Turing 专用内核 | 只认 Q1_0 与 sm_75,KV 必须 f16 2 |
| 公众号 寂寞的熊猫,双卡 4090 | IQ3_S → UD-IQ4_XS,专家 46.8→59.5 GB | 第四张卡 | 双卡单流从 96.8 掉到 68.8 5 |
| Reddit,IQ2 对 Q8 | Flash-Next IQ2 对 27B 的 Q8_K_XL | 更多参数 | 单文件页面里多出语法错与解析错 6 |
| Reddit,2 bit 加残差 | 2 bit 显存加 6–8 bit 内存 | 一个全精度校验器 | 只在 Q8 装不下时划算,还没有 tok/s 7 |
| X @sincoice,双 R9700 64GB | EXL3 3.05bpw | 自己移植的内核与 MTP | 发出不到一小时,没有第三方复现 4 |
| Recursive Flint,厂商侧 | 输出层 4 bit,再压到 NVFP4 | 离线自蒸馏 | 官方图里 Qwen3.8 稠密仍更高 8 |
一、198 tok/s 的第一名,答不出法国首都
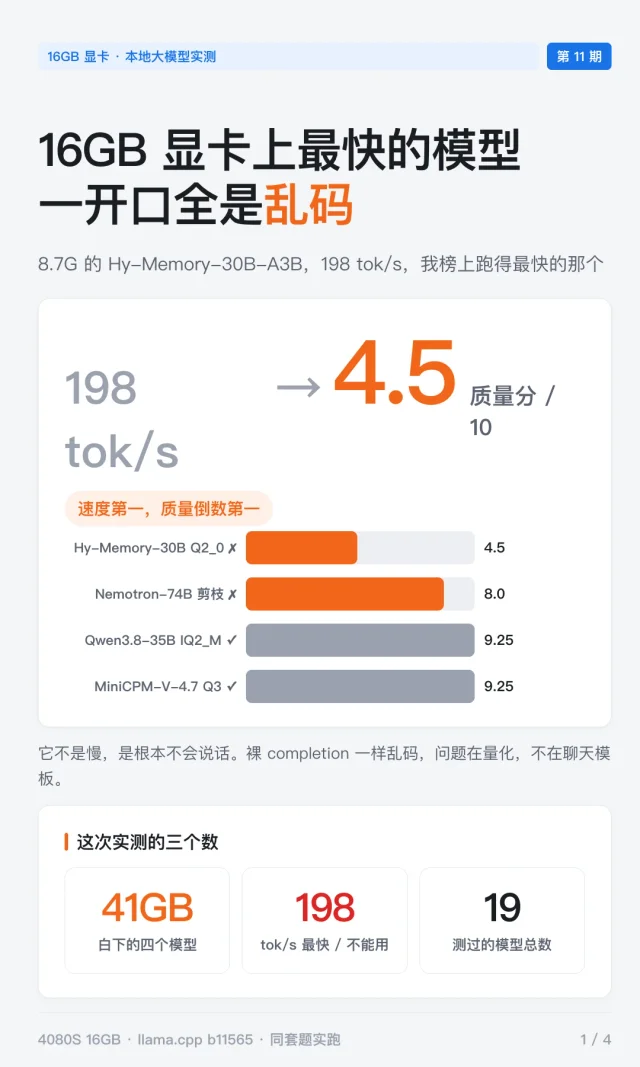
momo 的测试机是 4080S 16GB,引擎是 llama.cpp b11565,同一套题跑了 19 个模型,前后下载了 41 GB 权重1。
排第一的是 Hy-Memory-30B-A3B,momo 说这是腾讯出的长记忆模型;Q2_0 量化后 8.7 GB,跑到 198 tok/s,比她榜上任何模型都快。
问它法国首都是哪,它回「ireire 撕 ire 焦 / CT Trans…」。换成裸 completion 调用,输出一样乱,可以排除聊天模板。
原因写在量化作者的 README 里:这一版 Q2_0 没做 imatrix,作者自己标了「weak without an imatrix」。她下载时没看到那行字。
同一批 41 GB 里还有三个坑。Nemotron-3.5-Bolt-74B 的 REAP50 版剪掉一半专家,压到 12.5 GB,83 tok/s,逻辑题只拿 3 分:那道「只能进隔壁房间一次」的题,它理解成「只能按一次开关」。剪枝作者说编码和工具调用只掉 5–6 分,也明确没测中文。
Bonsai-2-27B-262k 标称 262K 上下文,抓到 3.3 万 token 就捞不到她要的那句话。
名字里堆了六个模型名的缝合微调版 13.3 GB,显存占到 15.7/16 GB,77 tok/s;同底模更小的量化版反而快 15%。
留下来的几个模型是同一个形状:MoE,激活 2–3B,量化 2–4 bit,144–166 tok/s,质量 9 分档。Qwen3.8-35B 的 IQ2_M 与 MiniCPM-V-4.7 的 Q3 都是 9.25 分。
二、同一个 1-bit 模型,换掉内核就快了三倍
u/Own_Guarantee8476 手上是一张 GTX 1660 SUPER:Turing 架构,6 GB 显存,没有 tensor core。
他跑的是 Bonsai-27B 的 Q1_0 版,3.53 GB,每个权重只有 +1 或 −1。原生 llama.cpp 在 tg512、深度 2048 下是 19.0 tok/s,换上他写的 CUDA 补丁后是 56.62。
权重一个 bit 没动。补丁做两件事:一个给 Turing 写的 Q1_0 矩阵内核,单矩阵约 2.7 倍;再加上单 token 注意力内核与 Gated DeltaNet 的融合,凑出三倍。Bonsai-27B 属于 Qwen3.5 那一系,48 层 Gated DeltaNet 加 16 层注意力。
质量这边能直接对,因为量化档没换:困惑度 18.11 对 18.10,llama-server 的贪婪回复与原生版逐字节相同。全程没有超频。
代价写在仓库的限制里:只认 Q1_0,不认 TQ1_0、IQ1_S、IQ1_M;只认 Turing 的 sm_75,也就是 GTX 16 系、RTX 20 系、Quadro RTX 与 T4;KV 缓存必须留在 f16,快的那条注意力内核不认 q8_0;端到端只在 Windows 上的一张 1660 SUPER 上验过9。
仓库里那张 llama-bench 截图给的是 18.71±0.21 对 54.32±0.14,比帖子里写的 19.0 与 56.6 略低,两次运行的口径不完全一样。
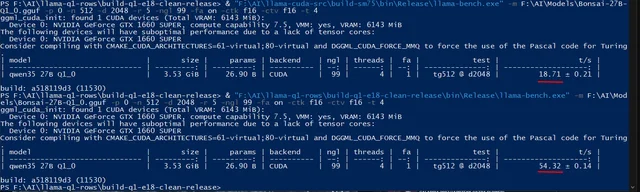
-ctk f16 -ctv f16 就是它说的 KV 必须留在 f16。9Loading content card…
三、精度提一档,双卡掉 29%,第四张卡补回来
寂寞的熊猫把生产机上一直在跑的 GSQ-RCO IQ3_S 换成 Unsloth 的 UD-IQ4_XS,引擎一起升到 Strata v0.1.455。
UD-IQ4_XS 是三个 GGUF 分片,共约 93.7 GB,其中专家权重 59.5 GB;IQ3_S 是两个分片 83.7 GB,专家 46.8 GB。同一台机器上,专家层多了 12.7 GB,涨幅 27%。
双卡 RTX 4090 只装得下约 11.8 GB 专家,其余专家留在主机内存,每生成一个 token 都要经 PCIe 搬一次。多出来的 27% 字节落在吞吐上:单流从 10 月 16 日 IQ3_S 的 96.8 tok/s 掉到 68.8,降 29%。
他给出的解法是加卡。同一版本、同一模型、同一套启动参数,512 token 流式请求,思考内容一并计入:
8 并发满载时四张卡的显存落在 21.8–23.4 GB,GPU 核心利用率只有 37%–43%。算力还剩六成,吞吐却翻了一倍多,挡住它的是搬运通道。
5293 token 的提示预填用 1.786 秒,速率 2963.6 tok/s。
还有一个坑:他开着 MTP,草稿头是 q2_0,接受率 58%–69%。想换 Unsloth 那份 Q4_K_M 草稿头提命中率,怎么调都起不来;翻源码发现
mtp_rt.py 把 Q2_0 的张量块形状写死了。四、IQ2 打赢 27B 的 Q8 吗:一条帖里两拨人给出相反答案
u/Borkato 的机器装不下更大的东西,只能跑 Flash-Next 的 Q2,也能跑 27B 稠密的 Q8。发帖前他问过一圈,得到的回答是「打平,或者 Q8 碾压」6。
他自己的结论相反:在复杂、烦人、特别细微的编码 bug 上,Flash-Next 明显更好,会主动跑测试、会真的想问题、知道该看哪儿。他也写明这是主观感受。
41 条评论里,第一条就是反例。u/MrMisterShin 用同一句提示词在 OWUI 里让两边各做一个单文件 SaaS 落地页,27B 在 Q8_K_XL、FP8、INT8 三档都比 Flash-Next 的 IQ3_S 好;Flash-Next 在 JavaScript 块里写出了语法错误与解析错误,发生在 29k token 以内。他补了速度:27B Q8 预填 1200、出字 90,Flash-Next IQ3_S 是 1800 与 140。
第三种声音按任务分:27B 稠密适合规格已经写清楚、照着实现的任务;开放式地「在仓库里找细微 bug」,Flash-Next 赢。还有人提醒,GSQ-RCO 这类量化族与普通 ggml 量化不能直接横比,他测的 IQ3 比 Q6 更强、工具调用出错更少。
同一天另一条帖问的是同一件事的另一面:低量化会不会让模型想得更久。u/Banana-Negra 的体感是思考块越写越长,省下的速度被吃掉,agent 循环里更明显;他还没系统测,先来问3。
评论给了三条边界。
30B 上下的小模型对激进量化最敏感;250B 到 1T 的模型配上好的 EXL 量化,压到 3bpw 思考轨迹几乎不变。
别让量化动 ngram 表——有人把 ngram 拼回原精度,才修掉一些奇怪的输出。
低于 Q2_K_X 就该考虑换一个小一点、精度高一点的模型,硬压是假省钱。
Loading content card…
五、把权重按 bit 分层:低比特做草稿,高比特做校验
u/Happy_Guitar3521 提的做法是:显存里放一份 2 bit 的模型,剩下的 6–8 bit 残差留在系统内存。2 bit 那份负责起草,完整模型负责校验;GPU 算 2 bit 的部分,CPU 算残差的部分,只有激活值过 PCIe7。
因为草稿本身就是校验器的一半,它不额外占内存。
他量到的几件事:2 bit 加 8 bit 残差比 Q8_0 更接近 bf16,KL 约一半;6 bit 残差能到 Q8_0 的质量,从内存少读约 28% 的字节。
复用校验器 KV 的 2 bit 草稿,每次检查的接受 token 比 Google 官方的 Gemma 4 草稿器(31B、16 节点树)多 25%–30%,5.23 对 4.20。
CPU 内核检查 16 个 token 与检查 1 个差不多快,因为卡在内存带宽上。
他自己把限制写在前面:这些都是真实权重,但反量化后在 PyTorch 里跑,所以一个 tok/s 都没有;他只做到这里,孩子和工作占掉了时间;只有在 Q8 装不下显存时这套方案才有意义,装得下就直接用 llama.cpp10。
最接近的已有工作是 SubSpec,那份用独立的 4 bit 副本、通过 PCIe 流式传权重;差别在于这里按 bit 把模型劈成两半。
Loading content card…
六、双 R9700 上自己写内核,EXL3 3.05bpw 跑出 130 与 375
@sincoice 的机器是两张 Radeon R9700,合起来 64 GB,引擎是 SGLang 加 ROCm 7.2,权重是 Qwen3.8-Flash-Next 的 EXL3 量化,3.05 bpw4。
单路解码约 130 tok/s,8 路并发总吞吐约 370 tok/s,每路约 46 tok/s;上下文 262144,24 万 token 的长文检索跑通,22.5 万 token 的预填约 115 秒。
这些数来自他自己改过的引擎:把 EXL3 的内核移植进 SGLang,加了 MTP 投机解码,写了跨卡的规约融合内核,还做了冷专家跳过;两张卡之间是 PCIe 5.0 x8 直连的 P2P。
另一条帖里他给了同机对照:和 27B 稠密比,速度互有胜负,质量显著更好(p=0.004);那条英文帖的 8 路数字写的是 375 tok/s11。p 值说明他跑过统计检验,两帖都没写样本量与题目。
两条帖发出来不到一小时,没有回复,浏览量个位数,调优细节他说晚点整理。这套数字目前只有作者一个人报过。
七、Flint:厂商把输出层压到 4 bit,再用自蒸馏补回来
Recursive 昨晚放出了 Flint,Apache-2.0,40B 总参、每 token 激活约 2.5B8。
结构是 49 层,前 2 层稠密、后 47 层 MoE;每层 256 个路由专家,每次选 6 个,另加 1 个共享专家;注意力是 35 层滑动窗口(窗口 513)加 14 层全注意力;上下文配置 262144,官方博文说最长能到 512K,编码任务建议压在 256K 内。
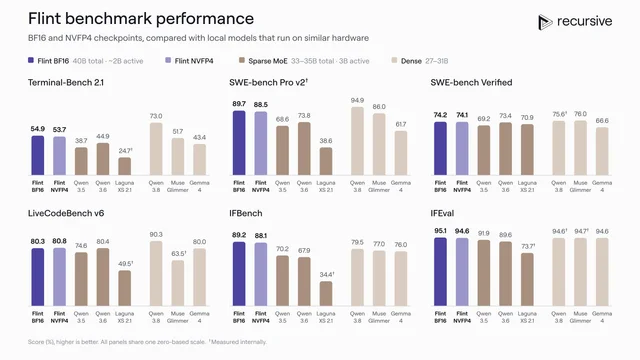
官方给的三项:Terminal-Bench 2.1 是 54.9%,SWE-bench Pro v2 是 89.7%,SWE-bench Verified 是 74.2%。采样统一为温度 1.0、top-p 0.95、top-k 20;Terminal-Bench 用 Terminus 2,靠网页检索拿到的解算作失败;SWE 两项用 mini-swe-agent、断网;带 † 的分数是 Recursive 自己测的。
量化这一节值得单读。他们把输出层(lm_head)压到了 4 bit,这在常规做法里是避开的;理由是只有 2.5B 激活时,输出层占每 token 读取权重的很大一块。
为了补回精度,他们加了一步离线蒸馏:量化后的模型在一批自采的 coreset 上、以 16 bit 版本为教师重新学,训练步数比量化感知训练的基线少近一半。最终 NVFP4 版本在各基准上与 16 bit 差 0.7 分以内12。
速度是官方的强项:M4 Pro 48GiB 上短上下文 131.22 tok/s、128K 会话平均 68.89;同机 llama.cpp 版是 87.98 与 47.58;对照 Qwen3.6 35B-A3B 是 65.55 与 37.13。RTX Spark N1X 上 NVFP4 版 155.82 与 101.95。
官方那张图里还有一栏要自己看:SWE-bench Pro v2 上,Qwen3.8 稠密的 94.9 高于 Flint 的 89.7;Terminal-Bench 2.1 上,Qwen3.8 的 73.0 高过 Flint 的 54.9。图例把 Qwen3.8 归在 27–31B 的稠密那一栏。这两栏与「与同尺寸稠密模型相当」的说法对不上。
首批用户还在等:r/LocalLLaMA 上最早那条帖子的作者写着「可能终于能掀翻 Qwen3.6-35B-A3B」,几小时后又补了一句,早期的报告显示 Ornith-1.5 仍是这一档的标准,希望只是早期实现的毛病13。
顺带
- 同一台 RTX 5070 12GB 加 5060 Ti 16GB 上,@murasametech 只改预填分块大小,8192 → 4096 → 2048,约 1.4 万 token 的预填从 189 涨到 241、再到 417–440 tok/s,加载时间从约 74 秒缩到 30 秒出头。他的理由是本地不按次计费,才敢一组一组地试14。
- @sora_dev_05 在 RTX 3090 加 5070 Ti 上把 Strata 的短回复从 103 调到 121、长回复从 105 调到 132,只动了两个开关:
--pipeline-windows 2与--resident-experts。踩到的坑是--adapt-async 1单独开并不生效,日志里要求先有 resident15。 - 小红书 爱吃饭饭饭饭饭的 idiot 用一张 11 GB 的 2080Ti、约 2000 块的洋垃圾配置跑 Qwen3.8-flash,标题写 91.4 tok/s,正文写「速度超过 100 token/s」,没给题目与上下文16。
在你自己机器上,先查这四样
- 先确认那个速度是在「能回答」的前提下测的:同一个问题问三次,答案里出现乱码就作废。
- 记下权重文件的总大小,以及实际装进显存的专家层有多大;文件名里的 bit 数说明不了这件事。
- 同一个任务在你能装下的两档上各跑一次,比总时长,把思考 token 算进去;只看 tok/s 会看反。
- 看引擎有没有把思考预算算进回复上限:8192 的总上限里思考吃掉 6144,正文就会是空的。
现在就能做的一件事:启动 llama-server 之后看第一行日志里的
file type =,确认加载的真是你以为的那一档;不认识的格式当场换掉。References
- 1小红书 momo《16GB显卡最快的模型,一开口全是乱码》
xiaohongshu.com
- 2
- 3
- 4X @sincoice
x.com
- 5公众号 寂寞的熊猫《Strata v0.1.45 实测》
mp.weixin.qq.com
- 6
- 7
- 8Hugging Face RecursiveSI/flint
huggingface.co
- 9GitHub pinkmanwest/llama-q1-turing
github.com
- 10Hugging Face HappyGuitar123/twobit-residual-spec
huggingface.co
- 11X @sincoice
x.com
- 12Recursive《Introducing Flint》
recursive.com
- 13
- 14X @murasametech
x.com
- 15X @sora_dev_05
x.com
- 16小红书 爱吃饭饭饭饭饭的idiot
xiaohongshu.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.