10月5日-10月11日大模型发布追踪:Haiku 5.5、Mistral Large 4 与 GPT-6 全员上线
本期核对 10 月 5 日至 10 月 11 日的发布,比较 Claude Haiku 5.5 的分档降价、Mistral Large 4 的万亿参数开放权重、GPT-6 面向全部 ChatGPT 用户的分层上线,以及通义千问图像模型的新接入方式。

覆盖窗口是 2026 年 10 月 5 日至 10 月 11 日(UTC+08:00)。
这一周,Anthropic、OpenAI、Mistral 和阿里通义做的是同一件事:把已经验证过的能力挪到更便宜的一档。10 月 7 日 Anthropic 发布 Claude Haiku 5.5,同一轮把 Sonnet 5.5 的缓存读取价砍掉一半;OpenAI 把 GPT-6 从付费档推到全部 ChatGPT 用户;Mistral 在 10 月 6 日拿出 1.05 万亿参数的开放权重旗舰;通义千问 10 月 11 日把图像模型的 Pro 与 Turbo 两档 API 一起上线,Turbo 权重同步开放。
这一周还多出一个以前没有的名字:决策模型。10 月 6 日 OpenAI 在 API 里放出 Decisions 接口,用 gpt-6-luna 把文字和图片变成结构化答案,官方称比 Responses 接口快 10 倍。三天后微软发布 Microsoft-Decision-1,一个只做决策打分的小模型,它不写文字,只给每个选项一个可以被程序立刻判读的概率。
文中的「智力指数」与「每任务成本」来自第三方评测机构 Artificial Analysis。前者是十项评测加权得到的综合分,后者是跑完这套评测平均每次任务的花费,把输入、缓存、推理与输出的 token 价格都算进去。厂商自报跑分的口径不同,本文把两者分列,不合成单一排名。
先看价格、状态和边界
| 模型与发布 | 发布与定位 | 关键变化 | 评测信号 | 价格与可用性 | 先测什么 |
|---|---|---|---|---|---|
| Claude Haiku 5.5 1 | 10 月 7 日发布;Claude 5.5 系列第三个模型,官方定位为迄今最快、最便宜、能力最强的小模型 | 10 万 token 以内的请求比 Haiku 4.5 便宜 90%,超过 10 万 token 便宜 50%;首个带可调 effort 档位的 Haiku;上下文从 200K 提到 1M;换用新分词器 | 官方自报 OSWorld 2.1 从 15.7% 升到 72.4%、Terminal-Bench 4.0 从 0% 升到 39.2%、HLE 无工具从 10.2% 升到 45.9%、GDPval-AA v2.1 为 1620;Artificial Analysis 独立记录智力指数 43,比上一次 Haiku 发布高 26 分,每任务输出约 16.2 万 token 2 | 每百万 token 输入 $0.10、输出 $0.50、缓存读取 $0.01(10 万 token 以内),超过 10 万 token 为 $0.50 / $2.50 / $0.05;模型名 claude-haiku-5-5,Anthropic API、AWS、Google Cloud、Azure 同步可用;Sonnet 5.5 缓存读取价同期由 $0.20 降到 $0.10 | 把摘要、压缩、子智能体这三类高频短任务从 Haiku 4.5 换过来,按新分词器后的真实 token 数重算账单 |
| GPT-6(ChatGPT 全线)3 | 10 月 7 日面向全球 ChatGPT 用户推出;GPT-6 系列从付费档铺到免费档,官方给出的规模是每周 12 亿用户 | 新增 Intelligent UI,回答可以带图表、按钮、表单和可交互组件;模型边想边答,官方称联网检索类问题开始作答平均早 44% | 官方自报 GPT-6 Extra High 开始作答的时间与 GPT-5.6 Medium 相当、总分高于 GPT-5.6 Extra High;本期没有第三方独立数据 | 付费档用 GPT-6 Sol,每百万 token 输入 $2、输出 $10、缓存输入 $0.20;免费档与 Go 用 GPT-6 Luna,$0.10 / $0.50、缓存输入 $0.01 4;只改 Chat 主对话,Work 与 Codex 的底层模型不变 | 在自家场景里量一次「边想边答」对首字延迟的影响,并确认 Intelligent UI 生成的组件能不能接进现有前端 |
| Mistral Large 4 Preview 5 | 10 月 6 日开放公开预览;Mistral 迄今最大的模型,官方称其代表开放权重的性能前沿 | 1.05 万亿总参、每 token 激活 52B,另有 1.6B 视觉编码器,原生多模态 MoE;官方文档标 1M 上下文;训练用 3,800 块 NVIDIA Grace Blackwell,全程在欧洲自建机房 | 官方自报 DeepSWE v1.1 61.7%、Terminal-Bench 4.0 28.3%、AutomationBench 59.9%、Dense 200 视觉定位 42%;Artificial Analysis 独立记录智力指数 38、网络安全指数 50、每任务成本 $1.13 6 | 每百万 token 输入 $1.36、输出 $4.18、缓存输入 $0.14;预览期前两周五折,即 $0.68 / $2.09;权重定在本月底开放,此前先交给网络安全机构与监管方做红队 7 | 拿需要视觉定位或安全分析的样本先试;成本敏感的场景先记下它比同智力的开放权重模型贵几倍 |
| Qwen-Image-2.1 Pro / Turbo 8 | 10 月 11 日千问 AI 平台上线两个 API;Turbo 权重 10 月 9 日已放进 Hugging Face | Pro 是 70 亿参数的生成编辑一体模型,支持最多 10 张参考图与圈选、涂抹、掩码编辑,可出原生透明图;Turbo 在同一架构上把去噪从 40 步压到 8 步,仍出 2K 图 | 官方未公布新跑分,本期也没有可引的第三方独立评测;「8 步不掉画质」目前只有厂商说法 | 千问 AI 平台按张计费,Turbo ¥0.1、Pro ¥0.25 9;Turbo 权重在 Hugging Face 开放,许可为 Qwen Research License,商用需另行申请 10 | 用自家商品图或人像做一次 10 张参考图的合成与局部编辑,重点看文字渲染、身份保持和 8 步出图的稳定度 |
注:价格按美元或人民币原币列示,不做汇率换算。表格「评测信号」一列把厂商自报与 Artificial Analysis 的独立数据分列,两者口径不同;「每任务成本」是跑完智力指数的加权平均,与厂商按单个基准算出的每任务成本不能直接比。
Claude Haiku 5.5:把 Haiku 档的单价压到上一代的十分之一
Anthropic 在 10 月 7 日发布 Claude Haiku 5.5,把它定位成摘要、压缩、数据库查询、分类这类高频任务的主力,也是 Opus 5.5 与 Sonnet 5.5 做编码时的子智能体。1
这一代最实在的改动是计价方式。Haiku 5.5 按输入长度分档:10 万 token 以内的请求,每百万 token 输入 $0.10、输出 $0.50;超过 10 万 token 的部分,输入 $0.50、输出 $2.50。缓存读取同样分档,$0.01 与 $0.05。对照 Haiku 4.5 的 $1.00 / $5.00,同一档的单价降到十分之一。1
官方说,上一代 Haiku 有九成请求落在 10 万 token 这个档里,所以按综合运行成本算,Haiku 5.5 便宜约 75%。这个数字要打折看:Haiku 5.5 换了新分词器,完成同一件事会多消耗一些 token,单价降幅有一部分被抵消,官方没有给出统一的实际节省比例。1
能力上,官方自报的跳变集中在电脑操作和命令行编码。OSWorld 2.1 从 Haiku 4.5 的 15.7% 升到 72.4%,Terminal-Bench 4.0 从 0% 升到 39.2%,HLE 无工具从 10.2% 升到 45.9%,知识工作的 GDPval-AA v2.1 从 735 升到 1620。Haiku 5.5 也是 Haiku 系列第一个带可调 effort 档位的模型,用户可以在成本和智力之间自己选,默认停在中档。1
第三方给出的是另一面。Artificial Analysis 记录 Haiku 5.5 在 max 档的智力指数为 43,略高于 GLM-5.3-Flash(42)、Gemini 3.8 Flash(41)与 GPT-6 Luna(38),比同代的 Sonnet 5.5(56)低 13 分。它的上下文窗口也从上一代的 200K 提到 1M。2
代价落在 token 用量上。跑完一轮智力指数,Haiku 5.5(max)平均每个任务输出约 16.2 万 token,约为 GPT-6 Luna(max)的三倍;从 xhigh 升到 max 只多拿 2 分,token 却要多约 1.8 倍。也就是说,它更适合范围明确、可以拆小的任务,长链路的智能体任务仍要交给 Sonnet 5.5 和 Opus 5.5。2
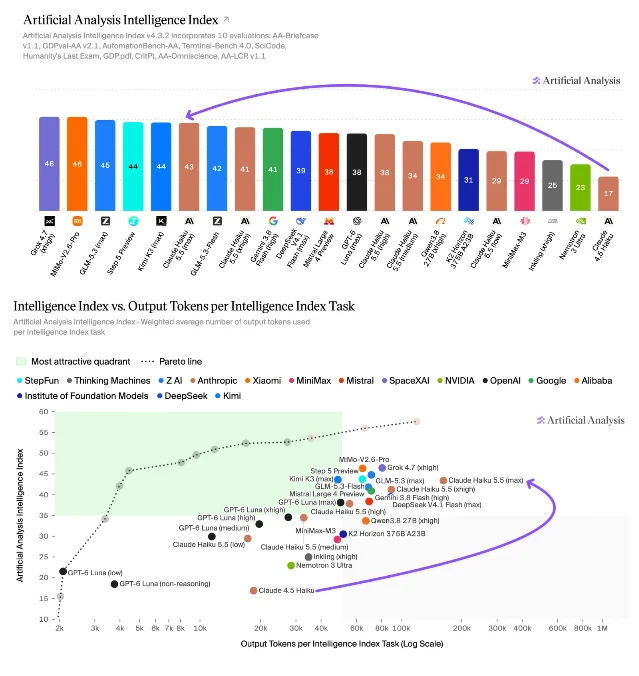
独立评测里还有两处出入值得记。Terminal-Bench 4.0 上 Artificial Analysis 记录的是 33%,比官方自报的 39.2% 低 6 个百分点;AutomationBench-AA 上它只拿到 35%,Artificial Analysis 说明这是发布前的一次安全拒答导致过度拒绝,Anthropic 正在修,该机构会重跑这项。2
安全侧有一条边界。Haiku 5.5 的网络安全护栏比 Haiku 4.5 更严,但比 Anthropic 最近几款模型松一些:它允许比 Sonnet 5.5 更宽的一批防御性任务,渗透测试仍在拦截范围内。生物学护栏与 Sonnet 5、Sonnet 5.5、Opus 5 保持一致。1
同一轮里 Anthropic 还做了两件抬高性价比的动作。Sonnet 5.5 的缓存读取价从每百万 token $0.20 降到 $0.10,官方测算多数智能体任务因此便宜约 20%;Max 与 Team 订阅者开始每月领取 Claude Platform 的 API 额度,Max 5x 为 $100、Max 20x 为 $200,Team 最多 $500 合并使用。1
OpenAI:GPT-6 走进 ChatGPT 主入口
OpenAI 在 10 月 7 日把 GPT-6 推到全球 ChatGPT 的 Chat 主对话,付费档(Plus、Pro、Business、Enterprise)用 GPT-6 Sol,免费档与 Go 用 GPT-6 Luna,第二天覆盖到全部用户。官方给出的规模是每周 12 亿用户。Work 与 Codex 的底层模型这一次不动。3
最容易感知的变化在界面。Intelligent UI 让模型按问题自己决定回答的样子,可以是并排比较、可交互的图、表单、图表,也可以是一段纯文字。OpenAI 的做法是给模型一套原生可流式的组件库,再加一个编译器,让界面在模型生成的同时逐段出现。3
另一处变化在作答方式。以前的推理模型要先想完再答,GPT-6 被训练成边想边答。官方称在内部的日常智能体任务评测里,GPT-6 Extra High 开始作答的时间与 GPT-5.6 Medium 相当,总分高于 GPT-5.6 Extra High;需要联网检索的问题,GPT-6 Instant 平均早 44% 开始作答。3
价格结构决定了这次铺开的分层:GPT-6 Sol 每百万 token 输入 $2、输出 $10、缓存输入 $0.20;GPT-6 Luna 输入 $0.10、输出 $0.50、缓存输入 $0.01。免费档拿到的是便宜十倍的 Luna,付费档拿到 Sol。4
API 侧同一周还有三条。10 月 6 日上线 Decisions 接口的 beta,用
gpt-6-luna 把文字和图片转成带类型的答案,官方称比 Responses 接口快 10 倍;10 月 7 日更新 chat-latest 快照,指向 ChatGPT 里最新的那个模型;10 月 8 日给 gpt-6.1-sol 加上 Ultrafast 档,用 service_tier: "ultrafast" 调用,全部 API 用户可用,覆盖全球处理与美欧数据驻留。4Mistral:1 万亿参数的开放权重,这一次从欧洲发出
Mistral 在 10 月 6 日开放 Mistral Large 4 的公开预览,内部代号 Le Chonk。它是一个 1.05 万亿总参、每 token 激活 52B 的原生多模态 MoE,另带一个 1.6B 的视觉编码器,官方文档标 1M 上下文。训练在 Mistral 欧洲自建机房的 3,800 块 NVIDIA Grace Blackwell 上完成,训练语料覆盖 160 多种语言。57
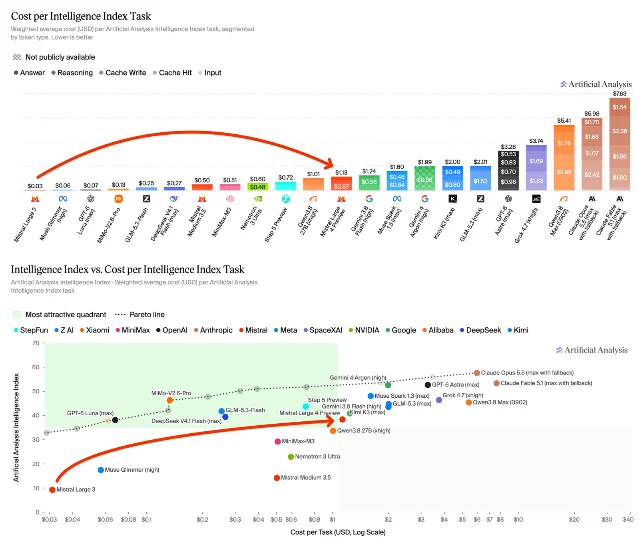
这个模型改变了一条记录。Artificial Analysis 把它记为智力指数 38,与 DeepSeek V4.1 Flash(max,39)和 GPT-6 Luna(max,38)同档,成为美国和中国之外最强的模型,法国因此回到了那张按国家排序的前沿曲线上。6
它的位置不在智力,在价格。标准价是每百万 token 输入 $1.36、输出 $4.18、缓存输入 $0.14;预览头两周打五折,即 $0.68 / $2.09。Artificial Analysis 记录的每任务成本为 $1.13,折后 $0.57,仍高于同智力的开放权重模型:GLM-5.3-Flash 是 $0.25,DeepSeek V4.1 Flash(max)是 $0.27,相差四倍以上。6
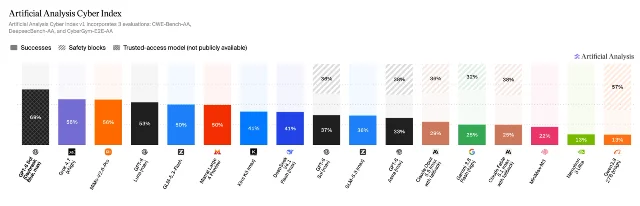
官方把网络安全当成主打方向。在 Artificial Analysis 的网络安全指数上,Mistral Large 4 得 50 分,与 GLM-5.3-Flash 持平,低于小米 MiMo-V2.6-Pro 的 56;在指数里一项要求先复现真实漏洞再修补的测试中,它拿到 82%,是全场最高。Mistral 特别指出,Claude Opus 5.5 与 GPT-6 Astra 在同一项上接近零分,原因是拒绝执行,而验证漏洞是否真实存在恰恰是防御工作的起点。56
权重不在今天。官方说本月底开放,此前先把同一模型、降低护栏并放开网络能力的版本交给网络安全机构、受审伙伴和国家监管方做实战红队。这一档能力现在先走「可信方优先」的通道。5
通义千问:图像模型上线 API,Turbo 权重同步开放
阿里通义千问在 10 月 11 日把 Qwen-Image-2.1 的 Pro 与 Turbo 两个 API 上线千问 AI 平台,Turbo 权重同时开放。权重实际更早就放出去了,Hugging Face 上的仓库在 10 月 9 日创建。开发者这次有两条路:想省事的直接调 API,要自己跑的拿权重。1011
Pro 是这一代的主模型。它的视觉生成部分是 70 亿参数、32 层单流 DiT,生成和编辑合成一个模型:既能从文字出图,也能编辑透明图层,还能从照片里把主体抠出来。它最多吃 10 张参考图,局部编辑支持圈选、涂抹和独立掩码,人像编辑上强调保留面部身份,商品编辑上强调保住文字、纹理与形态。9
Turbo 是同一架构上的加速版。它把去噪从原版的 40 步压到 8 步,仍能出 2K 图,官方称质量不掉。这个取舍值得自己验一遍:步骤减少八成,实际耗时不会等比例下降,画质也还没有独立评测。8
价格按张算,Turbo ¥0.1、Pro ¥0.25,都在平台上直接开通,并发上限分别是 10 与 10、每分钟请求数上限 120 与 20。要留意授权:Turbo 的模型卡标的是 Qwen Research License,权重可以下载,免费使用限于非商业研究与评估,商用要单独申请。8910
本期其他条目
微软:Decision-1 把「决策」做成一类模型
10 月 9 日微软发布 Microsoft-Decision-1,一个只做决策打分的模型,可在微软 Foundry 与 OpenRouter 调用。它不生成文字:给定一个情境和一组固定选项,它给每个选项一个校准过的概率,支持是非题、多选题和打分。底座是把 Qwen3.5-9B 后训练而来,微软说之后会换到其它底座,包括自家 MAI 与 OpenAI 的模型。12
价格是每百万输入 token $0.042,输出不计费。官方称它在 36 项、近 15 万道题的比对里准确率最高,P50 延迟约为 GPT-6 Sol 的 1/35;把同一个请求做八种改写后,只有 1.3% 的情况会改变决定,选项描述被改写或选项顺序被打乱时一次都没有翻盘。这条与 OpenAI 10 月 6 日的 Decisions 接口是同一件事的两端:一部分模型开始不写文字,只输出可以直接接进程序的分支。12
Google DeepMind:EmbeddingGemma 2 开放多模态嵌入模型
10 月 6 日 Google DeepMind 发布 EmbeddingGemma 2,一个 7.4 亿参数的开放嵌入模型,Apache 2.0 许可,把文本、图像、音频、视频映到同一个向量空间,权重在 Hugging Face 与 Kaggle 可下载。它按需拆分:纯文本最低 270M 参数,视觉编码器 170M,音频编码器 300M。上下文窗口从上一代的 2K 提到 8K,单次可处理约 5.5 分钟音频、29 张图片或 58 帧视频。它跑在本机上的意义是语义检索可以完全离线,做私有检索的团队值得先测一轮。13
Artificial Analysis:网络安全指数开始收录「受控访问」模型
10 月 8 日 Artificial Analysis 把只对特定机构开放、护栏更少的模型纳入网络安全指数。首批收录的是 GPT-6 Sol(Daybreak Blue,max),只通过 OpenAI 的 Daybreak 计划提供。它在这一版指数里升到第一,比公开可用的 GPT-6 Sol(max)高 32 分,整轮评测没有触发任何安全拦截,每任务成本 $1.77,低于 Grok 4.7(xhigh)的 $11.67。这件事对选型的提示是:同一款模型,公开版与受控版的分差主要来自拒答,而不是新增的能力。14
OpenAI:公开内部前沿模型的数学成果,两天后撤回三篇
10 月 6 日 OpenAI 在一个 GitHub 仓库里公开一批由未发布的内部前沿模型做出的数学结果,附上部分证明的 Lean 形式化,并披露了取得结果的方式,包括 10 份模型推理摘要与算力估计。官方给出的口径是平均每项结果消耗相当于约 3 小时 ChatGPT Pro 思考的算力。15
报道称这批手稿超过 700 篇、覆盖 372 个结果家族;两天后,OpenAI 撤回了其中三篇。数学界的反应不小,一份由数学家联署的声明把这次发布称为一次力量展示,并呼吁研究者暂停与之相关的这类合作。把它记在这一期,是因为它给「模型能做什么」提供了一种可机器核验的证据形式,同时也把发布方式本身的问题摆上了台面。1617
本期未纳入条目与覆盖说明
本期严格执行 2026 年 10 月 5 日至 10 月 11 日的时间窗核验,各厂商的筛查结果如下。
- DeepSeek:官方 API 更新日志在窗口内没有新条目,最新一条仍是 9 月 10 日的 DeepSeek-V4.1-Flash。窗口内与它相关的是融资报道,属于资本动作。18
- 智谱 GLM:官方模型的发布记录最近一条仍是 8 月 26 日上线的 GLM-5.3-Flash。窗口内的可核验动作是把 GLM-5.3 放进海外云渠道,属于分发层面。19
- 月之暗面 Kimi:窗口内没有发布。K3.1 到 10 月 11 日仍未上线,当天的报道称它计划 10 月中旬发布,重点提升智能体连续执行长任务的能力。20
- Meta:本期筛查未发现可核验的模型级发布,公开动作集中在广告创意工具与个人智能体协议。
- xAI:窗口内没有新模型。10 月 10 日把官方账号更名为 SpaceX Super Intelligence,属于品牌动作。
- Google:窗口内没有新的基座或 Flash 模型;除 EmbeddingGemma 2,其余是 Gemini 应用层的套餐与访问调整。
- Artificial Analysis 收录情况:本期窗口内新收录的模型只有 Claude Haiku 5.5、Mistral Large 4 Preview 与 10 月 1 日发布、已在上期覆盖的 Ling 3.1 Flash。21
面向技术选型的三项行动建议
- 把高频短任务从 Haiku 4.5 迁到 Haiku 5.5 之前,先按新分词器算一遍真实账单。 单价降到十分之一,但同一任务的 token 用量上升,两端相抵后的实际节省要自己量。同时值得把 compaction、摘要、子智能体这三类任务与 GPT-6 Luna 放在一起比:两者单价同为 $0.10 / $0.50,Luna 的 token 用量更低,Haiku 5.5 的独立评测分数更高。12
- 要自建图像生成与编辑能力,先确认授权边界再动手。 Turbo 权重可以下载,但许可是研究用途,商用要单独申请;只想尽快接入的走平台 API,按张付费,Turbo 每张 ¥0.1、Pro 每张 ¥0.25。810
- 评估最靠前那一档能力时,把「能不能拿到访问权」和「拿到后的真实通过率」分开算。 本周最靠前的几项都走受控通道:GPT-6 Sol 的 Daybreak Blue 版本只通过计划发放,Mistral Large 4 的权重开放前先做安全方红队,公开版的前沿模型在安全类评测里则因为拒答而拿不到分。514
References
- 1Anthropic:推出 Claude Haiku 5.5
anthropic.com
- 2Artificial Analysis:Claude Haiku 5.5
artificialanalysis.ai
- 3OpenAI:GPT-6 与 Intelligent UI 面向所有人
openai.com
- 4OpenAI API 变更日志
developers.openai.com
- 5Mistral:推出 Mistral Large 4
mistral.ai
- 6Artificial Analysis:Mistral Large 4
artificialanalysis.ai
- 7Mistral 文档:Mistral Large 4
docs.mistral.ai
- 8千问 AI 平台:Qwen-Image-2.1-Turbo
qianwenai.com
- 9千问 AI 平台:Qwen-Image-2.1-Pro
qianwenai.com
- 10Hugging Face:Qwen-Image-2.1-Turbo
huggingface.co
- 11
- 12微软:推出 Microsoft-Decision-1
commandline.microsoft.com
- 13Google:EmbeddingGemma 2
blog.google
- 14Artificial Analysis:网络安全指数收录受控访问模型
artificialanalysis.ai
- 15OpenAI:公开数学进展
openai.com
- 16Retraction Watch:OpenAI 撤回三篇预印本
retractionwatch.com
- 17陶哲轩博客:AHM 关于 10 月 6 日数学文件发布的声明
terrytao.wordpress.com
- 18DeepSeek API 更新日志
api-docs.deepseek.com
- 19智谱:模型与产品发布记录
docs.bigmodel.cn
- 20新浪财经:Kimi K3.1 月中发布
finance.sina.com.cn
- 21Artificial Analysis:模型发布列表
artificialanalysis.ai

This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.