刚刚,Hinton发了首篇RSI论文
Hinton 等 22 人的新论文把「AI 自己造 AI」摆上台面:Anthropic 内部数据显示获批代码八成由 AI 生成、自主研发占比半年从 1% 升到 26%;这篇讲清论文那笔「一年进步压缩成五周」的账怎么算出来,以及它自己划下的边界。

本文转载自微信公众号「量子位」2026 年 10 月 5 日推送的文章《刚刚,Hinton 发了首篇 RSI 论文》,作者梦瑶,发自凹非寺,量子位|公众号 QbitAI。原文链接:刚刚,Hinton 发了首篇 RSI 论文。
当 AI 开始参与研发下一代 AI,人类可能已经站到「智能爆炸」前夜。
最近超超超超火的递归自我改进(RSI),连 AI 教父辛顿都亲自下场了??咱诺贝尔物理学奖、图灵奖得主 Hinton 的首篇 RSI 论文,上来就研究一个相当炸裂的问题:
如果 AI 开始大规模参与造下一代 AI。然后,下一代 AI 再回来继续加速研发。这么一轮轮滚下去……会不会直接跑出一条智能爆炸曲线啊?
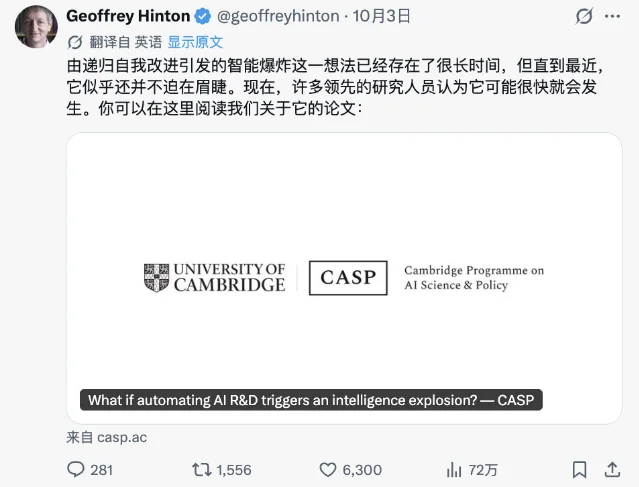
论文名叫《What if automating AI R&D triggers an intelligence explosion?》。1 它 2026 年 9 月 28 日提交到 arXiv,编号 2609.36054,归在计算机与社会(cs.CY)分类下。2
参与撰写论文的作者堪称 AI 学界全明星阵容:22 位作者里,包括两位 AI 教父 Geoffrey Hinton、Yoshua Bengio,强化学习先驱 Andrew Barto,OpenAI 首席科学家 Jakub Pachocki 等一众研究者。
这么多 AI 大牛凑在一起,讨论的正是 AI 领域最古老科幻的「智能爆炸」问题,论文核心观点先来一睹为快——
- 一旦 AI 能完整参与造下一代 AI,递归自我改进就可能真正闭环。
- AI 研发自动化一旦越过某个临界点,几年才能完成的 AI 进步,有可能被压缩到几个月,甚至更短。
- 未来 AI 实验室的研发规模,理论上可能从几千人直接跳到数百万研究员。
- 今天一年完成的 AI 进步,极端情况下,未来可能只需要约 5 周。
- 智能爆炸未必需要 AI 先变成超级智能,只要 AI 研发的自动化效率足够高,反馈循环就可能先启动。
AI 已经开始真正进入「造下一代 AI」的流水线
智能爆炸这个词,其实蛮古早了。
早在 1965 年,数学家 I.J. Good 就设想过一种超智能机器:如果一台机器已经比人更擅长设计机器,那么它可以继续设计一个更聪明的版本;新的版本继续参与下一轮改进,一轮接一轮,最后形成一个自我强化的反馈回路。
Good 当年的核心判断其实很简单——如果「改进机器」这件事本身,也能被机器做得越来越好,能力增长就可能反过来继续加速能力增长。
这套设想后来成了「智能爆炸」最经典的理论源头,和今年大火的递归自我改进(RSI)一脉相承。
只不过到了今天,RSI 讨论的重点已经悄悄变了:大家关心的已经不只是「一台 AI 能不能自己改代码、调参数」,而是一个更现实的问题——AI 能不能真正进入研发下一代 AI 的整套流程,并且让这套研发流程本身越来越快?
而辛顿等人在这篇论文里给出的一个关键判断,恰恰就是:
AI 开始真正进入 AI 研发流水线了,而且速度快得有点离谱。
之所以这么说,是因为论文引用了 Anthropic 等头部实验室的一批内部数据。
2025 年 1 月,AI 生成的获批代码还只有低个位数比例;才过了一年,到了 2026 年 5 月,这一比例已经超过 80%。3
变化更大的,是 AI「自主」完成研发工作的比例:2026 年 3 月,Claude 能够在仅接受高层次人类监督的情况下自主完成约 1% 的研发工作;到同年 8 月,这个数字已经升到了 26%。4
这两个数字都出自 Anthropic 自己发布的报告。按原文照录的口径,26% 衡量的是在高层人类监督下、可以由 AI 自主承担的内部 AI 研发工作比例,而不是 Claude 已经自动完成了 Anthropic 四分之一的全部研究;Anthropic 也说明,目前 Claude 还没有在哪一类被测 AI 研发工作上达到完全无人监督的水平。
半年左右翻了二十多倍,趋势本身已经很清楚了。
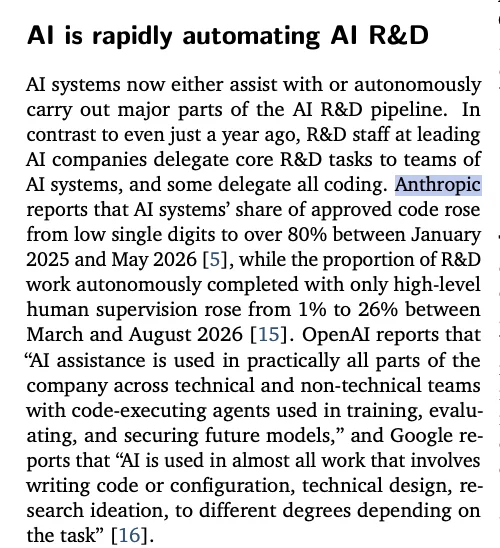
论文还提到,截至 2026 年 9 月,OpenAI 内部的 AI 系统已经可以经常完成原本人类员工需要数天完成的研发任务。论文引用的另一份报告里,OpenAI 称「AI 辅助几乎用在了公司所有部门,跨技术和非技术团队」,谷歌则称「几乎所有涉及写代码或配置、技术设计、研究构想的工作都用上了 AI,程度因任务而异」。2
这里一个很关键的变化是,AI 能独立处理的任务长度一直在增长。真正决定 AI 能不能像研究员一样工作,关键并不只是某个 benchmark 分数有多高;更重要的是,它能不能把几十个步骤连续串起来,在几个小时、几天,甚至更长时间里持续推进同一个研究目标。
论文综合 benchmark 趋势和实验室内部进展,认为未来几年 AI 有可能自动化大部分 AI 研发工作,甚至完成全部自动化。
写代码只是 AI 研发的一部分。完整的 AI 研发还包括提出研究假设、设计实验、实现实验、分析结果、定位失败原因、调整路线,再重新开始。这些环节里,任何单独一项被自动化,都只能算 AI 辅助研究;真正敏感的节点,是它们开始被串成一条长链。一旦这些步骤能够被一个 AI 系统长时间串起来,它承担的角色就开始越来越接近真正的研究员。
好巧不巧的是,AI 研发恰好又特别适合这种自动化。
AI 研发大量发生在数字环境里,代码能直接执行,实验结果可以快速返回,模型能力还能通过 benchmark、loss、reward 等指标立即验证。相比化学、生物或者制造业,它少了很多必须等待现实世界反馈的环节。
也正因为如此,Good 当年那个听起来非常遥远的循环,今天才第一次开始有了比较具体的工程路径:AI 参与研发下一代 AI,下一代 AI 能力更强,更强的 AI 再回来参与下一轮研发,循环继续下去,研发能力本身开始参与推动研发能力增长。论文把这类路径称为 software-driven intelligence explosion,也就是由软件改进驱动的智能爆炸。
这和造出更快芯片还有点区别。芯片设计、流片、建厂都有长周期,而算法、训练方法、Agent 工作流、合成数据策略一旦验证有效,理论上可以很快重新部署进下一轮研发。所以作者真正关心的是 AI 进步的反馈周期会不会越来越短:AI 只要能够越来越完整地接管下一代模型研发,自我改进的反馈回路就已经出现了。
几千个研究员变成数百万个,一年的 AI 进步可能只剩 5 周??
接下来,就是整篇论文最「抓马」的部分了。
AI 参与研发本身还不足以构成智能爆炸,真正重要的是,它和普通人类研究员存在一个非常大的区别——AI 研究员可以复制。
假设一家实验室今天有 1000 名顶尖研究员,未来它开发出了一个能力达到顶级人类 AI 研究员水平的 Agent。从这一刻开始,扩张研发团队这件事,游戏规则就变了。
培养一名顶尖人类研究员,可能要读五年博士、再积累多年科研经验;AI 研究员直接再开一个实例就行。它还能 24 小时工作,成千上万个实例同时跑任务;底层模型一更新,整支 AI 研发团队也能同步升级。这就直接绕开了人类科研最硬的一层增长限制——人才培养速度。
人类想把 1000 名顶尖研究员变成 100 万人,几乎是代际工程。AI 系统理论上可以靠增加推理算力和实例数量,在短得多的时间里扩张。论文为此专门引入了一个概念:effective R&D workforce,也就是有效研发劳动力。
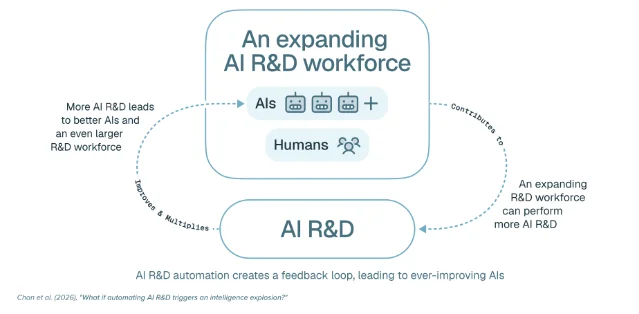
作者估算,如果 AI 达到顶级 AI 研究员水平,推理成本又与今天的前沿模型处于类似量级,那么一家领先 AI 公司的现有算力,理论上可能支撑至少数百万名顶级人类研究员等价的 AI 研发劳动力;而今天一家前沿 AI 实验室的研究团队,还只是几千人量级,两者之间差了几个数量级。
论文还算了另一笔账:如果 AI 研发全部自动化,只维持当前的软件效率改进趋势,自动化研发劳动力在数月到数年时间里就可能扩大 100 倍——同样的相对扩张,美国的研究人员队伍用了七十年才走完。2
而且这几百万个研究员还有一个人类组织很难复制的特点:能力可以同步更新。底层模型一旦升级,不需要重新培训几百万人,所有实例理论上都可以一起获得新能力。
这里最容易产生一个误解:100 万 AI 研究员,并不会自动带来 1000 倍研发速度。科研天然存在边际收益递减——10 个人研究一个问题,可能比 1 个人快很多;100 万人同时研究一个问题,很可能大量重复工作、争抢实验资源,还会发现好点子越来越难找。所以论文真正试图计算的是另一件事:新增 AI 研发劳动力带来的收益,究竟能不能跑赢科研本身越来越难这件事?
于是整篇论文非常关键的一个变量来了:returns to research effort,记作 r。简单理解,就是研究投入增加以后,技术进步速度能跟着涨多少。当 r 比较低,大量增加研究投入以后,收益很快递减;当这个数足够高,新增研发能力带来的进步又会进一步造出更强的 AI 研究员,这时反馈环才开始加速。
论文引用了一项对三个 AI 研究子领域历史数据的分析,r 的中心估计落在 1.2—1.9 之间。5
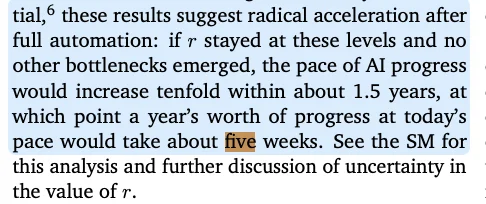
假设 AI 研发实现全面自动化,假设类似的研究回报能够维持,再假设短期内没有新的算力、数据等瓶颈突然卡死整个系统,模型得到的结果是:AI 技术进步速度可能在大约 1.5 年内提高 10 倍。换算一下,今天需要一年才能发生的 AI 进步,到了那个阶段,只需要大约 5 周。
于是智能爆炸真正反常识的地方出来了。
过去科技增长的一项天然限制,是培养研究人员很慢,培养一个真正优秀的研究员需要十几年教育和训练。AI 研究员一旦达到足够能力,培养这一步可能变成复制模型、分配算力。于是科研第一次可能遇到一种极其奇怪的供给冲击:研究能力本身,也变成了软件。
一旦研究能力变成软件,研究员数量和研究员能力这两个变量,就有可能同时被技术进步推动。这才是论文所说的智能爆炸真正危险的地方:加速来源本身也在被加速。
RSI 已经冒头,智能爆炸还没闭环
看到这里,很容易得出一个特别刺激的结论:完蛋,智能爆炸已经开了。
但辛顿这篇论文全篇给出的基调是,当前证据还远远不足以证明智能爆炸已经发生。目前 AI 研发自动化带来的生产率提升,依然没有明确越过引发爆炸式加速所需要的门槛。
作者提醒,AI 研发自动化和智能爆炸之间,中间还隔着很长一串条件:AI 首先得足够可靠,能够长时间自主工作;其次要真的提高研发产出;再然后,这些新研发成果还得反过来明显增强 AI 本身的研发能力。
即使未来出现几百万个 AI 研究员,它们面前至少还有几道很现实的墙。
第一道是算力。AI 研究员可以复制,GPU 不能凭空复制。如果大量关键实验都需要运行大型模型,再多 Agent 最后也可能排队等卡;训练一次真正的前沿模型本身就可能需要数月,100 万个 AI 研究员坐在电脑前,也没法把一个物理上需要三个月的训练任务压成五分钟。论文对这道墙的判断是证据好坏参半,但明确指出:软件迭代可以极快,底层计算基础设施的扩张依然受物理世界限制。
第二道是数据。互联网天然数据并不会随着 AI 研究员数量同步增长。按论文引用的趋势,现有高质量自然数据很可能在 2028 年之后连维持当前的进步速度都撑不住。未来能不能靠合成数据、可验证任务、环境交互等方式继续提供高质量训练信号,现在依然没有定论。
第三道是实验时间。有些事情本身就很难无限并行:训练模型需要时间,芯片制造需要时间,新数据中心建设也需要时间。哪怕有 100 万个 Agent 同时提出实验方案,最终还是要共享有限的 GPU、实验集群和训练窗口。
还有一类是难以自动化的任务。论文认为,只要自动化推进得足够快,这类任务不一定挡得住智能爆炸,但目前缺少经验数据说明哪些任务会长期难以自动化、又能把进度拉住多少。
最后一道更根本的问题,是科研会越来越难。容易找到的算法改进可能首先被找光,往后每提高一点能力,都需要越来越大的投入。论文把这一点叫作 diminishing returns:研究越往前走,下一次突破可能就越贵,如果科研难度上涨得比 AI 研发能力还快,智能爆炸自然也起不来。
总的来说,论文没有足够证据证明智能爆炸一定发生,但现有证据已经足够让它从科幻问题,变成一个需要提前准备的现实问题。作者给决策者的三项优先事项是:拿到更多关于 AI 研发自动化的可见度,找到引导和约束智能爆炸的办法,以及让社会为它的影响做好准备。2 这篇论文另有中译版《当 AI 接管 AI 研发:智能爆炸及其应对措施》。6
而递归自我改进这件事,确实已经离「科幻设定」越来越远了。
甚至未来回头看,2026 年真正值得记住的节点,可能还真不是某个模型又多拿了几分。恐怕是人类第一次开始认真意识到,AI 最猛的一次 Scaling,可能发生在「研究 AI」这件事本身。
References
- 1Hinton 在 X 上介绍这篇论文
x.com
- 2
- 3Anthropic:When AI builds itself
anthropic.com
- 4
- 5Ho & Whitfill:The software intelligence explosion debate needs experiments
epochai.substack.com
- 6论文中译版:当 AI 接管 AI 研发
casp.ac
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.