8 个量子电路基元里 7 个门数与量子位同时下降,乘积最高降 39 倍;点加那项是 Claude 在 53 小时里跑出的新架构
Anthropic 让 Claude 在八个量子电路基元上做设计:七个任务里门数与量子位同时下降,TQ 乘积降低 4.1 到 39 倍;点加那项是一次 53 小时运行产出的新可逆模逆架构。本文拆开两处增益的来源,并说明它们在哪个指标上仍未压过公开构造。

10 月 16 日,Anthropic 的研究页挂出一篇 Science 栏目的文章《Designing more efficient quantum circuits with Claude》;配套论文在 arXiv 上(v1 提交于 10 月 15 日),46 页、10 张图、6 张表,作者是 Andi Gu、Alek H. Kemeny、Susanne F. Yelin 与 Mikhail D. Lukin,Gu 的工作由 Anthropic 的 STEM Fellows Program 支持。12
结论是这样的:八个量子电路基元(更大的量子算法反复调用的子程序)的设计任务里,七个任务上 Claude 给出的线路同时用更少的 Toffoli 门和更少的量子位,两者乘积降低 4.1 到 39 倍。第八个是椭圆曲线点加,产出的是一条新的可逆模逆架构,论文称这是素数域上的首个可逆 divstep 实现,来自一次 53 小时的运行。1
这八个任务之所以能跑起来,前提是它们都能被一个便宜的经典程序判对错、打分数。这条前提划定了后面所有数字的适用范围,也划定了这套方法在哪里失灵。
可逆电路贵在哪
经典程序遇到 if 分支,只执行一边。量子线路要同时处理叠加在一起的许多输入,两边都得写进线路里,每条分支都计入代价。2
经典程序写完草稿可以覆盖掉。量子线路不许丢信息,每一步都可逆,中间值只能反着再算一遍清掉,论文把这一步叫反计算(uncompute)。2
代价很具体:一个临时的 AND,正向用一个 Toffoli 算出来,反向再清一次就要第二个。改用基于测量的反计算(MBU),第二次换成一次 X 基底测量加一个 CZ 修正,同一个临时值的总成本才回到一个 Toffoli。2
两条约束合起来,把设计变成一个空间与时间的取舍。早清中间值省量子位,之后要用就得重算,多花门;留着中间值省门,量子位就一直占着。
于是衡量用两个数:Toffoli 门数 T,与同时存活的峰值量子位数 Q。Toffoli 不是 Clifford 门,要靠昂贵的 magic state 供给,所以它的数量大致反映运行时间;量子位数决定处理器要有多大。论文把两者相乘得到 TQ,拿它当一个排序用的单目标。2
闭环:模型写 Python,判卷的是程序
每次搜索都从一份手写的任务说明和一段空程序开始。说明只讲这条线路必须实现什么,不给实现思路。2
论文用的模型是 Claude Mythos 5。它用 Python 调一组电路构造接口(分配、释放、ccx、测量)写候选。线路被写成程序,一个函数、一个命名寄存器都保留着,改一处就能重组整条线路,「换一种算法」这样的大改因此写得出来。2
评分器独立于模型。它精确模拟每一条计算基轨迹:给定输入,只跟踪一个比特串和一个相位号,不需要 2ⁿ 个振幅。3
接受条件有四条:输出与参考函数一致、全局符号一致、所有临时量子位归零、每个门的操作数互不相同。测试输入按提交线路的哈希抽样,改了线路就重新抽题;允许失败的预算写进任务里:多数任务是 10⁵ 次测试,数值函数那三项各 9×10³ 次,Fe₂S₂ 是 2×10⁷ 次。2
每次迭代开一个新会话,只给父程序、评分反馈与有限的档案上下文,模型可以跑草稿、查经典参考函数、把子任务派给子代理。2
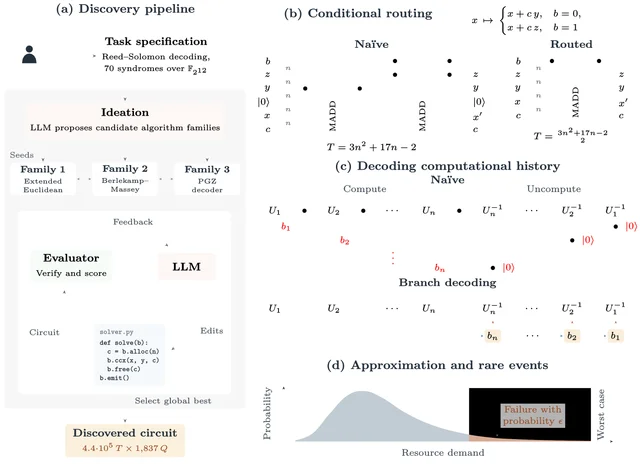
八个任务里反复出现的三个手法,都对着上面两条约束去。条件路由把「按分支选不同运算」换成「把数据路由到同一个运算」,两个受控乘法加法变成一次共享的乘法加法加两次受控交换。2
第二个手法是分支解码:反计算要求知道当时走了哪条路,与其把选择存进历史栈,不如从更新后的寄存器里把它解出来。第三个是拿失败预算剪掉只为罕见输入准备的栈容量与停机窗口。
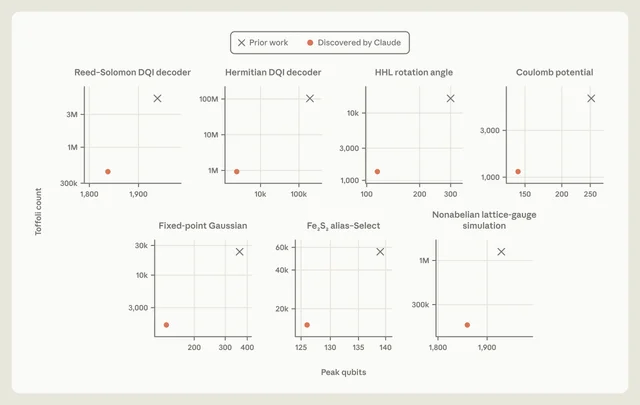
八个任务,七行的门数与量子位一起降
| 任务 | 基线 (T, Q) | Claude 的设计 (T, Q) | TQ 增益 |
|---|---|---|---|
| Reed–Solomon DQI 解码器 | 5.1×10⁶,1,938 | 4.4×10⁵,1,837 | 12× 2 |
| Hermitian DQI 解码器 | 1.0×10⁸,1.9×10⁵(朴素可逆实现) | 9.3×10⁵,2,395 | 无可比基线 2 |
| HHL 旋转角 | 1.6×10⁴,300 | 1,348,115 | 32× 2 |
| 库仑势 | 6,355,252 | 1,140,142 | 9.9× 2 |
| 定点高斯函数 | 2.4×10⁴,362 | 1,583,139 | 39× 2 |
| Fe₂S₂ 的 alias–Select | 5.5×10⁴,139 | 1.5×10⁴,126 | 4.1× 2 |
| 非阿贝尔格点规范场 | 1.3×10⁶,1,927 | 1.7×10⁵,1,859 | 7.7× 2 |
| 素数域模逆(完整点加基准) | — | 4.0×10⁶,935 | 另见表 2 |
八行分别是什么,各说一句。DQI 解码器服务于一类优化算法;HHL 旋转角是线性方程组算法里的受控旋转;库仑势是实空间哈密顿量模拟里的相互相位;高斯函数是数值函数库里的常客;Fe₂S₂ 的 alias–Select 是量子化学的 QROM 制备;格点规范场是晶格上的磁能演化。2
两处要留意。Hermitian 那一行的基线是朴素可逆实现,论文自己标了脚注:此前没有可逆编译,没有可比的对手,所以增益一栏是空的。2
另一处是增益的分布。四倍到四十倍这个区间里,最高的 39 倍属于高斯函数,32 倍属于 HHL 旋转角。这两项的基线都要在每一步里带着大位宽的定点中间值,改动省下来的正是这些寄存器。2
DQI 解码器:换掉算法,再换掉要存的东西
DQI(Decoded Quantum Interferometry,解码量子干涉)把一类优化问题变成经典纠错码的解码问题,靠干涉让好解更容易被读出;它的一个实例是 OPI,有限域上的曲线拟合。6
这条算法里最贵的一步是 Reed–Solomon 解码:从 70 个 12 比特的伴随式(syndrome)里,还原出至多 35 个错误的位置与取值。DQI 要在叠加态上跑这一步,解码器就成了主要开销。2
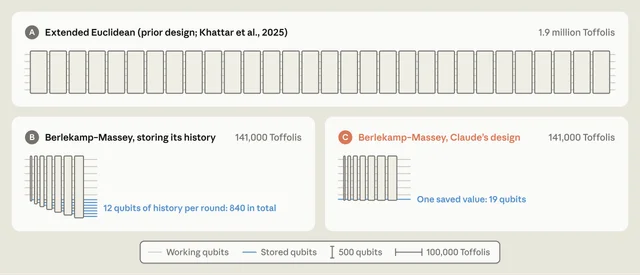
基线用扩展欧几里得算法解关键方程。问题是它的控制流依赖输入:不同输入需要不同的移位、交换与迭代次数,而量子线路只能跑一条固定的门序列。为了让所有输入共用一条路径,基线把欧几里得过程摊成 222 个同步周期,每一步运算都带上控制位,只在需要时生效。7
Claude 先换算法。Berlekamp–Massey 递推每轮的步骤完全一样,轮数也固定,正好合量子线路的胃口;算术上也更便宜。2
可逆化又带来第二个问题。BM 每轮用一个模板多项式 τ 与它的偏差量 δ 做修正,在「替换」那一支里,这两个量会被覆盖。朴素的可逆实现只能把被覆盖的值存起来,一轮存 12 个比特,70 轮下来是 840 个量子位。
Claude 把这一支重写成同一个算术路径上的两种用法:定位多项式只差一个非零倍数时根不变,所以两个分支共用一次计算,模板不必存。2
δ 也能解出来:τ 每轮左移一位,进入该轮时常数项为零,于是被覆盖的旧值满足 δ_old = σ₀τ₀⁻¹δ_new,由更新后定位多项式的常数项直接算出。真正需要入栈的只剩「保留」那一支的 Δ。
最坏情况要 35 个栈条目、665 个量子位。Claude 写了个高速模拟器,跑了 4.03 亿次采样解码,量出第二次入栈的概率是 10⁻⁴ 量级,于是只留一个条目,19 个量子位,接受这一档稀有输入失败。12
第二处改动在整条解码器的层面:解码出来的错误字有 49,140 个比特,DQI 只从里面取一个相位比特。线路因此直接由定位多项式与伴随式算这个比特,并把一次倒数多项式提到扫描之前算好,扫描里不再做域除法。2
两处叠加,整条解码器从 5.1×10⁶ 门、1,938 个量子位降到 4.4×10⁵ 门、1,837 个量子位,TQ 降到 1/12。2
点加:53 小时换来一条新的模逆路径
椭圆曲线点加是离散对数量子算法的核心步骤,反复正反执行,占了这类算法的大部分门数与量子位。点加里最贵的是模逆,基线用扩展欧几里得。2
divsteps 是 Bernstein 与 Yang 的常时间算法:不做除法,用条件加减和折半把一对整数化简,
libsecp256k1 里用的就是它。它此前没有可用的量子版本,卡在可逆性上。8每一步有三种走法,反向执行必须知道当时选了哪一种。朴素做法把选择记进历史栈,256 比特的输入要跑五百多步,量子位需求直接爆掉。2
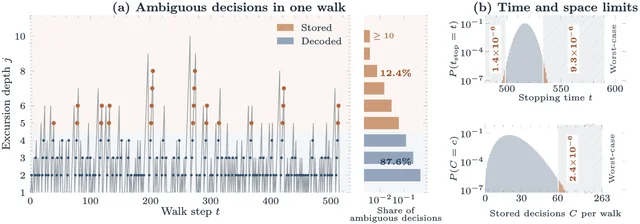
Claude 的做法是从更新后的状态里把选择解出来。交换那一步在系数 f_v 上留下显眼痕迹:f_v′ = 2g_v 只有一位尾零,所以交换位永远可判;非交换里三分之二也能用几条廉价测试定下来。2
剩下的是「交换之后连着几步非交换」这样一段行程,论文叫 excursion,深度 j 就是 f_v′ 的尾部零位个数。把更新式两边乘上 q⁻¹(mod 2ʲ)之后,第 j−1 位就是当时的分支位——历史被状态本身记住了。2
这个规则需要一条全局不变式才成立,模型把不变式找出来并证明了它;论文附录 A 给出证明,代码仓里还有一份 Lean 4 的形式化。9
深度越大,解码器越贵。于是在 j = 5 处截断:浅的用解码器,深的写进栈。这样只有 12.4% 的歧义决策需要存,栈从最坏的 263 个量子位收到 60 个。2
失败预算用在两处。栈溢出概率 2.4×10⁻⁶;另一处是停机窗口,理论上 590 步足够,实测多数在 505 到 530 步之间终止,线路只调度 533 步、从第 499 步开始测终止,落在窗口外的输入按失败处理,概率 1.4×10⁻⁶。两者并起来,一次点加的总失败上界是 2×10⁻⁴,十万次测试里失败四次。2
调整截断深度与工作区大小,得到的是一族线路:从 3.3×10⁶ 门 / 1,191 个量子位,到 3.6×10⁶ / 1,031,再到 7.9×10⁶ / 893。报出来的那个点是 4.0×10⁶ 门、935 个量子位。2
把这一项放回同行的工作里看,结论需要更小心。同一套仿射坐标接口下,四种构造的资源是:2
- Schrottenloher 2026,二元 GCD 加记录历史:190 万门、1,446 个量子位,TQ 2.7×10⁹。10
- Claude 的 divstep 线路:400 万门、935 个量子位,TQ 3.7×10⁹。2
- Luo 等 2026,打包欧几里得游走:7,000 万门、838 个量子位,TQ 5.8×10¹⁰。11
- Claude 特化欧几里得:2,100 万门、843 个量子位,TQ 1.7×10¹⁰。2
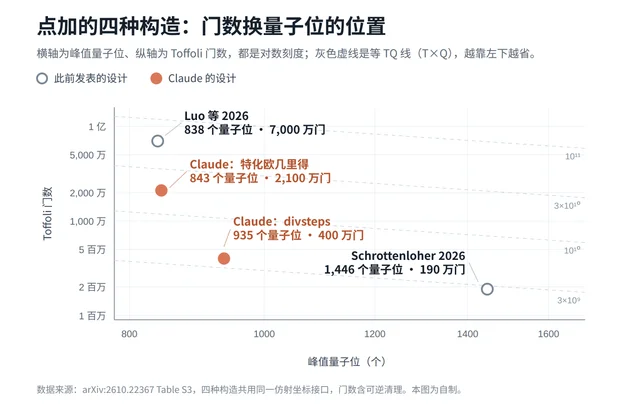
按论文自己的说法,这一项的价值在于它首次给出了素数域上的可逆 divstep 模逆:此前可逆 divsteps 只在二元域和多项式环上做出来过。2
53 小时这个数字,跟八年的积累比什么
官方博客拿 FeMoco 做对照。2017 年估计,算这个固氮酶核心簇的基态能量要 50 万亿个 Toffoli 门;12 经过一串算法改进,2025 年的估计降到约 3.4 亿,少 15 万倍。13
这 15 万倍是许多研究组八年里一步步做出来的。Claude 的点加方案,是一次 53 小时、人工只给了一份任务说明和偶尔几句「想得更宽一点」的运行。1
两个数字量的东西不一样。FeMoco 那些改进跨越了不同的算法族与表示,点加这一项只是一个基元。2
可比的是迭代的吞吐:一条设计从写出来到拿到「对错 + 两个整数」,中间不需要排队等机器时间。
这个吞吐对下游有具体含义。Google Quantum AI 估算过一个 OPI 实例:在 Frontier 上跑约三个月,在未来量子计算机上跑 DQI 约一小时,而这一小时里大部分花在 Reed–Solomon 解码上。714 解码器省 12 倍,省的就是这一小时里的主体部分。
模型在这件事上的短板
博客写了一段模型行为,对想复现的人有用。早期实验里 Claude 偏保守:反复质疑已经成立的改进,把结果检查两遍三遍,倾向沿用已知方案。1
这种谨慎也带来过好处,divsteps 那条线路的 Lean 证明就是它自己决定去写的。团队用两个办法把它推向更冒险的方向:强制提出几个定性不同的方案并行推进,以及偶尔提示扩大搜索。1
方法本身的边界,论文写在讨论一节。TQ 等权只是一种选择:量子位紧张时该用「量子位的 κ 次方乘以门数」(κ 大于 1),有便宜冷存储时该只数参与运算的量子位(active volume),magic state 工厂足够多时限制项换成 Toffoli 深度。2
任务接口同样设了边界。变换固定在计算基上定义,改变编码本身的优化就被挡在外面,例如用陪集表示让模加更便宜的那类做法。2
失败预算也改变了「正确」的含义:线路在给定输入分布上正确,允许在极稀有输入上出错。这个分布由任务规定,换个应用就要重新定。2
缺的是什么
所有数字都是逻辑资源的估计,没有一条线路在硬件上跑过。门数与逻辑量子位之外,纠错码、magic state 蒸馏、路由与测量都不在成本里。2
模型只用了 Claude Mythos 5 一个,论文没有给跨模型的对照。2
搜索过程没有被公开:仓库里有每条线路、任务定义、评分器与两份 Lean 证明,没有搜索时的会话与提示记录,53 小时那一次无法从外部重放。9
没有第三方复现,也没有重复运行的方差。论文报的是每个任务最终选中的那条线路,八个任务各一条。2
点加这一项在 TQ 上没有压过最省门的那条公开构造,它的贡献是新增了一个可逆模逆架构,并把前沿补密。10
下一个能核的节点
仓库是 Apache-2.0,装了 uv 之后
uv run python tools/eval.py <task> 就能自己跑一条线路、验一遍、打印门数与量子位。9 每条线路都有认证过的操作流,可以不重跑就复核。仓库里两份 Lean 4 证明覆盖了这条线的两个关键断言:divsteps 的步数上界与分支恢复规则,以及 DQI 的解码错误界。9 想验证「状态里真的能解出分支位」,这是最短路径。
论文指出的下一步是联合设计:把算法、逻辑线路、纠错码、magic state 供给与物理架构放在同一个评分器下一起改,让每层的取舍在同一个成本里互相牵制。2 这套东西能不能走通,取决于能不能把每一层的对错与代价都写成可判的程序。
在这些都发生之前,能确认的只有一件事:当一个问题同时具备可改的表达、可判的对错、可算的代价,模型加评分器的闭环已经能在八类量子电路基元上把资源压下一个档位,最快的单项来自一次 53 小时的运行。1
References
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8Fast constant-time GCD computation and modular inversion
tches.iacr.org
- 9
- 10
- 11
- 12
- 13
- 14Frontier
olcf.ornl.gov
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.