联邦学习搬进 TEE:Google 称隐私保证首次可外部核验,Gboard 隐私预算缩到 1/3
解读 Google Research 2026 年 10 月 2 日发布的联邦学习新系统:训练被搬进服务端的可信执行环境,Google 称中心化差分隐私的保证第一次可以被外部核验;Gboard 英文模型的隐私预算缩到约三分之一,训练从两个月压到三周。

10 月 2 日,Google Research 发了一篇博客《Toward provably private learning from federated data》,宣布把联邦学习搬进可信执行环境(TEE),并称这是第一次让中心化差分隐私的保证可以被外部核验1。配套论文当天也挂在 arXiv 上,编号 2609.31494,当前版本是 9 月 30 日的 v4,署名十二人,博客的第一作者 Katharine Daly 也是其中之一2。
值得记住的落点数字有两个。用这套系统训出的英文键盘模型,隐私预算 zCDP 是 0.215,生产上在用的英文模型按同一机制折算后是 0.641,约为前者的三倍;训练时间从两个月压到三周2。
下面拆两件事:所谓「可外部核验」究竟核到什么程度,以及为什么改一次架构就能同时改善隐私与效率。
旧系统的两个缺口
Google 做联邦学习已经很多年。2017 年它提出这套方法,此后用它训过 Gboard 的下一词预测和 Smart Compose、Google Messages 的回复建议、Android 的 Smart Text Selection13。
这套技术的四条隐私原则是数据最小化、匿名化、透明与可控、可验证与可审计4,这篇论文就是用它们逐条对比新旧两个系统的。
这套设计留下了两个缺口。第一个是核验:加噪这一段跑在服务端,设备看不到、外部审计者也看不到;你只能相信 Google 会把随机噪声正确地加到梯度总和里。第二个是效率:设备端要自己算梯度,这决定了模型能有多大;训练进度又被设备可用性牵着走——设备得在线、在充电、连着 WiFi,还要和其他训练任务抢同一批设备资源12。
数据先上传,训练在服务端
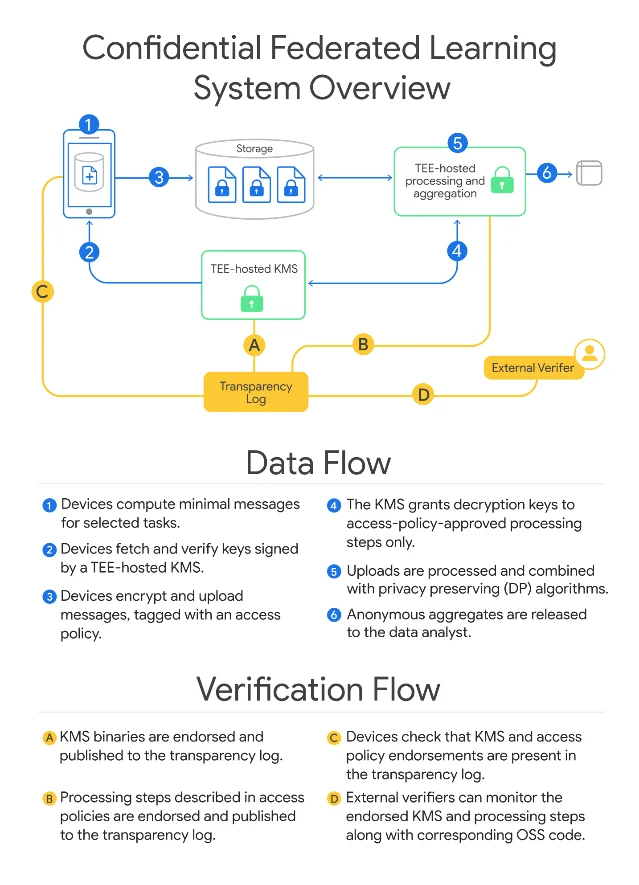
新系统把一次训练拆成两段,中间隔着密钥。
上传阶段,设备用密钥管理服务(KMS)的公钥把训练数据在本地加密,再上传到中间存储。上传的同时,设备把这份数据绑定到一份访问策略上,策略写明将来允许哪些计算处理它1。KMS 本身是跑在一组 TEE 上的集群,用 RAFT 共识协议保证容错,并维护一个防回滚的键值库2。访问策略和 KMS 的二进制都会写进公开透明日志 Rekor,那是 Sigstore 项目维护的公开日志,写入后难以篡改7。
处理阶段,一个「根」TEE 里跑一段 Python 训练循环。需要并行的部分由根节点下发给一组工作 TEE,用 Federated Language 表达——那是 Google 2024 年开源的一套编排语言,源自早期的 TensorFlow Federated28。根节点和工作节点之间用 Noise 协议在不可信的 gRPC 通道上建加密连接,根节点在握手时校验工作节点的证明(attestation)2。
KMS 只把解密密钥交给符合访问策略的那份 TEE 二进制。数据另有存活时间限制(TTL),到期后连合规程序也解不开。训练循环每轮结束会往 KMS 存一份加密的恢复状态,中途故障可以从最近一次发布结果之后的轮次接着跑;但它不允许从更早的轮次恢复,因为那等于把同一轮的结果重新放出来一遍,对非确定性程序会造成额外泄露2。
隐私算法这一侧没有换新东西,训练用的还是 Google 此前的 MF-DP-FTRL9。
「可核验」核到什么程度
外部能核对的事情只有一件:哪段代码有权碰你的数据。访问策略里直接嵌着将来要跑的那段 Python 程序,以及根节点和工作节点二进制的哈希;这些二进制可以从开源代码可复现地构建出来210。所以设备在上传之前就知道,自己的数据将来只会被这一份程序处理。
核不到的事情是,噪声到底有没有被加进去。差分隐私的正确性目前仍然建立在「代码可以被检视」之上,官方把「给差分隐私算法和系统组件的实现配上完整正确性证明」写成了期待中的将来1。
一个口径细节能说明这份声明落在哪个位置:论文 v1 的正文标题写的是 verifiably(可验证),到 v4 改成了 provably(可证明),博客用的是后者2。两者之间隔着的正是这层 TEE 假设。
还有两处保留要跟着读。TEE 本身有已知弱点,论文引用的是 2025 年那篇针对机密虚拟机做侧信道分析的工作 SNPeek11。另外,为了不暴露专有模型结构和数据预处理逻辑,程序支持在运行时把序列化信息「侧载」进去;只要隐私相关逻辑硬编码在程序里,侧载不会削弱可核验的隐私保证。换句话说,你核验的是隐私逻辑,未必是全部逻辑12。
隐私预算为什么会变小
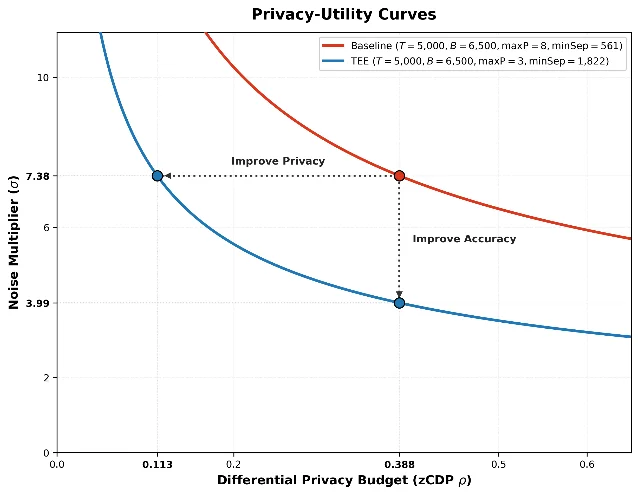
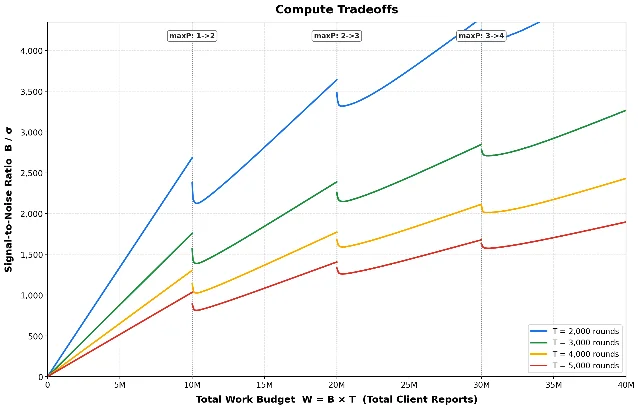
旧系统里,哪台设备在哪一轮参与,是设备可用性算出来的结果。单个设备最多参与多少轮(maxP)和两次参与之间的最小间隔(minSep)只能事后从完成时间戳反推,噪声乘子 σ 一旦定下就不好动。
新系统先把上传收集齐,再在服务端开跑,参与调度于是变成运行时可以优化的变量:可以让每台设备参与同样多次,并把 minSep 拉到最大,再由目标 zCDP 倒推需要的 σ2。
英文模型在 5000 轮、队列 6500 台这个点上,两个系统的差别是这样的:基线固定 σ=7.38,实际跑了 8616 轮、85 天,事后算得 maxP=8、minSep=561;TEE 版把目标定在 zCDP=0.232,运行时定出 σ=5.16,maxP=3、minSep=1822。同样要拿到 0.232 这个 zCDP,基线在同样的轮数下需要 σ=9.542。
所以曲线的内移不来自更强的差分隐私算法,而来自「参与调度不再由设备可用性决定」。官方还补了一句:图里画出的改善其实偏保守,因为随 maxP 和 minSep 一起变好的还有 BLT 矩阵,而噪声到效用的映射依赖它2。
覆盖、曲线与线上读数
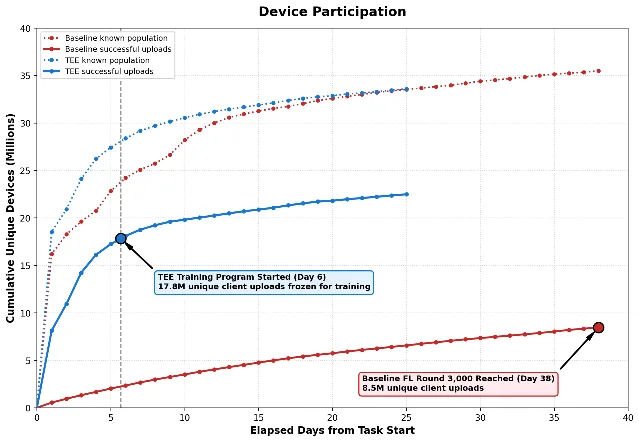
设备覆盖这一块用一个日文模型最能看清。基线在 38 天里跑满 3000 轮、队列 6500 台,最终只把 3550 万台可用设备里的 850 万台纳入了训练,占 23.9%;没参与的那批里,2050 万台从头到尾没收到过任务,650 万台收到过但被中断、一次也没跑完。TEE 版大约 6 天收到 1780 万份上传,随后开跑,这 1780 万份全部进了训练2。
收集多久也有代价。密钥的 TTL 是有限的:如果程序在第 y 天开跑、用的是第 x 天到第 y 天收集的数据、密钥 TTL 设成 30 天,那么这套程序只有 30−(y−x) 天能产出结果。等更多设备上传,和给训练留出足够时间,是一组必须自己权衡的量2。
线上 A/B 是在 Gboard 的真实用户里做的,英文模型,每组 350 万台设备。隐私这边收益明确:最好的一臂 zCDP 是 0.215,生产模型按同一 MF-DP-FTRL 机制折算后是 0.641。可用性这边持平,每分钟输入字数(WPM)和用户改动建议的比例(WMR)都没有明显变化。训练时间上,TEE 版三周训完,前一个生产模型花了两个月。这套系统已经在 Gboard 上线,支撑英文和日文的下一词预测12。
现在还不能做什么
规模是最硬的一条限制。到目前为止,这套系统训过的模型最大 10M 参数;工作 TEE 还没有用上 GPU,要训更大的模型,得先让 GPU 进 TEE,并解决根节点与工作节点之间的通信瓶颈2。
隐私这边还有一份可以拿但没拿的收益。管道操作者看不到上传内容,但能看到哪些上传被用在了哪一轮。如果能把这层信息也藏起来,就可以吃到采样带来的隐私放大,也就是在 σ 不变的情况下压低实际消耗的预算。论文给了两条路:可验证地打乱数据,或者让服务端程序按需过采样2。
剩下的几条:每个模型只测了一种配置,轮数和队列规模怎么选还需要更多实验;密钥 TTL 是尽力而为地执行的;这套材料是 arXiv 预印本,还没有经过同行评议2。
现在能下的判断
这篇的增量可以收成一句:把「数据收集」和「训练」解耦成两段,一次同时买到了两样东西——可核验的代码边界,和可优化的参与调度。前一样让隐私声明第一次可以被外部检查到「哪段代码有权碰数据」,后一样让隐私预算从设备可用性的结果变成设计变量。论文里最值得记住的数字组合是 maxP 从 8 降到 3、minSep 从 561 升到 1822,因为它们解释了曲线为什么内移,也解释了为什么这件事不靠更强的差分隐私算法。
对读者的实际意义在于回答方式变了。如果你原本的问题是「联邦学习能不能对外证明隐私」,这篇文章给的是「能证明到哪一步」:代码这一层可以核,噪声这一层还要等,而 TEE 假设本身有已知弱点。
References
- 1Toward provably private learning from federated data
research.google
- 2
- 3
- 4Federated Learning and Privacy
queue.acm.org
- 5
- 6Distributed Differential Privacy for Federated Learning
research.google
- 7Rekor - Sigstore
docs.sigstore.dev
- 8google-parfait/federated-language
github.com
- 9
- 10
- 11
- 12Discovering new words with confidential federated analytics
research.google
- 13Toward provably private insights into AI use
research.google
- 14
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.