AI 论文早报|8 月 14 日:5 篇论文把模型可靠性拆成预算、证据与恢复策略
精选 2026 年 8 月 12 日 UTC 提交的 5 篇 AI 新论文,比较推理预算、断言级验证、工具失败恢复、记忆压缩和多场景视觉规划如何暴露可靠性的具体条件。

截至 2026 年 8 月 14 日 07:00(北京时间),本期筛选的是 arXiv 详情页确认在 8 月 12 日 UTC 提交的 5 篇 AI 新论文。它们来自模型评测、推理可靠性、工具代理、长上下文记忆和具身视觉规划,看似问题不同,实际都在追问同一件事:一个总分或一次成功,究竟能不能代表系统在具体条件下真的可靠?12345
今日看点
| 论文 | 它把什么条件显式化 | 原文给出的关键数字 |
|---|---|---|
| Budget-Dependent Rankings | 推理 token 预算会不会改变模型排名 | 4 个模型、3 个推理基准、7 档预算,共 56,476 次推理;模型排名在所有基准上发生翻转。1 |
| Claim-Level Reliability Assessment | 可靠性判断应不应该从整条思路移到关键断言 | GPT-OSS-20B 在 CMIMC25 上比 pass@1 高 27.15 个百分点;相较 self-consistency,准确率从 77.50% 到 82.19%,token 少 37.0%。2 |
| Retry, Switch, or Abstain | 工具失败后,重试、切换和停止不是同一种动作 | 在留出的 Retail 任务上,BTM 不重训就能提升最多 16.8 个百分点;RL 与 BTM 结合后,注入失败环境下达到 40.8%—45.5%。6 |
| The Sleeping Agent | 摘要式记忆究竟丢掉了哪一类信息 | 10 段 LoCoMo 对话、1,935 道匹配问题;一条提示词改动让时间表达保留率从 3.05% 升到 62.39%,时间类问题的 judge accuracy 提升 0.314。7 |
| HUGIN | 多个分散视角是否被 VLM 合并成完整的行动计划 | SortingBench 覆盖 4 种物流布局、5 个开放 VLM;Qwen3-VL-8B 准确率从 63.6% 升到 78.8%,部署测试涉及 15,000 多个包裹。5 |
本期的阅读顺序可以按你的问题来选:想知道排行榜是否稳定,先看第一篇;想压低推理成本又不想只靠多数投票,看第二篇;在做会调用外部工具的代理,看第三篇;在设计长期记忆,看第四篇;在处理多摄像头和机器人规划,看第五篇。五篇都不是「全面更强」的证明,而是把原本混在总分里的条件拆开,让读者看到收益和代价分别落在哪里。
1. 推理预算一变,排行榜就可能换人
基本信息:Rodrigo Guedes de Souza、Alison R. Panisson,机构为巴西圣卡塔琳娜联邦大学(UFSC)。论文为 arXiv cs.AI/cs.CL 预印本,v1 于 2026 年 8 月 12 日提交;论文页未列出会议接收信息。1
问题背景:很多模型比较默认一个前提:只要 benchmark 和提示词不变,模型的相对排名就大致稳定。但推理模型能生成多少 token,本身就是评测条件。给 64 个 token 和给 4,096 个 token,既可能改变一个模型的准确率,也可能改变哪一个模型排在第一名。8
方法要点:作者让 4 个参数规模约 8B—70B 的模型,在 3 个推理基准上接受 64、128、256、512、1,024、2,048 和 4,096 七档最大生成长度的测试,共 56,476 次推理,温度设为 0。分析分成三层:先在题目级别标出随预算增加而变好、变坏或不变的行为;再比较每档预算下的模型排名;最后训练一个以题目文本和预算为输入的 XGBoost 路由器,观察能否把题目交给更合适的模型。8
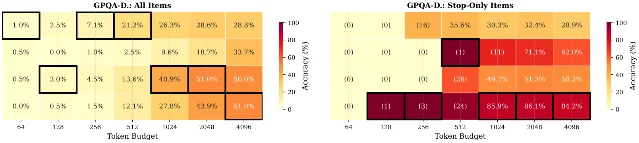
结果亮点:摘要报告,3%—19% 的题目出现非单调行为,即允许更多 token 后准确率反而下降;这种现象在不同模型之间的重合率只有 6%—14%,说明它不是某一类题目固定会触发的普遍「想太多」。模型排名在 3 个基准上都随预算发生翻转,McNemar 检验达到 p < 0.01。逐题 oracle 组合最多比单一最佳模型高 27.8 个百分点;预算感知路由器在跨领域测试中捕获了 oracle 差距的 14.1%。8
预算特征在同领域实验中带来 1.6—5.7 个百分点的提升,但跨领域迁移反而下降 1.2 个百分点。这个反差很重要:模型和预算之间的关系可以被学到,却不一定能直接搬到另一个题型。8
证据边界与阅读价值:证据来自 4 个模型、3 个推理基准和固定温度的离线评测,尚不能把「预算依赖的排名」外推成所有模型或所有真实任务的规律。路由器也只是 proof of concept:它在跨领域还有 85.9% 的 oracle 差距没有捕获,而且预算特征会伤害迁移。对评测或部署工程师来说,这篇论文最实用的提醒是:比较模型时,必须把 token 上限和成本预算一起写进实验条件;否则你比较的可能不是模型能力,而是某个模型在某档推理时间下的偶然优势。
一句话阅读价值:如果模型排行榜没有标明推理预算,它很可能只回答了「谁在这套算力条件下赢」,没有回答「谁在你的算力条件下赢」。
2. 不再让整条思路给关键错误打掩护
基本信息:Sen Xu、Wei Wang、Shixi Liu、Jixin Min、Yingwei Dai、Zhibin Yin、Yirong Chen、Junlin Zhang,论文原文列出的机构为 Sina Weibo Inc. 论文为 arXiv cs.AI/cs.CL 预印本,v1 于 2026 年 8 月 12 日提交;代码已公开。1011
问题背景:测试时扩展通常有两条路:多采样几条完整解法,再用多数投票或 self-consistency 选答案;或者检查整条推理轨迹。但整条轨迹里有大量例行 token,真正决定答案的错误可能只藏在一个关键跳步里。一个高置信度的错误解法,仍可能在表面上和其他错误解法形成共识。10
方法要点:CLR(Claim-Level Reliability Assessment)先采样多条解题轨迹,再把每条轨迹压缩成少量「决策关键断言」。第二阶段不重新完整解题,而是让同一个模型围绕这些断言主动寻找反证。作者利用了一个不对称性:构造正确解法需要整条路径都正确,但推翻错误断言只需要找到一个决定性漏洞。最后,系统用断言级验证结果重新给候选答案打可靠性分数。10
结果亮点:作者在 4 个大语言模型和 4 个推理基准上做 matched-budget 比较,报告 CLR 通常优于 pass@1 和 self-consistency。在 GPT-OSS-20B 的 CMIMC25 实验中,CLR 比 pass@1 高 27.15 个百分点;self-consistency 的准确率从 77.50% 提高到 82.19%,同时 token 用量减少 37.0%。2
这组数字支持的不是「少采样总是更准」,而是另一种预算分配方式:把一部分生成预算换成针对关键断言的负证据搜索。若错误解法之间共享同一个未经检查的前提,多数投票并不能消除它;断言级反证至少提供了一个不同的筛选信号。10
证据边界与阅读价值:论文是训练免费的推理时框架,结果来自 4 个模型和 4 个基准的匹配预算实验;当前证据还不足以证明它在开放域事实问答、长工具链或真实业务审查中同样有效。它还依赖模型先把完整轨迹压缩成正确的关键断言:如果关键信息在抽取阶段就被删掉,后面的反证检查也没有对象可查。对推理系统设计者来说,值得复现实验的不是单一提升数字,而是「全轨迹评分」与「关键命题反证」之间的成本—可靠性曲线。
一句话阅读价值:当多数投票已经被错误共识困住时,先找哪一句最可能是错的,可能比再生成十条完整答案更划算。
3. 工具失败后,代理要学会换路而不是盲目重试
基本信息:Chaoran Chen、Vy Nguyen、Ziji Zhang、Abhinav Gullapalli、Ziyi Wang、Yuxuan Lu、Dakuo Wang、Jing Huang、Zhou Yu、Jin Lai;论文原文将作者团队标为 Amazon。论文为 arXiv cs.AI 预印本,v1 于 2026 年 8 月 12 日提交;论文提出 Bench2Robust,并公开讨论重试、切换和停止三种恢复策略。6
问题背景:许多工具调用 benchmark 默认接口总能返回及时、格式正确和准确的结果。但线上工具会超时、触发限流、凭证失效,也可能返回看似合法却过时或错误的数据。此时「再试一次」并不等于恢复:瞬时错误适合重试,主路径持续失效时要切换备用工具,所有可行路径都失效时则应停止或升级。6
方法要点:Bench2Robust 把原本无失败的工具使用任务改造成可控的随机环境,并显式指定每个场景的可恢复性:S1 中重试可以恢复,S2 中主路径被持续阻断、必须切换,S3 中所有路径都不可用。作者再比较两种干预:Bayesian Tool Memory(BTM)在运行时提供备用路径、验证约束和历史可恢复性信息;课程式强化学习则让策略在受控失败中学习何时重试、何时切换。6
结果亮点:在 7 个模型、4 个模型家族和多个多轮工具任务切片上,70 个模型—任务子集组合中有 69 个在注入失败后性能下降,最大下降 46.7 个百分点。留出的 Retail 任务中,BTM 对 4B 基础模型在无备用路径场景提升 16.8 个百分点;不在推理时使用 BTM 的训练策略也能比基础模型提升 6.3/6.9 个百分点。两者结合后,在失败注入环境达到 40.8%/45.5%,同时保持无失败环境的表现。6
证据边界与阅读价值:这篇论文有一个容易被标题带过的限制:作者虽然把 S3 作为训练场景,但任务评估不会给「不可能完成」的 episode 正向完成奖励,因此留出的行为证据主要支持重试和切换,不足以声称模型已经学会了可靠的 abstain。6
此外,受控错误注入能隔离策略效果,却仍是 benchmark 环境,不等于真实 API 的全部故障分布。对代理工程师来说,这项工作的价值在于把恢复策略从一句模糊的「提升鲁棒性」拆成可验收的行为:在什么错误下继续试,在什么错误下换工具,以及什么时候不该继续消耗调用额度。
一句话阅读价值:真正可靠的工具代理,不是永远坚持当前路径,而是能根据错误是否可恢复来决定重试、换路或停下。
4. 摘要式记忆最容易丢掉的,可能是日期
基本信息:Nicholas E. Kyrkewood,论文页标注为 Independent Researcher。论文为 arXiv cs.AI/cs.CL 预印本,v1 于 2026 年 8 月 12 日提交;代码和结果已公开。412
问题背景:长对话代理无法永久保留全部历史,常见做法是把旧对话压缩成 gist,再在需要时检索。问题不只是压缩后总分下降,而是不同类型的记忆是否丢得一样多:人物、事件、关系和时间点,对后续问题的重要性并不相同。7
方法要点:论文用 Salience-Weighted Consolidation(SWC)作为诊断框架:先按显著性给对话片段打分,分成优先级,再对中间优先级内容做结构化 gist 抽象。作者在 LoCoMo 的 10 段对话上比较 4 种条件,共有 1,935 道匹配的文本问题;主聚合结果使用 1,501 道题,排除了第 5 类对抗问题,温度设为 0。4
结果亮点:gist 压缩在多跳推理和单跳事实问题上明显优于直接截断,但时间问题在压缩条件下仍明显落后于完整上下文。作者进一步检查摘要内容,发现提示词保留了关系和事件结构,却经常丢掉日期与时间。7
一个非常局部的修补就改变了结果:在 gist 提示词中明确保护时间表达后,时间表达保留率从 3.05% 升到 62.39%,约提高 20 倍;命名实体和事件保留率只分别变化到原来的 1.02 倍和 1.11 倍。时间类问题的 judge accuracy 在匹配集上恢复了 0.314,区间为 [0.254, 0.375],而且 10 段对话的方向都为正。7
证据边界与阅读价值:这是一项在 LoCoMo 上对摘要式压缩机制的诊断实验,不是对所有记忆架构的统一排名。完整上下文的比较也只在两种条件都能评估的对话上进行。它真正提供的是一个可操作的检查项:设计记忆摘要时,不要只问「有没有保留事件」,还要单独测日期、时间顺序和相对时间表达是否被保留。
一句话阅读价值:如果代理需要回答「先发生什么」「那次会议是哪天」,通用摘要里的时间信息不能靠运气保留下来,必须被明确写进压缩目标。
5. 多摄像头物流规划,难点不只是看清每个画面
基本信息:Xikai Sun、Cangtian Zhou、Kebin Liu、Ke Ma、Xu Wang、Zaishu Chen、Haotian Wang、Li Liu、Yunhao Liu,共 9 位作者。论文为 arXiv cs.AI 预印本,v1 于 2026 年 8 月 12 日提交;原文注明稿件正在评审。13
问题背景:物流分拣系统同时面对机械臂、格口、目的地笼车和分散摄像头。全景相机看得广,却可能看不清包裹细节;局部相机看得细,却不知道其他区域的状态。最终计划必须把多个空间上互不重叠、但决策上相互依赖的视角合在一起。论文把这个问题定义为 Joint Multi-Scene Understanding(JMSU)。13
方法要点:HUGIN 包含两个互补组件。Endogenous Data Augmentation(EDA)先把样本拆成可核验的原子事实,再按照物流操作约束重新组合,生成更多同时满足视觉、状态和动作一致性的训练任务。Global Context Ranking(GCR)则利用 VLM 的视觉上下文层级,让任务指令与完整视觉上下文的表示更接近,而不是只与前面一部分图像的表示接近。作者还从 4 种自动物流分拣系统布局构建 SortingBench。13
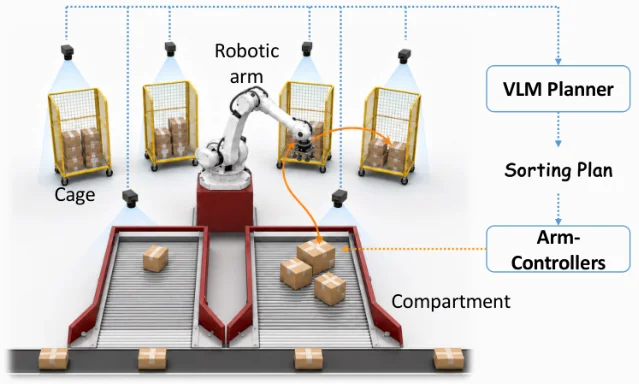
结果亮点:SortingBench 覆盖 4 种布局,作者在 5 个开放 VLM 上比较 HUGIN 与匹配基线。以 Qwen3-VL-8B 为例,准确率从 63.6% 提升到 78.8%;额外实验分别检查 EDA、GCR 和 JMSU 在其他具身任务上的迁移效果。部署测试涉及 15,000 多个包裹,论文据此报告 VLM 规划用于自动物流分拣的实践可行性。5
证据边界与阅读价值:15,000 多个包裹是部署测试规模,不等于论文已经给出了所有现场条件下的成功率、故障率或长期维护成本;主摘要也没有把它表述成真实生产环境的全面替代方案。论文的直接证据更适合支持一个窄问题:当任务需要多个分散视角共同决定动作时,训练数据的一致性和完整上下文对 VLM 规划很关键。对做机器人或工业视觉的人来说,值得带走的是数据构造原则:不要把每张图独立增强到失去跨场景关系,也不要只用局部视野的问答损失来训练一个必须做全局决策的模型。
一句话阅读价值:多摄像头规划的瓶颈不是把每张图看得更清楚,而是让模型知道哪些画面必须一起看,才能生成完整动作序列。
一句话收束
这五篇论文分别把五种隐藏条件摆到台面上:推理预算会改变模型排名,关键断言比整条轨迹更适合做可靠性检查,工具错误决定代理该重试还是换路,摘要压缩会优先丢掉时间锚点,多摄像头任务要求模型整合分散但互相依赖的证据。它们共同给出一条适合工程判断的阅读线索:看到一个更高的平均分时,继续追问这个分数在哪档预算、哪类错误、哪种记忆问题和哪组视觉证据下成立。
References
- 1本期论文 1:Budget-Dependent Rankings
arxiv.org
- 2
- 3本期论文 3:Retry, Switch, or Abstain
arxiv.org
- 4本期论文 4:The Sleeping Agent
arxiv.org
- 5本期论文 5:HUGIN
arxiv.org
- 6论文摘要与论文原文
arxiv.org
- 7论文摘要与论文原文
arxiv.org
- 8问题定义与评测设定
arxiv.org
- 9Budget-Dependent Rankings Figure
- 10作者、机构与代码链接
arxiv.org
- 11代码仓库
github.com
- 12代码与结果仓库
github.com
- 13作者、提交记录与评审状态
arxiv.org
- 14HUGIN ALSS 示意图
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.