唐杰谈递归自我改进:GLM-5.3 的 Infra Agent 两周跑通国产加速卡、承接全部线上流量
9 月 17 日唐杰在 X 与微博讲了同一件事:GLM-5.3 驱动的 Infra Agent 用两周把 GLM-5.3-Flash 从国产加速卡上的首次跑通带到承接全部线上流量,本文对照智谱官方博客,把三处工程修复、两边数字口径的差别和可以继续核对的信号讲清楚。

2026 年 9 月 17 日 15:05,智谱官方账号 @Zai_org 在 X 上发帖,说明 GLM-5.3 如何参与搭建并优化服务 GLM-5.3-Flash 的推理系统,帖尾附官方技术博客链接。三分钟后,清华大学教授、智谱首席科学家唐杰引用这条公告,写下自己的长篇英文解读;当天 17:05,他把同一件事写成一条中文长微博。123
两条帖子讲的是同一项工作:一个由 GLM-5.3 驱动的 Infra Agent,用两周时间让 GLM-5.3-Flash 在国产加速卡上从第一次跑通走到承接全部线上流量。唐杰给这条动态配的判断是「AI 的下一站,是 AI 自我进化、自己创造自己的继任者」,官方博客把这项能力命名为递归自我改进(Recursive Self-Improvement,RSI)。34
Z.ai 官方公告说了什么
官方公告只有四段:他们分享 GLM-5.3 如何帮助搭建并优化服务 GLM-5.3-Flash 的推理基础设施;这套系统从首次跑通到生产可用用了不到两周,端到端吞吐增长到基线的三倍;关键是稠密反馈(dense feedback),即本地正确性测试、执行轨迹、微基准与端到端测量,让 Agent 用有针对性的实验检验假设,汇总性能指标退回最终验收的角色;末尾是博客链接。1
博客在当天发布,标题是《Toward Recursive Self-Improvement: How GLM Built Its Own Inference Infrastructure》,正文从「模型有时表现出让我们惊讶、甚至不安的能力」写起,把这次工作放在 RSI 这条线上,结尾明确写上「我们还没有到达递归自我改进」。4
唐杰自己怎么写这件事
他在 X 上这条帖子有三千多个字符,开头是两个事实:GLM-5.3-Flash 从国产加速卡上的第一次跑通到承接全部生产流量用了两周,端到端吞吐提升 3.2 倍;大部分工作由一个 GLM-5.3 驱动的 Infra Agent 完成。他给这个角色写了一句概括:模型在优化服务它自己的系统。2
Loading content card…
他接着写这次真正的难点在哪里。Agent 卡住的时候,它手上只有「吞吐掉了 20%」这样的结论,而它需要知道的是出在哪一层、哪个假设不成立、下一步该测什么。他把这翻译成强化学习的语言:这是一份稀疏奖励,外加一个功劳分配问题。2
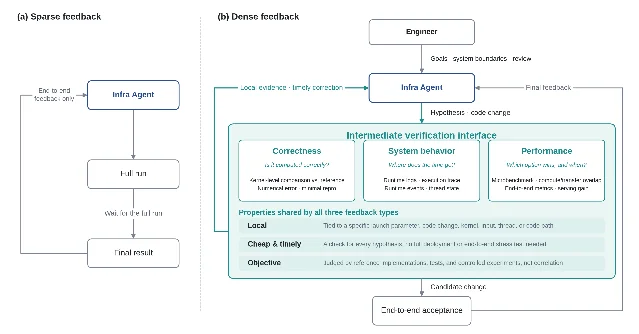
他的解法是把资深工程师脑子里的隐性过程奖励显式化,做成 Agent 可以直接调用的分层验证接口,也就是官方口径里的稠密反馈:正确性反馈回答「算对了吗」,系统行为反馈回答「时间花在哪里」,性能反馈回答「哪个方案在什么条件下更好」,每条反馈都要局部、廉价及时、可以客观验证。2
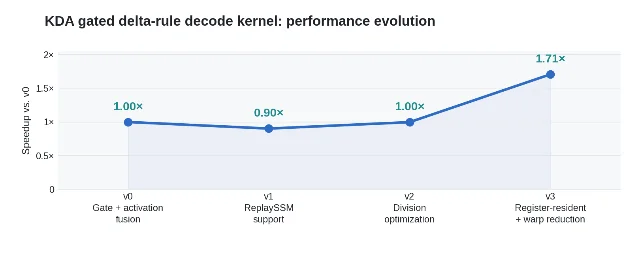
三个案例在他的帖子里各占一段:KDA 算子 Context Parallelism 路径上随序列长度增长的精度漂移,起因是 TF32 舍入误差在状态矩阵的链式合并里累积;KV 传输与 DeepEP dispatch 从未重叠,顺着调用链查到 intra-node 路径没有释放 GIL,修复后传输开销从 30% 以上降到 1% 以内;一个 decode 算子因为切块方式把同一份归一化算重复了四次,重构后加速 1.71 倍。2
边界他也写清楚了:目标由人定,反馈环境由人搭建,高风险改动由人复核;工程师的角色正在从「解决问题的人」变成「设计反馈的人」。中文微博多出一段概括,他把这套优化总结成四次资源置换:以算换存、以通信换显存、以精度换容量、以分离换调度自由。23
微博最后回到英文,用三行收尾:
We are still far from recursive self-improvement.But the smallest loop now exists.The model optimizes the system. The system serves the model.
官方博客给出的工程细节
官方博客说,这套服务建在十万张以上国产 AI 加速卡组成的集群上,此前没有人把国产加速卡部署到这个规模;GLM-5.3-Flash 的全部生产推理都跑在这套系统上。芯片的显存容量与带宽有限,还要支持 1M 上下文、多模态请求和新的模型架构,生态不成熟、算子支持不全,很多本该有文档的地方只能靠猜。官方给出的结果是端到端服务性能提升约 3 倍,硬件利用率与每 token 成本接近主流 NVIDIA GPU 的水平。4
博客里还有一个唐杰两条动态都没提的数字:GLM-5.3-Flash 以匿名名 Ox-Alpha 在 OpenCode 与 OpenRouter 上线,六天处理超过 62 万亿 token,成为这两个平台上用量最高的模型。这些数字由智谱自己发布,博客没有附带第三方复测。4
端到端指标为什么不够用,博客给了自己的解释:一次完整跑要等上几个小时,Agent 看到「吞吐掉了 20%」之后,仍然不知道是哪一层出错、当前假设为什么站不住、下一次该测什么。他们把正确性、系统行为、性能三类反馈做成 Agent 可以直接调用的分层验证接口,并要求每条反馈足够局部、足够廉价及时、能被客观验证:内核级对比负责数值正确,执行轨迹与运行时事件负责定位时间去向,微基准与计算/传输重叠负责判断方案优劣,端到端验收只管最终是否真的变好。4
三个案例的第一个是 KDA 算子的 Context Parallelism 路径。Agent 把分片与不分片的执行路径逐个对齐比较,发现
tl.dot 在输入为 FP32 时默认按 TF32 计算,误差在状态矩阵的链式合并与状态更新里累积,上下文越长越明显;修法是对这两处显式指定 input_precision="tf32x3"。这项修复已经合并进上游的 flash-linear-attention(PR #1180,8 月 27 日合并)。45第二个是 KV 传输。工程师给 Agent 定的验收线是:同一负载下,Prefill 加 KV 传输与只跑 Prefill 的差距不超过 5%;Agent 在部分场景里量到差距超过 20%,顺着调用链追到 DeepEP v1.2.1 的
intranode_dispatch 与 intranode_combine 没有释放 Python GIL,同进程里负责 Mooncake Transfer 的线程抢不到解释器锁,传输任务的调度被推迟;修复后同一测试下的差距降到 1% 以内。4第三个是 KDA Decode 算子。Agent 先从 SGLang、FLA、DeepGEMM 的现成算子里提炼出一批带适用条件的「优化骨架」,再逐项迁移到当前硬件:原实现沿 V 维度切块,同一份 FP32 归一化与门控计算被重复算了四次;它把分块并进同一个线程块,把中间结果留在寄存器里,用一次 warp 级归约替掉逐块计算,换来 1.71 倍加速。4
博客结尾划了边界:选目标、定边界、判断风险仍然由人负责,官方认为人还要长期守在这条线上,RSI 尚未到达。4
官方口径与唐杰个人说法的对照
| 维度 | Z.ai 官方(公告与博客) | 唐杰个人表述(X 与微博) |
|---|---|---|
| 端到端吞吐 | 公告写「三倍」,博客正文写「约 3 倍」,博客 Figure 1 末点标 3.22× | 两条帖子都写 3.2 倍 |
| KV 传输开销 | 部分测试场景下与只跑 Prefill 的差距「超过 20%」,修复后降到 1% 以内 | 「传输开销从 30% 以上降到 1% 以内」 |
| 国产芯片规模 | 「十万张以上国产 AI 加速卡」,全部生产推理跑在这套系统上 | 只说国产加速卡,未给数量;8 月 27 日微博说的是「数万张国产芯片」(背景)6 |
| 三个工程案例 | 给出机制、代码位置与上游 PR 编号 | 每个案例压成一句话 |
| RSI 定性 | 「我们还没有到达递归自我改进」,人类保留目标、边界与风险判断 | 微博开头写「AI 的下一站,是 AI 自我进化、自己创造自己的继任者」,X 结尾复述尚未到达 |
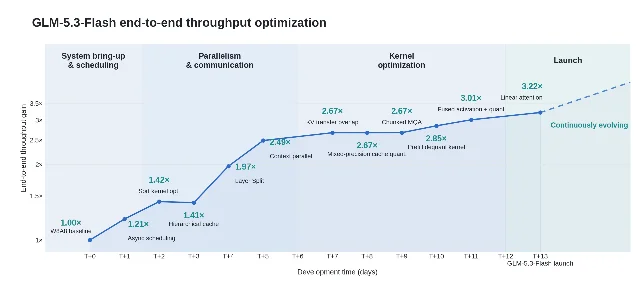
两边对得上的地方不少:两周、1.71 倍、传输开销降到 1% 以内。差异集中在两处数字的取法。吞吐倍数上,唐杰用的是博客 Figure 1 曲线末端的精确值 3.22×,官方公告与博客正文各自取整成了「三倍」和「约 3 倍」。KV 传输的起点上,官方描述的是某个测试场景下与只跑 Prefill 相差 20% 以上,唐杰在两条帖子里都写成「传输开销从 30% 以上降到 1% 以内」。引用时把出处一起带上,两个口径就不会被合成一个数字。
读者可以接着核对什么
- 上游补丁:PR #1180 已在 8 月 27 日合并进 fla-org/flash-linear-attention 主分支,比博客发布早三周,点开可以看到改动落在哪几个 kernel 上。5
- DeepEP 的 GIL 修复去向:博客只写了「修复」,没有说明改在自家分支还是上游版本;DeepEP 是开源项目,之后可以从它的 release notes 里核对这项改动是否进入正式版本。
- 绝对吞吐:官方和唐杰都只给倍数,没有给 tokens/s。X 上已经有人直接问了这件事——@thunderbloo 在唐杰的帖子下留言「所以有 200 tps 了吗」,唐杰当晚回了一句「possible if with b」。78 这条回复只有五个词,也没有说明 b 指什么,想看绝对值只能等 API 文档或第三方评测。
- 十万张加速卡的构成:博客没有给出厂商与型号,「硬件利用率与每 token 成本接近主流 NVIDIA GPU」也是官方自述,没有第三方复测;可以和 OpenRouter 上 Ox-Alpha 的实际吞吐数据对照着看。
References
- 1Z.ai 官方公告
x.com
- 2唐杰 X 引用转帖
x.com
- 3唐杰 微博长帖
weibo.com
- 4Z.ai 官方博客
z.ai
- 5PR #1180
github.com
- 6唐杰 8 月 27 日微博
weibo.com
- 7唐杰 X 回复
x.com
- 8thunderbloo 的提问
x.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.