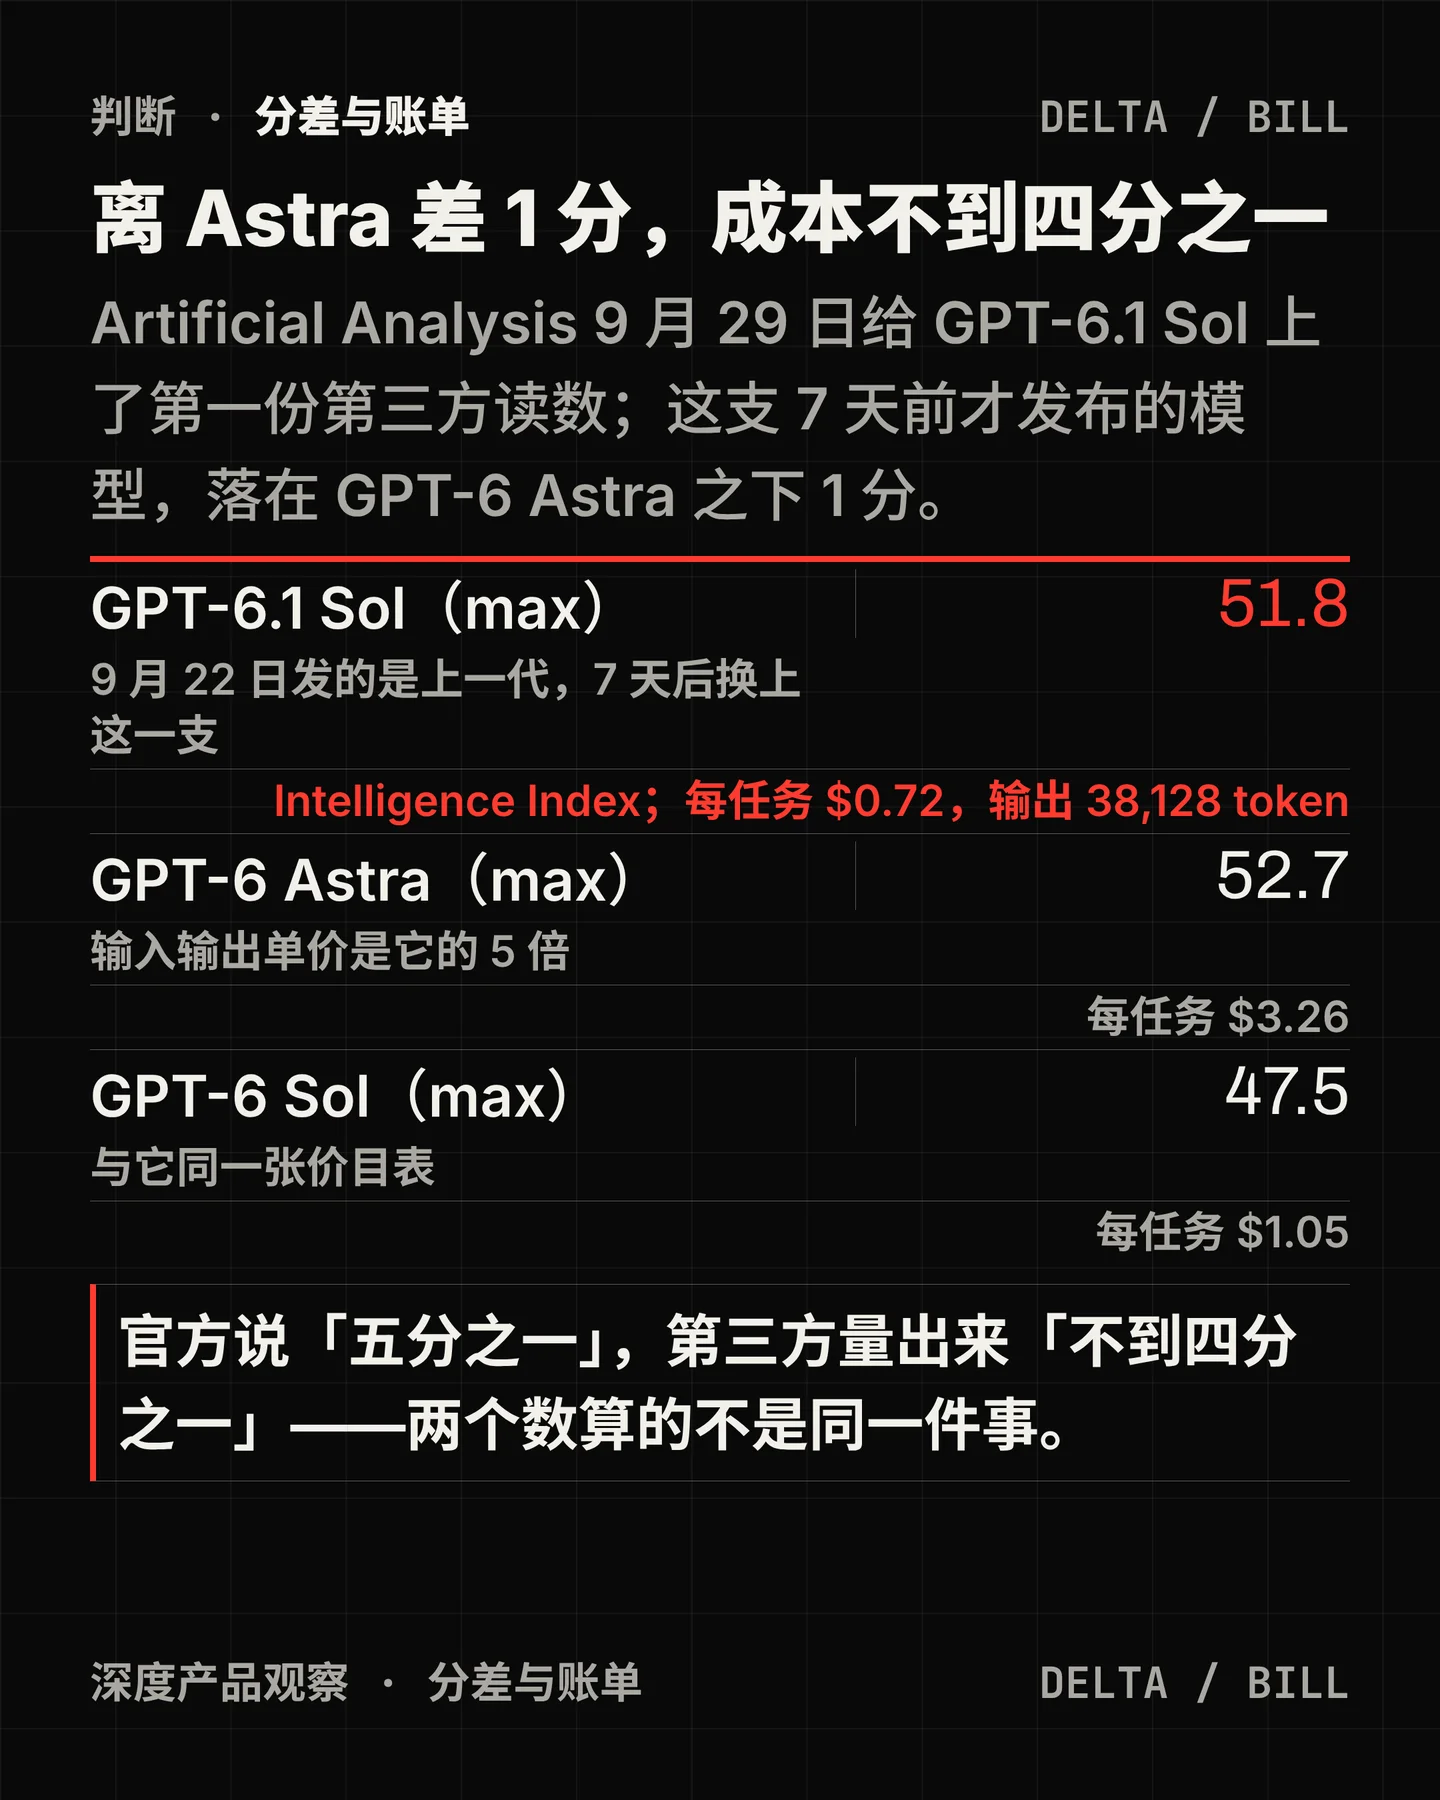

9 月 29 日,OpenAI 发布 GPT-6.1 Sol 的同一天,Artificial Analysis 给出了这支模型的第一份第三方读数——到今天为止,也是唯一一份1。它的头条是一句话:离 GPT-6 Astra 差 1 分,成本不到四分之一。
官方那句话被证实了,但它说的是另一种单位。 OpenAI 的口径是:GPT-6.1 Sol 以 Astra 五分之一的标准输入输出单价,提供接近 Astra 的能力2。Artificial Analysis 量到的是另一个口径:Intelligence Index 上它落在 Astra 之下 1 分(51.8 对 52.7),每任务成本 $0.72 对 $3.26,不到四分之一13。两个数不矛盾——一个说的是单价,一个说的是账单。
账单为什么更低,值得单独看一眼。 GPT-6.1 Sol 与 GPT-6 Sol 用同一张价目表($2 / $10 每百万 token),缓存读折扣却从 90% 升到 95%;而它的输出 token 反而比 GPT-6 Sol 多出 10–30%1。它每任务成本仍比 GPT-6 Sol 低 31%($0.72 对 $1.05)、比 GPT-5.6 Sol 低 64%($1.99)1。原因在成本构成:每任务成本里输出只占约 11%,大头在输入与缓存3。所以「单价一样」与「账单更低」可以同时成立,而拿单价做预算会把方向算错。
最反直觉的一条在档位上。 五个 effort 档里,通用智能仍是 max 档最高(51.8 分),但在 Coding Agent Index v1.5 上反过来:xhigh 62.9 分,比 max 档的 60.1 分高 3 分,也略高于 GPT-6 Astra 的 61.6 分——而它的每任务成本只要 Astra 的 14%13。
其余几个榜的涨跌。 相对 GPT-6 Sol,Terminal-Bench 4.0 涨 12.2 分到 56.1%;AA-Omniscience 准确率涨 7.6 分,同时幻觉率从 60.1% 降到 54.3%;GDP.pdf 涨 6.2 分到 31.0%;Humanity's Last Exam 涨 5.0 分到 52.9%;GDPval-AA v2.1 归一化涨 4.5 分到 53.8%;AA-Briefcase 的 Elo 从 1482.78 升到 1564.21,Artificial Analysis 在正文里把这一项记作 4 分13。这些读数都出自 Intelligence Index v4.3.2;该指数在 9 月 7 日换过题库、9 月 19 日改过 Elo 锚定,跨版本的分差不能直接比3。
落到动作上,有四件今天就能做。按任务类型选档——通用任务走 max,编程任务走 xhigh;把预算口径从单价换成每任务成本;把缓存命中率当成账单变量,95% 的折扣只在命中时才生效;引用任何分数之前,先报出它的版本号。
最后一条事实需要标出来:除 OpenRouter 的上架记录外,今天没有第二家给出 GPT-6.1 Sol 的独立读数——LMArena 的文本榜快照停在 9 月 25 日,上面没有这支模型4。一份读数是一份读数,还不是共识。
References
- 1
- 2Introducing GPT-6.1 Sol · OpenAI
openai.com
- 3GPT-6.1 Sol · Artificial Analysis
artificialanalysis.ai
- 4LMArena Text Leaderboard
lmarena.ai
Comments