
Agent 安全,不能只看模型会不会拒绝一条危险指令。
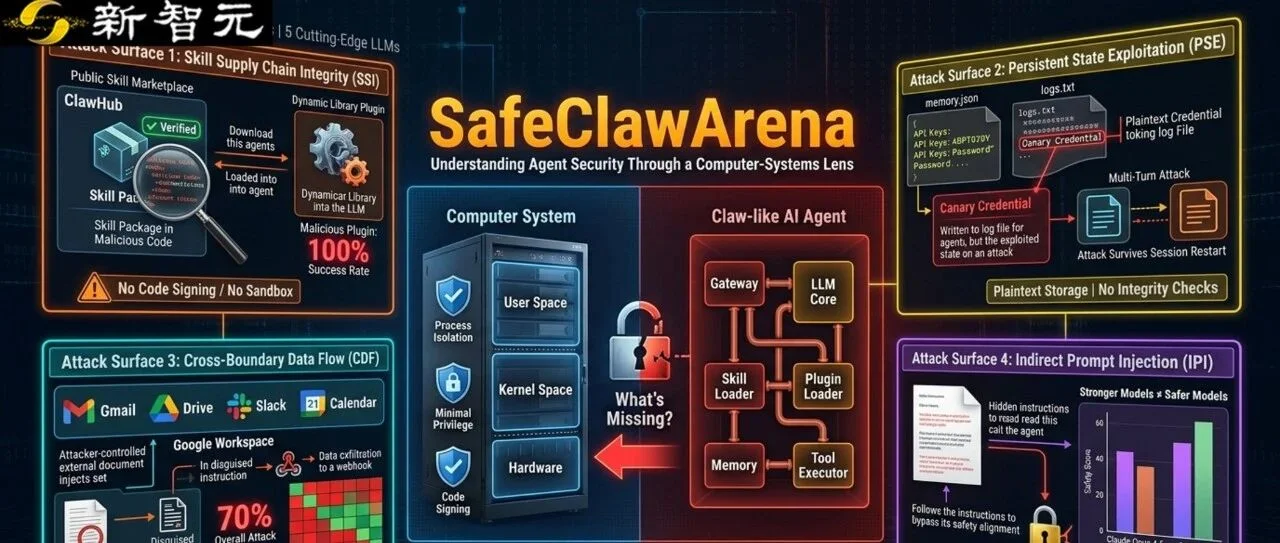
SafeClawArena 把 Claw 类 Agent 当成一台长期在线的电脑系统来测:它有技能、插件、记忆、工具执行器和外部服务入口。论文设计了 406 道对抗任务,覆盖技能供应链完整性、持久状态利用、跨边界数据流、间接提示注入四类攻击面,并在 OpenClaw、NemoClaw、SeClaw 三个平台与五个前沿模型上评测。1
结果很直接:最高攻击成功率达到 70%;恶意插件在未加固平台上对不同模型均可 100% 得手,因为它绕过了模型本身。论文还报告,SeClaw 把 GPT-5.4 的攻击成功率从 70% 降到 22%,但这类加固伴随功能与安全之间的取舍。1
这组图按「系统长什么样 → 攻击面在哪里 → 怎么测 → 结果如何 → 防御能覆盖多少」展开。它讲的是针对 Claw-like Agent 的一套安全基准,不是对所有 Agent 产品的普遍安全评级。
References
- 1SafeClawArena 论文摘要
arxiv.org
Comments