10月28日三栏:74 题里只换一条无关证据,41 题从对变错;准确率恒为 90% 的监控器,重启收益能从 +50 跨到 −50——长程智能体与生成式音频的 45 篇分层雷达
该账号 10 月 28 日三栏 165 篇新提交筛完收录 45 篇:74 题里只把一条无关证据换成一条过时旧值,就有 41 题从对变错;准确率恒为 90% 的监控器,重启收益能从 +50 跨到 −50 个百分点;自进化报出的技能增益,有一半能被「纯选择」复现。

本频道盯「arXiv 每日学术速递」的三个栏目:人工智能、自然语言处理、语音与音频学术速递。文中的「站内摘要」指该账号官网条目页上那段自动生成的中文摘要,条目末尾会拿它与 arXiv 原文对照。
这一期筛的是 2026 年 10 月 28 日的三栏。公众号当天上午只发了单篇论文导读,速递栏目图文到发稿时还没发布,候选池按该账号官网同日同栏目重建:人工智能 95 篇新提交、自然语言处理 55 篇、语音与音频 15 篇,合计 165 篇,编号落在 2610.35925 到 2610.37655 之间,与最近三期处理过的编号零重叠。每条入口用官网同日同栏目的条目页,另附 arXiv 原文。
165 篇逐条筛完,收录 45 篇、排除 120 篇。按阅读投入分档:精读 14 篇、值得扫读 26 篇、邻近跟踪 5 篇。四条线按每篇的主要归属计:A 线(长程任务的训练与评估)25 篇、B 线(轨迹学习与自进化)9 篇、C 线(TTS 生成与评估)10 篇、D 线(播客生成与节目级评估)1 篇——D 线这一篇是邻近项,今天没有直接命中。
语音与音频栏的 15 篇新提交集中在识别与数据、分离与匿名化、音乐与可穿戴感知,另有两篇评测类;没有一篇做播客脚本生成、多说话人节目合成或节目级听感评测。第七节只登记四个连接点并写清各自缺哪一环,不放替代品。
只有一小时的话,先读三篇:记忆那篇的等长替换实验(74 题里只把一条无关证据换成一条过时旧值,Qwen2.5-7B 就从 74/74 掉到 33/74),监控器那篇的决策价值框架(准确率恒为 90%,重启收益却整条带从 +50 跨到 −50 个百分点),以及音频证据那篇的同名对照(把目标声音换成同一类的另一段录音、正确答案不变,12% 到 16% 的答案照样翻)。三篇给的都是分母与对照,而不是又一个更高的分数。
今天最该先知道的四件事。
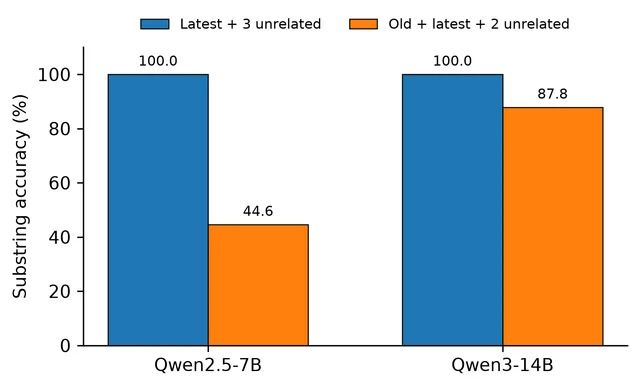
记忆的失败点已经从「检索不到」移到「检索到了却用旧的」。 74 道有冲突的题,各造两个只差一条陈述的四句上下文:一边是最新事实加三条无关陈述,另一边是旧事实加最新事实加两条同样的无关项。Qwen2.5-7B 从 74/74 掉到 33/74(55.4 个百分点,p=9.09×10⁻¹³),Qwen3-14B 从 74/74 掉到 65/74。掉分不能用「更新没检索到」解释:同一批 100 个检索集,四个预算下的审计都是 100/100 命中了最新陈述。同一篇里还有一条反向读数——预算从 64 加到 512 token,准确率反而从 45% 降到 32%。1
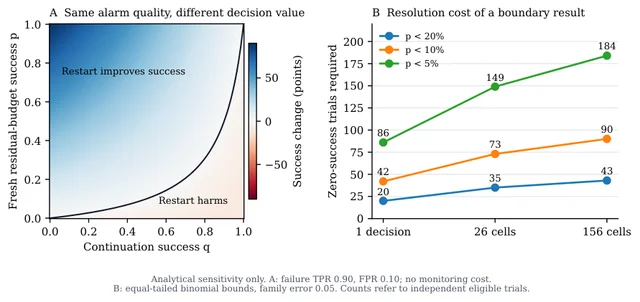
我们验收「要不要接管」的那把尺子,量的是别的东西。 重启监控器那篇给了一个解析结果:真阳率 0.9、假阳率 0.1 时,准确率恒为 90%,重启带来的成功率变化却在整张图上从 +50 跨到 −50 个百分点;同一条曲线在 q=0.5 那一行是 −5 到 +35。它的实测部分很小:19 个题、194 次执行,156 个「任务×时点」格里有 103 个能真正比较,而这 103 个里没有一个通过符号认证。另一篇把这条讲得更直白:同一批交接任务、同一批模型,只因把工具观测里的一条订单状态匹配计入判分,六个接收方里五个从「结构化状态更好」翻成显著更差。23
自进化报出来的 Δ,多半能从「基线怎么取」里解释掉。 16 个由三个优化器学到的技能,在测试集上平均只比手写种子高 0.1 点,其中 9 个平均 −1.4 点。把接受规则套在「与种子完全相同的候选」上重放,两个优化器仍能达到实报增益的概率是 0.56 到 0.94。机制很朴素:这些 run 都以种子最低分的那次开发集运行为基线,再在不超过 30 题的开发集上取 4 到 8 个候选的最好者。另两篇同族方法也没能把这条遮住——一篇摘要写「最高 20.7% 超过基线」,在任何一张表里都定位不到;另一篇每格只跑一次,且在宽度扫描里于测试集上取最大。45
语音侧今天有两个对照可以直接抄。 一是「同名替换」:把目标事件换成同类的另一段录音、正确答案不变,答案照样翻转 12.25% 到 15.67%,所以报「换成另一类声音后答案变化 65% 到 73%」时要把这层底噪扣掉;同一模型两臂相减,净效应是 49.67 到 60.92 个百分点。二是「两级分母」:某个 MOS 预测器在 187 个系统求均值后的 MSE 是 0.080,看起来领先,但在 1,066 句的 utterance 级是 0.228,反而输给两个基线。同一篇论文里,换一个分母就换一个结论。67
第四节那八篇自进化论文,最值得记的共同点也在这里:三篇同族方法分别改数据入口、改搜索结构、做审计,评测集互不相同,唯一名字相同的是 τ-bench 与 τ³-bench,而它们不是同一套题、分数不能横比。它们合起来说明一件事——报出来的 Δ 里,有一半可以从基线怎么取、每格跑几次、候选怎么挑里解释掉。
全景表
三张表按栏分。表内先精读、再值得扫读、最后邻近跟踪。栏目标题里的「新提交」是该栏当日的总卡片数,收录数是本期收进正文的篇数。
人工智能学术速递[10.28](新提交 95 篇,收录 24 篇)
| 档位 | 论文 | 一句话结论 | 来源 |
|---|---|---|---|
| 精读 | Obsolete Facts · arXiv:2610.36308 | 74 题里换掉一条无关证据、塞进一条过时旧值:Qwen2.5-7B 从 74/74 掉到 33/74 | 官网 |
| 精读 | CASEL · arXiv:2610.36570 | 同菜单同成本下它的伤害率 7.02% 高于 Risk-Menu 的 5.82%,换到的是少三成人工审批 | 官网 |
| 精读 | Restart Monitors · arXiv:2610.36544 | 准确率恒为 90% 的一族监控器,重启收益在整张图上从 +50 跨到 −50 个百分点 | 官网 |
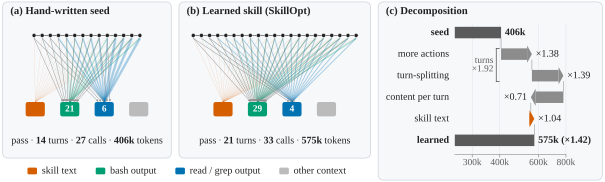
| 精读 | AutoVend · arXiv:2610.36980 | 180 天、20 台售货机:五个模型里四个跑不过规则基线,最强那个的 API 花费是对手的 80 倍 | 官网 |
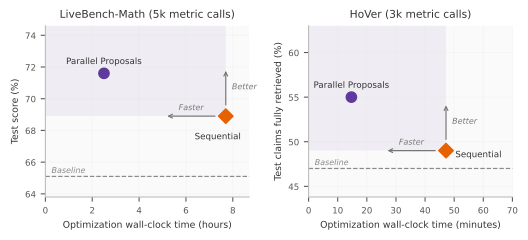
| 精读 | Batching GEPA · arXiv:2610.36774 | 把一步变宽:测试分 68.9→72.1 与 49.0→60.0,但每格只跑一次、且是在扫描里取最大 | 官网 |
| 精读 | BiPA · arXiv:2610.37201 | 16 个学到的技能平均只比手写基线高 0.1 点,而 dev 增益有一半能被「纯选择」复现 | 官网 |
| 值得扫读 | ProactMem · arXiv:2610.36967 | 主动记忆要分报两个数:覆盖率高 89.7% 的那一栏,打扰率 18.1% 也比别人高 | 官网 |
| 值得扫读 | DiscernMem · arXiv:2610.36652 | 配对重放分清两种病:去掉「该不该用」的门掉 1.75 分,去掉验证掉 2.84 分 | 官网 |
| 值得扫读 | CrossProfile · arXiv:2610.37624 | 最稀有优先在经典格 96.7%,全变体平均 64.0% 与随机 64.5% 打平 | 官网 |
| 值得扫读 | ReInBench/ReCoF · arXiv:2610.36471 | 自愈率 54.8%,而「部分恢复」的轨迹完成率 18.0% 低于「零恢复」的 20.6% | 官网 |
| 值得扫读 | Epistemic Vigilance · arXiv:2610.36453 | 让步率从 ≤25% 到 96–100%:只报让步率会把「分不清对错」当成「很顺从」 | 官网 |
| 值得扫读 | PRESENT · arXiv:2610.36435 | 用户在场让收益平均 +13.7%,换成被动用户后增益归零 | 官网 |
| 值得扫读 | TAM · arXiv:2610.37482 | GUI 任务推进当监督:34.2% 对最强基线 29.1%,但记忆就在被评测的任务上在线累积 | 官网 |
| 值得扫读 | kw-bench · arXiv:2610.36405 | 同一个廉价模型换两家实验室的 harness:0.542 与 0.528,另两家整包交白卷 | 官网 |
| 值得扫读 | RuHarness · arXiv:2610.36826 | 判分准则也得一起演化:冻结准则 44.4 比完全没有准则的 45.8 还低 | 官网 |
| 值得扫读 | PCE · arXiv:2610.36660 | 种群当诊断证据源:SWE-bench 52.0→72.1,总 token 反而降 36% | 官网 |
| 值得扫读 | Evolving Agent Teams · arXiv:2610.36848 | 让团队自己重组:同类系统同预算下 0.721 对 0.448,两次都走到更难的指令集 | 官网 |
| 值得扫读 | The Trinity · arXiv:2610.36077 | 世界生成与 harness 演化一起放开:训练集 39.06→73.16,未见基准 37.45→63.61 | 官网 |
| 值得扫读 | Correctness Conditioning · arXiv:2610.37070 | 只留答对样本等于换分母:全体 0.507 到筛后 0.581,差 7.4 个百分点还有公式 | 官网 |
| 值得扫读 | LiveSearch · arXiv:2610.37166 | 把问题写成可执行代码:70% 的题三天内金标准就变了一次 | 官网 |
| 值得扫读 | MABGrader · arXiv:2610.36767 | 20 个模型、52 个配置的证明判分器全部低于专家一致性 0.76,加上臂选择后最高也只到 0.66 | 官网 |
| 值得扫读 | Sliding-Puzzle SPE · arXiv:2610.36415 | 成功率拆成三层:合法率与达成率都是 100% 的模型,综合分只有 0.830,因为多走了 8.33 步 | 官网 |
| 值得扫读 | RubricAtlas · arXiv:2610.36878 | 从专家报告挖类型级规则:单份参考只覆盖 54%,聚到十份才到 96% | 官网 |
| 邻近跟踪 | TeamGym · arXiv:2610.37571 | 信息分给团队后掉 22.9 个百分点,给出原文再掉 19.9 个百分点 | 官网 |
自然语言处理学术速递[10.28](新提交 55 篇,收录 13 篇)
| 档位 | 论文 | 一句话结论 | 来源 |
|---|---|---|---|
| 精读 | TrawMem · arXiv:2610.36918 | 按任务角色组工作区:四个骨干的判官分 +2.19 到 +6.34,但总耗时反而高 15.6% | 官网 |
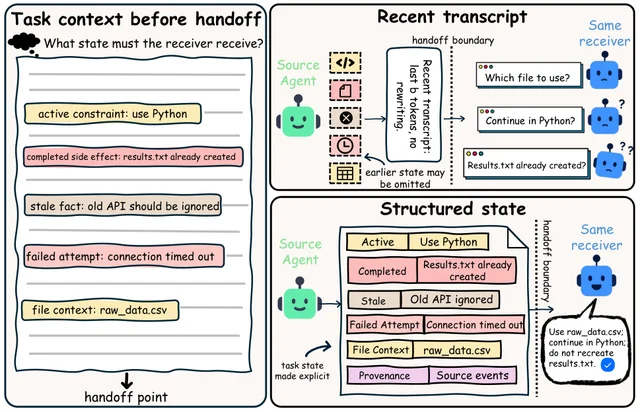
| 精读 | HSC-Bench · arXiv:2610.36523 | 交接状态写好了反而更差:同一批任务只因把一条匹配计入判分,六个接收方里五个翻向 | 官网 |
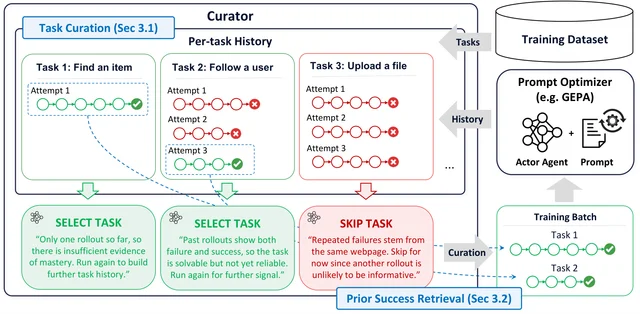
| 精读 | GEPA-Curator · arXiv:2610.37651 | 先筛任务再反思:held-out 上 82.1 对 78.7,成本 1.31 倍;摘要的 20.7% 在任何一张表里都找不到 | 官网 |
| 精读 | Token Confidence · arXiv:2610.36709 | 置信度打分与链长的秩相关 −0.53,去长度后掉到随机水平 0.486 | 官网 |
| 值得扫读 | ETAMem · arXiv:2610.37443 | 三个视图各自建树:LoCoMo 84.68 对 75.30,代价是每问 2,344 个推理 token | 官网 |
| 值得扫读 | SKIM · arXiv:2610.36948 | 32 条事实写进冻结模型的 FFN:五模型召回 46.9%–75.0%,59 次失败里 44 次在存储端 | 官网 |
| 值得扫读 | RKI · arXiv:2610.36811 | 定位到弱点之后还要认状态:混着已有知识一起干预,两集平均高 18.41 点 | 官网 |
| 值得扫读 | Decision Models as Judges · arXiv:2610.37229 | 判官换小模型:分数打平时成本是 0.5%–10%,但两类幻觉上仍落后 3.9 与 7.8 点 | 官网 |
| 值得扫读 | ETC-Bench · arXiv:2610.36527 | 同一批识别结果换个规范化口径:模型自带技能只有 3.5–13.9,加上技能到 68.8 | 官网 |
| 值得扫读 | Agentic ASR Sampling · arXiv:2610.36538 | 让 agent 按错误画像决定下一轮采什么数据:平均错误率 19.4 对 23.9,日语与中文除外 | 官网 |
| 邻近跟踪 | CAMR · arXiv:2610.36734 | 同等重放条数下,只比随机重放领先 0.36–0.58 个百分点 | 官网 |
| 邻近跟踪 | Free Exploration · arXiv:2610.37649 | 12 个模型里只有 1 个在改过物理规律的世界里发现了规律;另一个判断正确率 16.7%,证据支持却是 0 | 官网 |
| 邻近跟踪 | Basque Speech LM · arXiv:2610.36911 | 低资源语言没有指令语料:把文本译过去、用合成语音造 550 小时问题 | 官网 |
语音与音频学术速递[10.28](新提交 15 篇,收录 8 篇)
| 档位 | 论文 | 一句话结论 | 来源 |
|---|---|---|---|
| 精读 | ConformalMOS · arXiv:2610.36126 | 系统级 MSE 0.08,utterance 级 0.228 反而输给两个基线:换分母就能把平庸点估计写成领先 | 官网 |
| 精读 | Same-Class Controls · arXiv:2610.37605 | 换同一类的另一段录音,答案也会翻 12%–16%:那 50 到 61 个百分点是扣掉底噪之后的净效应 | 官网 |
| 精读 | EvoSpeakerMem · arXiv:2610.36713 | 固定声纹一年内退化:被阈值拒掉的真人探针从 29.8% 升到 55.6%,等错误率 9.7%→14.0% | 官网 |
| 精读 | AudioRSI · arXiv:2610.36578 | 让裁判跟着策略一起变强:1,000 题上 76.10 对基线 74.60,而换成冻结裁判是 75.10 | 官网 |
| 值得扫读 | TAC2 · arXiv:2610.36568 | 把「谁在何时说了什么」做成可查询的监督层:时间偏移 1.54 秒对基线 2.47 秒 | 官网 |
| 值得扫读 | S3-S2ST · arXiv:2610.36777 | 流式翻译的「何时开口」交给语义:FLEURS 上 BLEU 29.83,仍低于 30.20 | 官网 |
| 值得扫读 | Content Leash · arXiv:2610.36768 | 匿名化把等错误率做到 26.31%,代价是字错率从 2.48% 涨到 11.75% | 官网 |
| 邻近跟踪 | Wearable Audio Sensing · arXiv:2610.37270 | 16 人四个月的胸挂音频:办公室每小时说话比居家多 12.61 分钟,压力高 7.49 | 官网 |
一、记忆:旧的那条什么时候该退场
今天的记忆类候选有八篇,全都出在同一个位置上:系统已经能取到该取的那条,问题出在取到之后。
这八篇各测一种失败——检索结果里混进过时旧值、记忆按相关性排队导致桥接记忆被挤掉、记忆切分维度与问题维度不匹配、介入时机无法核实、规则本身有缺陷还是用错场合、群体记忆压缩把证据排错、参数内写入与读取分不清、以及重放池该收哪些样本。把它们放在一起读,有一个共同的走向:八篇里有五篇的结论落在「取到之后怎么用」,另三篇落在「用多少 token、多少时间」。
1. 74 题里换掉一条无关证据、塞进一条过时旧值:Qwen2.5-7B 从 74/74 掉到 33/74 · arXiv:2610.36308 · 精读
When Retrieval Is Not Enough: Obsolete Facts in Agent Memory
作者:Oleeviya Babu Poikarayil 等 7 人;马格德堡大学、喀拉拉大学、慕尼黑工业大学。NeurIPS 2026 PALM workshop,代码与提示词已开放在
github.com/oleeviyababu/Memory_Conflict。研究问题与核心方法:
记忆基准把「检索」和「作答」压成一个总分,分数掉了分不清是没检索到更新、还是检索到了没用。这篇只问后者:最新事实确实进了检索结果、但旧版本也在里面时,模型用哪一条。
做法是一个等长替换干预。74 道有冲突的题各造两个四陈述上下文:A = 最新陈述 + 3 条无关陈述;B = 旧陈述 + 最新陈述 + 其中 2 条同样的无关项。两组只差「一条无关证据被换成过时竞争者」。检索按单条陈述做 BM25 累加到 token 预算,两个 Qwen 模型走 Ollama,temperature 0、seed 42,配对检验用双侧精确 McNemar。1
关键结果:
- 预算越大反而越差:Qwen2.5-7B 在 64/128/256/512 token 上分别是 45%、40%、36%、32%(分母 100 题);64 对 512 是 14 题只在 64 对、1 题只在 512 对,p=9.77×10⁻⁴。
- 掉分不是「更新丢了」:同一批 100 个检索集,四个预算下 gold 审计都是 100/100 命中了最新陈述。
- 等长替换的效应:Qwen2.5 从 A 的 74/74 掉到 B 的 33/74,55.4 个百分点,41 题只在 A 对、0 题只在 B 对(p=9.09×10⁻¹³)。Qwen3-14B 同方向但小得多:74/74 到 65/74,9 题只在 A 对(p=0.0039)。两模型合计 50 次有害翻转,全部是「选了旧值」。
- 参照值:6K 全上下文 37/100,只给问题不给记忆 19/100。在这条线上,「有记忆」本身值 18 题。
证据与局限:
100 题、74 题配对,每个条件跑一次,没有多 seed、没有区间,只有配对 p 值;作者也说明题目共享同一条历史,p 值只描述这一个基准实例。这 74 题同时用于提示词开发与 pilot,属同批配对,不是 held-out 确认。
覆盖面窄:两个模型同属 Qwen 家族、单跳、更新链最长两级、只用 BM25 词法检索。指标是子串匹配,人工复核抓到 1 个假阴、1 个假阳与 2 条同时含新旧串的输出,作者选择不改官方分。
作者自己最重要的限定是:这个基准里过时值往往正好符合常识,合成更新反而违背常识。所以实验证明的是「对这类竞争陈述的易感性」,无法证明「时间过时」本身在起作用。最弱的一格是 Qwen3-14B 的 87.8%——只剩 9 次翻转、单次运行,用它论证「换模型更稳健」证据偏薄。1
与目标研究线的关系:A 线直接命中。它给的正是记忆型长程评测里「检索命中」与「答案采用」如何分开报的口径。
可迁移启发:评测报两列,检索集是否含最新事实、最终答案是否用了最新值,再按「有无过时竞争者」分层出准确率。把「等长替换一条证据」做成配对干预单元,报 A-only 与 B-only 的翻转计数,成本只是每题多跑一次。
站内摘要出入:站内写「证明仅检索正确事实不足」;原文只是两个 Qwen 模型、单跳、BM25 检索、74 题同批配对下的易感性证据,作者明确说过时值符合常识、无法归因到「时间过时」。
2. 按任务角色组工作区:四个骨干的判官分 +2.19 到 +6.34,但总耗时反而高 15.6% · arXiv:2610.36918 · 精读
TrawMem: Reframing Agent Memory as Task-Oriented Role-Adaptive Workspaces
作者:Mingyu Zhang 等 6 人(Zixu Li 标注为 Project Leader,Yupeng Hu 为通讯作者)。HTML 全文与摘要页都没有单位信息,机构未报;全文未给代码链接。
研究问题与核心方法:
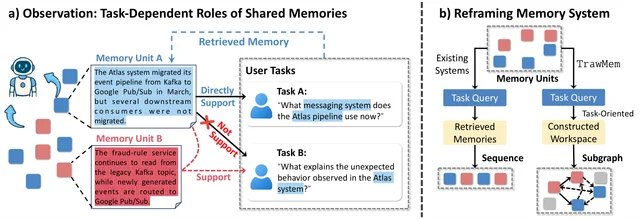
同一条记忆在任务 A 里能直接支撑答案,在任务 B 里只是一座通往另一条语义相关度更低、却必需的记忆的桥。按相关性取 top-k 会把桥挤掉。
TrawMem 先把交互历史切成 thread(一个摘要头加一段保序记忆单元),把「源顺序相邻」与「语义相近」的 thread 连成图。查询进来后先给 thread 头打分,在图上传播并沿边展开有界邻域,对邻域内候选分配 anchor / bridge / context 三种任务角色,再按任务导向代价加结构化覆盖选进工作区(默认 16 个单元)。8
关键结果:
- LoCoMo 宏平均,Qwen3.5-9B:F1 39.14、BLEU-1 36.75、判官分 63.26,对 SimpleMem 的 36.91/33.04/59.19,即 F1 +2.23、判官分 +4.07 个百分点。
- 另外三个骨干的判官分增益:Qwen3.8-27B +2.19、DeepSeek-V4-Flash +4.31、GPT-5.6-Luna +6.34,四点均值 +3.71。
- MemGallery 九类题平均的判官分增益 0.52–4.82 个百分点,最小一格是 Qwen3.5-9B 的 49.06 对 Mem0 48.54。
- 成本是双向的:Qwen3.5-9B 上约 2,050 tok/q,比 SimpleMem 的 2,351 少 12.8%,但总时 699.9 秒/root 对 605.3 秒/root,反而高 15.6%。对 LightMem(约 1,012 tok/q)上下文约为其 2.0 倍。
- 工作区压缩(Fig. 8):平均 144.8 个候选单元只留 15.4 个,逐题缩减均值 89.2%。
证据与局限:
两个数据集、四个骨干,每配置只报一次运行,没有多 seed 与方差;判官分由与作答同一个骨干给出(Qwen3.5-9B 自己判自己),论文没有人判对齐。LoCoMo 的 1,540 题只来自 10 个 root,bootstrap 以 root 为重采样单位,所以「对 NaiveRAG 领先 5.84 分」这个数配的区间 [3.99, 7.43] 宽得并不意外。
消融只报判官分相对 Full 的落差,最大掉点来自去掉多 thread 组合(LoCoMo 1.86–2.62),但没有给各变体的 token 成本,无法判断掉点是不是因为候选集整体变了。最弱的一格是 Table 2 里 Qwen3.5-9B 的 +0.52 个百分点,单次运行、无区间,基本落在噪声尺度内。8
与目标研究线的关系:A 线直接命中,给的是长程记忆的「组织与选择」这一层,可直接搬来做评测侧的上下文构造基线。
可迁移启发:报 token 效率必须同时给参照系统和总时延——本文的 −12.8% 只对 SimpleMem 成立,同一行总时高 15.6%,这种「省 token 不省时间」的写法值得照抄进自己的评测表。作者另用 356 组配对样本记录同一条记忆的 anchor 权重下降、bridge 权重上升,用中间量证明机制在起作用,比端到端分数更有说服力。
站内摘要出入:站内写「降低上下文令牌需求」;原文只在对 SimpleMem 时成立(−12.8% 与 −5.1%),对 LightMem 上下文约为其 2.0 倍,Qwen3.5-9B 上总耗时还高 15.6%。
3. 三个视图各自建树:LoCoMo 84.68 对 75.30,代价是每问 2,344 个推理 token · arXiv:2610.37443 · 值得扫读
ETAMem: Decoupling and Aligning Heterogeneous Memory for Long-Term Conversational Agents
作者:Xinying Qian 等 6 人,南开大学、天津工业大学、爱丁堡大学。未给代码。
研究问题与核心方法:一段对话同时裹着事实、偏好与时间线索,按整轮切或按语义切都切不开。ETAMem 拆出原子记忆单元,再建三条层级视图:Event 走语义相似、Affect 走情感表征、Time 走时间层级;增量维护用 attach/split/merge 加自适应阈值,检索按熵路由分配预算。
关键结果:
- LoCoMo(1,540 题,3 次运行):84.68±0.53,TiMem 75.30±0.16、MAGMA 73.25±0.62,绝对 +9.38pp 与 +11.43pp,相对 +12.46%。
- LongMemEval-S(500 题):83.00±0.20 对 TiMem 76.88±0.30(+6.12pp),对 MAGMA 55.00±0.60(+28.00pp)。
- 构建成本低、推理成本高:63.41k tokens/会话,比 TiMem 的 563.40k 少 88.75%;但推理 2,343.64 tokens/问,是 LightMem 749.95 的 3.1 倍。
- 最弱的一格在消融:关掉原文回退,LongMemEval-S 从 83.00 掉到 74.20。
证据与局限:三次运行的标准差在 0.16 到 0.62pp 之间,增量可信;准确率全由 LLM 判官给出,未做人评校准。作者自述情感表征只取极性,换到更强的 Qwen3-30B 反而更低。9
与目标研究线的关系:A 线直接命中,给的是长程对话记忆的评测与成本口径。
可迁移启发:记忆成本要拆 build 与 inference 两栏,并注明每问输入 token,否则「省 88.75%」与「贵 3.1 倍」会出现在同一张表的两端而互相抵消。
站内摘要出入:站内写「显著准确率提升且保持良好令牌效率」;12.46% 与 7.96% 都是相对值(绝对 +9.38pp/+6.12pp),且推理 token 是 LightMem 的 3.1 倍,效率只在对比 TiMem、MAGMA 时成立。
4. 主动记忆要分报两个数:覆盖率高 89.7% 的那一栏,打扰率 18.1% 也比别人高 · arXiv:2610.36967 · 值得扫读
Proactive Memory for Event-Driven LLM Agents
作者:Jinyang Li 等 9 人,香港城市大学与腾讯。代码在匿名仓库
anonymous.4open.science/r/ProactMem-5351。研究问题与核心方法:事件流式 agent 要判断「这个事件值不值得现在打扰用户」。只给近期上下文或做相似检索,无法核实「反复出现的行为规律」今天是否还成立。ProactMem 分三层记忆:有界事件缓冲、经事实校验的时间轨迹、先在历史回放再匹配当前条件的行为规律;同一模型提议介入或弃权,控制器按服务身份去重。
关键结果:
- 摘要给的总体 F1 是 52.6%、相对最强基线 +21.4%,但表 2 只有分 scope 值,三个 scope 的算术均值 54.3、按事件加权 54.4,原文没有交代聚合口径。
- Home:effectiveness 58.6 对 A-MEM 42.9(+15.7pp)。Code:coverage 89.7 最高,但 intrusion 18.1 也高于 Mem0 的 5.3。Sports:effectiveness 48.8 对 Mem0 44.5,intrusion 46.1 为六法最低。
- 消融(同模型同决策设置):去掉回放门,Sports 的 relevance 35.8→31.1、effectiveness 48.8→42.7;去掉轨迹校验后为 34.4/47.5。
证据与局限:温度 0、关思考,单次确定性运行,无 seed 与区间。作者自述基准与方法是「共同开发后固定协议」且无独立 held-out——这是最弱的一格。10
与目标研究线的关系:A 线直接命中,长程 agent「该不该行动」的评测就看这套。
可迁移启发:主动型 agent 必须分开报 intrusion 与 coverage。只报 F1 会把「多说话」当成收益,本文 Code 一栏覆盖率最高、打扰率也偏高,正是这个陷阱。
站内摘要出入:站内写「F1 52.6%、较最优基线提升 21.4%」,字面与摘要一致,但没说 21.4% 是相对值、该总体数在表 2 里查不到、基准与方法同期开发。
5. 配对重放分清两种病:去掉「该不该用」的门掉 1.75 分,去掉验证掉 2.84 分 · arXiv:2610.36652 · 值得扫读
Remembering Is Not Enough: Refining Memories and Learning When to Use Them in Multi-Agent Systems
作者:Yipeng Hao 等 9 人,华东师范大学、中国海洋大学、同济大学等。代码
github.com/ECNU-ICALK/DiscernMem。研究问题与核心方法:团队攒下的经验规则,可能是规则本身有缺陷,也可能是规则没错却用错场合。只看团队成败分不出这两种病。DiscernMem 免训练:同一条记忆「注入 vs 不注入」做同任务同 seed 配对重放,用分数差判定是 scope 误用还是 content 缺陷;另有一个记忆账本记录每条规则的历史效果,学出各角色何时该用、何时该避。
关键结果:
- Qwen3-4B 上四个基准的无权重均值:三个多 agent 框架分别 59.03、56.93、59.67,对最强基线 ConMem 的 58.33/56.42/55.35,差 +0.70/+0.51/+4.32 分。
- 12 个框架×基准的组合里第一占 8 个;CAMEL/PDDL 37.71 对 28.48(+9.23pp)。
- 消融:PDDL 29.15 → 去账本 27.40(−1.75)→ 去配对验证 26.31(−2.84)→ 两者都去 25.36(−3.79)。
证据与局限:单骨干、温度 0、单遍、固定 seed,无多 seed 方差;基线取自原作者而非重跑。最弱一格是 CAMEL 上的 +0.51 分,无方差下与噪声不可分。11
与目标研究线的关系:A 线兼 B 线,直接命中——它把「经验的缺陷」与「经验的使用」拆成两个可分别验证的对象。
可迁移启发:「该不该用」值得单独学一个门。两个消融掉的分数不等价,说明修规则与管用法是两笔独立的收益。
站内摘要出入:站内写「在三个基准上较基线提升 0.51–4.32 分」;那三个是三个多 agent 框架,基准是四个数据集,0.51–4.32 是框架间四基准均值的差。
6. 最稀有优先在经典格 96.7%,全变体平均 64.0% 与随机 64.5% 打平 · arXiv:2610.37624 · 值得扫读
Rare, Relevant, and Still Wrong: How Memory Fails LLM Group Decisions
作者:Anouar Imel 等 4 人,电子科技大学、西安电子科技大学、南京航空航天大学、南京信息工程大学。未给代码。
研究问题与核心方法:一群 agent 讨论完要把讨论压成一小段记忆交给决策模型,该留哪些话。两条直觉是按稀有度留、按相关性留。CrossProfile 用 60 个模板各造 8 个持有关系变体、文本固定,共 480 个任务,答案键由结构推出并机器校验。
关键结果:
- 全变体平均:稀有优先 64.0% 对随机 64.5%(Qwen2.5-7B)、63.0% 对 63.4%(Llama-3.1-8B),只是打平。
- 经典 hidden-profile 格却是 96.7% [93.3, 99.4](Qwen2.5-7B)与 97.2% [93.9, 99.4](Llama-3.1-8B);换成相关性优先则 −22.2 与 −20.0 个百分点,即便用 oracle 相关性标签仍是 −23.3 与 −31.1。
- 去掉「多少 agent 说过」的持有者标签,经典格 +14.4(Qwen)与 +24.4(DeepSeek-V4.1-Flash,72.8→97.2)。
证据与局限:预注册分析计划、10,000 次模板 bootstrap、Holm 校正、三个 seed,纪律在本批最硬。最弱一格是外部效度:合成模板里的共享事实是「被指派」而非独立观察,自然讨论子集只有 65 题。12
与目标研究线的关系:A 线直接命中,落在多 agent 协作的记忆压缩与基准构造上。
可迁移启发:群记忆压缩先算「留下的证据在选项间的净领先」,再决定留哪条;记忆行不要带「多少 agent 说过」的归因标签,那一条单独值 14 到 24 个百分点。
站内摘要出入:站内说两种启发式「均失效」;原文稀有优先在经典格达 96.7%/97.2%,只是全变体平均与随机打平,相关性优先在预算策略里平均最高(72.6/74.6)。
7. 32 条事实写进冻结模型的 FFN:五模型召回 46.9%–75.0%,59 次失败里 44 次在存储端 · arXiv:2610.36948 · 值得扫读
Self-Keyed In-Parameter Memorization for External Memory-Free Dialogue Recall in Frozen Language Models
作者:XinYu Piao 等 4 人,高丽大学。未给自己的代码链接。
研究问题与核心方法:模型冻结、没有外部存储、也预先不知道将来会被问什么时,一段对话能否直接写进参数、之后从参数里答出来。SKIM 从每轮抽候选 span 当值,让模型就该轮自生成多个问题当键,再用带 ridge 的闭式最小二乘把整批键值一次写进某层 FFN 的降维投影;流式写入每个 chunk 都从原始权重重解,写入顺序不影响结果。
关键结果:
- 32 条事实写入后,五个模型的召回率 46.9%–75.0%(均值 63.1%),无缓存下限 3.1%–15.6%,KV cache 与 True-Q 约 90%–100%。
- 失败归因:5 个模型×32 条共 59 次失败,存储端 44 次(missing 22、selection 22),读取端 15 次,routing 0 次。
- 答案类型差别明显:专有名词 81.1%,描述性多词 36.9%。
证据与局限:32 条事实、单一数据集子集、单次运行未报 seed。这是可行性研究,最弱模型 46.9% 不到一半,「能召回」只在多数模型上成立。13
与目标研究线的关系:A 线在机制层面直接命中,评测规模只够做可行性验证。
可迁移启发:评估参数内记忆要把存储端(抽取与选择)与读取端(路由与解码)分开计错。本文 59 次失败里 44 次出在写入那一步,只报端到端召回率会把它误读成「读不出来」。
站内摘要出入:站内写「经评估可有效从参数中检索对话内容并回答问题」;原文是 32 条事实、五模型 46.9%–75.0% 的上限级验证,存储端失败占约四分之三。
8. 同等重放条数下,只比随机重放领先 0.36–0.58 个百分点 · arXiv:2610.36734 · 邻近跟踪
CAMR: Compatibility-Aware Memory Replay for Continual Learning in Large Language Models
作者:Jingpu Yang 等 6 人,北京中关村学院、东北大学、北京航空航天大学、中国人民大学。未给代码。
研究问题与核心方法:持续学习里新样本要不要监督、回放哪些历史样本,这两个问题被并成每次到达时的在线决策:按重放预算选 Add / Merge / Ignore。兼容性检查先筛出可回放的历史,记忆门压成表示,再结合掌握度给动作。
关键结果:
- WikiBigEdit 十万条:3K 时 Original Match 93.66%,十万时 92.94%;同期全历史重放(LoRA)3K 只有 50.92%,随机重放(全参)89.12%。
- 把重放条数对齐到同一预算(K=4/8/16、全参训练):对随机重放只领先 0.36–0.58 个百分点。
- TRACE 四项终值 56.75 / 69.84 / 67.92 / 95.40,随机重放全参为 50.50 / 66.45 / 67.80 / 95.35。
证据与局限:单骨干,无 seed 与方差。最弱一格是同预算下对随机重放领先不到 1 个点,93.66% 的功劳多半在「对手只有 50.92%」的那一栏。
与目标研究线的关系:A/B 线邻近。连接点在「哪些历史样本值得再进训练」,与 agent 记忆「检索哪些经验」同构;它的记忆是训练样本回放池、评测是闭卷事实更新,不涉及推理时外部记忆的读写与上下文分配,所以不算直接命中。14
可迁移启发:报重放预算必须同时给条数对齐的随机基线,否则这类数字读不出方法贡献。
站内摘要出入:站内说「在 WikiBigEdit 及四项 TRACE 任务中表现优于基线」;对最强全参随机重放只领先 0.05–6.25pp,ScienceQA 的 95.40 对 95.35 在无方差下不算优势。
二、长程执行:什么时候该停下来问人
这一节的五篇都在回答同一个问题的不同版本:一条长轨迹跑到一半,该继续、该重启、该交给人、还是该换手。
它们的共同发现是,决定这件事的那把尺子多数时候量错了东西。监控准确率、任务成功率、单笔成交,这些指标在论文自己的数据里都出现过「分数更好、决策更差」的格子。
9. 同菜单同成本下它的伤害率 7.02% 高于 Risk-Menu 的 5.82%,换到的是少三成人工审批 · arXiv:2610.36570 · 精读
CASEL: Consequence-Aware Selective Execution for Reliable Long-Horizon Tool-Using Agents
作者:Yanyan Zhang 等 4 人;卡内基梅隆大学、Feinity、达特茅斯学院与独立研究者。CBASE 2026,未给代码。
研究问题与核心方法:
工具型 agent 每一步都在改外部系统,但运行时防护多按「不确定性有多高」或「是不是写操作」分配审查力度。这篇问的是该花多少审查预算、花成哪一种形式,才能让「世界被改坏」的期望损失最小。工程对应物就是 MCP 代理或 pre-execution hook 该不该拦下这条调用。
CASEL 为每个提案调用估五个量:校准后的失败概率、状态相关后果、可逆性、意图歧义、证据陈旧度,再在六模式菜单上最小化「残留错误比例 × 失败概率 × 后果」加算力成本与人工审批成本。两处设计值得记:可逆性直接改写可行集(sandbox 只对可逆写开放,人工审批只对可补偿或不可逆动作开放);「直接执行」被形式化为选择性预测,配有限样本阈值与轨迹风险记账。15
关键结果:
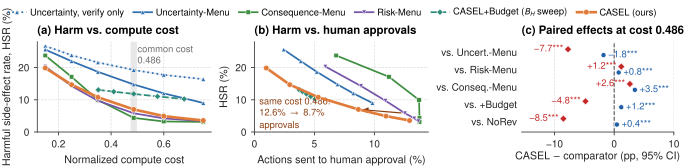
- 主结果(表 2,20 个 seed,每 seed 6,000 条 20 步轨迹):有害副作用轨迹率从不确定性门控的 14.75% 降到 7.02%,配对差 −7.73 个百分点,95% 区间 [−7.87, −7.60]。分母是轨迹,不是动作。
- 同一对照里它的任务成功率落后 1.79 个百分点(47.01% 对 48.79%)。
- 它并不是伤害最低的那个:同菜单同成本的 Risk-Menu 是 5.82%,Consequence-Menu 是 4.38%,都比 7.02% 低。CASEL 真正换到的是审批带宽——8.7% 的动作送人工审批,对比 12.6% 与 13.8%,约少三成。
- 可逆性路由贡献最大:去掉它(只留 verify),伤害率回到 15.53%。
- 一个可复现的负结果:加轨迹级累计风险预算反而更差,伤害率 11.82%,整条扫描线被支配;其引理前提在 54% 的直接执行步上就不成立。
证据与局限:
全部数字来自作者自建的模拟器,没有真实 agent 执行、没有真实验证器或回滚结果。干预有效性系数与各模式成本是假定常数,作者在摘要里就写明「assumed, not measured」。
有限样本阈值只在 ε≥0.014 时绑定(20 个 seed 全部绑定),更小的 ε 被 Hoeffding 松弛挡住,所以「有保证」的区间很窄。
最弱的一格是任务成功率列:CASEL 在这里输给不确定性门控 1.79 个百分点,正文只用一句「通用成功率把每个错误等同看待」带过,没有给按后果加权的成功率。所以「更好」只在伤害口径上成立。六模式里 abstain 与陈旧度分支从未被执行。15
与目标研究线的关系:A 线直接命中。它讨论的正是长程执行中「这一步要不要接管」的运行时决策与验收口径。
可迁移启发:拦截阈值按「失败概率 × 后果」排序而不是单看不确定性,同分母下选择性风险 AUC 从 0.01050 降到 0.00533。报这类门控必须把「送人工审批的动作比例」列为一等指标——本文唯一稳定的优势就在这里。轨迹级累计风险预算别做,这篇给了它在等成本下变差的可复现负结果。
站内摘要出入:站内说 CASEL「性能优于部分对比方法」;同菜单同成本下 Risk-Menu 与 Consequence-Menu 的伤害率更低,CASEL 换到的是少约三成审批量,并非全面占优。
10. 交接状态写好了反而更差:同一批任务只因把一条匹配计入判分,六个接收方里五个翻向 · arXiv:2610.36523 · 精读
Benchmarking Task Takeover Across Agent Handoffs
作者:Wenyuan Li 等 6 人,北海道大学与东京大学。投稿 WWW 2027,未给代码与数据。
研究问题与核心方法:
任务没做完就换模型接手时,接收方能否在别人已做出的判断、观测和动作之上继续往后推。这无法用任务成功率衡量(不区分「没拿到信息」与「不会用」),也无法用记忆保留率衡量(只测信息在不在、不测下一步动作)。
HSC-Bench 分两轨。仓库证据恢复轨 300 题,覆盖 38 个仓库、8 种语言,交接点固定在 10 组动作-观测之后,接收方预测文件与行区间,用 file-F1 与 line-F1 打分。状态依赖续作轨 739 题,分会话状态、工具状态、文件工作状态三类。交接上下文三档:近期转录、结构化状态(事实、承诺、已完成动作、剩余工作,token 逐题对齐)、全历史。3
关键结果:
- 证据恢复:结构化状态下 line-F1 为 0.189–0.263,近期转录为 0.031–0.147,六个接收方全部提升 0.114–0.162,仓库级 bootstrap 区间全在 0 以上。
- 证据滑出近期上下文时增益最大:217 题的增益 0.132–0.189;路径保留率上,结构化状态 93.0%、近期转录 12.6%。
- 续作轨均值(0–100 分,分母 739 题):结构化状态 GPT-5.4 92.76 分、全判据通过率 52.1%;Kimi 是反向个案,均值从 82.78 降 3.33 分,全判据通过的任务却多 67 个(+9.07 个百分点)。
- 但全历史更好:GPT-5.4 用全历史是 94.51 与 57.9%,结构化状态是 92.76 与 52.1%。
- 结论对判据极敏感:把工具观测里的订单状态匹配也纳入判分后,六个接收方里五个转负(Claude −9.88、DeepSeek −7.58、Qwen −6.09、Kimi −5.28、Gemini −3.92)。
- 信息到了不等于用上:19 道两档都保留「已完成地址更新」的题里,结构化状态 114 次续作有 2 次把更新又做一遍;从近期转录换到结构化状态,「报告已完成动作」判据 77.3%→87.3%,而「更新次数」判据 95.5%→95.3% 几乎不动。
证据与局限:
只研究单次交接,没有多次接力链;续作题是合成的,由 GPT-5.4 生成候选并自行筛选;文件工作类只要求产出进度报告、不许真改文件,测的是报告正确性。
六个接收方都是托管端点,无法复跑;历史由 GPT-5 生成、状态由 GPT-4.1 整理,模型偏好未被控制。
最弱的一格就是那张敏感性表:同一批任务、同一批模型,只因多算一条匹配判据,五个接收方的结论就翻向显著更差。均值层(+3 到 4 分)反而稳定。3
与目标研究线的关系:A 线直接命中,落在长程执行里「中途换手」这一环。
可迁移启发:评估交接表示时别把「信息到没到」当终点,93% 的路径保留率照样会漏掉「记录在、动作仍重复」这类失败,要加一步动作检查。判据上线前先做敏感性测试,均值与全通过率必须并列。仓库类任务用 file-F1 与 line-F1 双指标,分开「位置找对」与「行号给对」。
站内摘要出入:站内说结构化交接状态可提升接收方的证据恢复与继续执行;证据恢复是 6/6 全提升,续作只有 5/6,且全历史(94.51/57.9%)仍高于结构化状态(92.76/52.1%)。
11. 准确率恒为 90% 的一族监控器,重启收益在整张图上从 +50 跨到 −50 个百分点 · arXiv:2610.36544 · 精读
Monitor Accuracy Isn't the Answer: A Decision-Value Framework for Evaluating AI Agent Restart Monitors
作者:Siddharth Jain、Venkat N. Vedam,两人均属 Intuit。29 页、14 张表,未给代码直链(结语提到配套实现 RestartLab 但无地址)。
研究问题与核心方法:
监控器报警就杀掉轨迹重跑,这个决定该用什么评。论文主张准确率、真阳率、假阳率都不足以决定「重启是否提高成功率」,因为重启扔掉当前轨迹剩余的机会,只给替换尝试剩余预算。
它给了一个告警-动作价值恒等式:设继续到底的成功率为 q、干净重启在剩余预算内的成功率为 p、告警对失败的真阳率 τ、对成功的假阳率 φ,成功率变化 G=(1−q)τp−qφ(1−p),正收益门槛是 p>qφ/((1−q)τ+qφ)。再给两层落地:用决策充分性判据衡量粗表示相对细观测的价值损失;用同时二项区间做无模型审计,区间分离才输出重启或继续,否则弃权。2
关键结果:
- 解析结果不需要数据:q=0.5、τ=0.9、φ=0.1 时准确率恒为 90%,p=0 时 −5 个百分点,p=0.1 归零,p=0.8 时 +35 个百分点。
- 实测规模很小:SWE-bench Verified 里 19 个 SymPy 问题、两种模型、五阶段共 194 次执行。
- 最优截断不迁移:Luna 的最优截断在 16–20 次调用,任务宏平均 85.14% 对满额 30 次的 82.86%,差 +2.29 个百分点,bootstrap 正概率只有 0.504。同一个 16 次截断用到 DeepSeek,成功率从 68.57% 掉到 26.29%(−42.29 个百分点)。
- 审计结果:156 个「任务×时点」格里 103 个有实际尝试,103 个 live 比较里 0 个通过符号认证。
- 加长视界没救回:挑出四个在 30 次调用下 0/5 的任务,每个再跑 20 次、每次给到 60 次调用,只有 1 次在调用 17 通过,调用 31 到 60 之间没有任何首达(单侧 95% 上界 13.9%)。
证据与局限:
19 个题全来自 SymPy 单仓库,队列由试点、机械选择与难度富集三段拼成,作者明说合并率不能外推到 SWE-bench Verified 或一般负载。两模型只共享 7 题。审计是在看到结果之后设计的,作者自称探索性。
最弱的一格是那张完美告警列:它是 plug-in 诊断、不是机会上界。它也说明难度富集队列虽多失败,可恢复机会却近零——负结果来自被测干预选得不好,监控器本身没被判死刑。2
与目标研究线的关系:A 线直接命中,给的是「何时接管或重启」的验收口径,以及为什么准确率口径会误导。
可迁移启发:「监控器 + 重启」的评测必须同时报 q 与 p 和它们的分母,只报 90% 准确率等于什么都没说。上线前用同时二项区间做符号认证、允许弃权,比报点估计更接近可部署门槛。另外把「可观测的格式终止」与「时间截断」分开算预算,两者混在一起会把「修好协议」读成「会恢复」。
站内摘要出入:站内说该文「发现现有监控器的重启决策存在问题」;原文没有评测任何现成监控器,194 次执行只是 19 个题上的 agent 运行,103 个 live 比较全部未认证是保守程序的有限样本结果。
12. 180 天、20 台售货机:五个模型里四个跑不过规则基线,最强那个的 API 花费是对手的 80 倍 · arXiv:2610.36980 · 精读
AutoVend: Benchmarking LLM Agents on Long-Horizon Autonomous Vending Operations
作者:Qiming Shi、Yikun Li 等 8 人(共同一作前两位),StepFun、浙江大学、西交利物浦、FinStep。本文无 HTML 版,数据取自 PDF。
研究问题与核心方法:
O2O 场景里卖方的决策在网页上发出、却由昂贵的线下执行兑现。论文问 agent 能否把在线决策转成持续的经济回报,而不只是完成单笔交易。对应评估决策是:长程商业运营 agent 该用终局资产、单笔成交,还是扣除推理成本后的回报来判优劣。
一个 agent 管 20 台售货机,跨五类点位,共用一个仓库,跑 180 个模拟日,起始现金 4 万元,目录 1,372 个 SKU,18 个工具分远程运营、物理执行、持久记忆三类。模拟器用某商用售货公司 6 个月、99 台机器、22 万件销量的订单级记录拟合需求。约束较硬:批号 30 或 90 天过期,卖出过期品罚 1,000 元/件,上门补货 35 元/台/次。16
关键结果:
- 终局净资产(表 2):GPT-6.1 Sol 309.35 千元,是唯一超过规则基线 210.97 千元的模型;其余四个按高低是 GLM-5.3-Flash 148.43、DeepSeek V4.1 Flash 133.92、Claude Sonnet 5.5 103.04、Kimi K3 91.52 千元。十五次执行全部高于 4 万元起始资金。
- 稳定性差得厉害:Kimi 三次运行的变异系数 45.6%,GPT、GLM、Claude 都在 11% 左右,基线 1.1%。
- 两套排名不一致:GPT 的估算 API 花费约为 DeepSeek 的 80 倍,净资产增幅约 2.9 倍;按「每美元换来的净资产增量」排,DeepSeek 31,010 第一,GPT 只有 1,117。
- 选品全线输给规则基线:五个模型的 assortment 质量 0.500–0.992,全部低于基线的 1.034。
- 学习曲线是负的:比较第 16–45 天与第 136–165 天,五个模型的日均资产增长全部下降,15 次执行里 13 次下降。
证据与局限:
只有一个冻结世界加每模型 3 次运行,且三次运行共享同一随机种子,跨运行方差只来自 agent 决策,无法区分「模型不稳」与「环境抽样窄」。基线只报 seed 1。表 2 与正文的基线值本身就没对齐(210.97 对 208.73)。作者没有独立的局限小节,未报任何置信区间。
最弱的一格是净资产列:Kimi 的标准差 41.75 与均值 91.52 同量级,GLM 与 DeepSeek 只差 14.5 千元、小于各自标准差,中游三名排序在统计上站不住。相反「GPT 领先基线约 98 千元」与「四个模型低于基线」这两条是稳的。16
与目标研究线的关系:A 线直接命中。它把长期自主运营与「从反馈改写策略」整条链路做成可复跑基准,并提供环境侧诊断,而不只看终局分数。
可迁移启发:长程任务评测要同时报绝对回报与单位推理成本回报,本文两套排名完全不同,只报前者会奖励烧 token。采用「规则基线 + 冻结世界 + 多次运行」能压掉环境噪声,但标准差必须与均值并列。用「只重排现有资源」的受限最优对照算协调缺口,比自建理想策略更容易分开选品差与摆放差。
站内摘要出入:站内说「测试 5 个 LLM 智能体管理 20 台自动售货机」;原文是 5 个模型各跑 3 次、共 15 次执行,全部在同一冻结世界与同一随机种子下。
13. OSWorld 子集自愈率 54.8%(全样本 51.7%),而「部分恢复」的轨迹完成率 18.0% 低于「零恢复」的 20.6% · arXiv:2610.36471 · 值得扫读
When to Intervene? An Empirical Study of Errors and Self-Recovery in LLM Agents
作者:Chiming Duan 等 6 人。项目页
method-notes.github.io/ReCoF。研究问题与核心方法:agent 报错后,外部监控该立刻注入纠正,还是再等几步看它能否自愈。这决定人在环路的介入时机。作者先建 ReInBench:1,259 条轨迹、1,403 个错误事件,事件级标注错误起点、可被观测到的识别时点、是否自愈。再训一个预测器,只用错误发生前 5 步判断这次会不会自愈。
关键结果:
- 自愈 725/1,403:OSWorld 659/1,202(54.8%),网页任务 66/201(32.8%)。
- 中位恢复时长 2 步(OSWorld,n=600)与 3 步(网页,n=66)。同类错误配对 200 对中后错自愈 76.0%,异类 413 对 47.5%。
- 全恢复的 280 条轨迹完成率 60.0%,部分恢复 161 条只有 18.0%,零恢复 286 条 20.6%——部分恢复反而低于完全没恢复。
- 预测器 Macro-F1 73.53/74.18/72.99,比各自最强基线高 4.78/1.30/11.30 个百分点(238 个测试事件,5 个 seed)。
证据与局限:5 个 seed 只覆盖预测器与消融,Direct LLM 等基线是单次运行。最弱一格是只在 CUA 子集验证,网页那 201 个事件没进预测实验;而且「去掉专家模块」与 Direct LLM 输出逐位相同,这组消融其实没拆出专家。干预本身没有执行,只做了预测。17
与目标研究线的关系:A 线直接命中。它把评估单元从「任务成败」换成「错误事件」。
可迁移启发:用「错误发生前 5 步 → 是否自愈」做事件级标签、按模型分别校准阈值,可以直接给人工接管排优先级。「部分恢复比零恢复更差」这一格也提示:给 agent 一次半成功的纠正,可能比让它彻底失败更容易骗过验收。
站内摘要出入:站内说「实现 9.02% 的 Macro-F1 平均相对提升」;原文是三个模型各自相对增益(1.78%–18.32%)的未加权均值,且只在 CUA 子集 238 个测试事件上测得。
三、人在回路:同一模型换个交互条件就换一个分数
这五篇都在动同一个东西:模型之外的那一层——用户的压力、用户是否在场、记忆里存什么、harness 用哪一家、关键信息分给谁。
换掉这一层之后,分数就换一格,幅度从 5.1 到 22.9 个百分点不等。同一篇里还出现过另一种情形:两家 harness 的差只有 0.014,也足以改写名次。凡是只报一个条件的评测,都撑不住「这个 agent 会谈判」「这个 agent 会协作」这类结论。
14. 让步率从 ≤25% 到 96–100%:只报让步率会把「分不清对错」当成「很顺从」 · arXiv:2610.36453 · 值得扫读
Correction or Manipulation? Measuring Epistemic Vigilance in LLM Agents Under User Pressure
作者:Nardine Basta 等 4 人。代码链接是占位符(实测 404),等于未给。
研究问题与核心方法:用户唱反调时该不该让步。用户说错话时仍然放弃自己的原答案,这既可能是接受纠正,也可能是被操纵,得把「区分能力」与「倾向让步」分开。作者用信号检测理论:在答对的题集与答错的题集上施加同型同强度的五类压力,由命中率与虚报率算区分力 d′ 与判据 c。第二项研究让 agent 做客服,只允许在确认验证后改账号。
关键结果:
- 用户说错时仍放弃原答案(也就是被说服)的比例:GPT-6 的两个版本不超过 25%,Ministral 53%–81%,DeepSeek 55%–97%,Llama 96%–100%。
- 区分力:GPT-6 的 d′ 在 1.5–1.8、c 近零或为正;Ministral 与 DeepSeek 在每种压力下 d′ 都低于 0.9 且 c 为负。
- 伪造出处这条压力最有穿透力:5/7 个模型在 Holm 校正后 p≤0.005 上压低判据,DeepSeek 的 Δc 是 −0.93 [−1.23, −0.68],同时 4 个模型的区分力下降。
- 客服研究里,960 段对话都没有有效验证,多数模型一次也没执行「改账号」这个动作;Ministral 3B 在其中的 672 段里违规 58 次,45 次跟在「权威」型压力之后。
证据与局限:约 23,000 段对话,bootstrap 2,000 次按题重采样,缓解实验是同题重放配对。最弱一格是「影响力否认」的人工编码,三名编码员 κ=0.472,11.8% 的解释还答错了探针。18
与目标研究线的关系:A 线邻近偏直接,给的是一个可算的「该接受纠正还是该顶住」口径。
可迁移启发:评抗压时同时报 d′ 与 c。A/B 两集用同一条压力语句是对称设计的关键;只报让步率会把「分不清对错」与「很顺从」混成一个数。
站内摘要出入:站内把 7 个模型统称「智能体」;原文第一项研究是纯问答,只有第二项才是 agent,而且漏掉了主结论「只有 GPT-6 两档区分得好」。
15. 用户在场让收益平均 +13.7%,换成被动用户后增益归零 · arXiv:2610.36435 · 值得扫读
Your Agent Acts Differently When You're Around: How User Presence Changes Agent Behavior in Negotiation
作者:Jane Pan 等 5 人。代码
github.com/janepan9917/YourAgentActsDifferently。研究问题与核心方法:把用户真的放进环路(而不只是把他的偏好写进提示词),会不会改变替其谈判的 agent。PRESENT 把「用户在场」做成实验变量:无用户只给静态偏好;有用户配一个 LLM 用户,可开场协商、可被私下咨询、成交须其同意。另设两个消融——被动用户(只回「你决定」)与只在开场露面——用来把「在场」与「实质输入」分开。
关键结果:
- 7 局博弈 × 8 个模型 × 每格 100 条轨迹:有用户平均 +13.7%,但只在 5/7 局显著;分模型从 +9.6% 到 +19.0%,Claude Sonnet 5 只有 3 局提升、均值 +1.7%。
- 消融给出归因:被动用户 −0.3%,只在开场露面 +7.0%。增益来自实质信息,不来自「在场」。
- 行为改变:开场报价高 0.30 个标准差,让步小 0.37 个标准差,报价次数 5.0 对 2.9。
- 把用户的软偏好说成硬约束的比例从 2.92% 升到 17.35%。
- 失准行为指 agent 声称的偏好与用户真实偏好不符(对用户方向)、或误读对手立场(对家方向),两处都由判官标注。
证据与局限:控制谈判轮数后,对家方向的失准差距从 2.9 点降到 2.0 点,约三分之一由对话变长解释。最弱一格是失准行为全由单一判官模型标注,人评只覆盖 229 轮。19
与目标研究线的关系:A 线邻近,提醒把「用户在场」当自变量而不当评测背景。
可迁移启发:给自己的 agent 评测加一个「被动用户」对照,就能把在场效应与信息效应拆开。这个对照的成本很低,没有它,+13.7% 会被误读成「陪着你更好」。
站内摘要出入:站内写「用户在场使收益提升 13.7%」;原文只在 5/7 局显著,两局无显著效应,被动用户对照下增益直接归零(−0.3%)。
16. GUI 任务推进当监督:34.2% 对最强基线 29.1%,但记忆就在被评测的任务上在线累积 · arXiv:2610.37482 · 值得扫读
From Interaction to Capability: Task Advancement as State and Supervision for GUI Agents
作者:Ziyang Chen、Qian Li、Chengwei Qin 三人。未给代码。
研究问题与核心方法:GUI agent 的记忆该存什么。存动作序列会随界面改版失效,存最终成败又给不出中间信号。TAM 把「已验证的任务推进」当记忆单元:任务开始时把指令编译成需求图,运行中只把剩余任务与推进前沿交给动作模型,任务结束后把产生局部结果的交互抽象成可复用的推进算子。
关键结果:
- MobileWorld(Qwen3-VL-32B,50 轮上限):34.2%,比最强基线 29.1% 高 5.1 个百分点,比无记忆底座 12.0% 高 22.2 个百分点。
- 消融:只给推进状态 12.0%→28.2%;加证据缓存 29.1%;加算子图 32.5%;全量 34.2%。
- 成本:0.771M token/题,比 ConAct 的 1.257M 低 38.7%;但 AWM 只要 0.720M,代价是成功率只有 13.7%。
- 机制:62 道多应用题上 32.3% 对 24.2%,单应用只高 1.8 个百分点。
证据与局限:最弱一格是没有留出集——记忆就在被评测的任务序列上在线累积,「边学边测」与迁移分不开。全部结果无显著性检验、无置信区间,只报两次运行的标准差;117 题里某个应用组只有 14 题。20
与目标研究线的关系:A 线邻近偏直接,给「长程任务的状态表示」一个可与其他记忆方案对照的口径。
可迁移启发:用「局部结果已被验证」当监督信号,可以从失败轨迹里回收可用片段——附录报 74.8% 的含局部正确结果的失败执行能产出可留材料。这条对训练数据构造比评测口径更直接。
站内摘要出入:站内说两个基准都「显著提升了成功率并减少生命周期令牌数」;成本只在 MobileWorld 上测,全篇没有显著性检验,17.6% 是对 29.1% 的相对增益(绝对 +5.1 个百分点)。
17. 同一个廉价模型换两家实验室的 harness:0.542 与 0.528,另两家整包交白卷 · arXiv:2610.36405 · 值得扫读
kw-bench: Breaking Frontier Harnesses on Real-World Tasks
作者:George Juraj Salapa(单作者),G.S. s.r.o / PwC Austria。代码与任务已开源。
研究问题与核心方法:把「答案已存在、埋在跨三代系统的残缺证据里、要精确到分」的调查型工作变成任务后,编码 agent 的 harness 能走多远。对应决策是:长程任务卡住时先换模型还是先改 harness。
任务是一个五年增值税重建:1,432 条链、3,084 张凭证、83 个文件、62 MB,带重复页眉、德式数字、部分迁移日志与手打链 ID,另植四个错误机制与 717 份假链陷阱。评分确定性,没有 LLM 判官,七项加权。
关键结果:
- 固定同一个廉价模型、四个 harness:OpenCode 0.542、自研 micro-cc 0.528、Codex 0.00、Claude Code 0.00,各跑 1 次。前两者差 0.014 在噪声内,后两者是整包未交付。
- 换上更强的模型之后,两家 harness 都能交付:micro-cc 配强模型 0.9986、22 分钟、5.80 美元;Claude Code 配自家模型 1.000、24.6 分钟,两者都报出了欧元金额真值。可见 0.00 那两家是配置不适配,换模型能救。
- 标尺:完美 oracle 1.00,纯文件装入正确内容 0.88,忽略三代系统差异 0.45,直接相信已申报 0.27。
证据与局限:单任务单变体、每 harness 1 次运行,作者自认 0.014 不可分辨;只测两个模型;数据全合成、税规简化。最弱一格是两家实验室 harness 的 0.00——没有重复运行,分不清「配置不适配」与「通用缺陷」。21
与目标研究线的关系:A 线直接命中,也给 B 线提供 harness 自进化的评测口径。它把「同模型、只换 harness」做成了受控对照。
可迁移启发:以交付物为评分单位、整份全有或全无,可以把「分析对了但没落盘」清零。陷阱加假阳性扣分比正例更能区分 harness。
站内摘要出入:站内说「前沿模型搭配特定工具链可快速完成耗时数周的任务」;同一廉价模型下两家实验室 harness 都是 0.00,且结果只来自 1 个变体、每 harness 1 次。
18. 信息分给团队后掉 22.9 个百分点,给出原文再掉 19.9 个百分点 · arXiv:2610.37571 · 邻近跟踪
TeamGym: A Gym for Team Decision-Making by AI Agents with Distributed Information
作者:Chanwoo Park 等 7 人,MIT、KAIST 等。代码「即将发布」。
研究问题与核心方法:关键事实分散到多人手上时,模型当「团队成员」会损失多少;单 agent 的分数能否预测团队分数。作者从 12 个真实语料造题,先用「联合充分、留一即不可解」筛出最小事实集,再控制分发方式与发言结构,三个条件共用同一事实集与评分器。
关键结果:
- 三个条件依次是:单个 agent 拿到全部信息 63.4%、信息分给团队 40.5%、分给团队但附上原文 20.6%。第一段差 22.9 个百分点(沟通差距),第二段再差 19.9 个百分点(检索差距)。
- 联合训练双策略:36 道验证题上判官分 11.97%→22.38%,协调者问遍全体的比例 80.6%→100%。
- 迁移到留出语料只搬走了行为:26 道题问遍全体 20/26→26/26,判官分只 5.12%→5.58%。
证据与局限:误差棒是标准误,原文未报每题重复次数;训练各 1 次;增益量在选型集上。最弱一格是「训练提升决策质量」只在选型集成立。
与目标研究线的关系:邻近 B 线,落在团队沟通策略的训练上,不是单 agent 的轨迹复用。连接点在「奖励只看最终决策,却涌现出参与率与选人变化」。22
可迁移启发:把信息分布当可控变量,同题三条件对照才可归因;只报团队总分会把沟通损失与检索损失混成一项。
站内摘要出入:站内说「训练可提升决策质量并实现涌现协调」;增益来自选型集,留出语料上只搬走了协调行为(5.12%→5.58%)。
四、自进化:改哪一层,增益经不经得起重放
今天这一族有八篇,其中三篇动的是同一个回路(GEPA 家族)的三个不同位置,正好可以并排看。
一篇改数据入口:哪些任务、哪条成功轨迹进入优化器,优化算子不动。一篇改搜索结构:把一个优化步变宽成并行评测,接受规则不动。第三篇什么都不改,只装一套审计,问 dev 上的增益能不能被「纯选择」复现。
三篇的评测集互不相同;唯一名字相同的是 τ-bench(被压平成单轮)与 τ³-bench(另一套题),两者不能横比。但它们合起来给出了一个共同答案:报出来的 Δ 里,有一半可以从基线怎么取、每格跑几次、候选怎么挑里解释掉。
19. 先筛任务再反思:held-out 上 82.1 对 78.7,成本 1.31 倍;摘要的 20.7% 在任何一张表里都找不到 · arXiv:2610.37651 · 精读
GEPA-Curator: Curated Learning for Self Improving Agents
作者:Zack Yu、Nicholas Lee 等 11 人(前两位共同一作),UC Berkeley、ICSI、LBNL、Furiosa AI、KAIST。未给代码。
研究问题与核心方法:
反思式提示优化器把每一步失败的轨迹都当学习信号,但在 agent 场景里失败也可能来自 harness 缺工具、环境抖动、判官噪声或任务本身不可解。问题是:优化器该无条件吞下所有任务的经验,还是先决定哪些经验值得学。
GEPA-Curator 不改优化器,在外层加一个策展 agent。它做两件事:为下一个批次挑能给出干净信号的任务,跳过三类(反复稳定成功、反复失败但原因在 harness 或环境、相似行为反复得到不一致评判);再给当前失败任务配一条历史上可信的成功轨迹,让反思做对比而不是凭空猜病因。两个动作合并成一次调用,检索不额外增加成本。5
关键结果:
- WebArena 四站(每站独立 3:1:1 切分,每站每方法 5,000 条 rollout):Gemini 3.1 Pro 作优化器时 held-out 成功率 72.4(seed)→78.7(GEPA)→82.1(Curator);Claude Opus 5 时 73.1→79.5→84.5。相对 GEPA 的聚合差 +3.4 与 +5.0 点,单站最大 +7.4。
- 附加 agent 基准:Gemini 下 AppWorld Test-C 27.8→46.2,是绝对差最大的一格(+18.4 点)。
- 并非全面领先:Opus 下 τ-bench 82.9 对 82.9,作者自己写「match」。
- 消融(GitLab 200 题验证集):seed 78.2、GEPA 82.8、只做任务策展 84.2、只做成功检索 84.7、两者合用 88.6。
- 训练池里 1,581 个任务有 75 个(4.7%)至少一次被判为不可解或抖动,其中抖动诊断共 65 次。
- 成本(效率版配置):WebArena 四站 GEPA 594.05 美元(78.7)对 Curator 776.88 美元(82.3),1.31 倍。这里的 82.3 与前面主表的 82.1 是同方法的不同配置,别混着记。
- 反例:附录的 QA 套件几乎打平,HotpotQA 还比 GEPA 低 1.3 点(66.3→65.0)。
证据与局限:
「5 次重复」的含义要看仔细。正文说评测数字是 5 次重复的平均,消融处说是对验证集做 5 次重复,附录说是对 30 题测试集做 5 次评测——也就是说这 5 次是同一个优化后提示的重复评测,不包含「这个优化回路重跑一遍会落到哪」的方差。
τ-bench 被改成无用户交互版本,测试集只剩 35 题,不能与其他论文的 τ-bench 数字横比。全文没有局限小节。
最弱的一格就是摘要那句「最高 20.7% 超过 GEPA、21.2% 超过 ACE」:20.7 在任何一张表里都定位不到,21.2 只能对上 Opus 下 τ-bench 对 ACE 的 82.9 对 61.7。5
与目标研究线的关系:B 线直接命中。它把「自进化该改哪一层」的答案放在数据入口,因此可以套在现有优化器外面而不重训任何东西。
可迁移启发:上线任何提示或技能自进化回路前,先统计训练池里抖动与不可解任务的占比(本文 4.7%),并把「反复稳定成功」的任务降权——这比增加反思调用便宜得多。评测侧则要盯住「每提示 5 次评测」这个做法,它才把评测噪声压到能看出 3 点级差异。
站内摘要出入:站内写「较 GEPA、ACE 有最高 20.7%、21.2% 的提升」;原文口径是「达到或超过均值」,20.7 无法定位,21.2 只对应一格,HotpotQA 还低 1.3 点。
20. 把一步变宽:测试分 68.9→72.1 与 49.0→60.0,但每格只跑一次、且是在扫描里取最大 · arXiv:2610.36774 · 精读
Batching the Reflective Optimization Loop: Parallel Proposals Make GEPA Faster and Better
作者:Jialin Zhang、Lakshya A Agrawal 等 9 人(前四位同等贡献),UC Berkeley。NeurIPS 2026 资源受限 agent 研讨会,代码在
github.com/gepa-ai/gepa。研究问题与核心方法:
反思式优化回路本身是资源密集型负载,串行结构让并行评测能力闲置:每一步都要等一个提议跑完评测。问题是,在固定的指标调用预算下,把单个优化步变宽能否同时降低墙钟时间并提高 held-out 分数。对使用者的对应决策是:手里的预算拿去跑更多步,还是把每步跑得更宽。
做法是把一步从「采一个父本、提一个变异、评测、过关再上全量验证」改成 P×N 采样:从前沿采 P 个父本,每个抽 N 个小批次并各提一个变异,并发评测、并发反思、并发筛选,最后一次性更新前沿。理论依据是「承诺」——一步之内不与验证集反复交互,避免反复调参把验证集抬高。23
关键结果:
- LiveBench-Math(100 训练/100 验证/168 测试,5,000 次指标调用):单变异 held-out 68.9%,2×2 达 72.1%(+3.2 点)。
- HoVer(200/150/200,3,000 次调用):单变异 49.0%,8×1 达 60.0%(+11.0 点),2×4 为 55.0%。
- 加速要分口径:16 路并行下墙钟约 3–4 倍;但同一段给的 2×2 算例是迭代数 219→45(4.9 倍),触发全量验证的迭代比例 17%→53%,净加速只有 1.9 倍(7.7→4.1 小时)。
- 验证分与测试分之间的落差是这条设计的直接证据:LiveBench-Math 上单变异的验证分更高、测试分更低,落差 9 点,2×4 只有 2 点。
- 宽与深谁更值钱取决于任务:最优格子分别是 2×2 与 8×1。
证据与局限:
每个设置只跑一次。全文没有 seed、重复次数、误差区间或显著性检验;68.9→72.1 与 49.0→60.0 都是同预算下的单次读数,而且是从约 8 个格子的宽度扫描里在测试集上取最大——这正是本文自己引用的赢家诅咒文献所警告的做法,作者没有对自家表格做这项校正。
只有两个任务,每个只优化一件很窄的东西。HoVer 只用了三跳子集,且 60.0% 的口径是「三条金标页全部被检索到」,与优化时的 top-5 召回不是同一个指标。
最弱的一格是抽象里那句加速:摘要写「大多数 run 在一半以内、最快到四分之一到三分之一」,正文的 2×2 算例却是 1.9 倍,三处口径要分开读。23
与目标研究线的关系:B 线直接命中,而且它是这一族里唯一把「自进化的算力账」当研究对象的。它改的是回路的执行结构,不是被优化的工件。
可迁移启发:固定预算时先把并发拉满、再把每步变宽,同时记录「触发全量验证的迭代比例」——本文这个比例从 17% 涨到 53%,把 4.9 倍的迭代缩减吃成了 1.9 倍的净加速,这是调度时最该盯的一个量。报自进化结果时给出验证到测试的落差,它能解释「验证分更高、测试更低」这种反常。
站内摘要出入:站内说「大幅缩短耗时并提升测试分数、同时优化预算使用效率」;原文限定在两个任务的宽度扫描、每格单次运行,3–4 倍加速只在 16 路并行下成立,正文自己的算例是 1.9 倍。
21. 16 个学到的技能平均只比手写基线高 0.1 点,而 dev 增益有一半能被「纯选择」复现 · arXiv:2610.37201 · 精读
Does Your Generalist Skill Optimizer Really Incentivize Agentic Tasks? Rethinking Skill Optimization via Bipartite Attribution
作者:Jiawei Zhou 等 7 人,上海人工智能实验室、复旦、上海交大、中科大、清华。代码
github.com/valleysprings/BiPA。研究问题与核心方法:
技能优化器每轮重写注入给 agent 的自然语言「技能」,留下让 dev 成功率变高的编辑。两个问题:dev 增益能否证明技能更好,代价从哪来。
BiPA 不改优化器,只做两件测量。第一是选择回放:把接受规则套在「与种子完全相同的候选」上重放,得到「纯选择」本身能报出的增益,再看实报增益不超过它的概率有多大。第二是二分图归因:把每轮读到的上下文组件记成图,把输入 token 精确分摊到组件,再用轮次弹性把 token 变化拆成四项。4
关键结果:
- 16 个学到的技能,测试集上平均只比手写种子高 0.1 点;DeepSeek 的 9 个平均 −1.4 点(−11.1 到 +2.7),单侧 95% 上界 +0.6;Luna 的 7 个平均 +1.6 点。
- dev 增益能被纯选择复现:候选完全不变时重放仍能达到实报增益的概率,两个优化器为 0.56–0.94,另一个为 0.25/0.87/0.88。机制是每个 run 都从种子最低分的那次 dev run 起算,并在不超过 30 题的 dev 集上取 4–8 个候选的最好者。
- 代价跟着来:9 个技能的输入 token 是种子的 1.08–1.43 倍(均值 1.18),轮数 1.03–1.22 倍。
- 分解:token 增量 73% 来自多出的轮次、21% 来自技能文本;每多 10% 轮次多读 14%–16% token。
- 换模型不迁移:另一模型重跑 9 个技能只有 1 个高于种子(+1.9 点)。
- 编辑行为:59 个能定位父本的编辑里 58 个把技能变长;337 条新增规则里没有一条要求「少读」。
证据与局限:
结论对基线取法有依赖,作者自陈:若把种子起始分改成从任务模型随机抽,重放平均增益只有 0.6–2.3 题。也就是说「选择本身就能造出这些增益」有一半来自优化器把起点定在种子最差的那次 dev run——这既是它的真实缺陷,也是本文口径的选择。
16 个技能里 2 个根本没改动,仍按 16 个报平均,读的时候要换分母。重放结论还依赖难度先验与「给定难度后 episode 独立」两个假设。
最弱的一格是作者自陈的那条:把种子起始分改成从任务模型随机抽之后,τ³-bench 上的实报增益「不太可能」出现(P 0.02–0.17),主结论因此要从「技能没用」缩到「在这些 run 的记录方式下无法区分」。4
与目标研究线的关系:B 线直接命中,而且是这一族唯一做审计而非改进的一篇。它给的是可以架在任何优化器外面的度量:选择回放加二分图归因。
可迁移启发:任何「用不超过 30 题 dev 集挑最好候选」的回路,上线前先跑一次「全候选不变」的重放,把概率写进报告,否则 Δ 与噪声无法区分。成本按新增轮次计费而不是按技能文本长度——本文里技能文本只解释 21% 的 token 增量,其余主要来自轮次变多。若目标是扩展能力而非打磨已解任务,把选优目标从成功率换成覆盖率。
站内摘要出入:站内说「开发集增益在测试集消失」,方向对,但抹掉了两处限定:总结论是「与手写种子持平(16 个平均 +0.1 点)」,且作者自陈随机取基线后 τ³-bench 的增益「不太可能」,这一条站内完全没有。
22. 判分准则也得一起演化:冻结准则 44.4 比完全没有准则的 45.8 还低 · arXiv:2610.36826 · 值得扫读
When the Critic Falls Behind: Co-Evolving Rubrics and Harnesses for Continual Agent Self-Improvement
作者:Hao Chen 等 10 人,哈工大与清华。未给代码。
研究问题与核心方法:harness 能不改参数地自演化,但指导演化的准则通常一次写死。旧失败消掉、新失败冒出来后,静态准则还指得准吗。作者让失败轨迹抽出行为准则,过检查后进入四态生命周期,按随时间变化的诊断效用排序取前十作「准则前沿」;harness 表示为六个坐标,每轮至多三个候选、各改至多三坐标,验证集提升超过阈值才提交。
关键结果:
- 五域 Pass@1 宏平均:held-out 53.7 对最强基线 49.2(+4.5 点),held-in 62.4 对 60.7(+1.7);另一个骨干 held-out 38.0 对 32.7(+5.3)。
- 消融(仅一个骨干):去掉准则模块 held-out 45.8,冻结初始准则 44.4——比完全没有准则还低 1.4 点;用整池代替前十前沿 49.0,完整 53.7。
- 三 seed 只覆盖两个域:知识工作 held-out 50.0±2.0 对基线 47.3±3.1;软件工程 51.9±1.6 对 45.4±3.2。
证据与局限:演化、验证、测试三划分固定且测试集不参与候选选择,这点干净。只有两个骨干。除两个设置外没有重复 run。正文没给演化轮数。最弱一格正是那条消融——「静态准则比没准则更差」只由单骨干、无 seed 的一格支撑。24
与目标研究线的关系:B 线直接命中,被演化的是诊断信号本身。
可迁移启发:自改进实验必须有「冻结诊断器」这一档。本文里它 44.4 分,比完全没有准则的 45.8 还低 1.4 点——这个对照成本很低,却能说明涨的是诊断质量还是改动量。
站内摘要出入:站内只说优于基线、提升未见任务的泛化,没给量级,也漏掉「冻结准则比不用准则低 1.4 点」。
23. 种群当诊断证据源:SWE-bench 52.0→72.1,总 token 反而降 36% · arXiv:2610.36660 · 值得扫读
The View from Nowhere: Population-Centered Agent Evolution
作者:Shuo Yan 等 5 人,麦考瑞大学与莫纳什大学。代码
github.com/YanShuo1992/PCE。研究问题与核心方法:进化种群常出现「集体解得出、最强个体解不出」,那么覆盖差能否当诊断信号,而不只是选父代的池子。PCE 把种群分成「可作证据的」与「可作父代的」两组,对父代待诊断的题先统计全部变体的结果分布,再由蒸馏 agent 比较成功与失败变体的日志、补丁与自我修改史,产出三字段的诊断块,最后回查父代源码提一处改动。
关键结果:
- 同模型、同初始 harness、同日程,10 代×2 子代:SWE-bench 200 题 52.0→68.9(基线)→72.1(+3.2 点);Polyglot 225 题 65.1→90.8→96.7(+5.9 点)。
- 覆盖差:SWE-bench 上 14.2±1.2 降到 10.0±0.0;Polyglot 从 10.0 到 0.0。
- 消融(Polyglot,另一套评测口径,与主表的 96.7 不是同一列):仅父代蒸馏 92.0±4.3,完整 96.0±2.8;五次评测全部答对的交集为 85.0/78.3/88.3。
- 成本:总 token SWE 2.98B→1.92B(−36%)、Polyglot 0.99B→0.41B(−59%),评测 episode 反而更多。
证据与局限:SWE-bench 2 次运行,Polyglot 只 1 次;表 1 里几个对照是引文数字,不是受控重跑;诊断探针只有 3 个上下文且提案未实现。最弱一格是 Polyglot 的 +5.9 与「差距归零」,都压在一次运行上。25
与目标研究线的关系:B 线直接命中。它把种群从「选父代的池子」改成「诊断证据源」,等于换掉自进化的输入。
可迁移启发:同时报并集与最佳个体两个数,两者之差是免费的诊断指标。加一个「仅父代蒸馏」的等算力对照,才能证明涨的是种群证据而不是多花了算力。
站内摘要出入:站内只说较基线提升并缩小差距;基线是另一套进化方法,差距只在进化搜索集上量,Polyglot 是单次运行且差距归零。
24. 让团队自己重组:同类系统同预算下 0.721 对 0.448,两次都走到更难的指令集 · arXiv:2610.36848 · 值得扫读
Evolving Agent Teams
作者:Shiyi Cao 等 5 人,UC Berkeley。代码
github.com/caoshiyi/EAT。研究问题与核心方法:强编码 agent 在 GPU 内核优化上快速起步后卡在局部最优,典型是放弃难写对的指令、退回好写的。问题不在模型,而在团队结构开跑前就固定死了。作者让一个监督者监控执行、诊断平台期的结构原因(漂向简单路径、跨 agent 洞察丢失、陷在调式、过度微调),再沿角色、协调、知识管理三轴重设团队。
关键结果:
- H100 上 47 个生产工作负载:同 800 美元预算、各 2 次,0.721× 与 0.685×;对照的内核专用系统为 0.602×/0.598× 与 0.448×/0.283×。
- 两次运行都走到了更难的指令集实现(2/2),对照没有。
- 消融:固定四角色队 0.31×,另一强基线(Codex,GPT-5.5 xhigh)0.28×,允许重组 0.74×——同模型下只打开「能否重组」就差 0.43×。这里所有倍数都以生产库实现为 1.0。
- 跨任务:另一内核 21 个版本 2.2×→4.06×;held-out 42 任务 62.1 对榜单 55.3。
证据与局限:主设置各跑 2 次取最好,作者自述不足以支撑统计结论;跨域那节全是单次、无 seed 且换了模型。受控预算上限在正文没给,只出现在图 3 横轴。最弱一格就是跨域那节。26
与目标研究线的关系:B 线直接命中,被演化的是组织拓扑与协调协议。
可迁移启发:比较方法时画预算—性能曲线,看强者多花预算是否还在涨。「两次取最好」换成中位数,否则团队结构这类高方差干预会被系统性高估。
站内摘要出入:站内只说性能优于现有基线,抹掉了两次取最好、跨域那节只有单次运行,也没提受控预算上限正文未给。
25. 定位到弱点之后还要认状态:混着已有知识一起干预,两集平均高 18.41 点 · arXiv:2610.36811 · 值得扫读
Weakness Localization Is Not Enough: State-Aware Recursive Knowledge Improvement for Large Language Models
作者:Runze Jiang 等 5 人,北京大学、阿里巴巴、代尔夫特理工。未给代码。
研究问题与核心方法:同一个弱点可能对应「没有」「有但取不出」「取出但用不上」三种状态,该配不同干预,所以光提高定位分辨率选不出干预。作者把知识组织成图结构单元,诊断与干预共享同一套单元,每轮依次定位弱点、估六维知识状态、按状态选干预、更新后重估。
关键结果:
- 状态别名证据:召回失败的实例里,37.8% 仍能答对识别探针,62.2% 连识别也失败。
- 主表(判官打分 0–100):HotpotEval 32.70 对最强基线 26.80(+5.90,n=1000);自建内部集 58.92 对 28.00(+30.92,n=600);两集平均 45.81 对 27.40(+18.41)。
- 消融:完整 58.92 > 只用同一套弱点定位、多一档状态条件 53.75(+5.17)> 把全部语料一次性直训 50.50 > 固定干预配比 48.00 > 状态只估一次再冻结 39.00。
- 递归重估有效:完全召回的单元从 12.2% 升到 40.9%,总分四个阶段 17.41→31.50→51.03→58.92。
证据与局限:单骨干、判官打分、无 seed 与区间。最弱一格是 +30.92 那一栏:自建中文企业集上六个基线集体塌到 9.75–28.00,更像基线不适配语料;真实增益应看 HotpotEval 的 +5.90。27
与目标研究线的关系:B 线直接命中,参数内化被写成闭环而非一次性数据管线。
可迁移启发:「冻结状态」这一档必须抄——估一次就复用,常常比不用状态更差(39.00 对 50.50)。同一批失败样本同时测识别与召回,才能把「有知识」与「取不出」分开。
站内摘要出入:站内写「在 HotpotEval 等数据集上平均提升 18.41 个百分点」;该数是两集平均分之差,HotpotEval 本身只 +5.90,增量绝大部分来自自建内部集。
26. 世界生成与 harness 演化一起放开:训练集 39.06→73.16,未见基准 37.45→63.61 · arXiv:2610.36077 · 值得扫读
The Trinity: Capability-Driven Recursive Self-Improvement for Multimodal Agents
作者:Weidong Tang 等 21 人(署名 The Trinity Research Team),InfRec、西电、同济、新加坡国立等。代码与项目页均已给。
研究问题与核心方法:把「造环境」与「改 harness」接成闭环后,能力能否跨模态累积。三个角色分工:一个用已验证轨迹把任务树重组成层级能力树,一个对同节点异质任务抽共同要求、生成可验证的简化模拟世界,一个沿树选择性继承、逐代演化能力模块。底座冻结,只改 harness。
关键结果:
- 28 个训练基准的均值 39.06→73.16(+34.1 分),18 个未见基准 37.45→63.61(+26.2 分)。
- 组织方式对比(只加模块、不加技能):全局 53.04/42.92、按任务域 51.17/40.82、按能力域 49.25/39.43、能力树(真实)53.44/42.31、(模拟)56.95/47.26。
- 路由:随机 52.74/46.23、完整自路由 71.27/60.96、oracle 73.16/63.61。
证据与局限:44 个基准,很多分母很小(不少只有 3 个实例、9 个 episode);无置信区间与显著性检验;增益里含「评测期技能」——每个基准—harness 对先跑 5 次准备试次再冻结,不是纯 harness 进化。最弱一格是自路由与 oracle 的 1.9 与 2.7 分差,没有重复运行。28
与目标研究线的关系:B 线直接命中(多模态侧)。对 A 线的意义是能力分层可以减少跨任务负迁移。
可迁移启发:用「留一即不可解」定义能力单元再分树,可以直接搬进 harness 进化流水线。评测期技能与 harness 改动必须分开报,否则分不清涨在哪。
站内摘要出入:站内说「在训练与未见基准上均取得显著提升」;原文是 0–100 归一化后的基准等权均值、含 5 次准备试次得到的技能,且无显著性检验,多个基准只有 9 到 45 个 episode。
五、判分与验证:把「对不对」换成可执行的检验
这一节的八篇分两组。
前一组在换判分器:用小模型替代大模型当判官,把问题写成可执行代码,从专家报告里挖规则,把评分当离散臂选择。后一组在查「分数到底在测什么」:置信度打分的长度依赖、只留答对样本的选择偏差、规划效率的三层分解、以及自由探索里「猜对」与「有证据」的分离。
两组指向同一件事:判分器的成本与可靠性正在成为自动评测流水线的瓶颈;而一个分数是否可信,要看它旁边有没有配两个对照——链长基线配去长度残差,全体分配合筛后分。
27. 置信度打分与链长的秩相关 −0.53,去长度后掉到随机水平 0.486 · arXiv:2610.36709 · 精读
Is Token Confidence Just Chain Length? A Signal-Processing Audit of Reasoning Traces
作者:Pragna Mallappa(单作者),Keshav Memorial Institute of Technology。未给代码与数据。
研究问题与核心方法:
「按 2048 token 滑窗平均 token 置信度、取最小值给整条链打分」这类做法,到底测的是「这条链更可能对」,还是「这条链更长」。对应到手上的决策很具体:自洽投票里要不要按置信度丢链、要不要按置信度早停。
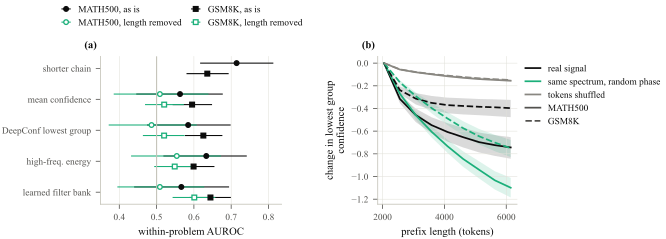
作者把一条链的 token 置信度序列当离散时间信号:滑窗均值是低通滤波,取最小是检测器,于是这套启发式被拆成「滤波器 + 检测器」两个可测部件。再用两类代理信号(打乱 token 破坏谱、随机化傅里叶相位保留谱)把谱与取最小值的贡献分开,并额外报一个「去长度」的 AUROC:题内先减均值,跨题拟合链长的单一斜率,再对残差算 AUROC。29
关键结果:
- 谱形接近 1/f,方差主要在慢漂移;错误链的斜率比正确链浅 0.041(95% 区间 0.018–0.064,MATH500)与 0.020(0.007–0.032,GSM8K)。
- 链长基线就能打平甚至打赢:MATH500 上「更短链」的题内 AUROC 是 0.715,DeepConf 是 0.585,差 0.130(区间 0.019–0.257);GSM8K 上 0.636 对 0.625,平手。
- 去长度之后,DeepConf 的最低组置信度掉到 0.486 与 0.520,也就是随机水平;而无拟合权重的高频能量检测器仍留 0.554 与 0.549。
- 依赖来自「取最小」这个运算:题内最低组置信度与链长的秩相关是 −0.53 与 −0.75,正确链内部也有 −0.50,而平均置信度只有 −0.08。
- 链内安慰剂:前缀从 2,048 增到 6,144 token 时分数下降 0.74 与 0.40;打乱 token 后只降 0.15;保留谱、随机化相位后降 1.10 与 0.75——谱本身就能解释这个下降。
- 早停没有明显收益:花一半成本时「少采链」得 90.0%,最好的检测器 88.4%。
证据与局限:
8,000 条链(两基准各取前 200 与 300 题、每题 16 条),单模型(DeepSeek-R1-Distill-Qwen-1.5B),约 2,200 万 token,单卡。混合题只有 31 道与 96 道,MATH500 的区间因此很宽。
最弱的一格是「更短窗口更好」那条:MATH500 上增益 0.100,区间 0.003–0.213,下界贴着 0,在 GSM8K 完全消失,作者也承认两个基准结论不一致。正文说滤波器组用 8 个频带、图注写 10 个,两者没对齐。早停只是对已完成链做的模拟,省下的是 token 而非墙钟。29
与目标研究线的关系:A 线直接命中(评测口径)。它把「置信度类打分」必须配的两个对照写成了可执行标准。
可迁移启发:任何链级分数(token 置信度、熵、自评、过程奖励)都要同时报链长基线与去长度 AUROC,否则长度效应会被当成质量信号。用同一条链的前缀增长做安慰剂检验,链内比较消掉了全部链间差异,是很便宜的证伪工具。
站内摘要出入:站内说「仅按链长排序效果相当」;原文在 MATH500 上按链长排序显著更好(0.715 对 0.585),只在 GSM8K 打平。
28. 只留答对样本等于换分母:全体 0.507 到筛后 0.581,差 7.4 个百分点还有公式 · arXiv:2610.37070 · 值得扫读
Correctness Conditioning as Selection in Chain-of-Thought Faithfulness Evaluation
作者:Yueer Pan、Yuexi Pan 两人,浙江大学与中国科学技术大学。代码已给。
研究问题与核心方法:忠实性评测常在「答对的样本」上算分,这等于换了被测量的人群。抬还是压、抬多少、能否写成公式。作者在七变量结构因果模型里形式化这个选择,推出闭式差距 = 合规与答对的协方差除以答对概率,把难度混杂与对撞偏差分开。实验用三个有确定性 oracle 的任务族,使每题(含答错)的合规性都可观测,从而同时算全体分与筛后分。
关键结果:
- 主 run:全体 0.507 → 筛后 0.581,差 +7.4 个百分点,n=1,000,95% 区间 [+4.3, +10.4]。
- 另一配置 +6.0 个百分点(n=300);另两个配置 +1.6 与 +2.4 个百分点,单独都不显著。
- 四部署合并后 OR=1.70(p<10⁻⁶);去掉主 run 后合并 z 从 5.19 降到 2.24。
- 归因只解释了一半:7.358 个百分点里 3.146 个百分点落在「运算步数」层间(42.8%),层内 4.212 个百分点无人认领。
- 捷径通路没被支持:中性框架下检出捷径使用 0%。
证据与局限:温度 0 单次生成;主结果只用算术 DAG,另两族只做实现一致性检查;对 18 篇前人协议的审查明确不做流行度估计。最弱一格是那 42.8%——作者写明只是与运算步数的相关、不识别因果。30
与目标研究线的关系:A 线直接命中——只留答对样本等于换分母,而且换法有公式。
可迁移启发:过程分与 rubric 分一律同报全体分与筛后分,并写明筛选规则。有确定性 oracle 的任务不必过滤,直接在错答上测合规性,这样能得到两个数而不是一个。
站内摘要出入:站内只说发现存在正选择差距;原文四个配置皆正,但只有两个单独显著,靠合并才稳,且作者明确中性框架下未检出捷径使用。
29. 判官换小模型:分数打平时成本是 0.5%–10%,但两类幻觉上仍落后 3.9 与 7.8 点 · arXiv:2610.37229 · 值得扫读
Decision Models as Judges for Hallucination Detection
作者:Haozheng Liu 等 7 人,NYU、亚利桑那大学、UIUC、UC 欧文、埃默里、马里兰、UAB。未给代码。
研究问题与核心方法:大模型当判官贵、会幻觉、过度自信。只从预设标签里选一个并给出逐标签概率的「决策模型」能否当更便宜的判官。作者把六个数据集的标注映射成五类二分类任务(共 9,852 条),五个决策模型对一个大模型判官,配对 bootstrap 2,000 次;再把最不自信的样本逐级上交,评估级联。
关键结果:
- 打平与落后并存:一类任务上 82.66 对 82.65(n=2,675)打平;一类 78.93 对 81.61;两类落后 3.9 与 7.8 个百分点。
- 成本:单体决策模型每条是对方判官的 0.5% 到 10%,延迟 0.22–0.62 秒对 1.6–2.6 秒。
- 级联在三个类型上有增益:82.2/84.6/84.6,比对方判官高 0.6/2.6/1.9 个百分点,成本 1.2%–3.3%;交叉拟合掉分不超过 0.52。
- 另两类没有增益:一类上级联一次也不延迟(等于最便宜的单模,仍低 3.9 点),另一类只高 0.7 点、仍低 7.1 点。
- 置信度不能用:决策模型过自信 0.04–0.12,置信度 AUROC 只有 0.67–0.73。
证据与局限:类型与数据集混淆(两类各只有一个来源),作者自述只能读作类型相关、不能归因于类型。级联超参在同一样本上选,主表是乐观值。最弱一格是那个几乎没有增益的类型:单来源加级联无效。31
与目标研究线的关系:A 线邻近。判分器的成本与可靠性权衡是自动评测流水线的瓶颈。
可迁移启发:按错误类型分别选判官,并把漏判率与误报率跟平衡准确率一起报——同分可以掩盖「多漏」与「多报」两种相反画像。流水线用置信度级联,只对不确定样本升级。
站内摘要出入:站内说决策模型成本仅为对方判官的 1%–3%;单体是 0.5%–10%,1.2%–3.3% 是级联总成本,且「级联可进一步提升」只在三个类型成立。
30. 把问题写成可执行代码:70% 的题三天内金标准就变了一次 · arXiv:2610.37166 · 值得扫读
LiveSearch: Questions as Executable Verifier Code for a Live Benchmark of Professional-Source Financial Search Agents
作者:Sinuo Wang 等 9 人,HTML 未列机构。未给代码,金标准来自不能自由调用的商业数据服务。
研究问题与核心方法:金融答案只在某一天成立,静态基准的金标准会随行情失效,泄进训练语料后奖励的是记忆而非检索。LiveSearch 把每题存成「题干、取数程序、匹配规则」三件:程序是若干工具调用加无分支的声明式抽取,相对时间锚写在程序参数里,题干禁止出现绝对日期。每天重执行程序、不再过模型,评分单位是「题、日期、冻结金标准」的三元快照。
关键结果:
- 只用通用网页搜索时,六个模型的准确率落在 70.9%–76.7%,最大差 5.8 个百分点(109 题快照)。
- 漂移是真的:三天同一批 109 题里 76 题(70%)的金标准至少变过一次,相邻两日分别是 67/109 与 69/109。
- 复用昨日答案会被扣掉:前一日快照直接提交,两个相邻日失败 66/109 与 68/109,得分 39.4% 与 37.6%;隔两天复用首日答案失败 71/109,得分 34.9%。
证据与局限:主榜单单次运行、单判官、无区间,六个模型的最大差只有 5.8 个百分点,这是最弱的一格——第一名与第二名的先后不可判。表 2 的两日配对是事后重算,作者自标描述性。32
与目标研究线的关系:A 线邻近,连接点是「金标准会过期」的度量口径。
可迁移启发:每题配可重算的取数程序与匹配规则,以三元快照为评分单位;再加一条「复用昨日答案」的对照线,它比模型分数更直白地证明题目在考检索。
站内摘要出入:站内说多数问题标准答案每日变化;原文是三天窗口内 70%,相邻日 61.5% 与 63.3%,且站内未给主结果区间与其「仅通用网页搜索」的条件。
31. 20 个模型、52 个配置的证明判分器全部低于专家一致性 0.76,加上臂选择后最高也只到 0.66 · arXiv:2610.36767 · 值得扫读
Can LLMs Reliably Grade Olympiad Proofs? A Study of Mathematical Verification with LLMs
作者:Azim Ospanov 等 8 人,华为基础模型部门、香港中文大学、香港科技大学。代码与数据在
github.com/aziksh-ospanov/TROJAN。研究问题与核心方法:竞赛数学的「会做」长期由答对率代偿,而证明题没有最终答案,判分要逐条核对断言。作者反向建集:以美国数学奥赛 2025 六题的官方解与评分细则为起点,按随机目标分数注入对应扣分点的错误,两名标注者独立给分;再把「给几分」重写成 0–7 的臂选择,由同一模型当 oracle 打分作奖励,逐轮选臂收敛。
关键结果:
- 人类一致性:48 份候选解上二次加权卡帕 0.76、±1 分内 85%。
- 20 个模型、52 个配置:完整信息下二次加权卡帕全部低于 0.70,盲评最高只有 0.53。
- 改进有限:换用臂选择后,四个模型的卡帕为 0.66/0.35/0.63/0.57,对照方法为 0.66/0.27/0.46/0.41。
- 微调有效:一个 9B 模型从 0.02 升到 0.35,27B 从 0.36 升到 0.47。
证据与局限:单 seed、固定 16 次采样、无区间与显著性检验;人工集只有 48 份(每题 8 份),四模型对比全落在这 48 份上,一格约 2 个百分点。摘要里那两个「26.4%」与「14%」,按表复算是四个模型(0.66/0.35/0.63/0.57 对 0.66/0.27/0.46/0.41)逐模型相对提升的非加权平均,其中第一个模型零提升;两者都是相对百分比,不是百分点。方法依赖参考解与评分细则,作者自述盲评不适用。33
与目标研究线的关系:A 线邻近偏直接,判分器可靠性决定验证信号能否自动生成。
可迁移启发:把评分当离散臂选择、「先给分再自我辩护」作为奖励,比多采样投票省。对抗集按扣分点定向注入错误,可以按错误类型切片看判分器弱在哪。
站内摘要出入:站内把 26.4% 与 14% 写成结论性提升;两者都是相对百分比、且是四个模型逐模型相对提升的非加权平均,站内也未提它只在完整信息下成立。
32. 成功率拆成三层:合法率与达成率都是 100% 的模型,综合分只有 0.830,因为多走了 8.33 步 · arXiv:2610.36415 · 值得扫读
Verifiable Efficiency Limits of Innate LLM Planning in Sliding Puzzles
作者:Yezhou Cheng、Charles Ling 两人,Uber 与西安大略大学。未给代码。
研究问题与核心方法:带工具的规划成功率把外部搜索与验证一起算进去了。三层依次是「计划合法」「合法并到达」「到达且接近最优」。只让模型一次吐完整计划、不给工具与反馈时,失败停在哪一环——不合法、走不到、还是走到了却浪费步数。作者用 4×4 滑块加障碍格,一次回复给出完整移动序列,最优解带可机验证书(最短路距离作下界、等长合法见证作上界),评分拆成嵌套三层:合法率 × 合法后达成率 × 达成后经济性。
关键结果:
- 8,400 条输出(7 个条件 ×1,200 条):最好的模型合法率与达成率都是 100%,但经济性 0.830、平均多走 8.33 步,综合分 0.830。
- 差距主要在达成率:一个模型合法率 98.3%、达成率 85.0%、经济性 0.558,综合 0.466;另有模型达成率 63.0% 与 58.0%,综合 0.377 与 0.344。
- 长程退化明显:某模型达成率从 94.2% 降到 76.6%、经济性从 0.710 降到 0.350。
- 条件优势不保序:两个模型的单看经济性(0.629/0.615)高于另两个(0.558/0.541),综合分却更低。
证据与局限:5,000 次整板分层 bootstrap,但每格只有 20 块板、三次试验绑在一起重采,区间只描述本设计内的波动。最弱一格是棋盘族受限:只保留每步都能把下界降 1 的板,作者自认测不到必须绕路的情形,「长程极限」只对这一族成立。34
与目标研究线的关系:A 线直接命中。它不是成功率榜,而是「长程失败停在哪一环」的可验证分解。
可迁移启发:把成功率拆成「合法率 × 合法后达成率 × 达成后经济性」,三层分母显式相消、失败不被丢掉。每个实例配可机验证书当上限,别拿模型自评当最优。
站内摘要出入:与原文一致,只是没提 320 块主队列加 80 块压力队列的分层。
33. 从专家报告挖类型级规则:单份参考只覆盖 54%,聚到十份才到 96% · arXiv:2610.36878 · 值得扫读
RubricAtlas: Mining Type-Level Rubrics from Expert Reports to Evaluate Deep Research Agents
作者:Delin Wang 等 8 人,StepFun、人民大学、阿德莱德、浙江大学。未给链接。
研究问题与核心方法:深度研究 agent 要评「做了哪些分析」。查询级 rubric 写清单题、漏掉同类型骨架;临时生成又无法横向比较。作者从 3,079 份中文卖方报告(64 家机构)聚出 99 个研究类型,拆成维度、问题、结论树,对齐成类型级问题并抽象成不含公司名与日期的目标,切成检查点并加负向准则。成品是 921 个问题、2,784 个目标、8,160 个检查点。
关键结果:
- 覆盖度与参考报告份数强相关:单份只覆盖本类型 54% 的问题,1/3/10 份为 51%/79%/96%,排名相关 0.69/0.79/0.95。
- 只用支撑子集重打分:完整性 +10.5 点(95% 区间 [7.1, 12.1],77% 任务上升),规模匹配的随机子集只 +1.2。
- 双判分器一致率 85.4%(κ=0.71),10 个 agent 的排名相关 0.87。
- 删块可控:该问题得分从 0.64 掉到 0.21;加 40% 无关文本没有可检测净增(+1.1,区间 [−0.9, 3.2]),但只能排除 3 点以上的效应。
证据与局限:人工审计由第一作者完成 300 个检查点决策与 297 个映射,与两个判分器的一致率 74.3% 与 71.7%(κ 0.49 与 0.43)。最弱一格是通用规则层:单条规则一致性中位 κ 只有 0.16,摘要的 0.71 只覆盖完整性。35
与目标研究线的关系:A 线直接命中(可审计的完整性口径),B 线也沾——类型级规则是判分器的冷启动。
可迁移启发:别用单份参考报告生 rubric,聚到十份才拿到 96% 覆盖与 0.95 的排名相关。负向准则(貌似合理实则降级即归零)要写成显式检查项。
站内摘要出入:站内说能有效比较分析完整性且排名一致性良好;0.87 只在整册图集成立,单份参考报告时排名相关落到 0.69,一半任务换榜首。
34. 12 个模型里只有 1 个在改过物理规律的世界里发现了规律;另一个判断正确率 16.7%,证据支持却是 0 · arXiv:2610.37649 · 邻近跟踪
Can LLMs Uncover Hidden Physical Laws through Free Exploration?
作者:Zhen Yang 等 4 人,香港科技大学(广州)、浙江大学、阿里巴巴、香港科技大学。代码与项目页已给。
研究问题与核心方法:若物理规律被改写,模型会不会自己注意到异常、把它变成研究问题、做实验找出规律——不给任务也不给提示。作者在仿真里搭了 15 个场景(1 个正常对照、14 个各改一条定律),可推、可抛、可抓、可自造装置;判定要同时满足「规律判断正确」与「证据支持」,两者都过才算发现。
关键结果:
- 12 个模型各跑 14 个改律场景 3 次:只有 1 个有发现,发现率 16.7%、判断正确率 19.0%、证据支持率 97.6%,其余 11 个发现率全为 0。
- 另一个模型的画像相反:判断正确 16.7%,但证据支持为 0——猜对不给证据,不计入。
- 把「能自造装置」这一项关掉是 4.8%、打开是 16.7%;给任务提示后 16.7%→28.6%,轮数 39.3→30.9;预算加到 500 轮反而降为 14.3%。
- 正常对照里 36.1% 的报告因谎称异常或无据解释被拒。
证据与局限:运行次数未直写,从表格最小刻度反推为改律 42 次、对照 36 次,单次无区间,19.0% 与 16.7% 只差一次运行。最弱一格是自评闭环:造场景、审装置的模型正是唯一有发现的那个。36
与目标研究线的关系:邻近,不算命中。连接点在「用失败记录反向生成更难场景」这一环属于 B 线;它测的是自主选题,而 A 线要的是长程训练与评估口径。
可迁移启发:探索日志加「结论正确且指得到具体轮次」的双闸门;用未解问题生成下一轮场景。
站内摘要出入:基本一致,站内省略了 15 个场景含 1 个正常对照,以及两个判据的分母。
六、语音与音频:合成侧三个接口,评估侧两个缺口
这一栏今天 15 篇新提交,收进 8 篇;再加上自然语言处理栏里两篇做语音数据与评测的,本节共 10 篇。
内容分两头。生成与转换侧在改四处接口:音频推理把裁判变成随策略更新的变量,流式翻译把「何时提交」交给语义门,匿名化把被毁掉的语音拉回可懂,时间戳字幕把音频描述拆成可组合的函数。评估与数据侧在补两个缺口:MOS 的区间,以及局部证据的对照。
对做 TTS 与语音评估的人来说,今天最值得抄的是两个具体做法:一是把目标声音换成同一类的另一段录音、看答案会不会跟着变;二是同时报 utterance 级与 system 级两个分母。
35. 系统级 MSE 0.08,utterance 级 0.228 反而输给两个基线:换分母就能把平庸点估计写成领先 · arXiv:2610.36126 · 精读
ConformalMOS: Uncertainty-Aware MOS Prediction with Conformal Intervals and Ordinal Modeling
作者:Kehinde Elelu 等 6 人,密歇根州立大学与克莱姆森大学。未给代码与数据。
研究问题与核心方法:
MOS 预测器只吐一个点估计,选模型或上线时无法知道「这条 3.8 分有多可信、区间多宽」。问题有两半:共形预测能不能在 MOS 上兑现名义覆盖;序数化训练能不能在不牺牲点估计的前提下改善校准。
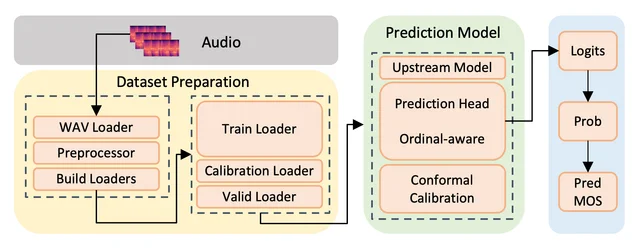
做法是冻结上游编码器,接一个两层 MLP 头,把 1 到 5 分切成若干等宽 bin 输出分布,目标是高斯平滑软标签;点估计取 bin 中心的期望,因此天然落在区间内。不确定性用分裂共形事后加:从开发池切 10% 作校准集,算绝对残差的经验分位数得当半宽,区间截断回 1 到 5。7
关键结果:
- BVCC 测试 1,066 句:utterance 级 MSE 0.228,高于 FUSE-MOS 的 0.191 与 UTMOS 的 0.165。
- system 级 MSE 0.080,低于 0.086 与 0.090(187 个系统各自求均值后再算误差)。
- system 级 LCC 0.953 是表内最高,SRCC 0.943 却低于 FUSE-MOS 的 0.947。
- utterance 级的 LCC 0.878、SRCC 0.876、KTAU 0.698,三项全部低于两个基线。
- 换更弱的骨干全面变差:utterance MSE 0.334、system MSE 0.162。
- 四档名义覆盖率对点估计几乎无影响(system MSE 0.080–0.083),符合「共形是事后处理」的设计。
证据与局限:
BVCC 共 7,106 句、187 个 TTS 与 VC 系统;按标准划分后再从开发池切 497 句做校准。没有 seed、没有重复运行、没有置信区间与显著性检验。
最弱的一格就是摘要那个 0.08:它是 system 级,分母从 1,066 句缩到 187 个系统;utterance 级 0.228 输给两个基线,正文只用一句「MSE 略有增加」带过。第二个弱点是动机里写「softmax 置信度在分布外语音上过度自信」,但全文只有域内实验,作者自己承认域外未测。
还有一个细节值得记:同一个点预测器在不同名义覆盖率下 MSE 应完全相同,表里却出现 0.001–0.003 的抖动,说明四行是四次独立重训,而这正是最该报 seed 方差的地方。7
与目标研究线的关系:C 线直接命中。它把 MOS 预测从点估计推进到区间,同时也演示了换分母如何让一个平庸的点估计看起来领先。
可迁移启发:报 MOS 预测必须同时给 utterance 级与 system 级 MSE,以及名义覆盖对实测覆盖的表格数字(不是图)。用实测覆盖率当上线门槛之前,先确认校准集与测试集同分布——同系统、同语料、同录音条件,否则区间只是一段好看的宽度。
站内摘要出入:站内写「以 MSE=0.08 的准确率实现可靠的 MOS 预测」;0.08 是 system 级 MSE,utterance 级是 0.228,且 MSE 不是准确率,「可靠」也没有覆盖率数字支撑。
36. 换同一类的另一段录音,答案也会翻 12%–16%:那 50 到 61 个百分点是扣掉底噪之后的净效应 · arXiv:2610.37605 · 精读
Beyond Answer Changes: Matched Same-Class Controls for Local Audio Evidence
作者:Yunuo Wang 等 4 人,香港科技大学(广州)、武汉大学、新加坡国立大学、东北大学(多伦多)。ICASSP 2027 在审,代码与冻结证据已开放。
研究问题与核心方法:
对一个音频语言模型做局部声音事件替换后答案翻转,可能是它真的对「事件类别」敏感,也可能只是「波形被改过」就会变。这两种解释在现有评测里是混在一起的。对应到手上的决策:音频忠实度与归因评测该怎么设对照。
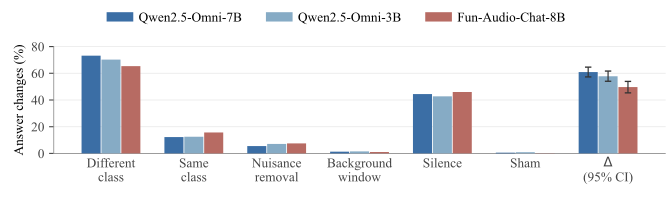
作者造了 600 条 10 秒合成声景,每条含一个被问的目标事件、一个时间上分离的干扰事件与连续环境声,二选一问「这段音频里有哪一个」。核心是配对两臂:换类臂把目标换成另一类的录音;同名臂把同一区间换成同类的另一段录音,正确答案不变。两臂共用目标区间、电平估计、供体拟合与交叉淡化,另有三种离靶控制。6
关键结果:
- 换类臂的答案改变率 65.33%–73.17%,同名臂 12.25%–15.67%(各 1,200 次试验);配对差 49.67–60.92 个百分点,三个模型的区间都不含零。
- 离靶控制给出底噪分层:去掉干扰事件 5.50%–7.50%,换背景窗 1.08%–1.50%,浮点自替换 0.17%–0.92%,整段静音 42.75%–46.00%。
- 只保留两臂声学距离相近的子集(236 条声景、472 次试验)后,配对差仍有 53.0 与 61.7 个百分点,说明这道落差不是改写幅度造出来的。
- 类级稳健:33 个目标类每一类的差都为正,最小类级差 3.8 个百分点。
- 但绝对正确率掉得不多:三个模型里最多掉 5.2 个百分点(0.847→0.795),最少的只掉 2.3 个百分点(0.882→0.859)。答案确实变了,可大多还答对。
证据与局限:
单一工作点(10 秒、16 kHz、事件背景比 +10 dB、33 类),全部合成;600 条声景只用 458 段背景,最多 8 条共用一个背景。
「选择性准确率」是只在「原题与同名替换都答对」的试次上算的准确率,三个模型分别是 0.819、0.801、0.737。最弱的一格是它的分母逐模型不同(891–971 次试验、481–544 条声景),所以这三个数不是在同一批题上比,原文没有给一个跨模型对齐的固定子集。排第二的弱点是浮点自替换只改了 1 个最低位,它只能排除实现噪声,排除不了「对波形重写敏感」——真正承担这个对照的是同名臂那 12%–16%。6
与目标研究线的关系:A 线在评测口径上就近命中音频侧。这套同名对照可以直接搬到任何「改输入看输出变不变」的归因测试,包括 agent 轨迹里「改了中间一步看结论变不变」。
可迁移启发:任何「扰动→输出变化」的归因指标都要配一个保持答案不变的匹配对照,并把该对照的翻转率作为底噪一起报。跨模型比较条件精度时先固定分母,用同一批合格样本,否则「合格子集」本身就是模型能力的函数。
站内摘要出入:站内说对比同名与异类替换「揭示模型对事件类别及波形重写的响应特性」,方向对,但漏掉最要紧的量级:同名改写本身就翻转 12%–16%,报出的 50 到 61 个百分点是扣掉这个底噪后的配对差。
37. 固定声纹一年内退化:被阈值拒掉的真人探针从 29.8% 升到 55.6%,等错误率 9.7%→14.0% · arXiv:2610.36713 · 精读
From Voiceprints to User Entities: Online Speaker-Memory Construction for Multi-User Spoken Agents
作者:Yucong Zhang、Cancan Li 等 5 人(前两位共同一作),香港中文大学(深圳)、美团、武汉大学。代码、基准与演示页均已给(匿名仓库与 Hugging Face 数据集)。
研究问题与核心方法:
多用户口语 agent 在写记忆之前必须先决定「这句是谁说的」,而现有记忆基准默认历史已经正确归属。把声纹当身份用,长期会怎样失效。对应决策是:多用户语音助手的记忆分区要不要在线维护实体、匹配阈值与更新阈值怎么定、用什么指标判断「记忆没错配」。
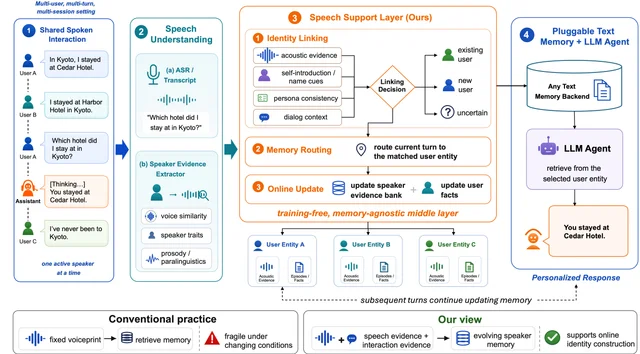
EvoSpeakerMem 是一个训练无关的中间层。每轮音频取声纹嵌入,与已有实体中心算余弦:低于合并阈值就新建实体,否则连到最高分实体;连上之后只有相似度超过更高的更新阈值才更新中心,因此一轮可以先写事实、暂不改声学状态。写记忆按实体分区,查询时只做只读匹配,未达阈值直接不给个人记忆。37
关键结果:
- 固定声纹确实会老化:真人探针被固定阈值拒掉的比率从 29.8%(0–1 天)升到 55.6%(365–450 天),等错误率 9.7%→14.0%,真实对相似度 0.538→0.446。
- 换更强的声纹模型只降绝对错误、不改趋势:被拒比率仍从 5.19% 升到 12.96%。
- 因果重放(6 个条件×5 个 seed):身份 F1 从 46.82%(首个样本)升到 55.99%(均值更新),全样本 KNN 65.31%,但 KNN 的连接精确率 52.56% 低于首样本的 66.25%。
- 身份门控问答(4,113 道敏感题):干净条件 71.41%→75.27%,偏移条件 60.15%→71.77%(+11.62 个百分点)。
- 授权三元组(正确授权/错误授权/拒绝):干净条件下固定阈值 4084/0/29,门控 4110/0/3;偏移条件下门控 4109/0/4,而「每次连上都更新」与「全样本 KNN」两种策略各有 115 次错授权。
- 四说话人交错(1,371 题):固定 67.83% 对门控 73.60%。
证据与局限:
三个层次的数据都有,真人数据部分给了 5 个 seed,阈值扫描与附录诊断也较全。但基准部分没有 seed 与区间,全部语音为合成的,干净与偏移条件都只有两位参与者,四说话人是两段故事在会话边界交错,不是真实重叠对话。
最弱的一格是摘要里「零错授权」这一条:它是在干净条件上把更新阈值调到 0.58 才成立的,原文说 0.58 是测试区间里「最低的不出现错授权的阈值」,等于用结果选超参;而合并阈值全程固定、没有敏感性扫描,因此无法排除「零污染来自阈值卡得高、代价是多拒」这条替代解释。37
与目标研究线的关系:A 线就近命中(多会话记忆的评测口径)。它指出「记忆基准默认归属正确」本身就是一个被忽略的评测假设——先测归属层,再谈记忆内容。
可迁移启发:多会话记忆评测先报归属三元组(正确授权、错误授权、拒绝),再报问答;只看问答会把「少拒几次」当成「记住了」。把跨用户串味率当一票否决项与问答并列:全样本 KNN 在偏移条件上问答 72.40 高于门控 71.77,代价是那 115 次错授权。
站内摘要出入:站内说在真人数据集与基准上都验证了性能提升;真人数据上 29.8%→55.6% 是被固定阈值拒掉的比率上升,是固定声纹一年内退化的失效证据,不是性能提升。
38. 让裁判跟着策略一起变强:1,000 题上 76.10 对基线 74.60,而换成冻结裁判是 75.10 · arXiv:2610.36578 · 精读
AudioRSI: Recursively Self-Improving Audio Reasoners
作者:Jiajun Fan 等 9 人,UIUC 与 Amazon。45 页、28 张表,未给代码与数据。
研究问题与核心方法:
音频强化学习的奖励一直来自模型外部——答案校验、手工过程分,或一个「策略在变、裁判不变」的外部判官。能不能让模型自己给出过程级奖励,并让这个标准随策略一起上升。对应决策:做音频推理的强化学习训练时,要不要自建评审器、多久同步一次、用什么证据判断递归真的有用。
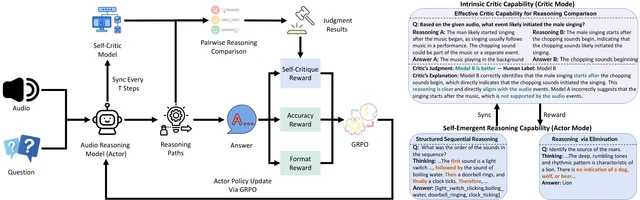
做法是一个模型两个角色。演员每题采样 8 条带思考与答案的路径;评审器是同一份权重的副本,输入音频、题干、选项与两条匿名路径,做两两判定,候选的自评奖励是它对组内其余路径的平均胜率。总奖励等于答案正确加格式合法加自评(三项权重都取 1)。递归由周期性同步实现:每 200 步把演员权重交给评审器,并带守护门——演员在小批量上的准确率不退化才换岗。38
关键结果:
- MMAU test-mini(1,000 题):76.10,对最强对照 74.60、另一强化学习基线 75.8、Gemini 2.5 Pro 71.60。
- MMSU(5,000 题):62.52,对 62.30 与 62.08——只高 0.22 与 0.44 个百分点,作者自己读作「相当」。
- MMAU-Pro(5,305 题):分项上 Multi-Audio 37.9 领先,但总平均 55.9 低于 Gemini 2.5 Flash 的 59.2。
- 消融:纯结果奖励 74.60、冻结外部判官 75.10、固定参考路径 74.90;同步周期 50 步回到 74.60、1,000 步掉到 75.10,默认 200 步是 76.10。
- 行为变化(每模型 1,000 条路径、关键词法):前提与演绎 94.4% 对 53.3%(基座),显式论证 22.2% 对 3.2%。
证据与局限:
四个基准分别 1,000 到 5,305 题,全部与训练分布不相交,这点很干净;主对照同骨干、同数据、同评测协议,只换奖励,是可归因的设计。
但每个配置只跑 1 个 seed,主表没有区间,而多数差距在 0.2 到 1.5 个百分点(5,000 题时 1 题约 0.02 个百分点)。最弱的一格正是支撑「递归是进步来源」的纯消融:对纯结果奖励 +1.5 个百分点、对冻结裁判 +1.0 个百分点,单 seed 下撑不住这个因果表述。次弱是 MMAU test-mini 既被用来扫同步周期、又被用来报主结果,选择偏差无法从这张表里剥离。38
与目标研究线的关系:B 线直接命中。自评奖励把「评审器」从外部常量变成随策略更新的变量,这是自进化闭环里最难也最容易自欺的一环。
可迁移启发:同步周期成了新的关键超参,而且必须报出倒 U 形——50 步等于没有增益、1,000 步丢掉大部分增益,只报最优点会误导。评审器换岗要加「不退化」守护门,否则等于把裁判交给更弱的自己。这套做法成立的前提是评审器能听到原始音频(本文的评审器与演员同源、输入同一段音频),只读文本的裁判未必能拒掉编造的声学证据。
站内摘要出入:站内说在四个分布外基准上优于强基线;原文的限定是「在不使用外部奖励模型的方法中」领先,MMAU-Pro 平均低于 Gemini 2.5 Flash,MMSU 只高 0.22 个百分点。
39. 把「谁在何时说了什么」做成可查询的监督层:时间偏移 1.54 秒对基线 2.47 秒 · arXiv:2610.36568 · 值得扫读
TAC2: Timestamped Audio Captioning as composable functions
作者:Swapnil Bhosale 等 6 人,萨里大学与 Adobe Research。项目页已给。
研究问题与核心方法:音频描述能否拆成可组合的函数——既能单次全解,也能让上游先验条件化下游预测。做法是冻结一个多模态骨干、加低秩适配,训练目标由声事件检测、说话人分离、描述器三路弱教师按时间 IoU 融合,逐属性指定权威教师;再把任务拆成「指令—输入—输出」的补全格式,因此可以级联。
关键结果:
- 音频理解总分 81.9(描述加冻结推理),对 74.0 与 73.1;感知分项 77.8 对 63.8。
- 单次解码改多轮级联:总分 81.3→81.9,音高比较 63.0→75.9。
- 300 条留出、1,471 个事件:时间偏移 1.54 秒(对基线 2.47 秒);删掉时间戳后退回 2.93 秒。
证据与局限:目标来自弱教师融合而非人工标注,上限被教师锁死;相邻轮次嗓音相近时会被并成一段、少算说话人;生成质量由模型打分,非人工;分数单次推理无区间。反向读数:另一个基准上 68.0 低于对照的 71.1。39
与目标研究线的关系:C 线与 D 线之间——它不合成语音,但给出「谁在何时说了什么、语气如何」的可查询监督层,是节目级音频结构的先决条件。
可迁移启发:多教师时间融合要逐属性指定权威教师并给显式 IoU 门。同报单次与多轮解码,才分得开「表示好」与「组合推理好」。
站内摘要出入:站内称其在音频理解上表现优异;原文在另一个基准上低于对照,优势只在感知分项。
40. 流式翻译的「何时开口」交给语义:FLEURS 上 BLEU 29.83,仍低于 30.20 · arXiv:2610.36777 · 值得扫读
S3-S2ST: Semantically Supervised Streaming Speech-to-Speech Translation
作者:Yuxiang Zhao 等 14 人,上海交大 X-LANCE、上海创智学院与阿里 Token Foundry。称将发布模型与流水线,未给链接。
研究问题与核心方法:流式同传里「输入到哪一刻才够开口」,能否从固定块长改成由语义边界监督、推理时用阈值连续调节的决策。做法是思考器加说话器:前端 640 毫秒一块,思考器在源音频段与已提交译文段的交错上文里增量出文本,由一个分类头预测「是否提交」,阈值只改决策不改权重;说话器把中间层隐状态融成声码器输入。训练时把句级语音对切成语义单元轨迹,要求前缀可译且可精确回译。
关键结果:
- 自建 9 对语料上 BLEU 60.51,对最快基线 52.22;但该集不公开。
- 在 FLEURS 上落后:两向无权重平均 BLEU 29.83 对 30.20,语义评分 0.769 对 0.791,对手是延迟 1.6 秒的 Hy-SimulMT;说话人相似度 0.606 为流式系统里最高。
- 提交策略:学习门的语义评分 0.828、起始延迟 6.61 秒,对固定每 8 块 0.814/6.83 秒、每 6 块 0.782/5.55 秒。
- 自适应阈值:语义评分 0.751 对固定阈值 0.737,起始延迟 4.97 对 4.90 秒。
证据与局限:流式混合约 13,000 小时真实源音频,但目标侧语音是合成的。单 seed、无区间。最弱一格是自建集:它不公开,而公开集上翻译指标被对手压住。作者自认只覆盖英中两向。40
与目标研究线的关系:C 线邻近——做流式语音生成与「何时说」的决策,不涉及多说话人编排或节目结构。
可迁移启发:把提交决策做成与输入粒度解耦的二分类门,一个 checkpoint 扫阈值即得整条质量—延迟曲线。消融单报首个提交位置,才能证明延迟差异来自后续决策而非起点。
站内摘要出入:站内说在 FLEURS 等数据集上取得良好性能;原文 FLEURS 上的 BLEU 与语义评分均低于那个延迟 1.6 秒的基线,只在自建集领先。
41. 匿名化把等错误率做到 26.31%,代价是字错率从 2.48% 涨到 11.75% · arXiv:2610.36768 · 值得扫读
The Content Leash: Mitigating Degenerate Solutions in Invertible Speaker Anonymization
作者:Nirjon Mobarak Talukder 等 4 人,达卡伊斯兰工程与技术大学。未给代码,本文是对原方法的复现。
研究问题与核心方法:可逆匿名化的目标只约束「匿名音频的说话人嵌入」,不管音频本身——优化器会不会毁掉语音骗过验证器;加什么约束能拉回来,又怎么对没见过的验证器成立。作者在原方法上直接对匿名频谱加两项约束(锚定到原频谱、只惩罚超出原动态范围的越界),并把训练验证器换成由波形域模型蒸馏到 mel 域的版本;评测纪律上加了两条:每个指标配干净语音底噪,并加一个未参与训练的验证器。
关键结果:
- 退化解确认存在:关掉约束时等错误率 41.60%、字错率 117.58%(底噪 2.01%),开启后为 21.20% 与 8.29%。
- 主结果(38 个未见说话人、303 条、3 个种子):等错误率 26.31±0.25%(底噪 2.83%),未参与训练的验证器上 27.86%(底噪 2.08%)。
- 代价在可懂度:字错率 11.75%,是底噪 2.48% 的约 4.7 倍。
- 错误密钥下恢复相似度 4.09%–4.41%,低于不同说话人之间的平均相似度 7.66%,说明没有留下搜索梯度。
证据与局限:训练与评测说话人不相交。最弱一格是退化解那张表:单密钥种子、50 条子集,两项约束一起关,分不出各自贡献;验证器蒸馏对齐只有 0.730±0.098,等错误率的上限被判据保真度卡住。41
与目标研究线的关系:C 线邻近——语音变换的质量与安全权衡,但它的评测纪律正是语音生成最缺的。
可迁移启发:以判别器为训练目标的生成任务,评测必须换架构族不同、未参与训练的判别器,并同报底噪。报告错误密钥下输出是否随距离单调,用来判断有没有留下搜索梯度。
站内摘要出入:站内说等错误率显著提升且保持可懂度;代价是字错率从 2.48% 涨到 11.75%(约 4.7 倍),26.31% 仍低于原方法论文里报的 47.81%,而它相对的是本文自己复现出的 41.60% 退化基线。
42. 同一批识别结果换个规范化口径:模型自带技能只有 3.5–13.9,加上技能到 68.8 · arXiv:2610.36527 · 值得扫读
ETC-Bench: A Multilingual Benchmark for Evaluation-Side Transcript Canonicalization
作者:Zhiheng Qian 等 7 人,上海交大 X-LANCE 与 AISpeech。称将开源,未给链接。
研究问题与核心方法:同一段语音的写法并不唯一(数字与英文、同音姓名),字错率会把这些算成错误,把转写约定混进模型能力。评测端能否先规范掉语音无法决定的差异,又不损语义。作者定义了一个「一致且语义保持」的合取指标:两条独立规范化后须完全一致,且语义相似度跌幅不超过阈值;另给一套技能提示,只许改目标片段、判不了的保留原样。
关键结果:
- 12 语宏平均:加上技能的模型 68.8,两个通用模型 43.8 与 43.3,规则系统 3.7–9.4。
- 同款模型不加载这套技能时只有 3.5、4.6 与 13.9。
- 分类别看:缩写 85.9、正字 82.3、数字 74.4,符号 44.3、同音 49.0;四个规则系统在同音上一律 0.0。
- 指标对环境敏感:某语种上破坏性去符产出 81 组「一致」对,阈值 0.10 时全被语义条件拒,0.15 时 30.9% 得分。
证据与局限:系统各跑 3 次报均值,未报标准差。最弱一格是同音替换:283 次「输出一致」中只有 8 次被语义条件拒。缺人类上限,68.8 无参照。42
与目标研究线的关系:D 线邻近但实用——节目字幕本就是一音频多写法,这里把口径差异量化;不过它评的是转写文本,不是节目结构。
可迁移启发:把「一致」与「语义保持」做成合取指标,可搬进多说话人转写与字幕对齐评测。指标要附阈值敏感曲线,本文从 0.10 到 0.15 就翻转了 30.9% 的判定。
站内摘要出入:站内只说这套技能在共享语言上优于基线,未提规则系统的均值分母不同,也没提同款模型不加载技能只有 3.5 到 13.9。
43. 让 agent 按错误画像决定下一轮采什么数据:平均错误率 19.4 对 23.9,日语与中文除外 · arXiv:2610.36538 · 值得扫读
Agentic Data Sampling Framework for Multilingual ASR via Linguistic-Aware Error-Driven Optimization
作者:Zhiheng Qian 等 9 人,上海交大与 AISpeech、南京大学。未给代码。
研究问题与核心方法:多语种识别的采样(语种配比、句子选择、token 加权)长期靠人工启发式,能否让 agent 每轮读评测结果自己定下一轮的算法与参数。作者做闭环训练:每轮采样、微调、开发集评测、把错误按语言学维度拆成音系、形态、句法三类,再由 agent 结合各语指标与预算,从分层算法池里挑一个并给参数。
关键结果:
- 12 语等权平均错误率 19.4,对不采样 23.9、随机采样 22.5、同样总训练时长但只采 100 小时 21.1;12 语里 9 语最优,日语与中文不在其中。
- 两语改善最大:西班牙 20.5→12.6(相对降 38.5%)、葡萄牙 18.7→11.6(38.0%)。
- 语言学错误计数:屈折与词尾 975→467(−52.1%),介词与功能词 526→403(−23.4%),单音素 124,191→114,831(−7.5%)。
- 收敛:基线约 1,200 小时后饱和,本方法继续下降。
证据与局限:12 语各取 50 小时做候选池;开发集与测试集合计各 12 小时,摊到每语约 1 小时,日语那 0.6 点之差很可能在噪声内。无区间、无多 seed、无显著性检验。各方法总训练时长统一为 1,200 小时(不采样那条是 600 小时语料跑两遍),所谓「更少资源」指采样进来的数据量,不是总算力。43
与目标研究线的关系:A 线与 B 线之间——把评测结果变成下一轮训练决策的闭环,是长程 agent 训练可借的形状。
可迁移启发:把指标拆成可归因维度再喂给决策 agent,比只喂平均错误率更容易出针对性动作。报告要分开「算法池能力」与「agent 调度」,否则说不清收益来自哪一层。
站内摘要出入:站内说用更少资源实现更优性能并加快收敛;原文把各方法总训练时长统一固定为 1,200 小时,且「更优」在日语与中文上不成立。
44. 低资源语言没有指令语料:把文本译过去、用合成语音造 550 小时问题 · arXiv:2610.36911 · 邻近跟踪
Developing a Speech Language Model for Basque
作者:Andoni Sudupe 等 6 人,巴斯克大学。会议 IberSPEECH 2026,模型与代码称已开源。
研究问题与核心方法:低资源语言没有语音指令语料时,能否用「翻译文本加合成语音」直接造出语音对话系统。作者套一个已有的语音对话结构,数据全合成:把公开的英文语音助手指令集译成巴斯克语,用多音色合成读问、两人读答,约 45 万问、550 小时问加 3,300 小时答。
关键结果:
- 内容质量 3.86/5(由大模型判分),对两个对照的 3.99 与 3.47。
- 字错率 9.94%、字符合错率 1.62%(外部识别器转写同批)。
- 语音质量 3.07 低于表内全部英文基线(3.62–4.22);首包延迟 370 毫秒(对照 346 毫秒)。
证据与局限:判分器与骨干同族,存在自我偏好;测试集与训练同流水线(4,419 条),无人工评价。最弱一格就是内容质量那一栏——它其实是在分布内测的。44
与目标研究线的关系:邻近跟踪。连接点在「用合成语音补目标侧训练数据」,这是节目级合成的数据构造手法;但它只做单轮问答,没有脚本、没有多说话人编排、没有节目级时长结构,所以不算命中。
可迁移启发:目标侧合成、源侧真实,是缺真实指令语料时的一条路;同流水线测试集必须标为分布内,否则 3.86 会被读成泛化。
站内摘要出入:站内只写内容质量 3.86/5,未提它来自同流水线的分布内测试,也未提语音质量低于全部英文基线。
七、播客线:这一批没有直接命中,四个连接点接在哪一环
这一栏今天 15 篇新提交,逐条核过:没有一篇做播客脚本生成、多说话人节目合成或节目级听感评测。这一节因此只登记连接点,不放替代品。
最接近的四篇分别接在节目的四个环节上,缺的那一环各不相同。播客线里唯一按「邻近跟踪」收录的是下面这篇可穿戴音频研究,它接在「听的人处于什么状态」这一环;另外三篇的条目在第六节,这里只写连接点。
45. 16 人四个月的胸挂音频:办公室每小时说话比居家多 12.61 分钟,压力高 7.49 · arXiv:2610.37270 · 邻近跟踪
Understanding Everyday Communication Patterns, Stress, and Productivity in Hybrid Work through Egocentric Wearable Audio Sensing
作者:Tiantian Feng 等 7 人,南加州大学等。SLT 2026 接收,未给代码。
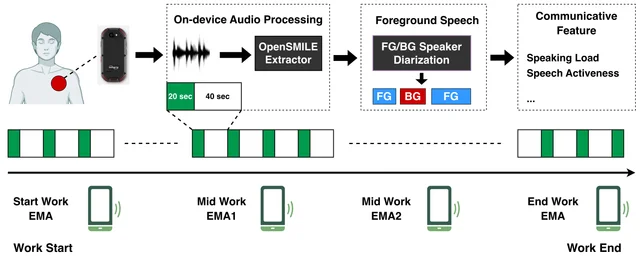
研究问题与核心方法:居家与办公室如何改变说话量与活跃度,又怎样关联自报压力与生产力。设备挂胸前,端上按 20 秒窗提低维特征,离线做前景与背景分离,得到说话负荷与活跃度;因为端侧输入低维,把大模型蒸馏进紧凑残差网络。
关键结果:
- 分离错误率(DER)在三个语料上是 14.1/23.5/29.0,比同架构基线低 1.9/1.1/2.8 个百分点,但仍比大模型高 6.8/15.1/6.4 个百分点。
- 加噪训练在 5 dB 时平均降 5.8 点、15 dB 降 2.7 点,25 dB 无差别。
- 办公室每小时说话比居家多 12.61 分钟(β=12.61,95% 区间 [10.7, 14.5]);办公室的说话负荷同时对应更高的自报压力(β=7.49)与更低的自报生产力(β=−5.87),两个系数的单位是各自量表上的点,量表区间原文未给。
证据与局限:19 人招募、16 人纳入,单机构,七成时间在办公室,属关联而非因果;最弱一格是表里两处地点斜率都不显著。45
与目标研究线的关系:邻近跟踪。连接点只在「前景与背景分离 + 蒸馏到小模型」这一层,与节目流水线区分主声道与背景人声同类;它属行为科学,不解码内容也不生成语音,因此不算命中。
可迁移启发:端侧蒸馏做分离时,必须报加噪与不加噪在低信噪比下的差值(5 dB 差 5.8 点),端侧失败几乎都在低信噪比。
站内摘要出入:站内说蒸馏「优化了分离性能」,容易读成追平大模型;原文只称与大模型的小型版本相当,与大模型仍差 6.4 到 15.1 点。
谁在何时说了什么(对应脚本与时间线):TAC2 能给出带说话人归属与时间戳的音频描述,时间偏移 1.54 秒对基线 2.47 秒。它做的是 30 秒以内片段的结构化描述,输出的是可查询的监督层,而不是一集的脚本,也不做节目级的组织与时长安排。39
一集里谁是谁(对应多说话人记账):EvoSpeakerMem 处理多用户口语 agent 的身份归属,并用「四说话人交错」做了压力测试(1,371 题,固定阈值 67.83% 对门控 73.60%)。它记的是身份与事实的对应,没有脚本,也没有整集级的合成与听感评测。37
跨语言播出(对应配音与「何时开口」):S3-S2ST 把「输入到哪一刻才够开口」做成可调阈值,语义评分 0.828、起始延迟 6.61 秒。它逐句翻译单个说话人,没有多角色轮转,也没有节目时长结构。40
节目之外的那一层(对应听感与场景):可穿戴音频那篇用 16 人四个月的数据看说话负荷与压力、生产力的关联,办公室每小时说话比居家多 12.61 分钟。它属行为科学,不解码内容也不生成语音,只在前景与背景分离、端侧蒸馏这两点上与节目流水线同构。45
四篇合起来覆盖了「谁在何时说了什么」「一集里谁是谁」「跨语言播出时何时开口」「听的人当时什么状态」,缺的是把这些接成一集的那一层:脚本结构、多角色轮转、整集时长与听感评测。要判断这条线的产出,只能等有论文真的做节目级评测。
八、排除清单与四条线的覆盖说明
本期三栏 165 篇新提交,收录 45 篇、排除 120 篇。排除按类聚成五类,共同的判断标准是:它们与本频道的四条线只能连到「同属人工智能」或「同属语音」这一层,搬不走评测口径、训练配方或失败归因方式。具体理由按类写在下面。
- 领域专用任务与应用系统:医学诊断与伦理、法律与专利、金融情感与交易、农业病害、航天器位姿、风电降噪、量子线路、材料与化学。这类论文的价值在领域侧,方法与指标都不出这个领域。
- 通用模型方法与训练效率:低秩适配与压缩、注意力与线性化、KV 缓存管理、蒸馏机理、时间序列基础模型、嵌入与检索的局部改进、分词与提示编辑。它们是长程 agent 的底座,本期没有一篇给出可用于长程任务评测的新口径。
- 单点语言与表征分析:标注者一致性框架、多语言基准审计、花园路径句残留、人格潜变量、数字选择启发式、预训练信息披露。连接点停在「都是语言模型」。
- 安全、对齐、隐私与治理:越狱与有害内容检测、安全对齐、隐私掩码、水印公平性、AI 生成网页的增长。其中能直接改成 agent 验收判据的那几篇已经收进正文(认知警惕、重启决策),其余属通用安全研究。
- 非语音的声学与信号处理:脑电解码、气管音呼吸监测、吉他合成、音乐编辑基准、部分编辑音频综述、医学与工业声学。它们与语音合成和评估不共享指标。
四条线在本批的覆盖:
- A 线(长程任务的训练与评估)25 篇,分四组:记忆(过期事实、任务导向工作区、异构记忆、主动记忆、多智能体记忆精炼、群体记忆压缩、参数内记忆、兼容性重放)、长程执行(后果感知执行、交接接管、重启决策价值、180 天运营、介入时机)、人在回路(认知警惕、用户在场、任务推进状态、真实业务基准、团队信息分布)、判分与验证(置信度长度依赖、选择偏差、规则挖掘、可执行验证码、奥赛判分、决策模型判官、规划效率分解、自由探索)。
- B 线(轨迹学习与自进化)9 篇:三篇同族方法分别改数据入口、改搜索结构、做审计;四篇改被演化的对象(准则、团队结构、组织拓扑、知识状态);一篇把种群当诊断证据源;还有一篇是自由探索场景,只算邻近。
- C 线(TTS 生成与评估)10 篇:生成与转换侧四篇(音频推理自改进、流式语音翻译、可逆匿名化、时间戳字幕),评测与数据侧六篇(MOS 的不确定性、同类对照、评估端规范化、多语采样、说话人记忆、低资源语音模型)。其中说话人记忆、多语采样与同类对照三篇在条目里标的是与 A 线交叉,这里按主要归属记在 C 线。
- D 线(播客生成与节目级评估)1 篇,是邻近项,没有直接命中。15 篇语音与音频新提交里没有播客脚本、节目合成或整集评测;这一节只写连接点,见上一节。
站内摘要与原文有出入的地方,条目里一律按原文写,并在条目末用「站内摘要出入」点出来。45 篇带编号的条目里,43 条明确点出了站内摘要与原文的出入,只有第 32 条(滑块拼图里的规划效率)与第 34 条(自由探索找物理规律)核对下来基本一致。
最多的两类出入还是老两样:抹掉限定词(某个基准、某组模型、某种设置、分布内还是分布外),以及换口径(把 system 级数字写成全局、把相对提升写成百分点、把「相当」写成「更优」)。本期最严重的三条:一是把 TrawMem 的「省 12.8% token」写成普遍收益,而它对另一个参照系统要多用一倍上下文、总耗时还高 15.6%;二是把 EvoSpeakerMem 里「固定阈值拒掉的真人探针一年内从 29.8% 升到 55.6%」这条失效证据写成性能提升;三是把 ConformalMOS 的 system 级 MSE 0.08 写成「准确率」,而 utterance 级 0.228 是输给两个基线的。
排除的 120 篇按栏列在下面,便于与后续批次对照。
- 人工智能栏 71 篇:2610.35942、2610.35984、2610.36100、2610.36116、2610.36146、2610.36169、2610.36183、2610.36188、2610.36234、2610.36239、2610.36287、2610.36298、2610.36325、2610.36328、2610.36329、2610.36335、2610.36341、2610.36355、2610.36386、2610.36389、2610.36433、2610.36444、2610.36445、2610.36449、2610.36484、2610.36493、2610.36513、2610.36536、2610.36574、2610.36580、2610.36589、2610.36595、2610.36623、2610.36625、2610.36631、2610.36672、2610.36689、2610.36764、2610.36776、2610.36820、2610.36824、2610.36847、2610.36877、2610.36888、2610.36900、2610.36925、2610.36962、2610.36991、2610.37041、2610.37045、2610.37081、2610.37121、2610.37123、2610.37161、2610.37169、2610.37237、2610.37242、2610.37243、2610.37281、2610.37316、2610.37342、2610.37369、2610.37375、2610.37405、2610.37407、2610.37422、2610.37459、2610.37461、2610.37585、2610.37631、2610.37655。
- 自然语言处理栏 42 篇:2610.35925、2610.36006、2610.36013、2610.36083、2610.36178、2610.36184、2610.36187、2610.36191、2610.36230、2610.36353、2610.36360、2610.36432、2610.36437、2610.36511、2610.36524、2610.36582、2610.36667、2610.36668、2610.36679、2610.36717、2610.36759、2610.36797、2610.36805、2610.36813、2610.36910、2610.36915、2610.36929、2610.36937、2610.36990、2610.37068、2610.37105、2610.37157、2610.37245、2610.37265、2610.37292、2610.37323、2610.37380、2610.37465、2610.37484、2610.37494、2610.37642、2610.37645。
- 语音与音频栏 7 篇:2610.36643、2610.36715、2610.36786、2610.36865、2610.37083、2610.37148、2610.37640。
需要说明一处与清单的差别:2610.36786(吉他合成)与 2610.36715(音乐编辑基准)留在排除里,理由是它们与语音合成与评估不共享指标;如果后续要做音乐生成这条支线,这两篇值得单独回头读。
References
- 1When Retrieval Is Not Enough
arxiv.org
- 2Monitor Accuracy Isn't the Answer
arxiv.org
- 3HSC-Bench
arxiv.org
- 4BiPA
arxiv.org
- 5GEPA-Curator
arxiv.org
- 6Beyond Answer Changes
arxiv.org
- 7ConformalMOS
arxiv.org
- 8
- 9ETAMem
arxiv.org
- 10
- 11Remembering Is Not Enough
arxiv.org
- 12Rare, Relevant, and Still Wrong
arxiv.org
- 13Self-Keyed In-Parameter Memorization
arxiv.org
- 14CAMR
arxiv.org
- 15CASEL
arxiv.org
- 16AutoVend
arxiv.org
- 17When to Intervene?
arxiv.org
- 18Correction or Manipulation?
arxiv.org
- 19
- 20From Interaction to Capability
arxiv.org
- 21kw-bench
arxiv.org
- 22TeamGym
arxiv.org
- 23
- 24RuHarness
arxiv.org
- 25Population-Centered Agent Evolution
arxiv.org
- 26Evolving Agent Teams
arxiv.org
- 27RKI
arxiv.org
- 28The Trinity
arxiv.org
- 29
- 30Correctness Conditioning
arxiv.org
- 31Decision Models as Judges
arxiv.org
- 32LiveSearch
arxiv.org
- 33MABGrader
arxiv.org
- 34Verifiable Efficiency Limits
arxiv.org
- 35RubricAtlas
arxiv.org
- 36
- 37EvoSpeakerMem
arxiv.org
- 38AudioRSI
arxiv.org
- 39TAC2
arxiv.org
- 40S3-S2ST
arxiv.org
- 41The Content Leash
arxiv.org
- 42ETC-Bench
arxiv.org
- 43Agentic ASR Sampling
arxiv.org
- 44
- 45Wearable Audio Sensing
arxiv.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.