外卖几条业务线共用一套精排骨干:美团 MTFM 免掉跨业务特征对齐,推理成本降 24%
解读美团 2026 年 9 月发布的 MTFM:外卖首页、拼好饭、神抢手等场景的特征各自编成 Token、免掉跨业务模板对齐,用四层里三层 Target Attention 扛住千级长序列,四条业务线里小流量业务拿到 0.60~0.93pp 的离线增量,在线推理成本降 24.0%。

2026 年 9 月 22 日,美团技术团队发布官方博客《MTFM:美团统一推荐基座大模型在外卖多业务场景的落地实践》1,同题论文在 2026 年 5 月被 KDD 2026 接收2,arXiv 上的版本停在 2 月 13 日的 v23。
先分清两个"基座"。MTFM 不做文本生成,它做的是推荐系统里的精排:外卖首页的商家顺序、拼好饭的餐品顺序、神抢手的券包顺序,都由这类模型打分排序。这里的"基座"指的是外卖首页、拼好饭、神抢手这些原本各训一个精排模型的业务,现在共用同一套注意力骨干,各自只保留自己的特征编码器与任务塔1。
博客给的两组数字方向相反地摆在一起:外卖多个业务的订单量提升 2.06%~6.68%,最显著的业务线增长超过 6%1;同时单样本计算量达到 192 GFLOPs,相对传统 DLRM 提高数百倍,在线推理成本却降低 24.0%1。模型吃得多了几百倍,账为什么反而更低,这是这份材料里最值得核的一处。
各业务的特征各自成 Token,由一张 Mask 管住可见性
外卖的几个推荐场景,供给并不一样:首页推的是商家,拼好饭推的是餐品,神抢手推的是券包4。商家身上没有餐品标签这类字段,券包和商家也不是同一种供给,这几套特征体系装不进同一个模板。论文把过去的多场景做法归成两条路线:一条把参数拆成"场景共享"与"场景独有"两部分,代表是 STAR、M3OE 与 MLoRA;另一条先训一个超大规模模型,再把知识蒸给场景专家,代表是 ExFM 与 LFM4Ads,论文作者把后者归为非端到端、认为能力上限受限456。
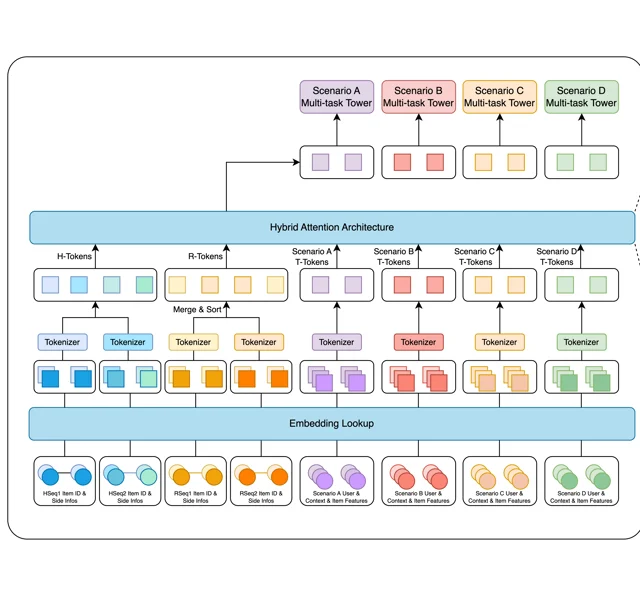
MTFM 把差异挪了个位置:差异进 Token,而不是进参数分区。三类 Token 各管一段。
- H-Token:跨业务的历史行为序列,也就是商家统一序列与商品统一序列,全业务共享;
- R-Token:近实时行为序列,点击、加购这类动作按时间戳统一排序,全业务共享;
- T-Token:本次要预估的目标(商家、商品或券包),加上下文特征与交叉特征,各业务各自维护一套编码器。
三类 Token 按顺序拼成一条序列,送进同一套骨干,跨业务的特征模板对齐这一步就免掉了1。免掉的是模板对齐这一层:跨业务统一的行为序列与统一的 SideInfo(挂在商家、商品上的属性信息)仍是前提,T-Token 的编码器也仍要各业务维护。
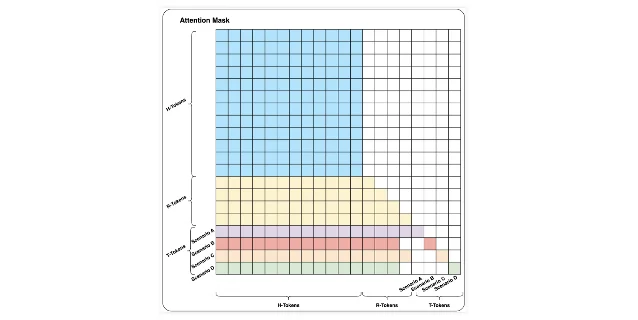
一条序列里装着多个场景、多个时间段的行为,谁该看到谁得写成规则,MTFM 用一张动态 Mask 把它编码进注意力1。H-Token 对所有 Token 可见,历史行为是全场景共享的用户上下文;R-Token 按时间因果可见,每个目标 Token 只能看到它这次曝光之前发生的实时行为;T-Token 只被自己看到,同一次请求里的候选互不感知。第三条把同一请求内的候选隔开,第二条堵住时间泄漏——用户级样本会把一次曝光之后的行为也装进同一条样本4。
四层里放三层 Target Attention,把长序列的账压下来
统一之后输入长度上去了:一条用户级样本要装下跨业务的历史序列、实时序列和多个业务的候选,博客里说的是千级长度1。全 Full Attention 的计算量随序列长度平方增长,直接堆在这么长的序列上,训练和推理的开销都接不住。
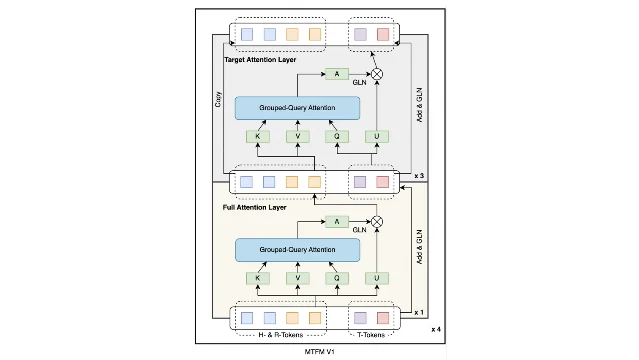
MTFM 的做法是每四层只放一层 Full Attention:这一层负责全序列的信息聚合,另外三层是 Target Attention,只让 T-Token 以全序列做 Key/Value 取信息,自己不再参与全序列的自注意力计算;注意力内部再上 GQA(多个查询头共用一组 Key/Value 头)1。骨干一共 16 层,也就是 4 个 Block,每个 Block 是 1 层 Full 加 3 层 Target,骨干块用的是 HSTU(Meta 2024 年提出的生成式推荐结构,把推荐当作序列转导任务)7。这套混合注意力的来源,博客点了两个语言模型的名:Qwen3-Next 与 MiMo-V2-Flash189。
这个比例是量出来的,标尺是某一业务场景的离线 GAUC(按用户分组分别算 AUC 再取平均)1:
| 配置 | Batch Size | CTR GAUC | CTCVR GAUC | 样本分发速度(相对) | 显存 |
|---|---|---|---|---|---|
| 全 Full Attention(15) | 96 | 0.8129 | 0.8531 | 100% | 66.7GB |
| Target:Full=(1:1)×8 | 160 | 0.8129 | 0.8530 | 245% | 72.2GB |
| Target:Full=(3:1)×4 | 160 | 0.8132 | 0.8536 | 290% | 67.0GB |
| Target:Full=(5:1)×3 | 160 | 0.8121 | 0.8523 | 300% | 68.6GB |
| Target:Full=(3:1)×4(去掉 GQA) | 160 | 0.8130 | 0.8528 | 263% | 71.2GB |
数值取自官方图表 11。
3:1 那一行是两个 GAUC 的最高值,batch size 从 96 提到 160(1.7 倍),样本分发速度是全 Full Attention 的 2.9 倍;注意力比例继续加码到 5:1,两个 GAUC 都掉下来,Full Attention 压得太少会伤到效果。GQA 那一行是单独对照:去掉它以后速度从 290% 降到 263%、显存从 67.0GB 涨到 71.2GB。论文里另有一套更细的扫描,在单卡 A100、7 天样本的配置上比较了 1:1、3:1、5:1 与纯 Target Attention,方向一致——3:1 的 GAUC 最高,5:1 掉 0.07pp,纯 Target Attention 掉 0.12pp,吞吐从纯 Full Attention 的 390 samples/s 提到 7804。
第二版的改动集中在 Target 侧。多场景长序列里,单个 Target Token 身上挂的特征比单个用户侧 Token 多得多,两者在 Token 化阶段却被压成同样维度的一个 Token,Target 的信息被过度压缩1。MTFM V2 因此把一个 Target 拆成 4 个 Token:用 AutoSplit 把用户、上下文、商品特征经一层线性映射成 4 个 Token Embedding;4 个 Token 各有自己的 Q 投影与 FFN;同一层的 Self-Attention 与 Target-Attention 用两套参数;再借 RankMixer 的 Mixing 模块让 4 个 Token 相互交叉,避免它们在同样的 Key/Value 下学到雷同的表征11011。
拆 Token 之后,四条业务线上的两个指标都往上走(增量为相对各自基线的百分点):
| 业务线(基线) | V1 CTR GAUC | V1 CTCVR GAUC | V2 CTR GAUC | V2 CTCVR GAUC |
|---|---|---|---|---|
| A 业务(MTGR) | +0.86pp | +0.94pp | +1.26pp | +1.62pp |
| B 业务(DLRM) | +1.66pp | +1.22pp | +2.06pp | +1.52pp |
| C 业务(DLRM) | +2.26pp | +2.76pp | +2.74pp | +3.44pp |
| D 业务(DLRM) | +1.90pp | +4.85pp | +2.61pp | +5.72pp |
数值取自官方图表 4,四条业务线匿名成 A 到 D1。pp 是百分点。
最右边那一列是提升最大的 D 业务线,CTCVR GAUC 从 V1 的 +4.85pp 提到 V2 的 +5.72pp。同时要记住,目前完成全量上线的只有 V1,V2 还停在实验口径1。
跨场景迁移的收益,落在数据最少的业务线上
把多个业务的数据汇进一个骨干,这一手赚多少,官方给了一张"各业务单独建模"与"多业务一起训练"的四业务线离线对照:
| 业务线 | 单业务建模 CTR / CTCVR GAUC | 多业务训练 CTR / CTCVR GAUC | 增量 |
|---|---|---|---|
| A | 0.6939 / 0.6760 | 0.6944 / 0.6760 | +0.05pp / +0.00pp |
| B | 0.7328 / 0.7686 | 0.7351 / 0.7711 | +0.23pp / +0.25pp |
| C | 0.7464 / 0.7696 | 0.7546 / 0.7756 | +0.82pp / +0.60pp |
| D | 0.6625 / 0.6967 | 0.6715 / 0.7060 | +0.90pp / +0.93pp |
数值取自官方图表 21。
A 的增量落在 +0.05pp 与 +0.00pp 上,C 与 D 的 CTR GAUC 增量分别是 +0.82pp 与 +0.90pp。博客把这条规律写得很直白:小流量业务显著提升 0.60~0.93pp,中流量业务提升 0.25pp,大流量业务持平微正1。收益的大小与业务手里的数据量反向对应,大业务自己已经把数据吃干,小业务缺的是样本。这也决定了"要不要建推荐基座"的答案:业务结构里有一批数据稀疏的小场景,跨场景迁移才有东西可赚;只剩一条大业务,收益就接近 A 那一行。
边界要一起读:四条业务线在图表里匿名成 A 到 D,读者无从对照自己的业务,而且这是离线 GAUC 对照,离上线 A/B 还有一层1。
行为序列的统一是同一个方向的另一面。过去每个业务各自维护本场域的行为序列,跨场景行为缺失在数据稀疏的小业务上尤其明显;MTFM 把全场景的点击、加购、完单聚成商家与商品两条长序列,并配一套覆盖质、价、品与情景化信息的通用 SideInfo,博客称消融显示多个业务都有提升1。
单样本算力涨了数百倍,账怎么算平的
模型的单样本计算量到了 192 GFLOPs,相对 DLRM 高了数百倍,在线推理成本却降低 24.0%1。DLRM 是推荐系统沿用了多年的标准骨架,特征是固定模板加交叉;MTFM 的推理成本指单位请求的线上开销。这中间的差额,靠三层动作摊平。
第一层在样本组织。DLRM 按曝光造样本,用户一次浏览就产生一条样本;MTFM 按用户聚合,一个用户当天在外卖各业务的曝光合成一条样本,几条业务线共用同一份用户兴趣表征,也共用同一段最耗算力的长序列注意力。线上部署时各业务只导出自己的子图,计算限定在本业务相关的组件上14。
第二层在训练策略,这部分明显是从语言模型搬过来的。初始化沿用 GPT-2 对多层 Transformer 的做法,HSTU 每个 Block 输出投影层的标准差按 0.02/√L 缩放(本次推全的骨干 L=16),让残差分支累积后的方差保持稳定;优化器把 HSTU 的 UQKV 投影与输出投影从 AdamW 换成 Muon,一种用 Newton-Schulz 迭代把梯度矩阵正交化的优化器,并借鉴月之暗面的实践加上 weight decay 与 update RMS scale1。两项叠加之后,5~10 组随机实验的 train AUC 波动从 0.4pp 降到 0.1pp1。
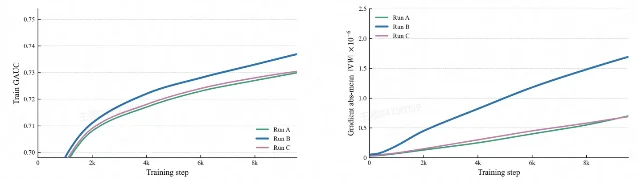
多业务联合训练带来两个新麻烦,官方也给了改法。各业务损失分别归一化再相加时,小流量业务的有效 batch 小、梯度噪声大,会通过共享参数影响其他业务;改成按 batch 内各业务样本量全局归一之后,噪声问题缓解1。另一些 batch 里不含小流量业务的候选,这些业务的编码器与专家在该步没有梯度,却仍被持续衰减;优化器改为跳过零梯度的 weight decay,把零梯度检测合并成一次批量同步,并引入步长为 2 的梯度累积1。
第三层在算子与系统,这是整份材料里最工程的一段。HSTU 动态 Mask 的构造在 2k 长序列下,从逐样本 Python 循环的 22ms 降到 Triton kernel 的 1ms;基于 Flash-Attention V2 扩展出的接口同时支持 Full 与 Target 两种注意力、动态 Mask 读取与 SiLU 融合,相比 NVIDIA 的实现前向加速 128%、反向加速 152%;Group LayerNorm 的前向用 Triton 重写后,内存带宽利用率从 30% 提到 60% 以上,整体提速超过 30%;Muon 的正交化把同形状的权重梯度堆成批量张量并行执行,该阶段加速 241%、端到端训练吞吐提升 19%;TorchRec 的数据分发与 HashTable 优化器链路改成交叠执行,多个 HashtableCollection 合成一张表,训练流水线整体提速约 15%;用 Agent 做特征分组搜索,从 1.3K+ 的特征里删掉近 500 个而 GAUC 无损,吞吐再涨 6%1。
推理侧的数字同样具体:多表查询合并后显存从 22GB 降到 5.9GB;用户侧的 Mask 按有效 Key 分块跳算,长序列下单算子延迟降低约 50%;候选侧"用户看不到候选"这个方向整体跳过,在 2000 用户加 200 候选的配置下延迟降低 13%;GLN 改成基于 Mask 的写法后吞吐提升 38%;推理图融合冗余算子、合并连续的 Cast 之后吞吐提升 20%1。论文里还有一处博客没写的:HSTU 的线性投影层上做了 2:4 结构化稀疏,显存减半,吞吐约提升 10%,推理延迟约减少 0.2ms4。
读完这一段,有一个判断可以带走:在推荐基座这套栈里,最贵的部分是稀疏特征查表与 Host/Device 同步,注意力只是其中一项。论文把 torch.unique、TorchRec 的 wait() 同步、HashTable 优化器 step,以及业务代码里的 .item() 引发的 D2H 同步列为典型阻塞点1。
离线 0.36pp 与在线 2.06%~6.68% 是两笔账
论文的离线实验用的是三个场景的真实日志:首页场景 2.4 亿用户、423 万商品、185.3 亿次曝光;拼好饭 1.51 亿用户、807 万商品、152.9 亿次曝光;神抢手 4400 万用户、98 万商品、22.4 亿次曝光,其中最小的一条只有首页曝光量的约八分之一4。
论文摘要给的离线增量是:CTR 任务的平均 GAUC 提升 0.36pp、最大 0.76pp,CTCVR 任务平均 0.29pp、最大 0.53pp3。零点几个百分点听上去小,放到同一张表里就有参照:首页场景的 CTR 任务上,GAUC 从 DCNv2 的 0.6853、MMoE 的 0.6857、RankMixer 的 0.6860,到 OneTrans 的 0.6944 与 MTGR 的 0.6951,MTFM 是 0.69544。这几个模型从最普通到最先进,跨度只有约一个百分点,0.36pp 是其中三分之一。同一张表里还能看到另一件事:相对最强的单场景生成式基线 MTGR,首页 CTR GAUC 只多 0.03pp,摘要里那个"最大 0.76pp"出现在拼好饭场景的 CTR 上(0.7398 到 0.7474),CTCVR 上是 0.7771 到 0.78244。
在线部分是两组数字,来自同一团队的两份材料,时间差七个月。
论文的在线 A/B(2026 年 2 月)覆盖两个场景:神抢手的 CTR +1.89%、UV_CTCVR +2.46%、订单 +2.98%、延迟 −5ms;拼好饭的 CTR +1.53%、UV_CTCVR +1.03%、订单 +1.45%、延迟 −6ms。每天的曝光量是数千万次,基线是该业务上线多年、持续优化的当前最优模型;论文说这一轮订单增量相当于该业务过去 2~3 轮模型迭代的累积4。
博客的在线数字(2026 年 9 月)是外卖多个业务的订单量提升 2.06%~6.68%,最显著业务线超过 6%,并被写成"最近两年多个核心业务推荐场景单次优化的最大收益"1。
两组数字的口径并不相同:2 月那份是两条业务线上的首轮 A/B,9 月这份是 V1 在多个业务完成全量之后的区间。博客没有交代这半年里基线、流量或指标口径有没有变化,所以两组数字只能并列;差距里有多少来自模型、多少来自场景铺开,材料里没有答案。
在线这一节缺的读数得点清楚:没有置信区间、没有测试时长、没有流量切分比例;四条业务线在图表里匿名成 A 到 D,读者无从对照自己的业务;论文也没有给模型的参数量与生产配置的层数,离线超参是 d_model=768、4 个 Block、每块 3 层 Target Attention、3 个查询头配 1 个 KV 头4。
Scaling 是这套架构主张的另一半,博客给了三张曲线:模型层数、Token 维度(192~768)与序列长度(400~2000)1。层数那张标了四条业务线的相关系数,r 分别是 0.9996、0.9910、0.9951、0.9876,32 层的 CTCVR GAUC 增量落在 +0.5pp 到 +1.0pp 之间1。
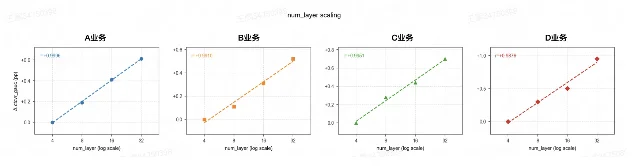
论文里的对应版本把横轴换成推理 GFLOPs,并给出 10 倍到 70 倍的模型规模扫描与三种规模的持续训练曲线,结论是数据量越大、不同规模之间的差距越明显4。两处曲线都是官方自测,没有第三方复现。
公开物的边界也在这里:博客与论文都没有放出代码、权重或训练数据,论文本体在 ACM 数字图书馆(DOI 10.1145/3770855.3818452),arXiv 版本停在 2 月 13 日的 v2,比博客的 9 月数字早了七个多月23。
能带走的与要等的
三样能带走。第一样是 Token 分类加可见性 Mask 的写法:把"哪类信息谁看得到"从特征工程的约定变成注意力结构里的规则,跨场景越界与时间泄漏由同一张 Mask 一次解决1。第二样是用户级样本聚合:用"一个用户当日的全场景曝光"替换"一次曝光一条样本",让多条业务线摊薄同一段长序列的算力,这是把推理成本压到 −24.0% 的那一步14。第三样是语言模型训练经验的取舍:初始化与优化器那一半在稀疏特征栈里同样管用(0.4pp 到 0.1pp),而注意力在这个栈里排不进成本大头,照搬注意力加速的思路会盯错地方1。
References
- 1MTFM:美团统一推荐基座大模型在外卖多业务场景的落地实践
tech.meituan.com
- 2
- 3arXiv:2602.11235
arxiv.org
- 4MTFM 论文全文(arXiv HTML v2)
arxiv.org
- 5
- 6
- 7
- 8Qwen3-Next
qwen.ai
- 9MiMo-V2-Flash Technical Report
arxiv.org
- 10OneTrans
arxiv.org
- 11RankMixer
arxiv.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.