AI Agent 运营工具周报:从评论、私信到转化数据,7 个接住发布之后的入口
按「读回互动、承接私域、回传效果」三段盘点 7 个能装进 Agent 的入口:读取抖音、小红书等平台的评论与转写,用自托管 SCRM 或 LinkedIn 技能接住私信与线索,再把漏斗、客户旅程和营收数据收回来。

上周那期停在稿子写完、还没点发布的那一段。这一期往后挪一步,看内容发出去以后发生的事。
那一段里有三件要人盯的事:评论区里谁在说什么,私信和线索由谁接住,这条内容最后换回了什么。它们过去靠人一条条翻、一条条回、过几天再回头对一遍账。要把这三件事接给 Agent,难点通常落在数据从哪来、程序跑在哪台机器上。
本期挑出的 7 个入口就落在这三件事上。选型的第一个分岔口是数据来路与部署形态:两个只读公开页面,本机装完就能跑;两个要复用你自己浏览器里的登录态,去碰平台账号;一个以自托管服务的形式装在你自己的服务器上,另一个依赖第三方的 LinkedIn 接口;剩下两个把分析放在托管服务里,按账号和套餐计费。分清这一步,后面几个工具之间谁替代谁,也就清楚了。
| 入口 | 一句话定位 | Agent 接入形态 | 工序位置与依赖 | 硬边界与成熟度快照 |
|---|---|---|---|---|
| Social Media Toolkit | 把抖音、小红书、B 站、YouTube 的公开链接转成结构化证据 | Python SDK、socialkit CLI、六个 MCP 工具 | 读回互动:只读公开页面,无需 Cookie 或登录 | Apache-2.0,作者自述仍是 alpha;抖音评论只取公开顶层样本 1 |
| redbook | 小红书命令行工具,搜索、分析、评论回复都在终端里 | npm 全局 CLI,附 SKILL.md 与 Claude Code 技能 | 读回互动:复用 Chrome 里的登录态 | MIT;用平台非公开接口,作者声明与小红书没有隶属关系 2 |
| HiveMtk | 自托管的私域 SCRM,把多端私信收进同一个收件箱 | Docker Compose 自托管,内置 ReAct 智能体与 41 个原子工具 | 承接:整套服务落在你控制的内网 | AGPL-3.0,改版后对外提供网络服务须按同协议开源;公开仓库 81 star、25 fork 3 |
| LinkedIn 技能 | 把 LinkedIn 的线索导入、筛选与邀约做成 Agent 技能 | Agent 技能加 @linkedapi/linkedin-cli | 承接:海外 B2B 线索,依赖第三方 API | MIT;需要 Linked API 令牌,账号与数据在第三方 4 |
| Humblytics MCP | 让 Agent 查站点流量、漏斗、A/B 与投放归因 | 托管 MCP,Streamable HTTP 端点 | 回传效果:数据在第三方托管服务 | 仓库 MIT;需 Plus 及以上套餐,一把账号级密钥覆盖所有站点 5 |
| Retentioneering | 用图方法看用户实际怎么走,算的不只是漏斗通过率 | pip install 的 Python 库,加 MCP 服务与 Agent 技能 | 回传效果:事件流在本机分析 | Apache-2.0;其他库与托管服务属于另外的商业产品 6 |
| OpenAnalytics | 自托管的无 Cookie 网站分析,带营收归因 | Docker Compose 自托管,oa CLI 加 MCP 服务 | 回传效果:采集与分析都在你自己的机器 | AGPL-3.0;自托管要备 4 GB 内存和四个 DNS 记录 7 |
表里的 star 数与最近提交取自 2026 年 10 月 5 日打开仓库时的页面快照,只反映当时的状态。
把互动读回来:一个免登录,一个用你 Chrome 里的 Cookie
Social Media Toolkit:公开链接进来,结构化证据出去
这个项目把抖音、小红书、B 站、YouTube 的公开链接收敛成一套固定格式:规范化元数据、可读文字、带时间轴的转写、媒体清单,以及受支持的公开评论样本。同一套编排逻辑同时支撑 Python SDK、
socialkit 命令行和 MCP 服务,三条入口返回的是同一份带版本号的结果契约 1。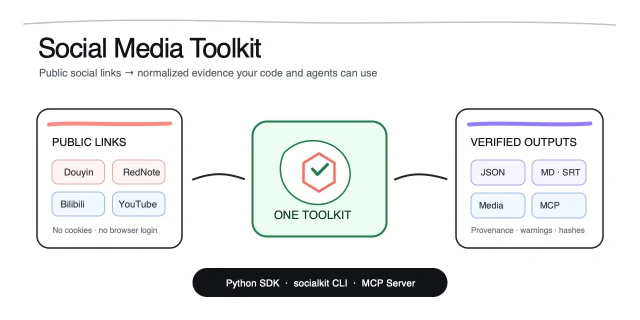
取文字有一条固定顺序:先取原始内容,取不到再用公开解析器,抖音解析失败且配了付费密钥时回退到 TikHub,仍然没有文字才走火山引擎的云端转写。项目文档写明它没有本地 Whisper、没有浏览器自动化或 CDP、也不做基于 Cookie 的抓取,能在哪一段取到数据,边界写得很清楚 1。
六个 MCP 工具覆盖了最常用的动作:
social_inspect 只归一化元数据,social_get_text 走文字与带时间轴转写,social_get_comments 取公开评论样本,social_download 与 social_capture_bundle 负责下载,social_doctor 报告依赖和配置项名称。发布不在范围内,小红书和 B 站的评论也不支持,抖音的评论样本只是一次性的顶层样本,不分页、不回补缺失项 1。- 典型使用场景:把一批竞品视频链接交给 Agent,一次拿到文案、口播转写和公开评论,再喂给选题或复盘;或者先用
social_inspect只看元数据,不花转写和下载的钱。 - 安装与接入:本机装 Node.js 18+,跑
npx -y github:JNHFlow21/social-media-toolkit,再用socialkit doctor看哪几条路径可用;MCP 端是本地 stdio 服务,把social-media-toolkit-mcp挂到客户端即可 1。 - 硬边界:许可为 Apache-2.0,作者把项目标为 alpha,结果契约有版本号,平台页面却随时可能变。火山引擎转写和 TikHub 回退都会产生费用;项目只接受公开地址,不绕过访问控制,也不承担发布 1。
redbook:小红书这一侧,评论回复也在终端里
redbook 是一个小红书命令行工具,用 Chrome 里的 Cookie 认证,不需要申请 API Key。搜索、读笔记、看博主数据、拆爆款只是它的一半,另一半直接对着互动:发表评论、回复指定评论、按策略批量回复 2。批量回复这一条值得单独看它怎么做。
redbook batch-reply 支持三种策略——问题优先、高赞优先、未回复优先,可以带模板和条数上限,而且默认先跑一次预览,确认之后再真的发出去。它另有一条限流检测命令,读创作者后台那个隐藏的 level 字段,判断笔记是不是被隐形限流 2。- 典型使用场景:一条笔记发出去之后,先按「问题优先」把有价值的提问挑出来预览,再决定批量回复哪些;或者定期跑一次
redbook health,看最近几篇有没有被限流。 - 安装与接入:装 Node.js 22 以上,
npm install -g @lucasygu/redbook,先在自己的 Chrome 里登录小红书,再跑redbook whoami确认能连上。仓库自带SKILL.md,在 Claude Code 里可以直接用/redbook调用 2。 - 硬边界:MIT 许可。项目用的是平台非公开接口,作者在免责声明里写明小红书随时可能改动或封禁这些接口,它也与小红书没有隶属关系 2。Cookie 来源可以指定 Chrome、Safari 或 Firefox,也可以手动传字符串;在云端或容器里跑时,作者提供
auth命令保存和检查 Cookie 文件。批量回复会真的改动账号状态,预览那一步别跳过。
把互动接住:一个收件箱装在自己服务器上
HiveMtk:多端私信进一个收件箱,智能体在内网接话
HiveMtk 是一个开源的私域营销系统,把 SCRM、CDP 和一套 ReAct 智能体装进同一个仓库。抖音、快手、小红书、闲鱼、TikTok 经 Chrome 扩展桥接,走你自己的登录态浏览器;微信、企业微信、Telegram、WhatsApp、邮件和短信走协议直连。所有会话汇进一个统一收件箱,客户资料汇成一份 CDP 视图 3。
智能体那一层有 41 个原子工具,按感知、规划、调工具、反思的循环走;知识库用 pgvector 混合检索,再用 bge-reranker 精排。整套推理栈跑在本地:llama.cpp 跑 Qwen2.5,TEI 跑 bge-m3 和重排模型,对话、向量化和检索都在内网完成。把
LLM_BASE_URL 指向 DeepSeek 或 OpenAI 也可以,但 Embedding 和 Rerank 仍强制走本地 3。- 典型使用场景:多个平台账号的私信和评论集中到一个收件箱,用 SOP 编排处理和跟进;或者给客服场景配一套只在内网跑的 RAG 知识库,客户对话不出内网。
- 安装与接入:要求 Docker 24+ 与 Compose v2。
git clone之后make install拉环境、下模型、拉起数据层与推理栈,改完.env里的数据库、Redis 和 JWT 密钥,再make dev启动。硬件最低 4 核 / 8 GB / 50 GB,GPU 可选,无 GPU 时走 CPU 推理 3。 - 硬边界:AGPL-3.0。私有部署和二次开发不受限,改过的版本如果作为 SaaS 或托管 API 对外提供,就要按同一协议开源改动部分。主动触达(短信、邮件、社媒私信、Telegram、WhatsApp)是敏感功能,服务端每次主动发送都会打印一条不可关闭的合规提示,使用者的发送方式由使用者自己负责 3。项目不提供 SaaS 版,只做私有化部署。
LinkedIn 技能:把线索筛选与邀约写成 Agent 能跑的技能
这套技能面向海外的 B2B 获客,动作交给配套的
@linkedapi/linkedin-cli 和 Linked API。技能分成两个:linkedin 负责取资料、搜人和公司、发消息、管理好友、发帖;linkedin-growth 是一条两段式线索管道,先按你的理想客户画像导入并筛选线索,再排期批量发好友邀请,可以挂在多个账号上 4。安装器把「装上了」和「能用」分开报告。退出码只说明文件是否装好,是否配置就绪写在 JSON 里;技能装好但令牌还没连上时,退出码是 0,返回里带着
ready: false 和一份待办清单,调用方要解析 JSON,不能把待配置当成安装失败 4。- 典型使用场景:把一个展会名单或表单线索导入
linkedin-growth,先按画像筛一遍,再让它在限定频率内分批发邀请;或者用linkedin取公司和人脉资料,补进自己的客户表。 - 安装与接入:需要 Node.js 20 以上。跑
npx @linkedapi/skills交互式安装,也可以让 Agent 自己读https://linkedapi.io/skills/install.md照做;非交互场景用npx @linkedapi/skills add linkedin --yes,令牌从app.linkedapi.io取 4。 - 硬边界:MIT 许可。账号数据和调用都经过第三方的 Linked API,令牌在对方平台上,这一步的数据边界要自己先想清楚。批量加好友属于写操作,频率限制、账号风控和品牌语气都落在使用者的配置里。
把效果收回来:托管分析、本地事件流、自托管平台
这三个都回答「发出去之后到底带来了什么」,差别在数据去哪、在哪算。一个把你的站点数据放在托管服务里算,一个把事件流拉回本机用 Python 算,一个把整套采集和分析装到你自己的机器上。
Humblytics MCP:托管的一整套转化测量,接进 Agent
Humblytics 把站点分析、实验和投放数据做成一个托管的 MCP 服务,端点是
https://mcp.humblytics.com/v1,走 Streamable HTTP,用 Bearer 密钥认证。接上之后,Agent 拿到 37 个工具:分析那一层给流量、实时访客、页面明细、点击热图、表单、入口出口页和多站点汇总;漏斗那一层给 Sankey 图和 AI 生成的漏斗建议;A/B 那一层能给实验建议、创建并管理分流测试、取结果;投放那一层把 Meta、Google 的广告花费一路接回 Stripe 的成交 5。服务端还挂了 12 条营销技能提示词,其中 5 条会自动接上你的实时数据,包括
cro-optimizer、ab-test-generator、heatmap-analyst、revenue-attributor 和 funnel-reporter 5。- 典型使用场景:让 Agent 每周回答一次「哪些页面在漏人」「该测什么」;或者把广告花费到成交的整条链路拉出来,看哪个渠道真的带来了收入。
- 安装与接入:需要 Humblytics 的 Plus 及以上套餐。在 Claude Code 里
claude mcp add humblytics --transport http https://mcp.humblytics.com/v1 --header "Authorization: Bearer $HUMBLYTICS_API_KEY",Cursor、VS Code 或任意 MCP 客户端按同一端点配置即可 5。 - 硬边界:仓库是 MIT 许可,真正的服务在对方服务器上,密钥是一把账号级密钥,覆盖你能访问的所有站点,调用前先用
list_properties拿到要操作的propertyId。写操作要留意:create_split_test一创建就立即生效,仓库也说明 Agent 会先给建议再创建 5。
Retentioneering:把用户实际走的路径画出来
Retentioneering 的做法与分析平台不同。它把原始事件流读进来——pandas DataFrame、CSV、TSV、Parquet,或者从 BigQuery、ClickHouse 导出的数据都行——再按转移图、步骤矩阵、路径过滤这些图方法,看用户实际怎么走:绕了哪些路才转化、在哪儿卡住、哪两个人群不一样。5.0 版本把引擎换成了 DuckDB 支撑的
Eventstream,分析直接在你的环境里跑,原始数据和结果都不离开本机 6。它也提供 MCP 服务和一组 Agent 技能,让 Agent 在你的事件流上跑分析、搭报告页,最后导出一份可交互的 HTML 报告,报告里每个数字都能点回它的数据来源 6。
- 典型使用场景:活动落地页的转化率不理想时,先看用户实际走了哪条路、在哪个步骤大量回退;或者比较投流人群和自然流量人群的路径差异。
- 安装与接入:Python 3.10+,
pip install retentioneering,在 Jupyter、Colab、VS Code 或 Claude Code 里都能用;没有数据时可以用它自带的那套合成电商数据集先跑通 6。 - 硬边界:仓库里的
retentioneering-tools是 Apache-2.0,可以商用于自己的产品。同一家的其他库、托管执行服务和企业集成是另外的商业产品,不走这份许可。匿名使用遥测默认开启,可以随时关掉 6。
OpenAnalytics:无 Cookie 的自托管分析,把营收也接上
OpenAnalytics 是一个自托管的网站分析平台,装一个很轻的追踪脚本,不用 Cookie、不做跨站画像,只按聚合口径读数。想省事可以用作者托管在
getopen.so 的实例,代码和自托管版本一致。它给的不只是访客和浏览量:自定义事件、会话、Web Vitals、漏斗、站点留存、可嵌入组件、公开分享链接,以及从你自己的 Stripe 账号读进来的营收分析,还有 CSV / JSON 的导入导出 7。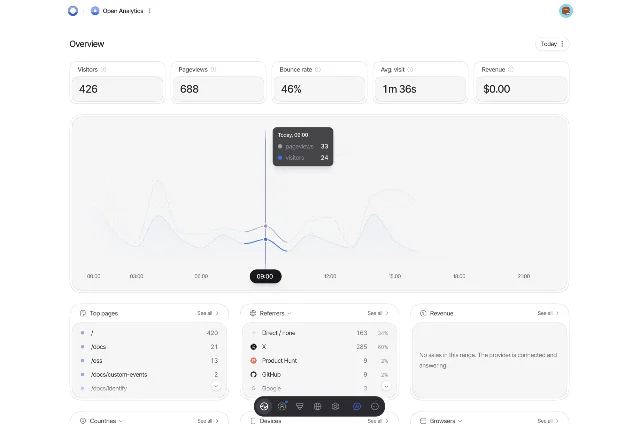
- 典型使用场景:给内容站或落地页换一套不依赖第三方的分析,把阅读和转化数据留在自己机器上;或者把营收归因接上,直接看哪篇内容的访问最终成了单。
- 安装与接入:一台装了 Docker 的 Linux 主机,先准备好四个域名。克隆仓库、切到最新发布 tag,在
infra/selfhost下跑./generate-secrets.sh生成密钥,再docker compose pull && docker compose up -d;证书在首次启动时签发。镜像直接从ghcr.io拉,不需要在机器上装工具链 7。 - 硬边界:AGPL-3.0。自托管要备大约 4 GB 内存和 25 GB 磁盘,四个 DNS 记录必须在启动前指好,否则证书签发会失败。它另有
oa命令行和 MCP 服务,代码里 ClickHouse 只能通过校验签名查询信封的查询网关访问 7。
这 7 个怎么排顺序
先装两个只读的。
Social Media Toolkit 只要本机有 Node.js,socialkit doctor 一跑就知道哪条路径能用,试错成本最低;手上有小红书账号的话,再补 redbook,先只用它的搜索、分析和 health 检测,确认连接正常,再决定要不要开评论回复。这两个都不碰写操作,是第一轮最适合观察的两个。第二步处理私信与线索。私域在国内、且愿意自己运维一台服务器,选 HiveMtk:它把渠道、收件箱、智能体和知识库都装在自己内网,代价是部署和硬件门槛最高,主动触达还要自己承担合规。线索在海外、又不想自己搭,选 LinkedIn 技能:装起来快,代价是数据经过第三方,且批量邀约要自己定频控。
第三步装测量,按数据想去哪里选。想让第三方托管、上手最快,选
Humblytics;想让事件流留在本机、又能跑图分析,选 Retentioneering;想连站点采集和营收归因都自己掌控,选 OpenAnalytics。三者可以只上一个,也可以按用途叠着用。最后一条这 7 个共有:它们都在替你看。评论该不该回、私信要不要接、这周的数据算好还是算差,判断和签字仍然落在人这边。把它们当成一份带来源、带时间的清单,比当成结论好用得多。
References
- 1JNHFlow21/social-media-toolkit
github.com
- 2lucasygu/redbook
github.com
- 3xiaofang142/hivemtk
github.com
- 4Linked-API/linkedin-skills
github.com
- 5Humblytics/humblytics-marketing-skills
github.com
- 6retentioneering/retentioneering-tools
github.com
- 7OpenLabs-so/openanalytics
github.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.