Transformer作者团队,下场RSI
Sakana AI 与 UC Berkeley 的 MASS 让同一个 Qwen3.6-27B 分饰执行、评估与优化三个角色,两轮自我改进后把四个研究基准上每个输出 token 换回的得分提到基模的 1.2 到 1.6 倍,代价是两项软件工程基准反向下滑。

本文转载自微信公众号「量子位」2026 年 10 月 18 日 20:30 推送,作者:文婷(发自 凹非寺 量子位 | 公众号 QbitAI)。原文:《Transformer 作者团队,下场 RSI》
Sakana AI 和 UC Berkeley 的一组研究者,让一个开源模型学会了给自己当教练。
方法叫 MASS,同一个 Qwen3.6-27B 在同一个编码环境里分饰三角:写代码跑实验的执行者、挑毛病的评估者、改分工的优化者1。
模型先自己组队干活,再由外面的强模型评判成果。
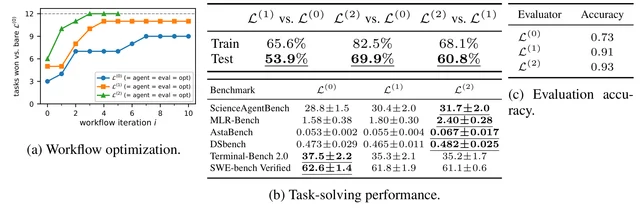
两轮自我改进之后,三个留出的研究任务上「比基模更好」的比例,从 53.9% 升到 69.9%1。
它给自己打分的准确率,也从 73% 升到 93%1。
论文 10 月 8 日挂上 arXiv,标题是《Recursive Self-Improvement through Multi-Agent Self-Supervision》,全文 39 页2。
原文标题里的「Transformer 作者团队」,指的是 Sakana AI 的联合创始人兼 CTO Llion Jones,他是《Attention Is All You Need》八位核心作者之一3。
一个模型分饰三角,自己给自己搭班子
模型自己教自己,最卡的地方是反馈太同质。
同一个模型写答案、打分、改错,用的是同一套学过的偏好,错误容易换个说法再被强化一遍1。
Sakana 借的是明斯基《心智社会》的思路:把复杂智能拆成若干简单组件,让它们在协作里显出单个组件没有的能力1。
MASS 把这份协作写进提示词。
执行者写代码、跑实验,产出代码、图表和研究报告;评估者把两份成果摆在一起比,说清哪一份更符合任务要求4。
优化者拿评估反馈去改工作流。工作流是一段文本,写明每个子智能体的角色、指令、输出契约,以及调用顺序1。
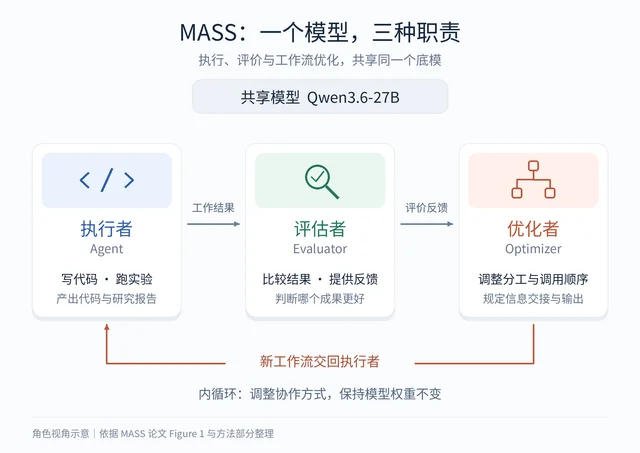
内循环跑完,外循环才动权重。
用选出的工作流把每个训练任务跑 18 遍,由同一代模型给这些成果两两排名,每道题留最多 16 条轨迹:15 条进训练,1 条做验证4。
微调用的是 LoRA。构造训练样本时还会把工作流文本从提示里删掉,逼模型从任务本身学会怎么组织人手4。
新一代权重接手三个角色,第二轮重新开始。
两轮之后:胜率涨了,自评也涨了
底模是 Qwen3.6-27B 的 FP8 版本,跑在 qwen-code 0.20.0 这个编码智能体环境里1。
训练数据是 12 个合成的研究型编程任务,金融、机器人、制药各 4 个,任务描述由 GPT-5.5 生成,其中 3 个留作测试1。
9 个训练任务里有 1 个被剔除,原因是工作流搜索找不到优于参照的方案,最终 8 个任务贡献了训练数据1。
裁判从外面请:GPT-5.5 与 Claude Opus 4.8 各跑三次,每对成果得到六次判断,平局剔除。这些判断只用于评估,整个学习过程看不到1。
四个研究类公开基准的分数逐代上涨:
- ScienceAgentBench 从 28.8 到 30.4 再到 31.71
- MLR-Bench 从 1.58 到 1.80 再到 2.401
- DSBench 从 0.473 到 0.465 再到 0.4821
- AstaBench 从 0.053 到 0.055 再到 0.0671
更意外的是评估能力的迁移。
微调只喂了任务求解的轨迹,没专门教它当裁判,评估准确率却从 0.73 到 0.91 再到 0.93,判定结果与外部强模型越来越合拍1。
论文把这件事看作递归能转下去的前提:换成更会评估自己的模型,下一轮挑工作流的眼光也更准4。
1.2 到 1.6 倍,算的是每个输出 token 换回的得分
原文开头那个「效率提升 1.2 到 1.6 倍」,取的是另一套口径。
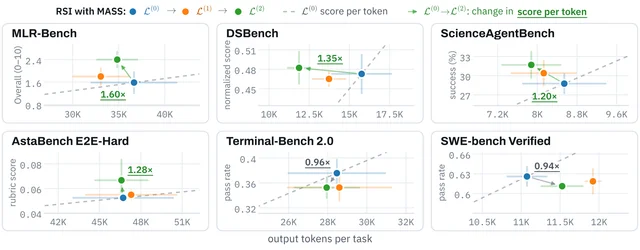
它把得分除以每个任务消耗的输出 token 数,再拿新一代的这个比值去比基模。同样的分数用更少的 token 换到,倍数才涨4。
按这个算法,第二代的每 token 得分是基模的 1.60 倍(MLR-Bench)、1.35 倍(DSBench)、1.28 倍(AstaBench E2E-Hard)和 1.20 倍(ScienceAgentBench)4。
这个区间只覆盖四个研究基准,因为它们和训练任务最像2。
喂多智能体轨迹,比喂单智能体轨迹更省
研究还做了一组对照:同一个底模,一边喂多智能体轨迹,一边喂单智能体轨迹。
多智能体这组用了 28.82M 监督 token,对基模胜率 68.3%;单智能体那组用掉 42M token,胜率 64.0%1。
少花 31.4% 的 token,胜率高出 4.3 个百分点1。
论文的解释是任务被拆开了:编排者的轨迹教怎么拆解任务、核对产出,子智能体的轨迹教怎么在局部边界里把活干完,两类轨迹一起更新同一份权重1。
行为上也看得出内化。不给任何工作流提示,让模型裸跑,基模在 110 条轨迹里只有 1 条主动派活,第二代涨到 87 条;跨子智能体的代码交接从 1 条升到 83 条1。
作者自己划的边界
偏科摆在表里:Terminal-Bench 2.0 从 37.5 降到 35.2,SWE-bench Verified 从 62.6 降到 61.11。
换成每 token 效率,这两项分别是 0.96 倍和 0.94 倍4。
官方博客给的解释是往训练数据里加软件工程任务应该就能缓解,用的是「我们怀疑」这种推测口气4。
原文另外记了一条:优化器改工作流时偶发性能暴跌,文本上动几个词,结果可能差很远3。
论文的消融把瓶颈指向优化器:卡住自我改进的是工作流搜索这一环2。
规模也要交代:两轮迭代、119 条训练轨迹、17.2M 监督 token、LoRA rank 641。
论文只跑到第二代。再套几轮会不会性能崩塌,作者留给后续工作1。
这家公司和这些人
Sakana AI 2023 年成立于东京,名字在日语里是「鱼」的意思,研究方向偏进化算法、模型融合和自主智能体3。
CEO David Ha 曾领导 Google Brain 东京团队,CTO Llion Jones 是 Transformer 论文的八位作者之一3。
七位作者来自 Sakana AI 与 UC Berkeley 两边:一作 Hyunin Lee 是伯克利机械工程系博士生,这项工作在 Sakana AI 实习期间完成2。
Matei Zaharia 是伯克利 EECS 副教授、Databricks 联合创始人兼 CTO,也是 Apache Spark 项目的发起人3。
原文里的话
AI 自己分身组队,就能在内部把自己卷上天…
不过,研究团队并没有把这项成果吹上天,直接在论文里交代了局限
它不再需要人类在 Prompt 里苦口婆心教它怎么分工,自己提笔就知道该叫分身出来干活了。
三句都出自量子位原文3。
References
- 1论文 §3:方法
arxiv.org
- 2arXiv:2610.12176v1 摘要页
arxiv.org
- 3量子位原文:Transformer作者团队,下场RSI
mp.weixin.qq.com
- 4Sakana 官方博客:MASS
pub.sakana.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.