9月21日-27日大模型发布追踪:Opus 5.5、GPT-6 Sol/Luna 与 MiMo-V2.6
本期核对 9 月 21 日至 27 日的五组发布,比较 Claude Opus 5.5、GPT-6 Sol 与 Luna、小米 MiMo-V2.6、Grok 4.7 与通义千问 Qwen-Audio-3.1 的能力、价格与可用性边界,并给出三组可复测的选型动作。

一句话判断
本期覆盖窗口是 2026 年 9 月 21 日至 27 日(UTC+08:00)。这一周里,四家厂商几乎同时做了同一件事:9 月 21 日 xAI 发布 Grok 4.7,9 月 22 日 Anthropic、OpenAI 与小米在同一天上新,四条发布的方向一致,都把同等能力的单位成本往下压了一档。
会真正进入选型清单的有三组。Anthropic 的 Claude Opus 5.5 把默认设置下的运行成本比 Opus 5 压低 40%,缓存读取降到每百万 token $0.20;OpenAI 的 GPT-6 Sol 与 GPT-6 Luna 把 API 价格对半砍;小米开源 MiMo-V2.6 系列,其中 Pro 版在 Artificial Analysis 智力指数上拿到 46 分,每任务成本 $0.13。另外两组改的是单价,能力档位维持原样:xAI 的 Grok 4.7 换了更大的底座,价格与速度维持 Grok 4.6 水平;阿里通义千问的 Qwen-Audio-3.1 把语音模型全线价格下调,最高降幅 95%。
「智力指数」与「每任务成本」这两个数字来自第三方评测机构 Artificial Analysis。前者由十项评测加权得出,衡量综合能力;后者是跑完这套评测平均每次任务的花费,把输入、缓存、推理与输出 token 的价格都算进去。厂商自报跑分的口径与它不同,本文把两者分列,不合成单一排名。
先看价格、状态和边界
| 模型与发布 | 发布与定位 | 关键变化 | 评测信号 | 价格与可用性 | 先测什么 |
|---|---|---|---|---|---|
| Claude Opus 5.5 1 | 9 月 22 日发布;Claude 5.5 系列的第一个模型,官方称它在多数工作上达到 Claude Fable 5.1 的水平,Sonnet 5.5 与 Haiku 5.5 预告在未来几周跟进 | 默认设置下的运行成本比 Opus 5 低 40%,输出速度提升超过 30%,缓存读取价格降 60%;新增最高 2.5 倍速的 Fast 模式;官方称这是其呼吁「放缓前沿」之后的第一次发布,发布前由 Frontier Design 与 METR 做外部评测 | 官方自报 Terminal-Bench 4.0 66.4%(xhigh 档)、CursorBench 4.0 57.8%、GDPval-AA v2.1 1846 Elo、AutomationBench 40.0%、Humanity's Last Exam 67.7%(带工具);Artificial Analysis 独立记录智力指数 58(max 档,位列第一)、输出速度 94 token/s、每任务成本 $5.98,低算力档为 $0.55 2 | 每百万 token 输入 $4、输出 $20、缓存读取 $0.20、缓存写入 $5(Opus 5 同口径为输入 $5、输出 $25、缓存读取 $0.50);Fast 模式 $8 / $40;API、Claude 应用与 Claude Code 即时可用;生物与网络安全场景沿用 Fable 5.1 级护栏,需通过生命科学验证计划或网络安全验证计划 | Agent 与编码任务的总账单(缓存读取占这块成本的大头),以及十万行级代码迁移、审计这类长任务的一次通过率 |
| GPT-6 Sol 与 GPT-6 Luna 34 | 9 月 22 日(美国时间)发布;与 GPT-6 Astra 用相近方法训练的两个较小模型,把 Astra 的能力往下摊到更便宜的档位 | 相对 GPT-5.6 的促销价,Sol 与 Luna 的 API 价格各降 50%;提示缓存默认命中率提高,缓存输入读取折扣最高 90%,并新增缓存看板、未命中诊断与显式缓存断点;对话中途调整推理强度或增删工具时,早先的上下文仍可复用 | 官方自报 AutomationBench 1.0.6(Zapier,47 个工具)Sol(xhigh)33.2%、每任务 $0.27,GPT-6 Astra(low)与 Claude Opus 5(max)的成本分别约为它的 3.9 倍与 11.1 倍;DeepSWE v1.1 Sol(max)68.8%、Luna(max)66.6%;OSWorld 2.0 offline Sol(xhigh)60.5%;Artificial Analysis 独立记录 Sol 智力指数 48、每任务 $1.06、上下文 872K,Luna 智力指数 37、每任务 $0.07、上下文 1M 56 | 每百万 token Sol 输入 $2、输出 $10,Luna 输入 $0.10、输出 $0.50;ChatGPT Work 与 Codex 面向 Plus、Pro、Business、Enterprise、Edu 当天上线,Free 与 Go 用户在桌面端可用 Luna;API 模型名 gpt-6-sol 与 gpt-6-luna;尚未进入 ChatGPT 主对话 | 把自己 Agent 的每任务成本按真实任务重算一遍,重点看缓存命中率提升后账单的变化 |
| Grok 4.7 7 | 9 月 21 日发布;xAI(其模型榜单页写作 SpaceXAI)面向编码与知识工作的旗舰 | 换用比 Grok 4.6 更大的底座模型,强化学习训练更长、任务分布更偏向需要数小时完成的问题;模型能原生理解 Grok Bot 工具框架;官方称价格与速度维持 4.6 的水平,另有一款输出速度翻倍的快速版 | 官方自报 CursorBench 4.0 46.3%(xHigh)、DeepSWE v1.1 71.0%(high 档)、EEBench 64.0%、AA Briefcase v1.1 1657、Harvey Legal Agent Benchmark 19.6%;官方称在 LatchBio 生物安全基准拿到 62.4%,HackerBench v0.3 只放行 3.3% 的高风险双用途提示;Artificial Analysis 独立记录智力指数 46、输出速度 83 token/s、每任务成本 $2.73(high)与 $3.74(xhigh)、上下文 500K 8 | 每百万 token 输入 $2 起、输出 $6 起;快速版输出速度翻倍,价格同样翻倍;Cursor、Grok Build、Grok API、第三方编码框架与模型路由平台可用 | 首 token 延迟(Artificial Analysis 记录 high 档为 44.07 秒)在交互式场景里能否接受,以及长任务里的自查是否减少返工 |
| 小米 MiMo-V2.6-Pro / Flash 910 | 9 月 22 日凌晨(北京时间)发布并开源;MiMo 团队的全模态旗舰与高效档,官方称这是其探索「以可验证任务规模化扩展强化学习算力」的下一步 | Pro 为稀疏 MoE,总参 1.02 万亿、每 token 激活 420 亿,原生支持文本、图像、视频、音频输入,上下文 1M;一次混合强化学习同时覆盖编码、通用智能体、视觉与网络安全,单步使用 1,568 条 prompt × 16 次 rollout;官方同时开源权重、技术报告、强化学习环境与训练代码 | 官方自报 DeepSWE v1.1 71.9、Terminal-Bench 2.1 89.9、AutomationBench v1.0.6 53.1、Toolathlon-Verified 76.9、GDPval-AA v2.1 1673、OSWorld-Verified 82.0、CyberGym 94.0;官方称 Pro 以 46 分成为该榜开源权重模型最高分;Artificial Analysis 记录 Pro 每任务成本 $0.13,Flash 智力指数 38、每任务成本 $0.06 11 | 官方称 API 定价沿用 V2.5 系列;权重在 Hugging Face 与 ModelScope 以 MIT 许可发布,也可通过 AI Studio、MiMo Code、MiMo Desktop、官方开放平台与 OpenRouter 调用 | 自建部署的显存与吞吐(1.02 万亿总参、420 亿激活属于 16 卡级别的部署问题),以及全模态输入在自家文档流里的实际收益 |
| 通义千问 Qwen-Audio-3.1 系列 12 | 9 月 23 日发布;千问的语音模型家族一次更新五款,覆盖识别、合成、实时交互与音频创作 | ASR、TTS、Realtime 三条线全面升级;新增音频创作模型 TTS-Next,用人声、音效与环境音一次生成完整音频,支持 48kHz 输出与细粒度时间戳;新增音频理解模型 ASR-Next,可理解人物情绪、环境声与机械声;ASR 支持 30 种语言与 16 种中文方言,并带原生转写润色 | 官方口径下 ASR 在 KeSpeech 与 WSYue 的 11 个子集上平均字错误率 4.55%,中文方言内部测试集平均 10.38%,AST 平均语义句准率 82.10%,首字响应约 160 毫秒;这批数字与第三方榜单口径不同 13 | 每百万 token:ASR-Flash 输入 ¥0.8、输出 ¥2.7 14,TTS-Next 输入 ¥6、输出 ¥12 15,Realtime-Plus 音频输入 ¥40、文本输入 ¥5、纯文本输出 ¥40、文本加音频输出 ¥150 16;全线价格下调,TTS 约 70%、Realtime 约 85%、ASR 最高 95%;多数 API 已在千问 AI 平台上线,ASR-Next 的 API 尚未开放 | 自家音频按分钟折算后的实际成本变化,以及方言、中英混说场景下的字错误率 |
注:价格统一按美元或人民币原币列示,不做汇率换算。表格中「评测信号」一栏把厂商自报与 Artificial Analysis 的独立数据分列,两者口径不同;Artificial Analysis 的「每任务成本」是跑完智力指数的加权平均,OpenAI 表格里的「每任务成本」是 AutomationBench 单次任务的花费,两种数字不能直接比。
Claude Opus 5.5:顶档能力下移到 Opus 价位
Anthropic 在 9 月 22 日推出 Claude Opus 5.5,这是 Claude 5.5 系列的第一个模型,官方称它在多数工作上达到 Claude Fable 5.1 的水平,而默认设置下的运行成本比 Opus 5 低 40%。1
对 Agent 与编码场景来说,这次降价里最要紧的一项是缓存读取。它从 Opus 5 的每百万 token $0.50 降到 $0.20,降幅 60%;输入从 $5 降到 $4,输出从 $25 降到 $20,缓存写入从 $6.25 降到 $5。Anthropic 自己的说法是,缓存读取在 Agent 与编码成本里占大头,降价与每任务 token 用量减少合起来,才凑出 40% 的降幅。1
官方自报的跑分里,Opus 5.5 在 Terminal-Bench 4.0 拿到 66.4%(xhigh 档),CursorBench 4.0 为 57.8%,GDPval-AA v2.1 为 1846 Elo,AutomationBench 为 40.0%。Anthropic 在同一页里提示,能力到了这个档位之后,跑分差距已经不太能反映真实使用中的差别。1
第三方数据给出了它在榜单上的位置:Artificial Analysis 记录 Opus 5.5 的智力指数为 58,在 max 算力档上位列收录模型第一,输出速度 94 token/s,每任务成本 $5.98;把算力降到 low 档,智力指数落到 42,每任务成本 $0.55,同一模型的各档之间价差达到 11 倍。上下文窗口为 1M,输入支持文本与图像。2
交付方式上,Opus 5.5 在 API、Claude 应用与 Claude Code 即时可用,Fast 模式定价为每百万 token 输入 $8、输出 $40。生物与网络安全场景沿用 Fable 5.1 级别的护栏,经过审核的机构可以通过生命科学验证计划申请用于生物研究,网络安全验证计划将在未来几周扩大开放。1
GPT-6 Sol 与 Luna:价格对半,能力档位拆开
OpenAI 在 9 月 22 日把 GPT-6 家族扩到三个模型。GPT-6 Sol 与 GPT-6 Luna 用与 GPT-6 Astra 相近的方法训练,官方把这次发布的目标说得很直接:把 Astra 的能力摊到更便宜、更快的档位上。34
价格调整相对 GPT-5.6 的促销价砍掉一半:Sol 从每百万 token 输入 $4 / 输出 $20 降到 $2 / $10,Luna 从 $0.20 / $1.20 降到 $0.10 与 $0.50。3
随同发布的还有提示缓存的改进,它的账单影响可能不低于降价本身。GPT-6 系列默认给出更高的缓存命中率,30 分钟内复用的共享前缀可以拿到折扣,缓存输入读取最高省 90%;开发者可以用显式缓存断点指定哪一段前缀复用,也可以在对话中途调整推理强度、增删工具,早先的上下文继续可复用。17 GitHub 在同一个页面里说,过去几个月这些改动让需要重新处理的 prompt token 占比下降超过 50%。17
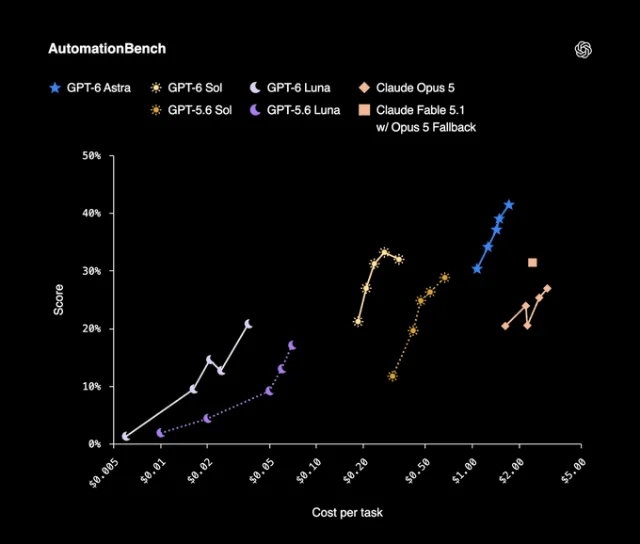
官方给出的关键对比是成本倍数:在 AutomationBench 1.0.6(Zapier 的一组跨 47 个工具的业务工作流测试)上,Sol 的 xhigh 档得 33.2%、每任务 $0.27,GPT-6 Astra 的 low 档得 30.3%、成本约为它的 3.9 倍,Claude Opus 5 的 max 档得 26.9%、成本约为它的 11.1 倍。3
软件工程这一侧,DeepSWE v1.1 上 Sol(max)得 68.8%,与 Claude Fable 5 的最高分 69.9%(xhigh)差 1.1 个百分点,每任务成本低约 80%;Luna(max)得 66.6%,官方称其水平接近中算力档的 Opus 5 与 Fable 5,而每任务成本分别低 93% 与 96%。3
第三方数据把两个模型放进同一把尺子里:Artificial Analysis 记录 Sol 的智力指数为 48、每任务成本 $1.06、上下文 872K,Luna 的智力指数为 37、每任务成本 $0.07、上下文 1M;Luna 的低算力档每任务成本为 $0.0045,是这批新模型里最低的一档。56
可用范围分三层:ChatGPT Work 与 Codex 当天面向 Plus、Pro、Business、Enterprise、Edu 用户开放,Free 与 Go 用户可以在桌面端用到 Luna,开发者通过 API 的
gpt-6-sol 与 gpt-6-luna 调用。两个模型暂时没有进入 ChatGPT 的主对话。3小米 MiMo-V2.6:开放权重里第一次出现全模态 Pro 档
小米 MiMo 团队在 9 月 22 日凌晨发布并开源 MiMo-V2.6 系列,包含旗舰的 MiMo-V2.6-Pro 与更小的 MiMo-V2.6-Flash,并同步放出超高速模式与桌面客户端正式版。团队把这代模型的目标写成「以可验证的复杂任务为基础,规模化扩展强化学习算力」。9
架构上,Pro 是稀疏 MoE(混合专家)模型,总参 1.02 万亿、每 token 激活 420 亿,上下文 1M,原生接受文本、图像、视频与音频四类输入。视觉侧是一个 6.81 亿参数的编码器,音频侧由 3.08 亿参数的音频分词器与 1.27 亿参数的音频块编码器组成,另外挂了一个五层、窗口 1024 的多 token 预测推测解码器,用来提升生成速度。10
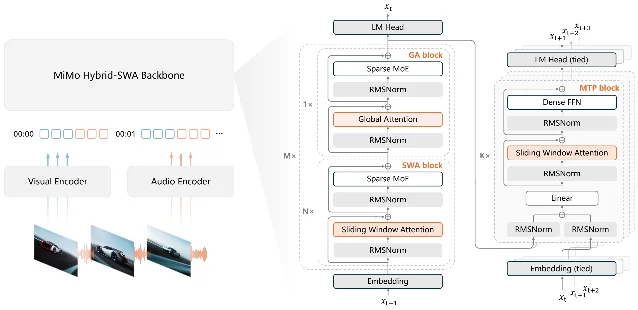
训练侧这次公开得比较细。Pro 与 Flash 用的是同一次混合强化学习:编码、通用智能体、视觉与网络安全四类任务混在同一批数据里,单步使用 1,568 条 prompt、每条 16 次 rollout。奖励信号分两层——离线用成对 rollout 生成任务专属评分细则,在线把优势重新分配给质量更高的通过轨迹,官方把这套机制称为「成组智能体评分」,用来在通过率之外拉开质量差距。此外还有一项多教师在线策略蒸馏,用来把能力扩展到难以自动验证的任务上。10
官方自报的评测里,Pro 在 DeepSWE v1.1 得 71.9,Terminal-Bench 2.1 得 89.9,AutomationBench v1.0.6 得 53.1,Toolathlon-Verified 得 76.9,GDPval-AA v2.1 得 1673,OSWorld-Verified 得 82.0,CyberGym 得 94.0。团队在同一批数据里放了 Claude Opus 5、GPT-5.6 Sol 与 Claude Fable 5 作对照。10
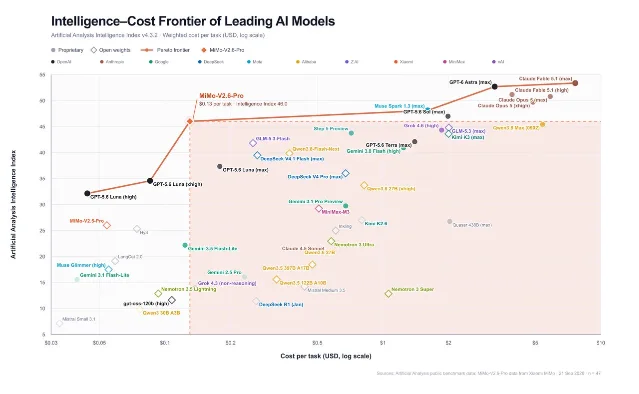
第三方这边,Artificial Analysis 记录 Pro 的智力指数为 46、每任务成本 $0.13,Flash 的智力指数为 38、每任务成本 $0.06,两个模型的上下文都是 1M。小米自己在发布时援引的也是这个 46 分,并称它是该榜开源权重模型的最高分。911
许可与获取方式这次给得比较开:权重在 Hugging Face 与 ModelScope 发布,许可为 MIT,技术报告、强化学习环境与训练代码一并开源;除自建部署外,还可以通过小米的 AI Studio、MiMo Code、MiMo Desktop、官方开放平台与 OpenRouter 调用。价格方面,官方称 API 定价沿用 V2.5 系列。910
Grok 4.7:换更大的底座,价格不动
xAI 在 9 月 21 日发布 Grok 4.7,官方称它换用了比 Grok 4.6 更大的底座模型,强化学习的训练时间更长,任务分布也更偏向需要数小时才能完成的问题。模型在自我核查与长上下文管理上做了针对性训练,并原生理解自家的 Grok Bot 工具框架。价格与速度维持 Grok 4.6 的水平。7
官方对照表里,Grok 4.7 的 xHigh 档在 CursorBench 4.0 得 46.3%,高于 Grok 4.6 的 40.4%;EEBench 得 64.0%,Grok 4.6 为 53.0%;Harvey Legal Agent Benchmark 得 19.6%,Grok 4.6 为 15.8%。同一张表里,它在 Terminal-Bench 4.0 的 37.6% 排在 Claude Fable 5.1 的 57.9% 之后。7
安全侧,官方称 Grok 4.7 用了全新的一套护栏,在 LatchBio 的生物安全基准上拿到 62.4%,在自家的 HackerBench v0.3 上只放行 3.3% 的高风险双用途提示,同时尽量少拦合法的安全工作。7
Artificial Analysis 记录它两个算力档的智力指数都是 46,输出速度 83 token/s,每任务成本 $2.73(high)与 $3.74(xhigh),上下文 500K。它还有一个值得单独看的数字:high 档的首 token 延迟为 44.07 秒,说明模型在开口前会先做较长的推理。8
获取方式上,Grok 4.7 当日在 Cursor 与 Grok Build 上线,同时可以通过 Grok API、第三方编码框架、模型路由与云平台调用。定价为每百万 token 输入 $2 起、输出 $6 起;官方另外提供一款输出速度翻倍的快速版,价格同样翻倍。7
通义千问 Qwen-Audio-3.1:语音模型一次更新五款
阿里通义千问在 9 月 23 日发布 Qwen-Audio-3.1 系列,一次性更新五款模型:识别、合成、实时交互三条线各升级一款,另加两款新模型。新的音频创作模型 Qwen-Audio-3.1-TTS-Next 把配音、音效与环境音合并成一次生成,支持 48kHz 输出与细粒度时间戳控制;音频理解模型 Qwen-Audio-3.1-ASR-Next 的处理对象从语音中的文字扩展到完整音频信息,可以理解人物情绪、环境声与机械声,并做声音描述、事件定位与音频问答。12
识别侧的升级集中在多语种与方言。Qwen-Audio-3.1-ASR 支持 30 种语言与 16 种中文方言,新增原生转写润色,可以自动去掉语气词与重复表达并重组语义,支持带说话人标签的分角色转写,首字响应约 160 毫秒。官方口径下,它在 KeSpeech 与 WSYue 两个公开方言测试集的 11 个子集上平均字错误率 4.55%,中文方言内部测试集平均 10.38%,AST 平均语义句准率 82.10%。13
价格是这次发布里最容易直接算清的部分。千问 AI 平台上的现行单价为:ASR-Flash 每百万 token 输入 ¥0.8、输出 ¥2.7;TTS-Next 输入 ¥6、输出 ¥12;Realtime-Plus 音频输入 ¥40、文本输入 ¥5、纯文本输出 ¥40、文本加音频输出 ¥150,上下文 262K,最大输入 245K、最大输出 16K。141516
相对上一代,全线价格的降幅为:TTS 约 70%、Realtime 约 85%、ASR 最高 95%。12 多数模型的 API 已经在千问 AI 平台上线,ASR-Next 的 API 还没有开放;这批评测数字来自官方口径,第三方语音榜单尚未收录新版本。13
本期其他条目
Google:Gemini 3.8 Live with Live Avatar 正式可用
Google 在 9 月 24 日宣布 Gemini 3.8 Live with Live Avatar 在 Gemini Enterprise 正式可用,提供美国与欧洲端点、预置吞吐与企业合规。Live Avatar 为视频对话智能体加上带唇形同步的视频形象,自定义形象需要单独申请白名单;模型支持 97 种语言并自动检测,可以在对话后台执行工具与 API 调用,同时处理实时摄像头画面与屏幕共享。所有生成的音频与视频都带 SynthID 水印。Gemini 3.8 Live Extended Thinking 仍在私测阶段。19
这一条属于 9 月 15 日发布的 Gemini 3.8 Live 从预览走向正式可用,能力描述在上期已经覆盖,本期的增量是可用范围与企业侧配套。19
MiniMax:M3.1-Flash-Preview 只在自家编码工具上线
MiniMax 在 9 月 27 日发布文本模型 M3.1-Flash-Preview,定位日常开发场景,当日只在 MiniMax Code 上线。官方公告没有给出跑分、上下文长度、API 模型名、token 价格与开放权重计划。20
OpenAI:GPT-6 的提示缓存改进
除模型发布外,OpenAI 在 9 月 22 日单独发布了 GPT-6 的提示缓存改进,新增缓存看板、未命中诊断与显式缓存断点,并允许在对话中途调整推理强度而不打断缓存复用。这条与 Sol、Luna 的降价配套,影响的是长会话与 Agent 的成本曲线。17
本期未纳入条目与覆盖说明
本期严格执行 2026 年 9 月 21 日至 27 日的时间窗核验,各厂商的筛查结果如下。
- DeepSeek:官方 API 更新日志与价格页在窗口内没有新条目,最新一条仍是 9 月 10 日的 DeepSeek-V4.1-Flash。21
- 智谱 GLM:官方开放文档的模型与产品发布记录,最近一条仍是 8 月 26 日上线的 GLM-5.3-Flash。22 中文媒体报道的 GLM-5.3-FlashX 发布于 9 月 18 日,落在本期窗口之前,因此不计入。23
- 月之暗面 Kimi:窗口内没有模型发布。有媒体在 9 月 24 日报道称 Kimi K3.1 计划下月推出,官方没有对应的发布页,本期只作为待跟进信号。24
- Meta:研究博客在窗口内只有一篇文章,讲的是 Muse 应用的产品侧内容,没有新模型。25
- Anthropic:除 Opus 5.5,官方在 9 月 23 日发布了一条科研进展(Claude 发现一类带 CRISPR 样重复序列的新型酶系统),属于科研进展,本期不作为模型条目计入。
- Google 的其他内容:窗口内没有新的基座或 Flash 模型发布;官方在 9 月 24 日对外表示 Gemini 4 会「尽快」推出,没有给出日期。26
- 通义千问的其他内容:模型级发布只有 Qwen-Audio-3.1 系列。9 月 22 日至 23 日的云栖大会上,阿里宣布 Qwen4 已在训练,并展示 Qwen-Image-3.1 与同传模型 Qwen3.8-LiveTranslate;前两者在窗口内没有发布页,LiveTranslate 也不在本次 Qwen-Audio-3.1 的发布列表里,本期都不作为条目。27
- OpenAI 的其他内容:9 月 23 日的 ChatGPT Ads 扩展到东南亚与台湾属于商业与产品动作,不是模型发布。3
- 小米 MiMo 官方发布页:官方博客页在抓取时只返回脚本外壳,本次发布事实取自官方 X 发布帖与官方 Hugging Face 模型卡,二者给出了架构、评测与许可的完整信息,价格沿用 V2.5 系列的说法来自官方发布帖。910
面向技术选型的三项行动建议
- 通用旗舰按每任务成本重跑一次自家任务集。 把 Claude Opus 5.5、GPT-6 Sol 与 MiMo-V2.6-Pro 放进同一批真实任务,记录成功率、总输入与输出 token、缓存命中率,再按各自的单价算每任务成本。三个模型的计价方式差别很大:Opus 5.5 的输入输出降了 20%,缓存读取降了 60%;GPT-6 Sol 的价格直接砍半并配了缓存折扣;MiMo-V2.6-Pro 的优势在于单价与开放权重。1311
- 开放权重这条线先验证部署,再谈替换。 MiMo-V2.6-Pro 是 1.02 万亿总参、420 亿激活的稀疏 MoE,自建部署先要算清显存、卡数与吞吐能不能覆盖自己的调用量;MIT 许可让商用与二次分发的门槛较低,权重、技术报告与训练代码都在同一个模型卡页面。10
- 语音链路的成本表要重算一遍。 Qwen-Audio 全线降价之后,ASR、TTS 与实时交互的每分钟成本都变了,按自家音频时长折算一次,再与 Gemini 3.8 Live 的音频定价对照。评估时把方言、中英混说与多人插话三种场景分开测,字错误率与打断后的恢复时间是这两个模型族差别最大的地方。1213
References
- 1Anthropic:推出 Claude Opus 5.5
anthropic.com
- 2Artificial Analysis:Claude Opus 5.5
artificialanalysis.ai
- 3OpenAI:推出 GPT-6 Sol 与 Luna
openai.com
- 4TechCrunch:OpenAI launches GPT-6 Sol and Luna
techcrunch.com
- 5Artificial Analysis:GPT-6 Sol
artificialanalysis.ai
- 6Artificial Analysis:GPT-6 Luna
artificialanalysis.ai
- 7
- 8Artificial Analysis:Grok 4.7
artificialanalysis.ai
- 9小米 MiMo:推出 MiMo-V2.6
x.com
- 10小米 MiMo-V2.6-Pro-RL 模型卡
huggingface.co
- 11Artificial Analysis:模型发布列表
artificialanalysis.ai
- 12
- 13智东西:阿里一口气上新 5 款千问模型
finance.sina.com.cn
- 14千问 AI 平台:Qwen-Audio-3.1-ASR-Flash
qianwenai.com
- 15千问 AI 平台:Qwen-Audio-3.1-TTS-Next
qianwenai.com
- 16千问 AI 平台:Qwen-Audio-3.1-Realtime-Plus
qianwenai.com
- 17OpenAI:GPT-6 的提示缓存改进
openai.com
- 18OpenAI 开发者社区:发布 GPT-6 Sol 与 Luna
community.openai.com
- 19Google Cloud:Gemini 3.8 Live with Live Avatar 正式可用
cloud.google.com
- 20
- 21DeepSeek API 更新日志
api-docs.deepseek.com
- 22智谱:模型与产品发布记录
docs.bigmodel.cn
- 23腾讯新闻:智谱发布 GLM-5.3-FlashX 的相关报道
news.qq.com
- 24新浪财经:消息称 Kimi K3.1 下月登场
finance.sina.com.cn
- 25Meta AI 研究博客
research.meta.ai
- 26
- 27开源中国:云栖大会开幕,Qwen4 已在训练
oschina.net
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.