Recursive 开源 Flint:40B 只激活 2.5B,M4 Pro 上 131 tokens/s,权重 Apache 2.0
Recursive 开源首个模型 Flint:39.8B 总参、每 token 只激活约 2.5B 的编码 MoE,48GB 的 M4 Pro 上跑 131 tokens/s,权重 Apache 2.0 可直接下载。

北京时间 10 月 21 日 21 点 51 分,Recursive 的第一批 Flint 权重出现在 Hugging Face;当晚 22 点 20 分,BF16 主仓建好;次日凌晨 6 点 10 分,官方博客上线。12
Flint 是一个 39.8B 总参数的混合专家模型,每个 token 只激活约 2.5B,输入输出都是文本,许可 Apache 2.0。3
官方给它的定位是一句话:在你自己笔记本上跑的编码 agent。1
按官方实测,它在 M4 Pro 的 MacBook Pro 上跑出 131 tokens/s(短上下文),在 64GB 的 NVIDIA RTX Spark 上 155 tokens/s。1
这台模型还有一个更少见的来源:Recursive 说 Flint 的架构、量化配方、推理内核几乎每一层,都由自家的自动化研究系统 Eureka Machine 提出并验证,一支小团队四个月从零做到发布。1
发布还不到一周,本地这条路才刚铺完。Ollama 上一个 23GB、256K 上下文的量化版可以直接拉,llama.cpp、LM Studio、Unsloth、vLLM、SGLang 各有入口,三个量化仓也已上架。45
先说结论
- 是什么:Recursive 的第一个模型,面向编码 agent 的语言模型,主打在自己的硬件上跑。3
- 规模:39.8B 总参数,每 token 约 2.5B 激活(含输出头;去掉输出头的骨干约 2.2B),词表 150,144。3
- 能不能拿到:Apache 2.0,免费下载;BF16 权重 79.6GB,另有 int4(22.6GB)、int4 GGUF(26GB)、NVFP4 GGUF(22.9GB)三个量化仓。2
- 官方分数:Terminal-Bench 2.1 54.9、SWE-bench Pro v2 89.7、SWE-bench Verified 74.2、LiveCodeBench v6 80.3、IFBench 89.2、IFEval 95.1。3
- 跑多快:M4 Pro 短上下文 131 tokens/s、128K 平均 68.9;一张 B300 或 H200 可以用仓里的 SGLang 套件起服务。13
- 谁做的:Recursive Superintelligence,CEO 是前 Salesforce 首席科学家 Richard Socher,今年 5 月以 46.5 亿美元估值融了 6.5 亿美元。6
- 缺什么:没有技术报告、没有第三方同口径复跑、没有按 token 的价目表、没有安全评估细节。3
快速核对
| 项目 | 内容 | 来源 |
|---|---|---|
| 发布时刻 | 2026-10-21:量化仓 21:51、BF16 主仓 22:20(北京时间),官方博客次日 06:10 | HF 元数据 · 官方博客 |
| 参数 | 39.8B 总参数 / 每 token 约 2.5B 激活(骨干约 2.2B) | 模型卡 |
| 架构 | 49 层,2 层稠密 + 47 层 MoE;256 路由专家取 6 + 1 共享专家;35 层滑动窗(513 token)+ 14 层全注意力 | config.json |
| 上下文 | 文档口径 262,144,输出预算 65,536;博客写「最高支持 512K,建议 256K 以内」 | 模型卡 · 文档 |
| 知识截止 | 2026 年 6 月 | 模型卡 |
| 许可 | Apache 2.0,权重可改可商用 | 模型卡 |
| 权重体积 | BF16 79.6GB(15 分片);int4 22.6GB;NVFP4 GGUF 22.9GB | HF 元数据 |
| 本地门槛 | rec 要 M4 Pro / M5 Pro / M5 Max,至少 48GB 统一内存,约 30GB 磁盘 | rec 文档 |
| GPU 服务 | 单卡 B300 或 H200,一副本一卡,走仓内 SGLang 套件 | 模型卡 |
| 免费托管 | OpenCode 免费档、Pi(经 Radius)、OpenRouter 免费条目;直接 API 只给合作方 | 发布资源 · OpenRouter |
| 现在该做什么 | 有 48GB 的 M4 Pro / M5 Pro / M5 Max,装 rec 后 rec launch pi 一条命令跑起来;只有 NVIDIA 卡,先看 NVFP4 GGUF 或 SGLang 套件 | rec 文档 |
本地能跑多快
官方那张速度图分两栏:左栏是 1K 短上下文的解码速度,右栏是 128K 会话内的平均速度。两个数差得很远,看哪个取决于你怎么用它。1
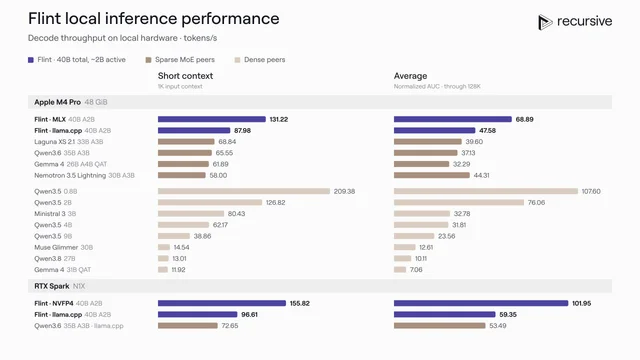
在 48GB 的 M4 Pro 上,Flint 用官方引擎 rec(MLX)跑 131.22 tokens/s,用 llama.cpp 跑 87.98;把上下文拉到 128K 平均,两者分别掉到 68.89 和 47.58。1
同一张图上,Qwen3.6 35B-A3B 是 65.55 / 37.13,Gemma 4 26B-A4B 量化版是 61.89 / 32.29,Nemotron 3.5 Lightning 30B-A3B 是 58.00 / 44.31。1
官方那句「比达到相近编码分数的 25–40B 稠密模型快五倍以上」,按图核算是这么来的:Qwen3.8 27B 稠密版在 128K 平均口径上只有 10.11 tokens/s,Flint 用 MLX 是 68.89(6.8 倍),用 llama.cpp 是 47.58(4.7 倍)。1
代价在门槛和并发上。rec 只认 M4 Pro、M5 Pro、M5 Max,至少 48GB 统一内存,引擎一次只处理一个生成请求,重叠请求会收到 429。7
RTX Spark 那条路现在还不能用 rec,官方写着「即将支持」,眼下要自己上 NVFP4 GGUF 或 SGLang。7
官方分数,和它对的那一组
六个基准里,Flint 报的是 54.9、89.7、74.2、80.3、89.2、95.1。采样参数全统一在 temperature 1.0、top-p 0.95、top-k 20,agent 类评测至少跑五次取 pass@1 平均。3
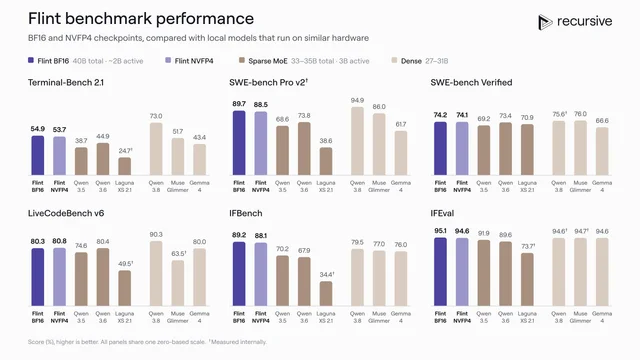
对照组的身份决定了这些分数的意思。官方那句「50B 以下最强 MoE」的范围是 agentic 编码基准;按图核对,Flint 在 SWE-bench Pro v2、SWE-bench Verified、Terminal-Bench 2.1 三项上都高过 Qwen3.5 35B-A3B、Qwen3.6 与 Laguna XS 2.1。13
非 agentic 的三项里有一处失手:LiveCodeBench v6 上 Qwen3.6 是 80.4,比 Flint 的 80.3 高 0.1 分。3
换成稠密对手,局面就分开了。Qwen3.8 27B 在 SWE-bench Pro v2 拿到 94.9(Flint 89.7)、SWE-bench Verified 75.6(74.2)、LiveCodeBench v6 90.3(80.3)、Terminal-Bench 2.1 73.0(54.9),六项里赢下四项;Muse Glimmer 30B 在 SWE-bench Verified 上以 76.0 对 74.2 领先。3
Terminal-Bench 这 18 分差距要打折看。Flint 这一格用的是 Terminus 2 这套 agent 评测框架、允许联网,但把通过检索拿到的解一律算作失败;模型卡也写明竞品分数多为开发者自报,未必做了同样处理。3
把六项平均起来,Flint 是 80.6,Qwen3.8 27B 是 84.7。TechCrunch 当天的写法与此一致:「在 Recursive 自己那套六项平均上,只有阿里的 Qwen3.8 27B 比 Flint 高。」8
所以它的位置很清楚:同样的硬件预算里,六项均值比 Qwen3.8 27B 低约 4 分、比 Muse Glimmer 30B 高约 6 分。
量化版掉多少
本地多数人会下量化版,所以 NVFP4 与 BF16 的差距值得单看。六项里逐项最大差 1.2 分(Terminal-Bench 54.9→53.7、SWE-bench Pro v2 89.7→88.5),六项均值差 0.6 分(80.6→80.0)。3
官方博客的表述是「各项在 0.7 分以内」,按上图逐项读,两格超过这个数。1
这个量化配方本身是 Eureka Machine 找出来的。它把输出层(lm_head)也压到 4 bit——常规做法会留着这一层——理由是 2.5B 激活里输出头占比很高,每次生成都要读它。1
压完再来一轮离线蒸馏:让量化模型在自己挑出的核心样本上重训,用 16 bit 版本当老师。官方说这一步把训练步数压到常规量化感知训练的一半左右。1
实际可下的三个仓:int4 权重 22.6GB,int4 GGUF 26GB(GGUF 是 llama.cpp 系运行时用的量化文件),NVFP4 GGUF 22.9GB(NVFP4 是英伟达的 4 位浮点格式);Ollama 上的默认标签是 23GB、256K 上下文,对照 79.6GB 的 BF16,那是量化后的体积。4910
架构细节与三个上下文口径
49 层里前两层是稠密层,其余 47 层是 MoE:每层 256 个路由专家,每个 token 取 6 个,另加 1 个始终激活的共享专家。11
注意力分两种:35 层滑动窗,窗口 513 token(当前 token 加前 512 个);14 层全注意力。32 个查询头、4 个 KV 头,每头 128 维。3
更少见的是位置编码的位置。旋转位置编码只加在 35 层滑动窗上,14 层全注意力里一层都没有——config 里的
no_rope_layer_indices 正好 14 项。11也就是说,模型的长程位置信息全靠那些局部窗口层层叠加传出去。11
上下文有三个口径,得一起看:模型卡与 config 写 262,144;文档说托管版 262,144、输出预算最多 65,536;博客却说「最高支持 512K,建议待在 256K 以内」。512K 在已发布的配置文件里没有对应的设置。1312
谁能用,花多少钱
权重这条路最干净:Apache 2.0,下载即用,不联网、代码不出本机。3
小团队直接蹭免费托管也行:OpenCode 有免费档,Pi 走 Radius 免费,OpenRouter 上有一个
recursive/flint-v1.0:free 条目,262,144 上下文,定价栏是 0。514官方自己的 API 只给少数合作方,没有公开价目表。15
第三方怎么看
Artificial Analysis 与 Vals Index 到今天都还没有 Flint 的条目(按 flint、recursive 检索均无结果),Hugging Face 上也没有接入任何推理提供方。316
目前最接近独立评测的是一台机器的实测。Wired 的 Will Knight 在 48GB 的 Mac 上用了几天。
他做了命令行待办、一个抓研究资料的爬虫、一个讲递归自我改进的静态站,原话是「每一次编码请求都答对了」。6
TechCrunch 的补充是速度对照组:Flint 在 M4 Pro 上约 131 tokens/s,大约是 Gemma 4 与 Nemotron 3.5 Lightning 在同一台机器上 58–69 tokens/s 的两倍。8
该不该试
- 手上是 48GB 的 M4 Pro / M5 Pro / M5 Max:现在就装 rec,
rec launch pi一条命令把模型和 Pi 一起配好,先拿一个熟悉的小仓库试「解释一个函数、补一个测试、修掉测试暴露的问题」。7 - 只有 NVIDIA 卡:跳过 rec,走 NVFP4 GGUF 或仓里的 SGLang 套件,单卡 B300 / H200 一副本。310
- 在挑选型、要写进文档:能引的只有官方自测与 Wired 的定性实测,第三方同口径分数还没有;同尺寸稠密对手里 Qwen3.8 27B 的六项均值更高,速度低一个数量级。8
- 在意数据不出本机:Apache 2.0 加本地推理这条路是这次最实的东西,代码与提示词都不必经过任何服务器。3
- 只是想知道行业走到哪:记两件事——一个四个月、小团队、靠自动化研究系统造出来的 40B 模型,已经能在笔记本上跑到可用速度;这类系统的卖点开始从「论文」变成「能下载的权重」。6
还没有的数字
References
- 1Introducing Flint
recursive.com
- 2HF 仓库元数据
huggingface.co
- 3Flint 模型卡
huggingface.co
- 4Ollama: flint
ollama.com
- 5Flint 文档
docs.recursive.com
- 6Wired 报道
wired.com
- 7rec 文档
docs.recursive.com
- 8TechCrunch 报道
techcrunch.com
- 9flint-int4
huggingface.co
- 10flint-nvfp4-gguf
huggingface.co
- 11config.json
huggingface.co
- 12Flint 文档
docs.recursive.com
- 13rec 仓库
github.com
- 14OpenRouter 条目
openrouter.ai
- 15发布资源
docs.recursive.com
- 16Artificial Analysis 榜单
artificialanalysis.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.