H-JEPA!LeCun世界模型创业交卷,代码权重全部开源
LeCun 的创业公司 AMI 交出世界模型论文 H-JEPA:多个 JEPA 叠成层级、高层给低层发子目标,Visual AntMaze 迷宫成功率从 18% 升到 73%,代码、权重和数据一并开源。

本文转载自微信公众号「量子位」2026 年 10 月 10 日推送,作者:henry(发自 凹非寺 量子位 | 公众号 QbitAI)。原文:《H-JEPA!LeCun 世界模型创业交卷,代码权重全部开源》
LeCun 的世界模型创业公司 AMI(Advanced Machine Intelligence),刚刚低调交卷了1。
论文叫 H-JEPA,由 AMI 联合纽约大学、巴黎 INRIA 和布朗大学的研究者完成,署名作者共五位2。
它做的是「分层世界模型」:把多个 JEPA 一层层堆起来,让每层在自己的表征空间里,预测不同时间跨度之后的状态。
规划时从上往下走。高层先定粗略计划,再把预测出的中间状态当成子目标交给低层,低层接力细化,最后输出可执行的动作。
在 Visual AntMaze 仿真迷宫任务里,三层 H-JEPA 的成功率达到 73%,单层模型只有 18%。分层模型还用更少的规划计算量,拿到了更好的成绩2。
为什么世界模型要分层?
这件事,LeCun 念叨很久了。
早在 2022 年还在 Meta 当首席 AI 科学家时,他就提出过分层 JEPA 的构想:让模型在不同抽象层级、不同时间尺度上预测,再通过分层规划,把复杂目标落实成动作1。
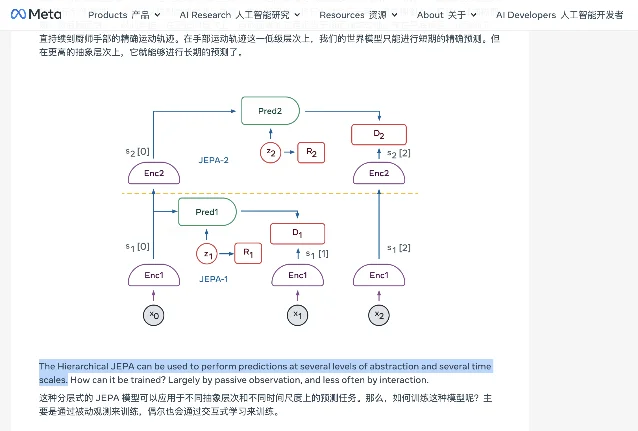
他常用的例子是一趟出差。
先定目的地、航班和时间安排;定完再安排怎么离开办公室、下楼、打车去机场;真走出办公室时,要关心的又变成了眼前的地面和下一脚落在哪。
这三层覆盖的时间跨度和需要的信息都不一样。规划航程时,某一级台阶有多高并不重要;真的下楼时,这个细节直接决定你迈哪只脚。
机器人也一样。高层要理解任务目标、环境关系和未来方向,低层要掌握具体动作和身体控制细节。
原文举了个反例:四足机器人明明已经走到目标位置,只因为腿部姿态与目标画面不同,模型仍可能判断自己离目标很远。
问题于是变成一句话:怎么让不同层级各自学到适合自己的表征,再把高层计划逐步落实成动作?
H-JEPA 具体怎么做?
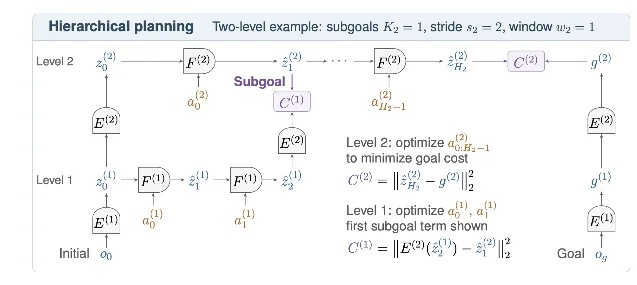
H-JEPA 给每一层配了三个组件,分别管状态、动作和预测。
状态编码器提取当前环境的表征。最低层直接读图像,更高层基于下层表征继续抽象,只保留这个时间尺度上更重要的信息。
动作编码器描述动作带来的变化。低层表示具体动作,高层把一段连续动作压成更粗粒度的变化。
预测器结合当前状态和动作,预测未来状态。不同层级覆盖不同时间跨度,论文实验里,高层走一步对应低层走两步。
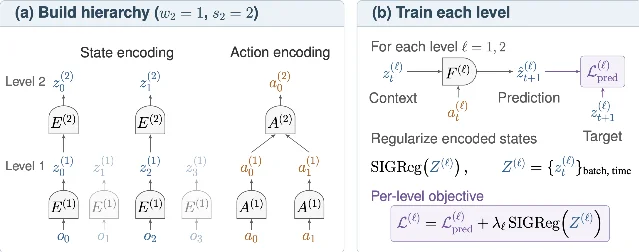
训练时各层端到端一起学,靠子目标衔接:高层预测出的状态就是低层的子目标,低层把自己的预测换算到高层表征空间,和子目标比一比,再照着调整动作。
训练世界模型还有一个经典麻烦:表征坍塌。
如果编码器把什么输入都压成同一个向量,预测器照着输出这个向量,误差也能很低,但模型其实什么都没学到。
H-JEPA 沿用了 LeCun 团队在 LeJEPA 里提出的 SIGReg,对表征分布加约束,避免不同状态被压成同一个向量。
73% 是怎么跑出来的?
成绩来自四个仿真环境,和一批真机视频。
- Visual AntMaze:视觉迷宫导航,三层 73%,单层 LeWM 只有 18%;
- FourRoom Distractors:带干扰物的房间导航,加层数后成功率与算力的权衡更好;
- OGBench Cube:抓取操作,同样分层占优;
- Push-T:推方块操作,两层最好,加到三层、四层成绩反而下降。
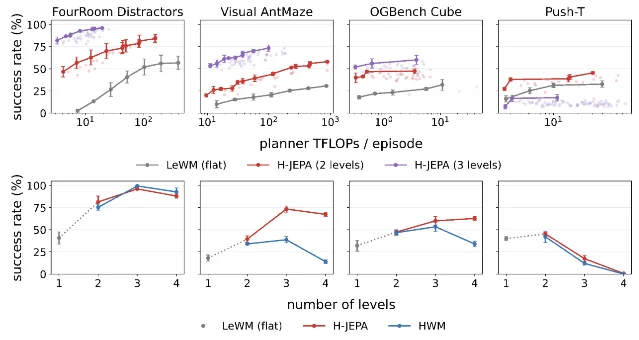
前三个环境的规律一致:层数加到三层,规划器用更少的算力就能换到更高的成功率。
Push-T 是例外,层数越多成绩越差。论文认为,短任务轨迹限制了高层可用的训练数据。
原文还提到一个细节:在迷宫任务里,层级越高,腿部姿态越难被还原,但机器人的位置信息保留得很好。
据论文项目主页,这种「选择性抽象」在时间尺度分离明显的任务上最有效;操作类数据集的时间频率差得比较小,选择性就没那么明显5。
真机这边用的是 DROID 数据集。团队加了一项逆动力学损失,用来预测连接相邻潜状态的动作,再在真机视频上做离线规划。
要留意评价口径:这里的指标是 Fréchet 保真度,比的是整条末端执行器路径与专家轨迹的接近程度,不是闭环任务成功率5。
开源了什么?
- 代码:kevinghst/H-JEPA 仓库里是训练与规划代码,覆盖四个仿真环境和 DROID 离线规划,说明称可复现论文 Figure 6 下排、Table 1、Table 9 与 Figure 9(b);
- 预训练权重:Hugging Face 上按环境分四组,每组 7 个模型、3 个随机种子、共 21 个检查点,另有 9 个 DROID 检查点;
- 数据与评测任务:Visual AntMaze、FourRoom Distractors 的数据集,以及每个环境 50 个起点/终点任务。
代码建立在 LeWM 与 stable-worldmodel 两个开源项目之上,不是从零搭起来的一套东西3。
LeCun,还是那个 LeCun
H-JEPA 延续的是 JEPA 一直以来的主张:在表征空间里做预测。
LLM 靠预测下一个 token 学生成;视觉 JEPA 先把图像、视频编码成内部表征,再预测目标部分的表征,不用逐个生成像素。
LeCun 对这条路的坚持,在 ECCV 2026 上又出现了一次。今年 9 月在瑞典马尔默,他的演讲幻灯片里有一页「给 AI 科学家的建议」,最后一行是红字:
如果你对人类级 AI 感兴趣,就不要研究 LLM。
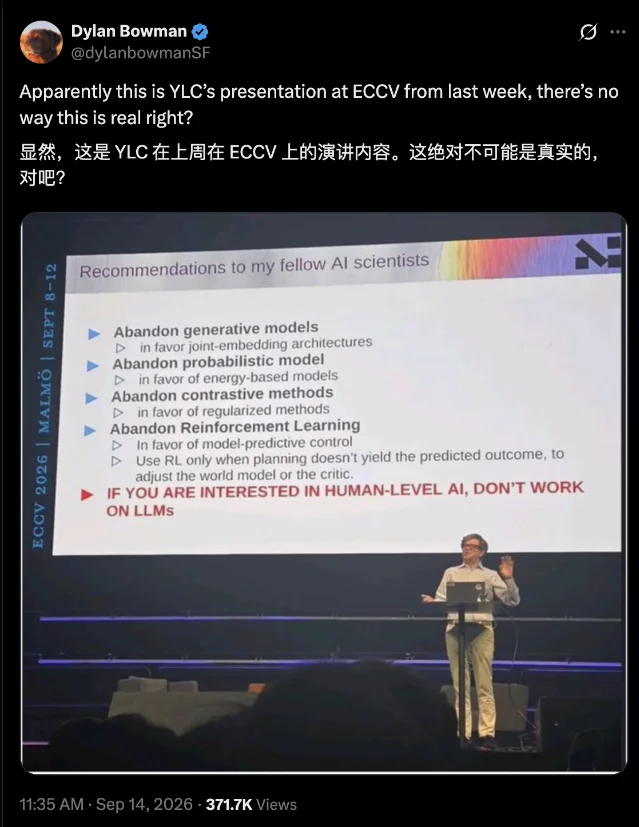
这张幻灯片传到社交平台后,有人怀疑是假的。LeCun 回复:包是真的。
他随后补充,基于 LLM 的 AI 工具非常有用,大家都在用;但他认为,单靠 LLM 本身无法走到人类级智能。
AMI 官网把目标列成了四条:理解真实世界、有持久记忆、能推理和规划、可控且安全6。
团队这边,LeCun 担任董事长,Alexandre LeBrun 任 CEO,谢赛宁任首席科学家,Pascale Fung 负责研究与创新,Michael Rabbat 负责世界模型——Rabbat 也是这次 H-JEPA 论文的作者之一6。公司在巴黎、纽约、蒙特利尔和新加坡都有团队。
今年 3 月,AMI 宣布完成 10.3 亿美元融资,投前估值 35 亿美元7。
不过论文归论文,外界对 AMI 的另一个期待仍然是产品。
至少从官网看,目前能点的只有联系、招聘和办公地点,没有面向公众的产品入口。
另一边,同样押注世界模型的 World Labs 已经走向和芯片公司的结合:9 月 28 日,AMD 宣布与李飞飞创办的 World Labs 签下约 82 亿美元的全股票收购协议8。
一家往芯片公司里走,一家沿着自己的研究路线往前推。
原文里的话
两句原话,留在这里。
我们有一个共同的信念:真正的智能并非始于语言,它始于世界。
这句出自 AMI 官网首页,英文原文是「We share one belief: real intelligence does not start in language. It starts in the world.」
当数据中的因素以分离的时间尺度演化时,更高的层级会丢弃快速、不可预测的细节,保留与任务相关的慢变量。
这句译自 H-JEPA 论文摘要(英文原文:When factors in the data evolve at separated timescales, higher levels discard fast, unpredictable detail and retain slower task-relevant state)2。
论文交出来了,代码和权重也放出来了。剩下的问题是那句常被拿出来问 LeCun 的话:大结果什么时候变成能用的东西。
References
- 1H-JEPA!LeCun世界模型创业交卷,代码权重全部开源
mp.weixin.qq.com
- 2
- 3kevinghst/H-JEPA
github.com
- 4jepa-world-models/h-jepa
huggingface.co
- 5H-JEPA 项目主页
h-jepa.com
- 6AMI Labs
amilabs.xyz
- 7
- 8AMD to acquire World Labs
newsroom.amd.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.