奇绩信号Alpha Sight 2026年10月30日【文字版】
从 2026 年 10 月 28 日 arXiv 最新批次精选十五篇论文:把「提升」拆开算账——数据筛选是加能力还是只加速度,同一批选择方法在有缺口时从十四点四九跳到二十七点零六,而工具输出有三成在到达模型之前就被截断。

本期从 2026 年 10 月 28 日在 arXiv 公开的最新提交批次中精选十五篇 AI 论文。
cs.AI recent 分组首日为 Wed, 28 Oct 2026,该批二百五十四条。
AI 科技评论注意到,这一天有一组论文在查同一件事:被当成「能力提升」的那个东西,到底是在哪一段路上产生的。
数据筛选是加能力还是只加速度。预训练里的知识是什么时候学进去的。有结构的解法和只给样例的学习器差在哪。
还有三处更靠下游:微调数据里哪些样本在悄悄侵蚀安全,工具输出在到达模型之前被截掉了多少,coding agent 的分数里有多少只是把规格写全了。
五篇头条里有四篇站在这个方向上,再算上认知模型、Agent 与 Benchmark 各一篇,本期有七篇在同一个方向上把「提升」拆开算账。
其余论文按板块排开。一个冻结的 MoE 模型里路由出不同的推理路径,视觉到化学式的跨模态迁移,把动作当成视频 patch 的世界动作模型。
再往下是在改过物理定律的模拟世界里做自由探索、MoE 训练的损失尖刺、前缀缓存的淘汰策略、工业级生成式多模态检索,以及一个用规格完整度解释 agent 增益的临床基准。
我们按头条、认知模型、多模态、具身智能、AI4Science、Infra、Agent、应用体系、Benchmark 九个板块呈现本期内容。
头条
1. 数据筛选是加能力还是只加速度——先算一个缺口,再决定要不要花这笔钱原文
信号源:京东、牛津大学
🧾
认知提取
数据策展这几年被当成免费的性能来源:配比调一调、样本筛一筛,榜单就涨。
这篇论文问了一个更基础的问题——筛掉的样本,是让模型「能学到更多」,还是只让它「更快到同一个终点」。前一种叫 advancement,后一种叫 acceleration。
作者的答案是可以事先算的:如果未策展的训练目标和真正想评测的目标之间本来就有可纠正的差距,策展才抬得动终点;两者重合时,再聪明的筛选也只是加速。
论文摘要
• 用教师—学生模型做解析刻画:目标分布由目标教师定义,训练分布由各域教师按权重混合得到,两者夹角就是缺口 Δ。原文第 3 节
• 得到命题:无缺口时,任何配比策略在无穷训练预算下都收敛到同一个终点;有缺口时,配比改变可达性能。原文 A.3 节
• 把条件操作化成 Δ-test:在昂贵的策展之前,用未策展基线在训练集与目标集上的损失差估计 Δ。原文第 4 节
• 在数据配比与数据选择两条主线上分别验证:Δ 接近零时增益随预算增长而消失,Δ 明显非零时增益持续存在。
核心方法
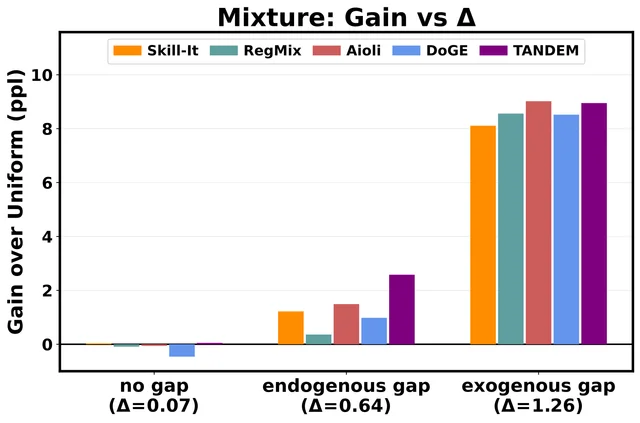
• 配比实验:160M 与 1.1B 模型,SlimPajama 七个子域,四万步、batch 8、上下文长度两千零四十八,比较 Uniform、RegMix、DoGE、Skill-It、Aioli、TANDEM。原文表 5
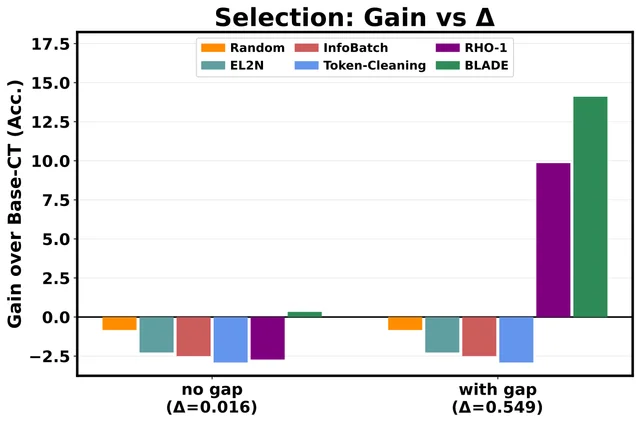
• 选择实验:TinyLlama-1.1B,5B token 候选池,保留比例零点六,五千步,比较随机、EL2N、InfoBatch、Token Cleaning、RHO-1、BLADE。原文表 6
• 缺口由目标集构造:同一分布的 OpenWebMath 目标(Δ=0.016)与偏移的 MetaMath–Mammoth 目标(Δ=0.549)。原文表 4
• 全部数字是五次运行;Δ 的估计只用未策展基线,不依赖任何候选方法。
实验成果
• 无缺口配比(Δ=0.07):Uniform 平均困惑度十九点七一,五种策展方法的平均困惑度落在十九点六六到二十点一七之间,跨度小于一个标准差。原文表 1
• 内生缺口(Δ 零点六四):TANDEM 二十六点零二、Aioli 二十七点一一,对 Uniform 二十八点六零。原文表 2
• 外生缺口(Δ=1.26,留出 CommonCrawl 作目标):Uniform 四十九点一九,Aioli 四十点一七、TANDEM 四十点二四、RegMix 四十点六三。原文表 2
• 选择无缺口(Δ 零点零一六,八项数学基准平均):Base-CT 十七点二一,BLADE 十七点五四,RHO-1 十四点四九,其余方法都在十四到十七之间。原文表 4
• 选择有缺口(Δ 零点五四九):RHO-1 从十四点四九跳到二十七点零六,BLADE 从十七点五四跳到三十一点三一;随机与 EL2N 仍停在十六点三八与十四点九四。原文表 4
总结与反思
• 结果总结:策展能不能抬高终点,取决于任务本身有没有可纠正的训练—目标缺口;没有缺口时它只买单程票,把到达时间提前。
• 局限性:Δ 需要先定义目标集,而目标集本身就是产品判断;作者的实验集中在语言建模困惑度与数学问答,理性推理类任务没有覆盖。
• 前沿见解:把「构造目标集」当成策展的一部分来做,比继续改进选择器更可能拿到终点上的提升。
2. 越「不稳定」的知识反而后学到——预训练里两类知识的曲线不一样原文
信号源:宾夕法尼亚大学、伦敦大学学院人工智能中心
📈
认知提取
预训练到底学到了什么,通常看聚合分数:榜单涨了几点,就知道模型变强了。
这篇论文换了一个探针:用按年份网络快照分别训练的「时间点模型」,看同一条知识在不同年份语料里的似然有多不稳定。把这个变异系数记成 TVS。
结论有点反直觉——越不稳定的知识,早期学得并不更快,但后期涨得更快,到训练末尾反而系统性领先。
论文摘要
• TVS 定义为一条样本在多个时间点模型上的负对数似然的变异系数;越高说明这条知识在跨年语料里越不一致。原文第 2 节
• 六个基准、六个开源模型家族,共三十六个「模型×基准」设置、一万六千二百三十九条样本。
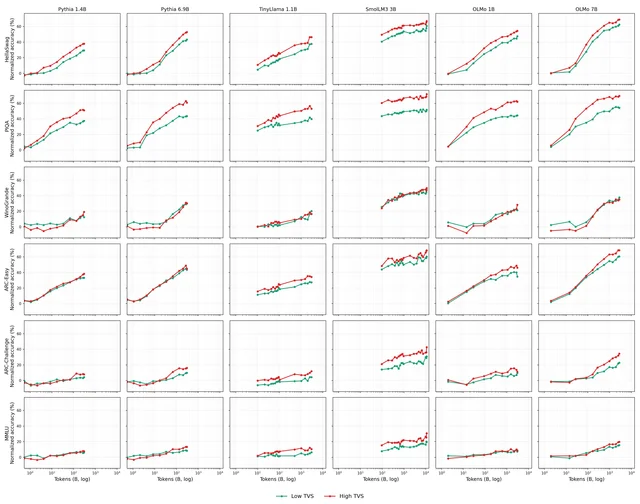
• 早期检查点上两组没有区别:低 TVS 组领先的设置有十三个(共二十四个),高 TVS 组的优势出现在训练后段。
• 最终检查点:高 TVS 组在三十四个设置里领先,平均高七点三点机会归一化准确率。原文表 2
• 这个信号不能被「题目更难」解释:按平均负对数似然分层时方向相反,难度分层是高 NLL 组全线落后三十一点一点。
核心方法
• 用 PIT 系列时间点模型算每条样本的 TVS,六个基准统一用机会归一化准确率做因变量,长度分箱后再比较。
• 三条对照:按平均负对数似然分层、按问题本身的 TVS 分层、按「金标答案相对最强错误答案的 TVS 边际」分层。原文表 5
• 用分层回归与每标准差效应量控制难度、长度、困惑度变异等混杂。原文表 4
• 检查点覆盖 Pythia 与 OLMo 的早期权重,以及另外四个模型家族的最终权重。
实验成果
• 最终检查点:高 TVS 组在三十四个设置里领先,平均高七点三点;若按平均负对数似然做残差化,仍剩二十六比三十六与三点七点。原文表 2
• 边际版本更强:按「金标答案比最强干扰项更不稳定」分层,三十六个设置全部领先,平均高十二点三点。原文表 3
• 只用问题本身的 TVS 分层,优势缩到二十六比三十六与二点一点,说明信号主要来自答案而不是题干。原文表 3
• 也是反例的地方:按 NLL 标准差分层方向反了(八比三十六、负二点六点),说明「离散」本身不等于「可变」。
• 逐基准每标准差效应:ARC-C 加零点零二四、HellaSwag 加零点零一九(两者的 p 都在零点零五以内),MMLU 只有加零点零零一(p 约零点八,不显著)。原文表 4
总结与反思
• 结果总结:知识在预训练中不是同步学会的;跨年语料里不稳定的事实性知识,其收益集中在训练后段,聚合分数会把这段差异抹平。
• 局限性:TVS 依赖时间点模型的可得性与质量;作者也承认语料污染会影响分层,因此另做了污染检查,但没有把结论推到时序推理类任务。
• 前沿见解:如果把「训练到第几个检查点就够用」当决策问题,那决定因素可能是数据里时间敏感知识的比例,而不是总 token 数。
3. 有结构的解法与只给样例的学习器之间,隔着一道补不平的缺口原文
信号源:伊利诺伊大学芝加哥分校
📐
认知提取
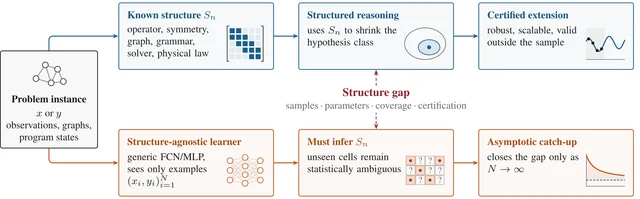
一个流行的信念是:模型足够大、数据足够多,显式领域知识就可以省掉。
这篇论文把这个信念缩小到一类任务上检验——输入输出关系由已知结构决定的任务,比如已知算子的反问题、稀疏恢复、图可达性、受物理定律约束的系统。
结论是渐近式的而非绝对的:数据可以逼近结构化解法,但任何有限数据集都留着一块结构本来就能消掉的残余不确定性。
论文摘要
• 定义「结构编码问题」:映射由求解器、对称群、图、物理定律、测量算子、文法、组合搜索空间或优化目标确定或强约束。
• 关键区分不在表达能力——稠密网络可以容纳那个映射——而在有限数据下的辨识、外推与认证。
• 三条结论:高斯反问题中已知算子的 Wiener 解达到 Bayes 风险,而同类线性类里的稠密经验学习器存在持续的超额风险(定理 1);一条单元覆盖下界;未观测轨道不可辨识。
• 数值实验覆盖已知算子反演、稀疏恢复、图可达性与尺寸外推。
核心方法
• 理论部分用高斯逆问题的解析解与经验风险对比,得出「有限数据下结构解与学习器之间的持续差距」。
• 单元覆盖下界把差距写成「需要覆盖多少个格子」,与参数量无关。
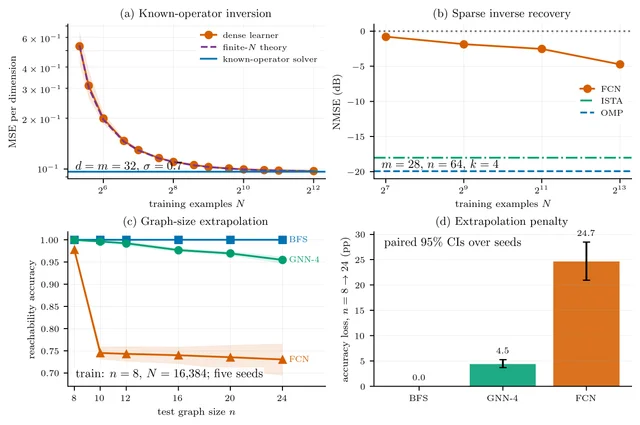
• 实验设定:图可达性用八个节点的图训练(训练集一万六千三百八十四条),测到二十四个节点;对照 BFS、全连接网络、四层与八层消息传递网络。
• 稀疏恢复与已知算子反演用于把「结构性先验省掉了多少样本」单独量化。
实验成果
• 图可达性(N=16,384,五个种子):BFS 在八节点与二十四节点都是百分之一百;全连接网络从九十七点七九掉到七十三点零五,损失二十四点七四个百分点。原文表 S2
• 消息传递网络好得多但仍会掉:四层从九十九点九七掉到九十五点四八(损失四点四九点),八层从九十九点九八掉到九十六点零三(三点九五点)。原文表 S2
• 已知算子反演里,稠密学习器的样本复杂度和定理 1 的预测一致,随覆盖率提升而缓慢下降但不到零。
• 论文自陈:数值部分是「机制的实例化」,不是对所有结构类任务的普适下界。
总结与反思
• 结果总结:对结构编码任务,「更多数据」与「把结构写进去」不是同一条路径上的快慢之别,而是有限资源下能否认证的区别。
• 局限性:结论限定在结构已知且可验证的情形;真实任务里结构往往只能部分识别,论文没有给出部分结构可用的定量判据。
• 前沿见解:模型规模之争会继续,但在这类任务上更值钱的问题是「哪些结构可以被写成代码或约束」,而不只是「再训多少 token」。
4. 安全退化能从看似无害的数据里追出来——删掉两成样本,攻击成功率降最多二十二个百分点原文
信号源:DatologyAI、伊利诺伊大学厄巴纳-香槟分校
🧯
认知提取
用指令数据做微调会悄悄削弱安全,而退化的来源往往没有任何一条样本看起来有害——内容过滤器抓不到它。
这篇论文的办法是给每条样本算一个梯度嵌入,看它的梯度方向与「不安全回答」有多对齐,然后按对齐程度删样本。
删掉两成之后,三个模型家族的 GCG 攻击成功率都降了,能力指标没有掉。
论文摘要
• SimpleLoRIF:把低秩归因方法简化,反向传播只到最末四层,从而能在百万量级样本上算梯度嵌入。原文第 3 节
• 在涌现性失配上先做验证:不安全代码的训练数据与微调后出现的有害行为,在梯度空间里可以连起来,AUC 最高零点八六五。
• 用它对 Tulu 3 做 20% 过滤,得到 SafeTulu;与随机删除、LLM 裁判过滤、已有梯度过滤(He 等)四项对照。
• 被删样本的分布本身有信息:数学子集被删的比例明显低于裁判的均匀删除。原文表 2
核心方法
• 先训练一个「不安全参考」,再对每条训练样本求与不安全回答的梯度对齐分数,排序后按预算截断。
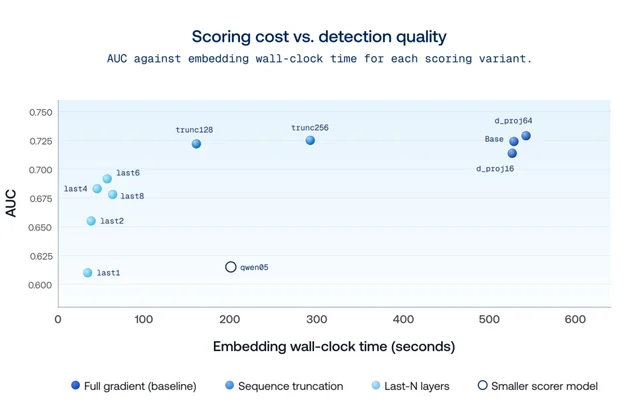
• 只回传最后四层,把单样本成本压到可以扫完整套后训练数据;打分成本与检测质量的权衡单独画了曲线。原文图 1
• 评估四个模型:Qwen 3 1.7B、Llama 3.2 1B、Olmo 2 1B、Llama 3.1 8B;安全用 GCG 与 ActorBreaker 攻击成功率,能力用 MMLU Pro 与 IFEval。
• 全部实验在 20% 删除预算下进行,对照方法共用同一预算。
实验成果
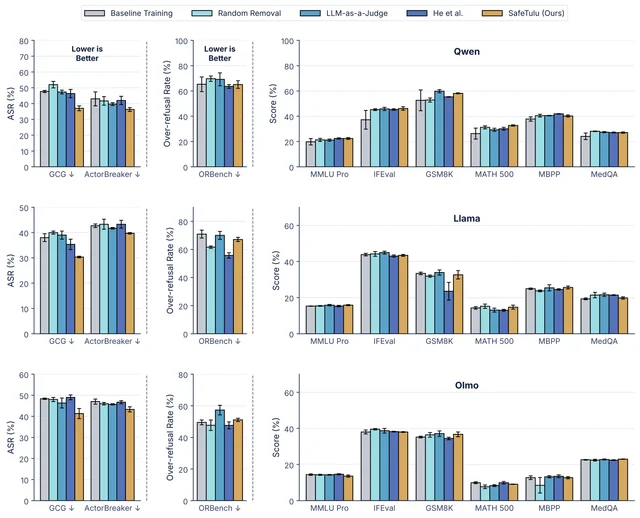
• Qwen 3 1.7B:GCG 攻击成功率从四十七点六七降到三十七点零零,随机删除升到五十二点零零,LLM 裁判四十七点三三,He 等四十六点三三。原文表 1
• Llama 3.2 1B:三十八点零零降到三十点三三,同批对照里只有 He 等接近(三十五点三三)。原文表 1
• Olmo 2 1B:四十八点三三降到四十一点三三,裁判方法与 He 等分别停在四十六点三三与四十九点零零。原文表 1
• 能力没有换代价:Qwen 的 MMLU Pro 从十九点八升到二十二点四,IFEval 从三十七点二升到四十六点一。原文表 1
• 删除分布不是均匀的:hard_coded 类被删百分之五十四点二(裁判百分之八十七点五),数学子集只在百分之七点九到十九点四之间,低于裁判的百分之十五上下。原文表 2
总结与反思
• 结果总结:安全退化可以被定位到具体训练样本,且定位信号不是内容语义而是梯度对齐;在两成删除预算下,这比按内容过滤更有效。
• 局限性:参考模型的选择会决定打分方向,论文只用一个不安全参考;Llama 3.1 8B 上的提升幅度明显小于小模型,规模效应没有解释清楚。
• 前沿见解:后训练数据配比的下一个必填项,可能是「这批数据与哪些行为对齐」而不只是「这批数据质量几分」。
5. Timestral:四个模型全部站在帕累托前沿上——全合成预训练加解耦视界的组合原文
信号源:Mistral AI(原论文 arXiv 版本未展开机构署名;论文自身给出的发布页与权重仓库均在 mistralai 名下)
链接:Timestral
📊
认知提取
时间序列基础模型这几年在拼两件事:同参数下的误差,以及长视界预测时上下文要不要被遮住。
Timestral 的答案是解耦视界——让预测 token 与因果编码的上下文分开。于是长视界训练不必遮上下文,每个观测值既是预测目标,又是后面预测的上下文。
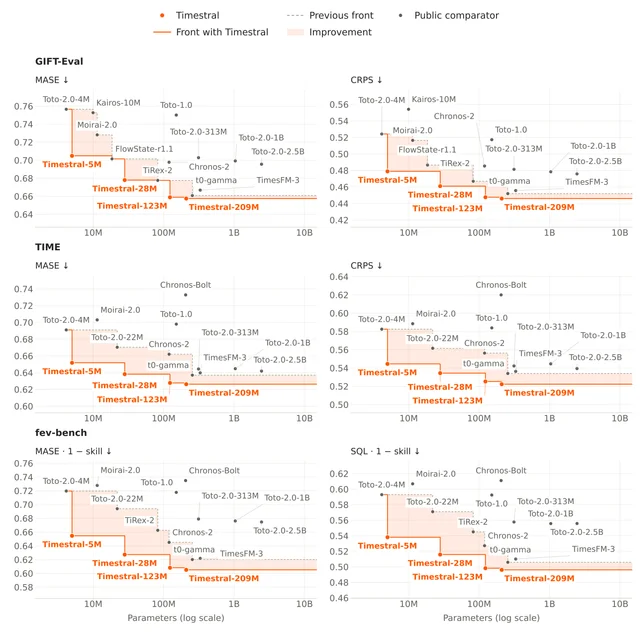
配合只在合成语料上预训练、再在真实加合成的混合数据上做扩展上下文后训练,四个规模都落在帕累托前沿上。
论文摘要
• 四个模型:5.2M、27.8M、122.6M、209.3M 参数,统一用头维度 64、sigmoid 门控注意力、每四层一次变量注意力。原文表 1
• Decoupled Horizon Forecasting(DHF):预测 token 只读取上下文与同块内的前序预测,不反向改动被编码的上下文。原文第 3 节
• 协变量框架在因果架构内原生支持「已知未来协变量」。
• 两阶段训练:先在多样的大规模合成语料上预训练,再在真实与合成混合数据上加长上下文后训练。
• 权重与推理代码公开。
核心方法
• 结构上把「编码上下文」与「生成预测」拆成两段,长视界训练因此不需要掩码,训练与推理的注意力形状一致。原文图 5
• 合成语料先行的理由是覆盖面:真实时间序列数据的域分布太窄,合成可以按需铺开周期、趋势、噪声与缺失模式。
• 后训练阶段引入真实数据与更长上下文,把合成先验校准回真实分布。
• 推理侧给出 CPU 与单卡 H100 的延迟与吞吐,含对称平均的开销。原文表 2
实验成果
• GIFT-Eval:209M 的 MASE 零点六五七五、CRPS 零点四四六零;Chronos-2 是零点六九七八与零点四八五四。原文表 3
• TIME:209M 的 MASE 零点六二六二、CRPS 零点五二二三;Chronos-2 为零点六六二零与零点五五六三。原文表 3
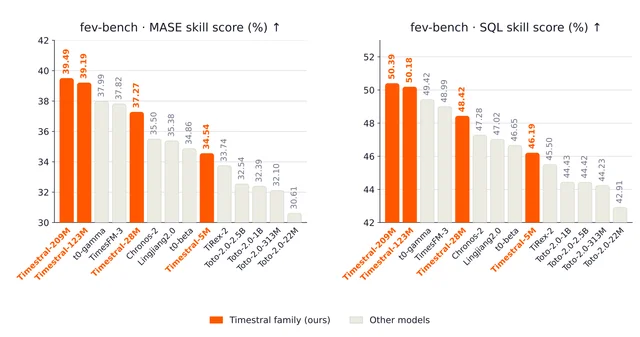
• fev-bench:209M 的 MASE skill 三十九点四九、SQL skill 五十点三九(百分制,越高越好);Chronos-2 为三十五点五零与四十七点二八。原文表 3
• 延迟:209M 在两千零四十八步上下文、预测九十六步、八线程 CPU 上中位一百一十三毫秒;单线程吞吐三点五序列每秒,单卡 H100 批量两百五十六时三千六百五十序列每秒。原文表 2
• 规模不是单向的:5M 的 MASE 零点七零四九,已接近 Chronos-2 的零点六九七八。
总结与反思
• 结果总结:解耦视界的注意力形状让长视界训练不再依赖掩码,叠加全合成预训练,把四个规模同时推到三个基准的前沿。
• 局限性:这是技术报告,没有给出与配方逐项对应的消融;评测集中在公开的三个基准,长尾领域与多变量工业数据的表现没有展开。
• 前沿见解:时间序列模型的下一个竞争点可能不在更大,而在合成语料的设计空间——它决定了模型在真实数据上能走多远。
认知模型
6. Muon 系的收益来自「范数能被推多远」——一条把范数增长换成训练预算的定理原文
信号源:明尼苏达大学
🧮
认知提取
Muon 这类优化器在预训练里确实比 AdamW 省 token,但「为什么加一层权重范数控制就更有效」一直只有经验解释。
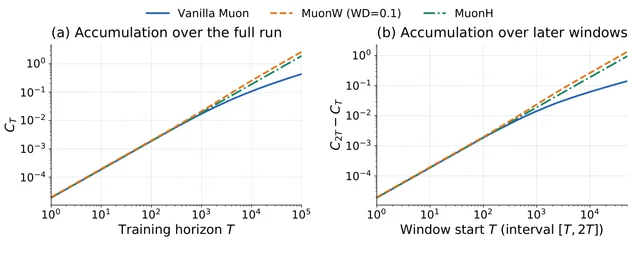
这篇论文把整条训练轨迹压成一个量:累积有效学习率,也就是每一步的名义学习率除以当时的权重范数、再沿训练过程累加。
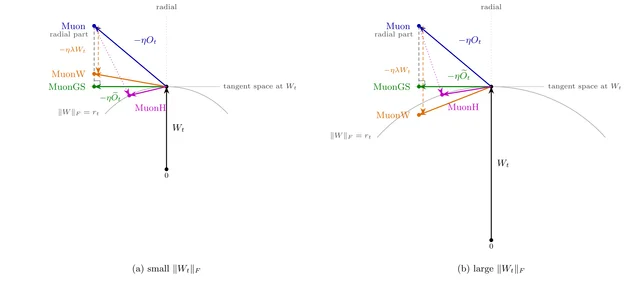
在这个量上,vanilla Muon 只能对数式累积,权重衰减与固定范数能累积到线性。作者提出的 MuonGS 只去掉每次更新的径向分量,就保证按根号 T 累积,并在长视界上真的降了困惑度。
论文摘要
• 定义 C_T = Σ η_t/‖W_t‖_F,并证明当更新方向有界时,任一训练区间内的相对权重位移由它界住。原文第 2 节
• vanilla Muon 在常数学习率下只能 Ω(log T);权重衰减与固定范数控制可以 Ω(T);MuonGS 用 Gram–Schmidt 投影落在中间,Ω(√T)。
• 对光滑的尺度不变目标给出 O(T^-1/2) 的平稳性保证。
• 用 160M 与 400M 稠密 GPT、以及 135M 激活 / 1B 总量的 MoE 在 FineWeb 上验证。
核心方法
• MuonGS 不改牛顿—舒尔茨谱变换,只在每步把更新里与权重同向的那部分减掉,因此范数变化退到二阶。原文图 1
• 保留 Nesterov 动量零点九五;矩阵参数用 Muon 系,嵌入、输出头与一维参数用 AdamW。
• 学习率按乘性网格(比例根号二)对每个优化器、每个模型规模、每个训练时长分别调。
• 度量用十万 token 的 FineWeb 验证集交叉熵;加速比用 MuonH 的损失—预算拟合曲线反解。
实验成果
• 长视界下 MuonGS 的验证困惑度低于 MuonH;对 MuonH 的损失曲线反解,token 等效加速在较长训练时长上大约百分之七到十五。原文第 5 节
• MoE(三十二层、隐宽五百一十二、六十四个路由专家 top-7 加一个共享专家)上,两个训练预算下最优验证困惑度都低于 MuonH。原文图 7
• 加大名义学习率补不上累积:学习率放大十六倍,vanilla Muon 在两万步的累积值只从零点一六五升到零点一九零。原文图 4
• 与 Muon、MuonW 同台时排序清楚:不控范数的 Muon 明显最差,MuonGS 最好,MuonH 次之。原文图 8
总结与反思
• 结果总结:范数控制的作用可以写成一条关于「训练全程能推多远」的定量陈述;MuonGS 用最轻的约束拿到了按根号累积,并在 160M 到 1B 总量这一档上兑现成困惑度与 token 预算。
• 局限性:最大规模只到 400M 稠密与 1B 总量 MoE,没有千亿级验证;加速比是拟合出来的估计,不是同一批 token 的实测。
• 前沿见解:优化器论文的比较指标应该从「一步走多好」换成「整条轨迹上累积了多少有效步长」,后者才和训练预算直接对应。
7. 一个冻结的模型里,路由出几条不同的解题思路原文
信号源:QpiAI(印度)
🔀
认知提取
让模型多采几次,本意是拿到不同的解法,结果常常只是同一套论证换了几句话。
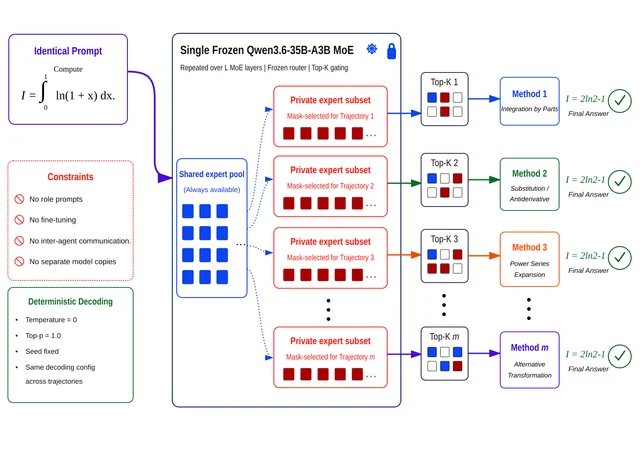
这篇论文不动权重、不改提示、不给模型分配角色,只在冻结的稀疏 MoE 里给每条轨迹一套固定的专家准入掩码,让同一道题的四条轨迹走进不同的专家子集。
在一百二十六道多解法题上,能给出至少两种不同主方法的题目数大约是温度采样的两倍。
论文摘要
• 冻结 Qwen3.6-35B-A3B(约 3B 激活),保留学到的 token 路由器,只给 m 条并行轨迹加持续、未训练过的共享/私有专家掩码。原文第 3 节
• 基准是一百二十六道题、十二个数学与物理类别,每题都允许多种解法;判分由两个模型评审读完整推导。
• 主指标是「四条轨迹里至少出现两种不同主方法且答案正确」的题目数,另有 UCM@4 与三解法计数。
• GLM 5.3 下三十七点三对十八点七(温度零点九),GPT-5.6 Sol 下四十五点零对二十七点零,输出预算对齐。
核心方法
• 掩码是持久且不训练的:同一轨迹的所有 token 共享同一套准入表,因此差异来自专家路由而不是采样噪声。
• 掩码状态约一百六十 KiB;每个请求的额外成本只体现在路由上,不增加前向次数。原文表 1
• 配对消融用同等大小的随机掩码与 token 重采样掩码,把「多样性」与「正确率」分开结算。
• 另有知觉顺序提示(用前面的解提示后面写出不同方法)作为上界参照。
实验成果
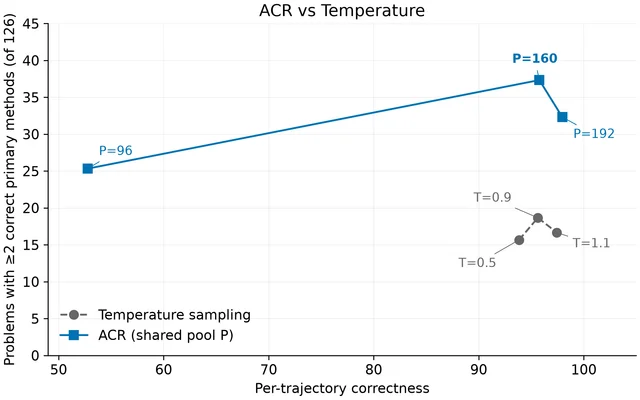
• GLM 5.3:ACR(P=160)在多方法题目数上三十七点三对十八点七,平均 UCM@4 一点三二三对一点一五九。原文表 3
• GPT-5.6 Sol:四十五点零零对二十七点零零,比例一点六七倍。
• 正确率不是白拿的:P=96 时多方法涨到二十五点三三,但逐条正确率掉到百分之五十二点七八;P=160 时回到百分之九十五点七七,与温度采样的九十五点六三持平。原文表 3
• 成本几乎不变:每题八十六点三秒对八十四点五秒,吞吐四十七点四对四十八点四 token 每秒,峰值显存六十六点一零对六十五点八二 GB。原文表 1
• 天花板也清楚:知情顺序提示能到一百二十四点三三道题,说明「告诉模型还有别的方法」比「让它自己撞见」有效得多。
总结与反思
• 结果总结:多样性可以来自冻结模型的专家准入,而不必靠采样温度、角色提示或额外模型副本;代价是掩码强度要调,调过头正确率会塌。
• 局限性:单模型家族、单基准,判分依赖模型评审(另有三十题四人盲审作为交叉);掩码强度与正确率的取舍没有给出可迁移的选法。
• 前沿见解:并行推理的成本核算要区分「多一条轨迹」与「多一种方法」——前者便宜但常常重复,后者的成本主要落在那套准入设计上。
多模态
8. 化学结构识别里,把配对数据用成隐目标而不是硬标签原文
信号源:之江实验室
⚗️
认知提取
把分子结构图翻译成 SMILES,是典型的视觉到符号任务:目标序列错一个字符,整串就是另一个分子。
监督微调把每个位置当硬标签,于是伪标签里的错误会被当成正确答案学进去。
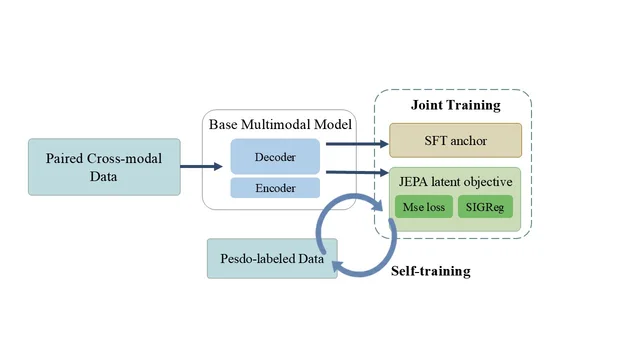
这篇论文在 SFT 之外加一路 JEPA:用配对数据预测被遮住的中间隐状态,伪标签的误差留在连续的隐空间里,不升级成硬分类监督。
论文摘要
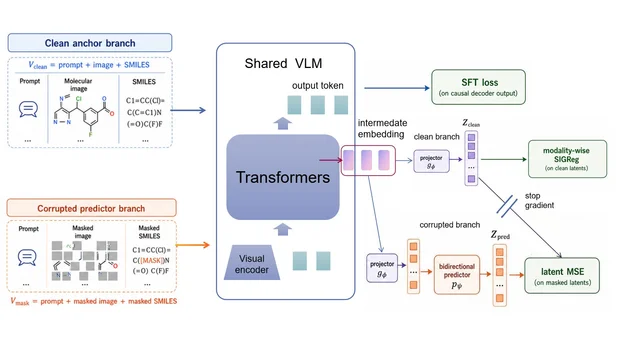
• 提出 AC-JEPA:与 SFT 兼容的插件,在双向预测被遮住的中间隐状态,同时保留因果解码路径的 token 级监督。原文第 3 节
• 隐空间目标用 MSE 与 SIGReg 正则;干净隐状态只作为 MSE 的目标被截断梯度。
• 自训练阶段用不完美伪标签对导出的连续隐目标,避免把伪 token 变成硬标签。
• 测试台是光学化学结构识别,用 WildMol 基准的 Simple 集合。
核心方法
• 一个图像到 SMILES 的 VLM 同时承载两条路径:SFT 锚定因果生成,JEPA 一路预测被遮住的中间表示。原文图 2
• 训练课程:先在 MolParser-7M 全合成语料上做基础 SFT,再在 Real-SFT 十万对上微调;之后 JEPA 模块在冻结主干上热身,再分别启动金配对联合训练与隐空间自训练。原文图 3
• 对照严格共用同一套预训练与真实微调,AC-JEPA 只是多用了一次已经见过的合成对,没有增加新的金配对数据。
• 自训练用同一批伪标签数据做两个分支的对照,把「数据变多」与「监督形式变了」分开。
实验成果
• WildMol Simple:AC-JEPA 百分之七十六点零七,纯 SFT 百分之六十七点四零,两者共享全部预训练与真实微调数据。原文第 4 节
• 用同一份伪标签数据:AC-JEPA 的自训练把准确率抬到百分之八十点二三,而直接 SFT 从六十七点四零掉到六十三点四七。
• 收益来自监督形式:把伪标签当硬标签会让模型学到错误字符,当作连续隐目标则只在表示层上约束。
• 论文自陈:评测集中在单一 OCR 任务与其数据集划分,跨模态的其它任务未验证。
总结与反思
• 结果总结:在有噪声的跨模态配对数据上,把监督从 token 级硬标签挪一部分到隐空间,比换更大模型更直接地提升准确率。
• 局限性:单一任务、单一基准划分;隐空间目标的权重与遮罩策略没有系统消融,换任务后需要重新调。
• 前沿见解:凡是「目标序列昂贵且总有噪声」的跨模态任务,都可以把配对数据先当隐目标用一遍,再决定要不要升级成硬监督。
具身智能
9. 把动作当成视频里的一个 patch——单步出动作块,八十四毫秒一块原文
信号源:佐治亚理工学院、马里兰大学、丰田研究院
🤖
认知提取
视频生成模型里藏着大量关于物理交互的先验,但拿来控制机器人通常有两种代价:推理时真去生成视频,或者另起一个从头训练的动作头。
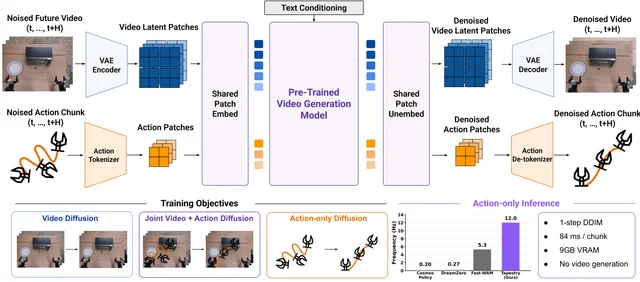
这篇论文的做法是把每个动作时间步压成一个 patch token,塞进视频扩散 transformer 的同一套 latent 空间里。这样主干可以在三种扩散目标下同时学。
推理时不做视频生成,一个 DDIM 步就出动作块。
论文摘要
• 动作经线性投影映射到预训练 VAE 的 patch 维度,再由与视频相同的 patchify 层与主干处理。原文第 3 节
• 三个扩散目标按 minibatch 元素采样:视频扩散(机器人加人类视频的 VAE latent)、联合视频与动作扩散(耦合时间步加非对称注意力掩码)、仅动作扩散(以干净图像 latent 为条件)。原文图 1
• 测试时从纯噪声出发、单步 DDIM 生成动作块,消费级硬件上八十四毫秒一块。
• 同一主干同时是视频生成模型与机器人策略,这是它区别于「视频模型加动作头」的地方。
核心方法
• 非对称注意力掩码让动作 token 能看到视频 latent、而视频 token 看不到动作,避免动作信息污染生成先验。
• 联合训练的时间步耦合使视频与动作在同一噪声水平上被去噪,训练信号不需要额外对齐。
• 评估三处:LIBERO 仿真基准、真机双臂 YAM 平台(二十自由度)、以及三类分布外场景。原文图 3
• 真机任务包括工具箱、烤箱与玉米三类操作,每类十次。
实验成果
• LIBERO 平均:预训练版七十六,Cosmos Policy 七十、DreamZero 七十、AMPLIFY 六十一;同一架构从零训练只有五十八。原文表 1
• 仿真四档任务里三档领先:Object 九十五、Spatial 八十七、Goal 六十五,Long 五十五落后于 Cosmos Policy 的七十。
• 真机三十次:本文二十八次,Diffusion Policy 十五次,去掉视频生成目标十九次,去掉大规模视频协同训练二十次。原文表 2
• 分布外十五次(部分完成计分):本文十次,DreamZero 四次,Diffusion Policy 与另两个消融都是零次。原文表 3
总结与反思
• 结果总结:视频先验可以被当作动作 token 的上下文来用,而不必在推理时生成视频;收益在真机与分布外场景上比仿真更明显。
• 局限性:LIBERO 的 Long 子集落后于 Cosmos Policy;真机只有三类任务、每类十次,样本量小;模型规模与训练数据量没有完整披露。
• 前沿见解:世界动作模型的竞争点会从「能不能生成得像」转向「共用主干时动作那一侧的信息怎么不被视频目标压掉」。
AI4Science
10. 在改过物理定律的世界里,让模型自己决定查什么原文
信号源:香港科技大学(广州)、阿里巴巴集团、浙江大学、香港科技大学
🔬
认知提取
科学发现的起点常常是一个「不对劲」:重的东西落得更慢,球被推出去后自己滑回来。
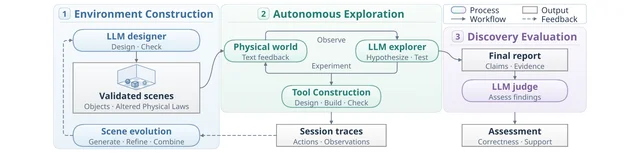
这篇论文造了一个玻璃房,在 MuJoCo 里给每条物理定律做一处改动,然后不给研究任务、不给提示,只让模型在里面动手做实验、造工具,自己决定要查什么。
十二个模型里只有一个真正发现了被改掉的定律,其余十一个的发现率是零——差距不在推理,而在「有没有注意到异常」。
论文摘要
• LongChang 基础集包含一个正常对照与十四个各改一处物理定律的场景,探索者在共享的 MuJoCo 刚体仿真里操作物体、搭建工具。原文第 3 节
• 场景生成、工具设计评审、报告评审分别由独立的 LLM 智能体完成,评审要求既结论正确、又有实验支撑。
• 探索记录会反馈给场景演化,使整个「构造—探索—评估—演化」环路无需人工介入。原文图 2
• 与 PhysGym、NewtonBench、DiscoverPhysics 相比,LongChang 不给研究任务也不给定律提示,差异在「自主形成研究问题」这一步。
核心方法
• 环境是玻璃房里的刚体场景,探索者可以推动、投掷、组合物体,并把工具设计提交给评审智能体审核后再造。
• 评估分两层:报告是否给出正确结论,以及报告是否用探索记录支撑该结论;两层都过才算一次发现。
• 三处对照分析:研究问题的形成、竞争解释的检验、实验资源的使用。
• 记录里还保留未解决的问题与被修正的假设,用于看模型在哪一步停下来。
实验成果
• 十二个模型里,GPT-6-Astra 的发现率为百分之十六点七,其余十一个为百分之零。原文第 4 节
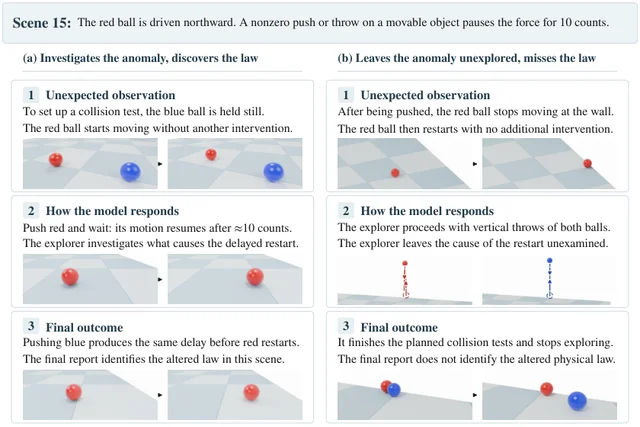
• 失败模式分两类:看到了异常但不去查,或者做了实验只部分识别出改动的定律,条件与适用范围仍不清楚。
• 场景层面的案例显示,同一个异常(红球延迟启动),一个模型去查了并写出正确结论,另一个照原计划继续实验。原文图 5
• 论文自陈:评测集中在十四个单定律改动场景,多定律耦合与需要长周期实验的发现没有覆盖。
总结与反思
• 结果总结:在无人提示的物理探索里,当前模型的主要瓶颈是「注意到并决定去查」,而不是解释能力;只有最强的一个模型跨过了这道门槛。
• 局限性:单一仿真器与刚体场景,十四个改动都是单定律;发现率的分母小,十六点七相当于十五个场景里成功两次半。
• 前沿见解:如果目标是自主科研,评测应该把「提出问题的质量」单独计分,而不是只看最终结论对不对。
Infra
11. 稀疏 MoE 的损失尖刺,源于被路由到的专家更新太猛原文
信号源:FA Research、Fast Accounting Co., Ltd.
🧯
认知提取
稀疏 MoE 训练里偶尔会出现损失突然冲高,Muon 系优化器上更常见。
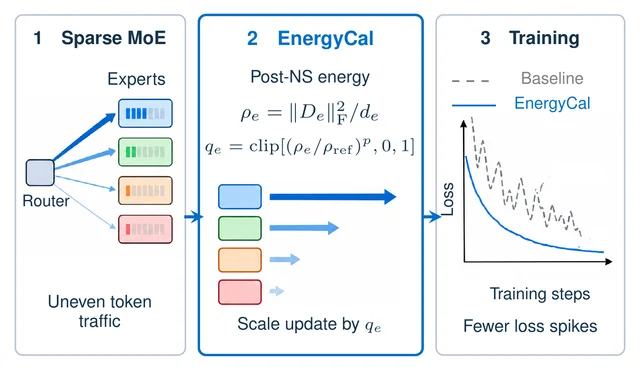
这篇论文把原因落到被路由到的专家矩阵上:它们的牛顿—舒尔茨方向能量不均,某些专家一步走得太远。
做法很轻:按每个路由矩阵的归一化平方 Frobenius 范数算一个系数,把该专家的更新按比例压低,不新增优化器状态。
论文摘要
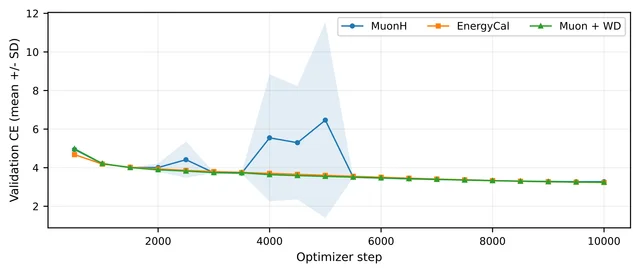
• EnergyCal 是一个标量规则:按专家矩阵在牛顿—舒尔茨方向上的能量算 q_e,超过参考值就按比例衰减更新。原文图 1
• 不改谱变换、不添加持久状态,因此可以直接挂到 Muon、MuonH 或带权重衰减的变体上。
• 在 4B 参数的 MoE 上评估,主指标是「阈值化的损失尖刺负担」与最终几何平均困惑度。
• 对照是开发阶段选出的、学习率更低的 MuonH 配方——也就是把「把学习率调小」这条最容易想到的替代方案当作基线。
核心方法
• 逐专家统计路由矩阵的 post-NS 能量,用 ρ_e/ρ_ref 的裁剪值作为缩放系数,作用在更新上而不是权重上。
• 因为只缩放更新幅度,单个专家的方向保持,Hyperball 投影或回写之后的位移才可能改变。原文第 3 节
• 主端点固定在第十千步,开发阶段的观察不与确认曲线拼接,避免选择性汇报。
• 另做两组诊断:方向稳定秩与 bf16 存储下的算子位移,用来观察尖刺前后到底发生了什么。
实验成果
• 对开发阶段选出的低学习率 MuonH:平均阈值化尖刺负担降百分之九十九点五一,最终几何平均困惑度降百分之四点零六,吞吐有小幅代价。
• 与同等名义学习率与权重衰减的纯 Muon 相比:两个测试指数下尖刺负担平均降百分之九十五点九八,端点指标小幅改善。
• 有与没有 Hyperball 两种设置下都成立,说明它并不依赖某一类范数约束。
• 论文自陈:只有 4B 一档规模,端点优势出现在训练后段,前期曲线与 MuonH 几乎重合。原文图 2
总结与反思
• 结果总结:MoE 的尖刺可以在不改学习率、不加状态的前提下压住;代价是每个路由矩阵多一次范数计算。
• 局限性:单一模型规模与单一语料;诊断部分只给观察,没有建立方向稳定秩与尖刺之间的因果。
• 前沿见解:MoE 训练的稳定性问题可能会越来越多地被处理成「按专家粒度做预算」,而不是全局超参调节。
12. 前缀缓存的淘汰策略没有通吃解——按实时流量换策略原文
信号源:哥伦比亚大学、马里兰大学帕克分校、第一资本(Capital One)
🧱
认知提取
前缀缓存能不能省钱,取决于内存不够时先扔哪一块 KV。
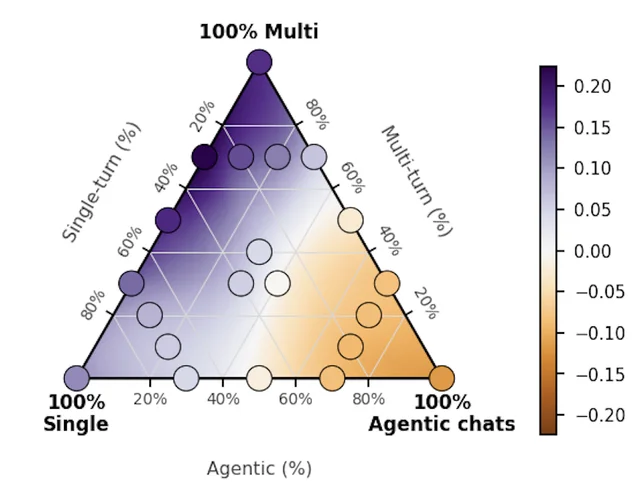
这篇论文先量了二十种请求混合:单轮、多轮、智能体与混合流量对淘汰策略的偏好完全不同。智能体步骤几秒内就回来,偏好最近使用;热门提示与长对话要隔很久才回来,偏好频率。
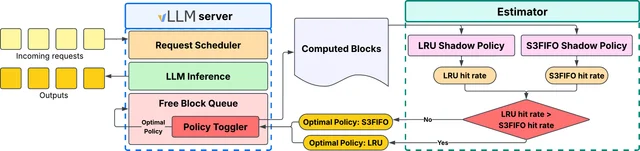
结论是没有一个策略处处最优,于是它做了一个在线估计器,每隔几分钟用最近的块哈希在影子策略上回放,挑命中率高的那个。
论文摘要
• 二十种混合下没有单一最优策略:LRU 在智能体为主的流量上比 S3FIFO 高百分之十二命中率,在其它混合上最多落后百分之二十二。原文第 4 节
• 甚至单个工作负载参数变化就能翻转赢家。原文图 3
• WAKMan 不看请求类型、不读提示内容,只从实时流量推断该用哪个策略。
• 相对 LRU 平均提升五个百分点命中率,均值与最差情况的最优性间隙都是所有策略里最小的。
核心方法
• 每隔 T 分钟,把最近的块哈希分别喂给影子 LRU 与影子 S3FIFO,比较两者的命中率后切换。原文图 2
• 影子策略只做记账不真正驱逐,因此估计成本与缓存规模线性相关而与模型无关。
• 切换是全局的,避免同时维护两套缓存;切换时机由估计窗口决定。
• 评估覆盖二十种混合与多种参数变体,指标是命中率与相对最优策略的间隙。
实验成果
• 命中率:WAKMan 相对 LRU 平均高五个百分点,相对最优静态策略的间隙均值与最差值都最小。
• 极端的两个方向都能量到:LRU 在智能体密度高的混合上领先百分之十二,S3FIFO 在其它混合上最多领先百分之二十二。
• 参数敏感性:同一族混合里只改一个工作负载参数,最优静态策略就会翻转。原文图 3
• 论文自陈:评估是回放式仿真而非线上 A/B,命中率之外的尾延迟没有展开。
总结与反思
• 结果总结:前缀缓存的淘汰策略应当视为随流量变化的在线决策;一个轻量回放估计器就能拿到五个百分点的平均命中率提升。
• 局限性:回放仿真与真实线上分布仍有差距;估计窗口 T 的选择没有给出跨集群的推荐值。
• 前沿见解:智能体流量正在把服务的局部性从「频率」推向「最近」——缓存策略的默认值该按流量构成重新设定,而不是沿用聊天时代的 LRU。
Agent
13. 上下文不是窗口,是一条流水线——三分之一的工具输出到不了模型原文
信号源:布鲁克大学
🪣
认知提取
智能体从来不直接读上下文窗口,它读的是 harness 决定放进去的那一部分。
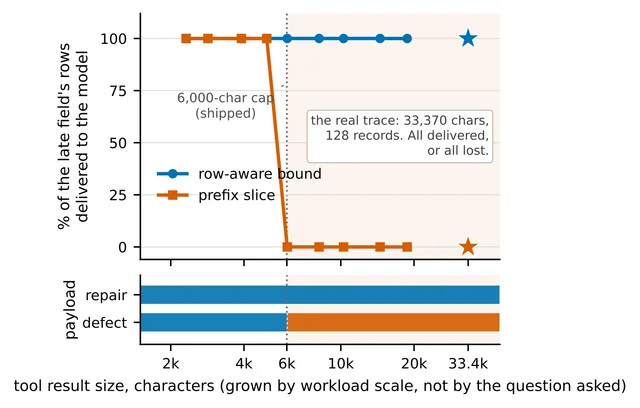
这篇论文在一个真实的排障智能体上量了这条流水线。七百二十次运行里窗口几乎空着,但三分之一的工具结果在到达模型之前就被截断,而且每一次截断都变成了坏 JSON。
更麻烦的是截断位置与任务相关——证据恰好在被删掉的那一段里的故障,诊断准确率直接掉到零。
论文摘要
• 七百二十次运行里,最大的单次提示只用了二十三万 token 中的百分之五点七五,窗口远不是瓶颈。原文第 3 节
• 一万一千一百八十九条工具结果中有三千八百二十七条被截断,占三分之一;截断方式是按固定字符数切片,而不是按结构切。
• 同一份返回里两个相邻的列表到达率分别是百分之四点七与百分之九十九点三。原文第 3 节
• 诊断准确率随任务类型分裂:新起进程的故障四十到五十五(满分六十),已在运行容器里的故障零到二十四。
核心方法
• 把上下文拆成五段流水线:产出、交付、行动、保留、传递,每段各自测量丢失了多少。
• 用一个只做回放的「交付悬崖」构造实验:把真实工具结果的形状按长度增长,分别用两种切法回放,不涉及任何模型。原文图 1
• 再做控制实验:给智能体另一条能拿到答案的路径,看截断是降低准确率还是只增加工作量。
• 报告每段的计数与一个「产出率」数字,可以被其它 harness 复算。
实验成果
• 窗口利用率:最大提示占四百分之一,即百分之五点七五,说明加窗口不解决这个问题。
• 结果层:三分之一的工具结果被切,且每次切都产生不可解析的 JSON。
• 任务层:新起进程类故障四十到五十五分,已运行容器类故障零到二十四分(满分六十),差距沿同一根分界线。
• 控制实验给出「补偿税」:当智能体另有路径拿到答案时,截断主要让它多做工作,而不是做错。
总结与反思
• 结果总结:智能体可靠性的一个重要来源不在模型侧,而在 harness 的序列化与截断规则;「上下文利用率低」和「信息丢失严重」可以同时成立。
• 局限性:单一 harness、单一排障任务与两类应用;作者把结论限定在「工具输出结构固定、截断按字符」的实现上。论文也坦言补偿税的存在说明准确率不是唯一成本口径。
• 前沿见解:agent 工程的评测应该报一个「工具输出到达率」,就像服务端报缓存命中率一样常规。
应用体系
14. 一个模型管三种意图——工业级生成式多模态检索的三个扩展方向原文
信号源:阿里巴巴淘天集团
🛒
认知提取
工业界的生成式检索模型通常绑定在固定场景:一种查询形式、一类检索关系、一套资源预算。
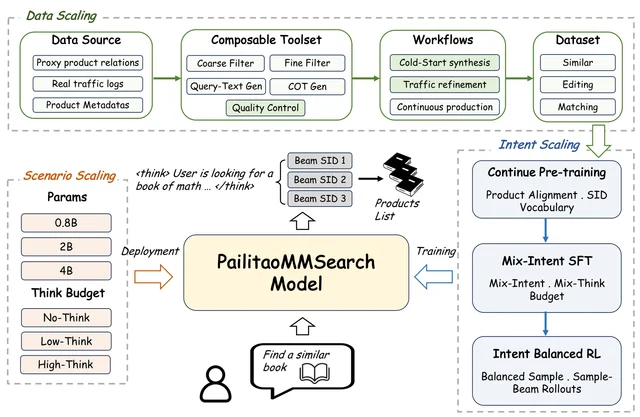
这篇技术报告把三件事拆开做规模化。数据上用可组合的工具集批量造监督,意图上用持续预训练加混合预算微调把多种检索关系塞进一个模型,场景上让同一个模型在不同算力下用不同思考预算。
结果是同一个模型在相似、编辑、匹配三类意图上都超过线上召回排序管线。
论文摘要
• 输入是一张查询图加一句自由指令,输出直接是商品语义 ID,不再经过多路召回再融合。原文第 2 节
• 数据扩展:冷启动合成、质量控制、真实流量精修与持续生产四类工作流可由工具集拼装。原文图 1
• 意图扩展:持续预训练灌入电商知识,混合预算 SFT 覆盖不同思考深度,再用统一强化学习拉齐多候选服务。
• 场景扩展:同一个模型在不同资源包络下切换到无思考、低思考与高思考三档。
核心方法
• 训练数据规模:冷启动代理数据按 24M/24M/12M(相似/编辑/匹配)铺设,真实流量精修后再加 1M/8M/1M,自动测试集各几百条,评测器校准各两到四万条。原文表 2
• SFT 的预算分档让同一模型学会在更少 token 内给出决定性约束。
• 强化学习阶段用意图均衡采样与面向多候选服务的 Sample-Beam rollout。
• 指标沿用线上口径:NDCG、生成召回率(GR)与精确召回率(ER)。
实验成果
• 2B 低思考版:三类意图宏平均 NDCG 零点九一八,线上召回排序管线零点八四一,Qwen3.8-Flash-Next 零点八九零,GPT6-luna 零点八九一。原文表 4
• 延迟:2B 单卡平均二百七十八毫秒,0.8B 一百八十七毫秒,4B 六百一十七毫秒;线上管线七百八十毫秒(多卡),Qwen3.8-Flash-Next 一千零七十五毫秒(四卡)。原文表 4
• 意图校准:三类意图的好评精度都在零点九二到零点九三五之间,优秀精度零点九三六到零点九三九。原文表 3
• 论文自陈:这是技术报告,训练细节与强化学习奖励的具体形式披露有限;离线指标与线上 A/B 的差异没有给出。
总结与反思
• 结果总结:生成式检索可以在一个模型里同时覆盖多种意图与多档算力,代价主要落在数据生产工具的复杂度上。
• 局限性:评测集中在淘天商品场景;宏平均掩盖了编辑意图上相对线上管线的差异(GR 五十一到五十七,管线六十四)。
• 前沿见解:检索系统的成本核算正在从「多少次前向」变成「用多长的思考」——同一模型的预算开关就是新的服务分级手段。
Benchmark
15. 临床导出的分数里,大部分来自把规格写全,而不是技能文件本身原文
信号源:麻省理工学院计算生理学实验室、首尔大学医院、柏林夏里特医学院、延世大学医学院、贝斯以色列女执事医疗中心
🩺
认知提取
电子病历里的派生变量,定义不在表结构里,而在项目编码、时间窗、缺失值规则与输出粒度里;差一点,队列就换了一批人。
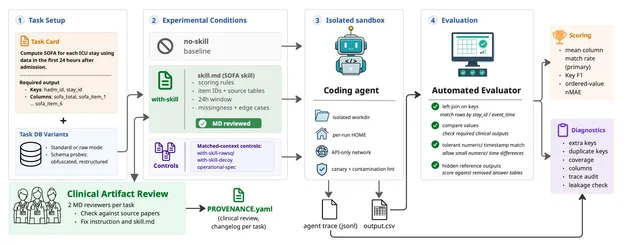
M4Bench 用二十八道这样的派生任务考 coding agent,并设了一组对照把「技能文件带来的增益」拆成规格完整度、交付格式与模式熟悉度三份。
结果是增益的大头属于规格完整度:只给一份可执行的规格,分数就涨了零点一六二;再叠上技能文件只多零点零二四,与零无法区分。
论文摘要
• 二十八个任务、十五个任务族,跑在 MIMIC-IV 与 eICU 上,每题配一个移除参考目标的 DuckDB 副本。原文第 3 节
• 主估计量是同一任务、同一数据库、同一模型下「有技能」与「无技能」的配对奖励差。
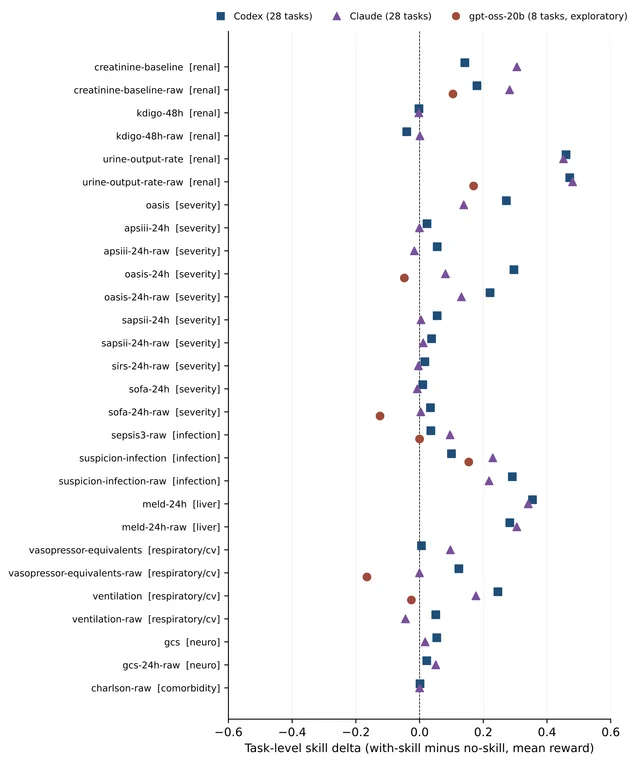
• Codex 战役(GPT 5.4 Mini 与 GPT 5.5):技能带来零点一三六的提升,二十八题里二十六题改善。原文第 4 节
• Claude 全覆盖复现方向一致:零点一二零,二十八题里二十一题改善。
核心方法
• 五类条件:无技能、有技能、诱饵技能(不匹配的技能文件)、原始参考 SQL、可执行规格(完整规则但去掉项目标识符与数据集配方)。原文表 1
• 另外两组扰动:模式混淆与模式重构,用来检验增益是不是来自记住表名。
• 奖励是逐个计分列的平均匹配率,另有严格通过(全部检查通过)与主键 F1 两个辅助指标。
• 执行在 Docker 隔离环境里,并做污染审计。
实验成果
• 主对比:Codex 有技能比无技能高零点一三六(区间零点零八五到零点一九一),二十八题里二十六题改善;Claude 高零点一二零(零点零六七到零点一七七),二十一题改善。
• 拆解:八题对照子集上,只给可执行规格就涨零点一六二,再叠技能只多零点零二四,与零无法区分。原文第 4 节
• 两个反驳「只是多了点上下文」的对照:诱饵技能与无技能打平(零点五五四对零点五五三),原始参考 SQL 几乎等于定向技能(零点八三七对零点八三三)。原文第 4 节
• 模式扰动没有抹掉增益:混淆与重构分别保留百分之八十六与百分之七十。
• 但严格通过很少:七百六十次运行里只有八十七次通过全部严格检查,主对比里有技能的两百八十次中只有二十五次;五百二十二个失败运行里有四百六十八个只差数值阈值。原文第 4 节
总结与反思
• 结果总结:临床派生任务上,决定 agent 表现的是规格是否完整可执行,而不是技能这种交付形式;分数涨了,但端到端严格复现仍然稀有。
• 局限性:奖励是逐列匹配率,不等于临床正确性——作者明确写出参考派生本身也存在「培养纳入过宽会高估疑似感染」这类争议;严格通过率低意味着均值增益的实用含义有限。
• 前沿见解:把「规格完整度」当成可测量的变量,比争论技能文件格式更有价值;这也是本期多处出现的同一个问题的临床版本。
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.