陆川手搓历史现场,王珞丹熬夜抽卡,阿里全模态开始兜底生产
量子位报道 2026 云栖大会上的阿里全模态发布:导演陆川用 AI 五天重建 1626 年「王恭厂之变」,阿里同时把 Qwen4 的训练路线与图像、视频、声音、音乐、世界模型一次铺齐。

5 天。
不用搭景,不用等演员,导演陆川和团队,直接用 AI 把一场发生在 400 年前的明代灾难现场「搓」了出来。宫廷、火药库,还有史料里「烟云如黑灵芝」的大爆炸。
按传统影视工业的做法,复原明代北京城、宫廷以及大规模爆炸场景,需要数月时间和千万级投入。这一次,团队只用了 5 天。1
这部短片叫《历史·现场》,题材是 1626 年明代的「王恭厂之变」,史料取自《酌中志》《天爵堂文集》等多种记载。陆川说,这个选题来自团队筹备电影《天工开物》时对明史的研究;他想借 AI 把不同亲历者留下的文字拼到一起,用影像走近历史现场,也追问爆炸背后至今未解的谜团。1
短片选取了三位事件亲历者的视角:爆炸中心幸存的火药匠役吴二、身处宫内的宦官刘若愚、身处民间的文人薛冈。三人的记述都来自明代留存史料。1
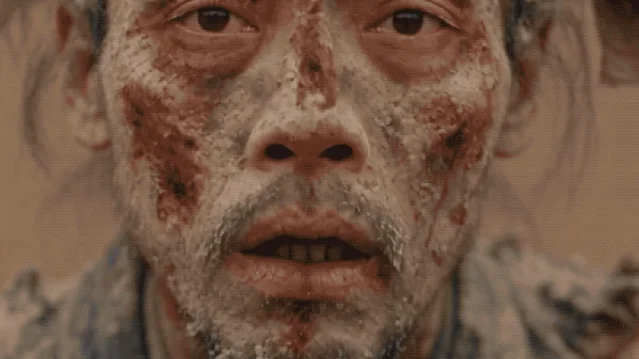
《历史·现场》预告片画面。人物写实程度是团队判断画面可用与否的主要依据,皮肤、神态与情绪的还原效果也决定了这些历史人物能否摆脱「一眼 AI」的观感。
人物的脸、皮肤、神态已经相当逼真,几个明代人物也不再是过去那种一眼 AI 的塑料感。再看爆炸:烟尘、碎片、火光一起往外冲,这种最容易穿帮的复杂场面,也都稳稳接住了。
按传统影视工业的路子,过去光是一场爆炸戏就要耗费 19 天。这次,陆川团队把史料里的文字一点点翻译成现代视觉概念,前后大约做了四轮提示词优化,再参考真实爆炸影像去校准。最后,阿里视频生成模型对烟尘、碎片这些复杂画面的还原,准确度达到团队预期的 95% 以上。1
这次 AI 参与的是完整创作链路:史料搜集与分析阶段,人先定研究方向,AI 协助搜集材料;短片制作中,导演把控镜头方向、画面质感和整体调性,AI 实现意图;到了主题讨论阶段,AI 还能当对话者,帮着梳理问题。单在视频生成环节,阿里模型的贡献度就超过一半。1
云栖大会上,阿里把模型家底端了出来
9 月 22 日,2026 云栖大会在杭州开幕,会期三天,大会设 3 大主论坛、120 余场分论坛和 5 万平方米展区。2 当天的开幕式上,阿里云把模型家底端了上来。
先看千问基座模型,架构、自我进化、全模态、参数规模,几乎每一层都在往前推:Qwen3.8-Max 开始自己训练自己,Qwen3.8-Flash 提前放出下一代架构,Qwen3.8-Omni 为大模型开辟全新的思考分区,Qwen4 已经开练,Qwen4.5、Qwen5 也在路上。参数规模则直接瞄准 5 万亿~10 万亿。3
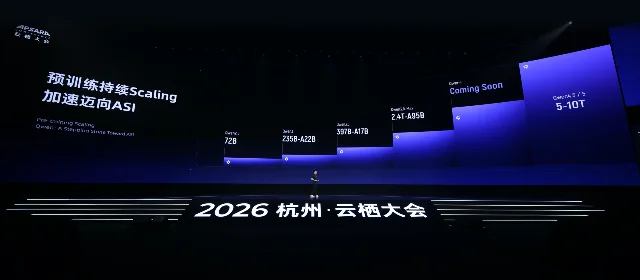
云栖大会现场幻灯片上的千问模型路线:从 Qwen3 72B、Qwen3.5 的 2.4T-A95B 一代代排上来,Qwen4 标着 Coming Soon,终点一栏写着 Qwen4.5/Qwen5 的 5—10 万亿参数。
「自己训练自己」指的是递归自我改进(RSI)。按阿里在大会上披露的数字,Qwen3.8-Max 能自主搭建训练流程、构造训练数据、自主设计实验并定位缺陷,在人类完全「零参与」的情况下持续迭代超一个月,完成 33 轮有效迭代;在 Artificial Analysis 的全球大模型排行榜上,它的得分从 40 分升到 45 分,与 Claude、GPT 等顶尖模型同处第一阵营。34
RSI 还往上下游延展。推理优化上,Qwen3.8 在平头哥新款 GPU 上,自主适配优化了下代架构 Qwen3.8-Flash 的 SGLang 推理框架,单实例推理吞吐量提升 96%。芯片与模型协同设计上,它仅凭一份真实的总线模块规范,自主展开前端、验证、后端的全链路自迭代,运行超 60 小时、调用 EDA 工具超万次,最终完成面积减少 42%、标准单元数降低 29%、功耗降低 59.5% 的物理实现优化。3
Qwen3.8-Flash 则提前开源了下一代千问架构。它通过注意力机制和模型内信息传递机制等改动,在性能对标前沿模型的同时,把训练成本降了近九成。3
图像、音乐、世界模型、语音、同传这几条线也各自上新:图像生成模型 Qwen-Image-3.1 面向电商、设计等真实商用场景优化,把原本数小时的视觉设计压到秒级交付;音乐生成模型 Happy Shrimp 1.1 支持百余种曲风与十余种主流语言;世界模型 HappyOyster 2.0 Preview 提升了智能实时交互、记忆能力、实时响应和物理规律遵循;语音模型家族 Qwen-Audio-3.1 覆盖 ASR、TTS、Realtime 三条赛道,据阿里披露均位列国内第一;同声传译模型 Qwen3.8-LiveTranslate 首次登场,字均延迟从 2.8 秒降到 2.3 秒。3
下一代视频生成模型预告 11 月发布。3
拼图铺齐了:从语言一路铺到空间
把这次云栖大会的模型更新全部摊开,一张相当完整的全模态地图已经摆在眼前。
文字和通用智能这边,有 Qwen3.8,以及已经投入训练的 Qwen4。往外看,图像生成与编辑有 Qwen-Image-3.1;视频生成有 Wan、Happy Horse 系列,以及计划 11 月发布的下一代视频模型;声音这边是 Qwen-Audio-3.1,音乐交给 Happy Shrimp 1.1。再往真实世界延伸,HappyOyster 2.0 Preview 开始处理世界模型和交互环境;Qwen3.8-Omni-Flash 把文字、图片、音频、视频放进统一理解框架;Qwen Intelligence 继续把 Agent 能力推向手机终端。
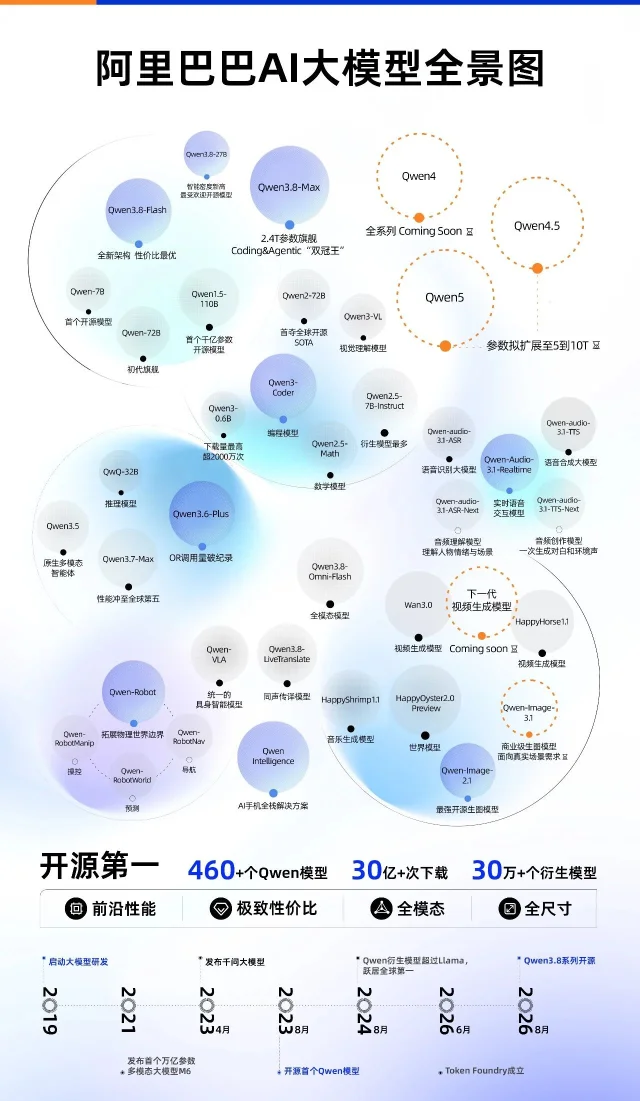
阿里巴巴 AI 大模型全景图,图下方标注的开源数据是:460 多个千问模型、30 亿次以上下载、30 万个以上衍生模型。
这一串名字看下来,很容易有种新品发布会开到停不下来的感觉。把它们塞进一项具体任务里,关系就清楚多了。
拍一条广告,脚本、商品图、人物、口播、音乐本来就混在一起;做一部电影也一样。导演给模型的可能是一段文字、一张参考图、一首音乐,最后交付的是一套完整的视听内容。现实任务天然就是混合模态的,文字、图像、视频、声音、空间信息往往同时出现,模型最终要处理的很少是单独一种信息。
云栖大会现场,阿里巴巴 ATH 事业群技术副总裁、淘天集团首席科学家郑波提到:
文本、图像、视频、声音、空间的能力正在加速协同,AI 也从生成一张图、一段视频、一首音乐,继续走向理解人的意图,创造完整沉浸式视听体验。
他同时给出一组数字:63% 的视频营销人员已经在使用 AI 视频工具,预计到 2030 年,AI 图像与视频生成的市场规模将达到 608 亿美元。5
从 Demo 走进生产线,多模态要过三层考验
这些问题只有进了真实工作流才会彻底暴露出来。
第一层:内容生产
这是最成熟的一层,也是视频模型最先撞上的考题。
Wan3.0 已经支持单次 30 秒生成,还能接受文档、表格、网页等结构化输入。6 据阿里披露,它曾在 Artificial Analysis 的文生视频和视频编辑两项榜单上位列第一。到了商业场景,榜单只能算入场券:一条广告片里的商品外观、Logo、人物和口播只要有一个漂掉,前面生成得再炫也很难直接交付。同样的指标也落在图像、语音、音乐上,「能不能稳定生产」成为多模态进入生产环境后的核心考题。不过 Wan3.0 已经拿到正向反馈,据使用者介绍,它已接近真实广告拍摄的水平。
第二层:进入专业创作
陆川的《历史·现场》就是一个很典型的样本。
5 天重建一场 400 年前的历史现场很惊艳,这次尝试更有意思的地方,是它把 AI 带到了创作者真正难啃的位置。通用模型很容易生成大家熟悉的古装剧质感,真正的历史现场需要陌生感,需要更严谨的史料,也需要模型理解导演到底想表达什么。对此,阿里巴巴视频生成模型技术负责人表示,未来将与更多导演、行业专家及历史学者合作,为模型引入更全面、更严谨的专业信息。1
音乐创作遇到的则是另一套难题。9 月 22 日下午,在 2026 云栖大会的视听生成分论坛上,太合音乐集团总裁余灏坦言,AI 给音乐行业带来的焦虑并不新鲜:电子合成器、MIDI(乐器数字接口)、DAW(数字音频工作站)都曾引发过类似担忧,最后都变成了新的生产工具。而现在,AI 又把音乐创作成本往下压了一大截,普通用户和专业艺人都开始把它当生产力工具。
音乐一旦进入产业,问题马上变得比「能不能生成一首歌」复杂得多:训练素材怎么获得,版权怎么算,AI 翻唱该不该授权,收益怎么分,这些都绕不过去。余灏特别提到,无授权 AI 翻唱的成本太低,大量版本泛滥,会直接侵蚀原版版权方和艺人的价值。7 太合与阿里 Happy Shrimp 的合作,也开始往音乐人共创、产业生态、版权机制和 AI 音乐新消费场景延伸。这时候,AI 音乐已经从创作工具走进产业规则这一层。
小旭音乐创始人卢小旭在论坛上的分享,更像一张多模态生产流程图。他的工作室做 AI 歌手,单靠一个模型跑不下来:先做人设和视觉锚点,再用音乐模型做歌曲、人声和编曲,接着把音乐交给视频模型做 MV 和对口型视频,后面还要接大模型做评论抓取、分类和运营反馈。用他的话说,平均 4 个项目才能跑出 1 个成功的 AI 歌手账号。但小团队的生产效率已经被明显拉高:6 个人孵化十多个 AI 歌手 IP,一些账号 4 个月涨粉 20 万,全网累计播放量突破 2 亿。
电影要理解导演意图,音乐要处理版权和产业规则,AI 歌手还得把音乐、视觉、人设、运营串成一整套工作流。进入专业创作之后,多模态的考题从生成质量扩到三件事:吃进专业知识、理解创作目标、接进完整生产流程。
第三层:进入终端和物理世界
再往外走,多模态开始离开内容产业。
千问端到端全双工实时语音交互大模型 Qwen-Audio-3.1-Realtime 已经进入千问办公、Qoder(阿里智能体编程工作台)、千问 AI 眼镜、随身助理和桌面机器人,能够边听、边想、边说。Qwen Intelligence 继续把 Agent 能力塞进手机,希望完成跨应用复杂任务。HappyOyster 2.0 Preview 则把战线拉到物理世界,它要解决的是环境能不能长期保持一致、物体运动能不能符合物理规律、用户操作后能不能及时得到反馈。8
这张布局图已经越来越清楚:先给人生成内容,再帮人完成工作,接着让机器理解并作用于世界。问题在于,单项能力越来越强之后,AI 怎么才能在一件复杂任务里一直记得自己在干什么?
下一关:AI 要一直记得自己在干什么
这个问题在创作者那里已经出现了。
演员王珞丹在视听生成分论坛现场分享了她的 AI 创作体验。今年年初,她开始认真学 AIGC,自己下场做短片,最开始连人物三视图都要一点点学。再往后是排队、抽卡、反复试:王珞丹曾经抽卡抽到凌晨 4 点,一度觉得很绝望,到了早上 6 点,终于抽到了想要的镜头。
更麻烦的是表演。她的脑子里明明有一个很具体的状态,模型却很难准确呈现;反而在给一个宽泛概念时,模型有可能突然给出惊喜。这很能说明现在多模态创作的一个尴尬:单个镜头已经越来越强,但故事一长,人物的状态、情绪和气质很难一直保持。创作者需要的,恰恰是 AI 能记住前面的内容,一直跟着同一个故事往下走。
放到更广泛的 Agent 任务里,这件事就是记住上下文、环境变化,以及前面已经执行过什么。图像、视频、语音、世界模型分别变强,只解决了单项能力;而一项完整任务往往同时包含视觉、声音、语言、空间、时间和动作,这些信息还会一路变化。AI 需要在这些信息之间保持同一个任务上下文,每切一次模态就像重新开始一次对话,这种方式撑不起真正复杂的工作。
阿里把更远的方向指向「原生全模态统一模型」。郑波给出了一个判断:
三年之内会出现一个原生的全模态统一生成模型,未来体验将不再受限于模态边界。
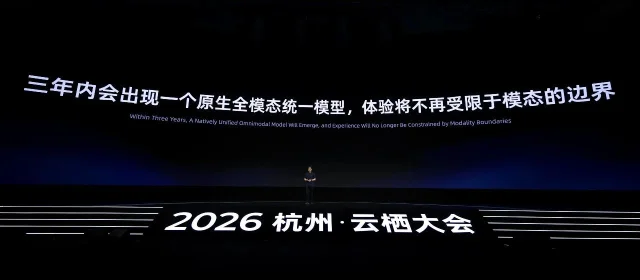
2026 杭州云栖大会现场,郑波演讲幻灯片上的这句判断:三年内会出现一个原生全模态统一模型,体验将不再受限于模态的边界。
重点在「原生」。今天很多多模态系统更像一场接力:图像模型做图,视频模型接着生成,音乐模型负责声音,Agent 再去调不同工具。能力都能用,但一次次交接也意味着上下文可能丢失。原生全模态想解决的,就是这种割裂——不同模态从模型底层共享同一个任务、同一份上下文和同一套世界理解,图像、视频、声音、空间、动作都围绕同一个目标往前走。
据了解,阿里的下一代视频模型已经沿着这条路继续推进,方向之一就是从生成单个镜头走向理解完整叙事。郑波把这个方向称为「Agentic Video」:模型开始理解创作目标和创作意图,从一个想法、一段故事出发,自动拆剧情、做分镜、组织角色和场景,再完成生成。这和今天的「抽卡式创作」已经是两种体验。
王珞丹熬夜抽卡的经历,暴露的正是多模态创作最后一公里的问题。陆川的《历史·现场》已经让另一种可能开始出现:AI 可以真正进入专业创作链路,并承担相当一部分生产工作。只是今天,这条链路还需要导演和团队在中间不断组织——查史料、定视觉、调提示词、校准画面,再把不同模型的能力接起来。
原生全模态要往前再走一步,让 AI 从接住一个镜头,走到接住一整件事。这意味着 AI 要从理解创作意图,到记住人物、场景和叙事,再到调用图像、视频、声音乃至空间能力持续完成任务。
再回头看阿里这一轮密集的多模态更新,真正值得关注的,是这些能力能不能被拧到一起,让 AI 从会生成,走向会把事情做完。
References
- 15天「搓」出古代历史现场,导演陆川携AI短片提前亮相
yzwb.net
- 22026云栖大会
yunqi.aliyun.com
- 3阿里大模型全面提速:Qwen4已在训练,下一代视频生成模型将于11月发布
finance.sina.com.cn
- 4Qwen3.8 Max (0902) - Intelligence, Performance & Price Analysis
artificialanalysis.ai
- 5淘天集团首席科学家郑波:三年之内会诞生原生全模态统一生成模型
finance.sina.com.cn
- 6千问大模型_AI大模型_阿里云
aliyun.com
- 7当AI学会「唱歌」:数字音乐版权治理须跑在技术前面
xinhuanet.com
- 8
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.