318,484 条设计,211 条进了湿实验室,17 条真结合:五种毒素一起抓的 91 条只成 1 条
Anthropic 让内部研究模型在 Claude Science 里跑 64 小时,从 318,484 条设计里挑出 211 条做湿实验,17 条真的结合;这篇拆开四条判据怎么把 17 数出来、为什么 AI 自己的打分挑不出赢家、以及五种毒素一起抓的那 91 条只成了 1 条。

10 月 20 日,Anthropic 在官网 Science 栏目发了一篇研究,讲 Claude 怎么设计出抗蝎毒蛋白。1
Anthropic 让一个内部研究模型在 Claude Science 里跑了 64 小时,中途只由人追问了四次。1
官方自己划了边界:这些结果停在「结合」,细胞环境里的中和实验还没做,抗毒血清这个说法他们也留在了场外。1
另一组数字更有信息量。冲着五种毒素同时结合去的那 91 条设计,只有 1 条达标,而且只对其中一种毒素有效。2
17 这个数是四条判据卡出来的
第四条是防粘。CLEC12A 是跟蝎毒无关的人蛋白,设计要是粘上它,说明看到的是非特异吸附。2
分母得按设计组拆开看。2 60 条单毒素设计里 11 条过关,占 18%;逐毒素从 Ts1 的 0 到 Cn2 的 42%。2 60 条双毒素与三毒素设计里 5 条过关。2 冲着五种毒素去的 91 条,过关的只有 1 条,而且只对其中一种有效。2
另一个参照是 Anthropic 自己 8 月那次:针对 15 个靶点,公布的命中率是 26.7%、22.6%、35.1%。3 靶点难度与打法都不同,这组数字只适合作参照;这次的单毒素组停在 18%,落在 8 月那三档的下方。两篇还差在机型上:8 月点名 Mythos Preview 与 Opus 4.8,这次只说「内部研究模型」。3
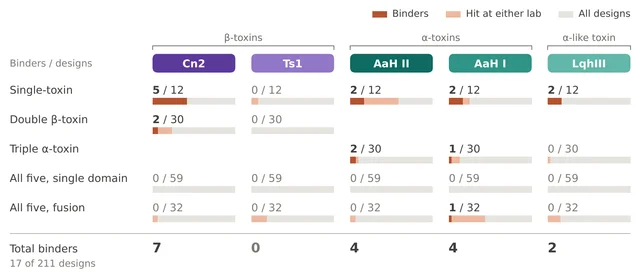
技术报告 Figure 7,官方原图。灰条是该组针对该毒素的全部设计,浅橙是在任一家实验室出现过阳性的比例,深橙是被标为结合蛋白的比例。LqhIII 只有 Adaptyv Bio 测过,两个读数与其余不可直接比。
从 32 万条到 211 条
提示词固定了大部分框架:五个靶点、每个靶点的钠通道结合面、分子尺寸(50 到 160 个残基)、禁用半胱氨酸、三个结构预测器与打分公式、新颖性与多样性上限。2
Claude 自己定下的是另一批:用哪些毒素结构、每个结合面上具体哪五个热点残基、所有分数阈值的具体数值、融合蛋白的接头与域顺序、算力怎么分、每个设计工具用多少。2
阈值这一步值得停一下。2 Claude 给每条毒素、每个预测器各定一个 ipSAE 门槛,最低 0.15,且不低于 28 到 31 个诱饵蛋白的 95 百分位。2 scDockQ 统一不低于 0.23,且这些阈值在任何一条设计被打分之前就固定了。2
后面是三段漏斗:318,484 条设计,553,052 对设计–毒素用单个种子共折叠筛一遍,28,451 对用至少五个种子重排。2 64 小时、四次追问、约 10,000 个 H100 卡时,跑在 Modal 上,最多同时开约 350 个容器。2
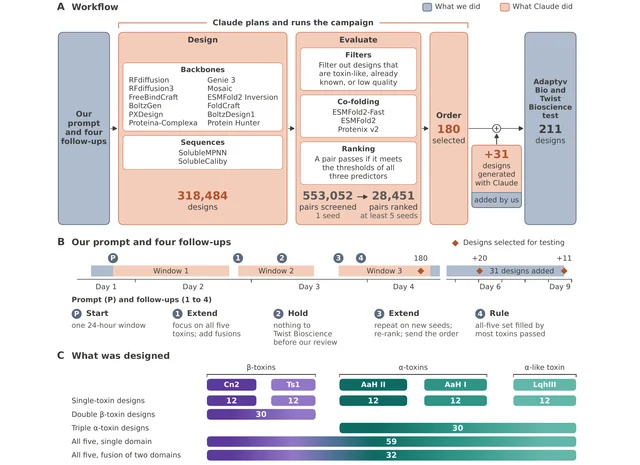
技术报告 Figure 2 的 A 到 C,官方原图。蓝色是团队做的,橙色是 Claude 做的;中间那条 318,484 → 553,052 → 28,451 → 180 就是筛设计的漏斗,下面是四次追问的时间轴与 211 条送测设计如何分组。
打分挑得出好的组,挑不出好的那一条
报告做了一件很多人会跳过的事:拿送测的 180 条、510 对设计–毒素,反过来检验自己的打分能不能预测命中。2
六个打分项各自的 AUROC 落在 0.50 到 0.71 之间,最好的是 ESMFold2 算的 ipSAE。2 三个 ipSAE 取平均是 0.70,95% 区间 0.53 到 0.83,下沿贴着随机。2
最能说明问题的是这组数:60 条单毒素设计的最终分全部落在 0.88 到 0.95,其中就包括一条都没成的 Ts1。2
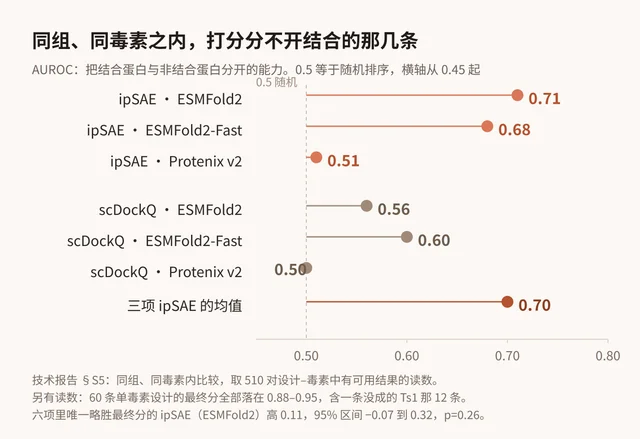
据技术报告 S5 自制。点落在 0.5 那条虚线上等于随机排序;ipSAE 是六项里最好的,但同组之内仍不足以挑出真正结合的那几条。
对想用这套流程的人,这一节最重要:in-silico 分数能把明显差的设计筛掉,最后那一步还得靠湿实验。
五种毒素一起结合,为什么一条都没成
问题可能出在筛选标准上。2 把每条设计单独预测成单体,针对 1 到 3 个毒素的那 120 条里有 107 条落在设计模型 2 Å 以内;冲着五种毒素去的 30 条里只有 1 条。2 一个解释是:靠五种毒素共折叠分数挑出来的界面,本身要等毒素在场才成形。2
32 条融合里有 7 条在初筛中对多种毒素呈阳性,但它们同时对 CLEC12A 也有信号,报告判断多半是脱靶吸附。2
还有一层在靶点本身。2 五种毒素共用一个折叠,任意两条的序列同一性只有 26% 到 62%;五个毒素全都相同的位置只有 14 个,其中 8 个是共享折叠里的半胱氨酸。2 同一个结合面要同时贴住差异这么大的残基,这正是多毒素设计的难点。2
C 端标签还可能挡住 C 端那个残基,而 11/12 条单毒素设计、28/30 条双 β 毒素设计在预测复合物里都接触这个残基。2 换句话说,Ts1 这一路的零,至少有一部分可能出在抗原上。
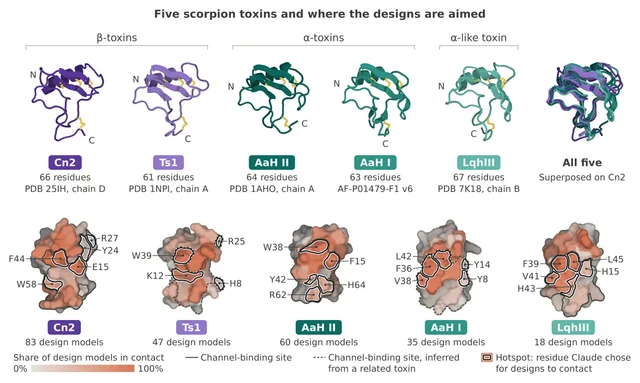
Anthropic 官方正文图。上排是五种神经毒素的结构;下排是同一条毒素的表面,白线是它与钠通道接触的界面,橙色深浅是设计模型接触该残基的比例,带圈的残基由 Claude 为每条毒素选定。
最强的一条证据来自竞争实验
Cn2-B1 与 Cn2-B2 是这批里结合最紧的两个。2 Cn2-B1 在 Adaptyv Bio 的 KD 不高于 3.1 nM、在 Twist Bioscience 不高于 1.7 nM,两个都是上限估计;Cn2-B2 分别是 5.6 与 3.4 nM。2
两个都解离得慢,解离速率低于 10⁻³ s⁻¹;其余五个 Cn2 结合蛋白是 4.9×10⁻³ 或更快,KD 都在 40 nM 以上。2
真正有分量的是竞争实验。2 LR 是一个已被报道能在小鼠体内中和 Cn2 的抗体片段,它的表位正好压在钠通道结合面上。2 先把 LR 挂到 Cn2 上,六个 Cn2 结合蛋白的结合信号掉了 87% 到 95%。2
按预测复合物,Cn2-B1 覆盖 Cn2 钠通道结合位点 20 个残基里的 16 个,LR 在晶体结构里覆盖 12 个。2
官方的说法是「可能中和」。2 支撑这句话的是位置上的重合,功能实验还没做。
已发表的抗体与纳米抗体仍是标杆:有三个对 Cn2 或 AaH II 的 KD 报在 0.11 到 0.70 nM,并且都在小鼠攻毒实验里保护过动物。2 Cn2-B1 的 1.7 到 3.1 nM 与它们差一个量级上下。
实验室之间的读数差得不少,这一点读者容易忽略。2 AaH II 的结合蛋白两边差 3 到 51 倍,AaH I 差 1.1 到 4.1 倍;Adaptyv Bio 自己对 AaH I 的两次重复就差 3 到 13 倍。2
这份材料留下的空白
它给的降本路径在另一篇工作里:把 30 多个开源生物模型压快约 4 倍,配一条简化提示词、单张 GPU 跑 24 小时,in-silico 分数可以接近早先用掉约 100 倍算力的战役。2 那项比较只到 in-silico 分数为止,这次战役跑的是原速版本。2
实际执行的是 Anthropic 自己的生命科学研究团队,加上 Adaptyv Bio 与 Twist Bioscience 两家合同实验室。1
特异性上还有两个口子。2 最紧的 Cn2-B1 对卵清蛋白也有信号,1 µM 时达到理论最大响应的 13%;而它在 Cn2 上达到同一水平只需约 0.5 nM,浓度差 2000 倍。2 Cn2-B2 与 Cn2-B3 在多反应性检测里分别到 98% 与 108%,超出 12 个参考抗体的区间。2
数据全开了:211 条设计的序列、制作方式、预测结构与打分、两家实验室的结合数据,都在 Hugging Face 上,CC BY 4.0。4
几条可以带走的读法
| 读数 | 能怎么用 | 前提 |
|---|---|---|
| 17 / 211 | 判断这条流水线的产出规模 | 单毒素组 11/60、双三毒素组 5/60、全五种组 1/91,三个分母不同 2 |
| Cn2-B1 的 1.7 到 3.1 nM | 看设计蛋白离可用的抗体还差多远 | 两个都是上限估计,且都比已发表的 0.11 到 0.70 nM 松 2 |
| 竞争实验掉 87% 到 95% | 判断结合位置是否压在功能面上 | 属于位置证据,中和未测 2 |
| AUROC 0.50 到 0.71 | 决定 in-silico 分数放在流程哪一步 | 组内排序失效,只适合粗筛 2 |
| 约 10,000 H100 卡时 | 估算自建一轮战役的成本 | 官方另有单卡 24 小时的降本路径,但只验证到 in-silico 2 |
第一件事,把命中率的分母写清楚。2 同样是「17 条结合」,按单毒素组算是 11/60,按全部 211 条算是 17/211。对外讲成果时用哪个分母,决定读者对这条流水线的预期。
第二件事,先看打分能不能在组内排序,再决定信它多少。2 这套打分能告诉你哪个方向有戏,送测名单仍得靠别的手段兜底。
第三件事,遇到零命中先查抗原。2 Ts1 那一路的零,至少有表达系统与标签遮挡两条现成解释;把零直接读成模型能力上限,会漏掉这一类。
这套流程眼下最扎实的部分,是它把「设计」这一段压到了几天,并且把全部负结果一起放了出来。2 离药还有中和、稳定性、成本、可及性几道关,报告把它们一道道列在了明面上。
References
- 1
- 2De novo design of protein binders against scorpion toxins with Claude
www-cdn.anthropic.com
- 3
- 4Anthropic/scorpion-toxin-binder-design
huggingface.co
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.